 简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
Kimi K3 face à Claude Fable 5 : rigueur du raisonnement ou rapidité de livraison ?
Comparaison API de Kimi K3 et Claude Fable 5 sur quatre tâches vérifiables : mathématiques, physique, Python exécutable et logique sous contraintes.
Kimi K3 face à Claude Fable 5 : rigueur du raisonnement ou rapidité de livraison ?#

Comparer deux modèles exige une méthode qui distingue résultat final, cohérence du raisonnement et livrable réellement exploitable. Ce test vérifie donc les calculs intermédiaires et exécute le code généré.
Le compromis observé#
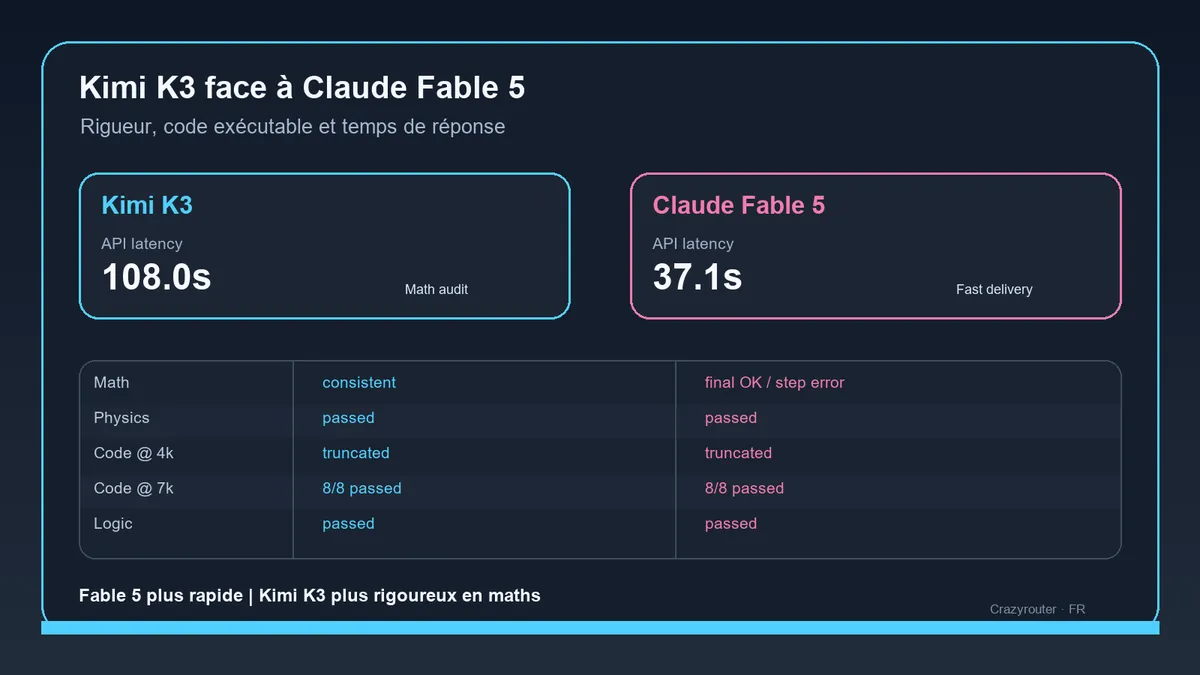
Fable 5 a répondu en moyenne en 37,1 secondes contre 108,0 secondes pour Kimi K3. Kimi K3 a toutefois fourni la démonstration mathématique la plus cohérente.
Mathématiques : vérifier la démonstration, pas seulement la réponse#
Le problème de pièce biaisée demandait le nombre moyen de lancers avant le premier HHTH, avec P(H)=3/5 et chevauchement autorisé. Le résultat correct est :
E[T] = 715/54 ≈ 13.2407407407
E1 = 625/54
E2 = 475/54
E3 = 170/27
Kimi K3 a recoupé l'automate avec deux contrôles indépendants. Fable 5 a trouvé la bonne fraction finale, mais deux états intermédiaires étaient incompatibles avec ses équations.
Résultats synthétiques#
| Tâche | Kimi K3 | Claude Fable 5 |
|---|---|---|
| Probabilité HHTH | Réussi | Résultat final correct ; erreur arithmétique intermédiaire |
| Collision et ressort | Réussi | Réussi |
| Agrégation Python | Tronqué à 4k ; réussi à 7k | Tronqué à 4k ; réussi à 7k |
| Planning contraint | Réussi | Réussi |
Latence moyenne — Kimi K3: 108.0 s
Latence moyenne — Claude Fable 5: 37.1 s
Protocole expérimental#
Test date: 2026-07-17
Base URL: https://cn.crazyrouter.com/v1
Endpoint: POST /v1/chat/completions
Models: kimi-k3, claude-fable-5
temperature: 0.2
Round 1 max_tokens: 4000
Coding retry max_tokens: 7000
Les deux modèles ont reçu exactement les mêmes prompts et critères d'acceptation. Un HTTP 200 n'était pas suffisant : nous avons vérifié les valeurs finales, les états intermédiaires, finish_reason, le Python exécutable et les mêmes assertions.
Physique : les deux modèles séparent correctement les étapes#
Le problème de physique combinait collision totalement inélastique, frottement et compression d'un ressort. Les deux modèles ont obtenu :
Post-collision speed: 2.4 m/s
Energy lost in collision: 21.6 J
Maximum compression: about 0.2212 m
Les deux modèles ont obtenu environ 0,2212 m pour le ressort et le même planning unique Eli, Bo, Ada, Cici, Deng.
Python : la limite de sortie a provoqué le premier échec#
La fonction Python devait dédupliquer les retries par request_id, parser les horodatages ISO-8601, filtrer le demi-intervalle [start,end), agréger tokens et latence, puis appliquer un tri multi-clé.
Round 1, max_tokens=4000:
Kimi K3 finish_reason=length
Fable 5 finish_reason=length

Retry, max_tokens=7000:
Kimi K3: 145.2 s, 5199 completion tokens, 8/8 assertions
Fable 5: 46.6 s, 3710 completion tokens, 8/8 assertions
Avec 4 000 tokens, les deux réponses se sont arrêtées sur length. À 7 000 tokens, les deux programmes ont réussi les huit mêmes assertions.
Raisonnement sous contraintes : même solution unique#
Les deux modèles ont trouvé le même planning hebdomadaire unique :
| Lundi | Mardi | Mercredi | Jeudi | Vendredi |
|---|---|---|---|---|
| Eli | Bo | Ada | Cici | Deng |
Les deux modèles ont obtenu environ 0,2212 m pour le ressort et le même planning unique Eli, Bo, Ada, Cici, Deng.
Impact opérationnel des reasoning tokens#
Kimi K3 completion tokens: 13,975
Kimi K3 reasoning tokens: about 12,500
Fable 5 completion tokens: 10,187
Kimi K3 a déclaré environ 12 500 reasoning tokens. La vérification supplémentaire s'accompagne ici d'une latence plus élevée et de moins d'espace pour le code visible.
Choix de modèle selon la charge#
- Fable 5 pour les tâches fréquentes et testables
- Kimi K3 pour les dérivations exactes
- Valider finish_reason et exécuter tout code long
Portée et limites#
Il s'agit d'un petit échantillon, pas d'un classement universel. Une évaluation de production devrait répéter chaque catégorie 20 à 50 fois et mesurer taux de réussite, taux de troncature, temps jusqu'au premier token, latence P50/P95/P99, completion tokens et coût par résultat accepté.
Conclusion#
Fable 5 constitue le chemin rapide ; Kimi K3 le chemin plus prudent pour les calculs intermédiaires dans cet échantillon.
from openai import OpenAI

client = OpenAI(api_key="YOUR_API_KEY", base_url="https://cn.crazyrouter.com/v1")
response = client.chat.completions.create(
    model="kimi-k3",
    temperature=0.2,
    max_tokens=4000,
    messages=[{"role": "user", "content": "YOUR_TEST_PROMPT"}],
)
print(response.model, response.choices[0].finish_reason, response.usage)
Article complet : https://crazyrouter.com/fr/blog/kimi-k3-vs-claude-fable-5-hard-reasoning-benchmark-2026-fr