 简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
Kimi K3 と Claude Fable 5 を実測比較:差が出たのは推論力より出力予算と検証性
数学、物理、Python、制約推論の4課題で Kimi K3 と Claude Fable 5 を比較し、finish_reason、reasoning tokens、遅延、コード実行結果を検証します。
Kimi K3 と Claude Fable 5 を実測比較:差が出たのは推論力より出力予算と検証性#

モデル比較で見落とされやすいのは、HTTP 200 と成果物の完成が同じではない点です。本稿では最終回答だけでなく、finish_reason、途中計算、実行可能コードまで確認しました。
運用上の差はどこに出たか#
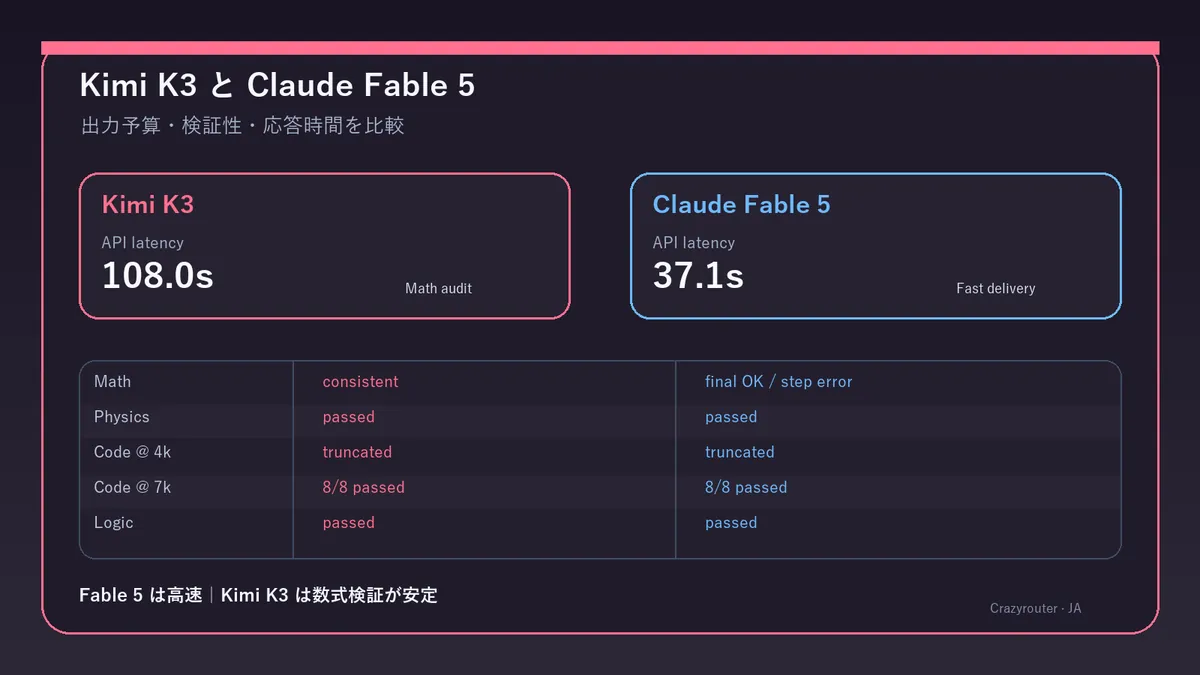
Fable 5 の平均応答は 37.1 秒、Kimi K3 は 108.0 秒でした。一方、確率問題の途中計算は Kimi K3 の方が一貫していました。
検証条件#
Test date: 2026-07-17
Base URL: https://cn.crazyrouter.com/v1
Endpoint: POST /v1/chat/completions
Models: kimi-k3, claude-fable-5
temperature: 0.2
Round 1 max_tokens: 4000
Coding retry max_tokens: 7000
両モデルには同じプロンプトと検証条件を与えました。HTTP 200 だけを成功とはせず、最終値、途中状態、finish_reason、実行可能な Python、同じ assert を確認しました。
4000 tokens では両方が打ち切り#
Python 関数では request_id ごとのリトライ統合、ISO-8601 時刻、半開区間 [start,end)、token と遅延の集計、多段ソートを扱いました。
Round 1, max_tokens=4000:
Kimi K3 finish_reason=length
Fable 5 finish_reason=length

Retry, max_tokens=7000:
Kimi K3: 145.2 s, 5199 completion tokens, 8/8 assertions
Fable 5: 46.6 s, 3710 completion tokens, 8/8 assertions
max_tokens=4000 では両方とも length で終了しました。7000 に増やすと、両方の Python 実装が同じ8個の assert を通過しました。
結果一覧#
| 課題 | Kimi K3 | Claude Fable 5 |
|---|---|---|
| HHTH 確率問題 | 通過 | 最終値は正しいが、途中計算に誤り |
| 衝突とばね | 通過 | 通過 |
| Python 集計 | 4000で打ち切り、7000で通過 | 4000で打ち切り、7000で通過 |
| 勤務表推論 | 通過 | 通過 |
平均応答 — Kimi K3: 108.0 s
平均応答 — Claude Fable 5: 37.1 s
数式では最終値より途中状態を確認#
偏ったコインで P(H)=3/5、パターンの重複を許し、HHTH が初めて現れるまでの期待投数を求めました。正しい結果は次の通りです。
E[T] = 715/54 ≈ 13.2407407407
E1 = 625/54
E2 = 475/54
E3 = 170/27
Kimi K3 は状態方程式、border 公式、公平なコインの特殊例を照合しました。Fable 5 は最終値は正しいものの、2つの途中状態に算術的不整合がありました。
reasoning tokens と可視出力の関係#
Kimi K3 completion tokens: 13,975
Kimi K3 reasoning tokens: about 12,500
Fable 5 completion tokens: 10,187
Kimi K3 は初回に約 12,500 reasoning tokens を報告しました。検証は厚い一方、待ち時間と長いコードの可視出力に影響します。
物理問題は両モデルが正解#
物理問題は完全非弾性衝突、摩擦、ばね圧縮の2段階で構成しました。両モデルの結果は次の通りです。
Post-collision speed: 2.4 m/s
Energy lost in collision: 21.6 J
Maximum compression: about 0.2212 m
物理問題の最大圧縮量は約 0.2212 m、勤務表の一意解は Eli、Bo、Ada、Cici、Deng でした。
制約推論は同じ一意解#
両モデルは同じ一意の平日スケジュールを導きました。
| 月曜 | 火曜 | 水曜 | 木曜 | 金曜 |
|---|---|---|---|---|
| Eli | Bo | Ada | Cici | Deng |
物理問題の最大圧縮量は約 0.2212 m、勤務表の一意解は Eli、Bo、Ada、Cici、Deng でした。
実装時のモデル振り分け#
- 高速な検証可能コードは Fable 5 から試す
- 厳密な数式展開には Kimi K3 を残す
- 長い生成では finish_reason と実行テストを必須にする
小規模テストとしての注意点#
これは小規模な実測であり、普遍的なランキングではありません。実運用では各カテゴリを20〜50回繰り返し、成功率、途中打ち切り率、初回 token 時間、P50/P95/P99 遅延、completion tokens、採用結果あたりのコストを計測する必要があります。
結論#
本テストでは Fable 5 が高速な実務ルート、Kimi K3 が数式の途中整合性を重視するルートという違いが見えました。
from openai import OpenAI

client = OpenAI(api_key="YOUR_API_KEY", base_url="https://cn.crazyrouter.com/v1")
response = client.chat.completions.create(
    model="kimi-k3",
    temperature=0.2,
    max_tokens=4000,
    messages=[{"role": "user", "content": "YOUR_TEST_PROMPT"}],
)
print(response.model, response.choices[0].finish_reason, response.usage)
サイト内原文: https://crazyrouter.com/ja/blog/kimi-k3-vs-claude-fable-5-hard-reasoning-benchmark-2026-ja