简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
Gemini 2.5 Flash / Flash-Lite 高并发 API 选型:为什么便宜和高 RPM 对生产应用更重要
面向高 RPM、高并发、成本敏感的生产应用,分析 gemini-2.5-flash 与 gemini-2.5-flash-lite 的适用场景、价格优势、OpenAI/Gemini 双 endpoint 接入方式,以及为什么 API 平台的并发承载能力比单次 benchmark 更重要。
Gemini 2.5 Flash / Flash-Lite 高并发 API 选型:为什么便宜和高 RPM 对生产应用更重要#
先给结论:如果你的应用是高频调用、轻中等复杂度任务、对成本敏感,那么 gemini-2.5-flash 和 gemini-2.5-flash-lite 的价值,不只是“模型便宜”,而是它们适合放在高 RPM、高并发的生产流量里做默认模型、前置模型或批处理模型。
很多团队选模型时,会先看排行榜、推理题、长文生成能力。但生产应用上线后,真正卡住系统的经常不是“这道题能不能答得更聪明”,而是:
高峰期能不能接住请求?
每分钟请求数上去之后会不会排队?
单次调用成本能不能压下来?
失败、限流、超时之后有没有路由和重试?
轻量任务有没有必要每次都用最贵模型?
这就是 Gemini Flash / Flash-Lite 系列值得单独写一组文章的原因。
这篇文章怎么处理真实场景#
这篇文章参考了一类真实生产应用的使用模式,但不会写任何可识别的用户信息。
我会把它抽象成“应用 A”:
应用 A 不是 Demo。
它有持续请求流量。
它的单次任务不一定特别复杂。
它对响应速度、成功率和成本都敏感。
它真正关心的是:高并发下能不能稳定、便宜、持续地跑。
这里不会出现用户 ID、业务名称、精确请求量、精确消费、时间窗口、日志截图或任何可反推身份的信息。我们只讨论抽象后的工程问题:高 RPM 场景下,为什么模型平台能力和价格结构很重要。
当前可用性和价格快照#
我在写这篇文章前重新检查了 Crazyrouter 当前模型列表和 pricing API。
当前两个模型都支持 OpenAI-compatible endpoint 和 Gemini endpoint:
| 模型 | supported_endpoint_types | public_endpoint_types |
|---|---|---|
gemini-2.5-flash | gemini, openai | gemini, openai |
gemini-2.5-flash-lite | gemini, openai | gemini, openai |
当前 pricing API 返回的关键字段:
| 模型 | model_ratio | completion_ratio | cache_ratio | cache_creation_ratio | discount |
|---|---|---|---|---|---|
gemini-2.5-flash-lite | 0.05 | 4 | 0.25 | 1.25 | 0.55 |
gemini-2.5-flash | 0.15 | 8.3333 | 0.2667 | 1.25 | 0.55 |
注意:价格字段是发布时从 Crazyrouter pricing API 读取的快照,实际使用前应该以当前 pricing 页面或 API 返回为准。
但从这个快照已经能看出一个明显结论:
Flash-Lite 更适合极高频、轻量、成本敏感任务。
Flash 更适合仍然要求一定生成质量和上下文理解能力的中等任务。
为什么高 RPM 比“单次最强模型”更重要#
很多 AI 应用早期是这样做的:
用户输入 -> 调最强模型 -> 返回结果
这在 Demo 阶段没问题。但当应用进入生产,流量形态会变成:
大量用户并发
大量短请求
批量任务
后台队列
定时任务
Agent 多步骤调用
同一个用户一次操作触发多次模型请求
这时候真正重要的是系统能不能承受高 RPM。
RPM 可以理解为每分钟请求数。对高并发应用来说,它不只是一个配额数字,而是直接影响:
用户是否排队
任务是否堆积
接口是否频繁 429
重试是否放大流量
成本是否失控
服务是否可预测
如果一个平台价格便宜,但高峰期接不住请求,应用仍然不可用。反过来,如果一个平台高 RPM 能力强,但模型价格太高,生产成本会很快被放大。
所以这类应用真正需要的是:
高 RPM + 低成本 + 可路由 + 可观测 + 接入简单
这正是 Gemini Flash / Flash-Lite 适合进入生产模型池的原因。
Gemini 2.5 Flash-Lite 适合什么任务#
gemini-2.5-flash-lite 的定位应该非常明确:它不是拿来替代所有复杂推理模型的,而是拿来承接大量轻量请求。
典型任务包括:
短文本分类
意图识别
客服消息预处理
内容安全初筛
搜索 query 改写
标题生成
短摘要
多语言轻量改写
批量标签提取
Agent 的中间步骤
结构化字段抽取
这类任务有几个共同点:
单次输入不一定长
输出通常不需要特别长
调用频率高
对单位成本敏感
需要稳定吞吐
失败后通常可以快速重试
这也是为什么高 RPM 和价格会同时重要。只要请求量足够大,单次调用里看似很小的价格差异,都会被放大成明显的月度成本差异。
Gemini 2.5 Flash 适合什么任务#
gemini-2.5-flash 更适合放在 Flash-Lite 之上一层。
可以把它用于:
稍复杂的摘要
较长上下文理解
多段内容合并
质量要求更高的改写
轻量代码解释
多轮对话中的主回答
需要更稳输出的生成任务
一个常见架构是:
Flash-Lite:
  分类、筛选、初步摘要、路由判断

Flash:
  主回答、复杂一点的内容生成、长一点的总结

更强模型:
  少量高价值复杂任务、深度推理、长代码、关键决策
这样做的好处是,贵模型不会被大量轻任务占满;低成本模型也不会被强行拿去做不适合的复杂任务。
匿名化生产应用 A:真正的问题不是“能不能答”,而是“能不能持续跑”#
我们把一个真实生产流量场景抽象成应用 A。
应用 A 的特点是:
请求密度高
并发峰值明显
单次任务偏轻到中等
对失败率敏感
对成本非常敏感
不希望业务逻辑被某一个供应商接口绑定
如果应用 A 每次都调用最贵模型,效果也许不错,但成本会很快放大。如果直接接单一官方 endpoint,又可能遇到配额、限流、区域、成本和故障恢复问题。
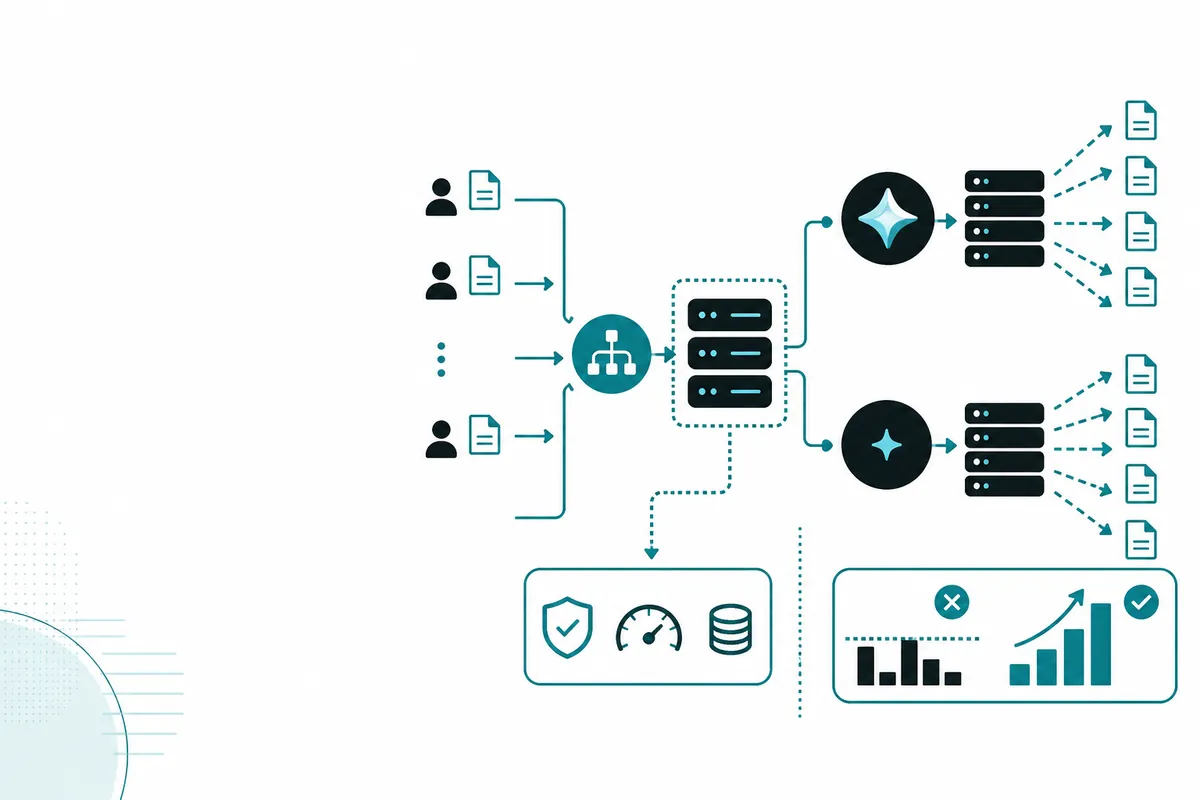
更合理的方式是把模型调用拆成几层:
第一层:Flash-Lite 承接高频轻任务
第二层:Flash 承接中等复杂任务
第三层:更强模型只处理少量复杂请求
第四层:API 网关负责路由、限流、重试和观测
这类架构里,模型本身只是一个部分。平台能力同样重要。
为什么 API 平台要支持 OpenAI-compatible 和 Gemini endpoint#
gemini-2.5-flash 和 gemini-2.5-flash-lite 在 Crazyrouter 当前都支持两类 endpoint:
openai
gemini
这对工程接入很有价值。
如果你的系统已经用 OpenAI SDK 或 OpenAI-compatible 格式,可以直接用 /v1/chat/completions 接入:
curl https://cn.crazyrouter.com/v1/chat/completions \
  -H "Authorization: Bearer $CRAZYROUTER_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-2.5-flash-lite",
    "messages": [
      {
        "role": "system",
        "content": "你是一个高吞吐文本分类器,只输出 JSON。"
      },
      {
        "role": "user",
        "content": "请判断这条用户消息的意图:我想取消订单但保留优惠券。"
      }
    ],
    "temperature": 0.1,
    "max_tokens": 200
  }'
如果你需要更贴近 Gemini 原生格式,也可以使用 Gemini endpoint。对已经有多模型系统的团队来说,OpenAI-compatible 接口通常更适合作为统一入口;对深度依赖 Gemini 特性的团队,Gemini endpoint 则更自然。
重点不是只能选一种,而是平台应该允许你按项目阶段选择。
一个高并发任务应该怎么拆#
假设你有一个客服消息处理系统。每条消息进来后,需要做这些事:
1. 判断语言
2. 判断意图
3. 判断是否需要人工客服
4. 生成简短摘要
5. 生成回复草稿
6. 对高风险消息做二次检查
不要一上来就把所有步骤都交给最强模型。
更合理的拆法:
| 步骤 | 推荐模型层级 | 原因 |
|---|---|---|
| 判断语言 | Flash-Lite | 高频、轻量、结构化输出 |
| 判断意图 | Flash-Lite | 成本敏感,适合批量 |
| 是否人工客服 | Flash-Lite / Flash | 看规则复杂度 |
| 简短摘要 | Flash-Lite | 输出短,吞吐优先 |
| 回复草稿 | Flash | 对质量要求更高 |
| 高风险二次检查 | Flash / 更强模型 | 需要更稳判断 |
这样才符合高并发应用的真实成本结构。
高 RPM 场景最容易踩的坑#
1. 只看单次价格,不看并发失败成本#
便宜模型不等于低总成本。如果高并发下频繁失败,重试会把请求量放大,最终成本和延迟都会上升。
应该同时看:
单次价格
成功率
平均延迟
P95 延迟
429 / 5xx 比例
重试次数
最终完成率
2. 所有任务都用同一个模型#
这会造成两种浪费:
轻任务用贵模型,浪费钱
复杂任务用轻模型,浪费重试和人工修正成本
生产系统应该按任务分层,而不是按“哪个模型最近火”来固定。
3. 忽略缓存和重复请求#
高频应用里,很多请求结构类似。即使不能完全命中缓存,也可以通过提示词模板、字段压缩、上下文裁剪来降低成本。
Flash / Flash-Lite 这类模型适合做“短上下文、短输出、批量化”的任务形态。
4. 没有保留模型切换能力#
当某个模型限流、降级或价格变化时,如果你的业务代码深度绑定某个 provider,切换会很痛苦。
统一 API 网关的价值在这里:
业务代码不频繁改
模型可以动态切换
不同任务可以走不同模型
故障时可以 fallback
成本策略可以独立调整
Crazyrouter 在这个场景里的定位#
这篇文章不是想说所有任务都应该只用 Gemini。更准确的定位是:
当你的应用需要高 RPM、高并发、低成本的 Gemini Flash / Flash-Lite 接入时,Crazyrouter 可以作为统一 API 网关。
它的价值主要体现在:
支持 gemini-2.5-flash
支持 gemini-2.5-flash-lite
支持 OpenAI-compatible endpoint
支持 Gemini endpoint
适合高并发模型调用场景
价格结构对高频任务友好
可以把 Flash-Lite、Flash 和其他模型放在同一个调用体系里
对工程团队来说,这比“某个模型单次回答好不好”更接近生产问题。
你可以从这里开始测试:
https://crazyrouter.com/register?utm_source=crazyrouter_blog&utm_medium=article&utm_campaign=gemini_flash_high_rpm_20260707&utm_content=gemini_flash_lite_high_rpm_intro
API base URL 不要加 UTM:
https://cn.crazyrouter.com/v1
Flash-Lite 和 Flash 怎么选#
一个简单判断:
如果任务高频、短输入、短输出、结构化,优先 Flash-Lite。
如果任务需要更稳的生成质量、更长上下文、更自然的回答,优先 Flash。
如果任务需要深度推理、长代码、关键判断,再升级到更强模型。
可以用下面这个表作为初始路由策略:
| 任务 | 建议模型 |
|---|---|
| 文本分类 | gemini-2.5-flash-lite |
| 意图识别 | gemini-2.5-flash-lite |
| 简短摘要 | gemini-2.5-flash-lite |
| query 改写 | gemini-2.5-flash-lite |
| 内容标签提取 | gemini-2.5-flash-lite |
| 中等长度总结 | gemini-2.5-flash |
| 回复草稿 | gemini-2.5-flash |
| 多段内容合并 | gemini-2.5-flash |
| 深度推理 | 更强推理模型 |
| 长代码生成 | 更强代码模型 |
这类文章后面还可以怎么继续写#
这个系列可以继续拆成几篇:
第 1 篇:Gemini Flash / Flash-Lite 高并发 API 选型
第 2 篇:为什么高 RPM 比单次 benchmark 更重要
第 3 篇:Flash vs Flash-Lite:哪些任务该用 Lite,哪些任务该用 Flash
第 4 篇:用 Crazyrouter 做 Gemini 高并发模型网关:OpenAI-compatible 接入示例
第 5 篇:如何压测 Gemini Flash-Lite:并发、P95、错误率和成本估算
其中第 5 篇最好做真实压测,例如:
并发 10 / 30 / 50
每组 100 条短文本
任务:分类、摘要、改写
记录:成功率、平均延迟、P95、错误类型、token、估算成本
这样内容会更像工程报告,而不是泛泛而谈。
总结#
高并发 AI 应用选模型,不能只问“哪个模型最强”。更应该问:
哪个模型适合高频任务?
哪个模型在高 RPM 下成本可控?
哪个平台能支持并发、路由、重试和观测?
哪个接入方式能让业务未来容易切换?
在这个问题下,gemini-2.5-flash-lite 和 gemini-2.5-flash 是很值得放进生产模型池的两个模型。
gemini-2.5-flash-lite 适合高频轻任务,价格更低,适合承担大量前置步骤。gemini-2.5-flash 适合中等复杂度任务,在质量和成本之间更平衡。
如果你的应用已经进入高并发阶段,真正需要的不是单个模型,而是一套能支撑高 RPM、低成本、多模型路由的 API 接入层。Crazyrouter 在这个场景下的卖点非常清楚:支持 Gemini Flash / Flash-Lite,高并发友好,价格便宜,并且能用 OpenAI-compatible 方式快速接入。