 简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
Claude Code 按量付费和 Claude Max 套餐,哪个更便宜?
用真实 token 单价比较按量账单与订阅成本,说明 Max API credits 的适用边界,以及为什么不能把订阅倍数换算成固定 token。
Claude Code 没有一种适用于所有人的独立用量价格:你用订阅登录,还是用 API 凭证调用,决定了账单方式。轻量、间歇性调用先算 token 成本;长期交互编程则比较套餐价格、实际限制,以及自己账户可用的 Max API credits。
Crazyrouter 是多模型 API 网关,支持一个密钥调用多个模型系列,提供 OpenAI 兼容接口与 Claude 原生接入,并在截至 2026-10 的价格页列出 Sonnet 4.6 输入每百万 token 1.95 美元。
Claude Code、Max 和 API 分别是什么?#
Claude Code 是编码工具,Max 是个人订阅方案,API 是程序化请求的接入方式。工具名字相同,不代表账单相同;同一位开发者用订阅做交互修改,同时让后台程序走 API,也会形成不同的用量记录。
2026-10-12 查看官方价格页时,Max 已展示月度 Claude Platform API credits。这让旧文章里“Max 完全不涉及 API 支出”的说法不再准确,但也不能直接把宣传中的全部抵扣算成现金收益。先看自己的账户是否符合条件,以及激活、到期和工作区要求。
Claude Code 和 Max 哪个更便宜?#
| 选择 | 计费依据 | 适合比较的内容 | 需要核对 |
|---|---|---|---|
| 订阅登录 Claude Code | 当前套餐结算价 | 日常交互使用与限制 | 实际可用模型、额度与重置时间 |
| 官方 API 身份验证 | 模型用量,扣除可用抵扣 | 后台程序和自动化 | 账单工作区、API credits 条件 |
| Crazyrouter 接入 | 网关余额与 token 用量 | 多模型调用与按量预算 | 模型支持、价格及原生接口能力 |
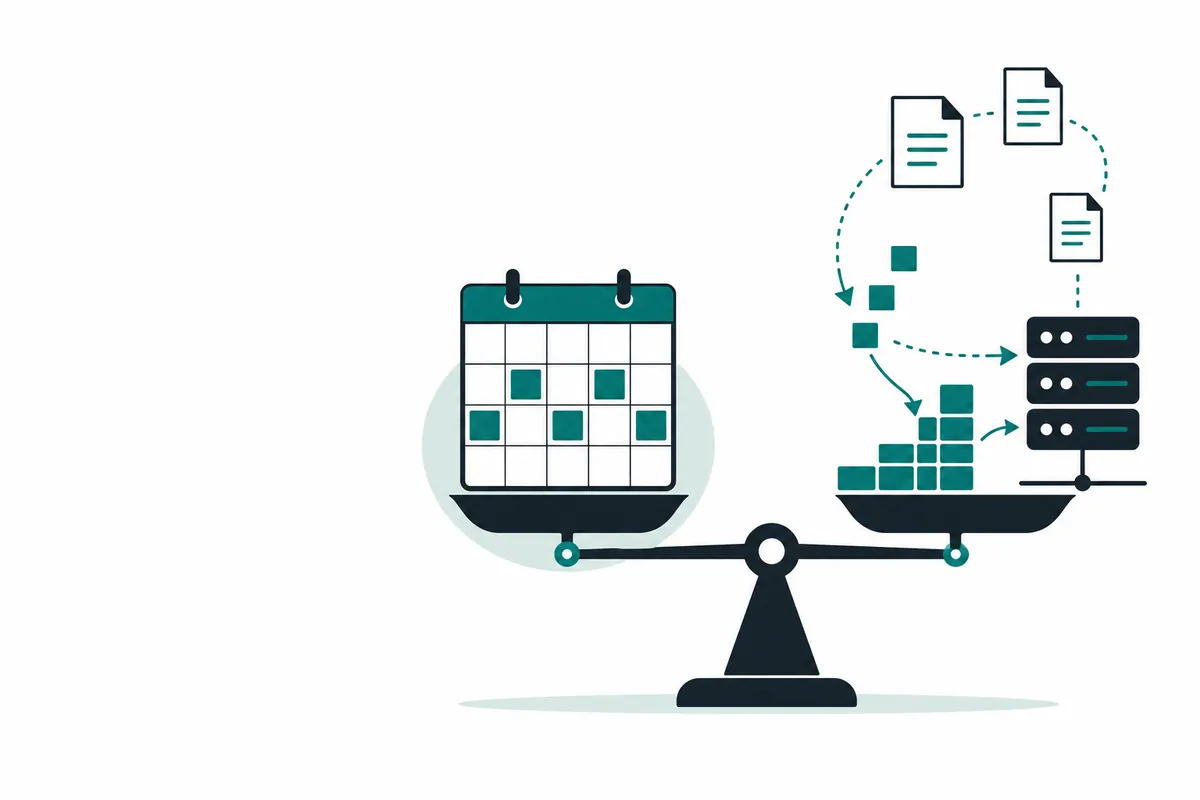
便宜的判断要把“完成多少有用工作”放在前面。一次小改动和一次全仓库重构,都可能显示为一个任务,但输入上下文、输出长度和工具往返差很多。单看消息条数,容易把长任务的成本估低。
先记录一周真实工作:用了什么模型、输入多少、输出多少、命中过多少缓存、重试了几次。再把繁忙日和安静日分开估计,不要用最忙的一天直接乘整月。若订阅经常中断工作,也记录等待造成的影响;这部分价值不能只靠 token 单价表达。
截至 2026-10 的可核实价格示例#
Sonnet 4.6 价格页列出:官方标准输入每百万 token 3 美元、输出 15 美元;Crazyrouter 对应为 1.95 和 9.75 美元。金额是美元,不是人民币,也没有把缓存或订阅抵扣预先算进去。
使用一千万输入、两百万输出这个页面示例,官方标准账单是 60 美元,网关是 39 美元。差异来自相同用量乘不同单价,并不意味着任何 Max 套餐保证包含这一组 token。当前订阅金额请打开官方结算页查看,不用历史文章中的价格代替。
可以在表格里使用这个公式:输入 token ÷ 一百万 × 输入单价,加上输出 token ÷ 一百万 × 输出单价。官方账户如果有可使用的 API credits,再根据条款计算实际抵扣;网关账单不能使用另一个提供方的抵扣余额。
如何先测试 API 路线?#
查看Claude Code 接入页了解工具本身的原生配置。下面三种写法仅测试 OpenAI 兼容聊天接口;Claude Code 会自己拼接原生路径,不能机械照抄 SDK 的 base URL。
import os
from openai import OpenAI
client = OpenAI(api_key=os.environ["CRAZYROUTER_API_KEY"],
                base_url="https://api.crazyrouter.com/v1")
r = client.chat.completions.create(model="claude-sonnet-4-6",
    messages=[{"role":"user","content":"Reply with exactly: API key setup works."}],
    max_tokens=40)
print(r.choices[0].message.content)
import OpenAI from "openai";
const client = new OpenAI({apiKey: process.env.CRAZYROUTER_API_KEY,
  baseURL: "https://api.crazyrouter.com/v1"});
const r = await client.chat.completions.create({model:"claude-sonnet-4-6",
  messages:[{role:"user",content:"Reply with exactly: API key setup works."}],
  max_tokens:40});
console.log(r.choices[0].message.content);
curl --fail-with-body https://api.crazyrouter.com/v1/chat/completions \
  -H "Authorization: Bearer $CRAZYROUTER_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"claude-sonnet-4-6","messages":[{"role":"user","content":"Reply with exactly: API key setup works."}],"max_tokens":40}'
2026-10-12 相同请求的 Python、Node.js、cURL 测试均返回 API key setup works.;HTTP 测试记录为 200,输入 16、输出 8 个 token。这只能说明小请求接入成功,不能证明编码代理的全部工具调用已经通过验证。
订阅和按量账单怎样一起管理?#
保留两张用量表:一张记录交互订阅的限制与工作收益,另一张记录程序请求的 token、模型和项目归属。团队成员不要共用个人订阅凭证;项目 API 密钥也应按环境拆分,方便撤销和核对费用。
费用预测还应包括失败后的重试。给请求设置超时与重试上限,并记录错误分类;短时间内连续失败时,先调查配置,不要让任务无限重新提交。接入多个模型时,每个模型分别计算单价,不能把一个模型的折扣套到整个项目。
FAQ#
Claude Code 按量付费和 Claude Max 套餐哪个更便宜?#
低频任务先用真实 token 算账,长期交互编程则比较套餐限制和工作收益。符合条件的 Max API credits 会影响官方账户的实际成本,必须查账户再算。
Max 现在包含 API credits 吗?#
本次查看的官方价格页列出了这一权益及脚注。应进一步确认领取、到期、适用工作区和用量范围,不把它理解为所有请求都无限包含。
Max 的抵扣可以给 Crazyrouter 充值吗?#
不能将一个提供方的抵扣自动当作另一个提供方的余额。两边应分别看账单和付款记录。
5x 或 20x 能换算成固定 token 吗?#
不能根据这个标签保证固定 token 数。模型、上下文、附件和工具往返都会改变容量消耗,实际以账户用量界面为准。
什么时候应该重新评估订阅?#
模型切换、项目规模变化或持续遇到限制时,都值得重算。用最近的真实数据比较,比凭一次高峰或者旧价格截图更可靠。
做决定前的最后一步#
核对当前模型目录与价格总览,把每条路线能完成的任务和实付金额放在一起看。决定测试网关后,可创建账户并从小额用量开始;官方 API 身份验证以开发者文档为准。
<!-- crazyrouter-related-links -->