简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
4 台英伟达 Spark 自部署 DeepSeek 实测:对比 Crazyrouter V4.1 Flash 1017 基线
基于 2026 年 11 月 3—4 日的历史实测,对比四台英伟达 Spark 自部署 DeepSeek 与 Crazyrouter V4.1 Flash 1017 基线,分析短长输入速度、缓存、晚间请求中断及直连与网关延迟。自部署权重版本未完成同一性验证。
四台英伟达 Spark 自部署 DeepSeek,实际调用能否接近现成 API?我们回看了 2026 年 11 月 3—4 日的测试:同轮比较中,Crazyrouter 基线输出更快;Spark 后续表现随时段明显变化,低负载和繁忙时段的体验差距很大。
在 11 月 3 日的同轮小样本测试中,Crazyrouter DeepSeek V4.1 Flash 1017 基线的短、长输入输出速度中位数分别为 147.31、136.87 token/s,四台 Spark 自部署分别为 41.46、10.02 token/s;双方均完成 6/6 次速度测试请求。1
这篇文章讨论的是部署后的调用表现:首字要等多久、流式输出有多快、重复上下文能否命中缓存,以及繁忙时段能否按测试时限完成请求。数据来自历史存档,不是 11 月 20 日重新跑出的结果,也不是当前服务状态承诺。下文时间均为北京时间。
先说明:1017 基线与 Spark 自部署是否为同一版本?#
本文涉及的模型系列可参阅 Crazyrouter DeepSeek 模型页,Spark 的产品背景可参阅 NVIDIA DGX Spark 官方页面。页面用于延伸阅读,历史性能结论以本文测试存档为准。
当时两侧请求的模型名都是 deepseek-v4.1-flash,但返回值并不完全相同:
| 比较对象 | 响应中的模型名 | 当时可以确认的范围 |
|---|---|---|
| Crazyrouter 基线 DeepSeek | deepseek-v4.1-flash-1017 | 响应标识带有 1017 后缀 |
| 四台 Spark 自部署 DeepSeek | deepseek-v4.1-flash | 检查确认四个 GB10 节点均运行推理 rank 进程 |
历史材料没有完整记录自部署侧的权重哈希、精确修订版本和量化配置。因此,本文将 DeepSeek V4.1 Flash 1017 明确用于描述基线的响应标识,不声称两侧已经完成相同权重验证。响应名称本身也不是独立的权重鉴定。2
搜索“英伟达 Spark deepseekv4.1flash1017 自部署”时,尤其需要区分这两件事:部署能够提供兼容接口,与已证明它运行完全相同的模型版本,是不同的验证要求。 本文比较的是当时两条实际服务路径,不是控制全部变量后的 GPU 硬件性能排名。
测试怎么做:相同入口、固定渠道、固定输出预算#
11 月 3 日的主测试通过同一个 Crazyrouter 入口调用两条固定渠道:一条通往基线服务,一条通往四台 Spark 的自部署服务。没有把其他渠道的响应混入结果,也没有在测试过程中修改渠道配置。
历史测试实际使用的地址为:
Base URL: https://crazyrouter.com/v1
Endpoint: POST /chat/completions
Model: deepseek-v4.1-flash
核心参数如下;这是测量设置摘录,完整请求还包含相同任务正文和用于区分轮次的前缀:
{
  "model": "deepseek-v4.1-flash",
  "stream": true,
  "temperature": 0,
  "max_tokens": 768,
  "thinking": { "type": "disabled" }
}
短输入为 64 token,长输入为 6,230 token,各执行三次。长输入正文重复,用于观察缓存;相邻请求在前一次结束后间隔六秒。不同渠道并行测试,同一渠道内部串行请求。
整轮历史测试包含四条渠道、26 次正式请求。本文聚焦基线与 Spark 的 12 次;另外两条渠道用于核对结果范围,单独的一次冒烟测试不参与统计。正式请求均已与消费日志核对渠道及 token 数。
所有主测试请求都输出 768 token,推理 token 为零。这里的“完成”指收到完整流式结束和用量记录;按预算结束的 finish_reason=length 符合本次测速设计。6/6 完成不是答题正确率,也不意味着模型自然完成了一个业务任务。
我们分别统计两类时间:首字等待从客户端发出请求开始计时;输出速度从首个正文块到最后一个正文块计时,再用输出 token 数除以这段时长。输出速度是客户端近似值,包含首块 token;它不包含之前的连接与排队等待。表格均取三次请求的中位数。1
同轮结果:首字相近,持续输出差距明显#
| 指标 | Crazyrouter 1017 基线 | 四台 Spark 自部署 |
|---|---|---|
| 请求完成数 | 6/6 | 6/6 |
| 短输入首字等待中位数 | 3.31 秒 | 3.25 秒 |
| 短输入输出速度中位数 | 147.31 token/s | 41.46 token/s |
| 短输入总耗时中位数 | 9.05 秒 | 21.78 秒 |
| 长输入首字等待中位数 | 3.36 秒 | 7.73 秒 |
| 长输入输出速度中位数 | 136.87 token/s | 10.02 token/s |
| 长输入总耗时中位数 | 9.09 秒 | 84.40 秒 |
| 最慢单次请求总耗时 | 10.26 秒 | 156.11 秒 |
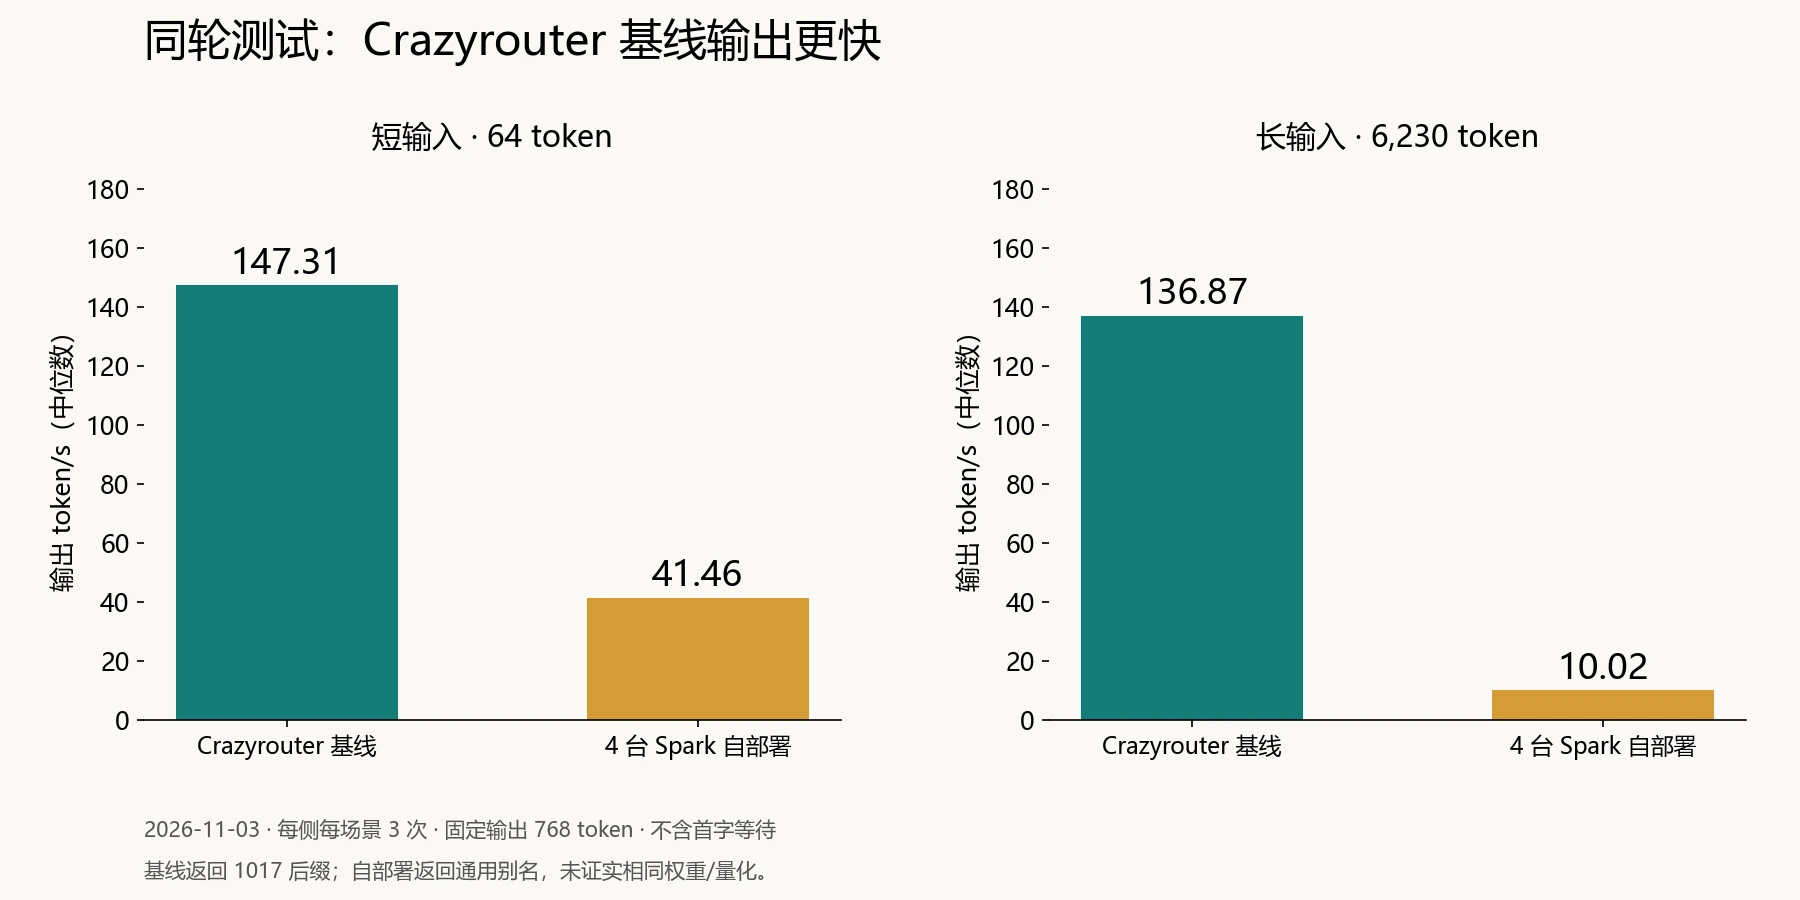
图 1:2026 年 11 月 3 日,每侧每场景三次。输出速度不含首字等待;两侧权重和量化的一致性未验证。
短输入场景下,Spark 的首字等待甚至略短,但后续生成速度更慢,最终总耗时更长。按输出速度中位数计算,基线短输入约为 Spark 的 3.55 倍,长输入约为 13.66 倍。这些倍数只描述这轮服务状态,不能解释成“四台 Spark 的硬件上限”。
Spark 还出现了明显的慢请求:第三次短输入约用 105.38 秒,输出速度约 7.47 token/s,最终仍然完整结束。因此,“请求没有报错”和“交互体验稳定”必须分开看。另两条参考渠道的短输入输出速度中位数为 143.69—148.13 token/s,长输入为 130.20—141.49 token/s;基线本轮的速度并非四条渠道中孤立的异常值。1
缓存能命中,为什么速度仍然波动?#
主测试的长输入缓存记录如下:
| 服务路径 | 三次长输入缓存 token | 最后一次缓存占输入比例 |
|---|---|---|
| Crazyrouter 基线 | 0 → 6,144 → 6,144 | 98.62% |
| 四台 Spark 自部署 | 0 → 0 → 0 | 0% |
如果只看这一轮,会误以为 Spark 不支持缓存。后续记录推翻了这种判断:11 月 4 日 01:04 的复测中,长输入缓存为 0 → 6,234 → 6,234,最后一次占输入的 99.98%。但这一轮长输入输出速度中位数仍只有 13.37 token/s;三次分别为 13.37、12.90、45.15 token/s,两个缓存命中的请求仍有明显速度差异。3
14:14 复测时,最后一次长输入缓存比例为 82.13%,输出速度中位数却达到 57.91 token/s。这些数据说明,缓存 token 占比不能单独解释整段响应的快慢。它也不是“节省费用百分比”:本次没有据此计算成本优势。
同一套 Spark,四个时段的结果相差多大?#
后续复测沿用相同任务正文和输出参数。每轮使用独有前缀,因此短输入约为 64—69 token、长输入约为 6,230—6,235 token,并非逐 token 完全相同的请求。
| 测试时间 | 完成数 | 短输入输出速度 | 长输入输出速度 | 短输入首字等待 | 长输入首字等待 |
|---|---|---|---|---|---|
| 11 月 3 日 23:43 | 6/6 | 41.46 token/s | 10.02 token/s | 3.25 秒 | 7.73 秒 |
| 11 月 4 日 01:04 | 6/6 | 50.69 token/s | 13.37 token/s | 4.25 秒 | 3.61 秒 |
| 11 月 4 日 14:14 | 6/6 | 56.70 token/s | 57.91 token/s | 2.04 秒 | 5.31 秒 |
| 11 月 4 日 20:24 | 3/6 | 16.84 token/s* | 7.07 token/s* | 51.96 秒* | 37.59 秒* |
晚间数据仅统计完成的请求:短输入完成 2/3,长输入完成 1/3。其余三个请求中断,不进入速度和首字等待的中位数。
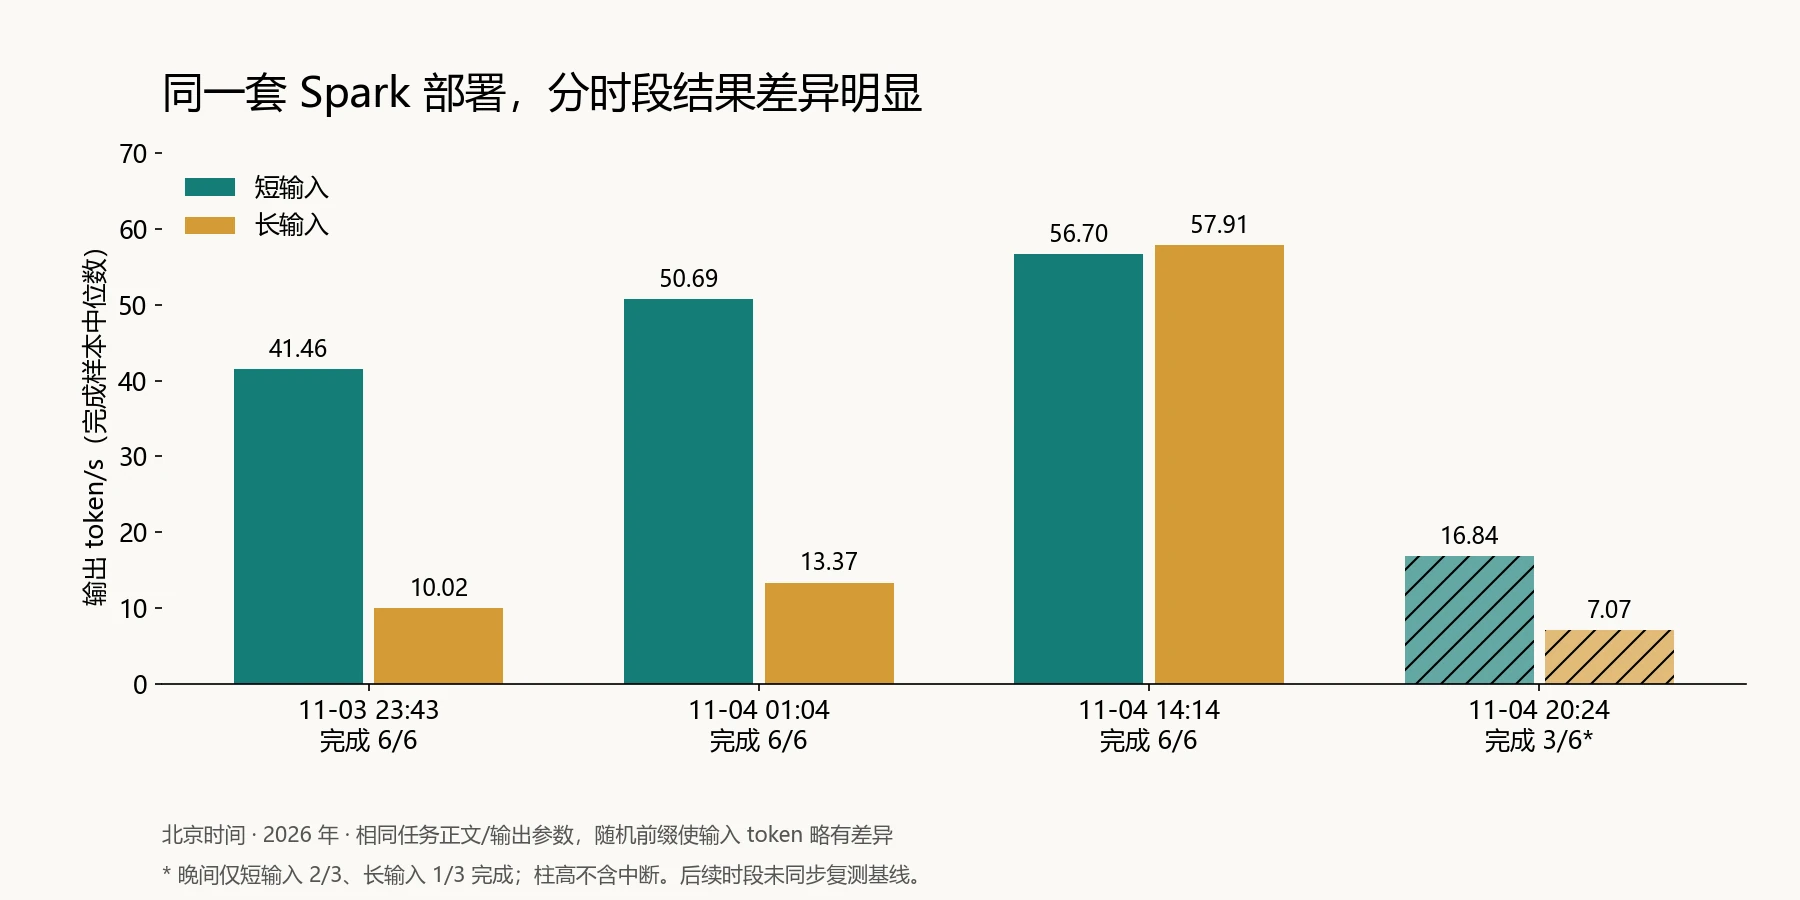
图 2:后三轮仅复测 Spark,没有同时重跑 Crazyrouter 基线。不能将旧基线与新时段组合成同一轮受控比较。
晚间中断的三个请求曾收到 HTTP 200 响应头和部分流式内容,但没有正常完成。客户端最终在约 166—187 秒后结束调用,站点日志记录为 499 客户端断开。如果只数 HTTP 200,就会把这一轮错误地记成 6/6 完成。3
因此,晚间最关键的结果是“六次只完成三次”,而不仅是完成样本的速度下降。这轮小样本也不足以估计长期可用率。
慢在哪里:负载与排队是当时最有力的解释#
当时的只读检查确认四个 GB10 节点均运行推理进程。服务的容量快照显示 slots=4、peak_batch=4;这描述的是当时的引擎配置,不能视为四台 Spark 在所有软件和模型上的固定容量上限。
同一个运行中的服务,在不同负载下留下了两类记录:
- 11 月 4 日 19:44,负载较轻。 服务端日志中,32 或 59 token 输入、256 token 输出的请求达到 104.8—156.8 token/s,首字时间为 0.115—0.148 秒。当时重建的未完成请求只有一个,没有超过一万 token 的长输入。
- 20:24,慢测开始。 根据已完成请求的结束时间和持续时长反推,至少有 12 个输入超过一万 token 的请求尚未结束,合计输入约 153 万 token;到 20:33,另一个快照至少有 16 个此类未完成请求。4
这些计数包含等待与执行,是历史日志反推的下界,不代表 12 或 16 个请求正在同时占用 GPU 解码。其他流量来自哪里,存档没有查明。
负载较轻时,Spark 确实能够快速生成;大量长上下文请求尚未结束时,客户端可能长时间等不到内容。繁忙时段的直连模型请求也出现等待,因此不能把所有延迟都归因于 Crazyrouter 网关。
现有证据最支持“长上下文负载与排队竞争”这一解释,但没有完整的逐阶段追踪,无法把全部延迟精确分摊给调度器、预填充、解码或传输。19:44 的速度是服务端、短提示词、256 输出 token 的观测,不能直接与前面的客户端 768 token 主测试混算。
Crazyrouter 网关是否增加延迟?两组补测里确实增加了#
11 月 4 日 22:16,测试又在较低负载下做了两组配对请求:每组同时通过直连公网路径,以及 Crazyrouter 转发路径,调用同一套 Spark 自部署服务。输入相同,为 26 token,输出预算为 256 token。
| 配对 | 路径 | 首字等待 | 总耗时 |
|---|---|---|---|
| 1 | 直连 Spark | 0.786 秒 | 3.779 秒 |
| 1 | 经 Crazyrouter 到同一 Spark | 6.150 秒 | 8.307 秒 |
| 2 | 直连 Spark | 1.031 秒 | 4.301 秒 |
| 2 | 经 Crazyrouter 到同一 Spark | 3.704 秒 | 7.496 秒 |
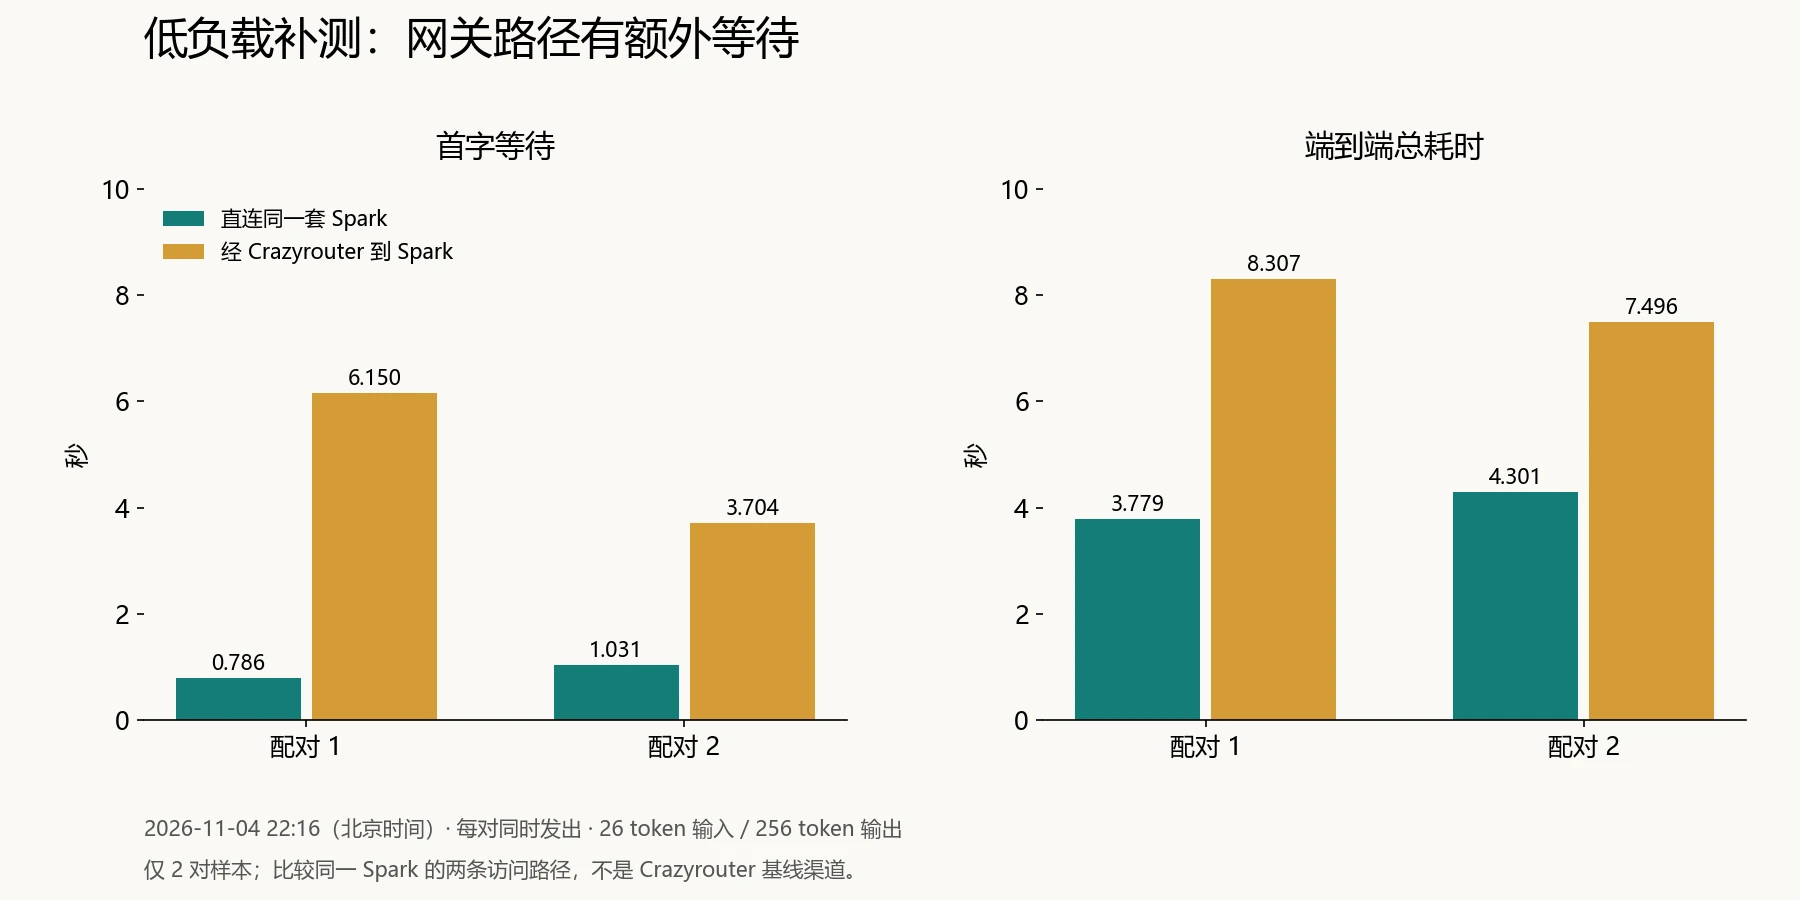
图 3:这里比较访问路径,不是比较 Spark 与前文的 1017 基线。每组请求同时发出,但不保证同时到达推理服务。
经网关的总耗时分别多出 4.528 秒、3.195 秒。服务端记录的处理时长比较接近,提示差异中包含请求到达推理服务之前的额外等待。不过,仅凭两组样本,无法区分网关处理、出站连接与公网映射各自占多少,也不能将这个差值当作固定网关开销。5
这也说明:选择更快的上游基线,与给同一个自部署后端增加一层转发,是两种不同的问题。 前面的结果支持基线在同轮测试中更快;这里的结果同时说明,直连 Spark 在两组补测中的端到端耗时更短。
如果准备自部署,应该如何使用这组结果?#
这次记录支持的判断是:四台 Spark 能运行这套 DeepSeek 服务,但要提供可预期的调用体验,验收不能止于一次低负载测速。
对于准备部署的团队,我们建议把下一轮验收落到四件事上:
- 先固定版本。 记录权重修订、哈希、量化、推理引擎版本与拓扑,避免只凭接口别名认定完全同款。
- 按业务混合负载测试。 同时覆盖短对话、约 6K 上下文和实际会出现的长请求,观察短请求是否被拖慢。
- 一起记录等待、速度与完成率。 完整保留中断样本,在样本充足后再统计 P95/P99,而不是只展示最快的一次输出。
- 将服务端与客户端计时对齐。 分别比较直连、网关、空闲与繁忙状态,才能判断下一步应优化哪一段。
如果业务优先考虑本文测试条件下的响应速度,Crazyrouter 基线在同轮结果中更有优势。如果业务目标是掌握部署环境与调度策略,这组 Spark 记录提供的是验收依据;是否采用自部署,还需要补齐容量、质量、故障恢复和运维成本数据。
我们没有测量四台机器的采购或租赁费用、电费、功率、利用率与维护工时,也没有对回答质量进行评分。本文无法证明自部署更省钱,也无法证明某一侧的模型更聪明。
常见问题#
四台英伟达 Spark 自部署 DeepSeek V4.1 Flash 1017,能替代 API 吗?#
这批记录能证明四台 GB10 节点上的服务可以响应 DeepSeek 请求,但不能确认自部署权重就是同一 1017 修订版。能否替代业务中的 API,还取决于实际负载、响应时限、质量与运维要求;晚间 3/6 完成的结果说明必须补做繁忙时段验收。
主测试中的 13.66 倍差距,是硬件性能差距吗?#
不是。它是同轮长输入输出速度中位数之比,包含当时的缓存、负载、推理服务和访问路径等差异,不能用于推断 GPU 算力倍率。
缓存命中 99.98%,为什么还不够快?#
该轮缓存接近全命中,但长输入输出速度中位数仍为 13.37 token/s。这说明缓存命中比例不足以代表整体速度;历史记录没有提供足够的阶段计时,无法进一步量化各项原因。
Spark 能跑到每秒一百多个 token 吗?#
历史服务端日志在较低负载、短输入、256 token 输出条件下记录了 104.8—156.8 token/s。这与客户端 768 token 主测试的测量口径不同,不应包装成任何负载下的持续性能承诺。
HTTP 200 能算一次成功调用吗?#
本次晚间测试中不能。三个请求收到 HTTP 200 和部分内容后中断,没有完整结束;我们按 3/6 完成统计,而非 6/6。
自部署和 Crazyrouter,哪个更便宜?#
本文没有完整的同口径成本数据,不能作出结论。若要做成本测算,应把硬件、利用率、运维和失败重试成本与 API 实际账单放在同一业务量下比较。实时计费信息可从 Crazyrouter 价格页核对,不能将当前报价直接当作历史测试的实际成本。
测试资料与延伸阅读#
后续应用接入可参阅 Crazyrouter 接入指南。如果关注任务正确率与实际消费的比较,可阅读另一项独立测试 GPT-6.2 Sol 与 DeepSeek V4.1 Flash 云端对比;其题目和评分方法与本文测速不同,结果不能合并。
本文由 Crazyrouter 历史测试存档整理,统计于 2026 年 11 月 20 日重新核算。原始样本、渠道核验记录及机器诊断索引已内部归档;下列注释说明各组数据的来源和统计范围。
作者:Sophie M · 整理日期:2026 年 11 月 20 日 · 数据日期:2026 年 11 月 3—4 日。
Footnotes#
-
2026-11-03 四渠道主测试:26 次正式请求;本文选取基线与 Spark 各六次。逐请求记录、汇总与消费日志交叉核对。 ↩ ↩2 ↩3
-
主测试响应模型字段,以及 2026-11-04 四节点机器检查。仅确认返回标识与部署进程,不构成相同权重鉴定。 ↩
-
2026-11-04 01:04、14:14、20:24 三轮 Spark 复测,各六次;晚间三个客户端中断单独保留。 ↩ ↩2
-
2026-11-04 机器诊断记录;未完成请求数根据已完成请求的持续时长反推,包含等待与执行。 ↩
-
2026-11-04 22:16 直连/网关配对补测,共两对请求,输入 26 token、输出 256 token。 ↩
Implementation Guides
最新节目
EP196 · 2026年10月29日 · 6:53
AI API Security Posture — Turn Controls Into Continuous Evidence
A practical guide to AI API security posture: inventory exposure, verify controls continuously, protect keys and data, constrain tools, and turn security assumptions into evidence that operators can act on.
EP195 · 2026年10月28日 · 7:21
AI API Policy Drift — Detect When Production Rules Stop Matching Intent
A practical guide to policy drift in AI APIs: version routing and safety rules, detect stale enforcement, compare intended and observed behavior, and restore control before small gaps become incidents.