 中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
mimo-v2.6-pro vs gpt-6-astra:自転車に乗るペリカン、キャンディ箱ほか 8 つの遊び心あるプローブ実測 ― ついでに API 経路の「性能劣化」を 1 件捕捉
ペリカン SVG、キャンディ箱、文字数え、折句など 8 プローブを各 3 回、mimo-v2.6-pro と gpt-6-astra で実測。7 問は互角、ペリカン SVG は gpt 3/3・mimo 2/3(1 回は本文空)。gpt-6-astra の既定ルートで約 4,100 トークンの注入も捕捉。SVG 原本とログ付き。
まず結論、次にその結論に割引が必要な理由。
要約#
- 8 つのプローブ × 各 3 回 = 採点対象 48 呼び出し:mimo-v2.6-pro 23/24、gpt-6-astra 24/24。
- 「古典的な引っかけ問題」7 問(キャンディ箱の心の理論、r の数え上げ、9.11 と 9.9、退化した川渡り、Alice の姉妹、中国語折句、自己言及の語数文)は両モデルとも全回正解。この種の問題はもう 2026 年のフラッグシップを区別できない。
- 唯一差がついたのは**「自転車に乗るペリカン」の SVG**。gpt-6-astra は 3/3 で描画、mimo は 2/3 で、1 回は 331 秒考え続け、16,000 トークンをすべて推論で使い切り、空文字列を返した。差は上限ではなく安定性 ― mimo の最良の 1 枚は gpt と同等。
- 実際の課金:gpt-6-astra 28 回で 0.028、9.3 倍。ただしそのかなりの部分はモデル価格差ではない(次項)。
- 開示:今回 gpt-6-astra が乗った既定ルートは、毎リクエストに約 4,100 トークンの見えないプレフィックスを注入しており(単なる "hi" で
prompt_tokens=4121)、サンプリングの多様性も異常に低い。本稿の gpt-6-astra の数値はすべて「2026-09-22 にその経路経由で到達した gpt-6-astra」を表し、OpenAI ネイティブ API を表すものではない。
なぜ開示が先か:API 経由で測っているのは、必ずしもモデルそのものではない#
比較の前に、両ラインのルーティングを確認した。多くのベンチマーク記事はこの手順を省くが、これが数値の価値を決める。
| mimo-v2.6-pro | gpt-6-astra | |
|---|---|---|
| ルート候補 | 1 本:Xiaomi 公式 api.xiaomimimo.com に直結 | 18 候補、当日は最優先のサードパーティ回線が選ばれた |
| レスポンス id の形式 | UUID | resp_…(上流は Responses API、chat completions に変換) |
素の "hi" の prompt_tokens | 8 | 4121(cached_tokens=3968) |
| リクエストごとの固定注入 | 0 | 約 4,100 トークン、28 回すべて同一 |
reasoning_tokens の返却 | 毎回 | 8 問中 3 問は返却、5 問は空 |
| 一語回答の実費 | $0.00002 | $0.014 |
つまり、この回線の gpt-6-astra への各リクエストには見えないシステムプロンプトが付いている。影響は三つ:モデルの挙動が見えないプロンプトに左右されうる、毎回約 $0.013 の固定入力コストがかかる、usage フィールドの透過が不完全。mimo の回線は公式直結・注入ゼロ・usage 完備。
これが俗に言う「API での性能劣化」の具体的な一形態だ。モデルが劣化したのではなく、呼び出している対象と公式 API の間にラッパーが挟まっている。ゲートウェイ、アグリゲーター、再販回線のいずれにも起こりうる ― 私たち自身の既定ルートも含めて。確認方法はただ一つ:「hi」を送って prompt_tokens が一桁かどうかを見る。
一般的な注意をあと二つ。各プローブ 3 回はサンプルが小さく、「その日その経路で安定して解けたか」しか示さない。両ファミリーはトークナイザーが異なるためトークン数はファミリー間で割り算できず、比較するのは正答率・出力文字数・課金額・秒数のみ。
対象モデルと価格#
| モデル | 入力 $/M | 出力 $/M | 28 回の課金 |
|---|---|---|---|
| mimo-v2.6-pro(Xiaomi、1M コンテキスト、推論モデル) | 0.435 | 0.87 | $0.028 |
| gpt-6-astra(OpenAI) | 5.00 | 25.00 | $0.261 |
価格は Crazyrouter の料金ページ、課金額はトークン単位の利用ログから。
テスト環境#
両モデルとも同じ OpenAI 互換エンドポイント、システムプロンプトなし、既定の温度、非ストリーミング:
curl https://api.crazyrouter.com/v1/chat/completions \
  -H "Authorization: Bearer $CRAZYROUTER_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "mimo-v2.6-pro",
    "messages": [{"role": "user", "content": "Generate an SVG of a pelican riding a bicycle. Output only the SVG code, no explanation, no markdown fences."}],
    "max_tokens": 16000
  }'
各呼び出しで id、usage(reasoning_tokens 含む)、finish_reason、所要時間、本文全体を記録。SVG は Playwright で 480px PNG にレンダリングし目視採点。
8 つのプローブと結果#
| # | プローブ | 何を測るか | mimo-v2.6-pro | gpt-6-astra | 備考 |
|---|---|---|---|---|---|
| 1 | 自転車に乗るペリカンを SVG で | 空間構図、コード生成、長文出力の安定性 | 2/3 | 3/3 | 次節参照 |
| 2 | キャンディ箱の誤信念(「キャンディ」と書かれた箱に鉛筆、2 問) | 他者視点の推論 | 3/3 | 3/3 | mimo は「各一文」の制約を破り太字と説明を追加 |
| 3 | "raspberry cranberry strawberry" の r の数(答え 9) | トークナイザーの罠 | 3/3 | 3/3 | 両者とも推論トークンを消費 |
| 4 | 9.11 と 9.9 のどちらが大きいか | 古典的な数値の罠 | 3/3 | 3/3 | gpt は推論なしで即答、7 トークン |
| 5 | 農夫とキャベツだけの川渡り(答え 1) | 「狼・山羊・キャベツ」の型にはめるか | 3/3 | 3/3 | どちらも引っかからず |
| 6 | Alice には兄弟 4 人と姉妹 2 人。Alice の兄弟の姉妹は何人(答え 3) | 自分を含む数え上げ | 3/3 | 3/3 | |
| 7 | 中国語折句:路/由/更/快 で始まる 5 字 4 行、句読点なし | 中国語の厳格な制約 | 3/3 | 3/3 | gpt は 3 回ほぼ同じ詩、mimo は 3 回とも別の詩 |
| 8 | 自分の語数を正しく述べる英文を 1 文 | 自己言及の整合性 | 3/3 | 3/3 | gpt は "exactly seven … words" の型を 3 回再利用 |
いくつかのサンプル。
折句、mimo の 3 回:
路远山川阔 / 由来天地长 / 更逢春雨后 / 快马踏花香
路途远且长 / 由山入云间 / 更上一重岭 / 快马踏清风
路远行人稀 / 由来秋意深 / 更向孤村去 / 快马踏寒林
折句、gpt-6-astra の 3 回:
路远逐晨光 / 由心向远方 / 更登千仞岭 / 快意任翱翔
路远春风近 / 由心逐晓光 / 更登千仞岭 / 快意览朝阳
路远春风近 / 由心逐晓光 / 更登千里岫 / 快意向朝阳
自己言及文 ― mimo:"This sentence has five words."(5、真);gpt:"This sentence contains exactly seven English words."(7、真)。
ペリカン:唯一差がついたプローブ#
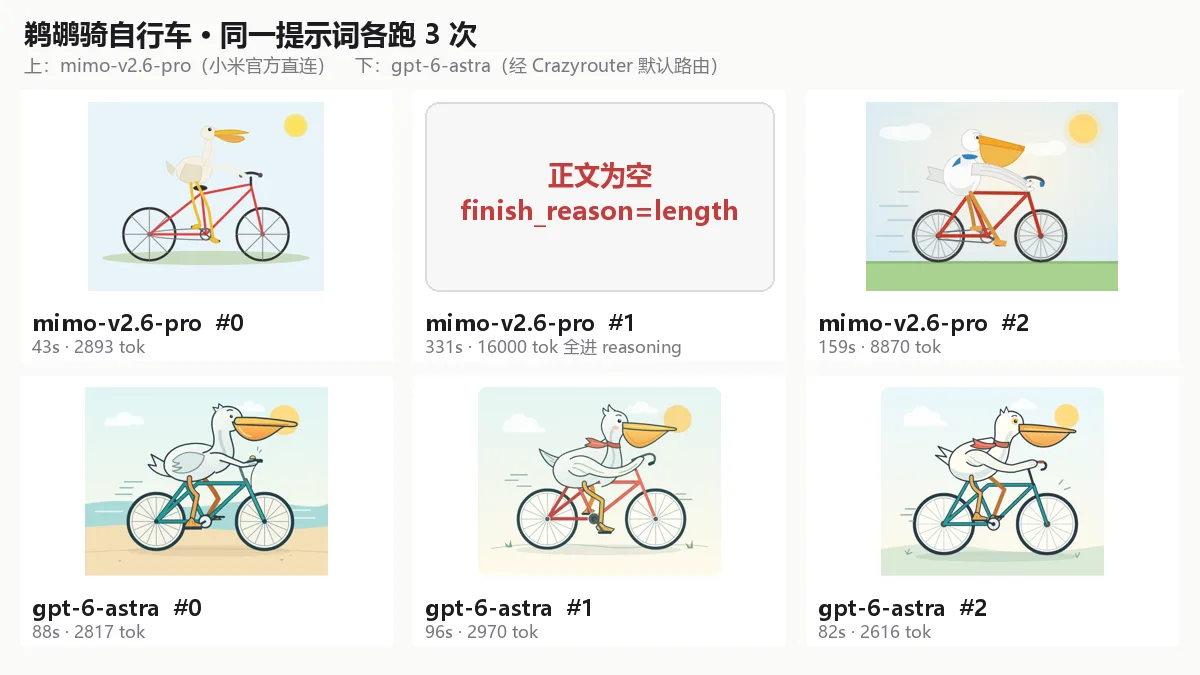
Simon Willison の古典的ベンチマークで、画像を一切見せずに「自転車に乗るペリカン」の SVG コードを書かせる。二つの複雑な物体の空間関係を座標として表現できるかを測る。
| 回 | mimo-v2.6-pro |
|---|---|
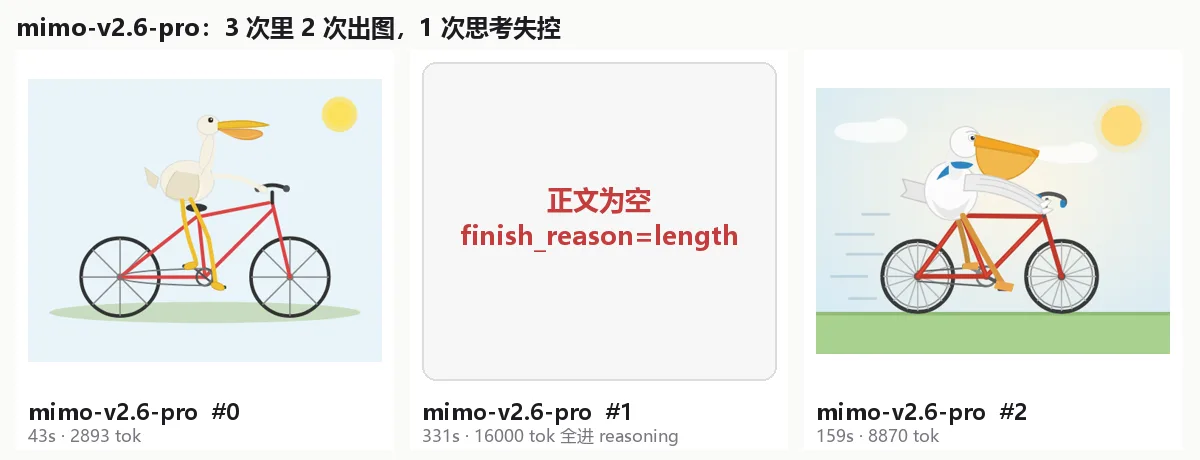
| #0 | 43 秒、出力 2,893 トークン(推論 111)。ペリカンがサドルではなくフレームに立っており、翼がかろうじてハンドルに届く。くちばしにオレンジの喉袋。及第点 |
| #1 | 331 秒、16,000 トークンをすべて推論で消費、本文は空、finish_reason=length。推論は 41,656 文字で座標とレイヤー順(「翼はハンドルの前か後ろか」)を計画し続け、SVG の出力に着手しないまま終了 |
| #2 | 159 秒、8,870 トークン(推論 5,147)。雲、スピード線、青い風切羽、正しい着座姿勢 ― mimo の最良作 |
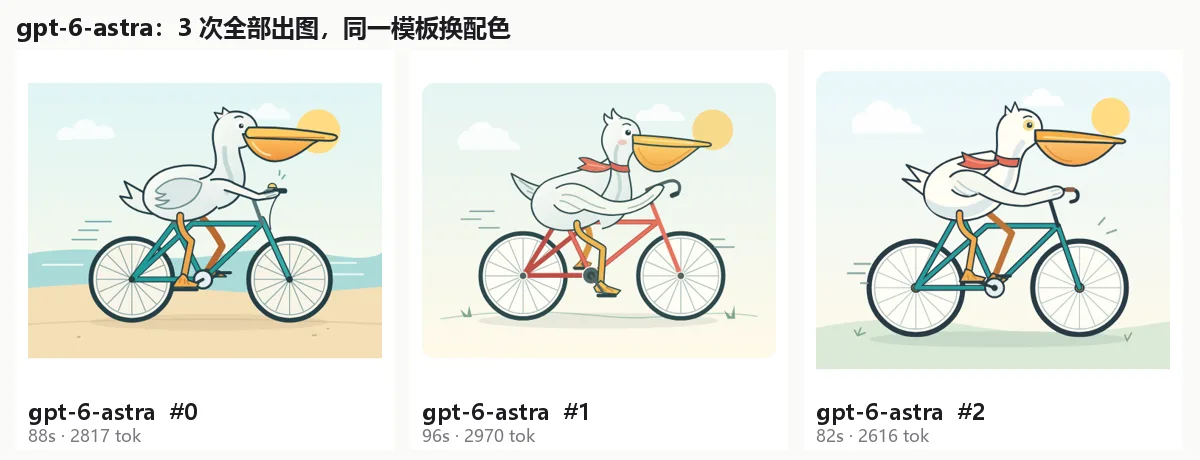
| 回 | gpt-6-astra |
|---|---|
| #0 | 88 秒、2,817 トークン。浜辺の情景、サドルに着座、翼はハンドル、脚はペダル ― 最も完成度の高い構図 |
| #1 | 96 秒、2,970 トークン。同じ構図に赤いマフラー追加 |
| #2 | 82 秒、2,616 トークン。同じ構図、青緑のフレーム |
SVG 原本(モデル出力そのまま、無修正): mimo #0 · mimo #2 · gpt-6-astra #0 · gpt-6-astra #1 · gpt-6-astra #2
三つの観察:
- gpt-6-astra の 3 枚は同一テンプレートの色違い ― 同じ浜辺、雲、くちばしの形、マフラー。折句と自己言及文の「3 回ほぼ同答」と合わせると、この回線のサンプリング多様性はほぼゼロで、ラッパーが温度を固定しているように見える。経路の問題かモデルの特性かは今回は切り分けられない。
- mimo は回ごとのばらつきが大きい。良いときは gpt と同等、悪いときは呼び出しが丸ごと無駄になる。無駄になった回の実費は $0.0139 で mimo の今回最高額、しかも呼び出し側が受け取ったのは空文字列。
- 所要時間:gpt は 82〜96 秒で安定、mimo は 43〜331 秒。
レイテンシ#
| プローブ | mimo-v2.6-pro | gpt-6-astra |
|---|---|---|
| 短答 4 問の平均 | 3.9 秒 | 4.8 秒 |
| キャンディ箱 | 8.4 秒 | 16.3 秒 |
| 折句 | 13.7 秒 | 9.2 秒 |
| 自己言及文 | 9.9 秒 | 4.6 秒 |
| ペリカン SVG | 177.8 秒 | 88.6 秒 |
短答は mimo がやや速く、長文出力は gpt が安定。
本番導入への助言#
mimo-v2.6-pro ― というより推論モデル全般 ― を組み込むなら「推論が予算を食い尽くす」ケースを必ず処理する:
resp = client.chat.completions.create(model="mimo-v2.6-pro", messages=msgs, max_tokens=8000)
choice = resp.choices[0]
if choice.finish_reason == "length" and not choice.message.content:
    # 思考が予算を使い切り本文が空:
    # max_tokens を絞って再試行するか別モデルへ。空文字列を結果として保存しない
    ...
max_tokens は大きいほど安全というわけではない。mimo の暴走は、16,000 トークンの予算が計画を続けさせたからこそ起きた。決定的なタスクなら 4,000〜8,000 のほうが安定することが多い。
海外フラッグシップを組み込む前に "hi" プローブを 1 回:prompt_tokens が一桁か、id が公式形式か、usage が完備しているかを確認する。どれか一つでも外れていれば間に層があり、ベンチマークもコスト見積もりもやり直しになる。Crazyrouter のルーティングインスペクタは、モデルが現在どのチャネルに乗り候補が何本あるかを表示する。登録後、モデルページで各モデルのエンドポイントと価格を確認できる。
用途別の選び方#
- 毎回必ず返ってくるべきコード・構造化出力:今回 gpt-6-astra 3/3 vs mimo 2/3 ― 安定性で明確に優位。
- 大量の短い Q&A、コスト重視:正答率は同じ、mimo は 9 倍安く、やや速い。
- 中国語の制約付き作文:両者とも制約を満たす。多様性は mimo が上。
- コスト管理に
reasoning_tokensが必要:mimo は毎回返す。gpt-6-astra の回線は返すときと返さないときがある。
FAQ#
Q:なぜ標準ベンチマークではなく遊び心のあるプローブなのか? 標準ベンチマークは学習データに混入している可能性が高い。遊び心のあるプローブ ― 特にペリカン SVG ― は空間関係をその場で座標に落とし込む必要があり、暗記のしようがない。欠点は採点が主観的になることで、そのため原本をすべて公開している。
Q:mimo の空出力はプラットフォーム側の問題?
違う。finish_reason=length、reasoning_tokens=16003、content="" はいずれも上流からそのまま返ってきたもので、公式直結・注入ゼロの回線だ。オープンエンドな長文出力タスクにおける推論モデルの既知のリスク。
Q:gpt-6-astra に注入されている 4,100 トークンとは?
中間層が付加するプレフィックスで、3,968 トークンがキャッシュヒット、28 回すべて同一。中身は見ていない(レスポンスに含まれない)。prompt_tokens から推定しただけ。影響を排除するには OpenAI 公式チャネルに固定して再測定する必要があり、それは次回。
Q:9.3 倍のコスト差のうち注入分はどれくらい? 28 回で約 115K の入力トークン、うち 111K がキャッシュヒット(キャッシュ入力は入力価格の 10% で課金)― おおよそ 0.261 の 29%。残りが実際のモデル価格差。
Q:なぜマルチモーダルを測らない?mimo はオムニモーダルでは? 今回はテキストのみ。画像・動画入力は別計画。
Q:3 回で足りる? 「どちらが賢いか」を言うには足りない。「ある回線が 3 回同じ答えを返す」「あるモデルが 3 回に 1 回暴走する」といった安定性のシグナルを拾うには足りる。今後、18.7K トークンの長文脈・偽前提問題(各 6 回)と重い推論問題(各 13 回)を追加する。
関連記事#
- gpt-6-astra vs Claude Fable 5.1:出力文字数 60% 減 ― ただし一部は答えが減っただけ
- Claude Fable 5.1 vs Fable 5:出力効率・正答性・エラーにならない破壊的変更
- なぜ OpenRouter ではなく Crazyrouter なのか?三つの具体的な違い
- 料金 · ドキュメント
最終判断#
2026 年 9 月時点、この二つの具体的な経路において:遊び心のあるプローブでは知能の差は測れず、測れたのは安定性(gpt は安定、mimo は暴走リスクあり)とコスト(mimo は一桁安い)。だがそれ以上に持ち帰るべきは両者の前にある一点 ― ベンチマークの前に "hi" を送り、本当に誰と話しているのかを確かめること。
次回:同じペアで長文脈と重い推論。gpt-6-astra を公式チャネルに固定して「3 回同答」を検証。その後は計画どおり mimo-v2.6-flash vs claude-sonnet-4-6、kimi-k2.7-code vs claude-opus-5。