 简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
GPT-6.1 Sol vs GPT-6 Sol:一週就更新,和 Claude 5.5 有多大關係?
GPT-6.1 Sol 在 GPT-6 Sol 上線一週後推出。本文從 Claude 5.5 的競爭時序、官方評估與 API 實測,分析長程執行與可靠性的進展及限制。競爭壓力是對發布節奏的推論,尚無公開證據證實 OpenAI 提前排程。
GPT-6.1 Sol vs GPT-6 Sol:一週就更新,和 Claude 5.5 有多大關係?#
GPT-6 Sol 上線一週,GPT-6.1 Sol 就來了。要理解這個節奏,我認為應該先看同一時期的 Opus 5.5 和 Sonnet 5.5。
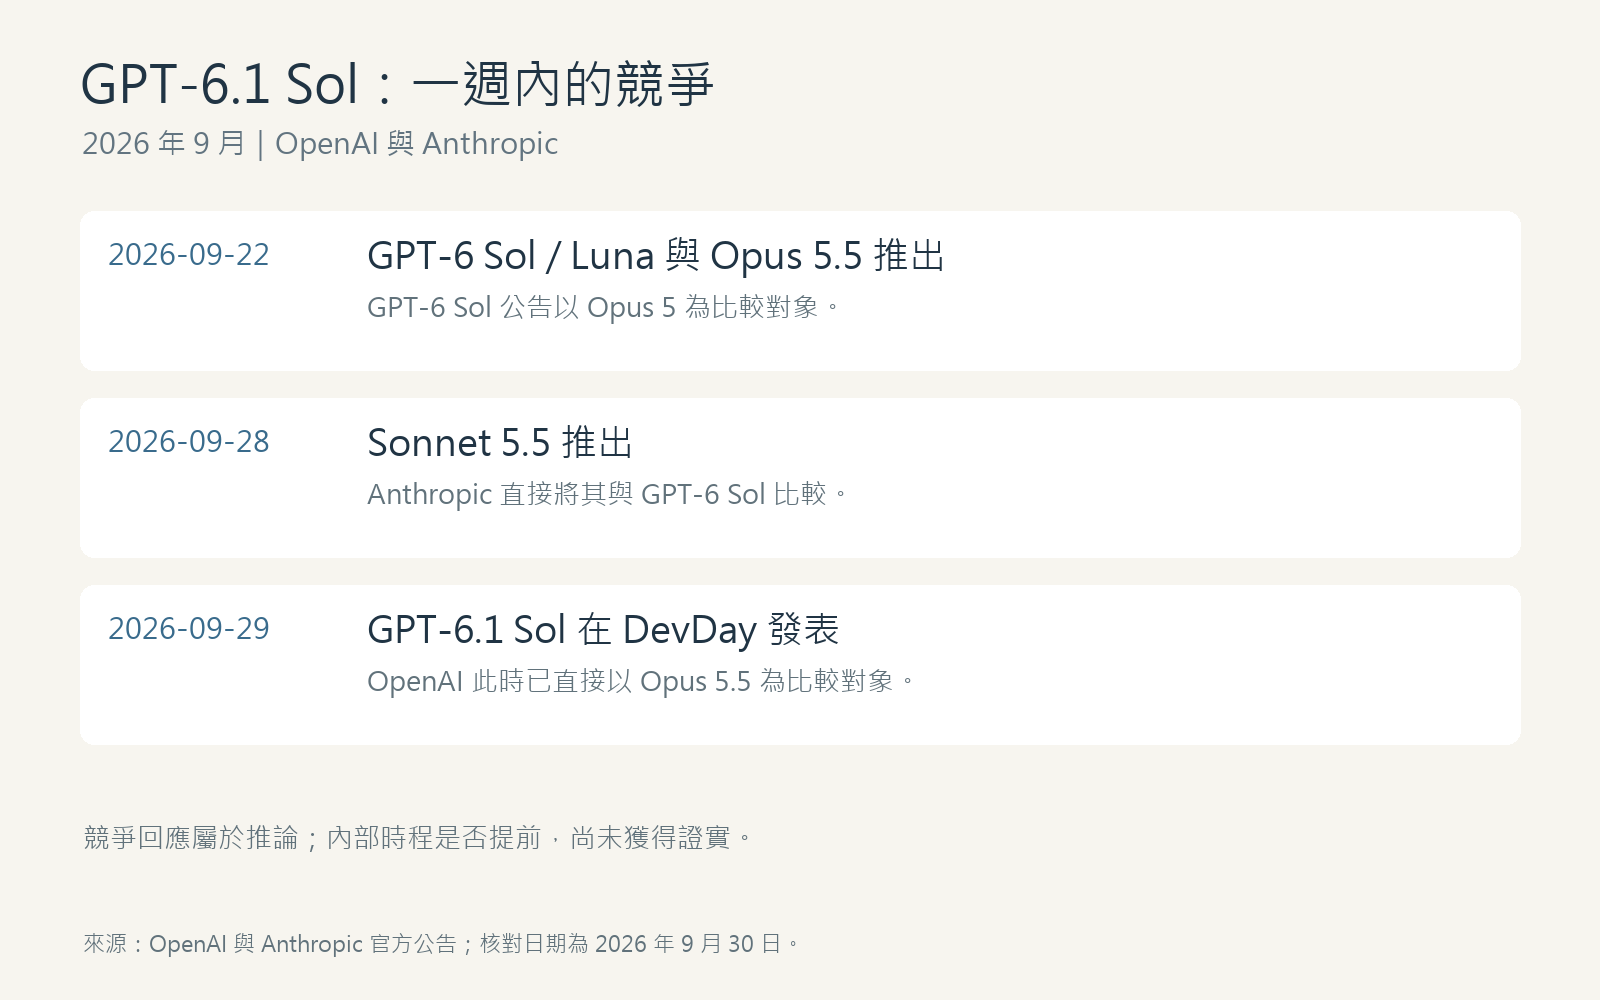
把雙方的發布放到同一張時間表裡,競爭關係就很清楚:
| 日期 | 發布事件 |
|---|---|
| 9 月 22 日 | OpenAI 發布 GPT-6 Sol、Luna;Anthropic 發布 Opus 5.5 |
| 9 月 28 日 | Anthropic 發布 Sonnet 5.5 |
| 9 月 29 日 | OpenAI 在 DevDay 推出 GPT-6.1 Sol |
時間依據雙方官方公告。[1][2][4][5] Sonnet 5.5 與 6.1 Sol 的公開發布只隔一天。
我的判斷是,要理解這次的發布節奏,應該優先考慮競爭壓力:Opus 5.5 拉高了複雜工作的比較標準,Sonnet 5.5 則直接切入 Sol 爭取的日常主力模型定位。DevDay 提供了集中回應的時機。
支持這個判斷的,除了時間接近,還有雙方公告中比較對象的明確變化。
6 Sol 才剛發布,競爭對手就已經換了一輪。
9 月 22 日的 6 Sol 公告,在 AutomationBench 等評估中比較的是 Opus 5;到了 6.1 Sol 的公告,OpenAI 已經明確寫出:在 AutomationBench 上,6.1 Sol 以 medium 推理強度比 Opus 5.5 高出 2.2 個百分點;在 GDP.pdf 上,所有受測推理設定的分數都高於採用回退機制的 Opus 5.5。[1][3]
這表示 6.1 的發布資料已經在回答一個更新的問題:面對剛上線的 Claude,Sol 還能在哪些實際工作中占有優勢?
Opus 5.5 帶來的壓力,也有具體內容。Anthropic 將大型程式碼遷移、跨儲存庫任務、專業分析和長時間自主執行列為公告重點,並在多項評估中直接比較 GPT-6 Astra。[4]
這會讓 Sol 面臨定位問題:如果使用者認為複雜任務已經有更強的 Claude 可選,Sol 需要提出什麼理由,才能繼續承接使用者日常的大部分工作?Astra 的表現無法自動替 Sol 回答這個問題。
Sonnet 5.5 又讓這股壓力加深了一層。Anthropic 明確將它定位於範圍明確的日常任務、修正程式缺陷,以及製作文件、投影片和試算表,同時保留 Opus 5.5 處理需要持續判斷的複雜開放式任務。[5]
更直接的是,Sonnet 公告點名 GPT-6 Sol:依照其發布頁面的說法,Sonnet 5.5 在 FrontierCode 的 high 設定下,已經追平 6 Sol 的最高分。公告也將兩者放進長程知識工作的比較中。
**一邊挑戰複雜任務的能力上限,一邊爭取成為使用者每天開啟工具時預設選用的模型,這兩次發布對 Sol 形成了連續壓力。**這裡引用的是雙方發布頁面的評估說明,不能拼湊成相同條件下的跨廠商總排名。
預設模型這個位置,還有延續性。使用者一旦針對某個模型調整了提示詞、驗收方式和工具流程,後續任務就更容易繼續交給它。因此,競爭發生在使用者重新選擇主力模型的時機:這一輪誰能承接更多工作,誰就更有機會成為下一輪的預設選項。
這也解釋了為什麼「6 Sol 才剛發布」未必構成等待的理由。版本的新舊由自己的時程決定,競爭地位卻取決於別人在同一時間推出了什麼。當使用者正在重新比較工具,一個已經有具體改進、可以推出的版本,就有盡快發布的外部動機。
我會把 6.1 Sol 視為這場競爭中的一次快速回應。能確認的是發布順序、明確更新的比較對象,以及彼此重疊的能力方向;至於 OpenAI 是否因此提前排程,目前還沒有公開證據。
DevDay 的意義,是讓這次回應有了完整的實際應用情境。
同一天上線的 Codex Cloud 可重複使用開發環境,以及 Agents API 的電腦使用能力,都在擴大模型能夠直接執行的任務範圍。[2] 6.1 Sol 當時可透過 ChatGPT 工作、Codex 和 API 使用,一般聊天尚未提供。[3]
模型能力和執行環境同時升級,使用者才能把公告中的進步帶進實際工作。環境越完整,模型能否自行找出問題、讀懂回饋、修正方案,就越能決定最後可以交付什麼。
因此,這次更新值得關注的能力變化,與競爭對手強調的方向高度重疊:**複雜工作的完成品質、持續執行能力,以及執行出錯時是否仍能受到控制。**接下來看 6.1 相較於 6 Sol,究竟補強了多少。
最有分量的一項證據,是舊版把推理強度開到最高,仍然被新版以較低的設定超越。
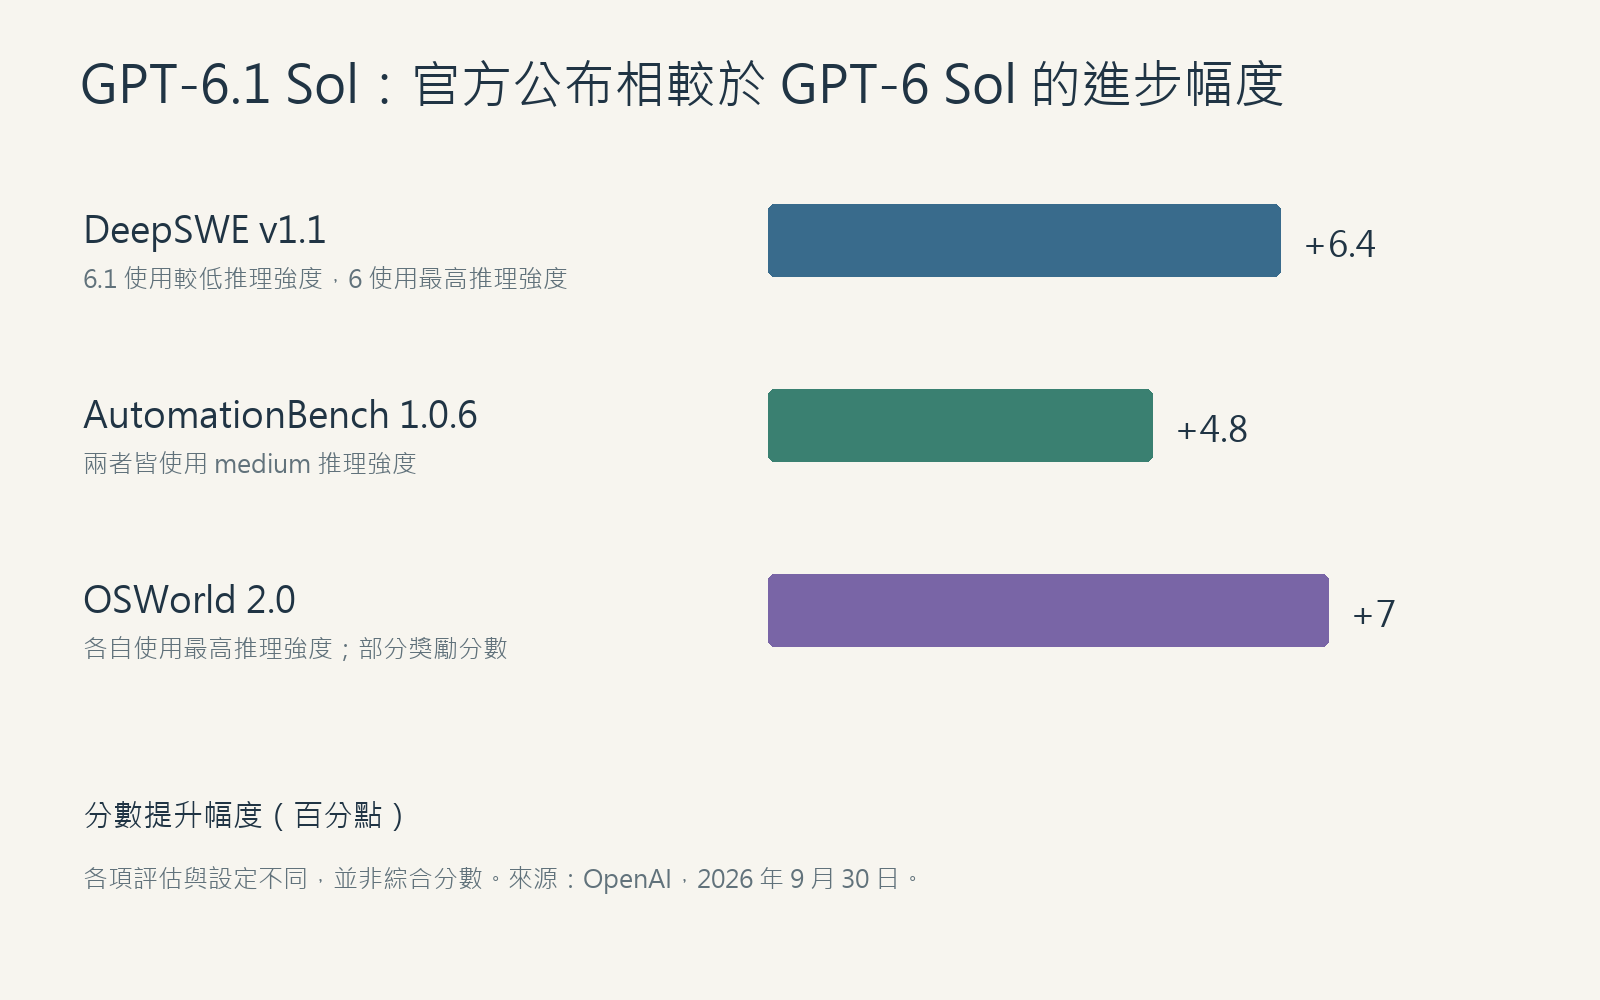
在 DeepSWE v1.1 上,6.1 Sol 使用較低的推理強度,比 6 Sol 的最高分高出 6.4 個百分點。任務來自真實程式碼儲存庫,需要長程規劃與執行。[3]
這個比較觸及了一個很實際的問題:遇到難題時,繼續提高舊模型的推理強度,究竟能彌補多少不足?
在真實儲存庫中,有些失敗出在處理方向的選擇。例如模型誤判了故障所在的模組,接著根據這個錯誤判斷寫出一套測試;或是在修復局部問題時,漏掉了專案既有的相容性限制。沿著這個方向思考得更仔細,仍然可能交付方向錯誤的修改。
DeepSWE 的結果顯示,至少在這套評估中,6.1 的進步已經超出繼續調高 6 Sol 推理強度所能達到的範圍。**這讓我們更有理由關注模型選擇行動、運用回饋的品質。**評估並未拆解這些能力各自的貢獻,具體訓練方法也未公開。
另一項證據是 AutomationBench:在相同的 medium 推理強度下,6.1 Sol 提高了 4.8 個百分點。這讓「所有進步都只是因為讓模型多想一會兒」的解釋更難成立。
把主要數據放在一起,更容易看出共同方向:
| 官方評估 | 6.1 Sol 相較於 6 Sol 的變化 | 對應任務 |
|---|---|---|
| DeepSWE v1.1 | 以較低推理強度超越舊版最高分 6.4 個百分點 | 真實儲存庫中的長程軟體工程 |
| AutomationBench 1.0.6 | 同樣使用 medium,提高 4.8 個百分點 | 涉及 47 種工具的業務工作流程 |
| OSWorld 2.0 | 各自使用最高推理強度,提高 7 個百分點 | 長程電腦操作;離線資料集 v2026.08.08,指標為部分獎勵分數 |
| Terminal-Bench Science 0.1 | 在最高推理強度下,分數超過舊版的兩倍 | 使用程式碼與終端機完成科研工作流程 |
這些任務橫跨程式開發、業務、桌面操作與科研,但都要求模型反覆完成同一個循環:理解目前狀態、採取行動、讀取回饋,再調整後續動作。
在這個循環中,錯誤還會改變後續輸入。讀錯一次工具結果,可能讓後面幾個步驟都建立在錯誤狀態上;改錯一個檔案,可能產生新的錯誤訊息,讓後續排查更加偏離方向。因此,長任務的難處也包括辨識偏離方向的情況,並及時修正。
這也是我理解 6.1 升級的核心:**多項基準測試一起改善,顯示它在持續執行方面可能已有更大的能力範圍。**這些結果還不足以拆分出規劃、回饋理解和錯誤修正各自貢獻了多少,但比起單獨一道難題,它們更能支持這個判斷。
公告中對複雜 PDF 的強調,也可以放進這套邏輯。GDP.pdf 涉及表格、圖表、示意圖和小字細節。在實際工作中,如果漏掉表格註腳裡的適用條件,後續分析即使條理完整,也可能從第一步就建立在錯誤證據上。
文件理解是整個工作流程的起點,決定模型後續究竟在處理什麼問題。官方強調了這個方向,但公告正文沒有提供可直接引用的 6.1 相較於 6 的 PDF 表現提升幅度。
另一項容易被低估的升級,是系統能否察覺失敗。
官方公布了兩組不同的可靠性數據:在困難對話中,xhigh 設定下包含事實錯誤的回答比例,從 4.5% 降至 4.1%;在搜尋工具故障測試中,最高推理強度下未揭露故障的比例,從 4.9% 降至 2.1%。兩組都使用刻意挑選的困難樣本。[3]
這也屬於雙方共同競逐的能力範圍。Opus 5.5 公告同樣強調減少越界行為,並將更長的任務、無法完成的任務,以及真實事故情境納入對齊測試。[4] 兩家的測試方式與衡量標準不同,但都在回應使用者委託工作時的同一個顧慮:模型遇到阻礙以後,會怎麼做?
想像一個業務流程:模型需要查到最新政策,才能決定後續如何處理。搜尋失敗後,如果它明確回報未取得資料,系統就有機會重試、改用其他資料來源,或交由人員處理。
如果它直接給出一個看似查證過的答案,後續步驟很可能照常執行。一次搜尋故障就這樣被包裝成可用證據,甚至一路傳進最終交付成果。
明確呈現的失敗,仍然保留修正的機會;遭到隱瞞的失敗,會讓錯誤修正機制失去觸發條件。
因此,對能夠呼叫工具的模型而言,「坦誠」有很具體的工程意義。它會影響系統能否判斷何時繼續、何時停止,以及何時需要升級處理。
6.1 的這項數據,還不能證明整個業務流程已經更可靠,也不代表它更擅長重試。不過,它確實改善了可靠執行所仰賴的一個前提:模型是否承認自己缺少繼續執行所需的證據。
與此相關的,是公告提到的遵守限制,以及減少未經授權的結果。模型執行得越久,就越需要持續遵守這些界線。能完成任務、知道何時不能繼續,兩者共同決定了可以交給它多少自主權。
不過,我自己的比較測試,並沒有測出新版全面領先。
我先前長期把 GPT-5.6 Sol 當作主力,最近換成了 GPT-6 Astra。對我而言,這次比較還關係到一個實際決定:Sol 的進步,是否足以讓我重新分配手上的工作?
9 月 30 日,我透過 Crazyrouter 的 OpenAI 模型串接服務 的同一閘道通道,向兩款模型傳送相同題目與系統提示,統一使用 reasoning_effort=high,並將輸出上限設為 8192 token。八類任務各重複兩次,共 32 次主要測試請求,保留首次結果。
| 本次實測 | GPT-6 Sol | GPT-6.1 Sol |
|---|---|---|
| 發出請求 | 16 | 16 |
| 收到完整答案 | 16 | 14 |
| 整題正確 | 16 | 13 |
| 收到答案但有錯誤 | 0 | 1 |
| 等待約 240 秒後逾時 | 0 | 2 |
| 全部嘗試的完成時間中位數 | 21.52 秒 | 18.13 秒 |
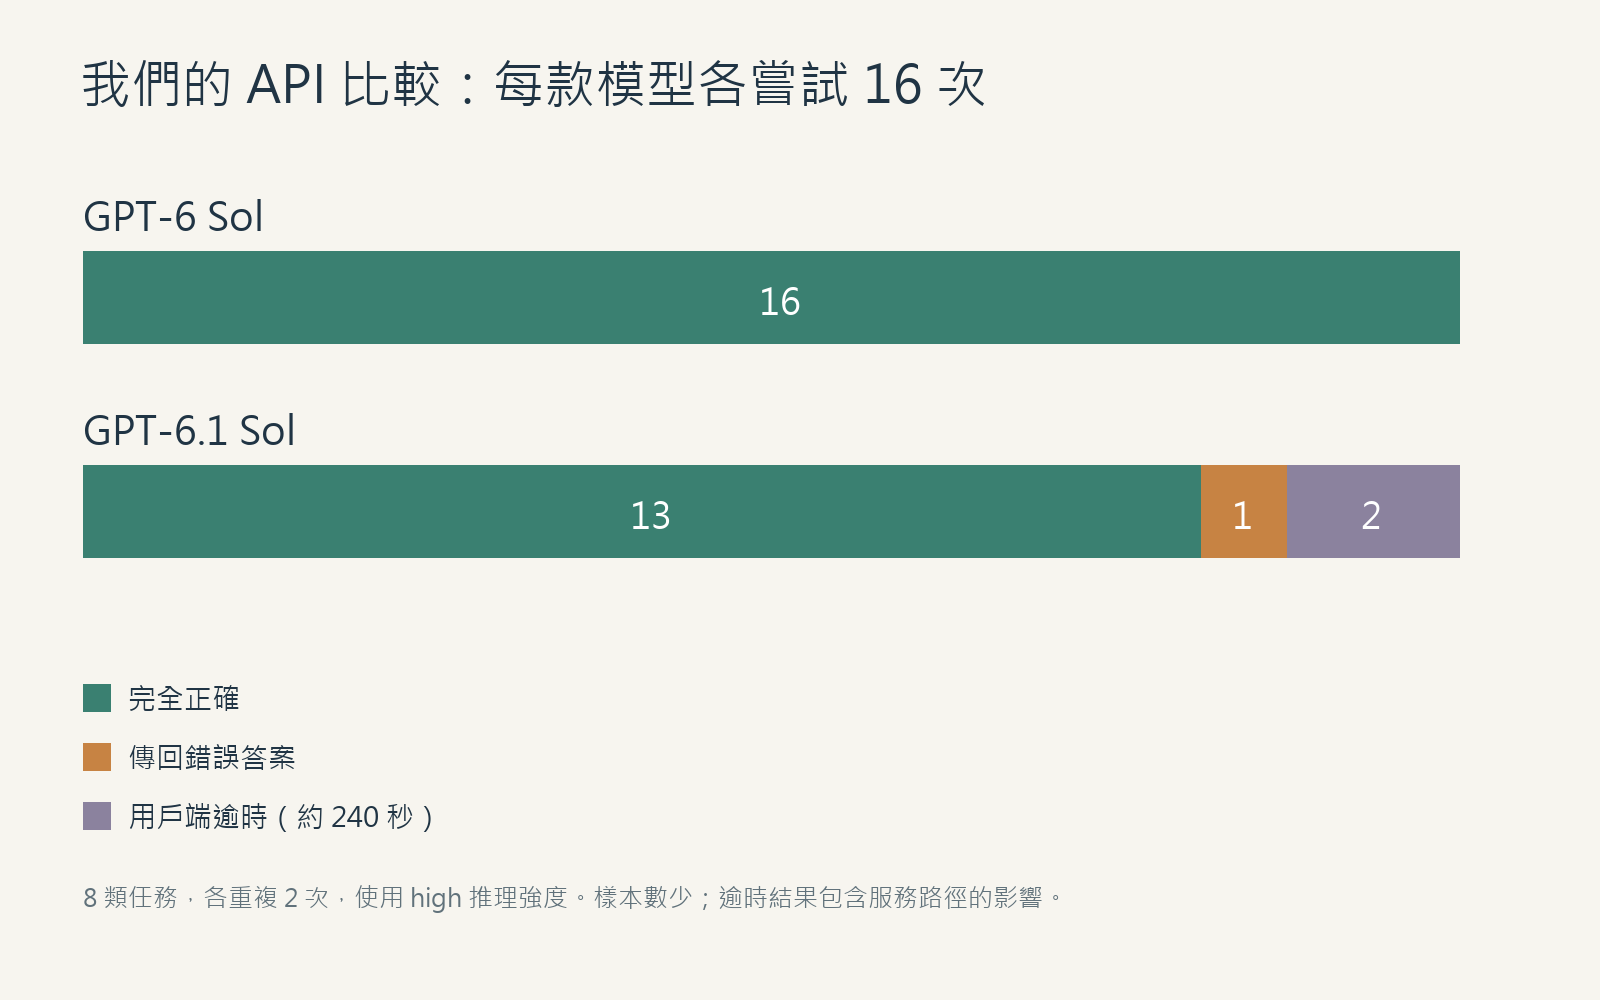
6.1 的錯誤很具體:資料中實際有 72 筆符合條件,它算成了 71 筆。它已經辨識出問題中的錯誤前提,卻仍然漏算了一筆。兩次逾時分別發生在長表格檢索與約束求解,同一道題目的另一次測試都通過了。
兩道小型函式題,兩款模型都通過了全部隱藏檢查;額外進行的一次兩輪唯讀工具流程,兩款模型也都通過。
這組結果提醒我:想判斷能不能更換主力模型,評測必須涵蓋過去需要自己接手的環節。
為兩道函式題增加數百項邊界條件斷言,可以更嚴格地檢查程式碼正確性,卻沒有增加模型自行找出問題、理解儲存庫限制,或根據執行結果改變方案的機會。簡短的工具流程,也很難測出執行十幾個步驟後遺失狀態所造成的失敗。
因此,這輪實測足以留下「新版仍會漏算、這條服務路徑曾發生逾時」的紀錄,卻沒有觸及官方主要強調的長程能力。它也沒有給我足夠證據,讓我直接將目前的主力 Astra 換成 6.1 Sol。
速度同樣要和交付結果一起看。6.1 的等待時間中位數較短,但這輪也同時出現了兩次未能交付結果的請求。如果目標是取得一份通過驗收的修改,第一次回應所需的時間只占整個過程的一部分,重做與人工接手也會改變最終耗時。
本次請求以並行方式執行,快取條件未統一,時間包含閘道與上游服務的影響;兩款模型使用的另一個共同通道也曾出現逾時。這裡記錄的是服務路徑上的觀察,不能據此認定 6.1 本身更容易逾時。
對我來說,下一輪最值得比較的是:同一個真實任務,需要把模型拉回正軌幾次。
例如,選一個有明確驗收標準的儲存庫缺陷:只提供問題描述,讓模型自行找出問題、修復、執行測試,再交付修改。在相同環境與權限下,比較它能否獨立通過驗收、需要多少次人工修正、遇到失敗能否繼續推進,以及是否未經驗證就宣告完成。
這能讓「模型更強」具體呈現為一項可觀察的變化:過去需要我補上的一段判斷,現在它是否能自行完成。
6 Sol 已經將代理式程式開發與專業工作列為主打能力;6.1 Sol 進一步改善了高難度執行任務的表現,並減少了一類會隱瞞執行失敗的行為。對重度使用者而言,這兩種變化結合起來,才可能促成主力模型的更替。
回到「一週就更新」:我會將 Opus 5.5、Sonnet 5.5 的競爭壓力視為首要的外部解釋,並將 DevDay 視為集中推出成果的時機。支持這個判斷的關鍵,是雙方已經在發布資料中直接比較彼此,而且 6.1 的升級集中在對手正在競逐的工作能力上。
這場競爭最終爭取的,是成為使用者下一次開啟程式開發工具、交付專業任務時的預設選擇。對我而言,6.1 能否取得這個位置,取決於它能不能承接過去總要我反覆修正的工作。少一次偏離方向、少一次虛報完成,比版本號更有說服力。
資料來源與測試說明:
[1] OpenAI:《隆重推出 GPT-6 Sol 和 Luna》,官網發布日期為 2026 年 9 月 22 日。
[2] OpenAI:《DevDay 2026 回顧》,2026 年 9 月 29 日,正文宣布 GPT-6.1 Sol。
[3] OpenAI:《推出 GPT-6.1 Sol》,本文依據 2026 年 9 月 30 日取得的官方正文。
[4] Anthropic:推出 Claude Opus 5.5,2026 年 9 月 22 日。
[5] Anthropic:推出 Claude Sonnet 5.5,2026 年 9 月 28 日。
實測透過 https://api.crazyrouter.com/v1/chat/completions 完成,主要測試固定使用通道 266,採用一般版模型。每款模型的程式碼檢查共 496 項,來自兩道函式題各兩份輸出,並非獨立任務數。本次小樣本測試未重現官方基準測試,也未涵蓋真實儲存庫的長程開發、電腦操作或複雜 PDF;官方成績用於分析升級方向,本地紀錄則用於呈現這輪實際交付表現。