 简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
GPT-6.1 Sol vs. GPT-6 Sol: Update nach nur einer Woche – welche Rolle spielt Claude 5.5?
GPT-6.1 Sol im Vergleich mit GPT-6 Sol: die Rolle von Claude 5.5, offizielle Fortschritte bei langen Aufgaben und meine API-Tests samt Grenzen.
GPT-6.1 Sol vs. GPT-6 Sol: Update nach nur einer Woche – welche Rolle spielt Claude 5.5?#
Eine Woche nach dem Start von GPT-6 Sol ist bereits GPT-6.1 Sol da. Wer diesen Rhythmus verstehen will, sollte sich meiner Ansicht nach zuerst die zeitgleichen Veröffentlichungen von Opus 5.5 und Sonnet 5.5 ansehen.
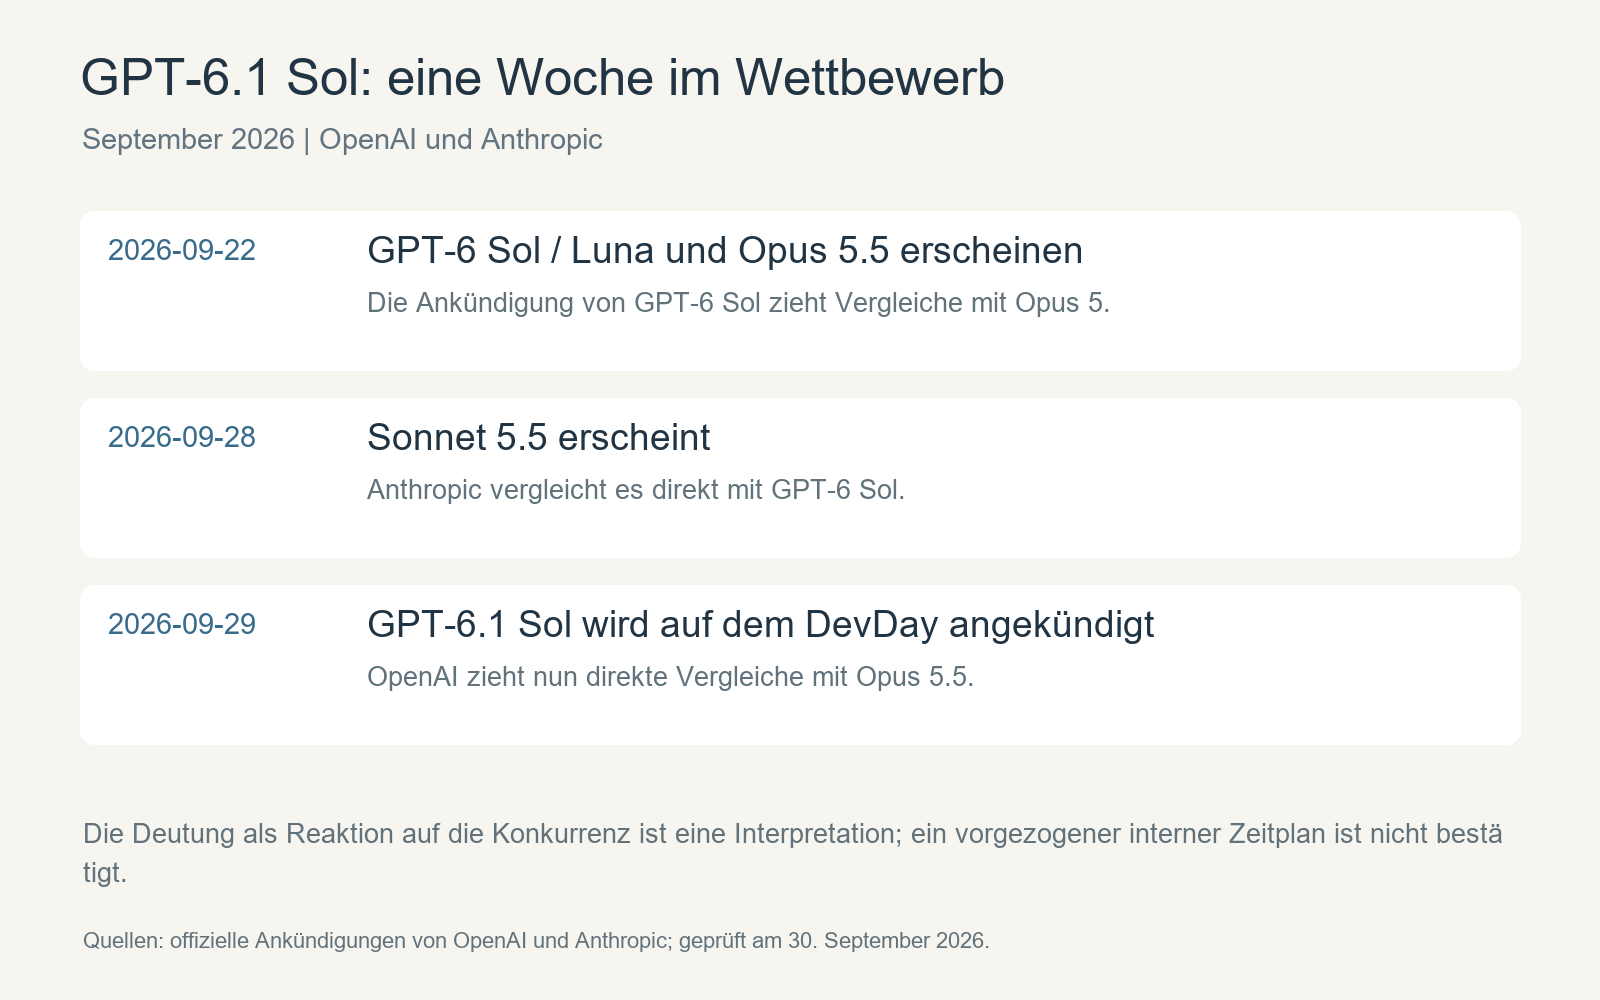
Stellt man die Veröffentlichungen beider Anbieter in einer gemeinsamen Zeitleiste gegenüber, wird die Konkurrenzsituation deutlich:
| Datum | Veröffentlichung |
|---|---|
| 22. September | OpenAI veröffentlicht GPT-6 Sol und Luna; Anthropic veröffentlicht Opus 5.5 |
| 28. September | Anthropic veröffentlicht Sonnet 5.5 |
| 29. September | OpenAI stellt GPT-6.1 Sol auf dem DevDay vor |
Die Daten stammen aus den offiziellen Ankündigungen beider Anbieter.[1][2][4][5] Zwischen den öffentlichen Veröffentlichungen von Sonnet 5.5 und 6.1 Sol liegt nur ein Tag.
Meine Einschätzung: Der Wettbewerbsdruck sollte bei der Einordnung dieses Veröffentlichungsrhythmus an erster Stelle stehen. Opus 5.5 hat die Messlatte für komplexe Arbeiten höher gelegt, während Sonnet 5.5 direkt um die Rolle als Alltagsmodell konkurriert, die auch Sol anstrebt. Der DevDay bot die Gelegenheit für eine gebündelte Antwort.
Für diese Einschätzung spricht neben der zeitlichen Nähe auch, dass sich die Vergleichsmodelle in den Ankündigungen beider Anbieter deutlich verändert haben.
Kaum war 6 Sol erschienen, stand schon die nächste Generation der Konkurrenz bereit.
In der Ankündigung von 6 Sol vom 22. September diente bei Bewertungen wie AutomationBench noch Opus 5 als Vergleich. In der Ankündigung von 6.1 Sol schreibt OpenAI bereits ausdrücklich, dass 6.1 Sol bei AutomationBench mit der Reasoning-Intensität medium um 2,2 Prozentpunkte über Opus 5.5 liegt. Bei GDP.pdf liegen die Ergebnisse in allen getesteten Reasoning-Einstellungen über denen von Opus 5.5 mit Fallback-Mechanismus.[1][3]
Die Veröffentlichungsmaterialien zu 6.1 beantworten damit bereits eine neue Frage: Bei welchen praktischen Arbeiten kann Sol gegenüber dem gerade erschienenen Claude noch Vorteile behaupten?
Auch der Druck durch Opus 5.5 lässt sich konkret benennen. Anthropic stellt große Codemigrationen, Aufgaben über mehrere Repositories hinweg, Fachanalysen und die autonome Ausführung über längere Zeit in den Mittelpunkt der Ankündigung. In mehreren Bewertungen zieht das Unternehmen direkte Vergleiche mit GPT-6 Astra.[4]
Für Sol entsteht daraus eine Frage der Positionierung: Wenn Nutzer für komplexe Aufgaben bereits ein stärkeres Claude zur Auswahl sehen, welche Argumente braucht Sol dann, damit sie ihm weiterhin den Großteil ihrer täglichen Arbeit anvertrauen? Astras Leistung beantwortet diese Frage nicht automatisch für Sol.
Sonnet 5.5 verstärkt diesen Druck noch einmal. Anthropic positioniert es ausdrücklich für klar abgegrenzte Alltagsaufgaben, das Beheben von Fehlern sowie das Erstellen von Dokumenten, Präsentationen und Tabellen. Opus 5.5 bleibt dabei für komplexe, offene Aufgaben vorgesehen, die fortlaufende Abwägungen erfordern.[5]
Noch direkter wird die Sonnet-Ankündigung, indem sie GPT-6 Sol ausdrücklich nennt: Laut der Veröffentlichungsseite erreicht Sonnet 5.5 bei FrontierCode mit der Einstellung high bereits den Höchstwert von 6 Sol. Außerdem vergleicht Anthropic beide Modelle bei Wissensarbeit über längere Abläufe hinweg.
Die eine Veröffentlichung greift die Leistungsspitze bei komplexen Aufgaben an, die andere konkurriert um das Modell, das Nutzer beim täglichen Öffnen ihrer Werkzeuge standardmäßig wählen. Zusammen setzen sie Sol anhaltend unter Druck. Die hier zitierten Bewertungsaussagen stammen aus den Veröffentlichungsseiten beider Anbieter. Sie lassen sich nicht zu einer anbieterübergreifenden Gesamtrangliste unter einheitlichen Bedingungen zusammenfügen.
Die Rolle als Standardmodell wirkt zudem über einzelne Aufgaben hinaus. Sobald Nutzer ihre Prompts, Abnahmekriterien und Werkzeugabläufe auf ein Modell abgestimmt haben, übergeben sie ihm eher auch die nächsten Aufgaben. Der Wettbewerb findet deshalb in dem Zeitfenster statt, in dem Nutzer ihr bevorzugtes Modell neu auswählen: Wer in dieser Runde mehr Arbeit übernehmen kann, hat bessere Chancen, in der nächsten Runde die Standardwahl zu sein.
Das erklärt auch, warum „6 Sol ist doch gerade erst erschienen“ nicht unbedingt ein Grund zum Warten ist. Wie neu eine Version ist, bestimmt der eigene Kalender. Die Wettbewerbsposition hängt dagegen davon ab, was andere zur selben Zeit liefern. Wenn Nutzer ihre Werkzeuge gerade neu vergleichen, besteht für eine Version, deren Verbesserungen bereits einsatzbereit sind, ein äußerer Anreiz zur zügigen Veröffentlichung.
Ich sehe 6.1 Sol als eine schnelle Reaktion in diesem Wettbewerb. Bestätigt sind die Reihenfolge der Veröffentlichungen, die ausdrücklich aktualisierten Vergleichsmodelle und die Überschneidungen bei den angestrebten Fähigkeiten. Ob OpenAI deshalb seinen internen Zeitplan vorgezogen hat, ist öffentlich nicht belegt.
Die Bedeutung des DevDay liegt darin, dass er dieser Antwort einen vollständigen Rahmen für den praktischen Einsatz gab.
Die am selben Tag eingeführten wiederverwendbaren Entwicklungsumgebungen von Codex Cloud und die Computerbedienung über die Agents API erweitern beide das Spektrum der Aufgaben, die Modelle direkt ausführen können.[2] 6.1 Sol war für die Arbeit in ChatGPT, in Codex und über die API zugänglich; im gewöhnlichen Chat stand es zu diesem Zeitpunkt noch nicht zur Verfügung.[3]
Erst wenn Modellfähigkeiten und Ausführungsumgebung gemeinsam weiterentwickelt werden, können Nutzer die angekündigten Fortschritte in ihre tatsächliche Arbeit übertragen. Je vollständiger die Umgebung ist, desto stärker hängt das Endergebnis davon ab, ob das Modell Probleme selbst lokalisieren, Rückmeldungen verstehen und seinen Lösungsweg korrigieren kann.
Die bemerkenswerten Veränderungen dieses Updates überschneiden sich deshalb stark mit den Schwerpunkten der Konkurrenz: die Qualität abgeschlossener komplexer Arbeiten, die Fähigkeit zur fortlaufenden Ausführung und die Frage, ob der Ablauf auch bei Ausführungsfehlern kontrollierbar bleibt. Sehen wir uns an, wie viel 6.1 gegenüber 6 Sol tatsächlich hinzugewonnen hat.
Einer der aussagekräftigsten Befunde: Selbst mit maximaler Reasoning-Intensität bleibt die alte Version hinter einer niedrigeren Stufe der neuen zurück.
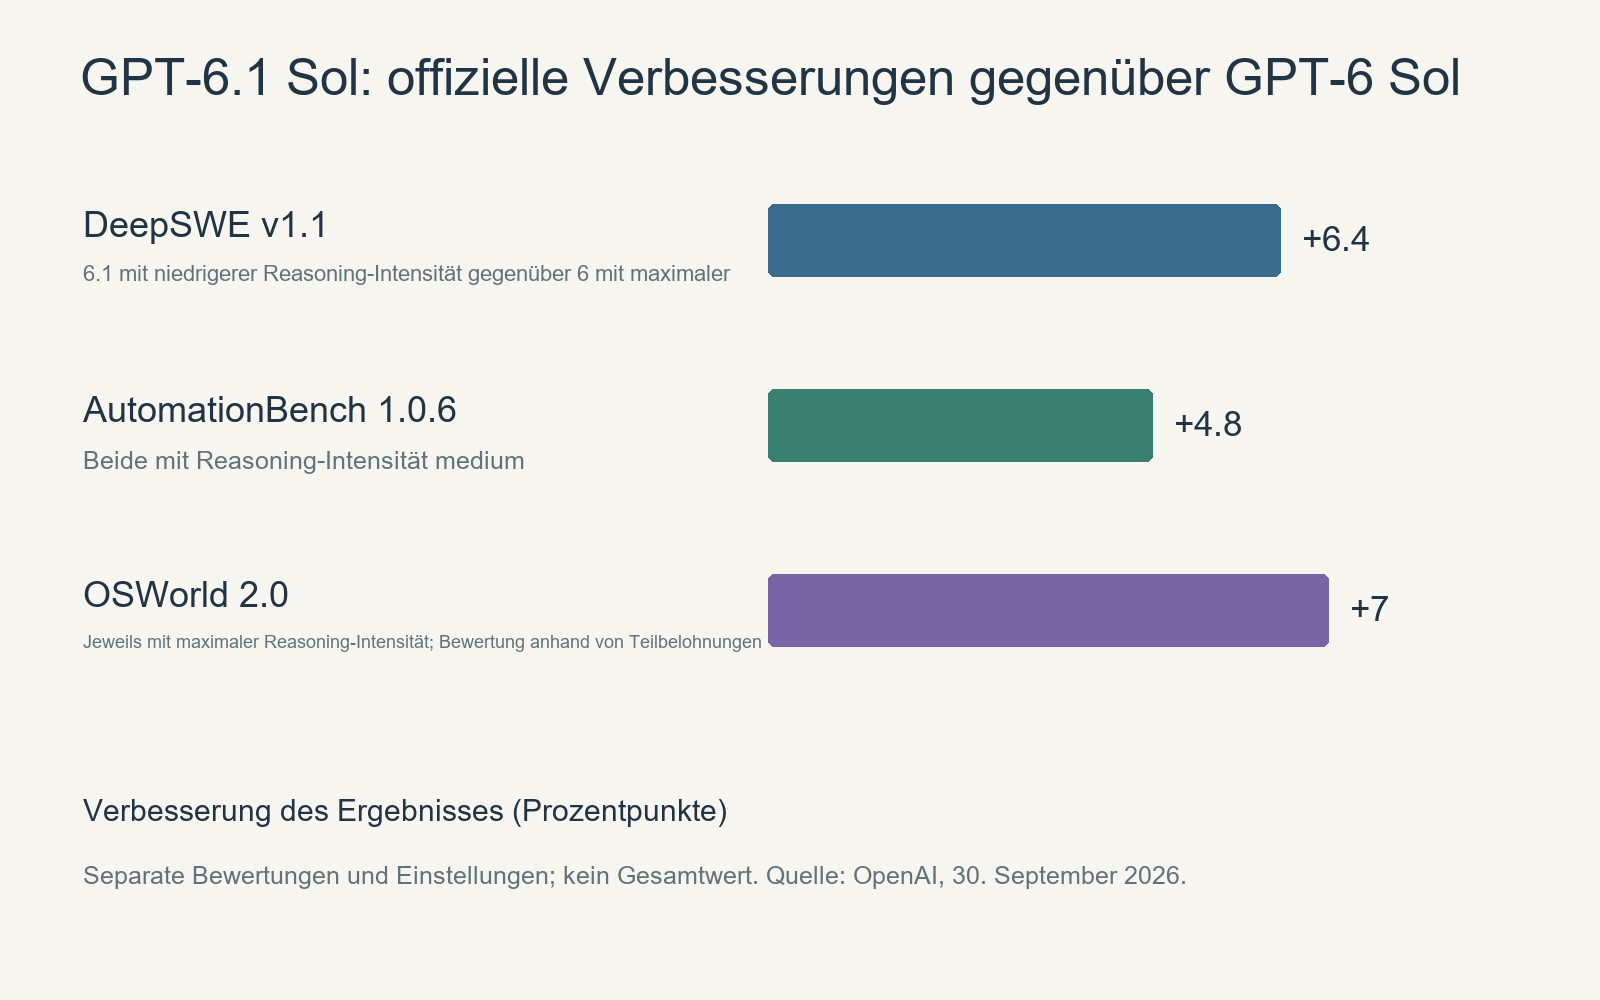
Bei DeepSWE v1.1 liegt 6.1 Sol mit einer niedrigeren Reasoning-Intensität um 6,4 Prozentpunkte über dem Höchstwert von 6 Sol. Die Aufgaben stammen aus realen Code-Repositories und erfordern Planung und Ausführung über längere Abläufe hinweg.[3]
Dieser Vergleich berührt eine sehr praktische Frage: Wie viel lässt sich bei schwierigen Aufgaben noch herausholen, indem man die Reasoning-Intensität des alten Modells weiter erhöht?
In realen Repositories scheitern manche Versuche bereits an der Wahl des Lösungswegs. Ein Modell kann etwa den Fehler im falschen Modul vermuten und anschließend Tests schreiben, die auf dieser Fehleinschätzung beruhen. Oder es behebt ein lokales Problem, übersieht dabei aber bestehende Kompatibilitätsvorgaben des Projekts. Auch wenn es diesen Weg noch gründlicher durchdenkt, kann am Ende eine Änderung stehen, die in die falsche Richtung geht.
Das Ergebnis von DeepSWE zeigt, dass der Zugewinn von 6.1 zumindest in dieser Bewertung über das hinausgeht, was durch eine weitere Erhöhung der Reasoning-Intensität von 6 Sol erreichbar war. Das gibt uns mehr Anlass, auf die Qualität der Handlungsauswahl und der Nutzung von Rückmeldungen zu achten. Welchen Anteil diese Fähigkeiten jeweils haben, wurde in der Bewertung nicht aufgeschlüsselt. Auch die konkreten Trainingsmethoden wurden nicht offengelegt.
Ein weiterer Befund kommt von AutomationBench: Bei derselben Reasoning-Intensität medium verbessert sich 6.1 Sol um 4,8 Prozentpunkte. Die Erklärung, sämtliche Fortschritte entstünden lediglich dadurch, dass das Modell länger nachdenkt, wird damit weniger plausibel.
Stellt man die wichtigsten Daten nebeneinander, lässt sich ihre gemeinsame Richtung leichter erkennen:
| Offizielle Bewertung | Veränderung von 6.1 Sol gegenüber 6 Sol | Zugehörige Aufgaben |
|---|---|---|
| DeepSWE v1.1 | Mit niedrigerer Reasoning-Intensität um 6,4 Prozentpunkte über dem Höchstwert der alten Version | Softwareentwicklung über längere Abläufe in realen Repositories |
| AutomationBench 1.0.6 | Bei derselben Einstellung medium um 4,8 Prozentpunkte höher | Geschäftsabläufe mit 47 verschiedenen Werkzeugen |
| OSWorld 2.0 | Bei jeweils maximaler Reasoning-Intensität um 7 Prozentpunkte höher | Computerbedienung über längere Abläufe; Offline-Datensatz v2026.08.08, bewertet anhand von Teilbelohnungen |
| Terminal-Bench Science 0.1 | Bei maximaler Reasoning-Intensität mehr als doppelt so hoher Wert wie die alte Version | Wissenschaftliche Arbeitsabläufe mit Code und Terminal |
Diese Aufgaben reichen von Programmierung und Geschäftsprozessen bis zu Desktopbedienung und Forschung. Sie alle verlangen aber, dass das Modell denselben Kreislauf wiederholt durchläuft: den aktuellen Zustand verstehen, handeln, Rückmeldungen auswerten und die nächsten Schritte entsprechend anpassen.
In diesem Kreislauf verändern Fehler auch die nachfolgenden Eingaben. Wird ein Werkzeugergebnis einmal falsch gelesen, können die nächsten Schritte auf einem falschen Zustandsbild beruhen. Eine Änderung an der falschen Datei kann neue Fehlermeldungen erzeugen und die Fehlersuche noch weiter vom Ziel wegführen. Zu den Schwierigkeiten langer Aufgaben gehört deshalb auch, Abweichungen vom richtigen Weg zu erkennen und rechtzeitig zu korrigieren.
Darin liegt für mich der Kern des Updates auf 6.1: Dass sich mehrere Benchmarks gemeinsam verbessern, deutet darauf hin, dass sich die Leistungsgrenzen des Modells bei der fortlaufenden Ausführung erweitert haben. Die Ergebnisse reichen noch nicht aus, um den jeweiligen Beitrag von Planung, dem Verständnis von Rückmeldungen und Fehlerkorrektur zu bestimmen. Sie stützen diese Einschätzung aber stärker als eine einzelne schwierige Aufgabe.
Auch die Betonung komplexer PDFs in der Ankündigung passt in diesen Zusammenhang. GDP.pdf umfasst Tabellen, Diagramme, Schaubilder und kleingedruckte Details. Übersieht das Modell in der praktischen Arbeit eine Geltungsbedingung in einer Tabellenfußnote, kann die nachfolgende Analyse trotz schlüssiger Gliederung von Anfang an auf einer falschen Beleggrundlage stehen.
Das Dokumentenverständnis steht am Anfang der gesamten Arbeitskette. Es bestimmt, mit welchem Problem sich das Modell anschließend überhaupt befasst. OpenAI betont diesen Bereich, nennt im Haupttext aber kein direkt zitierbares Maß für die Verbesserung von 6.1 gegenüber 6 bei PDFs.
Ein weiterer leicht unterschätzter Fortschritt betrifft die Frage, ob das System einen Fehlschlag überhaupt erkennen kann.
OpenAI veröffentlicht zwei unterschiedliche Datensätze zur Zuverlässigkeit: In schwierigen Gesprächen sinkt bei xhigh der Anteil der Antworten mit sachlichen Fehlern von 4,5 % auf 4,1 %. In Tests mit Ausfällen des Suchwerkzeugs sinkt bei maximaler Reasoning-Intensität der Anteil der nicht offengelegten Ausfälle von 4,9 % auf 2,1 %. Beide Tests verwenden gezielt ausgewählte schwierige Fälle.[3]
Auch dieser Bereich gehört zu den Fähigkeiten, um die beide Anbieter konkurrieren. Die Ankündigung von Opus 5.5 betont ebenfalls die Verringerung von Grenzüberschreitungen und bezieht längere Aufgaben, nicht lösbare Aufgaben und Szenarien realer Vorfälle in die Alignment-Tests ein.[4] Die Testansätze der beiden Anbieter unterscheiden sich. Beide greifen jedoch dieselbe Sorge auf, die Nutzer beim Delegieren von Arbeit haben: Wie verhält sich das Modell, wenn es auf Hindernisse stößt?
Man stelle sich einen Geschäftsprozess vor, bei dem das Modell aktuelle Richtlinien recherchieren muss, um über die weitere Bearbeitung zu entscheiden. Schlägt die Suche fehl und meldet das Modell ausdrücklich, dass es die Informationen nicht beschaffen konnte, kann das System einen neuen Versuch starten, eine andere Datenquelle verwenden oder die Aufgabe an einen Menschen übergeben.
Liefert es dagegen direkt eine Antwort, die wie überprüft wirkt, werden die nachfolgenden Schritte möglicherweise ganz normal ausgeführt. Ein Suchausfall wird so als brauchbarer Beleg ausgegeben und kann sich bis in das endgültige Arbeitsergebnis fortpflanzen.
Ein klar offengelegter Fehlschlag lässt weiterhin eine Korrektur zu. Ein verdeckter Fehlschlag nimmt dem Korrekturmechanismus seinen Auslöser.
Für Modelle, die Werkzeuge aufrufen können, hat „Ehrlichkeit“ deshalb eine sehr konkrete technische Bedeutung. Sie beeinflusst, ob das System erkennen kann, wann es fortfahren, wann es anhalten und wann es den Fall zur weiteren Bearbeitung eskalieren muss.
Dieser Wert für 6.1 beweist noch nicht, dass der gesamte Geschäftsprozess zuverlässiger geworden ist. Er bedeutet auch nicht, dass das Modell besser mit Wiederholungsversuchen umgeht. Verbessert hat sich aber eine Voraussetzung für zuverlässige Ausführung: ob das Modell zugibt, dass ihm die für die Fortsetzung nötigen Belege fehlen.
Damit verbunden sind die in der Ankündigung erwähnte Einhaltung von Einschränkungen und die Verringerung nicht autorisierter Ergebnisse. Je länger ein Modell eine Aufgabe ausführt, desto wichtiger ist es, dass es diese Grenzen durchgehend wahrt. Ob es Aufgaben abschließen kann und ob es erkennt, wann es nicht weiterarbeiten darf, bestimmt gemeinsam, wie viel Autonomie man ihm geben kann.
Mein eigener Vergleichstest ergab allerdings keinen durchgängigen Vorsprung der neuen Version.
Ich habe zuvor lange hauptsächlich mit GPT-5.6 Sol gearbeitet und bin vor Kurzem zu GPT-6 Astra gewechselt. Für mich hängt an diesem Vergleich deshalb auch eine praktische Entscheidung: Sind die Fortschritte von Sol groß genug, um meine Aufgaben neu zwischen den Modellen zu verteilen?
Am 30. September habe ich beiden Modellen über denselben Gateway-Kanal des OpenAI-Modellzugangs von Crazyrouter identische Aufgaben und System-Prompts geschickt. Einheitlich eingestellt waren reasoning_effort=high und eine Ausgabegrenze von 8192 Token. Acht Aufgabentypen wurden jeweils zweimal ausgeführt, insgesamt also 32 Hauptanfragen. Festgehalten wurde jeweils das erste Ergebnis.
| Ergebnisse dieses Tests | GPT-6 Sol | GPT-6.1 Sol |
|---|---|---|
| Gestellte Anfragen | 16 | 16 |
| Vollständige Antworten erhalten | 16 | 14 |
| Aufgabe vollständig korrekt gelöst | 16 | 13 |
| Antwort erhalten, aber mit Fehlern | 0 | 1 |
| Timeout nach etwa 240 Sekunden Wartezeit | 0 | 2 |
| Mediane Abschlusszeit über alle Versuche | 21,52 Sekunden | 18,13 Sekunden |
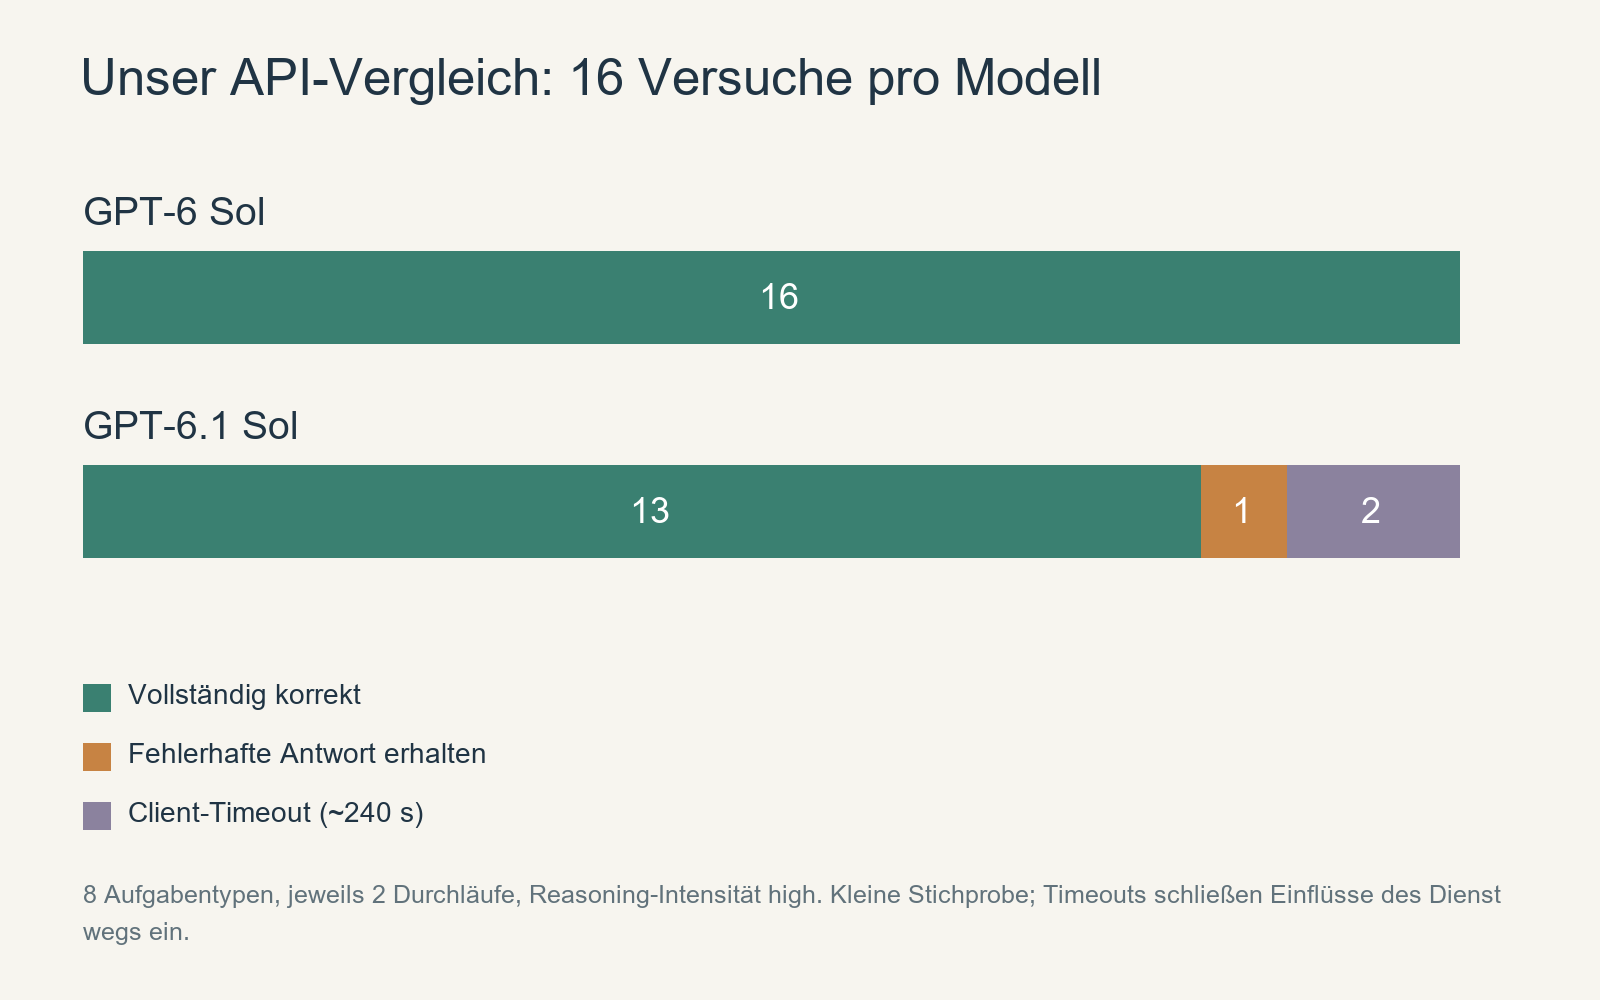
Der Fehler von 6.1 war sehr konkret: Im Material erfüllten tatsächlich 72 Einträge die Bedingungen, das Modell zählte jedoch nur 71. Es hatte die falsche Prämisse in der Frage bereits erkannt, übersah beim Zählen aber trotzdem einen Eintrag. Die beiden Timeouts traten bei der Suche in einer langen Tabelle und beim Lösen eines Problems mit Nebenbedingungen auf. Der jeweils andere Durchlauf derselben Aufgabe war erfolgreich.
Bei zwei kleinen Funktionsaufgaben bestanden beide Modelle sämtliche verdeckten Prüfungen. Auch einen zusätzlichen zweirundigen Werkzeugablauf mit ausschließlich lesenden Zugriffen bestanden beide.
Diese Ergebnisse erinnern mich an einen entscheidenden Punkt: Wer beurteilen will, ob ein Wechsel des hauptsächlich genutzten Modells sinnvoll ist, muss in seinen Tests die Schritte abdecken, bei denen er bisher selbst eingreifen musste.
Ergänzt man die beiden Funktionsaufgaben um Hunderte Assertions für Grenzfälle, prüft man die Korrektheit des Codes strenger. Das schafft aber keine zusätzlichen Gelegenheiten, bei denen das Modell Probleme selbst lokalisieren, Vorgaben des Repositories verstehen oder seinen Lösungsweg anhand von Ausführungsergebnissen ändern muss. Auch ein kurzer Werkzeugablauf kann kaum zeigen, ob ein Modell nach einem Dutzend oder mehr Schritten den Zustand aus dem Blick verliert.
Dieser Test reicht deshalb aus, um festzuhalten, dass auch die neue Version noch Einträge übersehen kann und dass es auf diesem Dienstweg Timeouts gab. Die von OpenAI hauptsächlich betonten Fähigkeiten über längere Abläufe hinweg hat er jedoch nicht erfasst. Er liefert mir auch nicht genügend Belege, um mein derzeitiges Hauptmodell Astra unmittelbar durch 6.1 Sol zu ersetzen.
Auch die Geschwindigkeit muss zusammen mit den gelieferten Ergebnissen betrachtet werden. Die mediane Wartezeit war bei 6.1 kürzer, zugleich blieben in dieser Runde aber zwei Anfragen ohne Ergebnis. Wenn das Ziel eine Änderung ist, die die Abnahme besteht, macht die Zeit bis zur ersten Antwort nur einen Teil des gesamten Ablaufs aus. Nacharbeit und die Übernahme durch einen Menschen verändern ebenfalls die Gesamtdauer.
Die Anfragen liefen parallel, und die Cache-Bedingungen waren nicht vereinheitlicht. Die gemessenen Zeiten enthalten Einflüsse des Gateways und der vorgelagerten Dienste. Auch über einen weiteren, für beide Modelle verwendeten Kanal traten Timeouts auf. Hier werden Beobachtungen entlang des Dienstwegs dokumentiert. Daraus lässt sich nicht ableiten, dass 6.1 selbst anfälliger für Timeouts ist.
Für mich lautet die interessanteste Vergleichsfrage für die nächste Runde: Wie oft muss ich das Modell bei derselben realen Aufgabe wieder auf den richtigen Weg bringen?
Dafür eignet sich etwa ein Fehler in einem Repository mit klaren Abnahmekriterien: Das Modell erhält nur die Problembeschreibung und soll den Fehler selbst lokalisieren, beheben, Tests ausführen und anschließend die Änderung liefern. Bei gleicher Umgebung und gleichen Berechtigungen lässt sich vergleichen, ob es die Abnahme selbstständig besteht, wie viele menschliche Korrekturen nötig sind, ob es nach Fehlschlägen weiterkommt und ob es den Abschluss meldet, ohne das Ergebnis überprüft zu haben.
So wird aus „das Modell ist leistungsfähiger“ eine beobachtbare Veränderung: Kann es eine Entscheidung, die ich bisher selbst ergänzen musste, nun eigenständig treffen?
Schon 6 Sol stellte agentisches Programmieren und professionelle Arbeit als Kernfähigkeiten heraus. 6.1 Sol verbessert die Leistung bei schwierigen Ausführungsaufgaben weiter und reduziert eine Verhaltensweise, die Ausführungsfehler verdecken kann. Für intensive Nutzer könnte erst die Verbindung dieser beiden Veränderungen einen Wechsel des Hauptmodells rechtfertigen.
Zurück zum „Update nach nur einer Woche“: Ich sehe den Wettbewerbsdruck durch Opus 5.5 und Sonnet 5.5 als wichtigste externe Erklärung und den DevDay als Gelegenheit, die Neuerungen gebündelt bereitzustellen. Entscheidend für diese Einschätzung ist, dass beide Anbieter sich in ihren Veröffentlichungsmaterialien bereits direkt miteinander vergleichen und dass die Fortschritte von 6.1 genau auf jene Arbeitsfähigkeiten konzentriert sind, um die die Konkurrenz gerade wirbt.
Letztlich geht es in diesem Wettbewerb darum, welches Modell Nutzer standardmäßig wählen, wenn sie das nächste Mal ihr Programmierwerkzeug öffnen oder eine Fachaufgabe delegieren. Ob 6.1 diesen Platz bei mir einnehmen kann, hängt davon ab, ob es die Arbeiten bewältigt, bei denen ich bisher immer wieder korrigieren musste. Einmal weniger vom richtigen Weg abzukommen oder einen Abschluss fälschlich zu melden, überzeugt mich mehr als eine Versionsnummer.
Quellen und Hinweise zum Test:
[1] OpenAI: „Vorstellung von GPT-6 Sol und Luna“, auf der offiziellen Website mit dem Veröffentlichungsdatum 22. September 2026 angegeben.
[2] OpenAI: „DevDay 2026 im Rückblick“, 29. September 2026. Im Text wird GPT-6.1 Sol angekündigt.
[3] OpenAI: „Vorstellung von GPT-6.1 Sol“. Dieser Artikel stützt sich auf den am 30. September 2026 abgerufenen offiziellen Text.
[4] Anthropic: „Vorstellung von Claude Opus 5.5“, 22. September 2026.
[5] Anthropic: „Vorstellung von Claude Sonnet 5.5“, 28. September 2026.
Die Tests wurden über https://api.crazyrouter.com/v1/chat/completions durchgeführt. Für den Haupttest war Kanal 266 fest eingestellt; verwendet wurden die Standardversionen der Modelle. Pro Modell gab es insgesamt 496 Codeprüfungen. Diese bezogen sich auf jeweils zwei Ausgaben zu zwei Funktionsaufgaben und entsprechen nicht der Zahl unabhängiger Aufgaben. Diese kleine Stichprobe hat die offiziellen Benchmarks nicht reproduziert und weder längere Entwicklungsarbeiten in realen Repositories noch Computerbedienung oder komplexe PDFs abgedeckt. Die offiziellen Ergebnisse dienen der Analyse der Entwicklungsrichtung; die lokalen Aufzeichnungen zeigen, welche Ergebnisse in dieser Testrunde tatsächlich geliefert wurden.