 中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
JEV 1.13 verwenden: Von Support-Triage bis Agent-Routing
JEV 1.13 macht aus natürlicher Sprache Entscheidungen, Wahrscheinlichkeiten und Scores. Praxisbeispiele erklären Choice, Noul und Score. Im Crazyrouter JEV Decision Playground lassen sich 12 Szenarien testen und API-Code kopieren.
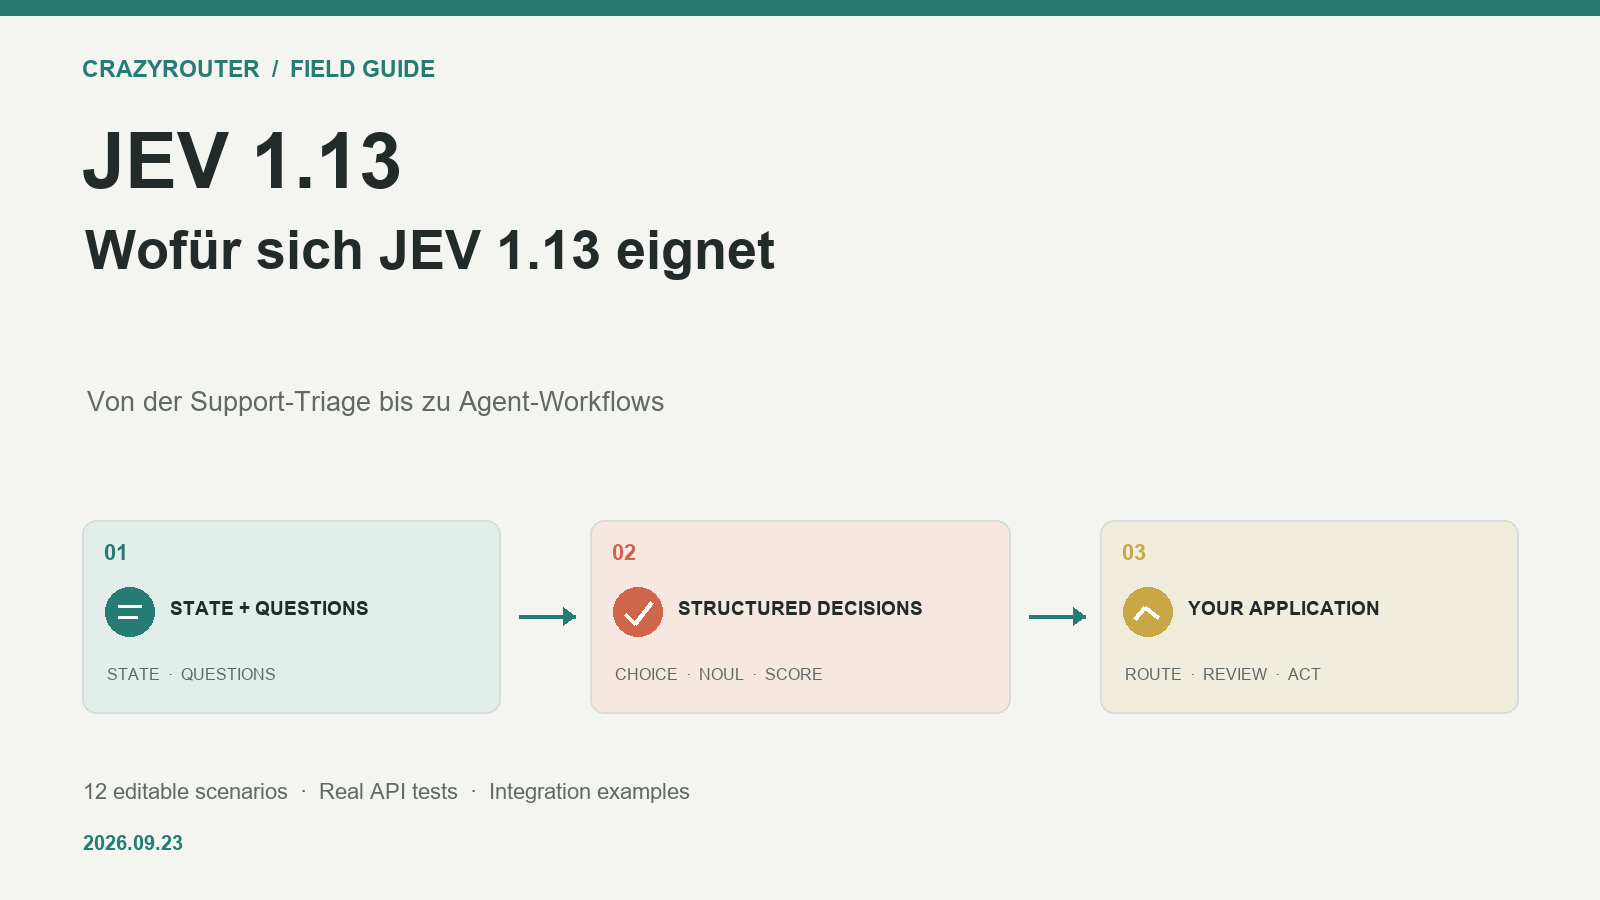
Wie verwendet man JEV 1.13? Von der Kundenservice-Verteilung bis zum Agent-Routing: Dieses kostengünstige Entscheidungsmodell im Praxistest#
„Der Kunde sagt, dass die Zahlung nicht funktioniert und der Betrieb bereits beeinträchtigt ist. An wen soll dieses Ticket weitergeleitet werden? Wie dringend ist es? Wie ist die Stimmung des Kunden?“
Das ist eine typische kleine Aufgabe in einem KI-Produkt. Am Ende benötigst du möglicherweise nur drei Felder: technical, eine Dringlichkeitswahrscheinlichkeit und eine Stimmungsbewertung. Diese Felder bestimmen, in welche Warteschlange das Ticket gelangt, an welcher Position es eingeordnet wird und ob es vorrangig von einem Menschen bearbeitet werden muss.
JEV 1.13 ist besonders gut für solche klar abgegrenzten Einschätzungen geeignet. Du gibst dem Modell den Kontext und die Bewertungskriterien vor, und es liefert eine Auswahl, Wahrscheinlichkeit oder Bewertung zurück, die von einem Programm direkt verarbeitet werden kann.
In letzter Zeit wurde viel über JEV berichtet: Manche Beiträge erklären „System One“, andere stellen die niedrigen Kosten und die schnelle Entscheidungsfindung heraus, wieder andere integrieren das Modell in Agent-Workflows. Für alle, die einsteigen möchten, ist vor allem eines wichtig: Welche Aufgaben kann JEV übernehmen, und wie lässt sich überprüfen, ob es tatsächlich zum eigenen Anwendungsfall passt?
Dieser Artikel erklärt zunächst das Modell. Danach öffnest du das [Crazyrouter JEV Decision Playground]playground und probierst es praktisch aus. Zum Schluss folgen direkt verwendbare Python-Beispiele. Die Tests in diesem Artikel wurden am 23. September 2026 über Crazyrouter durchgeführt; sowohl erfolgreiche Anfragen als auch Zeitüberschreitungen wurden dokumentiert.
Was ist JEV 1.13? Drei Ausgabewerte, die du dir merken solltest#
JEV ist ein Entscheidungsmodell von TypeSafe AI. Der Anbieter bezeichnet diese Modellklasse als System One Models: Sie lesen den aktuellen Zustand ein, führen schnell Klassifizierungen, Einschätzungen und Bewertungen durch und liefern Software eine ausführbare Entscheidungsgrundlage.
Die Eingabe besteht im Wesentlichen aus zwei Teilen:
state: die Fakten zum Kontext. Das kann eine Kundenservicenachricht, ein Dokument oder auch ein JSON-Objekt mit dem Bestellstatus sein.questions: die Fragen, die du bewerten lassen möchtest. Jede Frage legt den Typ, die Bewertungserklärung sowie gegebenenfalls die erforderlichen Optionen oder Bewertungskriterien fest.
Die drei wichtigsten Fragetypen sind:
| Typ | Wofür geeignet? | Rückgabe | Typische Verwendung |
|---|---|---|---|
| Choice | Welche Option soll ausgewählt werden? | Option, Wahrscheinlichkeit für jede Option, confidence | Ticketklassifizierung, Toolauswahl, Anfrage-Routing |
| Noul | Trifft die Aussage zu? | Wahrscheinlichkeit für „Ja“, im Bereich 0–1 | Dringlichkeit, Relevanz, Eskalationsbedarf |
| Score | Welcher Bewertungsstufe entspricht die Eingabe nach den vorgegebenen Kriterien? | Numerische Bewertung, Wahrscheinlichkeiten der Stufen, confidence | Schweregrad, Inhaltsqualität, Lead-Passung |
Mehrere Fragen unterschiedlichen Typs können in derselben Anfrage enthalten sein. So kann ein Kundenserviceticket gleichzeitig darauf geprüft werden, welche Abteilung zuständig ist, ob es dringend ist und wie die Stimmung einzuschätzen ist. Die drei Ergebnisse können anschließend direkt vom Code verwendet werden.
JEV unterstützt derzeit Eingaben in Textform, einschließlich Objekten und Arrays, die aus Text bestehen. Bilder, Audio oder Video werden nicht direkt entgegengenommen. Aufgaben wie das Verfassen von Antworten und Artikeln oder das Erzeugen von Code werden weiterhin von generativen Modellen übernommen. Diese Abgrenzung der Fähigkeiten wird in der System-One-Dokumentation von TypeSafe ausdrücklich beschrieben.
Was macht JEV besonders? Kleine Einschätzungen automatisierbar machen#
1. Ergebnisse fließen direkt in Programme ein und benötigen weniger Interpretation und Umwandlung#
Angenommen, du definierst drei Abteilungen: billing, technical und sales.
Das Choice-Ergebnis von JEV liefert eine dieser Optionen zusammen mit einer Wahrscheinlichkeitsverteilung. Dein Programm kann answers.department.choice direkt auslesen und anhand des Ergebnisses die zuständige Bearbeitungswarteschlange auswählen.
Auch allgemeine große Sprachmodelle können Klassifizierungen über strukturierte Ausgaben erledigen. Der interessante Punkt bei JEV ist, dass typisierte Bewertungen und Wahrscheinlichkeitsausgaben die zentrale Schnittstelle bilden und das Modell gezielt auf diese Aufgaben optimiert ist.
Für Systeme, die täglich große Mengen an Nachrichten, Dokumenten oder Routing-Anfragen verarbeiten, ist diese Spezialisierung praktisch relevant: Du kannst Klassifizierungsergebnis, Bedingungen für eine manuelle Prüfung und auszuführende Aktion jeweils eindeutig festlegen.
2. Mehrere unabhängige Fragen in einer Anfrage stellen#
Aus demselben Kontext lassen sich häufig mehrere Einschätzungen ableiten:
- Worum geht es dem Kunden?
- Beeinträchtigt das Problem die normale Nutzung?
- Muss es schnell bearbeitet werden?
Laut der offiziellen TypeSafe-Dokumentation werden diese Fragen für denselben state unabhängig voneinander und parallel bewertet. Die Anwendung kann dadurch mit einer einzigen Anfrage mehrere Dimensionen ermitteln und sie anschließend im Code kombinieren.
Dabei ist ein Detail wichtig: Die Fragen innerhalb derselben Anfrage sind voneinander unabhängig. Wenn der zweite Schritt vom Ergebnis des ersten abhängt, sollte das Programm zunächst das Ergebnis der ersten Anfrage auslesen und anschließend die nächste Anfrage zusammenstellen.
3. Sehr geringe Kosten pro Eingabe, geeignet für häufige Aufrufe#
Zum Zeitpunkt dieser Prüfung gelten folgende Richtpreise:
| Position | Richtpreis |
|---|---|
| Eingabe | $0.042 / 1 Million Token |
| Ausgabe | $0 |
Bei insgesamt 1.000 Eingabe-Token pro Anfrage betragen die Kosten für eine einzelne Eingabe schätzungsweise 4.20.
Diese Berechnung basiert auf dem Richtpreis. Kontext, Fragen und Kriterien verbrauchen gleichermaßen Eingabebudget. Die tatsächliche Token-Anzahl ist in der Antwort unter usage zu sehen; der endgültig abgerechnete Betrag lässt sich in den Verbrauchsprotokollen dieser Plattform nachvollziehen. Den aktuellen Preis kannst du in der Crazyrouter-Modellliste überprüfen.
Damit können auch kleinere Einschätzungen in ein Produkt aufgenommen werden, für die sich ein eigener Aufruf eines großen Sprachmodells bisher nicht gelohnt hätte: Ist ein Dokument relevant? Welchem Thema gehört ein Feedback an? Sollte eine Anfrage an ein leistungsfähigeres Modell weitergeleitet werden?
4. Wahrscheinlichkeiten helfen bei der Gestaltung von Verarbeitungspfaden#
Wenn technical ausgewählt wurde und die Verteilung stark konzentriert ist, kann das Programm die Anfrage direkt weiterleiten. Liegen mehrere Optionen nahe beieinander, kann es zusätzliche Informationen anfordern, ein anderes Modell verwenden oder die Anfrage an einen Menschen übergeben.
Allerdings gilt: confidence darf nicht direkt als Trefferquote interpretiert werden. Der Wert beschreibt, wie eindeutig die zurückgegebene Verteilung ist. Ein Wert von 0.91 bedeutet bei einer einzelnen Antwort nicht, dass die Richtigkeit dieser Einschätzung bereits mit 91 % nachgewiesen wurde.
Die vom Anbieter hervorgehobene „Kalibrierung“ muss anhand einer Stichprobe mit Referenzantworten bewertet werden. Du solltest Schwellenwerte weiterhin anhand deiner eigenen Tickets und Kriterien festlegen. Weitere Informationen findest du in der Confidence-Dokumentation.
Zuerst einmal ohne Code im Browser ausführen#
Öffne den JEV Decision Playground oder direkt die chinesische Entscheidungswerkbank.
Die Seite bietet 12 bearbeitbare Szenarien:
| Kategorie | Szenarien |
|---|---|
| Kundenservice und Betrieb | Verteilung von Kundenservicetickets, Entscheidung über Rückerstattungen, Klassifizierung von Produktfeedback |
| Geschäft und Risikokontrolle | Einstufung von Vertriebs-Leads, Prüfung von Transaktionsrisiken, Zulassung von Lieferanten |
| Inhalte und Sicherheit | Weiterleitung der Inhaltsmoderation, Erkennung von Kontoübernahmen, Prüfung von Compliance-Dokumenten |
| KI-Workflows | Bewertung von RAG-Fragmenten, Routing von Agent-Tools, Einstufung von Produktionsvorfällen |
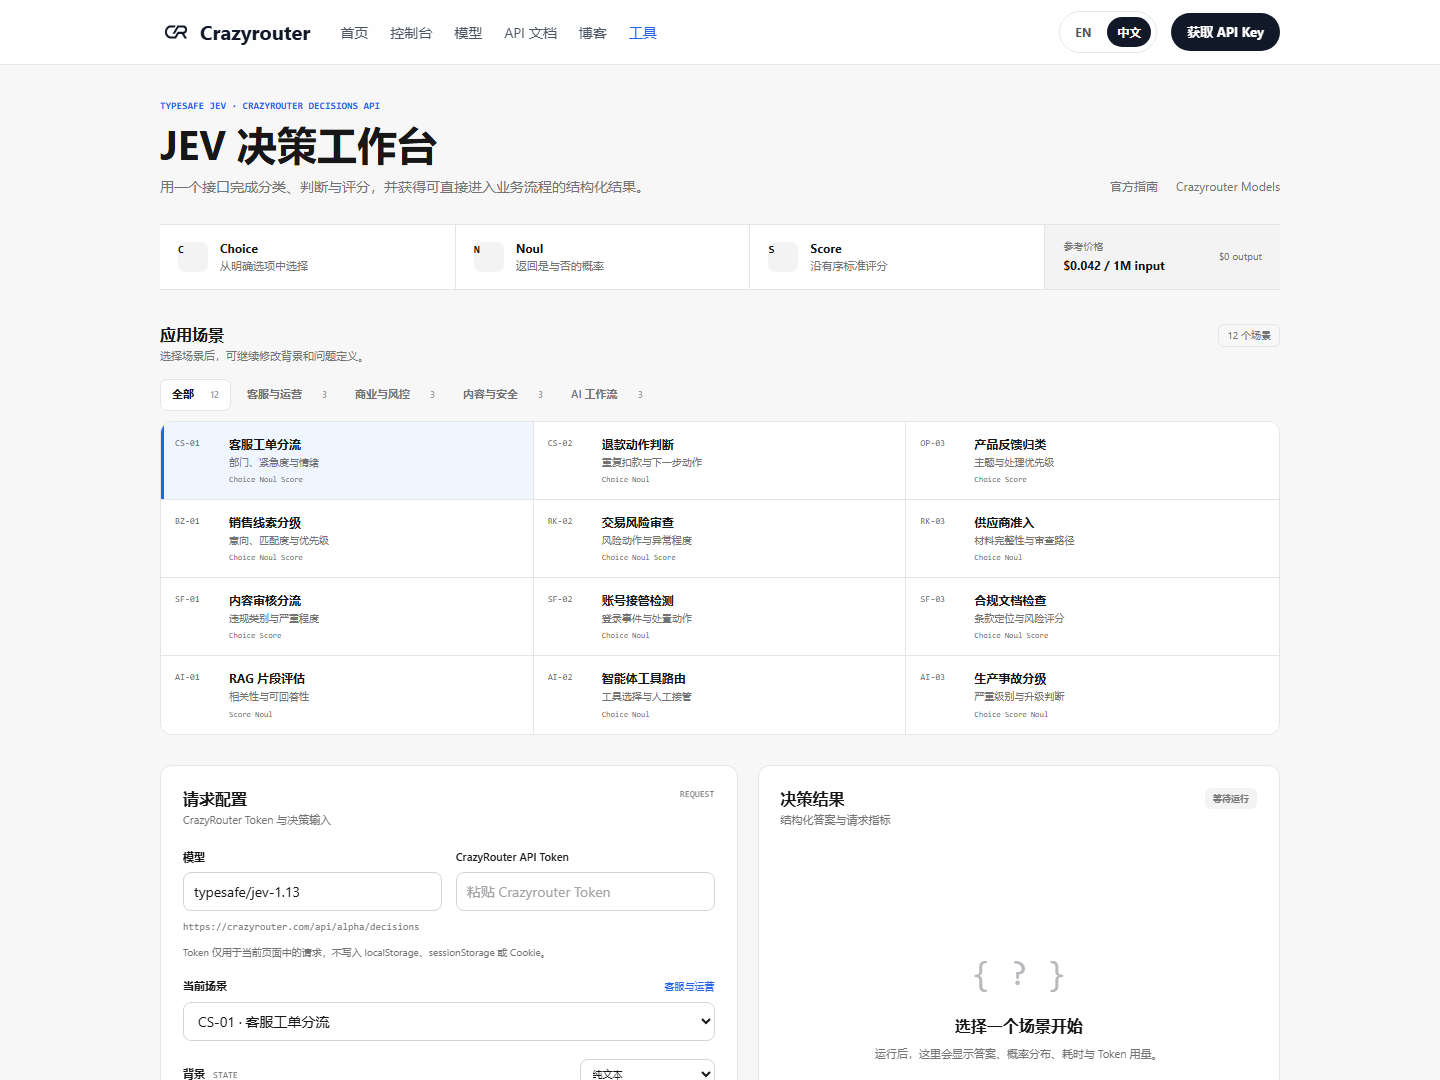
Für den ersten Versuch empfiehlt sich „Verteilung von Kundenservicetickets“. Gehe dabei folgendermaßen vor:
- Rufe auf der Token-Verwaltungsseite ein Crazyrouter-API-Token ab und trage es in der Werkbank ein.
- Behalte das Standardszenario bei und lies zunächst den Kontext sowie die Kriterien der drei Fragen durch.
- Klicke auf „Entscheidung ausführen“.
- Prüfe auf der rechten Seite die Abteilungsauswahl, die Wahrscheinlichkeitsverteilung, die Stimmungsbewertung, die Verarbeitungsdauer und den Token-Verbrauch.
- Ersetze den Kontext durch einen eigenen Text, führe die Entscheidung erneut aus und vergleiche die veränderte Bewertung.
Dieser Vorgang verursacht echte API-Kosten; dass die Ausgabe nicht abgerechnet wird, bedeutet nicht, dass der gesamte Aufruf kostenlos ist. Laut Hinweis auf der Seite bleiben die Token nur im Arbeitsspeicher der aktuellen Seite und werden nicht im Browserspeicher abgelegt.
Bei der Ausführung des standardmäßigen chinesischen Support-Tickets auf der tatsächlichen Webseite ergab sich Folgendes:
- Abteilung:
technical, mit einer Wahrscheinlichkeit von 0,94. - Dringlichkeitswahrscheinlichkeit: 0,97.
- Stimmungswert: 1,01; die drei Stufen lauten „ruhige Darstellung von Fakten / unzufrieden, aber beherrscht / sehr wütend“.
- Auf der Seite angezeigte Dauer: 0,70 Sekunden.
- Nutzung: 467 Eingabe-Token, 73 Ausgabe-Token.
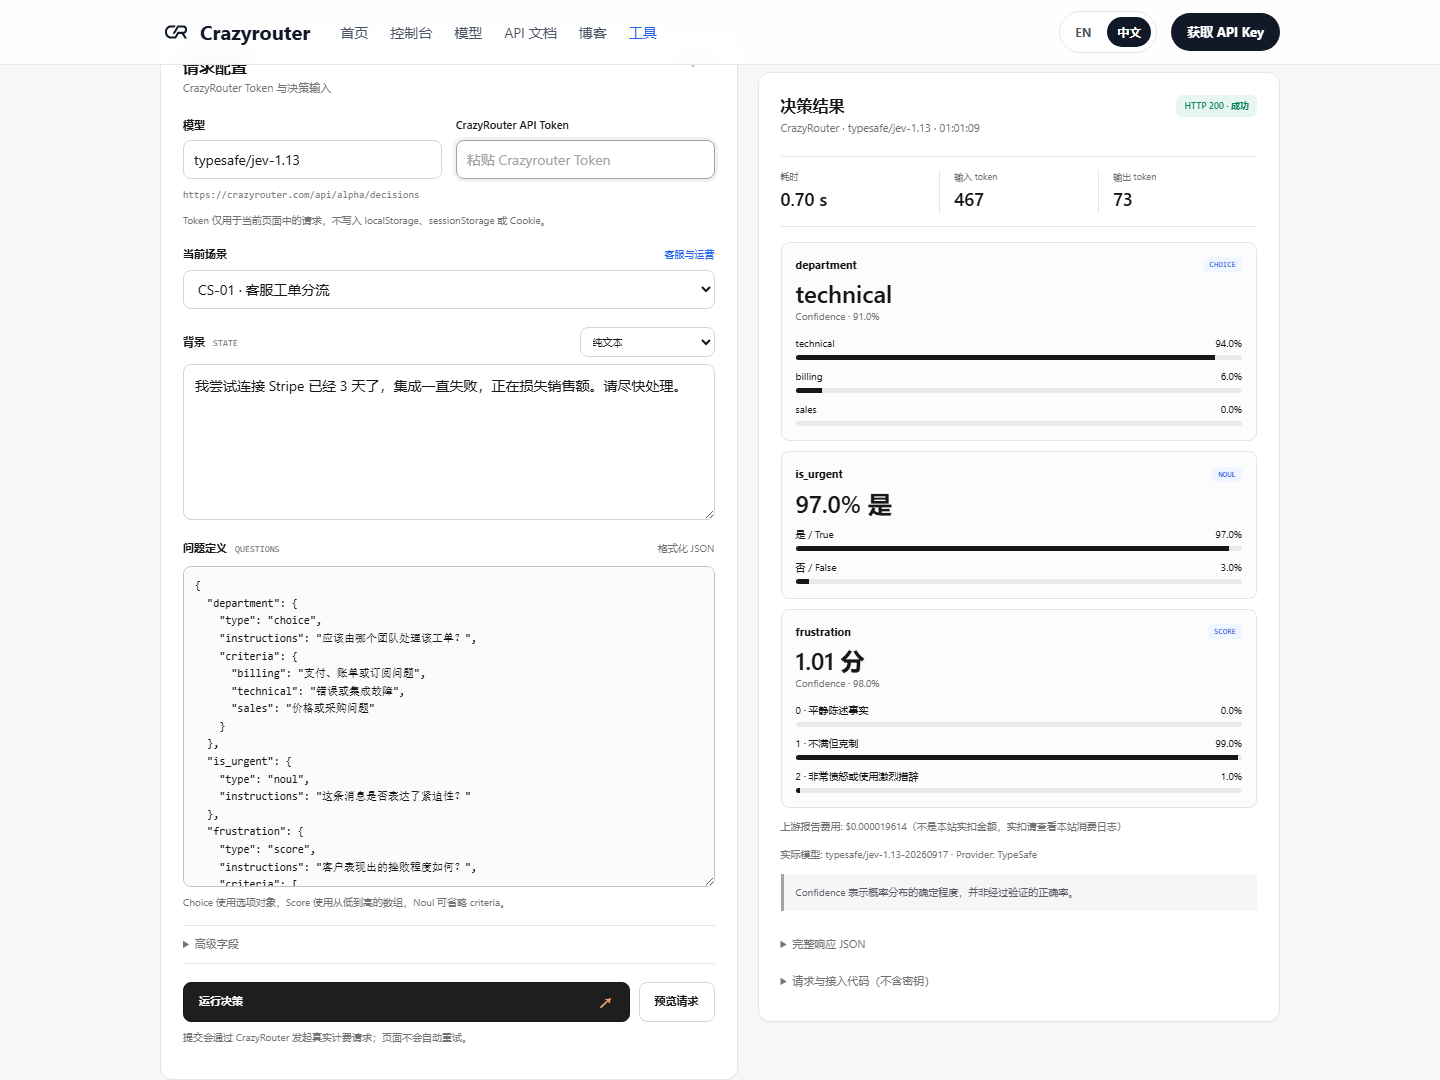
Die tatsächlich zurückgegebene Version war typesafe/jev-1.13-20260917. Dies ist das Ergebnis eines echten Webseitenaufrufs; bei einer erneuten Ausführung können sich Wahrscheinlichkeit und Dauer ändern.
Auf der Seite gibt es außerdem die Option „Anfrage in der Vorschau“. Damit lassen sich Beispiele für JSON, cURL, JavaScript und Python anzeigen. Wenn du das Szenario zunächst anpasst, bis es deinen Anforderungen entspricht, und anschließend die Anfrage zur Integration in dein eigenes Produkt kopierst, ist das einfacher, als direkt mit leerem Quellcode zu beginnen.
Hintergrund ändern und prüfen, ob sich die Einschätzung verändert#
Nur das Standardszenario auszuführen reicht noch nicht aus, um zu beurteilen, ob das Modell tatsächlich etwas leistet. Aussagekräftiger ist es, die Bewertungskriterien beizubehalten, den Hintergrund auszutauschen und zu beobachten, ob das Modell seine Antwort entsprechend der Evidenz ändert.
Wir haben denselben Decisions-Endpunkt mit sechs verschiedenen Eingaben getestet. Die tatsächlichen Aufzeichnungen sehen so aus:
| Testeingabe | Tatsächliche Antwort | Dauer des Python-Clients |
|---|---|---|
| Stripe-Integration seit 3 Tagen fehlgeschlagen, dadurch gehen Umsätze verloren | technical; Dringlichkeitswahrscheinlichkeit 0,98; Stimmung 1,01/2 | 1,102 Sekunden |
| Vorab nach dem Abonnementpreis für den nächsten Monat gefragt und ausdrücklich erklärt, dass keine Eile besteht | sales; Dringlichkeitswahrscheinlichkeit 0,04; Stimmung 0/2 | 0,784 Sekunden |
| Zwei Zahlungen für dieselbe Bestellung wurden beide bereits verifiziert und abgerechnet | refund; Wahrscheinlichkeit einer bestätigten Doppelabrechnung 0,95 | 0,675 Sekunden |
| Kunde vermutet eine Doppelbelastung, es liegt jedoch noch kein verifizierter Zahlungsdatensatz vor | Erster Aufruf und erneuter Test liefen beim Lesen in einen Timeout; keine Einschätzung erhalten | jeweils etwa 60 Sekunden |
| Die Dokumentation enthält ein Beispiel für den Timeout-Parameter einer Python-Anfrage | Relevanz 1,98/2; Wahrscheinlichkeit, die Frage beantworten zu können, 0,80 | 2,293 Sekunden |
| Die Dokumentation beschreibt ausschließlich Bildmodelle und ist für die Frage zu Anfrage-Timeouts nicht relevant | Erster Aufruf mit Timeout; erneuter Test: Relevanz 0/2, Wahrscheinlichkeit, die Frage beantworten zu können, 0,01 | beim erneuten Test 5,413 Sekunden |
Aus diesen Ergebnissen lassen sich einige konkrete Schlüsse ziehen.
Die Klassifizierung von Supportanfragen kann Thema und Ton gleichzeitig berücksichtigen. Wird der Hintergrund von „beeinträchtigt bereits das Geschäft“ zu „vorab nach dem Preis gefragt, keine Eile“ geändert, verändern sich sowohl die Abteilung als auch die Dringlichkeitswahrscheinlichkeit entsprechend.
RAG-Filterung kann Relevanz und Beantwortbarkeit voneinander trennen. Ein Fragment kann hochgradig relevant sein und dennoch nicht ausreichen, um die Frage vollständig zu beantworten. Im Beispiel lag die Relevanz nahe an der höchsten Stufe, während die Wahrscheinlichkeit einer möglichen Antwort 0,80 betrug. Beide Dimensionen erfüllen unterschiedliche Zwecke.
Geringe Kosten bedeuten nicht, dass keine Aufruffehler auftreten. Der Rückerstattungsfall mit unzureichender Evidenz lieferte kein Ergebnis. Deshalb ergänzen wir nicht nachträglich die Schlussfolgerung, das Modell habe „korrekt eine Untersuchung ausgewählt“. Ebenso lässt sich allein anhand eines Timeouts nicht feststellen, ob die Ursache beim Modell, beim vorgelagerten Dienst oder im Netzwerkpfad liegt.
Diese Runde umfasste den ersten Test, zwei Wiederholungsversuche und einen Webseitenaufruf, insgesamt also 9 Anfragen, davon 6 mit erfolgreicher Antwort und 3 mit einem Lesetimeout. Die von den sechs erfolgreichen Antworten gemeldeten Kosten des vorgelagerten Dienstes beliefen sich insgesamt auf $0.000115962. Nicht enthalten sind die noch nicht abgeglichenen Abrechnungen für die Anfragen mit Timeout; außerdem handelt es sich nicht um die vollständige tatsächlich belastete Abrechnung des Kontos auf dieser Plattform.
Die Stichprobe ist klein, und die Eingaben wurden als Demonstrationsfälle von Hand formuliert. Dies ist ein Einstiegs- und Verbindungstest. Daraus lassen sich weder eine allgemeine Genauigkeit berechnen noch Aussagen über die Stabilität des Dienstes ableiten.
Wie sind „mehrere hundert Mal schneller“ und „keine Halluzinationen“ zu verstehen?#
Der offizielle Veröffentlichungsartikel von TypeSafe schreibt, dass die Ende-zu-Ende-Antwortzeit unter den dortigen Testbedingungen 70–500 Millisekunden betrug. Die auf der Startseite genannten Vorteile von 193,6-facher Geschwindigkeit und 444,6-facher Kosteneffizienz stammen aus der Bewertung eines bestimmten Workflows. Der Anbieter weist außerdem darauf hin, dass diese Vorteile am oberen Ende dessen liegen, was in praktischen Anwendungen beobachtet wird, und erläutert, wie der interne Workflow und die Referenzantworten erstellt wurden.
Diese Zahlen helfen dabei, die Ausrichtung des Produkts zu verstehen. Sie lassen sich jedoch nicht unmittelbar auf dein Netzwerk, deine Daten und den gesamten Agent-Prozess übertragen.
Die Dauer der Python-Aufrufe mit erfolgreicher Antwort lag in diesem Test bei 0,675–5,413 Sekunden; ein Webseitenaufruf zeigte 0,70 Sekunden an. Zusätzlich trat ein Lesetimeout auf. Diese Zeiten umfassen den Aufrufpfad vom lokalen System über das Gateway bis zum vorgelagerten Dienst und sind daher nicht dasselbe wie die reine Rechenzeit des Modells. Ein Geschwindigkeitsvergleich mit anderen Modellen anhand derselben Aufgaben wurde in diesem Test nicht durchgeführt.
Auch „keine Halluzinationen“ muss im richtigen Geltungsbereich betrachtet werden. Der Anbieter betont, dass die Ausgabetypen und der vorab definierte Antwortbereich eingeschränkt sind: Gibt es beispielsweise drei mögliche Abteilungen, erzeugt das Modell nicht eigenmächtig den Namen einer vierten Abteilung.
Eine zulässige Option ist nicht automatisch die richtige Option. Das Modell kann ein Abrechnungsproblem weiterhin fälschlich dem technischen Team zuordnen oder bei einer falschen Einschätzung eine stark konzentrierte Wahrscheinlichkeitsverteilung ausgeben. Für den produktiven Einsatz solltest du einen Testsatz mit bekannten Antworten beibehalten, die Fehlertypen beobachten und erst danach festlegen, welche Entscheidungen automatisch ausgeführt werden dürfen.
Wie integrieren Entwickler die API? Die Decisions API verwenden#
In /v1/models von Crazyrouter wurde in diesem Test der öffentliche Modellname jev-1.13 bestätigt; auch die von der Webseite verwendete Version typesafe/jev-1.13 konnte erfolgreich ausgeführt werden. Eine erfolgreiche Antwort enthält die tatsächlich verwendete, aufgelöste Version.
Für diesen Test wurde Folgendes verwendet:
Website: https://crazyrouter.com
Schnittstelle: POST /api/alpha/decisions
Modell: jev-1.13
Authentifizierung: Authorization: Bearer <Crazyrouter API Token>
JEV verwendet eine spezielle Decisions-Schnittstelle. Es ist daher nicht geeignet, einfach model auf JEV zu ändern und anschließend /v1/chat/completions oder /v1/responses aufzurufen. Die Antwort wird hier synchron als JSON zurückgegeben; Streaming-Ausgabe wird ebenfalls nicht verwendet.
Das folgende vollständige Python-Beispiel entspricht dem Test mit dem Support-Ticket. Installiere zunächst requests und setze CRAZYROUTER_API_KEY als Umgebungsvariable auf deinem lokalen System:
import json
import os

import requests

payload = {
    "model": "jev-1.13",
    "state": "Ich versuche seit 3 Tagen, Stripe zu verbinden. Die Integration schlägt weiterhin fehl, und dadurch gehen Umsätze verloren. Bitte kümmert euch so schnell wie möglich darum.",
    "questions": {
        "department": {
            "type": "choice",
            "instructions": "Welches Team sollte dieses Ticket bearbeiten?",
            "criteria": {
                "billing": "Zahlungs-, Abrechnungs- oder Abonnementprobleme",
                "technical": "Fehler oder Integrationsprobleme",
                "sales": "Preis- oder Beschaffungsfragen",
            },
        },
        "is_urgent": {
            "type": "noul",
            "instructions": "Drückt diese Nachricht Dringlichkeit aus?",
        },
        "frustration": {
            "type": "score",
            "instructions": "Wie stark wirkt der Kunde frustriert?",
            "criteria": ["Ruhige Darstellung von Fakten", "Unzufrieden, aber beherrscht", "Sehr wütend oder mit drastischer Wortwahl"],
        },
    },
}

try:
    response = requests.post(
        "https://crazyrouter.com/api/alpha/decisions",
        headers={
            "Authorization": f"Bearer {os.environ['CRAZYROUTER_API_KEY']}",
            "Content-Type": "application/json",
        },
        json=payload,
        timeout=(10, 60),
    )
    response.raise_for_status()
except requests.Timeout as exc:
    raise SystemExit("Anfrage-Timeout: Keine Einschätzung erhalten. Prüfe die Aufrufprotokolle, bevor du einen erneuten Versuch startest.") from exc
except requests.RequestException as exc:
    raise SystemExit(f"Anfrage fehlgeschlagen: {exc}") from exc

data = response.json()
answers = data.get("answers")
if not isinstance(answers, dict) or not all(
    key in answers for key in ("department", "is_urgent", "frustration")
):
    raise RuntimeError("Die Antwort enthält keine vollständigen Entscheidungsergebnisse. Prüfe die vom Dienst zurückgegebenen Informationen.")

print(json.dumps(answers, ensure_ascii=False, indent=2))
print("Tatsächliches Modell:", data.get("model"))
print("Anfrage-ID:", data.get("id"))
print("Nutzung:", data.get("usage"))
Die wichtigsten Felder des entsprechenden ersten API-Praxistests sehen wie folgt aus; Erläuterungen zu den Stufen sowie ein Teil der Wahrscheinlichkeitsverteilung wurden weggelassen:
{
  "id": "gen-dec-1790095587-mts183W9F0rPWFGshpnx",
  "model": "typesafe/jev-1.13-20260917",
  "answers": {
    "department": {
      "type": "choice",
      "choice": "technical",
      "probabilities": {"technical": 0.94, "billing": 0.06, "sales": 0},
      "confidence": 0.91
    },
    "is_urgent": {"type": "noul", "noul": 0.98},
    "frustration": {"type": "score", "score": 1.01, "confidence": 0.98}
  },
  "usage": {"input_tokens": 467, "output_tokens": 73, "cost": 0.000019614}
}
Zwei Felder werden leicht missverstanden:
Noul 0.98 ist die Wahrscheinlichkeit für „Ja“. Wenn dein Programm letztlich einen booleschen Wert benötigt, musst du den Schwellenwert selbst festlegen. 0.5, 0.8 oder 0.95 sind lediglich mögliche geschäftliche Entscheidungen. Maßgeblich sollten die Kosten von Fehlentscheidungen und deine Validierungsdaten sein.
Score 1.01 ist der wahrscheinlichkeitsgewichtete Mittelwert des Stufenindex. Die drei Stufen des obigen Beispiels entsprechen den Werten 0, 1 und 2. Daher liegt der Wert nahe bei „unzufrieden, aber zurückhaltend“. Score kann eine Dezimalzahl sein und verwendet nicht automatisch eine Prozent-Skala. Die genaue Definition findest du in der offiziellen Score-Dokumentation.
Die drei lohnendsten Einsatzbereiche für den Anfang#
Kundensupport-Eingang: Abteilung und Dringlichkeit gleichzeitig bestimmen#
Lass JEV die Nachricht des Benutzers und den bekannten Bestellstatus auswerten. Als Ergebnis soll es die zuständige Abteilung, die Dringlichkeitswahrscheinlichkeit und die Kategorien noch benötigter Informationen ausgeben. Dein Programm erstellt daraus die Warteschlange; die Antwort formuliert anschließend ein generatives Modell oder ein Mitarbeiter.
Achte beim Definieren der Optionen darauf, die Grenzen klar voneinander abzugrenzen, und plane für unzureichende Informationen eine Option wie „Sonstiges“ oder „Weitere Prüfung erforderlich“ ein. Das Rückerstattungsbeispiel ist nur als Empfehlung gedacht; eine tatsächliche Rückerstattung muss dein Geschäftssystem anhand seiner Regeln ausführen.
Nach der RAG-Suche: Fragmente aussortieren, die keine Antwort unterstützen können#
Nachdem du die Kandidatendokumente erhalten hast, kannst du getrennt fragen, „ob das Fragment relevant ist“ und „ob es die Antwort unterstützt“. Anschließend entscheidest du, welche Fragmente in den endgültigen Generierungskontext gelangen.
Wenn es viele Kandidatenfragmente gibt, solltest du messen, wie viel zusätzliche Kosten und Wartezeit die Filterung selbst verursacht. Ob sie Eingabetoken für die Generierung einspart und dabei wichtige Belege versehentlich entfernt, muss anhand von Geschäftsdaten validiert werden.
Vor dem Aufruf eines Agent-Tools: Den nächsten Verarbeiter auswählen#
Definiere die verfügbaren Aktionen als Choice, zum Beispiel „Bestellung abrufen“, „Wissensdatenbank durchsuchen“, „Benutzer fragen“ oder „an einen Mitarbeiter weiterleiten“. JEV wählt die Aktion aus, und der Code führt den entsprechenden Ablauf aus.
JEV eignet sich für solche Entscheidungspunkte. Informationen zur Integration und weitere Modi findest du im TypeSafe-Schnelleinstieg. Andere Modelle und Schnittstellen sind in der Crazyrouter-API-Dokumentation aufgeführt.
Häufige Fragen#
Kann JEV das Hauptmodell von Claude Code, Codex oder Cursor direkt ersetzen?#
Nein. JEV generiert keinen Code, führt keine fortlaufenden Dialoge und gibt keine Abläufe für Tool-Aufrufe wie ein Programmiermodell aus. Du kannst einen Programmier-Agent damit beauftragen, einen Klassifizierer oder Router zu schreiben, der JEV verwendet. Die [offizielle Dokumentation zu coding agents]agents erläutert diesen Punkt ausführlich.
Unterstützt JEV Deutsch?#
Die chinesischen Kundensupport-Anfragen, chinesischen Problembeschreibungen und chinesischen RAG-Fragmente dieses Tests lieferten allesamt verwertbare Ergebnisse. Diese drei Fälle reichen jedoch nicht aus, um die Genauigkeit für alle chinesischen Geschäftsanwendungen zu belegen. Fachbegriffe, lange Texte und Grenzfälle müssen separat getestet werden.
Ist JEV online kostenlos nutzbar?#
Die Crazyrouter-Arbeitsumgebung führt tatsächlich abgerechnete Anfragen aus und benötigt ein API-Token dieser Plattform. Der Ausgabepreis des Modells beträgt null, die Eingabe wird weiterhin berechnet. Übertrage vorübergehende kostenlose Aktionen anderer Plattformen nicht auf diesen Dienst.
Warum enthält die Antwort des API-Aufrufs output_tokens, obwohl der Ausgabepreis null ist?#
Die Statistik der Ausgabetoken und die Abrechnung der Ausgabe sind zwei unterschiedliche Konzepte. Die erfolgreiche Antwort dieses Tests enthielt output_tokens; der Ausgabetarif des Referenzpreises beträgt null.
Reicht es aus, in die Eingabe nur „Schau dir das bitte an“ zu schreiben?#
Du solltest ausreichend Kontext liefern und klar angeben, was beurteilt werden soll. Zerlege beispielsweise „Ist dieser Kunde gut?“ in Fragen wie „Gibt es einen Beschaffungsplan?“, „Passt der Bedarf zu unserem Angebot?“ und „Ist der Kunde bereit, eine technische Evaluierung zu vereinbaren?“. Klarere Bewertungskriterien erleichtern die Beurteilung und machen das Testen zuverlässiger.
Kann ich bei einer sehr hohen confidence alle Aktionen direkt automatisiert ausführen?#
Du solltest nicht nur auf eine einzelne Zahl achten. Validiere zunächst Fälle mit bekanntem Ergebnis und lege die Ausführungsbedingungen anschließend anhand der Kosten der jeweiligen Aktion fest. Ein Fehler bei einem Klassifizierungslabel hat andere Folgen als eine falsche Abbuchung oder das Sperren einer Rufnummer. Deshalb sollten auch Schwellenwerte und Prüfprozesse unterschiedlich ausfallen.
Bedeutet ein Timeout, dass keine Kosten entstanden sind?#
Nicht unbedingt. Wenn der Client keine Antwort erhalten hat, lässt sich daraus nicht ableiten, dass der Server die Anfrage nicht verarbeitet hat. Prüfe die Aufruf- und Verbrauchsprotokolle. Dieser Bericht fasst nur die Kosten von Anfragen mit erhaltener Antwort zusammen und behandelt Anfragen mit Timeout nicht als kostenlos.
Probiere es jetzt mit deinen eigenen zwei Texten aus#
Öffne die JEV-Entscheidungsumgebung, führe zunächst das standardmäßige Kundensupport-Ticket aus und ändere es anschließend in eine „nicht dringende allgemeine Anfrage“. Behalte dieselbe Aufgabendefinition bei und beobachte, wie sich Abteilung, Dringlichkeitswahrscheinlichkeit und Emotionsbewertung verändern.
Wähle danach aus deinem echten Geschäft eine Gruppe von Fällen mit bereits bekannten Antworten aus: Nimm eindeutige, vage und leicht zu verwechselnde Fälle auf. Wenn JEV bei akzeptablen Kosten und akzeptabler Latenz stabil eine dieser Entscheidungsarten übernehmen kann, hast du einen sinnvollen Ansatzpunkt für die Integration in dein Produkt.
Quellen- und Testhinweis: Dieser Artikel basiert auf den offiziellen Veröffentlichungen und der Dokumentation von TypeSafe, den aktuellen Modellinformationen von Crazyrouter sowie API- und Webaufrufen vom 23.09.2026. Die Abbildungen sind Screenshots der tatsächlichen Seiten und Ablaufdiagramme. Offizielle Leistungsangaben sind gesondert gekennzeichnet; die Ergebnisse dieser kleinen Stichprobe sind kein allgemeines Benchmark-Ranking.