简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
中美AI模型真实差距到底有多远?|序章
中美AI模型对比系列序章:基于2026年10月29日Artificial Analysis数据,比较前沿分差、Opus 4.8门槛与112次真实API调用;建立后续文本、编程、图像、视频、语音、向量与重排专题的共同研究方法。
中美AI模型对比系列 · 序章。我们先从文本模型建立比较方法,再分别研究图像、视频、语音、向量检索与重排。本篇是方法和问题的起点,文本模型的分数不能代表其他模态的实力。
美国模型在当前前沿榜单和头部阵容上领先,但“中美模型差距正在持续扩大”不符合本次同标尺回溯结果。以 Opus 4.8 作为个人满意度的参考门槛,AA 已覆盖样本中有 12 个中国发布版本、21 个美国发布版本的 Progress Index 分数高于它;这不意味着每个任务都更好用。
数据截点为 2026 年 10 月 29 日。本文把三个容易混淆的问题拆开:最强模型之间差多少、跨过旧旗舰门槛的选择有多少,以及实际请求中哪些差距能够被感受到。前两个问题使用 Artificial Analysis(AA)数据,第三个问题通过 Crazyrouter 进行 7 款模型、8 种任务、每题 2 次,共 112 次调用审计。[1][2]
这是一份模型样本研究。它不评判两国整体 AI 产业,也没有进行人类主观盲评;“可用”最终取决于你的任务、等待时间和容错要求。
先看结果:前沿领先与普遍可用,是两件事#
| 指标 / 标尺 | 中国 | 美国 |
|---|---|---|
| 当前最高分 · Intelligence v5 | 46.0 · Kimi K3.1 Pro | 59.4 · Gemini 4 Carbon |
| Top 5均分 · Intelligence v5 | 34.74 | 56.68 |
| 全球Top 10版本数 · Intelligence v5 | 1 | 9 |
| 当前最高分 · Progress v1 | 340.70 | 351.65 |
| 超过Opus 4.8 · Progress v1,含历史版本 | 12 | 21 |
| 其中AA未标记deprecated的版本 | 9 | 13 |
两种指数的数值不能相减或混排。当前 v5 前沿分差为 13.4 分;Progress v1 的当前前沿分差为 10.94 分。前者衡量当前评测集的表现,后者用于分析跨时期的能力变化。
统计将 AA 的 716 条推理配置合并为 517 个发布版本,其中中国 176 个、美国 257 个,其余为其他国家或未分类。按 release.id 合并,同一版本的 high、max、xhigh 不重复算成多个模型。每项指标分别取该版本的最高得分配置,最高配置可能不同。
新 v5 榜单目前只有 39 个发布版本有可用总分,其中中国 12 个、美国 24 个、其他国家 3 个。这里的 Top 10 和均分是已测样本的统计,缺测不代表零分。排名按原始 API 返回精度,并列占同名次,后续名次跳位。[1]
当前前20名:谁在头部?#
| 全球名次(版本去重) | 发布版本 | 归属 | v5分数 | 发布日期 |
|---|---|---|---|---|
| 1 | Gemini 4 Carbon | 美国 | 59.4 | 2026-10-28 |
| 2 | Claude Opus 5.5 | 美国 | 58.4 | 2026-09-22 |
| 3 | GPT-6 Astra | 美国 | 56.9 | 2026-09-03 |
| 4 | GPT-6.1 Sol | 美国 | 54.5 | 2026-09-29 |
| 5 | Claude Sonnet 5.5 | 美国 | 54.2 | 2026-09-28 |
| 6 | GPT-6.1 Terra | 美国 | 51.0 | 2026-10-26 |
| 7 | Gemini 4 Argon | 美国 | 50.4 | 2026-09-30 |
| 8 | Muse Wonder Full | 美国 | 49.7 | 2026-10-12 |
| 8 | Claude Fable 5.1 | 美国 | 49.7 | 2026-09-01 |
| 10 | Kimi K3.1 Pro | 中国 | 46.0 | 2026-10-23 |
| 11 | Muse Wonder | 美国 | 43.3 | 2026-10-12 |
| 12 | Muse Spark 1.3 | 美国 | 36.4 | 2026-09-02 |
| 13 | Claude Haiku 5.5 | 美国 | 36.2 | 2026-10-07 |
| 14 | Grok 4.7 | 美国 | 35.0 | 2026-09-21 |
| 15 | Qwen3.8 Max (0902) | 中国 | 33.6 | 2026-09-02 |
| 16 | DeepSeek V4.1 Flash 1017 | 中国 | 32.5 | 2026-10-17 |
| 17 | GLM-5.3 | 中国 | 31.7 | 2026-08-18 |
| 18 | Gemini 3.8 Flash | 美国 | 30.5 | 2026-09-02 |
| 19 | MiMo-V2.6-Pro | 中国 | 29.9 | 2026-09-21 |
| 20 | Ling 3.1 Flash 1019 | 中国 | 29.5 | 2026-10-22 |
这份前20名中,中国占6席、美国占14席;前10名分别为1席和9席。结合Top 5均分34.74与56.68,可以看到单个前沿模型追近与头部梯队厚度仍有差别。总分缺测的版本不参与排名。[1]
分数差距是在越拉越大吗?#
不是持续扩大,而是明显受旗舰发布节奏影响。 我们用同一次抓取的 Progress Index v1,按各版本发布日期重建两国前沿:某天之前已发布版本的最高分,就是那天的回溯前沿。
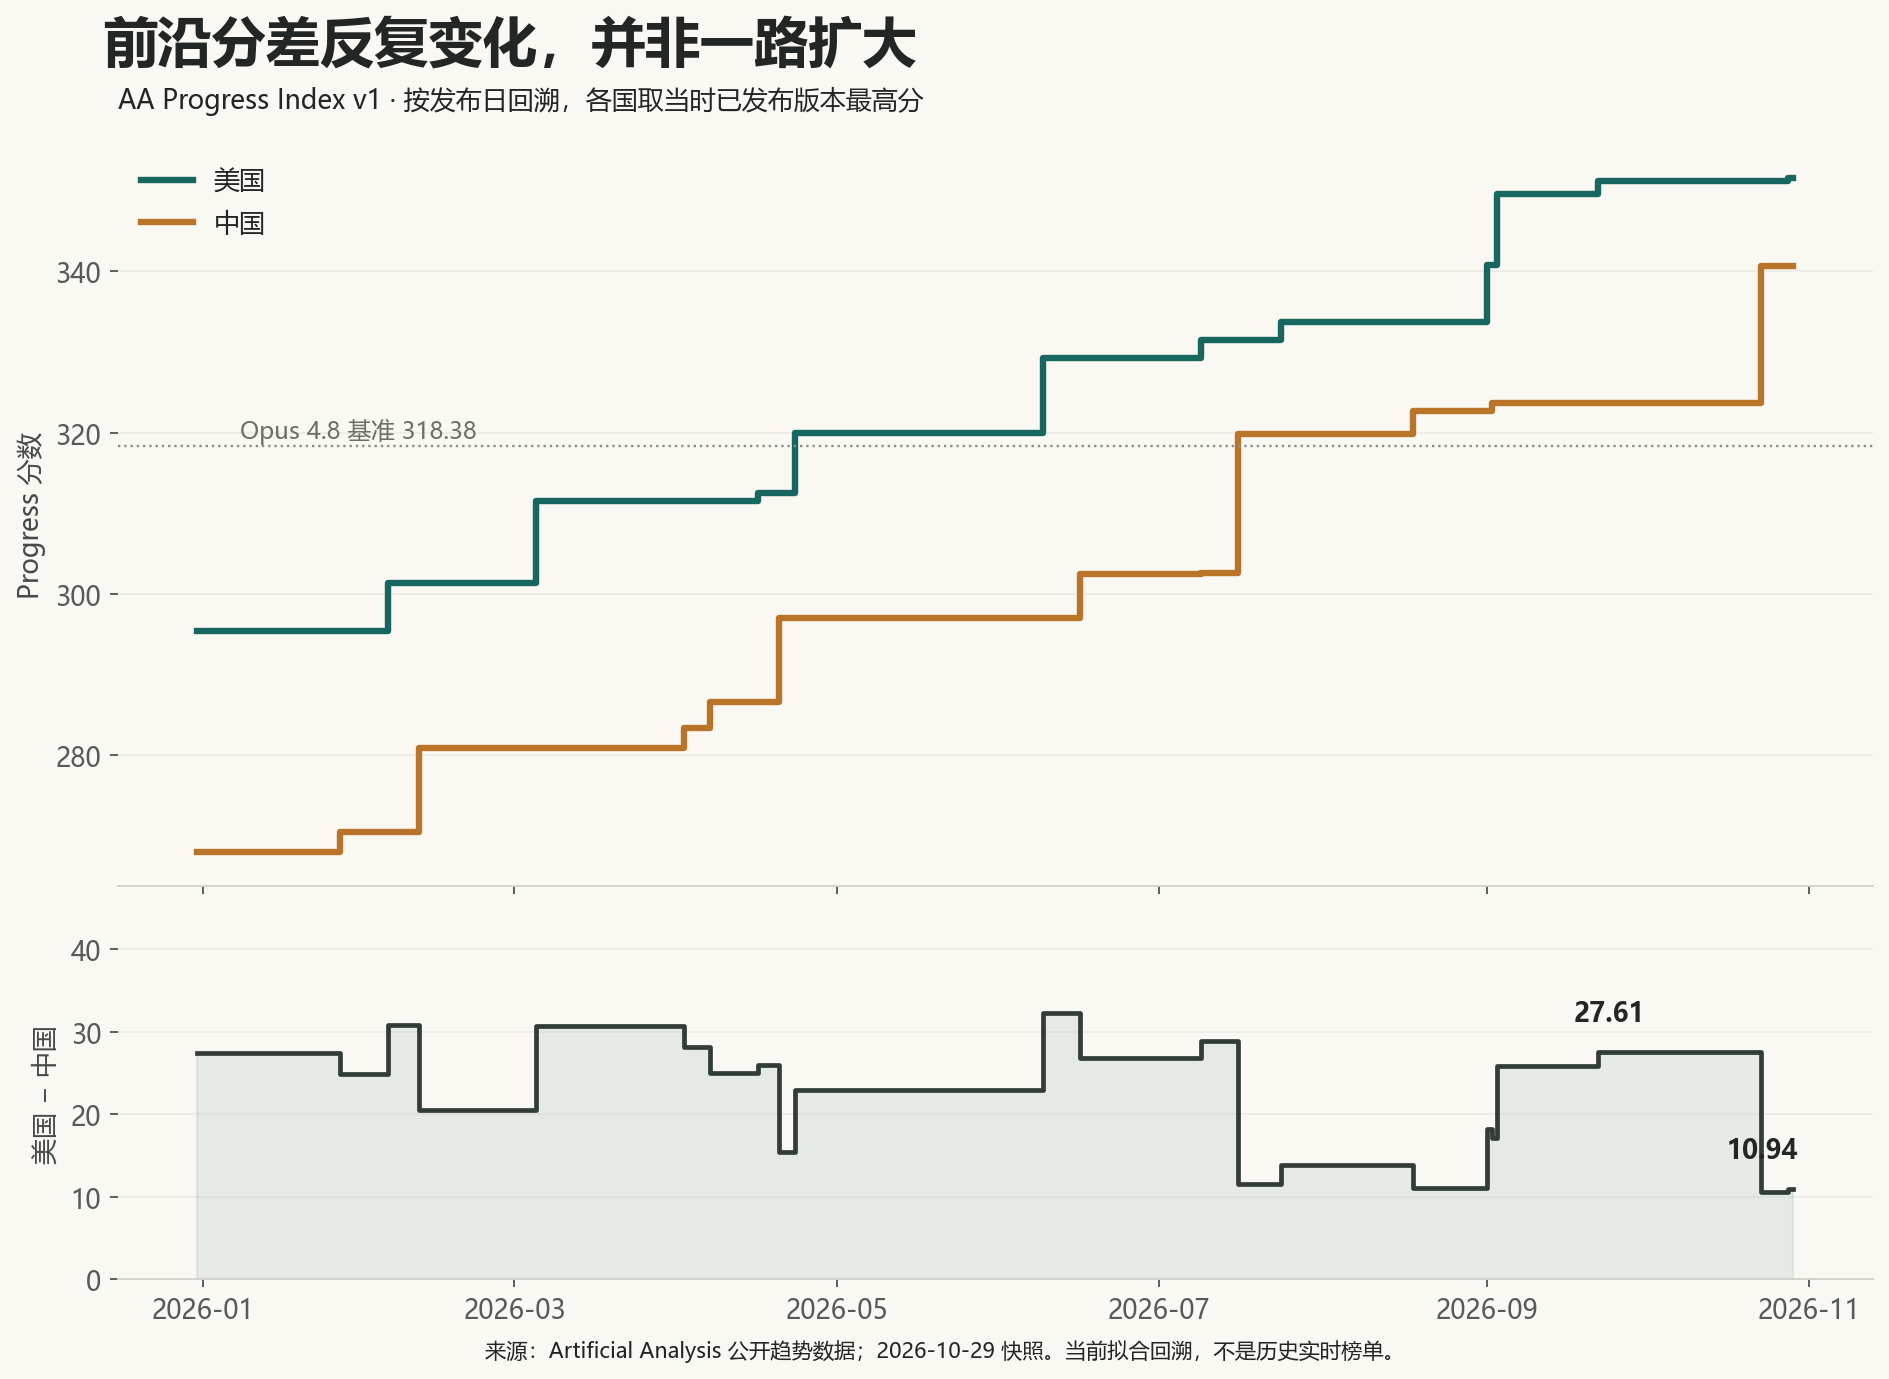
| 回溯日期 | 中国前沿 | 美国前沿 | 分差:美国−中国 |
|---|---|---|---|
| 2025-12-31 | 267.96 | 295.46 | 27.49 |
| 2026-03-31 | 280.87 | 311.55 | 30.69 |
| 2026-06-30 | 302.52 | 329.33 | 26.80 |
| 2026-07-31 | 319.88 | 333.73 | 13.85 |
| 2026-08-31 | 322.66 | 333.73 | 11.07 |
| 2026-09-30 | 323.67 | 351.27 | 27.61 |
| 2026-10-23 | 340.70 | 351.27 | 10.57 |
| 2026-10-29 | 340.70 | 351.65 | 10.94 |
2026 年 8 月底的分差是 11.07。9 月美国新旗舰集中推出后,月底扩大至 27.61;10 月 23 日 Kimi K3.1 Pro 发布,将差距收窄至 10.57;10 月 28 日 Gemini 4 Carbon 发布后,10 月 29 日快照为 10.94。[2]
这使“看哪个时间窗口”成为结论的一部分。当前分差比30天前缩小约 16.66 分,比90天前缩小约 2.91 分,比180天前缩小约 12.00 分。与此同时,美国依然在两国前沿比较中领先。收窄与领先可以同时成立。
但不能把这张图称为“过去每一天的实时榜单”。Progress Index 是基于当前已取得评测的统计拟合,未来补测与重新拟合可能改变回溯分数;历史 API 开放状态也没有完整复原。它回答的是“现在用同一把尺子看过去发布的模型”,不是“当时用户实际能调用到什么”。[3]
为什么有人会看到差距突然变大?#
AA 在 2026 年 10 月 27 日将 Intelligence Index 升级至 v5,新增或升级了软件工程、科研和知识推理评测。其公告提到,开放权重类别头部与领先模型的差距,从 v4.3 的3分变成 v5 的12分。[4]
这里既更换了测量尺子,又使用了“开放权重与领先模型”的分组;不能把它直接改写为“两天内中美能力差距从3分扩大到12分”。该公告还将权重尚未发布的 Kimi K3.1 Pro 纳入相关描述,更不能把这一分组等同于当日已经可以下载的模型集合。
v5 给知识工作、编程、科学和通用四类各25%权重。这会比单纯聊天更重视困难任务和多步骤执行。因此,榜单差距可以很大,同时某些日常任务的差距较小;是否如此,需要具体任务证据。[4][5]
如果 Opus 4.8 已经够用,有多少模型跨过了它?#
先固定标尺。Opus 4.8 在2026年5月发布评测中的 61.4 分属于旧版 Intelligence Index。本次 API 快照中,它的 v5 总分为空,不能把空值当0,更不能拿旧61.4筛选新榜单。[1][6]
本文改用 Progress Index v1 中的 Opus 4.8(max):318.376758998036 作为固定参考,严格大于才算超过;相等不算,缺测记未知。阈值取完整精度,表格只保留两位小数。[2]
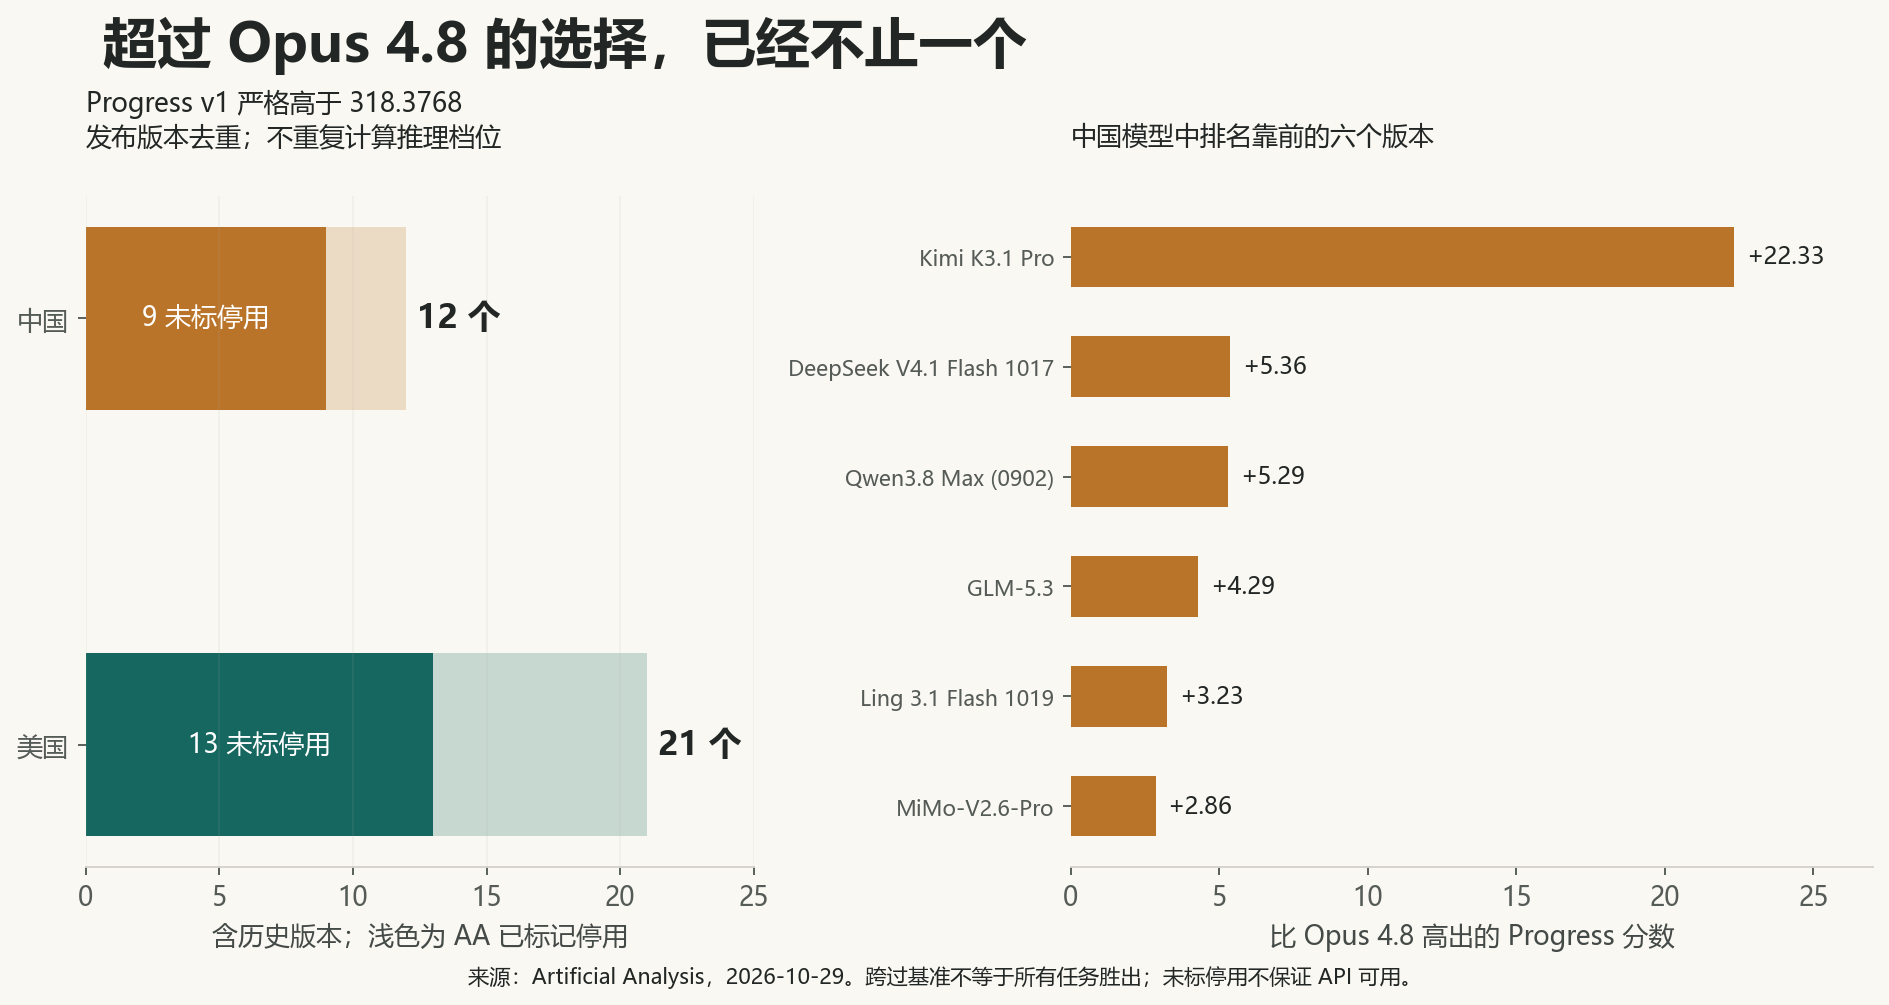
在517个发布版本中,全球共33个超过此门槛,全部落在本次中美两组内。其中中国12个、美国21个。仅看AA没有标记 deprecated 的版本,分别为 9个和13个。AA标记是页面状态,不证明官方已经关停,也不保证当前任何网关都可调用。
中国跨过门槛的完整名单#
| 中国模型发布版本 | 最高Progress分数 | AA已标记deprecated |
|---|---|---|
| Kimi K3.1 Pro | 340.70 | 否 |
| DeepSeek V4.1 Flash 1017 | 323.74 | 否 |
| Qwen3.8 Max (0902) | 323.67 | 否 |
| GLM-5.3 | 322.66 | 否 |
| Ling 3.1 Flash 1019 | 321.61 | 否 |
| MiMo-V2.6-Pro | 321.24 | 否 |
| DeepSeek V4.1 Flash | 320.25 | 是 |
| Qwen3.8-Flash-Next | 320.23 | 否 |
| Ling 3.1 Flash | 320.01 | 否 |
| Kimi K3 | 319.88 | 是 |
| Qwen3.8 Max | 319.63 | 是 |
| GLM-5.3-Flash | 318.64 | 否 |
美国跨过门槛的完整名单#
| 美国模型发布版本 | 最高Progress分数 | AA已标记deprecated |
|---|---|---|
| Gemini 4 Carbon | 351.65 | 否 |
| Claude Opus 5.5 | 351.27 | 否 |
| Claude Sonnet 5.5 | 350.50 | 否 |
| GPT-6 Astra | 349.57 | 否 |
| GPT-6.1 Sol | 348.47 | 否 |
| GPT-6.1 Terra | 345.25 | 否 |
| Muse Wonder Full | 343.22 | 否 |
| Gemini 4 Argon | 341.79 | 否 |
| Claude Fable 5.1 | 340.85 | 否 |
| Muse Wonder | 335.78 | 否 |
| GPT-6 Sol | 334.04 | 是 |
| Claude Opus 5 | 333.73 | 是 |
| GPT-5.6 Sol | 331.46 | 是 |
| Claude Fable 5 | 329.33 | 是 |
| Claude Haiku 5.5 | 326.13 | 否 |
| Muse Spark 1.3 | 324.46 | 是 |
| GPT-5.6 Terra | 323.87 | 是 |
| Grok 4.7 | 322.68 | 否 |
| Grok 4.6 | 321.54 | 是 |
| Gemini 3.8 Flash | 320.30 | 否 |
| GPT-5.5 | 320.00 | 是 |
不能把微弱超出都叫“明显领先”。例如,GLM-5.3-Flash高于基准约0.27分;本次公开数据未提供足以支持此比较的置信区间。所以下表只做阈值敏感性分析,这些加分档不是统计显著性标准:
| 门槛(Progress v1) | 中国版本数 | 美国版本数 |
|---|---|---|
| 严格高于 Opus 4.8 + 0 分 | 12 | 21 |
| 严格高于 Opus 4.8 + 1 分 | 11 | 21 |
| 严格高于 Opus 4.8 + 3 分 | 5 | 19 |
| 严格高于 Opus 4.8 + 5 分 | 3 | 17 |
| 严格高于 Opus 4.8 + 10 分 | 1 | 14 |
这个角度能同时解释两种感受:达到旧旗舰水平的选择确实增加了;远高于旧旗舰的头部选择仍集中在美国组。 中国12个跨线版本中,只有3个高出5分以上;美国则有17个。以上都含历史版本,不能解读为当前API库存。
跨过这个能力门槛,相差多少天?#
在当前 Progress v1 回溯中,美国最早越线的版本是2026年4月23日发布的 GPT-5.5,中国是2026年7月16日发布的 Kimi K3,两次越线日期相差 84天。若从Opus 4.8自身发布日5月28日起算,到Kimi K3是 49天。[2]
GPT-5.5比Opus 4.8更早跨过这条回溯阈值并不矛盾:Progress与当时Intelligence榜单的目标、拟合和排序不同。84天只是这一条指定阈值的首次跨越日期差,不是“中国所有模型整体落后三个月”的证据。
实际体感差距,真的有分数看起来那么大吗?#
本次实验能回答的是“在这套请求条件下,哪些任务顺利交付”,不能替代人的总体满意度评价。我们从Anthropic系列和OpenAI系列选取当前代表模型,并保留Opus 4.8基准;中国组覆盖Kimi系列、Qwen系列、DeepSeek系列与GLM系列。这是有目的选样,不用于估计国家平均胜率。
测试在 2026年10月29日进行,统一走 https://cn.crazyrouter.com/v1/chat/completions,请求设置为 reasoning_effort="high"、max_tokens=8192、非流式,不调用工具,每次读取超时180秒,随机顺序,最多4并发。相同high标签不代表相同内部算力,也不等同AA各模型的最高档评测。
| 任务组 | 具体任务 | 判分依据 |
|---|---|---|
| 日常任务,5种 | 订单提取去重、冲突记录、中文格式约束、240条库存定位、退款规则边界 | 固定真值、字段类型、文本格式 |
| 推理压力,3种 | 环形约束计数、带依赖排程、组合选择优化 | 本地穷举的唯一最优答案/指定并列规则 |
严格通过要求HTTP成功、正常结束、最终答案及格式全部符合要求。我们保留预先约定的这一主指标;另外做事后敏感性检查,仅去掉一个外层Markdown代码围栏,不修答案、不重试。后者更接近“内容是否可读懂”,前者更接近“程序能否直接接入”。
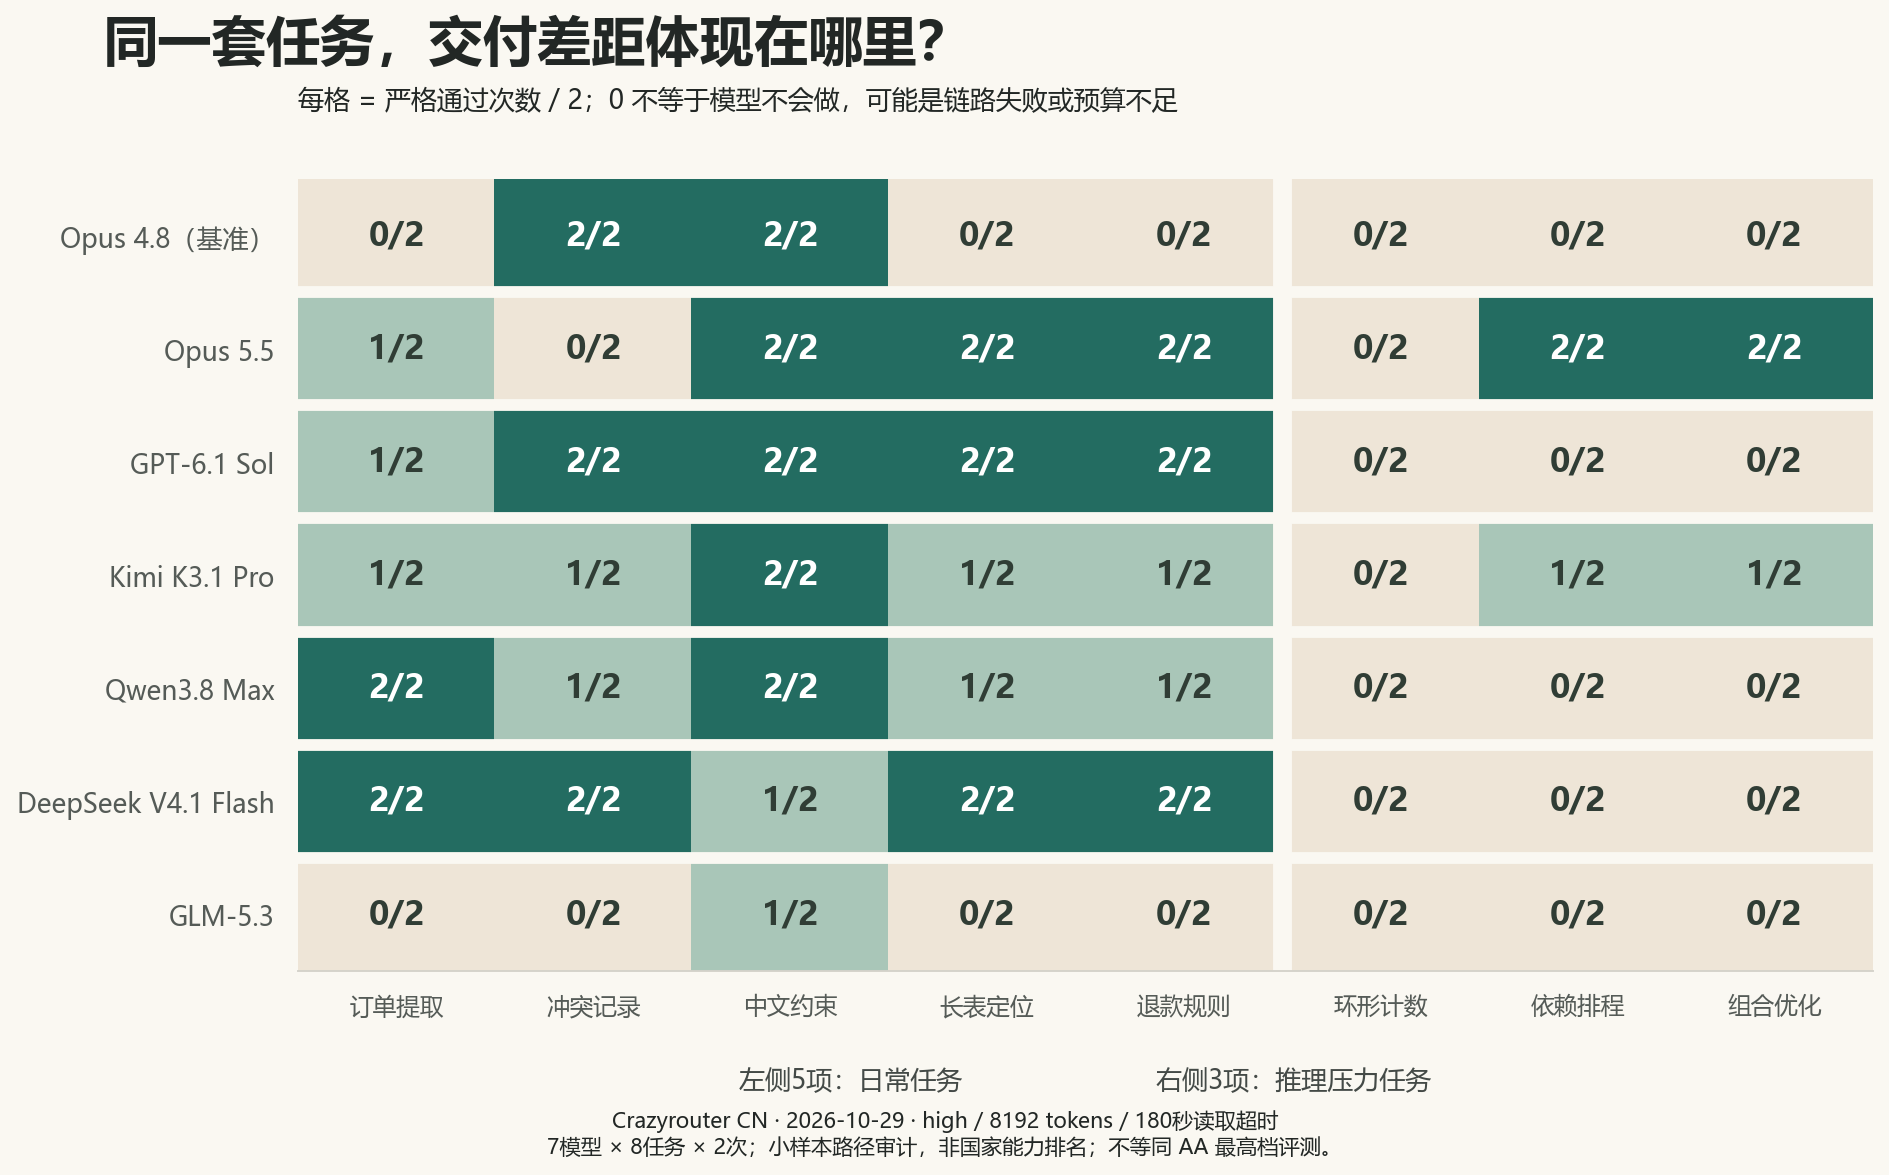
| 请求模型 | 日常严格通过 / 10 | 压力严格通过 / 6 | 全部严格 / 16 | 去单层围栏后 / 16 |
|---|---|---|---|---|
| claude-opus-4-8 | 4/10 | 0/6 | 4/16 | 13/16 |
| claude-opus-5-5 | 7/10 | 4/6 | 11/16 | 16/16 |
| gpt-6.1-sol | 9/10 | 0/6 | 9/16 | 9/16 |
| kimi-k3.1-pro | 6/10 | 2/6 | 8/16 | 8/16 |
| qwen3.8-max | 7/10 | 0/6 | 7/16 | 7/16 |
| deepseek-v4.1-flash | 9/10 | 0/6 | 9/16 | 9/16 |
| glm-5.3 | 1/10 | 0/6 | 1/16 | 1/16 |
差距体现在哪里?#
以本轮 DeepSeek V4.1 Flash 与 Opus 5.5 为例:日常任务严格交付分别为 9/10 与 7/10,压力任务为 0/6 与 4/6。这是固定预算下的交付差别,不能将未完成全部解释成“模型不会做”;特别是压力任务可能耗尽输出预算或在等待上限前未完成。
另一个真实例子来自 Opus 4.8:它在订单提取中返回了正确字段和值,却包裹了Markdown代码围栏,导致严格JSON检查未通过。若你在聊天窗口阅读,可能并不觉得这是错误;若结果直接进入程序,就需要增加清洗步骤。同一份输出,在两种使用方式下会产生不同的体感。
只移除单层代码围栏后,结果变为:
| 请求模型 | 日常:只去围栏后 / 10 | 压力:只去围栏后 / 6 |
|---|---|---|
| claude-opus-4-8 | 10/10 | 3/6 |
| claude-opus-5-5 | 10/10 | 6/6 |
| gpt-6.1-sol | 9/10 | 0/6 |
| kimi-k3.1-pro | 6/10 | 2/6 |
| qwen3.8-max | 7/10 | 0/6 |
| deepseek-v4.1-flash | 9/10 | 0/6 |
| glm-5.3 | 1/10 | 0/6 |
Opus 4.8与Opus 5.5的日常题均为10/10,但压力题分别为3/6与6/6。这提供了一个具体例子:更高能力的优势可能主要在更难的任务上出现。这里只有5种日常任务和3种压力任务,同题两次调用不算两道独立题,不能据此证明日常能力已经等效。
网关和版本映射也会改变体验#
本次112次请求中,HTTP错误 15次、读取超时 17次、预算截断 7次。这些调用都保留在固定预算交付率的分母里,并在下表独立列出。
| 请求模型 | HTTP错误 | 180秒读取超时 | 预算截断 | 正常结束的响应数 |
|---|---|---|---|---|
| claude-opus-4-8 | 1 | 0 | 2 | 13 |
| claude-opus-5-5 | 0 | 0 | 0 | 16 |
| gpt-6.1-sol | 5 | 0 | 0 | 11 |
| kimi-k3.1-pro | 6 | 2 | 0 | 8 |
| qwen3.8-max | 1 | 8 | 0 | 7 |
| deepseek-v4.1-flash | 0 | 2 | 5 | 9 |
| glm-5.3 | 2 | 5 | 0 | 9 |
例如,Kimi K3.1 Pro的一次请求返回 provider_authentication_failed。这说明该次请求未被上游正确鉴权,不能作为模型答错的证据。读取超时同样只表示客户端没有及时拿到完整响应,不能定位为模型计算慢。
| 请求名称 | 实测响应中出现的model字段 |
|---|---|
| claude-opus-4-8 | claude-opus-4-8 |
| claude-opus-5-5 | claude-opus-5-5 |
| gpt-6.1-sol | gpt-6.1-sol |
| kimi-k3.1-pro | kimi-k3.1-pro |
| qwen3.8-max | qwen3.8-max |
| deepseek-v4.1-flash | deepseek-v4.1-flash、deepseek-v4.1-flash-1017、deepseek/deepseek-flash |
| glm-5.3 | glm-5.3 |
响应model字段只是服务端声明,不是权重身份的独立证明。尤其DeepSeek的同一请求名返回过不同版本/别名,本轮无法保证所有请求精确对应AA的同一个发布版本。因此,这些结果应称为“本次API路径的交付审计”,不能与AA分数硬配对计算相关系数,更不能由它宣布某国模型整体更强或等效。
GLM-5.3路径还出现JSON后附加额外文本、重复答案和异常标记的响应。本文保留原始证据,但不能判断异常来自模型、模板还是上游适配。它的低严格交付数尤其不适合作为基础模型能力结论;本轮没有为获得更好成绩而修改通道或重跑替换失败。
我们没有完成真人盲评、生产用户任务抽样、长周期负载测试或同预算的多轮Agent评测。所以,对“总体体感是否一样好”,本次证据仍然不足。已经能确认的是:题目类型、输出格式、请求预算和服务链路,会使实际体验与单一榜单顺序不同。
谁更新更快?发布数量与能力突破分开看#
以下统计的是 AA覆盖样本中的独立发布版本,不是两国所有模型的完整发布普查。一个版本的多个推理档位只算一次。刷新前沿按发生提升的日期计数,同日多个版本不重复算多次。
| 2026年月度 | 中国发布版本 | 美国发布版本 | 中国刷新前沿日期数 | 美国刷新前沿日期数 |
|---|---|---|---|---|
| 2026-01 | 5 | 4 | 1 | 0 |
| 2026-02 | 9 | 7 | 1 | 1 |
| 2026-03 | 12 | 9 | 0 | 1 |
| 2026-04 | 16 | 15 | 3 | 2 |
| 2026-05 | 6 | 4 | 0 | 0 |
| 2026-06 | 6 | 7 | 1 | 1 |
| 2026-07 | 5 | 10 | 2 | 2 |
| 2026-08 | 11 | 10 | 1 | 0 |
| 2026-09 | 8 | 13 | 1 | 3 |
| 2026-10(截至29日) | 5 | 10 | 2 | 1 |
2026年1月1日至10月29日,样本中中国发布 83个版本,美国 89个。最近90个日历日(8月1日至10月29日,首尾均计入),分别为 24个与33个,但两组各只有 4个日期刷新自己的Progress前沿。发布得更多,不自动意味着最高能力提升得更多。[2]
截至本次快照,中国最近一次刷新前沿是 10月23日的Kimi K3.1 Pro,美国是 10月28日的Gemini 4 Carbon。数据采集于10月29日,不能把采集日称作模型更新日。AA API没有提供每个模型完整的历史评分变更日志;我们也不臆造该字段。
如何复算,以及下一轮如何验证“体感”#
本次在编辑部研究归档中保留了AA四页API响应、公开趋势图表数据、归并后的517行CSV、统计脚本、任务真值、全部112次调用及摘要。正式博客里的统计只来自这些冻结记录。来源为 Artificial Analysis;聚合计算和Crazyrouter路径实测由本文完成。
核心计算可以用以下伪代码理解:
# 同一快照、同一指标版本;release_id来自AA,不根据名称猜测。
release_score = max(non_null_scores_for_each_release)
baseline = progress_score_of_opus_4_8_max
above_baseline = release_score > baseline
frontier_at_date = max(scores_of_releases_available_by_date)
gap_at_date = us_frontier_at_date - cn_frontier_at_date
例如,订单提取任务的Opus 4.8响应ID为 msg_011CgWecKv2YBwoHYumCeURh,HTTP 200且正常结束;原答案是正确JSON外包代码围栏,严格判失败、格式敏感性检查判通过。Kimi鉴权失败的请求ID为 608ccc90b353423d036dca779cafcc37。这两个记录分别说明“拿到结果但格式不符”和“未得到模型答案”的区别。
以下示例重放一项业务规则任务,API Key只从环境变量读取,端点不带UTM:
import os
import requests

response = requests.post(
    "https://cn.crazyrouter.com/v1/chat/completions",
    headers={"Authorization": "Bearer " + os.environ["CRAZYROUTER_API_KEY"]},
    json={
        "model": "claude-opus-4-8",
        "messages": [{"role": "user", "content": "未拆封且签收次日起7日内可退款;第7日包含在内。A在2026-10-20签收,2026-10-27申请退款,无质量缺陷。只输出JSON,键eligible为布尔值。"}],
        "reasoning_effort": "high", "max_tokens": 8192, "stream": False,
    },
    timeout=(15, 180),
)
response.raise_for_status()
print(response.json())
这是正文的简化复现示例,不是112次正式测试中的完整原题。完整8道题、判分脚本与原始记录由编辑部归档;本文未提供完整原始研究包的公开下载。没有用此简化题追加或替代正式成绩。
这里的 available_by_date 仅指发布日期不晚于该天,不保证当日有公开API。缺分不填零,不把一分当作固定百分比。两国国别沿用AA研发机构标签,Google归入其标记的美国组,不以服务器位置或员工国籍划分。[1][3]
下一轮如果要真正检验“体感等效”,建议先固定三类目标用户任务与可接受差异,再进行匿名、随机左右顺序的配对盲评。主指标应包含任务完成质量、重大错误、人工返工和偏好;调用失败率单列。等效界限与样本量在看结果前确定,按任务聚类分析。不能用“没有检验出显著差异”当作“体验相同”。
接下来,这个系列准备研究什么?#
本篇先回答“分数差距、旧旗舰门槛与实际交付有什么不同”。后续将按能力类型分篇,分别使用适合该任务的基准、固定预算和真实API测试,不把不同模态的分数拼成一个“国家总分”。以下为选题规划,后续专题尚未发布。
| 篇章 | 拟定主题 | 重点回答的问题 |
|---|---|---|
| 第一篇 · 文本模型 | 跨过旗舰门槛之后,日常任务还差多少? | 中文写作、结构化输出、长文档、事实性与人类盲评的差距 |
| 第二篇 · 编程与Agent | 会回答,是否也能把事情做完? | 代码修改、测试通过、工具调用、多步骤任务、预算内完成率 |
| 第三篇 · 图像模型 | 好看之外,谁更能按要求出图? | 文生图、图像编辑、中文文字、主体一致性与多次生成稳定性 |
| 第四篇 · 视频模型 | 单帧惊艳之后,动作和叙事能否成立? | 文生视频、图生视频、运动与物理一致性、角色连续性、成片等待 |
| 第五篇 · 语音模型 | 听得准、说得自然、对话跟得上吗? | 语音识别、语音合成、实时语音分别测量,兼顾口音与延迟 |
| 第六篇 · 向量与重排 | 知识库效果的差距,究竟在哪里? | 中文与跨语言检索、长文档、Recall@k、nDCG、重排增益和索引成本 |
| 第七篇 · 综合选型 | 同样预算下,怎样组合不同模型? | 把前述实测汇总为具体场景的质量、等待、成本与可靠性选择 |
每篇都会保留“谁在前沿、谁跨过实用门槛、差距是否影响真实任务”三个问题,但门槛由该模态的参考模型或业务验收条件定义。例如,Opus 4.8可以作为本篇的文本参考,不能成为图像、语音或向量模型的通用门槛。
常见问题#
中美AI模型真实差距到底有多远?#
本次快照中,美国在AA Intelligence v5前沿领先13.4分;同一Progress v1标尺上的前沿差距为10.94分。二者测量目标不同,都不能直接换算成能力百分比或用户满意度差。
差距是否越来越大?#
当前回溯数据不支持“持续扩大”。2026年9月底分差27.61,10月29日为10.94,中间随新模型发布明显收窄。但前沿追近不等于头部梯队已经一样厚。
多少中国模型已经超过Opus 4.8?#
按Progress v1、独立发布版本、严格高于Opus 4.8(max)计数,是12个,包含历史版本。其中9个尚未被AA标记deprecated。超过评测参考门槛不保证在你的每种任务上都胜过它。
为什么不用Opus 4.8的61.4分?#
61.4来自它发布时的旧Intelligence Index;本轮v5中该模型没有总分。必须使用同一标尺比较,不能把历史分值直接套到新榜单。
中国模型是不是已经足够日常使用?#
不能仅凭国别给出统一答案。本轮部分模型能完成日常任务,但网关错误、格式差异与预算截断也改变结果。应从自己的任务与可接受失败率出发,选择具体模型及可靠调用路径。
这次测试能证明中美模型体感相同吗?#
不能。这里只做了8种合成任务、每题2次,且部分请求出现版本别名和链路问题,没有人类盲评。它展示了榜单与体验可能分离的具体原因,没有证明总体等效。
发布版本、模型配置与API名称有什么区别?#
AA的一个发布版本可能有多个推理档位;网关又可能使用别名或滚动更新到新版本。榜单计数按发布版本去重,实测则保留实际请求名与返回model字段,两者不自动一一对应。
参考资料#
- Artificial Analysis Data API:字段、分页、版本与缺值定义。本次完整采集2026-10-29,API报告Intelligence版本5。
- Artificial Analysis AI Trends:Progress、国家归属与发布版本。本次2026-10-29匿名公开页面快照;文中统计为作者对该快照的再计算。
- Artificial Analysis Progress Index v1 方法。IRT标尺、档位与历史比较的边界。
- AA Intelligence Index v5发布公告,2026-10-27。用于解释评测变化,不作为10月29日最新榜单替代品。
- AA Intelligence Index方法与版本说明。
- AA Opus 4.8发布评测,2026-05-28与当前模型页。
- Anthropic Opus 4.8官方发布页。
本文的“超过”“领先”均限定于明确标尺和已覆盖样本,不代表统计显著性。AA数据后续补测、修订或新增模型后,结果需要重新计算。