简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
Kimi K2 Thinking 使用指南 2026:开发者场景、工具调用与成本控制
一篇面向开发者的 Kimi K2 Thinking 中文指南,涵盖适用场景、对比、示例和 Crazyrouter 路由思路。
Kimi K2 Thinking 使用指南 2026:开发者场景、工具调用与成本控制#
Kimi K2 Thinking 是一个偏推理和工具调用的中文大模型工作流,适合长文分析、代码理解和多步任务。这个话题之所以持续出现在开发者搜索数据里,原因很简单:大家都在尝试把产品决策、模型质量和成本整合进同一个工作流。如果你只看营销页面,就会错过最关键的部分:这个工具在真实交付工作中的表现。
什么是 Kimi K2 Thinking?#
对团队来说,Kimi K2 Thinking 最好被理解为一种工作流决策,而不只是一个模型名称。你要选择需要多深的推理能力、系统必须承载多长的上下文,以及结果是面向人类使用还是由机器驱动。这一点很重要,因为最便宜的请求并不总是最便宜的系统。重试循环、提示词膨胀和人工清理都会带来隐藏成本。
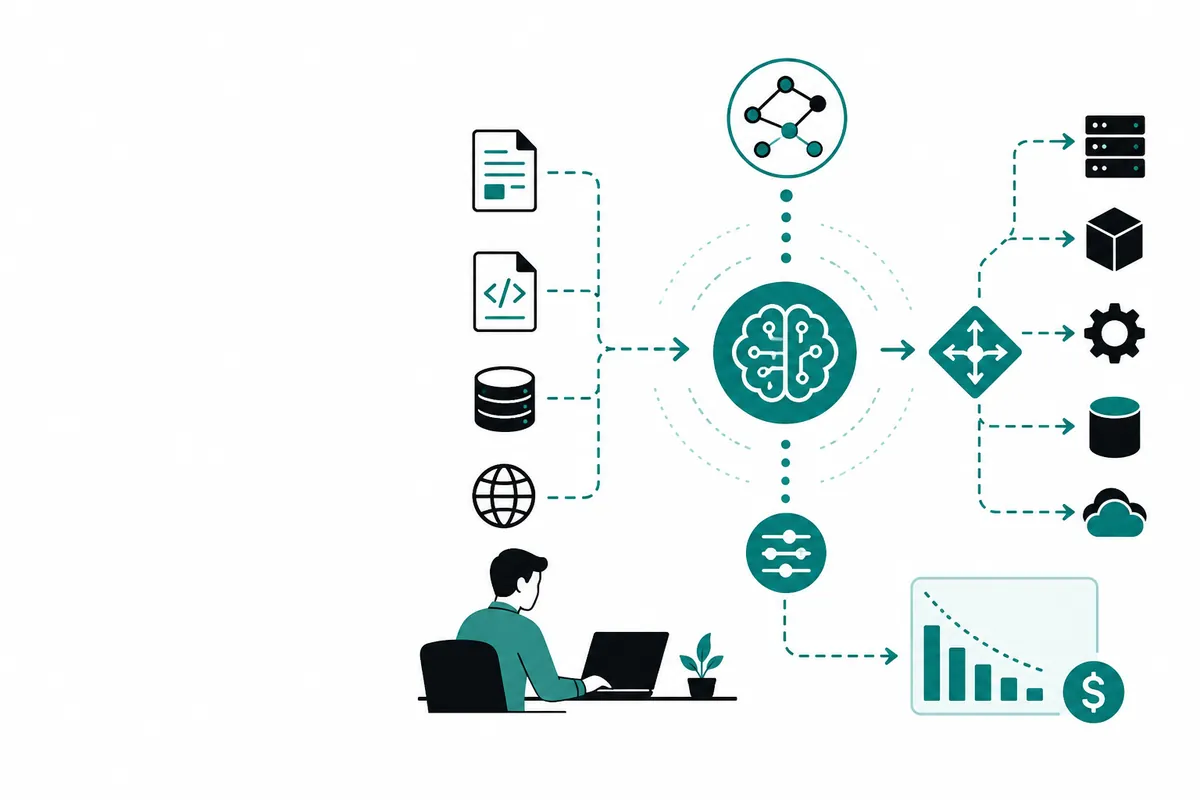
一个实用的思考模型是:在能改变结果的地方使用高阶工具,其余任务则路由到更便宜的默认方案。这也正是许多团队把 Crazyrouter 放在产品逻辑和供应商 API 之间的原因。它为回退、成本可视化和模型切换提供了一个控制平面。
Kimi K2 Thinking 与替代方案对比#
与 Claude、Gemini、Qwen2.5 Omni,以及直接 API 路由相比,Kimi K2 Thinking 通常会在一两个具体领域胜出,也会在其他方面落后。错误的做法是用通用基准测试去比较所有模型。你应该基于真实任务进行比较:代码审查、规划、长上下文阅读、视频提示词优化,或结构化抽取。
如果你正在订阅工具和 API 之间做选择,可以问一个简单的问题:用户是人,还是系统?人类用户通常更偏好订阅。系统几乎总是需要 API。对系统来说,路由器通常是更好的长期决策,因为当供应商的质量或价格发生变化时,它能让你的技术栈保持灵活。
如何通过代码示例使用 Kimi K2 Thinking#
使用任何模型最干净的方式,都是让任务保持小而明确。使用一条系统指令、一条范围清晰的用户指令,以及一个明确的成功标准。这样可以避免不必要的开销,并减少异常输出。
import os
import requests

headers = {'Authorization': f"Bearer {os.environ['CRAZYROUTER_API_KEY']}"}
payload = {
    'model': 'kimi-k2-thinking',
    'messages': [{'role': 'user', 'content': 'Summarize this diff for a release note.'}]
}
r = requests.post('https://crazyrouter.com/v1/chat/completions', json=payload, headers=headers, timeout=60)
print(r.json())
const res = await fetch('https://crazyrouter.com/v1/chat/completions', {
  method: 'POST',
  headers: {
    Authorization: `Bearer ${process.env.CRAZYROUTER_API_KEY}`,
    'Content-Type': 'application/json',
  },
  body: JSON.stringify({ model: 'kimi-k2-thinking', messages: [{ role: 'user', content: 'Review this PR for regressions.' }] }),
});
console.log(await res.json());
curl https://crazyrouter.com/v1/chat/completions -H "Authorization: Bearer $CRAZYROUTER_API_KEY" -H "Content-Type: application/json" -d '{"model":"kimi-k2-thinking","messages":[{"role":"user","content":"Turn this request into a production-ready plan."}]}'
如果你正在构建更大的流水线,可以把问题拆成三个步骤:分类任务、选择模型,然后对输出进行后处理。这正是路由真正产生价值的地方。一个强健的默认配置可以是:摘要使用较小模型,常规推理使用中档模型,只有困难的边界场景才使用高阶模型。
价格拆解#
Kimi K2 Thinking 的价格应该放在上下文中理解。如果你的团队规模超出订阅模式,并开始在其他地方重复工作,那么订阅并不真的“便宜”。如果按量计费 API 能消除人工返工,或让你自动化重复任务,那么它也并不“昂贵”。
| 选项 | 成本模型 | 最佳用途 |
|---|---|---|
| 官方直接调用 | 按量计费 | 单模型应用 |
| 多供应商直连 | 分别记账 | 小团队手工切换 |
| Crazyrouter | 统一路由与预算控制 | 需要多模型回退的团队 |
最好的成本策略通常是混合式的。如果这样更简单,可以把人类实验保留在席位订阅中,但要把生产流量迁移到路由 API 路径。Crazyrouter 的价值在于,它能让你衡量高阶模型真正发挥作用的位置,而不是凭轶事经验猜测。
FAQ#
Kimi K2 Thinking 适合谁? 适合做长上下文阅读、方案整理、代码分析的开发者。
它和 Claude 有什么区别? Claude 更偏稳健推理,Kimi 更适合中文场景和本地化工作流。
Crazyrouter 能做什么? 它能帮助你在 Kimi、Claude、Gemini 之间做成本和质量路由。
总结#
如果你想把中文长上下文、推理和成本控制放在同一个流程里,可以直接从 Crazyrouter 开始。
如果你正在构建 AI 产品,真正的收益并不是选出一个单一赢家,而是构建一个能在价格、质量或延迟变化时持续适应的系统。这正是 Crazyrouter 要解决的问题。