 简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
GPT-6.1 Sol vs GPT-6 Sol:わずか1週間で更新、Claude 5.5との関係は?
GPT-6.1 SolがGPT-6 Solの公開から1週間で登場。Claude Opus 5.5・Sonnet 5.5との競争、公式評価での改善、各モデル16回のAPI実測をもとに、長期タスクの遂行能力と信頼性を検証する。
GPT-6.1 Sol vs GPT-6 Sol:わずか1週間で更新、Claude 5.5との関係は?#
GPT-6 Solの公開から1週間で、GPT-6.1 Solが登場した。このペースを理解するには、まず同時期のOpus 5.5とSonnet 5.5に目を向けるべきだと私は考えている。
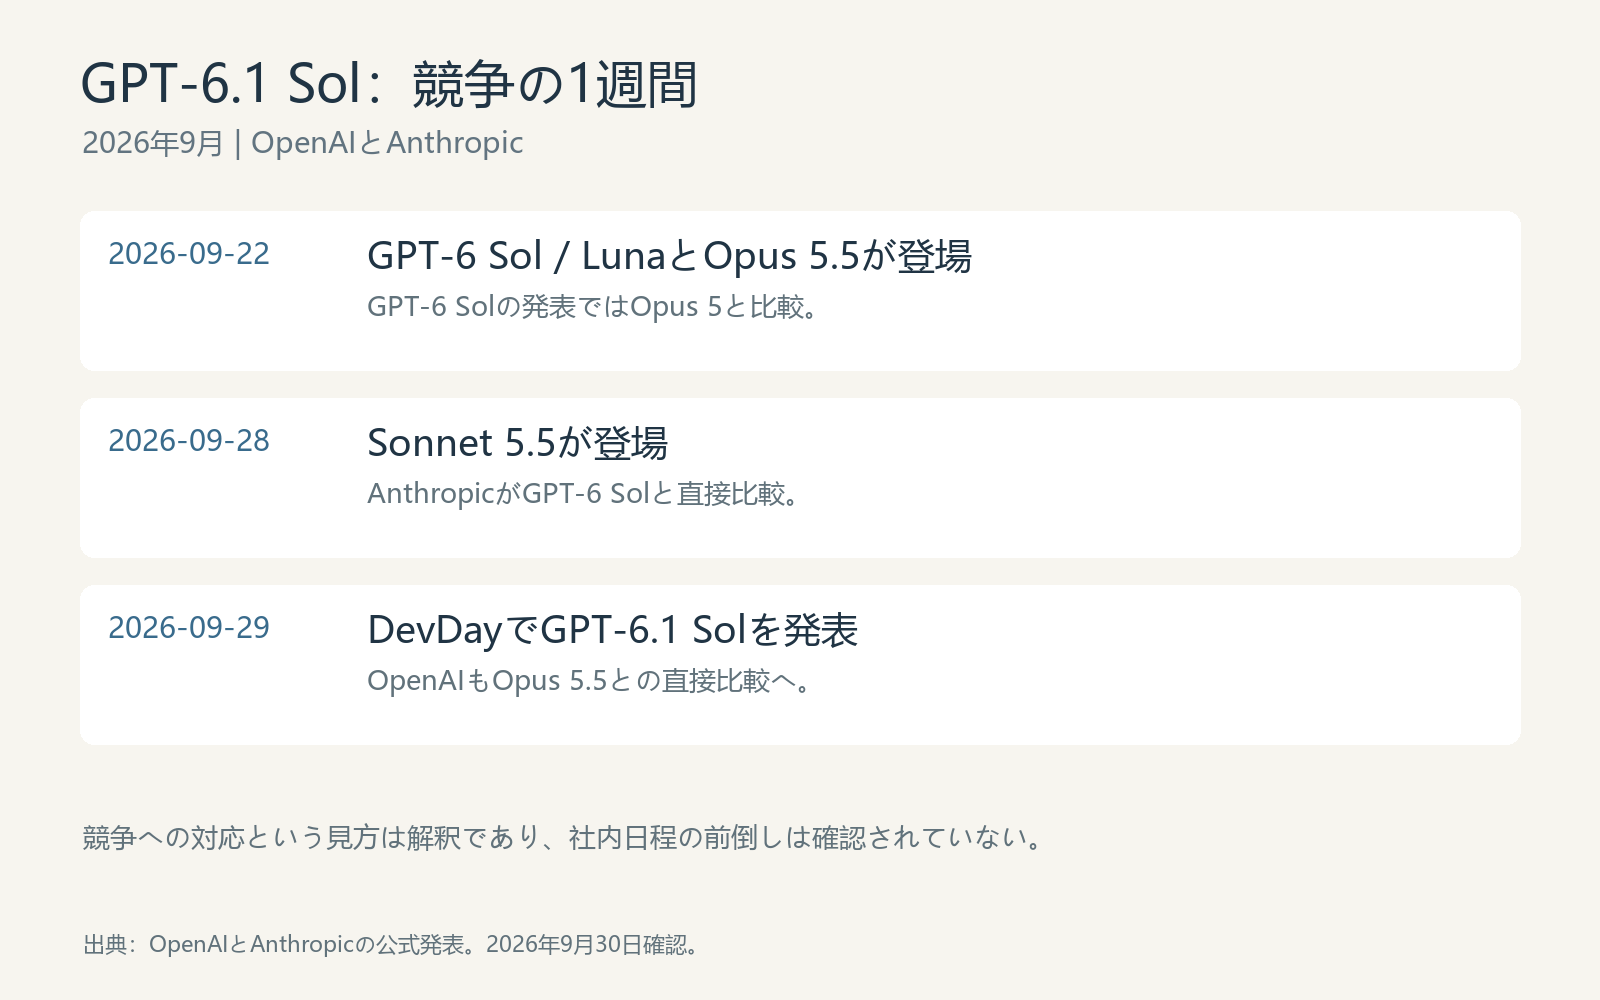
両社の発表を同じ時系列に並べると、競争の構図がはっきりする。
| 日付 | 発表内容 |
|---|---|
| 9月22日 | OpenAIがGPT-6 Sol、Lunaを発表。AnthropicがOpus 5.5を発表 |
| 9月28日 | AnthropicがSonnet 5.5を発表 |
| 9月29日 | OpenAIがDevDayでGPT-6.1 Solを発表 |
日付は両社の公式発表に基づく。[1][2][4][5] Sonnet 5.5と6.1 Solの公開は、わずか1日違いだった。
私の見立てでは、今回のリリース間隔を理解するうえで、競争圧力を第一に考えるべきだ。Opus 5.5は複雑な仕事における比較基準を引き上げ、Sonnet 5.5はSolが狙う日常業務の主力というポジションに直接切り込んだ。DevDayは、それらへの対応をまとめて示す機会になった。
この見方を支えるのは、発表時期の近さだけではない。両社の発表文では、比較対象が明確に変わっている。
6 Solが登場したばかりなのに、競合はすでに次の世代へ移っていた。
9月22日の6 Solの発表では、AutomationBenchなどの評価で比較対象となっていたのはOpus 5だった。ところが6.1 Solの発表では、OpenAIは、AutomationBenchで6.1 Solが推論強度mediumでOpus 5.5を2.2ポイント上回り、GDP.pdfではテストしたすべての推論設定でフォールバック機構付きのOpus 5.5を上回ったと明記している。[1][3]
つまり6.1の発表資料は、すでに新たな問いに答えようとしていた。登場したばかりのClaudeに対し、Solはどのような実務で優位に立てるのか、という問いだ。
Opus 5.5がもたらした圧力にも、具体的な中身がある。Anthropicは、大規模なコード移行、リポジトリをまたぐタスク、専門的な分析、長時間の自律実行を発表の中心に据え、複数の評価でGPT-6 Astraと直接比較している。[4]
これはSolの位置づけに関わる問題になる。複雑なタスクには、より強力なClaudeを選べるとユーザーが考えたとき、Solはどのような理由を示せば、日々の仕事の大半を引き続き任せてもらえるのか。Astraの性能だけでは、Solに対するこの問いへの答えにはならない。
Sonnet 5.5は、この圧力をさらに強めた。AnthropicはSonnet 5.5を、範囲が明確な日常的タスク、不具合修正、文書・スライド・表の作成に明確に位置づける一方、継続的な判断が必要な、複雑で終着点の定まらないタスクはOpus 5.5に担わせるとしている。[5]
さらに直接的なのは、Sonnetの発表でGPT-6 Solを名指ししている点だ。発表ページによると、Sonnet 5.5はFrontierCodeのhigh設定で、すでに6 Solの最高スコアに並んでいる。長時間に及ぶ知識労働でも、両モデルを比較している。
**一方では複雑なタスクの到達点を押し上げ、もう一方では毎日ツールを開くときに最初に選ばれるモデルの座を争う。この2つの発表は、Solに立て続けに圧力をかけた。**ここで引用しているのは両社の発表ページに記載された評価結果であり、これらを組み合わせて、同一条件によるメーカー横断の総合順位を作ることはできない。
普段使うモデルの座には、継続性もある。ユーザーがあるモデルに合わせてプロンプト、成果物の確認方法、ツールの利用手順を調整すると、その後のタスクも同じモデルに任せやすくなる。つまり競争が起きるのは、ユーザーが主力を選び直すタイミングだ。今回、より多くの仕事を引き受けられたモデルほど、次も標準の選択肢になりやすい。
このことは、「6 Solを出したばかり」が必ずしも待つ理由にならないことも説明している。バージョンの新旧は自社のカレンダーで決まるが、競争上の立ち位置は、同じ時期に他社が何を提供したかで決まる。ユーザーがツールを比較し直しているとき、すでに提供可能な改善を備えたバージョンがあるなら、早く投入する外的な動機が生まれる。
私は6.1 Solを、この競争に対する素早い応答と捉えている。確認できるのは、発表の順序、明確に更新された比較対象、そして強化する能力の方向性の重なりだ。OpenAIがそのために社内のリリース日程を前倒ししたかどうかについては、公開された証拠はない。
DevDayの意義は、この応答を実際の仕事につなげる環境もそろったことにある。
同日に提供されたCodex Cloudの再利用可能な開発環境と、Agents APIのコンピューター操作機能は、どちらもモデルが直接実行できるタスクの範囲を広げるものだ。[2] 一方、6.1 SolはChatGPTの作業機能、Codex、APIから利用でき、当時は通常のチャットには提供されていなかった。[3]
モデルの能力と実行環境が同時に進化してこそ、ユーザーは発表された改善を実務に持ち込める。環境が整うほど、モデル自身が問題の所在を突き止め、フィードバックを読み取り、方針を修正できるかどうかが、最終的な成果物を左右する。
だからこそ、今回注目すべき能力の変化は、競合が強調している方向と大きく重なる。**複雑な仕事の完成度、継続して実行する能力、そして実行中に失敗しても制御可能であることだ。**ここからは、6.1が6 Solに対してどこまで改善したのかを見ていきたい。
最も重みのある証拠は、旧版が推論強度を最大にしても、新版のより低い設定に及ばなかったことだ。
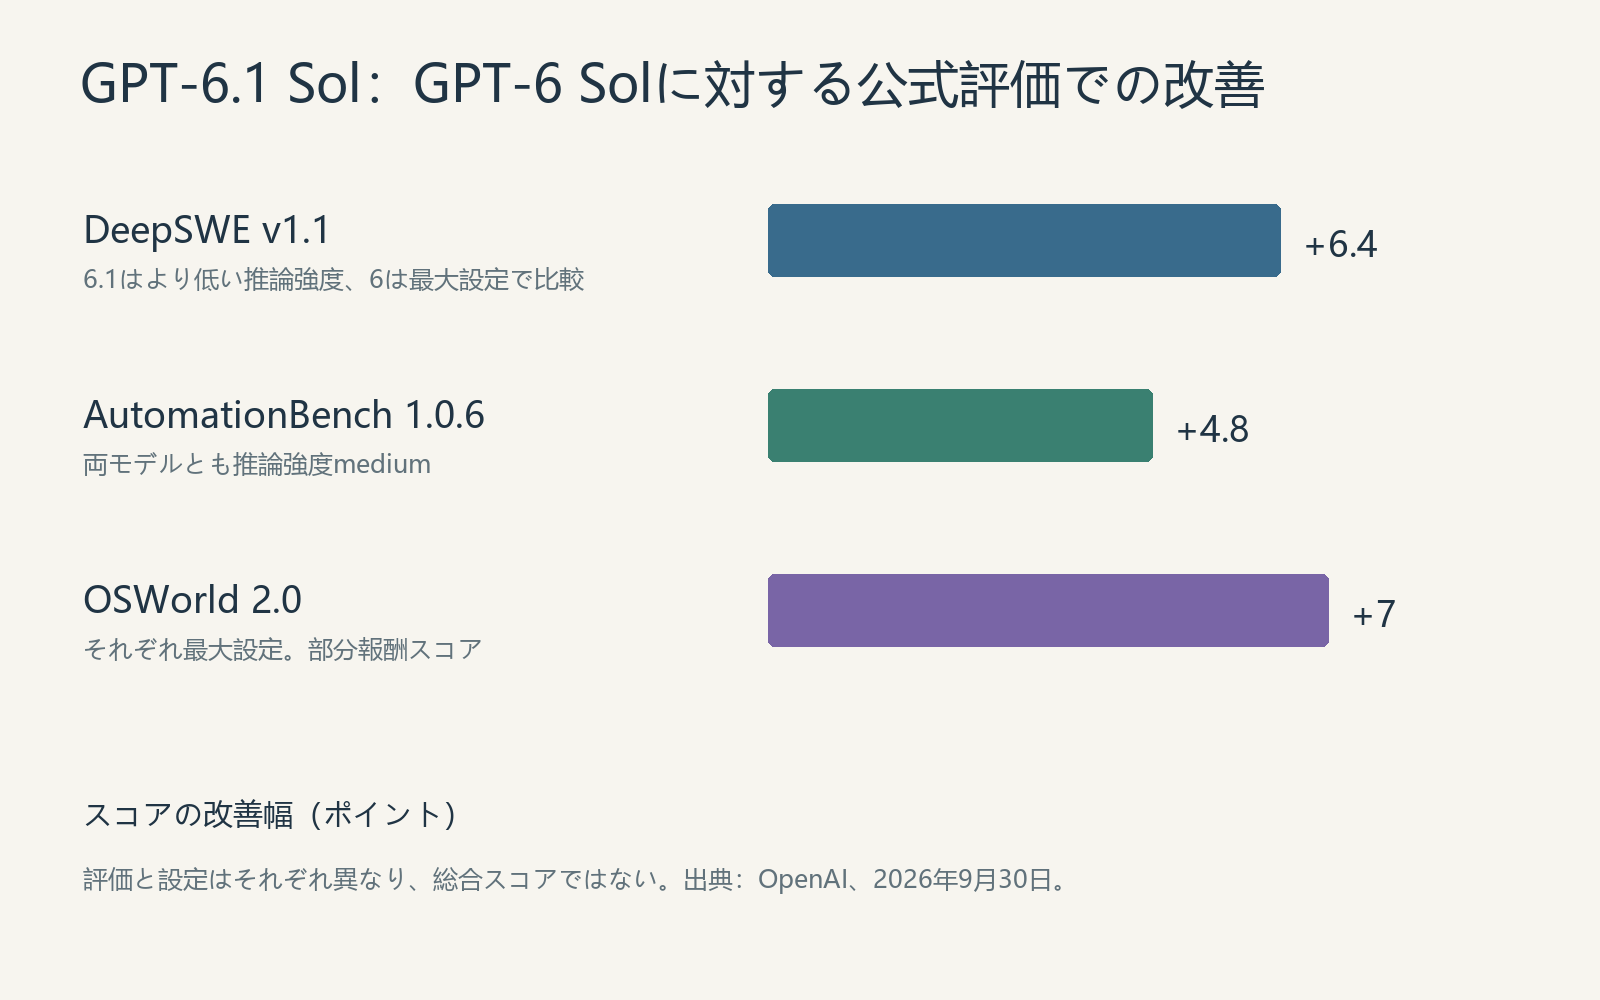
DeepSWE v1.1では、6.1 Solはより低い推論強度で、6 Solの最高スコアを6.4ポイント上回った。課題は実際のコードリポジトリに由来し、長期的な計画と実行を必要とする。[3]
この比較は、非常に実践的な問いに関わっている。難しい問題に直面したとき、旧モデルの推論強度を上げ続けることで、どこまで補えるのか。
実際のリポジトリでは、進め方の選択によって失敗することがある。たとえば、不具合のあるモジュールを誤って特定し、その誤認を前提としたテスト一式を書いてしまう場合だ。あるいは局所的な問題を修正する際に、プロジェクトがもともと求めている互換性の制約を見落とすこともある。その道筋のまま細かく考えを重ねても、方向の間違った修正を提出する可能性は残る。
DeepSWEの結果は、少なくともこの評価では、6.1の改善が、6 Solの推論強度をさらに上げて得られる範囲を超えていることを示している。**行動の選択やフィードバックの活用の質に、より注目する理由がある。**ただし、この評価はそれぞれの能力がどれだけ寄与したかを分離しておらず、具体的な学習方法も公開されていない。
もう1つの証拠がAutomationBenchだ。同じ推論強度mediumで、6.1 Solは4.8ポイント改善した。これにより、「改善はすべて、モデルに長く考えさせた結果だ」という説明は成り立ちにくくなる。
主なデータを並べると、共通する方向性が見えやすい。
| 公式評価 | 6 Solに対する6.1 Solの変化 | 対象タスク |
|---|---|---|
| DeepSWE v1.1 | より低い推論強度で旧版の最高スコアを6.4ポイント上回る | 実際のリポジトリでの長期的なソフトウェアエンジニアリング |
| AutomationBench 1.0.6 | 同じmedium設定で4.8ポイント改善 | 47種類のツールを使う業務ワークフロー |
| OSWorld 2.0 | それぞれの最大推論強度で7ポイント改善 | 長時間に及ぶコンピューター操作。オフライン評価セットv2026.08.08、指標は部分報酬スコア |
| Terminal-Bench Science 0.1 | 最大推論強度で、スコアが旧版の2倍超 | コードとターミナルを用いた科学研究ワークフロー |
これらのタスクは、プログラミング、業務、デスクトップ操作、科学研究にまたがるが、いずれも同じサイクルの反復を求める。現在の状態を理解し、行動し、フィードバックを読み取り、次の行動を調整する、というサイクルだ。
このサイクルでは、誤りが後続の入力まで変えてしまう。ツールの結果を一度読み違えると、その後の数ステップが誤った状態認識に基づいて進む可能性がある。間違ったファイルを変更すると、新たなエラーを生み、調査をさらに誤った方向へ進めかねない。したがって、長いタスクの難しさには、軌道から外れたことに気づき、適切なタイミングで修正することも含まれる。
これが、私が6.1の進化を捉えるうえでの核心だ。**複数のベンチマークがそろって改善したことは、継続的な実行で対応できる範囲が広がった可能性を示している。**これらの結果だけでは、計画、フィードバックの理解、誤りの修正がそれぞれどれだけ寄与したかまでは分からない。それでも、単独の難問での成果より、この見方を強く支える材料になる。
発表で強調された複雑なPDFの扱いも、この文脈で理解できる。GDP.pdfには、表、グラフ、模式図、小さな文字で書かれた細部が含まれる。実務で表の脚注にある適用条件を見落とせば、その後の分析が整然としていても、最初から誤った根拠の上に成り立っている可能性がある。
文書理解は、一連の作業の入口だ。その後モデルがどの問題を扱うことになるのかを決める。公式発表ではこの方向が強調されているが、本文には、6から6.1へのPDF処理の改善幅として直接引用できる数値は示されていない。
もう1つ、見過ごされがちな改善が、システムから失敗を把握できるかどうかだ。
公式発表は、信頼性に関する2種類のデータを公開している。難しい対話では、xhighで事実誤認を含む回答の割合が4.5%から4.1%に低下した。検索ツールの障害テストでは、最大推論強度で障害を報告しなかった割合が4.9%から2.1%に低下した。いずれも、意図的に選び出した難しいサンプルを用いている。[3]
これも両社が競う能力の範囲に入る。Opus 5.5の発表でも、許容範囲を逸脱する行動の削減を強調し、より長いタスク、完遂できないタスク、実際の事故に即した状況をアラインメントテストに組み込んでいる。[4] 両社のテスト条件は異なるが、仕事を委ねるユーザーの同じ懸念に答えようとしている。障害にぶつかったモデルは、どう行動するのか。
ある業務フローを考えてみたい。モデルは後続の処理を決めるために、最新の方針を調べる必要がある。検索に失敗した後、資料を取得できなかったと明確に報告すれば、システムには再試行する、情報源を変える、人に引き継ぐといった対応の余地が残る。
一方、確認済みに見える回答をそのまま出せば、後続の処理は通常どおり進んでしまう可能性が高い。1回の検索障害が利用可能な根拠に姿を変え、最終成果物にまで入り込むおそれがある。
明らかになった失敗には、修復の入口が残る。隠された失敗は、修正の仕組みが作動するきっかけを失わせる。
したがって、ツールを呼び出せるモデルにとって、「正直さ」には具体的なエンジニアリング上の意味がある。いつ続行し、いつ止まり、いつ上位の判断に委ねるべきかをシステムが判断できるかどうかに関わるからだ。
6.1のこのデータだけでは、業務フロー全体の信頼性が向上したとは証明できず、再試行がうまくなったとも言えない。ただし、信頼できる実行を支える前提の1つは改善している。続行に必要な根拠が足りないことを、モデルが認めるかどうかだ。
これとつながるのが、発表で触れられた制約の遵守と、許可されていない結果の削減である。実行が長くなるほど、モデルにはこれらの境界を保ち続けることが求められる。タスクを完遂する能力と、続行してはいけない場面を理解する能力。その両方が、どこまで自律性を任せられるかを決める。
ただし、私自身の比較テストでは、新版が全面的に優位という結果にはならなかった。
私は以前、GPT-5.6 Solを長く主力にしていたが、最近GPT-6 Astraに切り替えた。そのため今回の比較には、実際の判断もかかっている。Solの進歩は、手元の仕事の割り振りを見直すほどのものなのか。
9月30日、私はCrazyrouterのOpenAIモデル接続サービスを通じ、同一のゲートウェイ経路から両モデルに同じ問題とシステムプロンプトを送った。設定はreasoning_effort=high、出力上限8192トークンに統一した。8種類のタスクをそれぞれ2回ずつ実行し、主テストは計32リクエストとした。結果は初回のものをそのまま採用した。
| 今回の実測 | GPT-6 Sol | GPT-6.1 Sol |
|---|---|---|
| 送信したリクエスト | 16 | 16 |
| 完全な回答を受信 | 16 | 14 |
| 問題全体に正解 | 16 | 13 |
| 回答を受信したが誤りあり | 0 | 1 |
| 約240秒待機後にタイムアウト | 0 | 2 |
| 全試行の完了時間の中央値 | 21.52秒 | 18.13秒 |
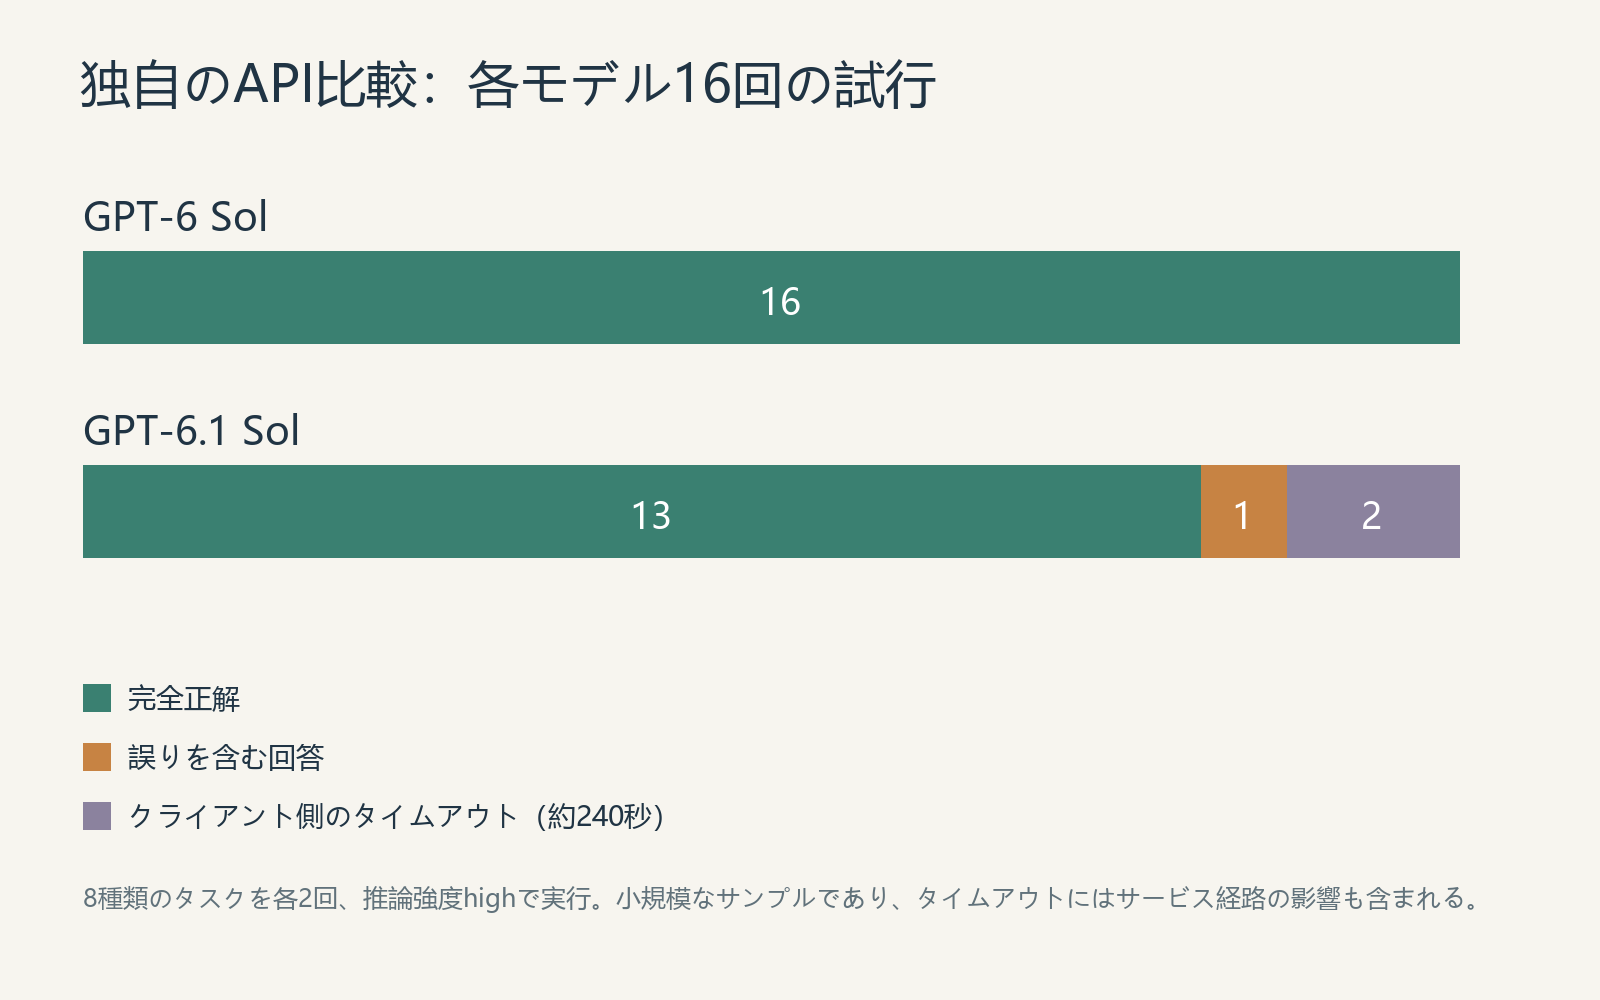
6.1の誤りは具体的だった。資料中で条件に合う項目は実際には72件あったが、71件と数えた。質問に含まれる誤った前提には気づいていたものの、それでも1件を数え落とした。2回のタイムアウトは、それぞれ長い表からの検索と制約求解で発生した。同じ問題のもう1回の試行では、どちらも合格した。
小規模な関数を作る2問では、両モデルとも非公開のチェックをすべて通過した。追加で1回実施した、2ターンの読み取り専用ツールフローでも、両モデルとも合格した。
この結果は、私に次のことを再認識させた。主力を替えられるか判断するには、これまで自分が引き取る必要のあった工程まで評価に含めなければならない。
2問の関数課題に境界条件のアサーションを数百件追加すれば、コードの正しさをより厳密に検証できる。しかし、モデルが自律的に問題を特定し、リポジトリの制約を理解し、実行結果に応じて方針を変える機会が増えるわけではない。短いツールフローでも、十数ステップ実行した後に状態を見失うような失敗は表面化しにくい。
したがって今回の実測は、「新版にも数え落としがあり、このサービス経路でタイムアウトが発生した」という記録を残すには十分だが、公式が主に強調する長期タスクの遂行能力には踏み込めていない。現在の主力であるAstraを、すぐに6.1 Solへ替えるだけの根拠も得られなかった。
速度も、成果物とあわせて見る必要がある。6.1は待ち時間の中央値が短かった一方、今回は結果が返らなかったリクエストが2回あった。目的が受け入れ基準を満たす修正を得ることなら、初回応答までの時間は全工程の一部にすぎない。手戻りや人による引き継ぎも、最終的な所要時間を変える。
今回のリクエストは並行実行し、キャッシュ条件は統一していない。計測時間にはゲートウェイと上流サービスの影響が含まれる。また、両モデルで共通して使った別の経路でもタイムアウトが発生した。ここで記録しているのはサービス経路上の観察であり、これをもって6.1そのものがタイムアウトしやすいとは判断できない。
私にとって、次に最も比較したいのは、同じ実務タスクでモデルを何回軌道に戻す必要があるかだ。
たとえば、明確な受け入れ基準のあるリポジトリの不具合を使う。問題の説明だけを渡し、モデル自身に原因の特定、修正、テストの実行、変更の提出まで任せる。同じ環境と権限の下で、自力で受け入れ基準を満たせるか、人による修正指示が何回必要か、失敗しても作業を進められるか、検証せずに完了を宣言していないかを比較する。
これなら「モデルが強くなった」を、観察できる変化に落とし込める。これまで私が補っていた判断を、今度はモデル自身でできるのか、という変化だ。
6 Solは、すでにエージェント型のプログラミングと専門的な仕事を主力機能としていた。6.1 Solは、難しい実行タスクでの性能をさらに高め、実行の失敗を隠してしまう行動の一種を減らしている。日常的に使い込むユーザーにとっては、この2つの変化が組み合わさって初めて、主力モデルの交代につながる可能性がある。
「わずか1週間で更新」という話に戻ると、私はOpus 5.5とSonnet 5.5からの競争圧力を、最も有力な外的要因と捉え、DevDayをまとめて提供する機会と見ている。この見方を支えるのは、両社がすでに発表資料で互いを直接比較していること、そして6.1の改善が、競合と争っている実務能力に集中していることだ。
この競争で最終的に争われているのは、ユーザーが次にプログラミングツールを開き、専門的なタスクを任せるときの、標準の選択肢となる座だ。私にとって6.1がその座を得られるかどうかは、これまで何度も修正を促す必要があった仕事を引き受けられるかにかかっている。軌道を外れる回数が1回減ること、終わっていないのに完了と報告する回数が1回減ることのほうが、バージョン番号より説得力がある。
出典とテストに関する補足:
[1] OpenAI:「GPT-6 SolとLunaのご紹介」。公式サイトの公開日は2026年9月22日。
[2] OpenAI:「DevDay 2026を振り返る」。2026年9月29日。本文でGPT-6.1 Solを発表。
[3] OpenAI:「GPT-6.1 Solのご紹介」。本記事は2026年9月30日に取得した公式本文に基づく。
[4] Anthropic:「Claude Opus 5.5のご紹介」。2026年9月22日。
[5] Anthropic:「Claude Sonnet 5.5のご紹介」。2026年9月28日。
実測にはhttps://api.crazyrouter.com/v1/chat/completionsを使用した。主テストでは経路266に固定し、通常版のモデルを使用した。コードのチェックはモデルごとに計496項目で、2問の関数課題それぞれの2回分の出力に対するものであり、独立したタスクの数ではない。今回の小規模なサンプルでは公式ベンチマークを再現しておらず、実際のリポジトリでの長期的な開発、コンピューター操作、複雑なPDFも対象に含めていない。公式スコアは改善の方向性を分析するために用い、独自の実測記録は今回実際に得られた成果を示すために用いている。