 中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
Como usar o JEV 1.13? Da triagem ao roteamento de Agents
O JEV 1.13 transforma linguagem natural em escolhas, probabilidades e pontuações utilizáveis por programas. Veja Choice, Noul e Score em casos de atendimento, reembolso e RAG, e teste 12 cenários editáveis no Crazyrouter.
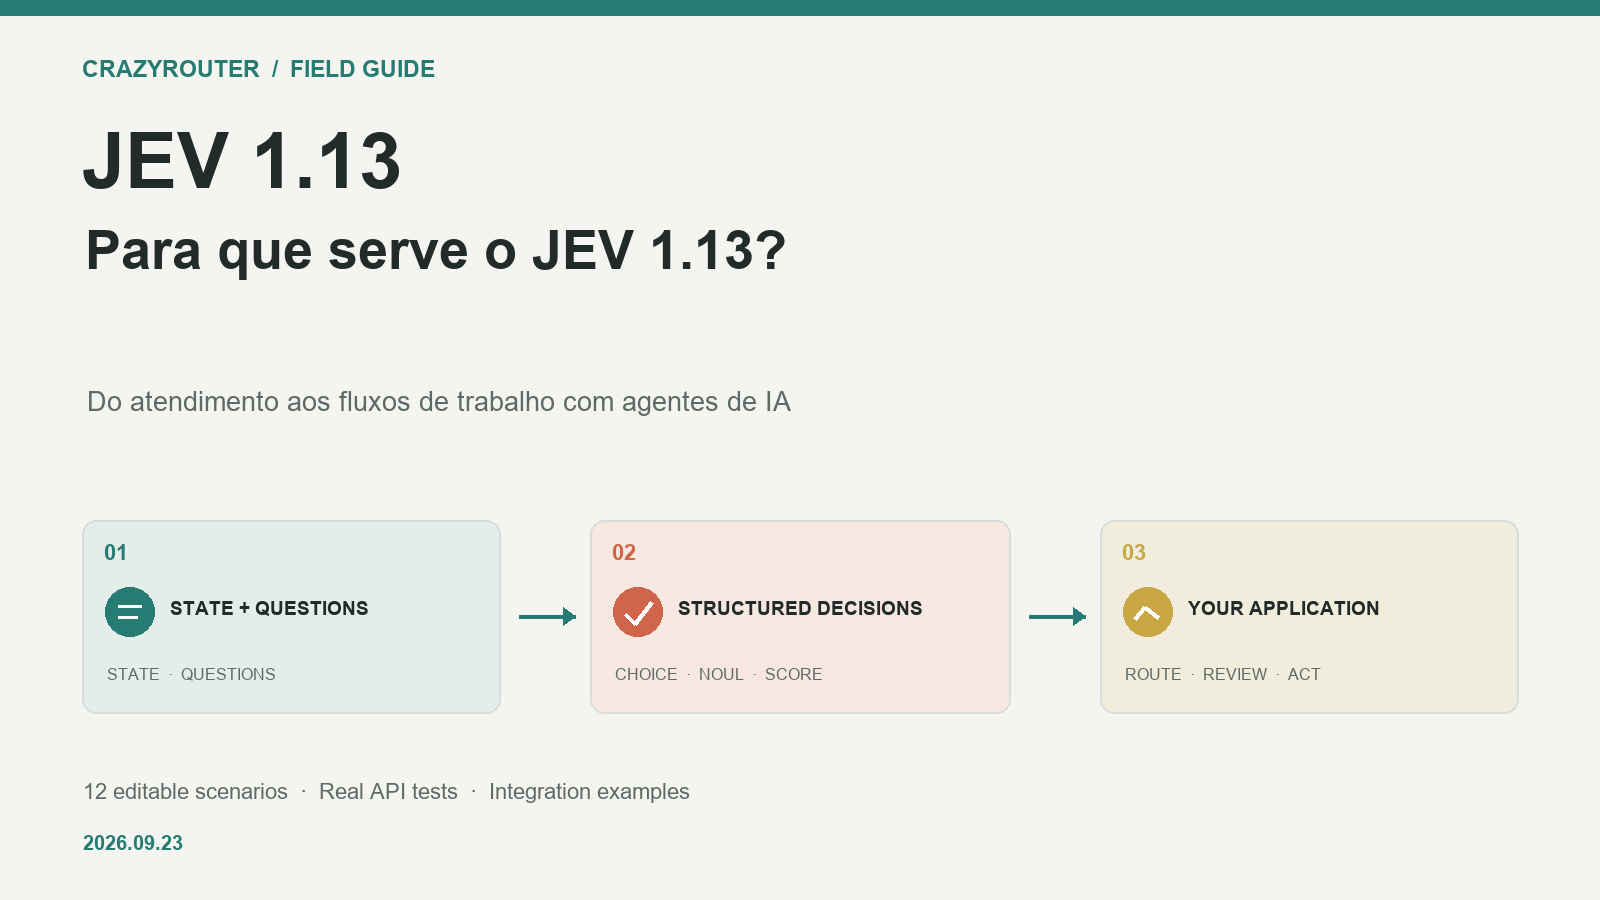
Como usar o JEV 1.13? Do roteamento de atendimento ao roteamento de Agents: testes práticos com este modelo de decisão de baixo custo#
“Um cliente disse que não consegue concluir o pagamento, e isso já está afetando as operações. Para quem este ticket deve ser encaminhado? É urgente? Como está o estado emocional do cliente?”
Esta é uma tarefa pequena bastante comum em produtos de IA. No fim, talvez você precise de apenas três campos: technical, uma probabilidade de urgência e um nível de sentimento. Esses campos determinam para qual fila o ticket deve ser enviado, em que posição ficará e se é necessário priorizar o atendimento humano.
O JEV 1.13 é especialmente bom nesse tipo de julgamento com limites bem definidos. Você fornece o contexto e os critérios de avaliação, e ele retorna uma escolha, uma probabilidade ou uma pontuação que o programa pode ler diretamente.
Recentemente, surgiram muitas apresentações sobre o JEV: algumas falam sobre o “System One”, outras sobre baixo custo e decisões ultrarrápidas, e algumas o integram a fluxos de trabalho de Agents. Para quem quer começar, o mais importante é entender quais tarefas ele consegue assumir e como verificar se ele realmente é adequado ao seu negócio.
Este artigo começa explicando o modelo, depois mostra como abrir o [Crazyrouter JEV Decision Playground]playground para experimentá-lo na prática e, por fim, apresenta exemplos em Python que podem ser chamados diretamente. Os testes do artigo foram realizados pelo Crazyrouter em 23 de setembro de 2026; tanto os casos bem-sucedidos quanto os timeouts foram mantidos.
O que é o JEV 1.13? Lembre-se destes três tipos de saída#
O JEV é um modelo de decisão desenvolvido pela TypeSafe AI. Oficialmente, a empresa chama esse tipo de modelo de System One Models: ele lê o estado atual e realiza rapidamente classificações, julgamentos e avaliações, fornecendo ao software uma base de decisão executável.
Sua entrada é composta principalmente por duas partes:
state: fatos de contexto. Pode ser uma mensagem de atendimento, um documento ou um objeto JSON que contenha o status de um pedido.questions: as perguntas que você quer avaliar. Cada pergunta especifica o tipo, as instruções de avaliação e as opções ou os critérios de pontuação necessários.
Os três tipos de pergunta mais importantes são:
| Tipo | O que perguntar | O que retorna | Usos comuns |
|---|---|---|---|
| Choice | Qual opção deve ser escolhida? | Opção, probabilidade de cada opção e confidence | Classificação de tickets, seleção de ferramentas e roteamento de solicitações |
| Noul | Esta afirmação é verdadeira? | Probabilidade de “sim”, no intervalo de 0 a 1 | Verificar se é urgente, se é relevante ou se precisa de escalonamento |
| Score | Em que nível a situação se encontra segundo os critérios fornecidos? | Pontuação numérica, probabilidade de cada nível e confidence | Gravidade, qualidade do conteúdo e adequação do lead |
Os três tipos de pergunta podem ser incluídos na mesma solicitação. Por exemplo, é possível avaliar simultaneamente “qual departamento deve tratar o caso”, “se ele é urgente” e “o nível de sentimento” de um ticket de atendimento. Os três resultados retornados ficam disponíveis diretamente para o código.
Atualmente, o JEV aceita entradas em formato de texto, incluindo objetos e arrays compostos por texto; ele não recebe imagens, áudio ou vídeo diretamente. Tarefas como redigir respostas, escrever artigos e gerar código continuam sendo mais adequadas para modelos generativos. Esses limites de capacidade estão descritos claramente na documentação do System One da TypeSafe.
Onde ele se destaca? Automatizando julgamentos pequenos que valem a pena#
1. O resultado entra diretamente no programa, com menos interpretação e conversão#
Suponha que você tenha definido três departamentos: billing, technical e sales.
O resultado de Choice do JEV apresenta uma das opções e também a distribuição de probabilidades. Seu programa pode ler diretamente answers.department.choice e selecionar a fila de atendimento com base no resultado.
Modelos de linguagem de uso geral também conseguem classificar itens por meio de saídas estruturadas. O que torna o JEV interessante é ter julgamentos tipados e saídas de probabilidade como interface principal, com otimização específica para esse tipo de tarefa.
Para sistemas que processam grandes volumes diários de mensagens, documentos ou solicitações de roteamento, essa especialização tem utilidade prática: você pode definir com clareza os resultados da classificação, as condições de revisão e as ações de execução.
2. É possível fazer várias perguntas independentes de uma só vez#
Em um mesmo contexto, geralmente é possível extrair vários julgamentos:
- O que o cliente está perguntando?
- Isso afeta o uso normal?
- É necessário tratar o caso com rapidez?
A documentação oficial da TypeSafe informa que essas perguntas são avaliadas de forma independente e paralela com base no mesmo state. Assim, a camada da aplicação pode obter várias dimensões em uma única solicitação e combiná-las no código.
Há um detalhe importante de uso: as perguntas dentro da mesma solicitação são independentes entre si. Se a segunda etapa depender da resposta da primeira, o programa deve ler o resultado inicial e só então montar a solicitação seguinte.
3. O custo por entrada é muito baixo, o que favorece chamadas frequentes#
Na data desta verificação, os preços de referência eram:
| Item | Preço de referência |
|---|---|
| Entrada | US$ 0,042 / 1 milhão de tokens |
| Saída | US$ 0 |
Considerando um total de 1.000 tokens de entrada por solicitação, o custo de entrada por chamada fica em aproximadamente US 4,20.
Esse cálculo usa o preço unitário de referência. O contexto, as perguntas e os critérios consomem o orçamento de entrada; a quantidade real de tokens pode ser consultada em usage na resposta, e o valor efetivamente cobrado pelo site aparece nos registros de consumo. O preço atual pode ser conferido na lista de modelos do Crazyrouter.
Isso significa que alguns julgamentos pequenos que antes “não justificavam uma chamada específica a um modelo de linguagem maior” também podem ser incorporados ao produto: verificar se um documento é relevante, identificar o tema de um feedback ou decidir se uma solicitação deve ser encaminhada a um modelo mais poderoso, por exemplo.
4. As probabilidades ajudam a projetar ramificações de tratamento#
Depois que technical for selecionado, se a distribuição estiver muito concentrada, o programa pode fazer o roteamento diretamente; se várias opções estiverem próximas, você pode coletar mais informações, usar outro modelo ou encaminhar o caso para uma pessoa.
No entanto, confidence não deve ser tratada diretamente como taxa de acerto. Ela descreve o grau de concentração da distribuição retornada. Um retorno de 0,91 em determinado caso não significa que esse julgamento já tenha sido comprovado como correto em 91% dos casos.
A “calibração” destacada pela documentação oficial precisa ser avaliada em um conjunto de amostras com respostas de referência. Você ainda deve usar seus próprios tickets e critérios para escolher os limiares. Consulte a documentação de Confidence para obter mais detalhes.
Execute uma vez na interface web sem escrever código#
Abra o JEV Decision Playground ou acesse diretamente o playground de decisões em chinês.
A página oferece 12 cenários editáveis:
| Categoria | Cenários |
|---|---|
| Atendimento e operações | Roteamento de tickets de atendimento, decisão sobre ações de reembolso e categorização de feedback de produto |
| Negócios e risco | Classificação de leads de vendas, análise de risco de transações e aprovação de fornecedores |
| Conteúdo e segurança | Roteamento de moderação de conteúdo, detecção de tomada de controle de contas e verificação de documentos de conformidade |
| Fluxos de trabalho de IA | Avaliação de trechos de RAG, roteamento de ferramentas de Agents e classificação de incidentes em produção |
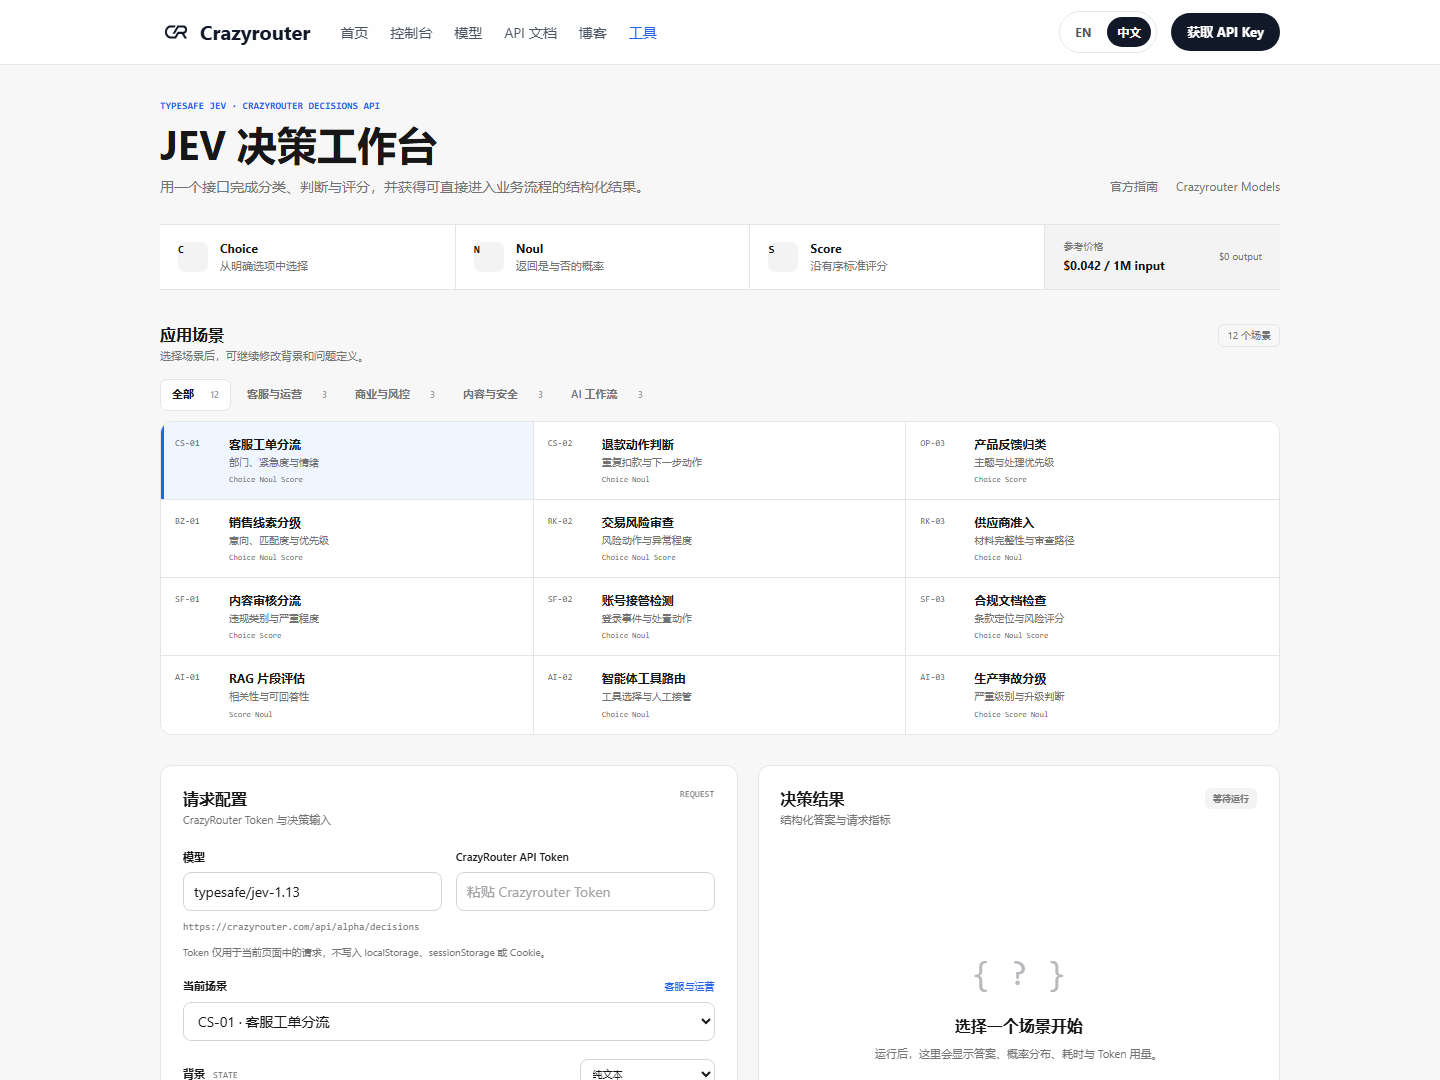
Na primeira vez, recomendamos escolher “Roteamento de tickets de atendimento” e seguir estas etapas:
- Obtenha um Crazyrouter API Token na página de gerenciamento de Tokens e informe-o no playground.
- Mantenha o cenário padrão e leia primeiro o contexto e os critérios das três perguntas.
- Clique em “Executar decisão”.
- No lado direito, consulte a escolha do departamento, a distribuição de probabilidades, a pontuação de sentimento, o tempo de execução e o consumo de tokens.
- Substitua o contexto pelo seu próprio texto, execute novamente e compare as mudanças no julgamento.
Esta operação gera custos reais de API; o fato de a saída não ser cobrada não significa que toda a chamada seja gratuita. A página informa que o token é mantido apenas na memória da página atual e não é gravado no armazenamento do navegador.
Nesta execução, o ticket padrão em chinês foi processado na página real, com os seguintes resultados:
- Departamento:
technical, com probabilidade de 0.94. - Probabilidade de urgência: 0.97.
- Pontuação de emoção: 1.01, correspondente aos três níveis “relato calmo dos fatos / insatisfação, mas com moderação / extrema irritação”.
- Tempo exibido na página: 0.70 segundo.
- Uso: 467 tokens de entrada e 73 tokens de saída.
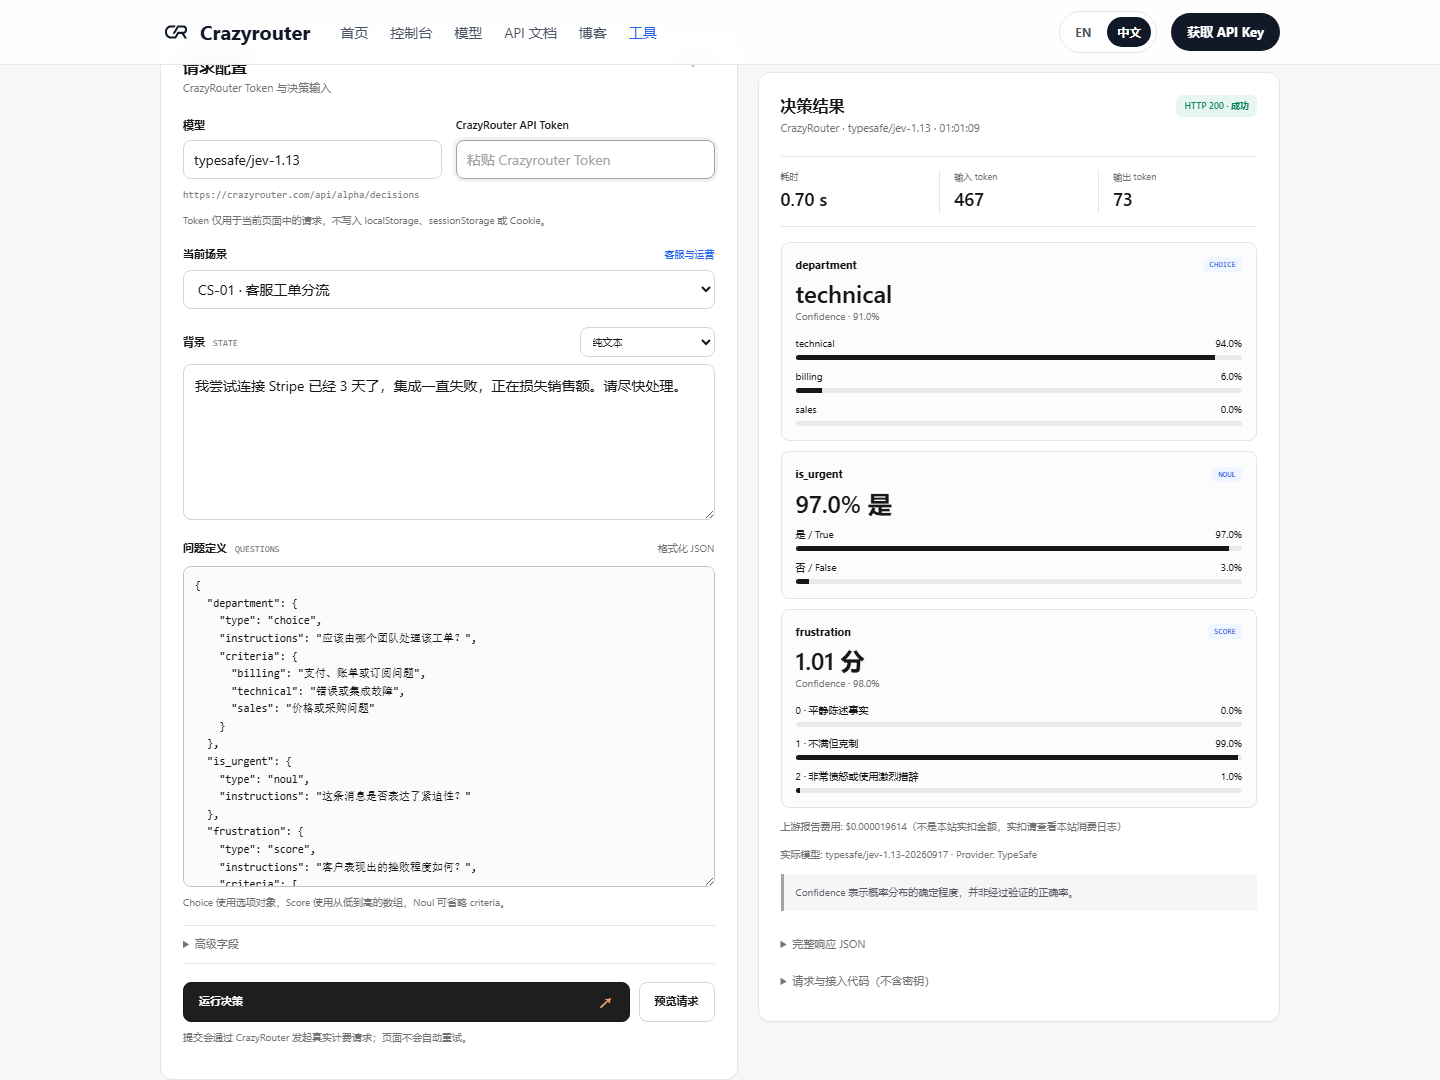
A versão retornada foi typesafe/jev-1.13-20260917. Este foi o resultado de uma chamada real pela página; ao executar novamente, as probabilidades e o tempo de resposta podem variar.
A página também oferece a opção “Visualizar requisição”, que permite consultar exemplos em JSON, cURL, JavaScript e Python. Ajustar o cenário até chegar a um resultado satisfatório e depois copiar a requisição para integrá-la ao próprio produto tende a ser mais fácil do que começar diretamente com código vazio.
Altere o contexto e veja se a avaliação muda#
Executar apenas o exemplo padrão não é suficiente para saber se o modelo realmente está sendo útil. É mais significativo manter os critérios da pergunta, substituir o contexto e observar se ele altera a resposta conforme as evidências.
Testamos 6 entradas diferentes usando o mesmo endpoint Decisions. Estes foram os registros reais:
| Entrada de teste | Retorno real | Tempo do cliente Python |
|---|---|---|
| A integração com o Stripe falhou por 3 dias e as vendas estão sendo perdidas | technical; probabilidade de urgência 0.98; emoção 1.01/2 | 1.102 segundos |
| Consulta antecipada sobre o preço da assinatura do próximo mês, deixando claro que não há urgência | sales; probabilidade de urgência 0.04; emoção 0/2 | 0.784 segundo |
| Foi confirmado que as duas cobranças do mesmo pedido foram liquidadas | refund; probabilidade confirmada de cobrança duplicada 0.95 | 0.675 segundo |
| O cliente suspeita de cobrança duplicada, mas ainda não há um extrato confirmado | Tanto a primeira tentativa quanto o novo teste atingiram o tempo limite de leitura; não foi possível obter uma avaliação | Aproximadamente 60 segundos cada |
| A documentação forneceu um exemplo do parâmetro de tempo limite para requisições em Python | Relevância 1.98/2; probabilidade de conseguir responder à pergunta 0.80 | 2.293 segundos |
| A documentação trata apenas de modelos de imagem e não tem relação com a questão do tempo limite da requisição | A primeira tentativa atingiu o tempo limite; no novo teste, relevância 0/2 e probabilidade de conseguir responder 0.01 | 5.413 segundos no novo teste |
Esses resultados permitem observar alguns pontos concretos.
A classificação de atendimento pode tratar simultaneamente do tema e do tom. Quando o contexto foi alterado de “já está afetando as operações” para “consulta antecipada de preço, sem urgência”, tanto o departamento quanto a probabilidade de urgência mudaram.
A filtragem de RAG pode separar grau de relevância e capacidade de resposta. Um trecho pode ser altamente relevante e, ainda assim, não ser suficiente para responder completamente à pergunta. No exemplo, a relevância ficou próxima do nível máximo, enquanto a probabilidade de conseguir responder foi de 0.80; as duas dimensões têm finalidades distintas.
Baixo custo não significa ausência de falhas de chamada. O caso de reembolso, que tinha evidências insuficientes, não retornou um resultado. Portanto, não atribuímos a ele a conclusão de que “o modelo escolheu corretamente investigar”, nem é possível determinar apenas pelo tempo limite se o problema ocorreu no modelo, no serviço upstream ou no caminho de rede.
Esta rodada incluiu o teste inicial, duas tentativas novamente e uma chamada pela página, totalizando 9 requisições, 6 respostas bem-sucedidas e 3 tempos limite de leitura. O custo upstream informado pelas seis respostas bem-sucedidas foi de $0.000115962; esse valor não inclui a cobrança ainda não verificada das requisições que atingiram o tempo limite e também não representa o débito completo na conta deste site.
A amostra é pequena, e as entradas são casos demonstrativos escritos manualmente. Este é um teste de introdução e conectividade; não é possível calcular uma taxa de precisão geral nem garantir a estabilidade do serviço com base nele.
Como interpretar “centenas de vezes mais rápido” e “sem alucinações”?#
O artigo oficial de lançamento da TypeSafe informa que, em suas condições de teste, a resposta de ponta a ponta ficou entre 70 e 500 milissegundos; os números de 193,6 vezes mais velocidade e 444,6 vezes mais vantagem de custo exibidos na página inicial vêm de uma avaliação de um fluxo de trabalho específico. A publicação também esclarece que esses ganhos estão na faixa mais alta observada em aplicações reais e explica como os fluxos internos e as respostas de referência foram construídos.
Esses números ajudam a entender a direção do produto, mas não podem ser aplicados diretamente à sua rede, aos seus dados e a todo o fluxo do seu Agent.
O tempo das chamadas Python que obtiveram uma resposta bem-sucedida nesta execução foi de 0,675 a 5,413 segundos; uma chamada pela página exibiu 0,70 segundo, e também ocorreram tempos limite de leitura. Esses tempos incluem o caminho de chamada entre o ambiente local, o gateway e o upstream, portanto não são a mesma métrica que o tempo de computação do próprio modelo. Nesta execução, não foi feita uma comparação de velocidade com outros modelos usando a mesma pergunta.
A afirmação “sem alucinações” também precisa ser entendida dentro de seu escopo. A publicação oficial enfatiza que os tipos de saída e o espaço de respostas predefinido são restritos: se as opções candidatas forem três departamentos, o modelo não gerará arbitrariamente o nome de um novo departamento.
Uma opção válida não significa que ela esteja necessariamente correta. O modelo ainda pode classificar incorretamente uma questão de cobrança como pertencente à equipe técnica e também pode atribuir uma distribuição de probabilidade concentrada a uma avaliação errada. Em produção, mantenha um conjunto de testes com respostas conhecidas, observe os tipos de erro e só então determine quais avaliações podem ser executadas automaticamente.
Como integrar para desenvolvedores? Use a API Decisions#
Nesta execução, confirmamos o nome público do modelo jev-1.13 em /v1/models da Crazyrouter; a página usa typesafe/jev-1.13, que também foi executado com sucesso. A resposta bem-sucedida informa a versão real analisada.
O teste desta execução usou:
Site: https://crazyrouter.com
Endpoint: POST /api/alpha/decisions
Modelo: jev-1.13
Autenticação: Authorization: Bearer <Crazyrouter API Token>
O JEV usa uma interface Decisions dedicada. Ela não serve para continuar chamando /v1/chat/completions ou /v1/responses depois de alterar model para JEV. Aqui, a resposta é um JSON síncrono e não usa saída em streaming.
A seguir está a requisição Python completa, consistente com o teste de atendimento. Primeiro instale requests e configure CRAZYROUTER_API_KEY nas variáveis de ambiente da máquina local:
import json
import os

import requests

payload = {
    "model": "jev-1.13",
    "state": "Estou tentando conectar ao Stripe há 3 dias, a integração continua falhando e estou perdendo vendas. Resolva isso o quanto antes.",
    "questions": {
        "department": {
            "type": "choice",
            "instructions": "Qual equipe deve tratar este ticket?",
            "criteria": {
                "billing": "Problemas de pagamento, cobrança ou assinatura",
                "technical": "Erros ou falhas de integração",
                "sales": "Questões de preço ou aquisição",
            },
        },
        "is_urgent": {
            "type": "noul",
            "instructions": "Esta mensagem expressa urgência?",
        },
        "frustration": {
            "type": "score",
            "instructions": "Qual é o nível de frustração demonstrado pelo cliente?",
            "criteria": ["Relato calmo dos fatos", "Insatisfação, mas com moderação", "Extrema irritação ou uso de linguagem agressiva"],
        },
    },
}

try:
    response = requests.post(
        "https://crazyrouter.com/api/alpha/decisions",
        headers={
            "Authorization": f"Bearer {os.environ['CRAZYROUTER_API_KEY']}",
            "Content-Type": "application/json",
        },
        json=payload,
        timeout=(10, 60),
    )
    response.raise_for_status()
except requests.Timeout as exc:
    raise SystemExit("A requisição atingiu o tempo limite: não foi possível obter uma avaliação. Verifique os registros da chamada antes de decidir se deve tentar novamente.") from exc
except requests.RequestException as exc:
    raise SystemExit(f"Falha na requisição: {exc}") from exc

data = response.json()
answers = data.get("answers")
if not isinstance(answers, dict) or not all(
    key in answers for key in ("department", "is_urgent", "frustration")
):
    raise RuntimeError("A resposta não contém todos os resultados da decisão. Verifique as informações retornadas pelo serviço.")

print(json.dumps(answers, ensure_ascii=False, indent=2))
print("Modelo real:", data.get("model"))
print("ID da requisição:", data.get("id"))
print("Uso:", data.get("usage"))
Os principais campos do primeiro resultado de teste real da API correspondente são os seguintes; as descrições dos níveis e parte da distribuição de probabilidades foram omitidas:
{
  "id": "gen-dec-1790095587-mts183W9F0rPWFGshpnx",
  "model": "typesafe/jev-1.13-20260917",
  "answers": {
    "department": {
      "type": "choice",
      "choice": "technical",
      "probabilities": {"technical": 0.94, "billing": 0.06, "sales": 0},
      "confidence": 0.91
    },
    "is_urgent": {"type": "noul", "noul": 0.98},
    "frustration": {"type": "score", "score": 1.01, "confidence": 0.98}
  },
  "usage": {"input_tokens": 467, "output_tokens": 73, "cost": 0.000019614}
}
Há dois campos que podem ser facilmente interpretados de forma incorreta:
Noul 0.98 é a probabilidade de “sim”. Se o programa precisar de um valor booleano, você deverá definir o limite por conta própria. 0.5, 0.8 ou 0.95 são apenas possíveis escolhas de negócio; a decisão deve considerar o custo dos falsos positivos e falsos negativos e ser orientada por amostras de validação.
Score 1.01 é a média ponderada pelas probabilidades dos índices dos níveis. No exemplo acima, os três níveis correspondem a 0, 1 e 2; por isso, o resultado está próximo de “insatisfeito, mas contido”. Score pode ser um número decimal e não adota, por padrão, uma escala percentual. Consulte a documentação oficial do Score para ver a definição exata.
Os três primeiros pontos de negócio que vale a pena testar#
Entrada do atendimento: avaliar departamento e urgência ao mesmo tempo#
Faça o JEV ler a mensagem do usuário e o status conhecido do pedido para retornar o departamento responsável, a probabilidade de urgência e a categoria das informações que precisam ser complementadas. O programa cria uma fila com base nesses resultados; a resposta pode ser produzida por um modelo generativo ou por uma pessoa.
Ao escrever as opções, procure deixar claras as diferenças entre os limites de cada uma e reserve “outros” ou “precisa de verificação adicional” para os casos com informações insuficientes. O exemplo de reembolso fornece apenas uma sugestão; o reembolso efetivo deve ser executado pelo seu sistema de negócio, de acordo com as regras aplicáveis.
Depois da recuperação no RAG: eliminar trechos que não ajudam a responder#
Depois de obter os documentos candidatos, você pode perguntar separadamente “é relevante?” e “pode sustentar a resposta?” e, em seguida, decidir quais trechos entrarão no contexto da geração final.
Se houver muitos trechos candidatos, meça o custo e o tempo de espera adicionais introduzidos pelo próprio filtro. Quanto de entrada da geração ele economiza e se há exclusão indevida de evidências importantes são questões que precisam ser validadas com dados do negócio.
Antes de o Agent chamar uma ferramenta: escolher o próximo processador#
Defina as ações disponíveis como Choice, por exemplo: “consultar pedido”, “pesquisar na base de conhecimento”, “perguntar ao usuário” e “encaminhar para atendimento humano”. O JEV escolhe a ação, e o código executa o fluxo correspondente.
Ele é adequado para assumir esse tipo de ponto de decisão. Consulte o guia de início rápido do TypeSafe para conhecer o método de integração e outros padrões; os demais modelos e interfaces estão disponíveis na documentação da API do Crazyrouter.
Perguntas frequentes#
O JEV pode substituir diretamente o modelo principal do Claude Code, Codex ou Cursor?#
Não. Ele não gera código, não mantém conversas contínuas nem produz fluxos de chamadas de ferramentas como um modelo de programação. Você pode pedir a um Agent de programação que escreva um classificador ou roteador usando o JEV. A [documentação oficial sobre coding agents]agents explica esse ponto especificamente.
O JEV oferece suporte ao chinês?#
O atendimento ao cliente em chinês, as descrições de problemas em chinês e os trechos de RAG em chinês usados neste teste produziram resultados válidos. No entanto, esses casos não são suficientes para comprovar a precisão em todos os cenários de negócio em chinês; termos especializados, textos longos e casos-limite precisam ser testados separadamente.
A experiência online do JEV é gratuita?#
A área de trabalho do Crazyrouter executa solicitações com cobrança real e exige um API Token deste site. O preço unitário da saída do modelo é zero, mas a entrada continua sendo cobrada. Não aplique a este serviço promoções temporárias de gratuidade oferecidas por outras plataformas.
Por que a interface retorna output_tokens, mas o preço da saída é zero?#
A contagem de tokens de saída e a cobrança pela saída são conceitos diferentes. A resposta bem-sucedida deste teste continha output_tokens, e a tarifa de referência para a saída era zero.
Posso escrever apenas “dê uma olhada” na entrada?#
Você deve fornecer contexto suficiente e deixar claro o que precisa ser avaliado. Por exemplo, divida “este cliente é bom?” em perguntas como “há um plano de compra?”, “a necessidade é compatível?” e “há disposição para agendar uma avaliação técnica?”. Um critério de pergunta mais claro favorece a avaliação e também facilita os testes.
A confidence está muito alta. Posso executar todas as ações automaticamente?#
Não se deve considerar apenas um número. Primeiro, valide o comportamento com casos cuja resposta seja conhecida e, depois, defina as condições de execução de acordo com o custo de cada ação. O custo de um erro é diferente para uma etiqueta de classificação e para operações como realizar uma cobrança ou bloquear um número; portanto, os limites e os fluxos de revisão também devem ser diferentes.
Se houve timeout, isso significa que não houve consumo?#
Não necessariamente. O cliente não ter recebido uma resposta não prova que o servidor não processou a solicitação. Verifique os registros da chamada e do consumo; este relatório consolida apenas os custos das solicitações que receberam resposta e não considera gratuitas as solicitações que sofreram timeout.
Teste agora com dois textos seus#
Abra a área de decisão do JEV, execute primeiro o ticket de atendimento padrão e depois substitua-o por uma mensagem de “solicitação de orçamento comum, sem urgência”. Mantenha a mesma definição do problema e observe como variam o departamento, a probabilidade de urgência e a pontuação de sentimento.
Em seguida, escolha no seu negócio real um conjunto de casos com respostas já conhecidas: inclua casos claros, ambíguos e fáceis de confundir. Se ele conseguir assumir de forma consistente uma determinada categoria de decisão, com custo e tempo de resposta aceitáveis, você terá encontrado um ponto de integração relevante para o produto.
Materiais e observações sobre os testes: este artigo foi elaborado com base nas publicações e na documentação oficiais do TypeSafe, nas informações atuais sobre os modelos do Crazyrouter e nas chamadas à API e às páginas online realizadas em 2026-09-23. As imagens são capturas de tela das páginas reais e diagramas do fluxo. As alegações oficiais de desempenho estão identificadas separadamente; os resultados desta pequena amostra não devem ser considerados um ranking de referência geral.