 简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
Em português, o mimo-v2.6-pro não desenha: 8 provas divertidas contra o gpt-6-astra, zero pelicanos em três e uma injeção de 4.100 tokens revelada
Rodada em português de 8 provas divertidas (SVG do pelicano, caixa de doces, letra a em "banana abacaxi laranja", 9,11 vs 9,9, acróstico ROTA) no mimo-v2.6-pro e no gpt-6-astra, 3 execuções cada. Nas provas curtas, empate. No pelicano o mimo fez 0/3: pensou 265 s, queimou 16.000 tokens e devolveu vazio; em inglês desenha 3/3. O gpt fez 3/3, mas a rota injeta ~4.100 tokens por chamada.
Esta é a rodada em português de uma série que começou em chinês. Mesmos dois modelos, mesmos oito tipos de prova, mas cada prompt foi escrito em português do zero, cada chamada foi feita de novo e cada desenho abaixo foi gerado para este artigo. As rodadas em outros idiomas são experimentos separados, com dados próprios; cruzamos os resultados no fim porque, juntos, eles mudam a conclusão.
Resumo#
- 48 chamadas (8 provas × 2 modelos × 3 execuções); 44 voltaram, 4 estouraram o timeout de 900 s do cliente e ficaram fora da nota (veja "O que quebrou").
- Nas sete provas de texto, os dois modelos acertaram praticamente tudo. Único deslize: um acróstico do mimo com sete palavras no último verso em vez de seis.
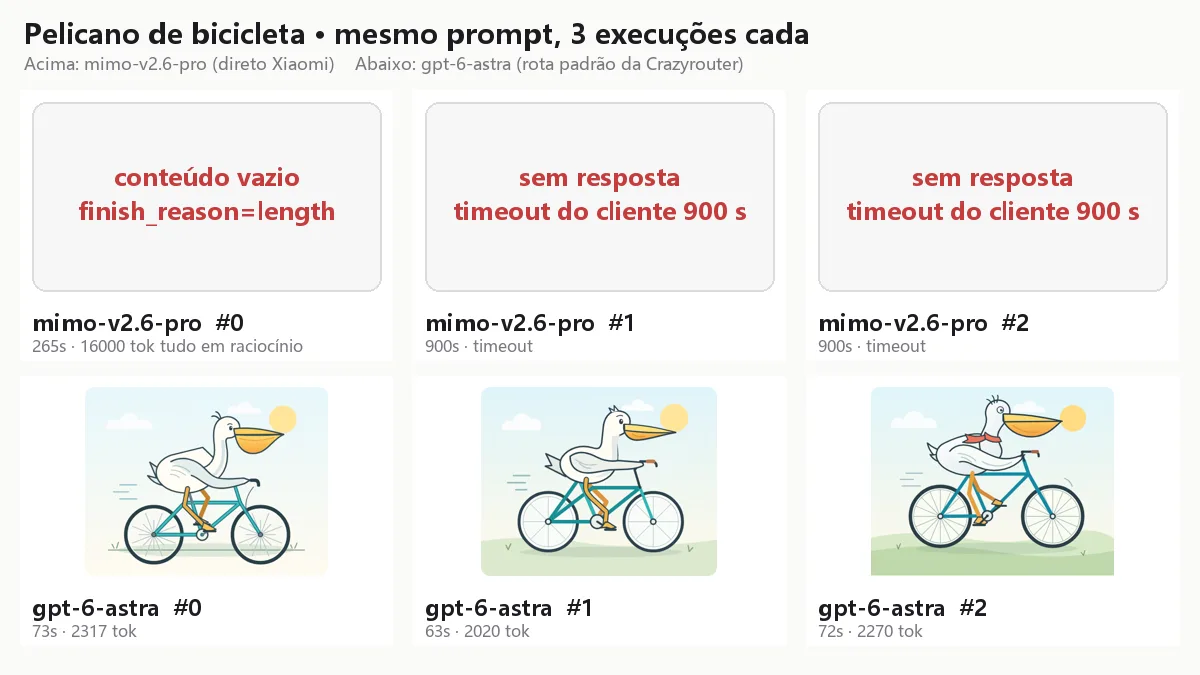
- SVG "pelicano andando de bicicleta": mimo-v2.6-pro 0 de 3. Uma execução pensou 265 s, gastou exatamente 16.000 tokens em raciocínio e devolveu string vazia com
finish_reason=length; as outras duas não responderam em 900 s. gpt-6-astra: 3 de 3, em 63–73 s. - O mesmo mimo, com o prompt em inglês, desenha 3 de 3. O problema não é saber desenhar; é o prompt em português disparar um planejamento sem fim.
- Custo das chamadas que voltaram: mimo US 0,246 — 13×.
- Aviso: a rota padrão do gpt-6-astra injeta ~4.100 tokens ocultos em cada requisição; estavam presentes nas 22 chamadas que voltaram.
Primeiro a rota: o que exatamente testamos#
| mimo-v2.6-pro | gpt-6-astra | |
|---|---|---|
| Rota | um canal, direto para o endpoint oficial da Xiaomi | 18 canais candidatos; vence a linha terceirizada de maior prioridade |
prompt_tokens de um "hi" | 8 | 4121 (3968 deles em cache) |
| Prefixo oculto por chamada | nenhum | ~4.100 tokens em todas as 22 chamadas recebidas (prompt_tokens de 4142 a 4255) |
| id da resposta | UUID | resp_… — upstream na Responses API, traduzido para chat completions |
reasoning_tokens no usage | sempre | às vezes |
Ou seja: "gpt-6-astra" neste artigo significa o gpt-6-astra alcançado em 22/09/2026 por essa rota. O prefixo pode moldar o comportamento, custa cerca de US$ 0,013 por chamada antes de você escrever qualquer coisa e não aparece na resposta. A verificação leva um segundo e recomendamos antes de qualquer benchmark: mande "hi" e olhe prompt_tokens.
Condições#
curl https://api.crazyrouter.com/v1/chat/completions \
  -H "Authorization: Bearer $CRAZYROUTER_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "mimo-v2.6-pro",
    "messages": [{"role": "user", "content": "Gere um SVG de um pelicano andando de bicicleta. Responda apenas com o código SVG, sem explicação e sem cercas de markdown."}],
    "max_tokens": 16000
  }'
Sem system prompt, temperatura padrão, sem streaming; max_tokens 4.000 para texto e 16.000 para o SVG; timeout do cliente 900 s. Registramos id, usage, finish_reason e tempo de parede; os SVGs foram renderizados com Playwright a 480 px. Preços: mimo-v2.6-pro US 5 / 25 (entrada em cache US$ 0,50) — veja a página de preços.
As oito provas#
| # | Prova (prompt em português) | Resposta certa | mimo-v2.6-pro | gpt-6-astra |
|---|---|---|---|---|
| 1 | SVG de um pelicano andando de bicicleta | um desenho | 0/3 (1 vazio, 2 timeouts) | 3/3 |
| 2 | Caixa "DOCES" com lápis: o que a Ana acha antes e depois da troca secreta | doces / lápis | 3/3 | 2/2 (1 timeout) |
| 3 | Quantas letras a em "banana abacaxi laranja" | 9 | 3/3 | 3/3 |
| 4 | Qual é maior, 9,11 ou 9,9 (vírgula decimal) | 9,9 | 3/3 | 3/3 |
| 5 | Fazendeiro e repolho, mínimo de travessias | 1 | 3/3 | 3/3 |
| 6 | Alice tem 4 irmãos e 2 irmãs; irmãs do irmão dela | 3 | 3/3 | 3/3 |
| 7 | Acróstico ROTA, exatamente seis palavras por verso | checagem estrutural | 2/3 (um verso com 7 palavras) | 3/3 |
| 8 | Uma frase que declara corretamente o próprio número de palavras | checagem por contagem | 3/3 | 2/2 (1 timeout) |
O que a tabela esconde.
O gpt-6-astra se repete. Dois dos três acrósticos abrem com o mesmo verso, "Rios levam meus sonhos para longe". As duas frases autorreferentes recebidas seguem o mesmo molde, "Esta frase contém exatamente seis palavras." e "…exatamente sete palavras portuguesas." O mimo variou: "Esta frase tem cinco palavras." e "Esta frase contém cinco palavras.", além de três poemas sem nada em comum.
O mimo formata o que não pediram. Na caixa de doces acerta, mas envolve cada resposta em negrito Markdown e acrescenta um "pois…". O gpt responde em duas linhas numeradas, como pedido.
Acrósticos — mimo (a execução que passou):
Rodas giram sem pressa no mundo
Olhando o céu aberto e infinito
Talvez o tempo traga a resposta
Acordemos quando a aurora nos chama
gpt-6-astra:
Renasce o sol sobre campos dourados
O vento conduz meus sonhos distantes
Teus passos desenham caminhos entre estrelas
A noite acolhe nossas almas serenas
O pelicano: onde a rodada se decidiu#
| Execução | mimo-v2.6-pro |
|---|---|
| #0 | 265 s, 16.000 tokens de saída, 16.003 deles em raciocínio, conteúdo vazio, finish_reason=length |
| #1 | sem resposta em 900 s |
| #2 | sem resposta em 900 s |
Olhamos o raciocínio da execução #0 (o upstream o devolve): 37.931 caracteres — em inglês, embora o prompt fosse em português — planejando coordenadas, onde o pelicano senta, para onde vai a asa, a ordem das camadas, e até rascunhos de <svg> dentro do próprio raciocínio, reescritos várias vezes. Nada disso chegou à resposta. O modelo não desenhou mal; não se decidiu a entregar. Essa execução custou US$ 0,0139 e devolveu uma string vazia.
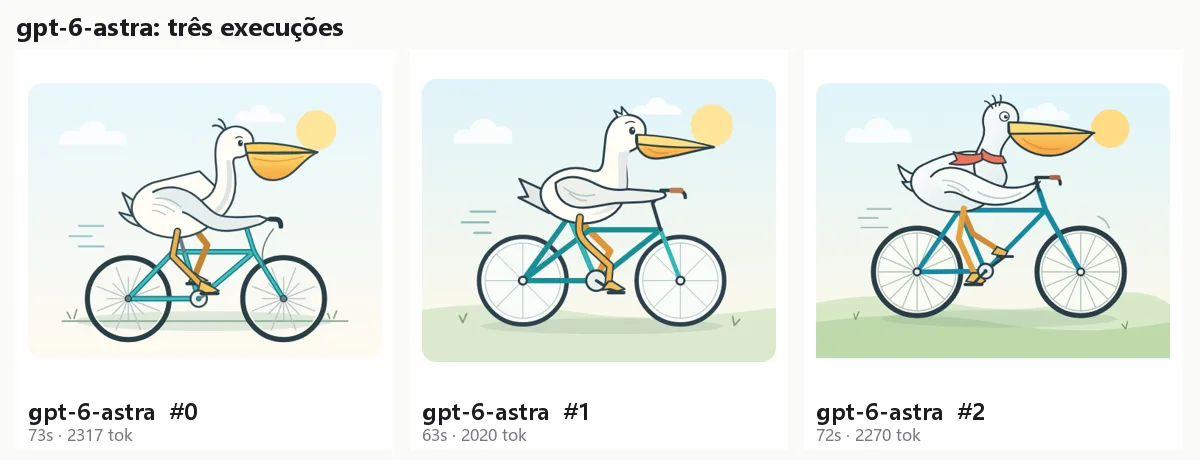
| Execução | gpt-6-astra |
|---|---|
| #0 | 73 s, 2.317 tokens. Pelicano no selim, asa no guidão, pé no pedal, sol e nuvem |
| #1 | 63 s, 2.020 tokens. Mesma cena, quadro turquesa |
| #2 | 72 s, 2.270 tokens. Mesma cena, cachecol vermelho |
SVGs originais, sem modificação: gpt #0 · gpt #1 · gpt #2. Do mimo não há nada a publicar.
Latência (só chamadas que voltaram, média em segundos)#
| Prova | mimo-v2.6-pro | gpt-6-astra |
|---|---|---|
| Quatro pegadinhas curtas | 6,3 | 3,7 |
| Caixa de doces | 9,6 | 3,9 |
| Acróstico | 17,7 | 8,2 |
| Frase que se conta | 6,0 | 6,3 |
| SVG do pelicano | 265 (uma execução) | 69,4 |
O que quebrou: 4 timeouts em 48 chamadas, nos dois modelos#
Quatro chamadas não voltaram em 900 s: duas execuções do pelicano do mimo, a caixa de doces do gpt e uma frase autorreferente do gpt. No log de uso da plataforma, a maioria não tem registro concluído — não terminaram no upstream, não foram cobradas e também não devolveram erro; a conexão só ficou aberta. Dois modelos, dois upstreams, prompts triviais: é transporte, não inteligência. Tiramos essas chamadas da nota e as listamos aqui. Em produção, coloque seu próprio prazo em chamadas longas sem streaming.
O que os outros idiomas mostraram#
Rodamos o mesmo conjunto com prompts escritos nativamente em chinês, inglês, russo e japonês. As provas curtas empataram em todos. O pelicano, não:
| Idioma do prompt | pelicanos do mimo-v2.6-pro | pelicanos do gpt-6-astra |
|---|---|---|
| Inglês | 3/3 | 2/2 recebidos |
| Chinês | 2/3 | 3/3 |
| Russo | 0/3 | 3/3 |
| Português (este artigo) | 0/3 | 3/3 |
| Japonês | 1/3 | 3/3 |
Pergunte ao mimo em inglês e nada disso acontece. É o resultado mais útil da série, e um benchmark só em inglês nunca o mostraria.
Conselho para produção#
Para qualquer modelo de raciocínio, proteja-se contra "o pensamento comeu o orçamento":
resp = client.chat.completions.create(model="mimo-v2.6-pro", messages=msgs, max_tokens=8000)
c = resp.choices[0]
if c.finish_reason == "length" and not c.message.content:
    # pensou até esgotar max_tokens e o corpo veio vazio: repita com orçamento menor
    # ou troque de modelo; nunca guarde a string vazia como resposta
    ...
Para tarefas generativas abertas, dê prompts em inglês ao mimo até isso ser corrigido; ponha timeout próprio em chamadas sem streaming. Antes de fazer benchmark de qualquer flagship estrangeiro por um gateway, mande "hi" e leia prompt_tokens. O inspetor de roteamento da Crazyrouter mostra em qual canal o modelo cai agora e quantos candidatos existem, depois de criar uma conta; a página de modelos lista endpoints e preços.
FAQ#
Por que essas provas e não um benchmark padrão? Porque não dá para decorá-las: o pelicano obriga o modelo a codificar espaço em coordenadas na hora, o acróstico e a frase autorreferente são checados estruturalmente, e as pegadinhas testam se o modelo troca o enunciado por um enigma famoso. O preço é a avaliação subjetiva dos desenhos, por isso todos os SVGs estão publicados.
A resposta vazia do mimo é problema da plataforma?
Não. finish_reason=length, reasoning_tokens=16003 e conteúdo vazio vieram do endpoint oficial da Xiaomi, sem um token injetado, e a plataforma cobrou por eles. É o loop de raciocínio do modelo, disparado por prompts fora do inglês em tarefas abertas.
Quanto da diferença de 13× é o prefixo injetado? 22 × ~4.100 ≈ 90 mil tokens de entrada, quase todos ao preço de cache de US 0,05 dos US$ 0,25, uns 20%. O resto é tabela de preço.
Três execuções bastam? Para "quem é mais inteligente", não. Para "quem para de funcionar em português", sim.
Cadê o teste multimodal? O mimo é omnimodal. Não nesta série. Só texto, de propósito.
O acróstico do mimo com sete palavras conta como erro? Sim: o prompt pedia exatamente seis por verso e o quarto verso tem sete. É um erro de restrição, não de sentido — mas restrições são o que se testa aqui.
Veja também#
- gpt-6-astra vs Claude Fable 5.1: 60% menos caracteres de saída — mas em parte por responder menos
- Claude Fable 5.1 vs Fable 5: eficiência de saída, acerto e as mudanças incompatíveis que nunca geram erro
- Por que escolher a Crazyrouter em vez do OpenRouter? Três diferenças concretas
- O mesmo experimento em chinês · inglês · russo · japonês
- Preços · Documentação
Veredito#
Em português, em 22/09/2026, por estas duas rotas: nas provas de texto os modelos são quase indistinguíveis; na única tarefa generativa aberta o mimo-v2.6-pro não entregou nada em três de três, sendo que em inglês entrega três de três. O gpt-6-astra custa 13 vezes mais, se repete e carrega um prefixo invisível — mas desenha. Teste no idioma em que seus usuários escrevem.