简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
企業如何統一使用 AI?用 LiteLLM 管理多部門、模型權限與費用
企業使用 AI 後,如何解決多個部門共用一把 Key、模型權限難控制、預算容易失控和費用無法歸屬的問題?本文以 LiteLLM 為企業內部閘道,透過 Crazyrouter 統一接入模型 API,介紹團隊與應用帳戶、獨立虛擬金鑰、模型白名單、部門預算、限流、用量統計和帳單核對的實施方法,並附實際設定匯出、API 呼叫紀錄與上線驗收清單。
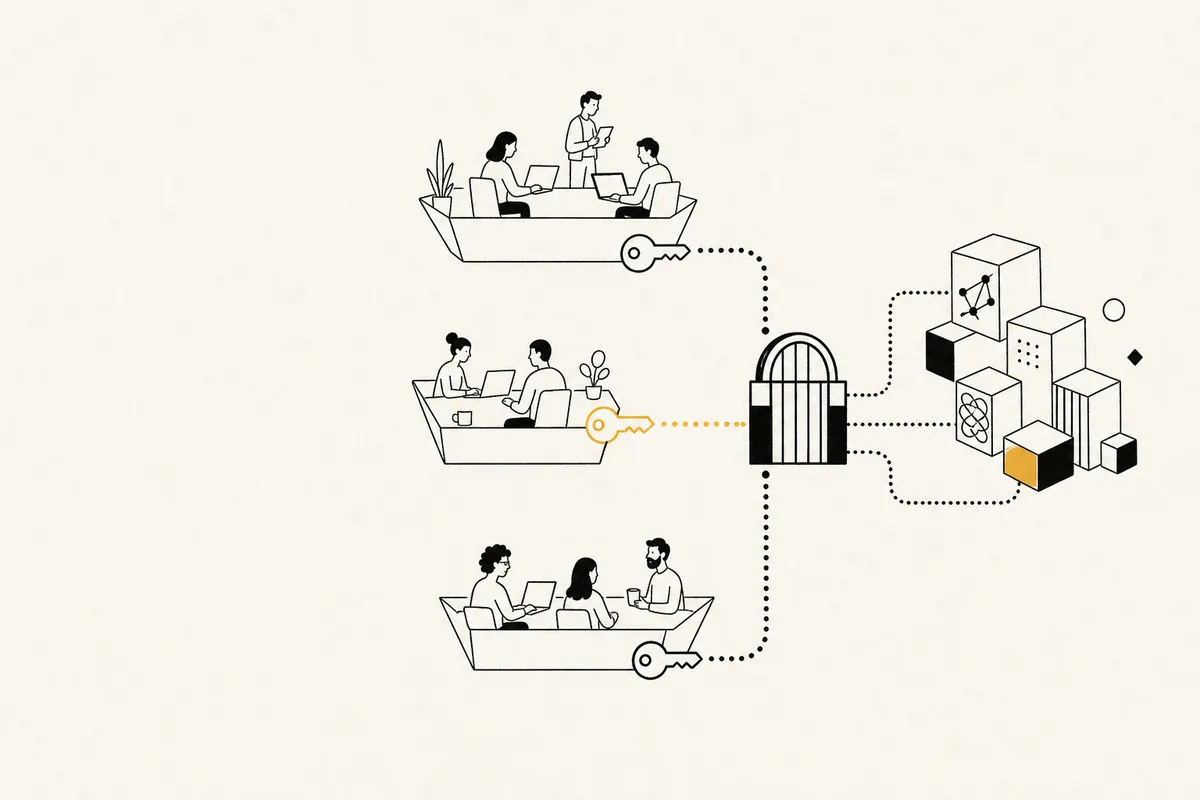
企業統一使用 AI,可以由 IT 團隊部署 LiteLLM 作為內部閘道,按部門和應用發放獨立金鑰,再通過 Crazyrouter 接入模型 API。這樣,業務團隊共用一套上游接入體系,企業仍能分別管理誰可以呼叫、能用哪些模型、允許花多少,以及費用歸誰承擔。12
Crazyrouter 是多模型 API 接入服務,可作為 LiteLLM 的上游,並匯出模型與價格配置;本文核驗了 4 個模型的配置匯出。LiteLLM 負責企業內部的團隊、金鑰和預算策略。
這篇文章從一個常見場景展開:研發、市場和客服都開始使用 AI,公司希望統一採購和結算,同時保留部門權限與費用邊界。
企業使用 AI,為什麼會卡在帳戶、權限和費用管理上?#
試用階段,一個人申請 Key,接上模型,能返回答案就算成功。
等到市場部批次生成文案、研發團隊接入編程工具、客服系統開始自動彙整工單,同一套做法就會顯現問題:某個腳本突然消耗大量額度,但沒人說得清它屬於哪個項目;員工離職了,公司不知道他是否還保存著可用金鑰;某個部門只需要做文本分類,卻能呼叫所有高成本模型。
企業需要把這些問題變成明確的管理動作。
| 企業痛點 | 希望實現的結果 | 方案中的對應做法 |
|---|---|---|
| 多個部門共用一把 Key | 知道是誰、哪個應用在呼叫 | 部門建 Team,應用或成員分配虛擬 Key |
| 每換一個模型就要改接入 | 應用使用統一入口 | LiteLLM 顯現內部 API,集中維護上游配置 |
| 普通任務也能使用高成本模型 | 按工作需要開放模型 | 團隊和 Key 設定明確模型允許清單 |
| 某個自動化任務耗盡預算 | 異常用量只影響有限範圍 | 部門預算、應用預算、請求速率限制 |
| 財務只看到一個總金額 | 按部門、項目核算費用 | Key 關聯 Team,保存用量與價格紀錄 |
| 員工離職後金鑰仍然有效 | 可單獨停用和追溯 | 回收成員 Key,檢查共享應用憑據 |
| 管理員權限過大、分工不清 | 平臺、部門、財務各有職責 | 按版本與授權設定管理角色和報表可見範圍 |
| 呼叫失敗沒人能定位 | 能關聯應用與上游請求 | 保存請求 ID、模型、狀態和耗時 |
LiteLLM 的虛擬金鑰、團隊預算和用量紀錄為這些管理動作提供基礎;具體權限策略需要在企業部署中配置並驗收。134
一個 API Key,如何服務多個部門和多個模型?#
“一個 Key 接入多個模型”適合描述上游接入方式。落實到企業內部,還需要給不同呼叫方分發獨立憑據。
建議採用下面的結構:
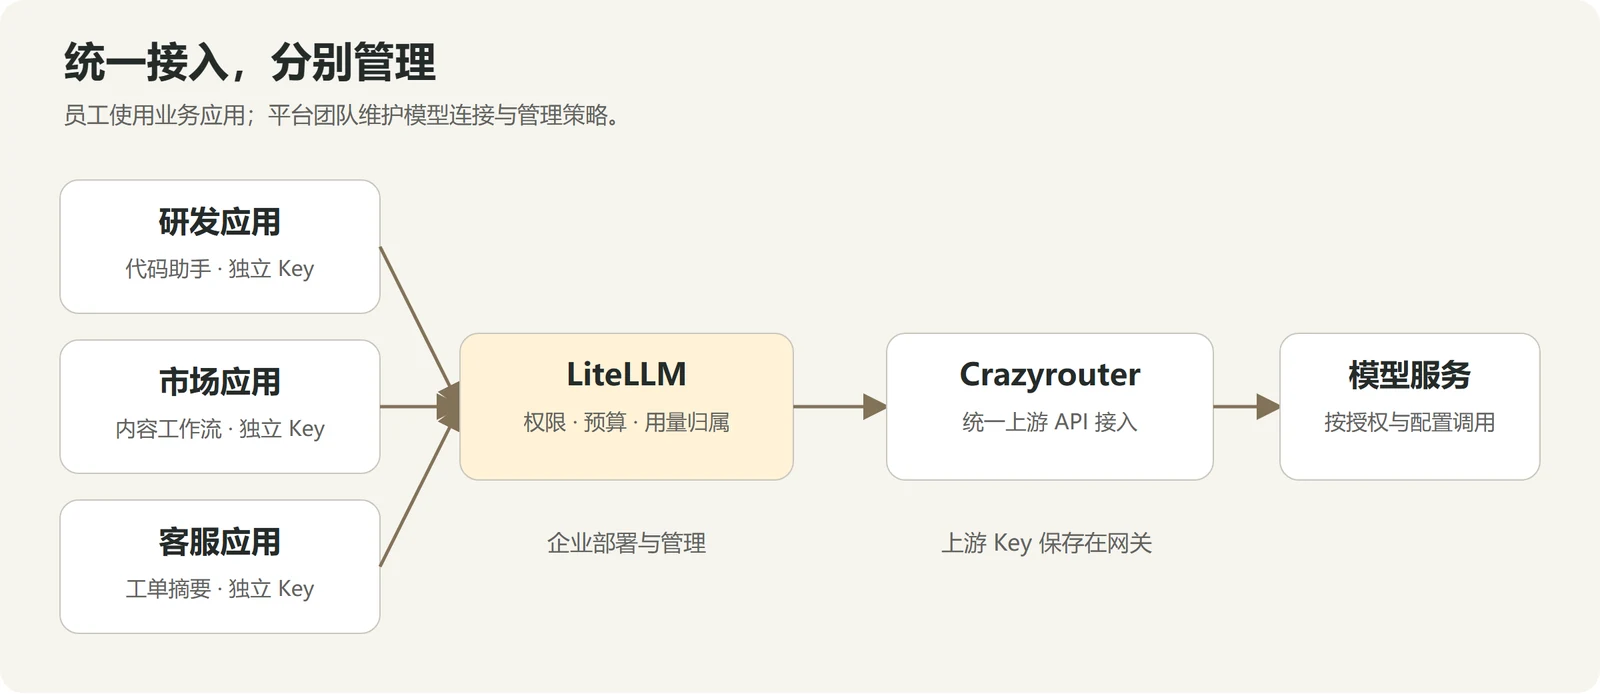
圖中各部門呼叫企業自己的 LiteLLM 地址。上游 Key 由閘道保管,業務應用使用 LiteLLM 簽發的虛擬 Key。
三類金鑰分別交給誰?#
| 金鑰 | 用途 | 保管者 |
|---|---|---|
| Crazyrouter API Key | LiteLLM 呼叫上游模型 | 平臺運維,通過服務端環境或金鑰管理系統保存 |
| LiteLLM Master Key | 配置和管理內部閘道 | 少數平臺管理員 |
| LiteLLM Virtual Key | 應用或成員呼叫已授權模型 | 對應應用後端或獲授權成員 |
研發的代碼助手、市場的內容工作流、客服的工單機器人各有自己的 Key。某個應用需要停用時,可以處理對應憑據;上游配置變化則由平臺團隊集中維護。12
統一帳戶不等於所有人共用同一把金鑰。 對大型企業,還可以按生產與測試環境、事業部或風險等級拆分上游憑據。共用上游帳戶能簡化結算,也意味著帳戶余額、配額或故障可能影響多個部門,需要在容量與可用性設計中考慮。
先設計部門、帳戶和應用,再發 Key#
假設一家企業先讓三個部門試點,下表可以作為配置討論稿。預算為演示數值,不是套餐價格或使用量建議。
| 部門 | 業務應用 | 模型開放範圍 | 演示預算 | Key 拆分方式 |
|---|---|---|---|---|
| 研發 | 代碼助手、測試用例生成 | 通過代碼任務評估的模型 | 500 美元/預算周期 | 開發工具、CI 任務分別建 Key |
| 市場 | 文案初稿、資料整理 | 通過內容任務評估的模型 | 200 美元/預算周期 | 內容工作流與個人試用分開 |
| 客服 | 工單摘要、回復建議 | 通過客服準確性評估的模型 | 300 美元/預算周期 | 生產與測試分別建 Key |
部門適合映射為 LiteLLM 的 Team;應用通常使用歸屬明確的服務憑據;需要個人歸屬時,再建立對應使用者與成員關系。13
命名也應讓人看懂。例如 marketing-copy-prod 表示市場文案生產應用,support-summary-test 表示客服摘要測試應用。每個 Key 紀錄負責人、用途、環境和復查時間,避免半年後留下幾十把無人認領的金鑰。
普通員工是否需要登錄 LiteLLM?#
不一定。LiteLLM 主要承擔閘道與管理功能。普通員工可以在企業已有的聊天入口、知識庫助手、辦公自動化工具或業務系統里使用 AI,應用後端再呼叫 LiteLLM。
企業應分別設計兩條鏈路:
- 員工使用鏈路:員工登錄業務應用,應用檢查身份和資料權限,再呼叫 AI。
- 平臺管理鏈路:獲授權的管理員管理模型、成員、Key、預算和報表。
如果所有員工請求都由同一個應用 Key 發起,閘道首先識別到的是這個應用。要進一步統計到個人,需要應用後端傳遞經過驗證的使用者標識,並確認閘道版本、功能與報表支持情況。不要把使用者能自行填寫的 user 或部門標簽當作權限憑證。4
企業 AI 權限,至少要分成三層#
第一層:誰能管理帳戶和預算?#
建議平臺管理員維護模型連接與全局配置,部門負責人處理本部門申請和預算,財務查看獲授權的費用報表,普通成員使用分配的應用或憑據。
這是企業角色設計,不代表安裝 LiteLLM 後上述分工會自動生效。SSO、SCIM、組織與團隊管理員、審計記錄等能力有版本和許可要求。核驗時,LiteLLM 官方定價頁將多項高級治理能力列在 Enterprise 中;SSO 文檔另有小規模使用者例外,應結合企業人數與採購方案逐項核對。56
第二層:誰能呼叫哪些模型?#
模型授權應從具體任務出發。客服摘要只需要經過該業務評估的模型;研發需要代碼工具呼叫,就驗收對應能力後再開放;某個新模型先給試點項目使用,通過評估後再擴展。
在 LiteLLM 中,應用呼叫的是注冊後的 model_name。設定團隊、虛擬 Key 的模型範圍時,要使用對應名稱,並檢查實際生效規則。1
如果使用路由或 fallback,候選模型也要滿足原任務的資料、能力和成本要求。允許呼叫一個業務別名,不應該意味著該別名可以被隨意改到未經批準的模型。
第三層:誰能讀取哪些企業資料?#
模型允許清單控制“能呼叫什么模型”,業務系統還需要控制“能把什么資料交給模型”。
客服人員能使用摘要模型,並不意味著可以讀取所有客戶合同;員工能訪問企業知識庫助手,也不意味著能搜索其他部門的薪資資料。資料訪問應在業務系統、檢索層和工具執行層依據員工身份執行,不能只靠提示詞要求模型遵守權限。
閘道自托管也不等於推理完全留在企業內網。使用本文架構時,請求會經過企業 LiteLLM,再到 Crazyrouter 及實際模型服務鏈路。敏感資料是否適合發送,需要結合具體服務約定、資料分類和企業審批要求決定。
部門預算、應用限額和速率限制應該怎樣配合?#
可以把控制措施理解為三個不同問題:
| 控制項 | 回答的問題 | 實施重點 |
|---|---|---|
| 部門預算 | 一個部門在周期內能花多少? | 團隊歸屬和共享預算 |
| 應用或 Key 預算 | 一個工作流最多能花多少? | 避免單個應用消耗全部部門額度 |
| RPM / TPM | 一分鐘內允許多快、多大量呼叫? | 控制請求速率和 token 速率 |
LiteLLM 官方文檔提供團隊、虛擬 Key 等預算及速率限制配置;預算依賴資料庫中的用量資訊。生產實施應配置 PostgreSQL 持久化,不能把一個無資料庫代理當作已完成的預算系統。3
還要關注幾個會影響結果的細節:
- Key 必須歸屬正確的團隊。 同一部門有多個應用 Key,應確認它們實際計入同一個 Team。
- 不要假設所有層級限制都會疊加。 團隊 Key、個人預算、團隊成員預算的適用規則有區別,應按部署版本驗證。3
- 預算周期要與財務口徑對齊。
budget_duration、多窗口預算、重置時間可能有不同語義;核對實際budget_reset_at和時區,不要僅看到30d就認為與財務自然月完全一致。 - 告警和拒絕請求是兩種行為。 80% 提醒、100% 暫停等規則可以作為管理設計,但必須配置對應功能,並測試通知與阻斷。
- 併發下要驗證邊界。 在途請求、成本預估、價格同步和多實例狀態都會影響預算控制;不要承諾設定一個金額後就絕對不會多出一分錢。34
對客戶服務這類關鍵業務,預算告警還應有明確負責人和追加審批流程,避免系統停用後才發現無人處理。
如何按部門、項目和模型統計 AI 費用?#
企業月報至少應該回答:哪個部門用了多少、主要用在哪個應用、呼叫了哪些模型,以及這些呼叫帶來了什么業務結果。
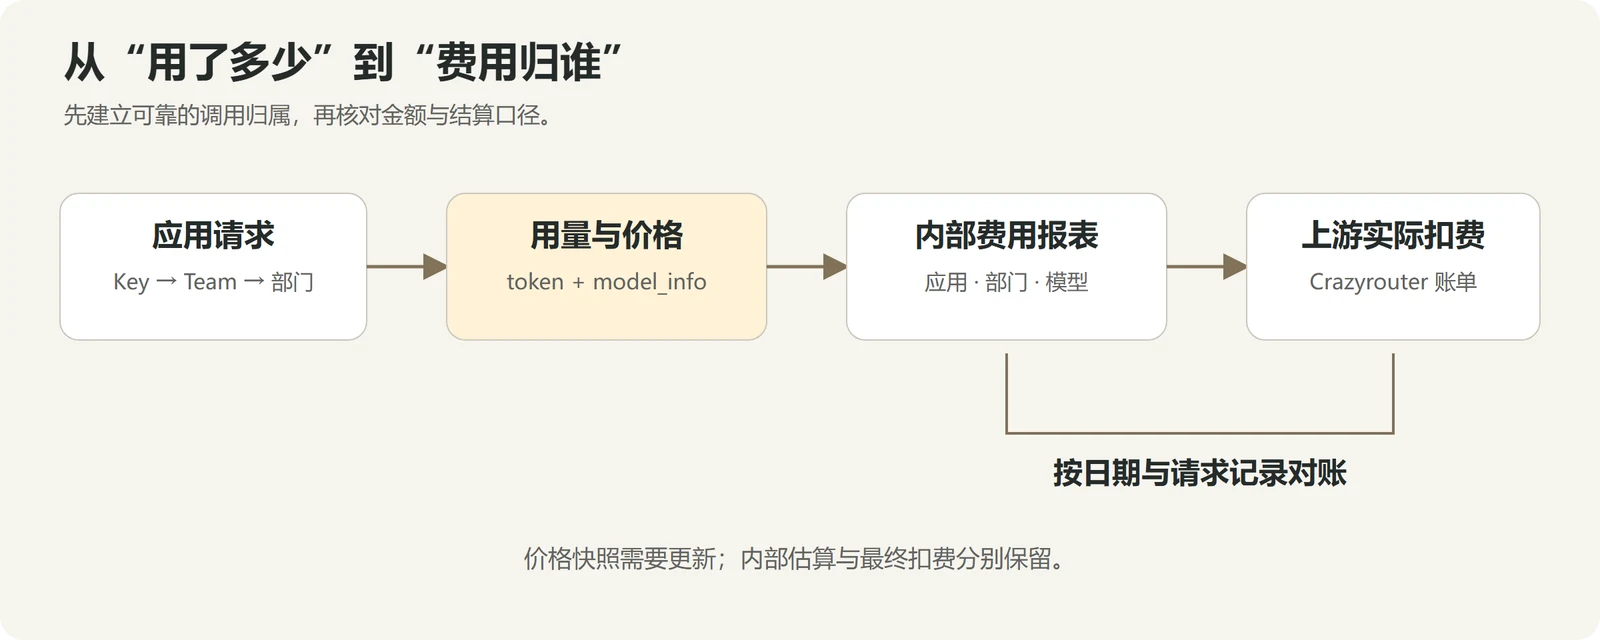
建議從下面的報表字段開始:
| 統計維度 | 關鍵字段 | 可以做出的管理判斷 |
|---|---|---|
| 部門與應用 | Team、Key 別名、應用、環境、負責人 | 費用歸誰,是否有閑置應用 |
| 模型 | 請求模型、實際使用模型、請求量 | 哪些任務在使用高成本模型 |
| 用量與費用 | 輸入、輸出、緩存 token、估算費用 | 成本由長輸入、長輸出還是呼叫次數推動 |
| 穩定性 | 成功率、錯誤類別、耗時、重試 | 是否存在失敗重試和異常呼叫 |
| 業務效果 | 處理工單數、人工采納率、任務完成數 | 每完成一項業務的成本是否合理 |
LiteLLM 可以紀錄 Key、使用者和團隊的費用,並提供呼叫記錄;標簽分析、報表和高級訪問控制的可用範圍應按版本與許可核對。業務采納率等指標仍需要企業應用自己紀錄,再與呼叫資訊關聯。45
能看到 token,為什麼費用仍可能不準確?#
因為 token 數和金額之間還隔著一套價格規則。
輸入、輸出、緩存讀取、緩存寫入可能有不同價格;長上下文或不同時段可能使用不同檔位;帳戶分組和折扣也可能影響實際結算。自定義模型如果沒有正確價格資訊,閘道里的費用可能缺失、為零或偏離上游帳單。247
因此,本方案接入時應同時導入模型連接和 model_info 價格資訊。只拿到 /v1/models 列表,還沒有完成費用統計配置。2
LiteLLM 統計和 Crazyrouter 帳單分別用來做什么?#
LiteLLM 的費用資料用于內部歸屬、預算和趨勢分析;Crazyrouter 的實際扣費紀錄用于上游結算核對。
價格快照更新延遲、特殊計費項、舍入、重試與時間邊界等因素可能造成差異,不能預設兩個系統逐筆金額永遠相等。2
建議保留日期、時區、模型、用量、應用請求 ID 和可獲得的上游請求 ID,先核對每日匯總,再排查差異較大的請求。如果多個應用共用一把上游 Key,而雙方紀錄又無法逐筆關聯,就不能宣稱已經實現精確的應用級結算分攤。
用 LiteLLM 接入 api.crazyrouter.com 的實施步驟#
1. 確定模型與業務範圍#
先從兩個部門、兩三個應用開始,準備實際業務樣例,分別驗收答案質量、必要功能、延遲和成本。
平臺團隊可以先查看 Crazyrouter 模型目錄,再結合 模型 API 價格對比確定候選。需要 Claude 或 DeepSeek 時,可分別查看 Claude 系列說明與 DeepSeek 系列說明,最後以自己憑據返回的模型列表和業務實測為準。
2. 準備專用上游 Key,匯出模型與價格配置#
OpenAI 兼容接入使用的 Base URL 為:
https://api.crazyrouter.com/v1
服務端先安全設定 CRAZYROUTER_API_KEY。下面的 Python 示例從本站獲取四個模型的配置,只保存響應中的 config,並檢查沒有把真實金鑰寫入檔案。依賴 requests,在新目錄運行,已存在同名檔案時會停止覆蓋。2
import json
import os
from pathlib import Path
import requests

api_key = os.environ["CRAZYROUTER_API_KEY"]
response = requests.get(
    "https://api.crazyrouter.com/v1/litellm/config",
    headers={"Authorization": f"Bearer {api_key}"},
    params={
        "provider": "openai",
        "models": "claude-opus-5-5,gpt-6-astra,glm-5.3,deepseek-v4.1-flash",
    },
    timeout=30,
    allow_redirects=False,
)
if response.status_code != 200:
    raise SystemExit(f"Config export failed: HTTP {response.status_code}")

config = response.json()["config"]
if not config.get("model_list"):
    raise SystemExit("No models exported")

config.setdefault("general_settings", {})["master_key"] = (
    "os.environ/LITELLM_MASTER_KEY"
)
config["general_settings"]["database_url"] = "os.environ/DATABASE_URL"
output = json.dumps(config, ensure_ascii=False, indent=2)
if api_key in output:
    raise SystemExit("Refusing to write an API key into the config")

with Path("crazyrouter.config.json").open("x", encoding="utf-8") as file:
    file.write(output + "\n")
print("Saved config; review, import and reload LiteLLM explicitly.")
本次核驗已確認上述四模型匯出介面返回有效配置。企業部署還需要向 LiteLLM 進程或容器注入 CRAZYROUTER_API_KEY、LITELLM_MASTER_KEY 和真實 DATABASE_URL,完成資料庫、認證及網路配置後顯式加載配置。完整安裝與驗證流程見 Crazyrouter 的 LiteLLM 接入指南。
匯出的 openai/<model> 表示 LiteLLM 使用 OpenAI 兼容適配器,不代表這些模型都來自 OpenAI。需要 Claude 原生協議時,應按指南單獨匯出對應配置,不能隨意混用 API 路徑。2
3. 建部門、發應用 Key,再接業務系統#
在帶資料庫的 LiteLLM 中,為試點部門建立 Team,再給應用創建歸屬於該團隊的虛擬 Key,設定允許的模型、預算和速率限制。13
業務系統最終需要的連接資訊可以整理成下面的交付單。這是配置示意,其中企業域名必須替換為實際部署地址:
内部 API 地址:https://ai-gateway.example.com/v1
业务调用密钥:该应用专用的 LiteLLM Virtual Key
允许模型:对应 Key 已授权的 model_name
费用归属:该 Key 绑定的 Team
负责人:应用维护人及部门预算负责人
企業應用使用內部閘道地址;LiteLLM 的上游配置使用 https://api.crazyrouter.com/v1。各工具的具體字段和協議要求可以參考 接入指南目錄,再驗證它是否能夠通過本企業閘道呼叫。
4. 把權限拒絕和預算耗盡也納入驗收#
完成配置後,建議至少測試以下場景:
| 驗收場景 | 需要觀察的結果 |
|---|---|
| 正常 Key 呼叫授權模型 | 最終答案、結束狀態和用量紀錄完整 |
| Key 呼叫未授權模型 | 請求被拒絕,不能只依賴前端隱藏模型 |
| 吊銷某個應用 Key | 舊 Key 不能繼續呼叫,其他應用行為符合預期 |
| 同部門兩個 Key 連續呼叫 | 費用歸屬及團隊匯總正確 |
| 用隔離測試團隊耗盡小額預算 | 後續呼叫按策略拒絕,紀錄錯誤與重置時間 |
| 超過速率限制閾值 | 觸發預期限制,客戶端退避行為正確 |
| 部門負責人查看報表 | 只能訪問設計中允許的範圍 |
| 更新價格或模型配置 | 新請求使用更新後的配置和價格口徑 |
預算和吊銷測試應使用專門的測試對象。生產上線前還要驗證多實例狀態、資料庫備份與恢復,以及敏感記錄的訪問和保留規則。
本方案實際核驗了哪些內容?#
2026 年 10 月 27 日,我們使用 https://api.crazyrouter.com 完成了模型列表、配置匯出和一次直連推理核驗。
| 檢查 | 結果 | 能證明的範圍 |
|---|---|---|
/v1/models | 本次選擇的四個模型均可見 | 這些模型對測試憑據可見 |
/v1/litellm/config | 四模型匯出成功,均含價格資訊 | 本次憑據可取得相應配置快照 |
glm-5.3 Chat Completions | 最終正文 OK,finish_reason=stop | 本次普通文本直連成功 |
| 2026-10-24 歷史 LiteLLM 驗證 | 1.106.2 版本下,四模型普通與 SSE 的 8 項檢查通過 | 已測試模型和路徑的接入依據 |
本次直連請求為:
{
  "model": "glm-5.3",
  "messages": [{"role": "user", "content": "Reply with exactly OK."}],
  "max_tokens": 512
}
請求端點為 POST /v1/chat/completions,request ID 為 e6d9b321143a4367e53c9e697fa25f1a。返回輸入 17 token、輸出 56 token、合計 73 token;輸出用量包含 54 個推理 token。正文雖然只有 OK,輸出 token 仍不止兩個字符對應的數量,這也是費用分析應讀取 usage 的具體例子。
歷史 LiteLLM 紀錄與本次直連檢查是兩組證據。本文沒有將歷史兼容性檢查寫成企業部門預算驗收,也沒有宣稱覆蓋全部模型、SSO、併發負載或故障切換。現有 Claude 接入指南還明確列出 json_object、強制工具選擇等能力邊界,應按實際業務逐項驗證。2
企業推廣 AI,可以從一張試點清單開始#
第一批業務不必覆蓋所有部門。選擇輸入可控、結果容易評價、負責人明確的任務,例如客服工單摘要、市場文案初稿或研發測試用例生成。
為每個應用寫清五件事:誰負責、用什么資料、允許哪些模型、預算多少、如何判斷結果有用。把部門 Team、應用 Key 和統計字段同時建好,再讓員工開始使用。
一輪試點結束後,用“完成一項任務的成本、結果采納率、人工復核量和失敗原因”決定是否擴大範圍。模型呼叫次數增加,並不自動代表業務效果改善。
準備實施時,可以先創建 Crazyrouter 接入帳戶,由平臺團隊保管專用上游憑據,再在 LiteLLM 中建立第一個部門和應用 Key。上線標準應包括:正常呼叫可用、越權會被拒絕、預算規則生效、費用能夠歸屬。
FAQ#
企業使用者如何使用 AI,才能同時管理多個部門?#
讓員工通過企業應用使用 AI,由內部閘道集中處理呼叫,再按部門、應用和成員分配權限與費用歸屬。本文方案使用 LiteLLM 管理團隊和虛擬 Key,通過 Crazyrouter 接入上游模型。12
一個 Crazyrouter API Key 可以給多個部門使用嗎?#
可以由 LiteLLM 在服務端統一使用同一把上游 Key,但各部門和應用應使用獨立的 LiteLLM 虛擬 Key。能呼叫哪些模型,還取決于上游憑據權限和閘道自身配置。12
LiteLLM 能按部門設定預算嗎?#
可以配置團隊預算,並給團隊下的應用 Key 設定相應限制。需要資料庫、正確的團隊歸屬與價格配置,而且應實測預算耗盡後的行為,不能僅憑配置頁面認定已經生效。3
LiteLLM 的部門費用統計能直接當財務帳單嗎?#
應先用于內部歸屬和預算分析,再與上游實際扣費核對。價格快照、特殊計費項與紀錄關聯方式會影響逐筆一致性,正式分攤前需要明確對賬口徑。24
員工離職後,停用登錄帳戶就夠了嗎?#
離職流程還應檢查個人 Key、服務憑據和本人能夠訪問的金鑰存儲。登錄帳戶與 API 憑據是不同對象,要驗證相關 Key 已失效;業務共用憑據則應轉移負責人,並按顯現情況決定是否輪換。
LiteLLM 是否可以替代企業知識庫或聊天應用?#
在這套架構中,它負責模型閘道和呼叫治理。員工使用界面、知識庫檢索、文檔權限與業務審批仍由對應應用承擔;模型權限不能代替業務資料權限。
SSO、審計和部門管理員是否安裝後就都有?#
需要核對部署版本與許可。LiteLLM 官方將多項高級治理功能列為 Enterprise 能力,部分 SSO 場景另有小規模例外;採購前按人數、角色分工和審計要求確認。56
換模型後,所有業務代碼都不用改嗎?#
統一介面能減少連接層改動,但不能保證模型行為一致。工具呼叫、結構化輸出、上下文和多模態要求仍要重新驗收,再決定是否切換。2
參考資料#
以下文檔于 2026 年 10 月 27 日核對;官方在線文檔可能繼續更新,實施時應同時檢查固定部署版本。