简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
Claude Opus 5.5 vs GPT-6.1 Sol:官方基准、价格与选型
Claude Opus 5.5 与 GPT-6.1 Sol 应如何选?本文核对两家官方编码、业务工作流和专业文档基准,比较标准 API 标价、缓存与长上下文规则,并补充 Crazyrouter 的 GPT-6.1 Sol 16 次请求记录。官方自报结果与本站小样本分开呈现,保留两次超时和一次答错,明确没有 Opus 5.5 同题对照,帮助读者按任务通过率、交付质量和总成本建立自己的验收集。
截至 2026 年 10 月 30 日,公开证据不足以给 Claude Opus 5.5 和 GPT-6.1 Sol 排出一个适用于所有任务的总名次。**Crazyrouter 在固定渠道对 GPT-6.1 Sol 的 16 次任务请求中记录到 14 次交付、13/14 个交付答案完整正确;由于没有 Opus 5.5 同题样本,这组本地数据不能判定谁胜出。**官方发布材料另称,GPT-6.1 Sol 在中等推理档的 AutomationBench 比 Opus 5.5 高 2.2 个百分点、单任务成本约为三分之一;Opus 5.5 则在另一组高推理档编码与科学基准中展现了很强的能力上限。这些厂商评测不能当成同一实验室、同一配置下的独立横评。
如果你重视长时间、多步骤的代码代理工作,可以优先把 Opus 5.5 纳入候选;如果日常任务量大、希望控制 API 成本,GPT-6.1 Sol 更值得先测。最终选择应看自己的任务通过率、返工次数和总账单,而不是只看单项榜单。
Claude Opus 5.5 vs GPT-6.1 Sol,哪款更适合日常工作?#
两款模型的目标区间有重叠,但公开数据反映的侧重点不同:Opus 5.5 在 Anthropic 公布的高难度编码、桌面操作和知识工作测试中表现突出;OpenAI 则强调 GPT-6.1 Sol 在专业文档、业务工作流和科学研究任务中的成本效率。公开证据支持按工作负载做选择,不支持把某一家厂商的单项领先外推成全面胜出。
快速对比#
| 维度 | Claude Opus 5.5 | GPT-6.1 Sol | 读数时要注意 |
|---|---|---|---|
| 官方 API 型号名 | claude-opus-5-5 | gpt-6.1-sol | 使用第三方网关时,应以其当前 /v1/models 返回和文档为准 |
| 官方 API 标准价 / 百万 token | 输入 20;缓存读取 $0.20 | 输入 10;缓存输入 $0.10 | GPT-6.1 Sol 的标准输入、输出和缓存输入标价约为 Opus 5.5 的一半;实际账单还受缓存、工具和输出长度影响 |
| API 上下文窗口 | 1,000,000 tokens | 1,050,000 tokens | 实际可用窗口还取决于所用产品、接口与请求配置 |
| 默认推理档 | medium;adaptive thinking 始终开启 | medium | 同名档位不保证相同推理预算或相同计算量 |
| Anthropic SWE-bench Pro 子集 | medium:92.8% 解题,$0.22 / solved task | 没有同一子集的公开对照 | 原始兼容子集 482 题;Opus 5.5 两次运行按 478 题计分,不等于公榜成绩 |
| AutomationBench | Anthropic 公布 40.0%,该次结果未用 fallback | OpenAI 称中等推理档高 2.2 个百分点,单任务成本约为三分之一 | Anthropic 页面还指出,其 Opus 5.5 结果来自 Zapier 早期测试;不同报告的 fallback 与运行口径需分开看 |
| GDP.pdf 专业文档 | OpenAI 的比较称 GPT-6.1 Sol 在各测试推理档均高于带 fallback 的 Opus 5.5,且每任务成本不到一半 | OpenAI 发布材料中的自报结果 | 公布文字没有列出这组比较的完整分数;不能据此推断所有 PDF 或知识工作都由 GPT-6.1 Sol 胜出 |
| Terminal-Bench 4.0 | Anthropic 报告 66.4%,使用 xhigh effort | Anthropic 表格未列 GPT-6.1 Sol | 该表的 GPT 对照为 GPT-6 Astra,不是 GPT-6.1 Sol |
| Terminal-Bench Science 0.1 | Anthropic 报告 58.7%;标准误为 ±3.5–5 个百分点 | OpenAI 报告最高推理档每任务平均成本 23.21;发布正文未给出 GPT-6.1 Sol 的精确分数 | 任务通过率与单任务成本是两个指标,不能把低成本直接写成高于对方的准确率 |
| Crazyrouter 本地小样本 | 没有 Opus 5.5 同题结果 | 16 次请求中 14 次交付;交付答案 13/14 正确,另有 2 次超时 | 2026-09-30 固定渠道的独立工作负载记录,不是 Opus 对照,也不是长期可用率 |
官方基准显示的优势并不相同#
业务工作流:GPT-6.1 Sol 的成本主张更明确#
OpenAI 在 2026 年 9 月 29 日的发布材料中称,GPT-6.1 Sol 在中等推理档 AutomationBench 得分比 Opus 5.5 高 2.2 个百分点,单任务成本约为三分之一。AutomationBench 测试代理使用 47 种工具完成销售、市场、运营、客服、财务和人力资源等端到端工作流。
Anthropic 的 Opus 5.5 页面则列出 AutomationBench 40.0%,并明确说明其这次运行未使用 fallback;同表 GPT-6 Astra 为 41.4%。因此,引用 OpenAI 的直接比较时,应保留它属于 OpenAI 发布材料中的对照结果;不能把两家页面上的数字拼成一场控制条件完全一致的独立实验。fallback 会影响完成率与成本,也会影响用户实际拿到的交付结果。
编码:Opus 5.5 的公开高档成绩亮眼,GPT-6.1 Sol 的直接分数较少#
Anthropic 公布 Opus 5.5 在 Terminal-Bench 4.0 得分 66.4%,评测使用 xhigh 推理档;该页面同时列出 GPT-6 Astra 的 57.9%,但没有 GPT-6.1 Sol 的同项结果。Anthropic 还公布了 Opus 5.5 在 FrontierCode v1.1 主集合得分 54.4%,高于表内 GPT-6 Astra 的 53.3%。这些数字说明 Opus 5.5 在所列编码代理测试中有竞争力,但不能直接说明它一定胜过 GPT-6.1 Sol,因为对照型号、推理档或评测条件并不完整一致。
Anthropic 的模型成本指南还公布了另一组较新的编码数据:其 SWE-bench Pro 兼容子集最初选取 482 题;由于评分容器问题,Opus 5.5 的两次 medium 运行按剩余 478 题计分,解题率为 92.8%,每个解题任务约 $0.22。Anthropic 明确指出,这个子集和运行条件与公开 SWE-bench Pro 排行榜及 Opus 5.5 system card 的结果不同。OpenAI 没有在同一子集上公布 GPT-6.1 Sol 的对照分数,因此这组数字只能补充 Opus 5.5 自身的质量与成本基线。
OpenAI 对 GPT-6.1 Sol 的主张集中在 DeepSWE v1.1:它称 GPT-6.1 Sol 在较低推理档就超过 GPT-6 Sol 的最高分 6.4 个百分点,并与 GPT-6 Astra 的结果相当、任务成本约低五倍。这个结果是 GPT-6.1 Sol 对上一代 Sol 的升级证据,不是 Opus 5.5 对照分数。
专业文档与科学任务:看任务交付成本,也看是否提供了分数#
OpenAI 称 GPT-6.1 Sol 在 GDP.pdf 的各个测试推理档均高于“带 fallback 的 Opus 5.5”,单任务成本不到一半。GDP.pdf 要求模型从包含表格、图表、示意图和细则的复杂 PDF 中回答专业问题。由于发布正文没有同时给出完整逐档分数、fallback 运行细节和共同评测记录,这个结论适合作为选型线索,不应被改写成无条件的胜负裁决。
在 Terminal-Bench Science 0.1 上,OpenAI 报告 GPT-6.1 Sol 最高推理档平均每任务 23.21。Anthropic 报告 Opus 5.5 得分 58.7%,并指出该分数的标准误为 ±3.5–5 个百分点;但 OpenAI 发布正文没有列出 GPT-6.1 Sol 的精确得分。因此可比较公开的成本信息,却不能只凭这两句话判断谁的科学任务成功率更高。
API 价格差距有多大?#
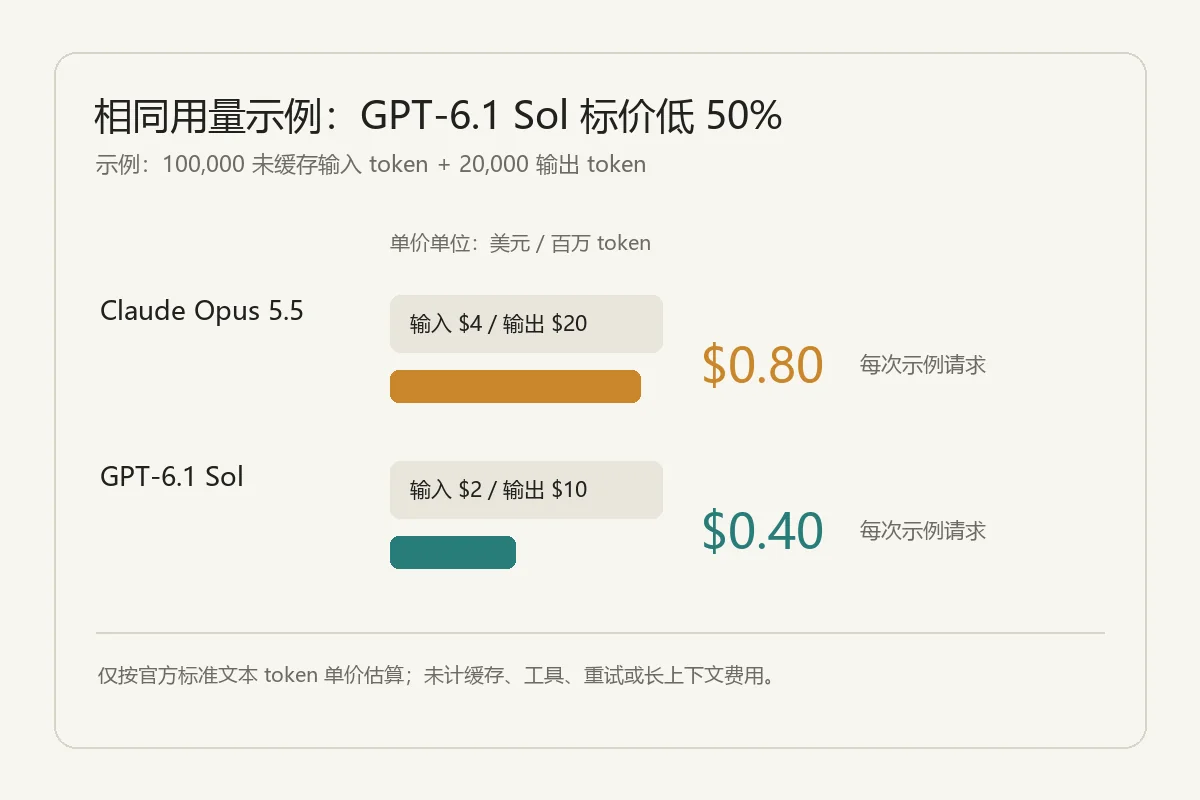
按两家官方页面所列的标准 API 标价,Opus 5.5 为每百万输入 token 20;GPT-6.1 Sol 为 10。若一次请求使用 100,000 个未缓存输入 token、20,000 个输出 token,按标准标价估算:
input_tokens = 100_000
output_tokens = 20_000

opus55 = input_tokens / 1_000_000 * 4 + output_tokens / 1_000_000 * 20
gpt61 = input_tokens / 1_000_000 * 2 + output_tokens / 1_000_000 * 10

print(f"Opus 5.5: ${opus55:.2f}")
print(f"GPT-6.1 Sol: ${gpt61:.2f}")
这组示例得出 Opus 5.5 0.40。它只比较未缓存文本 token 的标价,不包含重试、工具调用、长上下文附加费、缓存策略或其他托管平台折扣。GPT-6.1 Sol 的 API 请求输入超过 272,000 tokens 时,官方定价文档说明该请求会按更高的长上下文价格计费;Opus 5.5 的官方文档则说明其 1M 上下文窗口按标准价格计费。Anthropic 与 OpenAI 的 token 计量、推理开销和产品配置也未必完全相同,所以“标价一半”不等于“相同工作流总账单必定一半”。
实际使用前,可查看按厂商浏览模型与接入方式,以及模型价格对比。若要核实供应商目录,还可查看 Anthropic 模型目录 与 OpenAI 模型目录。不同平台的折扣与计费配置可能和厂商标准标价不同。
Crazyrouter 的 GPT-6.1 Sol 记录能说明什么?#
2026 年 9 月 30 日的一轮本地开发工作负载测试中,GPT-6.1 Sol 使用固定渠道、reasoning_effort=high 和 max_completion_tokens=8192。8 类任务各独立请求两次,共 16 次:14/16 成功交付,其中 13 个交付答案整题正确;另外两次请求等待 240 秒仍未获得完整响应。主批次含两道代码题的隐藏检查;另有一次独立的模拟工具流程,不计入上述 16 次主任务。这类小样本结果不能替代长周期仓库开发测试。
这轮测试没有把 Claude Opus 5.5 放入同一题组。因此它能说明 GPT-6.1 Sol 在这批任务上的交付情况,不能据此宣称 GPT-6.1 Sol 比 Opus 5.5 更准、更快或更稳定。与官方基准相比,它的价值是补充一个真实网关路径下的小样本记录,同时提醒读者把超时也计入交付体验。
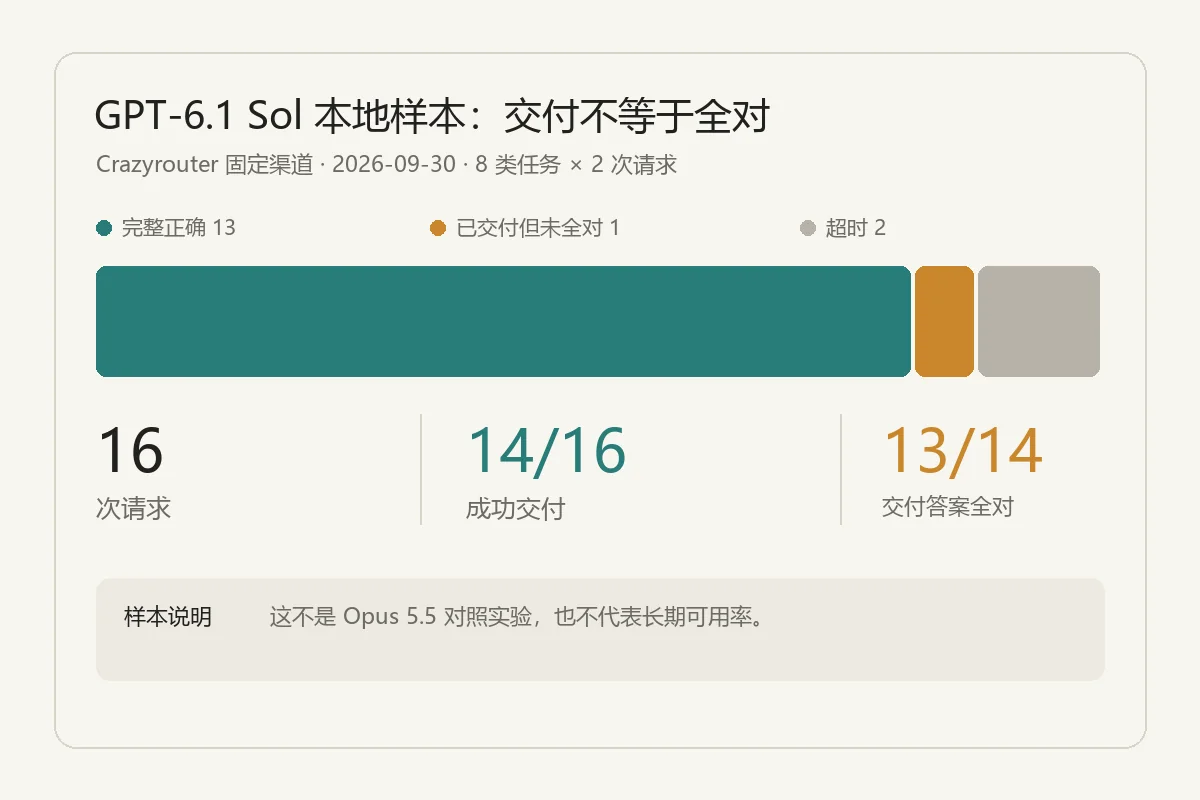
这组记录和任何厂商发布的模型卡都不是同一类证据。若计划将模型接入编码代理,可先查看 Claude Code 接入指南 与 Codex 接入指南,再用自己的仓库任务建立验收集。
本地记录的请求与失败说明#
本轮调用的 Base URL 为 https://api.crazyrouter.com/v1,端点为 POST /chat/completions,模型为 gpt-6.1-sol。请求使用 messages(固定 system 提示和同题 user 提示)、reasoning_effort="high"、max_completion_tokens=8192,不发送 temperature。这是 2026-09-30 的历史记录,不是本文发布日重新进行的可用性测试。
| 项目 | 可核对的结果 |
|---|---|
| 交付情况 | 14/16 请求收到完整结果;其中 13/14 答案整题正确 |
| 已交付但答错 | 一次规则计数将实际 72 条写为 71 条 |
| 未交付 | 长规则检索、带约束最优选集各一次等待 240 秒超时;未用重试成功覆盖失败 |
| 示例任务 | 账单事件去重:全局按事件 ID 去重,保留 10 <= ts < 20,排除内部用户,计算净金额 |
| 示例请求最终状态 | HTTP 200,finish_reason=stop,答案通过本地标准答案核对 |
示例响应 ID:resp_0a6633bd82c5ee75016abd0e0e8b9887d29ef32e920c8843ba;请求 ID:202609301326374284700288BdKuu3w。该例为合成测试数据,返回的最终答案如下:
{"net_cents_by_user":{"alice":-173,"bob":88},"included_unique_events":12}
超时只表明客户端未在等待上限内收到完整交付,不能证明模型不会解题,也不证明上游请求已经取消。样本没有测量长期可用率或两款模型的首 token 延迟。
怎么选:按任务建立自己的验收集#
- 优先评估 Opus 5.5:大型代码迁移、多仓库审查、长周期编码代理,以及你愿意为高档推理能力支付更高标准 token 费用的工作。
- 优先评估 GPT-6.1 Sol:大量重复的日常 API 请求、业务流程自动化、复杂 PDF 抽取和需要控制单任务成本的代理任务。
- 做并行试跑:任务价值高、错误代价大,或结果会被直接用于生产时。固定模型版本、推理档、工具、上下文和验收条件,并保留超时、fallback 与重试记录。
建议先从 20–50 个真实任务建立小型验收集,逐项记录是否完整交付、通过自动检查的比例、人工返工次数、端到端耗时和总 token 成本。把任务按编码、文档、工具流程分类后再算结果;一个总分容易掩盖某个模型在特定子任务上的明显短板。
FAQ#
Claude Opus 5.5 一定比 GPT-6.1 Sol 更强吗?#
不能这样概括。Opus 5.5 在 Anthropic 公布的 Terminal-Bench 4.0 等测试中成绩突出;OpenAI 则称 GPT-6.1 Sol 在特定 GDP.pdf 和 AutomationBench 条件下优于 Opus 5.5。测试机构、推理档、fallback 和任务集合不同,适合结合自己的任务做验证。
GPT-6.1 Sol 比 Opus 5.5 便宜多少?#
按官方标准 API 标价,GPT-6.1 Sol 的每百万输入 token 10,Opus 5.5 为 20;相同未缓存 token 数的标价约低 50%。实际任务账单还取决于输出长度、缓存、重试和平台定价。
哪款更适合写代码?#
Opus 5.5 在其官方公布的 Terminal-Bench 4.0 和 FrontierCode 成绩上很强;GPT-6.1 Sol 的公开发布材料强调 DeepSWE 长周期软件工程测试。由于缺少两款模型在同一编码 harness、相同推理预算下的完整公开对照,按实际仓库任务试跑更可靠。
这篇文章做了 Opus 5.5 与 GPT-6.1 Sol 的本地同题测试吗?#
没有。本文引用两家官方评测材料,并补充 Crazyrouter 在 2026 年 9 月 30 日对 GPT-6.1 Sol 的 16 次请求记录;该批次没有 Opus 5.5 对照,不能称作本地双模型 benchmark。
选择模型时应该看哪些指标?#
至少同时看任务通过率、完整交付率、超时和 fallback、人工返工、端到端耗时、总 token 成本。对于代理工作流,还要检查工具调用是否完成、模型是否正确处理失败,以及最终产物是否通过自动验收。
结论#
Opus 5.5 与 GPT-6.1 Sol 的公开数据呈现的是不同任务上的取舍:Opus 5.5 的高档编码与科学结果有吸引力,GPT-6.1 Sol 的标准 token 价格更低,且 OpenAI 在部分业务基准中报告了更优的任务成本表现。如果成本是主要约束,先试 GPT-6.1 Sol;如果复杂长程任务的质量上限更重要,把 Opus 5.5 纳入同题验收。没有两者同条件实测之前,不把厂商基准合并成一个总冠军。
来源与测试口径#
- Anthropic, Introducing Claude Opus 5.5, 2026-09-22. 含官方标价、Terminal-Bench、FrontierCode、AutomationBench 和 Terminal-Bench Science 数据及条件说明。
- OpenAI, Introducing GPT-6.1 Sol, 2026-09-29. 含 GPT-6.1 Sol 与 Opus 5.5 在 GDP.pdf、AutomationBench、Terminal-Bench Science 的发布方比较及 API 标价。
- Anthropic, Claude Opus 5.5 model and pricing documentation与成本与能力优化指南. 包括模型限制、价格,以及原始 482 题 SWE-bench Pro 兼容子集的方法和结果。
- OpenAI, GPT-6.1 Sol API model documentation. 包括 API 上下文窗口、输出上限、标准与缓存输入价格,以及长上下文计价门槛。
- Crazyrouter,2026-09-30 内部归档《GPT-6 Sol、GPT-6.1 Sol 对比 GPT-5.6 Sol 与 GPT-6 Astra:实测与主力模型选择》。本文公开结果摘要和一条响应标识;完整请求、判分脚本与响应在编辑部本地留档,未提供完整证据包的在线下载。该批次不含 Opus 5.5 同题结果。
本文不将厂商自报评测称为独立复现,也不比较两款模型的首 token 延迟、长期可靠性或生产环境总体排名。两家官方标价与本地网关实际价格可能不同,正式上线前请重新核对当前价目。