Crazyrouter
高校 AI 实验室如何低成本接入多模型 API?统一管理方案详解
高校科研项目需要同时使用 Claude、GPT、DeepSeek 等多个 AI 模型,但分别采购管理成本高、流程复杂。本文介绍一种统一接入方案,一个账号管理所有模型,适合实验室和教学场景。
高校 AI 实验室如何低成本接入多模型 API?统一管理方案详解#
问题:科研项目需要多个模型,但采购很麻烦#
做 NLP 研究的实验室,日常工作可能是这样的:
- 用 Claude 做长文本分析和代码生成
- 用 GPT 做多模态任务和快速原型
- 用 DeepSeek 做中文场景的对比实验
- 用 Embedding 模型做向量检索
- 用 Whisper 做语音转文字
每个模型来自不同厂商,意味着:
- 5 个不同的账号
- 5 套不同的 API 格式
- 5 份不同的消费记录
- 5 次不同的采购流程
对于经费有限、流程复杂的高校实验室来说,这不只是技术问题,更是管理问题。
解决方案:统一 API 网关#
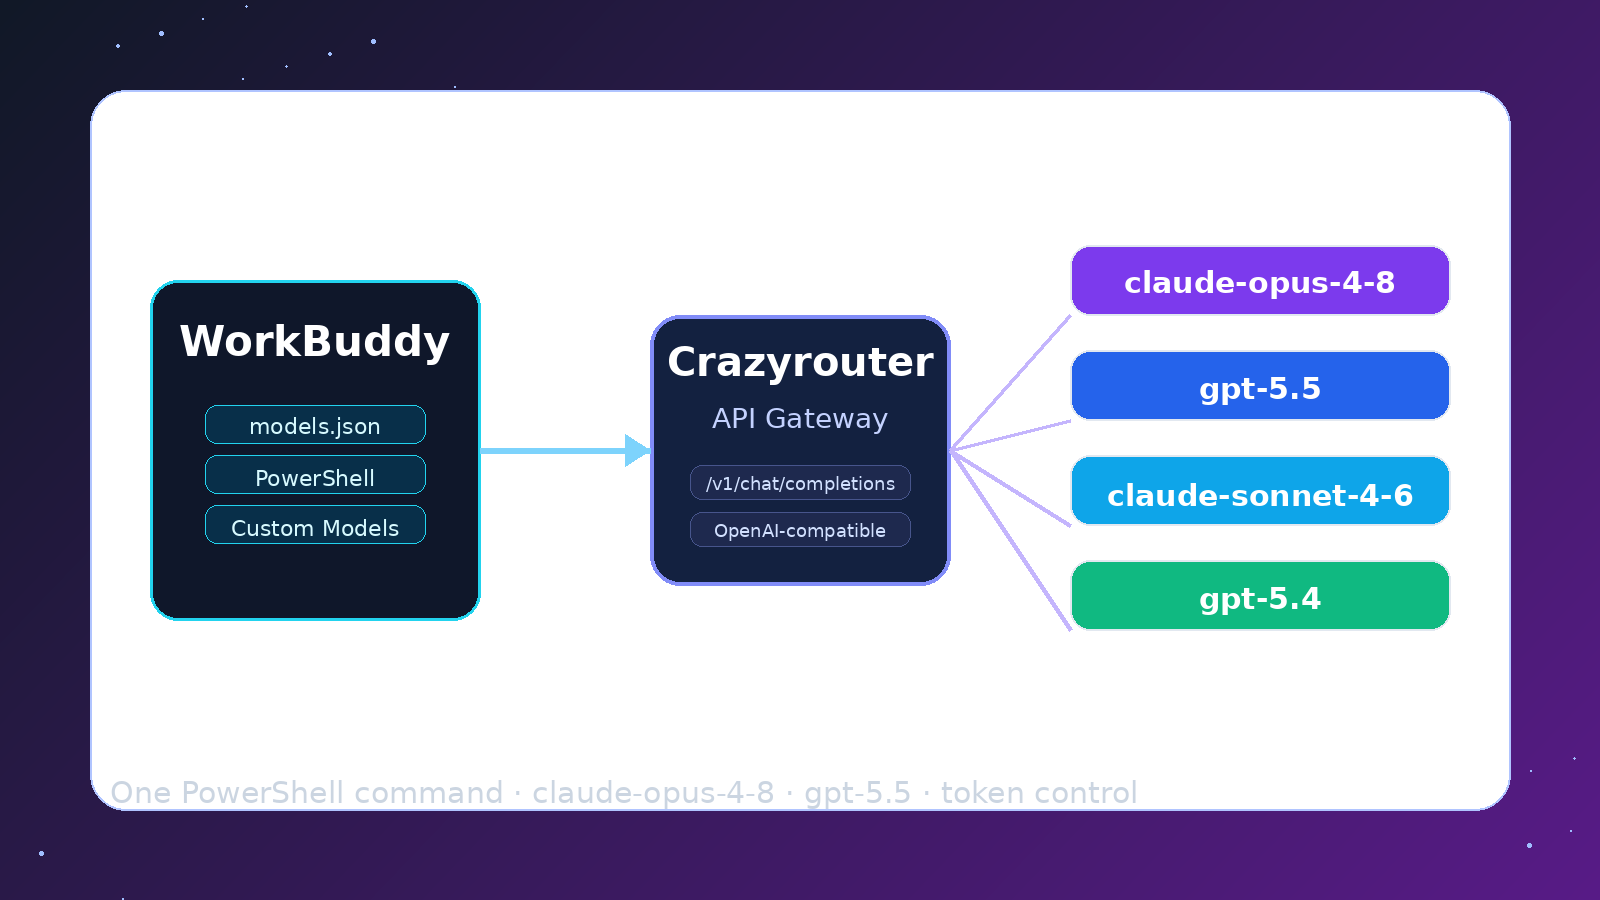
AI API 网关的核心思路很简单:一个接口、一个密钥、所有模型。
你只需要对接一个 OpenAI 兼容的 API 端点,就可以调用 Claude、GPT、DeepSeek、Gemini、Llama 等 600+ 模型。
from openai import OpenAI

# 一个客户端,所有模型
client = OpenAI(
    api_key="your-api-key",
    base_url="https://crazyrouter.com/v1"
)

# 调用 Claude
response = client.chat.completions.create(
    model="claude-sonnet-4.6",
    messages=[{"role": "user", "content": "分析这段论文的方法论部分"}]
)

# 调用 GPT
response = client.chat.completions.create(
    model="gpt-5.2",
    messages=[{"role": "user", "content": "总结这篇论文的核心贡献"}]
)

# 调用 DeepSeek
response = client.chat.completions.create(
    model="deepseek-chat",
    messages=[{"role": "user", "content": "用中文解释这个算法的时间复杂度"}]
)
代码结构完全一样,只是 model 参数不同。
对高校实验室的实际好处#
1. 采购流程简化#
不需要分别向 OpenAI、Anthropic、DeepSeek 各开一个账号。一个平台,一次采购,一份消费记录。
2. 成本可控#
按量付费,用多少算多少。没有月费、没有最低消费。适合科研项目经费按课题拨付的模式。
实际价格通常比官方直连低 40-55%,因为网关平台有批量采购优势。
3. 消费明细清晰#
后台可以看到每个模型、每次调用的消费明细,支持导出。方便做经费核算和项目结题报告。
4. 团队管理#
可以给实验室不同成员分配不同的 API Key,各自的用量独立统计。导师可以看到整个实验室的总消费。
5. 模型切换零成本#
论文实验经常需要对比不同模型的效果。统一接口意味着切换模型只需要改一个字符串,不需要重写代码。
典型使用场景#
场景 1:论文实验 — 多模型对比#
models = ["claude-sonnet-4.6", "gpt-5.2", "deepseek-chat", "gemini-2.5-flash"]
results = {}

for model in models:
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": benchmark_prompt}]
    )
    results[model] = response.choices[0].message.content

# 对比分析各模型输出
场景 2:教学 — 学生分组使用不同模型#
给每个学生组分配独立的 API Key,设置用量上限,避免超支。
场景 3:RAG 系统 — 混合使用 Embedding + Chat 模型#
# Embedding
embedding = client.embeddings.create(
    model="text-embedding-3-small",
    input="量子计算的基本原理"
)

# 检索后用 Chat 模型生成回答
answer = client.chat.completions.create(
    model="claude-sonnet-4.6",
    messages=[{"role": "user", "content": f"根据以下资料回答:{context}"}]
)
如何开始#
- 访问 Crazyrouter 注册账号
- 充值(支持多种支付方式)
- 获取 API Key
- 把
base_url改成https://crazyrouter.com/v1 - 开始调用任意模型
整个过程 5 分钟。
常见问题#
支持哪些模型?#
600+ 模型,包括 Claude 全系列、GPT 全系列、DeepSeek、Gemini、Llama、Mistral、Embedding 模型、TTS、STT 等。
数据安全怎么保证?#
API 网关只做请求转发,不存储对话内容。所有请求通过 HTTPS 加密传输。
适合什么规模的团队?#
从个人研究者到几十人的实验室都适合。按量付费,没有最低消费门槛。
如何获取消费明细?#
后台提供详细的调用记录和消费统计,支持按时间、按模型、按成员筛选和导出。
机构采购怎么咨询?#
发邮件到 support@crazyrouter.com,说明机构名称和预估用量,会有专人对接。