 简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
Русский промпт ломает mimo-v2.6-pro: 8 забавных проб против gpt-6-astra, ноль пеликанов из трёх
8 забавных проб по-русски (SVG пеликана, коробка конфет, буква «о», 9,11 против 9,9, акростих МОСТ) на mimo-v2.6-pro и gpt-6-astra, по 3 прогона. Короткие задачи — ничья. На пеликане mimo 0/3: думает 5–6 минут и молчит; по-английски рисует 3/3. gpt 3/3, но маршрут вставляет ~4100 токенов в запрос.
Это русскоязычный раунд серии, которую мы начали на китайском. Те же две модели и те же восемь типов проб, но каждый промпт написан по-русски с нуля, каждый вызов выполнен заново, и все рисунки ниже сгенерированы именно для этой статьи. Раунды на других языках — отдельные эксперименты со своими данными; в конце мы их сопоставим, потому что вместе они меняют вывод.
Коротко#
- 48 вызовов (8 проб × 2 модели × 3 прогона); вернулось 42, шесть упёрлись в клиентский таймаут 900 с и исключены из оценки (см. «Что сломалось»).
- На семи текстовых пробах, где ответ вернулся, обе модели верны почти во всём. Единственный сбой mimo: один акростих, на котором она истратила весь бюджет 4000 токенов на рассуждение и не вывела ни строки.
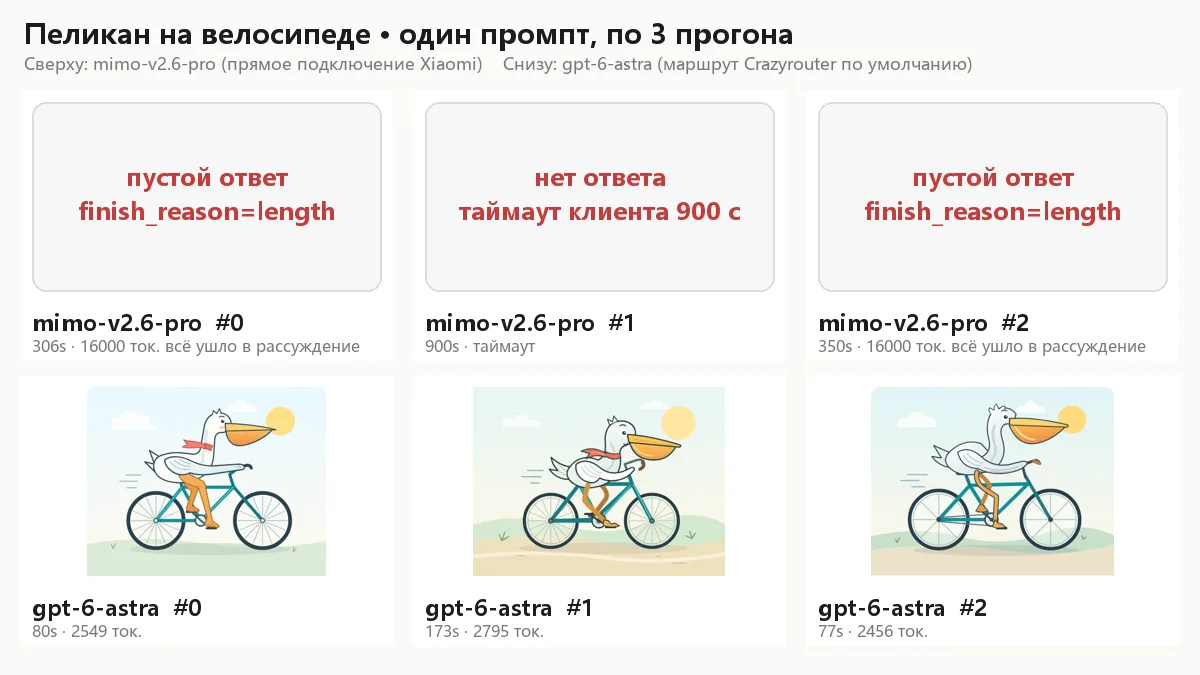
- SVG «пеликан на велосипеде»: mimo-v2.6-pro 0 из 3. Два прогона думали 306 и 350 секунд, сожгли ровно 16 000 токенов в рассуждении и вернули пустую строку с
finish_reason=length; третий вообще не ответил за 900 с. gpt-6-astra — 3 из 3, 77–173 с. - Та же модель по-английски рисует 3 из 3. Проблема не в способности рисовать, а в том, что русский промпт запускает у mimo бесконечное планирование.
- Стоимость вернувшихся вызовов: mimo 0,267 — 7,2×.
- Раскрытие: маршрут gpt-6-astra по умолчанию вставляет в каждый запрос ~4100 скрытых токенов, а в этом раунде дважды упал и был перекинут платформой на другой канал — мы увидели это по
prompt_tokens.
Сначала о маршруте: что именно мы тестировали#
| mimo-v2.6-pro | gpt-6-astra | |
|---|---|---|
| Маршрут | один канал, прямое подключение к официальному эндпоинту Xiaomi | 18 каналов-кандидатов; побеждает сторонняя линия с наивысшим приоритетом |
prompt_tokens на «hi» | 8 | 4121 (3968 из них — попадания в кэш) |
| Скрытый префикс | нет | ~4100 токенов в 17 из 21 вернувшихся вызовов (prompt_tokens 4139–4280) |
| Что случилось с остальными четырьмя | — | prompt_tokens 35, 45, 63 и 65 — префикса нет; в журнале платформы в это время четыре записи «Service temporarily unavailable» по gpt-6-astra: канал по умолчанию отказал, запрос ушёл на резервный |
| id ответа | UUID | resp_… — апстрим Responses API, переведённый в chat completions |
Значит, «gpt-6-astra» в этой статье — это gpt-6-astra, достигнутый 22.09.2026 через этот маршрут, причём в четырёх вызовах — уже через другой. Показательно, что четыре «чистых» вызова без префикса дали тот же стиль пеликана и те же ответы, что и вызовы с префиксом: сам префикс, похоже, на содержимое не влияет, но платить за него приходится — около $0,013 за вызов ещё до вашего вопроса.
Проверка занимает секунду и мы советуем её перед любым бенчмарком: отправьте «hi» и посмотрите на prompt_tokens.
Условия#
curl https://api.crazyrouter.com/v1/chat/completions \
  -H "Authorization: Bearer $CRAZYROUTER_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "mimo-v2.6-pro",
    "messages": [{"role": "user", "content": "Напиши четверостишие-акростих: первые буквы строк по порядку должны образовать слово МОСТ. В каждой строке ровно пять слов. Выведи только четыре строки, без заголовка, без знаков препинания и без пояснений."}],
    "max_tokens": 4000
  }'
Без системного промпта, температура по умолчанию, без стриминга; max_tokens 4000 для текста и 16 000 для SVG; клиентский таймаут 900 с. Записывались id, usage, finish_reason и время; SVG рендерились Playwright в 480 px. Цены: mimo-v2.6-pro 0,87 за миллион входных / выходных токенов; gpt-6-astra 25 (кэшированный вход $0,50) — см. тарифы.
Восемь проб#
| # | Проба (промпт по-русски) | Верный ответ | mimo-v2.6-pro | gpt-6-astra |
|---|---|---|---|---|
| 1 | SVG пеликана на велосипеде | рисунок | 0/3 (2 пустых, 1 таймаут) | 3/3 |
| 2 | Коробка «КОНФЕТЫ» с карандашами: что думает Лена до и после тайной подмены | конфеты / карандаши | 3/3 | 2/2 (1 таймаут) |
| 3 | Сколько «о» во фразе «молоко около окошка» | 8 | 3/3 | 3/3 |
| 4 | Что больше, 9,11 или 9,9 (с русской запятой) | 9,9 | 2/2 (1 таймаут) | 3/3 |
| 5 | Фермер и капуста, минимум переправ | 1 | 2/2 (1 таймаут) | 2/2 (1 таймаут) |
| 6 | У Алисы 4 брата и 2 сестры; сколько сестёр у брата | 3 | 3/3 | 3/3 |
| 7 | Акростих МОСТ, ровно пять слов в строке | структурная проверка | 2/3 (1 — бюджет ушёл в рассуждение) | 2/2 (1 таймаут) |
| 8 | Предложение, правдиво называющее число своих слов | проверка счётом | 3/3 | 3/3 |
Что не видно в таблице.
gpt-6-astra повторяется. Все три самоописывающих предложения — одно и то же: «В этом предложении ровно шесть слов.» Два акростиха начинаются с «Осенний ветер тихо гладит воду» на второй строке. mimo дала три разных формулировки («состоит из шести слов» дважды, «содержит ровно шесть слов») и два непохожих стихотворения.
mimo добавляет форматирование, которого не просили. В коробке конфет она отвечает верно, но заворачивает каждый ответ в жирный Markdown и приписывает «так как…». gpt — две нумерованные строки, как просили.
Акростихи — mimo:
Мрачный вихрь кружит в ночи
Осенний лист шуршит под ногой
Солнечный луч сияет в окно
Тихий ветер дует над рекой
gpt-6-astra:
Мерцает месяц над рекой сонной
Осенний ветер тихо гладит воду
Сияет мост над тишиной бездонной
Теченье дарит лодке вновь свободу
Оба соблюдают форму; у gpt есть рифма, у mimo — нет, но её и не просили.
Пеликан: здесь раунд решился#
| Прогон | mimo-v2.6-pro |
|---|---|
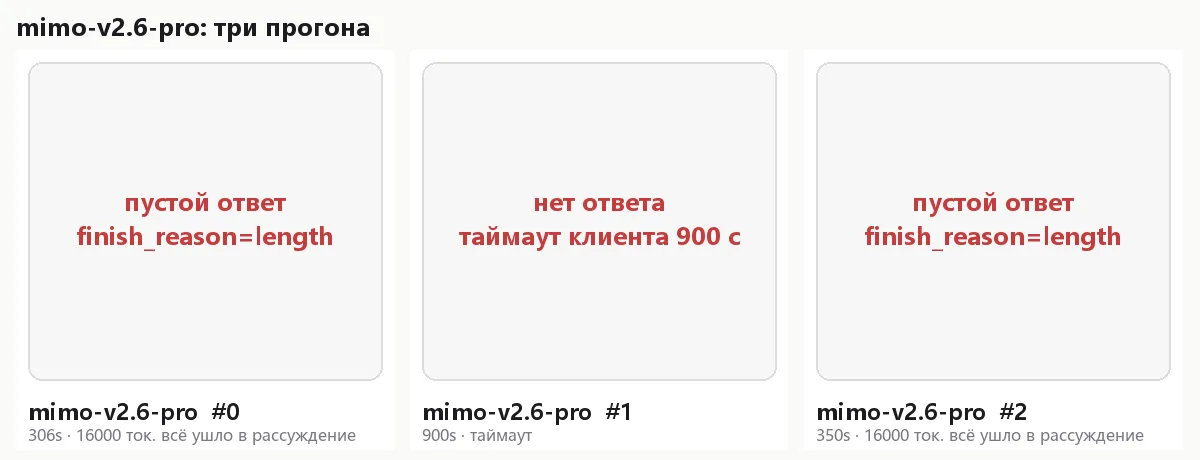
| #0 | 306 с, 16 000 токенов вывода, из них 16 002 в рассуждении, контент пуст, finish_reason=length |
| #1 | нет ответа за 900 с |
| #2 | 350 с, 16 000 токенов, снова всё в рассуждении, контент пуст |
Мы заглянули в рассуждение первого прогона (апстрим его возвращает): 41 957 символов — по-английски, хотя промпт русский — планирование координат, где сидит пеликан, куда крыло, в каком порядке слои, и даже черновики <svg> внутри самого рассуждения, которые модель раз за разом переписывала. В ответ не попало ничего. Модель не ошиблась в рисунке; она не решилась его отдать. Каждый такой прогон стоил $0,0139 и вернул пустую строку.
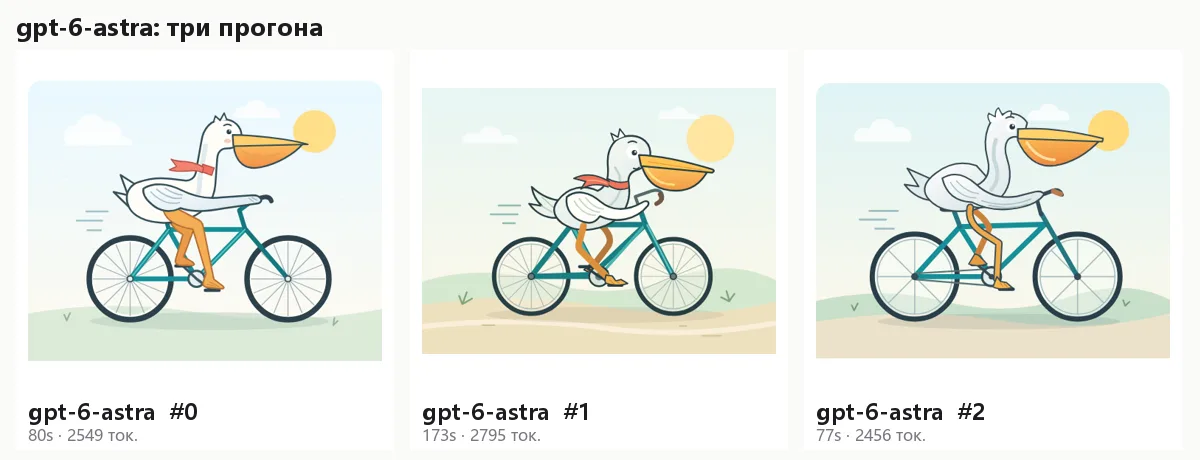
| Прогон | gpt-6-astra |
|---|---|
| #0 | 80 с, 2549 токенов. Пеликан на седле, крыло на руле, лапа на педали, красный шарф |
| #1 | 173 с, 2795 токенов. Тот же сюжет; этот вызов ушёл на резервный канал (без префикса, reasoning_tokens=112) — стиль не изменился |
| #2 | 77 с, 2456 токенов. Тот же сюжет, чуть другой фон |
Исходные SVG без изменений: gpt #0 · gpt #1 · gpt #2. У mimo публиковать нечего.
Задержки (только вернувшиеся вызовы, среднее, с)#
| Проба | mimo-v2.6-pro | gpt-6-astra |
|---|---|---|
| Четыре короткие ловушки | 8,7 | 12,2 |
| Коробка конфет | 15,6 | 5,1 |
| Акростих | 68,0 | 17,5 |
| Самоописывающее предложение | 9,4 | 4,6 |
| SVG пеликана | 328 | 110 |
У gpt короткие задачи замедлил переезд на резервный канал (задача про Алису — 20–60 с вместо обычных 3–4). У mimo русский акростих стоил 17–109 с раздумий против 7–10 с у gpt.
Что сломалось: 6 таймаутов из 48, у обеих моделей#
Шесть вызовов не вернулись за 900 с: пеликан mimo, конфеты gpt, «9,11 или 9,9» mimo, переправа у обеих, акростих gpt. В журнале использования платформы большинства из них нет — они не завершились на апстриме, не были оплачены и не вернули ошибку; соединение просто висело. Две модели, два апстрима, тривиальные вопросы — это транспорт, а не интеллект. Мы исключили их из счёта и честно перечисляем здесь. В продакшене ставьте собственный дедлайн на длинные нестриминговые вызовы.
Что показали другие языки#
Тот же набор проб с промптами, написанными носителями, мы прогнали на китайском, английском, португальском и японском. Короткие пробы — ничья везде. Пеликан — нет:
| Язык промпта | пеликаны mimo-v2.6-pro | пеликаны gpt-6-astra |
|---|---|---|
| Английский | 3/3 | 2/2 вернувшихся |
| Китайский | 2/3 | 3/3 |
| Русский (эта статья) | 0/3 | 3/3 |
| Португальский | 0/3 | 3/3 |
| Японский | 1/3 | 3/3 |
Спросите mimo по-английски — и ничего из описанного не происходит. Это самый полезный результат серии, и англоязычный бенчмарк его бы не показал.
Совет для продакшена#
Для любой рассуждающей модели — страховка от «рассуждение съело бюджет»:
resp = client.chat.completions.create(model="mimo-v2.6-pro", messages=msgs, max_tokens=8000)
c = resp.choices[0]
if c.finish_reason == "length" and not c.message.content:
    # думала до исчерпания max_tokens, тело пустое: повторить с меньшим бюджетом
    # или уйти на другую модель; пустую строку не сохранять как ответ
    ...
Для открытых генеративных задач давайте mimo английский промпт, пока это не исправлено; на нестриминговые вызовы ставьте свой таймаут. Перед бенчмарком любого зарубежного флагмана через шлюз отправьте «hi» и прочитайте prompt_tokens. Инспектор маршрутизации Crazyrouter показывает, на какой канал сейчас попадает модель и сколько у неё кандидатов — после регистрации; страница моделей перечисляет эндпоинты и цены.
FAQ#
Почему именно такие пробы, а не стандартный бенчмарк? Их нельзя заучить: пеликан заставляет модель кодировать пространство в координаты здесь и сейчас, акростих и самоописывающее предложение проверяются структурно, ловушки проверяют, не подставляет ли модель знаменитую задачу вместо заданной. Цена — субъективная оценка рисунков, поэтому все SVG опубликованы.
Пустой ответ mimo — проблема платформы?
Нет. finish_reason=length, reasoning_tokens=16002 и пустой контент пришли с официального эндпоинта Xiaomi без единого вставленного токена, и платформа списала за них деньги. Это цикл размышлений модели, который запускают неанглийские промпты на открытых задачах.
Как вы поняли, что gpt-6-astra переехал на другой канал?
По prompt_tokens: 4139–4280 у семнадцати вызовов и 35–65 у четырёх; у четырёх появился reasoning_tokens, которого линия по умолчанию не отдаёт; в журнале платформы в это время — четыре ошибки «Service temporarily unavailable» по gpt-6-astra. Резервирование сработало, но задержка выросла.
Какая часть разрыва 7,2× — вставленный префикс? 17 × ~4100 ≈ 70 тыс. входных токенов, почти все по кэшированной цене 0,04 из $0,27, то есть примерно 15%. Остальное — прайс-лист.
Достаточно ли трёх прогонов? Для «кто умнее» — нет. Для «кто перестаёт работать по-русски» — да.
Где мультимодальный тест? mimo ведь омнимодальна. Не в этой серии. Только текст, намеренно.
См. также#
- gpt-6-astra vs Claude Fable 5.1: на 60% меньше символов вывода — но отчасти потому, что отвечает меньше
- Claude Fable 5.1 vs Fable 5: эффективность вывода, правильность и ломающие изменения без ошибок
- Почему Crazyrouter, а не OpenRouter? Три конкретных отличия
- Тот же эксперимент на китайском · английском · португальском · японском
- Тарифы · Документация
Итог#
На русском, 22.09.2026, через эти два маршрута: на текстовых пробах модели почти неразличимы, а на единственной открытой генеративной задаче mimo-v2.6-pro не выдала ничего три раза из трёх, при этом по-английски выдаёт три из трёх. gpt-6-astra дороже в 7 раз, повторяет сама себя и один раз на наших глазах сменила канал — но рисует. Тестируйте на языке, на котором пишут ваши пользователи.