 简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
日本語で聞くと mimo-v2.6-pro は黙る:gpt-6-astra との遊び心プローブ 8 種、折句 0/3・ペリカン 1/3、そして API 経路の 4,100 トークン注入
日本語プロンプトによる 8 種の遊び心プローブ(ペリカン SVG、キャンディ箱、「すもももももも」の「も」数え、9.11 と 9.9、いろはに折句)を mimo-v2.6-pro と gpt-6-astra で各 3 回。短答は互角だが、mimo は折句 0/3・ペリカン 1/3 ― 推論で予算を使い切り本文が空。英語なら 3/3 描ける。gpt は 3/3 だが経路が毎回 ~4,100 トークンを注入。
中国語で始めたシリーズの日本語ラウンドです。モデルもプローブの種類も同じですが、プロンプトはすべて日本語で書き下ろし、呼び出しはすべて新規に実行し、以下の絵はこの記事のために生成したものです。他言語のラウンドは別の実験・別のデータで、最後に突き合わせます ― 合わせて見ると結論が変わるからです。
要約#
- 48 呼び出し(8 プローブ × 2 モデル × 3 回)。42 件が返り、6 件はクライアント側 900 秒タイムアウトで採点対象外(「何が壊れたか」参照)。
- 短答 4 問と心の理論は両モデルとも返ってきた分は全問正解。
- いろはに折句(各行 7 文字):mimo-v2.6-pro 0/3。 3 回とも 102〜148 秒考え続け、4,000 トークンの予算をすべて推論で使い切り、本文は空。gpt-6-astra は 3/3(ただし 3 回ほぼ同じ句)。
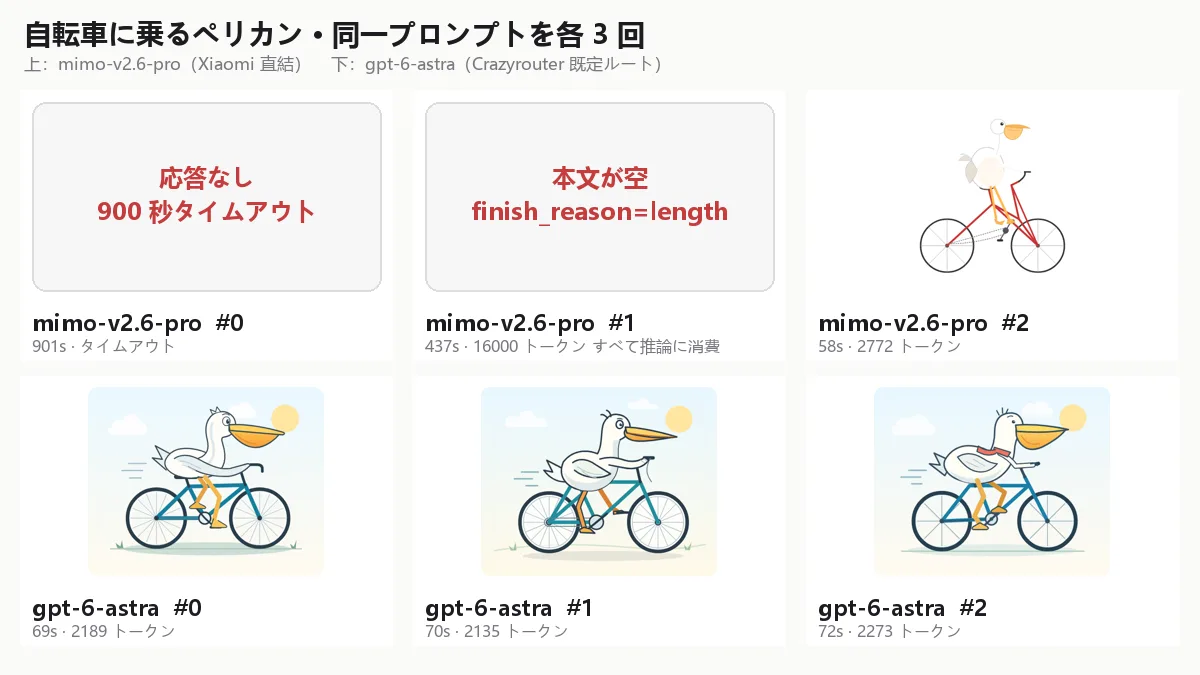
- ペリカン SVG:mimo 1/3(1 回は 437 秒・16,000 トークンを推論で消費して空、1 回は無応答、描けた 1 回もフレームの上に立つだけ)。gpt 3/3、69〜72 秒。
- 同じ mimo に英語で頼むとペリカンは 3/3。描けないのではなく、日本語プロンプトが終わらない計画ループを起動する。
- 返ってきた呼び出しの費用:mimo 0.270 ― 8.2 倍。
- 開示:gpt-6-astra の既定ルートは毎リクエストに約 4,100 トークンの見えないプレフィックスを注入している。返ってきた 21 件すべてに付いていた。
まず経路:何を測ったのか#
| mimo-v2.6-pro | gpt-6-astra | |
|---|---|---|
| ルート | 1 チャネル、Xiaomi 公式エンドポイントに直結 | 候補 18 チャネル、最優先のサードパーティ回線が選ばれる |
素の "hi" の prompt_tokens | 8 | 4121(うち 3968 がキャッシュヒット) |
| 隠しプレフィックス | なし | 約 4,100 トークン、返ってきた 21 件すべて(prompt_tokens 4146〜4299) |
| レスポンス id | UUID | resp_… ― 上流は Responses API、chat completions に変換 |
usage の reasoning_tokens | 毎回 | ときどき |
つまり本稿の「gpt-6-astra」は 2026-09-22 にこの経路で到達した gpt-6-astra です。プレフィックスは挙動を変えうるし、何も書かないうちから 1 回約 $0.013 かかり、レスポンスには現れません。確認は一瞬で、どのベンチマークの前にも勧めます ― "hi" を送って prompt_tokens を見る。
条件#
curl https://api.crazyrouter.com/v1/chat/completions \
  -H "Authorization: Bearer $CRAZYROUTER_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "mimo-v2.6-pro",
    "messages": [{"role": "user", "content": "四行の折句を作ってください。各行の最初の文字は順に「い」「ろ」「は」「に」とし、各行はちょうど七文字にしてください。四行だけを出力し、タイトル、句読点、説明は付けないでください。"}],
    "max_tokens": 4000
  }'
システムプロンプトなし、既定温度、非ストリーミング。max_tokens はテキスト 4,000・SVG 16,000、クライアントタイムアウト 900 秒。id・usage・finish_reason・所要時間を記録し、SVG は Playwright で 480px にレンダリング。価格:mimo-v2.6-pro 入力 0.87(100 万トークンあたり)、gpt-6-astra 25(キャッシュ入力 $0.50)― 料金ページ。
8 つのプローブ#
| # | プローブ(日本語プロンプト) | 正解 | mimo-v2.6-pro | gpt-6-astra |
|---|---|---|---|---|
| 1 | 自転車に乗るペリカンの SVG | 絵 | 1/3(空 1、無応答 1) | 3/3 |
| 2 | 「キャンディ」箱に鉛筆:花子は入れ替え前後に何が入っていると思うか | キャンディ / 鉛筆 | 3/3 | 3/3 |
| 3 | 「すもももももももものうち」の「も」の数 | 8 | 2/2(1 無応答) | 3/3 |
| 4 | 9.11 と 9.9 のどちらが大きいか | 9.9 | 2/2(1 無応答) | 2/2(1 無応答) |
| 5 | 農夫とキャベツだけの渡河、最少回数 | 1 | 3/3 | 3/3 |
| 6 | アリスは兄弟 4 人姉妹 2 人、兄弟の姉妹の数 | 3 | 3/3 | 3/3 |
| 7 | いろはに折句、各行ちょうど 7 文字 | 構造チェック | 0/3(3 回とも推論で予算切れ) | 3/3 |
| 8 | 自分の文字数を正しく述べる一文 | 文字数チェック | 2/3(1 回は予算切れで空) | 1/1(2 無応答) |
表に出ない二点。
gpt-6-astra は同じ句を繰り返す。 折句 3 回の 1〜2 行目は完全に同一 ―「いろづくやまへ/ろじにかぜふく」。変わるのは 3〜4 行目の語尾だけです。中国語ラウンドでも同じ経路で同じ現象を見ました。モデルの性質か、ラッパーが温度を固定しているのかは外からは判別できません。
mimo は頼んでいない装飾を付ける。 キャンディ箱では正答しつつ、各答えを太字 Markdown で包み「〜ので」と理由を足す。gpt は指示どおり二行で返す。
gpt-6-astra の折句(#0):
いろづくやまへ
ろじにかぜふく
はなびらゆれて
にじをみあげる
mimo は 3 回とも本文なし。推論を覗くと(上流が返してくれる)、7 文字を満たす候補を英語で延々と数え直していました ―「ろうかのあかりは = 8 ✗」「ろくかのひかり = 7 ✓ "Light of green fire" - weird」― そのまま 4,000 トークンを使い切って終わっています。
自己言及文:mimo「この文は十文字です。」(句点込みで 10 文字、正しい)、gpt「この文は十六文字でできています。」(句点込みで 16 文字、正しい)。句点を数えるかどうかで揺れるので、込み・抜きどちらか一致すれば正解としています。
ペリカン#
| 回 | mimo-v2.6-pro |
|---|---|
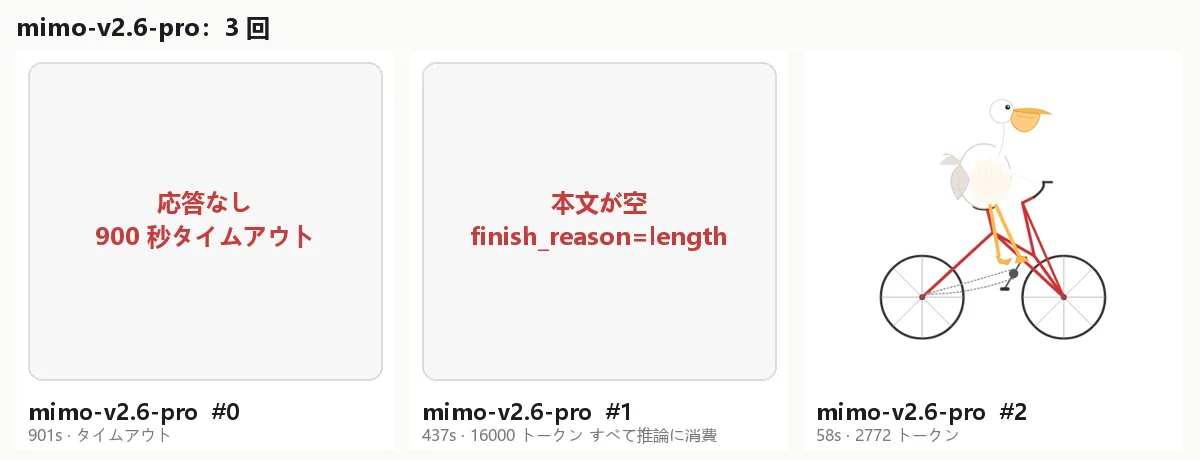
| #0 | 900 秒無応答 |
| #1 | 437 秒、出力 16,000 トークン(推論 16,004)、本文空、finish_reason=length |
| #2 | 58 秒、2,772 トークン。赤い自転車の上にペリカンが立っている。脚はペダルに届かず、車体は線画に近い |
#1 の推論は 38,108 文字 ― プロンプトが日本語でも推論は英語 ― 座標の計画、翼の位置、レイヤー順、そして推論の中で <svg> を何度も下書きしては書き直し、結局一つも回答に出さずに終わっています。1 回 $0.0139 で、返ってきたのは空文字列でした。
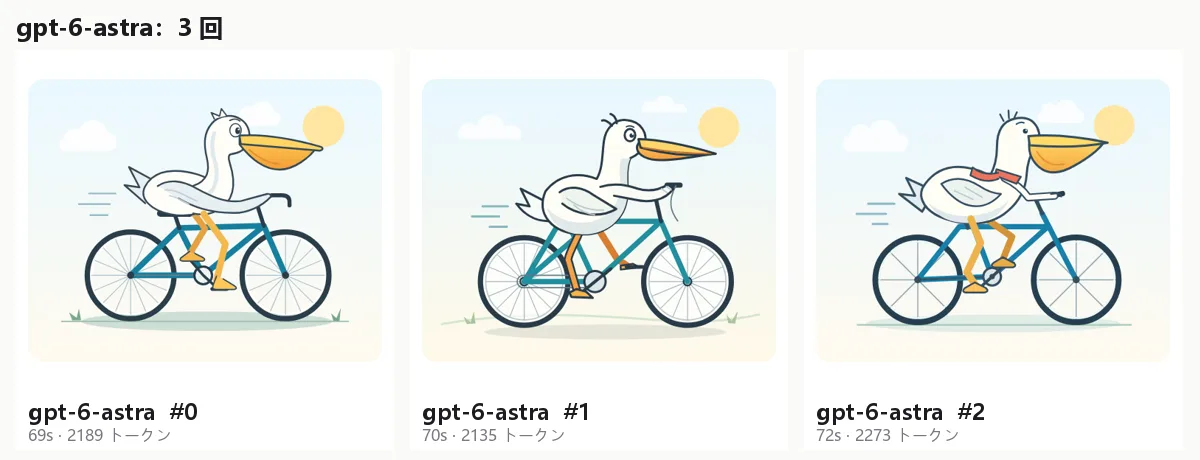
| 回 | gpt-6-astra |
|---|---|
| #0 | 69 秒、2,189 トークン。サドルに着座、翼はハンドル、脚はペダル、太陽と雲 |
| #1 | 70 秒、2,135 トークン。同じ構図 |
| #2 | 72 秒、2,273 トークン。同じ構図に赤いマフラー |
SVG 原本(無修正):mimo #2 · gpt #0 · gpt #1 · gpt #2
レイテンシ(返ってきた呼び出しのみ、平均秒)#
| プローブ | mimo-v2.6-pro | gpt-6-astra |
|---|---|---|
| 短答 4 問 | 5.0 | 4.9 |
| キャンディ箱 | 12.7 | 4.3 |
| 折句 | 123.9(3 回とも失敗) | 8.6 |
| 自己言及文 | 39.7 | 8.1 |
| ペリカン SVG | 247.6(2 回) | 70.2 |
何が壊れたか:48 件中 6 件のタイムアウト、両モデルで#
6 件が 900 秒以内に返りませんでした:mimo のペリカン・文字数え・小数比較、gpt の小数比較と自己言及文 2 回。プラットフォームの利用ログにはその多くの完了記録がなく ― 上流で終わらず、課金もされず、エラーも返らず、接続が開いたままでした。2 モデル・2 上流・「9.11 と 9.9」のような自明の問いでも起きたので、これは知能ではなく転送の問題です。採点から除外し、ここに明記します。本番で長い非ストリーミング呼び出しをするなら、自前の期限を必ず置いてください。
他の言語では#
同じ 8 種を中国語・英語・ロシア語・ポルトガル語でもネイティブに書いたプロンプトで実行しました。短答はどの言語でも互角。ペリカンは違います:
| プロンプト言語 | mimo-v2.6-pro のペリカン | gpt-6-astra のペリカン |
|---|---|---|
| 英語 | 3/3 | 受信 2/2 |
| 中国語 | 2/3 | 3/3 |
| ロシア語 | 0/3 | 3/3 |
| ポルトガル語 | 0/3 | 3/3 |
| 日本語(本稿) | 1/3 | 3/3 |
折句まで落ちたのは日本語だけです(7 文字制約が推論ループを誘発したと見ています)。英語で頼めば何も起きない ― これがシリーズ最大の収穫で、英語だけのベンチマークでは決して見えません。
本番への助言#
推論モデル全般に、「思考が予算を食い尽くす」ケースの防御を:
resp = client.chat.completions.create(model="mimo-v2.6-pro", messages=msgs, max_tokens=8000)
c = resp.choices[0]
if c.finish_reason == "length" and not c.message.content:
    # max_tokens まで考えて本文が空:予算を絞って再試行するか別モデルへ。
    # 空文字列を回答として保存しない
    ...
修正されるまで、mimo への自由生成タスクは英語プロンプトで。非ストリーミング呼び出しには自前のタイムアウトを。ゲートウェイ経由で海外フラッグシップをベンチマークする前に "hi" を送って prompt_tokens を読む。Crazyrouter のルーティングインスペクタは、モデルが今どのチャネルに乗り候補が何本あるかを表示します ― 登録後に、モデルページでエンドポイントと価格を確認できます。
FAQ#
なぜ標準ベンチマークではなくこのプローブか? 暗記できないからです。ペリカンは空間関係をその場で座標にする必要があり、折句と自己言及文は構造で機械的に検証でき、引っかけ問題は与えられていない有名パズルに当てはめないかを見ます。代償は絵の採点が主観になることで、そのため SVG は全公開しています。
mimo の空出力はプラットフォーム側の問題?
違います。finish_reason=length、reasoning_tokens=16004、空の本文は Xiaomi 公式エンドポイントから注入ゼロで返ってきたもので、トークンは課金されています。非英語プロンプトが自由生成タスクで誘発するモデル自身の思考ループです。
8.2 倍のコスト差のうち注入分は? 21 × 約 4,100 ≒ 86K 入力トークン、ほぼキャッシュ価格 0.27 のうち約 $0.045、2 割弱。残りは定価の差です。
日本語の「文字数」の数え方は? 句点を含めるか否かは曖昧なので、どちらか一致で正解にしています。mimo は 10 文字(句点込み)、gpt は 16 文字(句点込み)で、いずれも一致しました。
3 回で足りる? 「どちらが賢いか」には足りません。「どちらが日本語で動かなくなるか」には足りました。
マルチモーダルは? mimo はオムニモーダルでは? このシリーズでは扱いません。意図的にテキストのみです。
関連#
- gpt-6-astra vs Claude Fable 5.1:出力文字数 60% 減 ― ただし一部は答えが減っただけ
- Claude Fable 5.1 vs Fable 5:出力効率・正答性・エラーにならない破壊的変更
- なぜ OpenRouter ではなく Crazyrouter なのか?三つの具体的な違い
- 同じ実験の中国語版 · 英語版 · ロシア語版 · ポルトガル語版
- 料金 · ドキュメント
結論#
2026-09-22、日本語、この二つの経路において:短答では両者はほぼ区別できず、制約付き生成(折句)と自由生成(ペリカン)では mimo-v2.6-pro が本文を出せないことが 6 回中 5 回 ― 同じモデルが英語なら描ける。gpt-6-astra は 8 倍高く、同じ句を繰り返し、見えないプレフィックスを背負っている ― それでも描く。ユーザーが実際に書く言語でテストすること。