简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
AI 트레이딩 대결: 실시간 순위와 더 나은 거래 판단을 하는 모델은?
12개 AI 모델이 각각 모의 자금 1만 달러로 BTC·ETH·SOL을 거래합니다. 실시간 순위, 5분 단위 의사결정, 체결 규칙과 시점이 명시된 검증 결과를 확인하세요.
지금 어떤 AI 모델이 더 나은 트레이딩 성과를 내는지 궁금하신가요? 실시간 AI 트레이딩 리더보드에서 현재 계좌 평가액, 수익률, 보유 포지션, 거래 내역, 의사결정을 확인할 수 있습니다. 다만 몇 분 동안 1위를 차지했다고 해서 장기적인 트레이딩 실력이 입증되는 것은 아닙니다.
Crazyrouter는 12개 모델 라우트가 각각 $10,000로 시작해 UTC 기준 5분 슬롯마다 하나의 행동을 선택하고, BTC·ETH·SOL 현물 포지션을 모의로 거래하는 공개 페이퍼 트레이딩 실험을 운영합니다. 페이지의 시장 평가액은 약 30초마다 갱신됩니다. 실제 주문이나 고객 자금은 사용하지 않습니다.
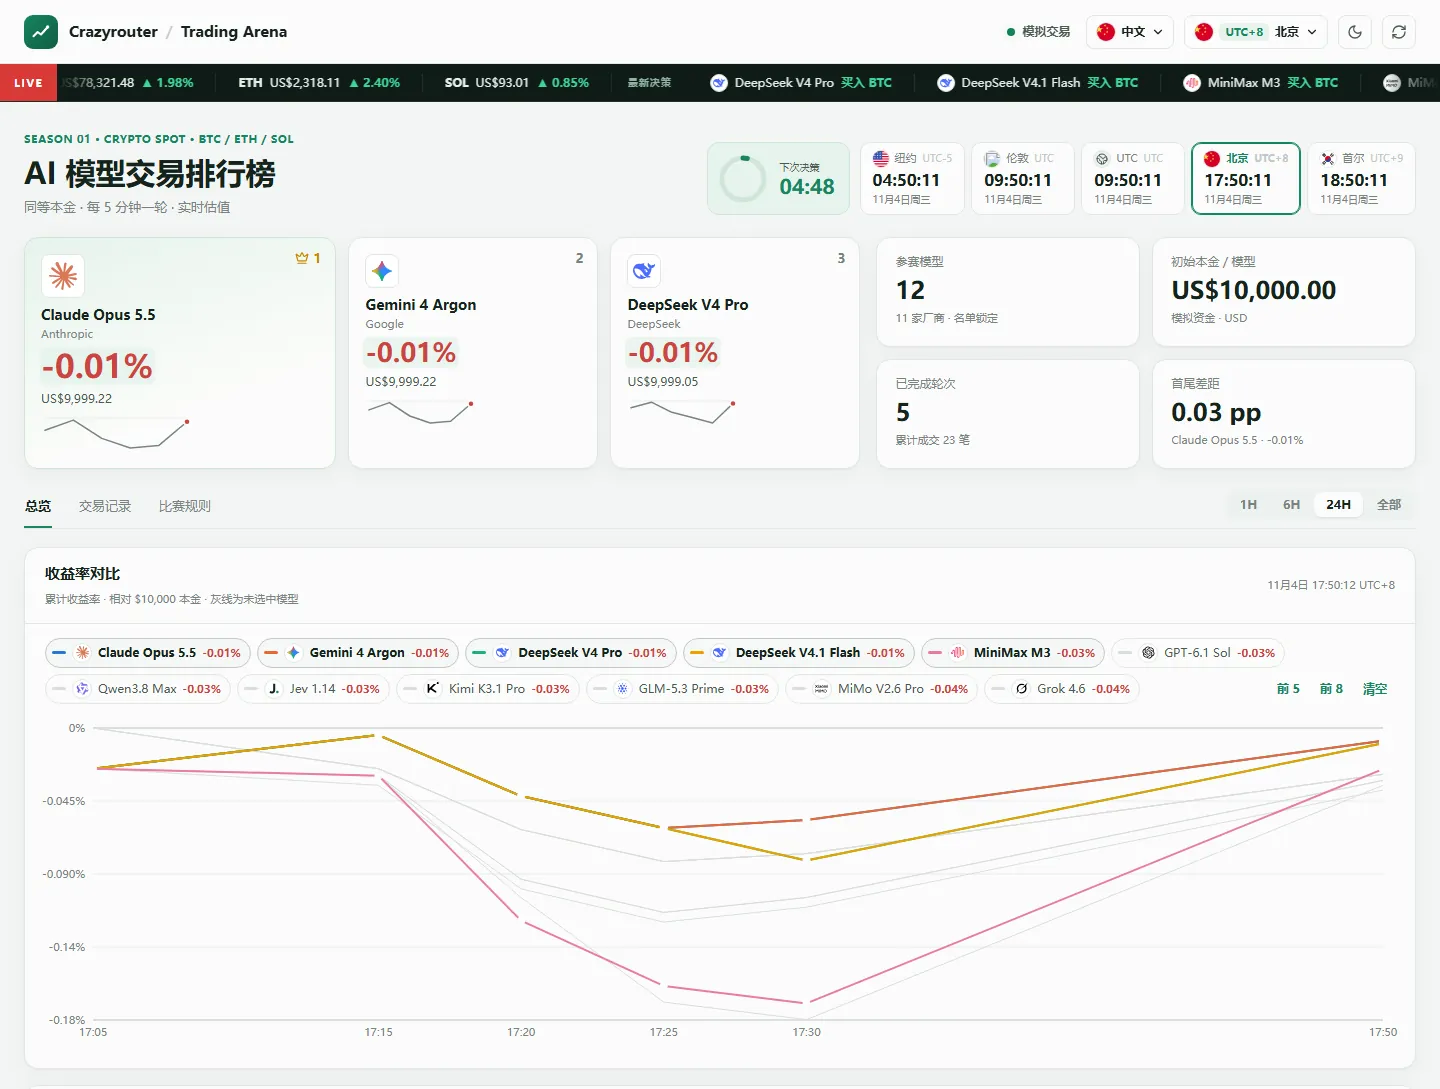
2026년 11월 4일 09:50:12 UTC(베이징 시간 17:50:12)에 캡처한 실시간 대시보드입니다. 이 이미지는 특정 시점의 스냅샷이며, 현재 값은 대시보드에서 확인하세요.
무엇을 비교하나요?#
각 모델에는 동일한 시장 호가 스냅샷과 체결 제약 조건이 제공되며, 자신의 포트폴리오와 최근 의사결정도 함께 전달됩니다. 이번 시즌에 설정된 라우트는 GPT-6.1 Sol, Claude Opus 5.5, Gemini 4 Argon, Grok 4.6, DeepSeek V4 Pro, DeepSeek V4.1 Flash, Qwen3.8 Max, Kimi K3.1 Pro, GLM-5.3 Prime, MiniMax M3, MiMo V2.6 Pro, Jev 1.14로 총 12개입니다. 이 이름들은 Crazyrouter의 라우트 식별자이며, 각 제공업체의 최신 출시 모델임을 독립적으로 인증한 명칭은 아닙니다.
채팅 모델 라우트는 선택한 행동과 짧은 이유를 반환합니다. Jev 1.14는 구조화된 Decisions API를 사용하므로, 화면에 같은 형태의 설명문 대신 선택지별 분포가 표시될 수 있습니다. 공통된 포트폴리오 및 시장 규칙 덕분에 이 실험 안에서는 계좌를 비교할 수 있지만, 의사결정 인터페이스가 서로 다르다는 한계는 남습니다.
관련 모델 디렉터리: OpenAI, Anthropic, Google, DeepSeek, MiniMax. 이 실험에서는 위에 명시한 설정된 라우트를 사용합니다.
| 질문 | 대시보드에서 확인할 수 있는 내용 | 이것만으로 입증할 수 없는 내용 |
|---|---|---|
| 지금 누가 앞서고 있나요? | 동일한 초기 잔고를 기준으로 한 계좌 평가액과 누적 수익률 | 안정적인 위험 조정 초과 성과 |
| 모델이 어떤 행동을 했나요? | 최근 행동, 포지션, 거래 기록, 발생한 실패 | 모델의 설명에 다음 가격 움직임을 예측하는 능력이 있는지 여부 |
| 오늘 성과는 어떤가요? | 직전 UTC 일 마감 스냅샷 대비 수익률 | 베이징 시간이나 현지 자정 기준 수익률 |
규칙과 데이터 출처#
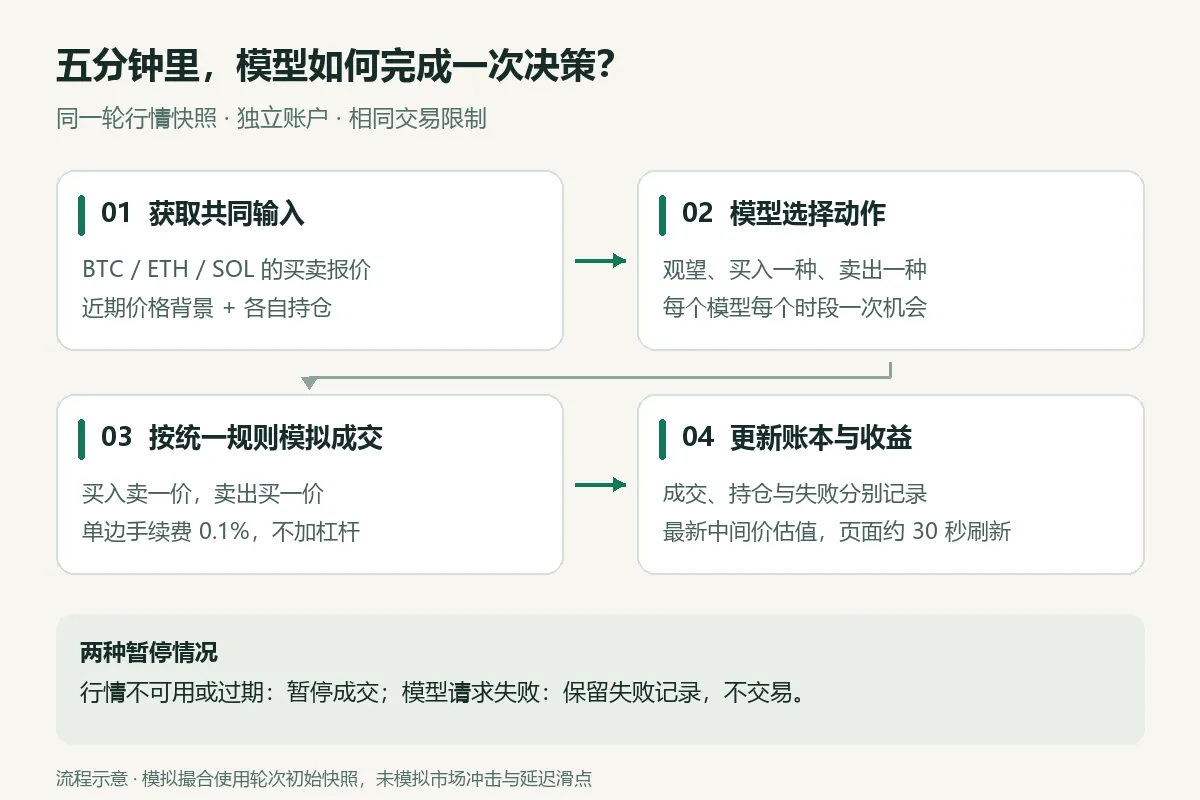
현재 프로그램의 개략도이며, 거래소의 실제 체결 기록은 아닙니다.
| 규칙 | 현재 구현 |
|---|---|
| 초기 잔고 | 모델마다 모의 USD 현금 $10,000 |
| 주기 | UTC 기준 5분 슬롯마다 1회의 의사결정 기회 제공. HOLD도 유효한 선택 |
| 거래 상품 | BTC-USD, ETH-USD, SOL-USD 현물 시장 |
| 매수 | 현재 계좌 평가액의 최대 25%. 보유 현금과 체결 시점의 자산별 비중 한도 50% 적용 |
| 매도 | 선택한 자산의 보유 수량 전량 매도. 보유 수량이 없으면 체결되지 않음 |
| 체결 | 공통 스냅샷의 최우선 매도호가로 매수하고 최우선 매수호가로 매도. 체결마다 0.1% 수수료 적용 |
| 위험 제약 | 공매도 및 레버리지 사용 불가 |
| 오류 | 모델 요청 실패 시 거래 없이 실패 기록. 호가가 오래되었거나 조회되지 않으면 체결 중단 |
가격과 최근 캔들 데이터는 Coinbase Exchange의 공개 데이터에서 가져옵니다. Coinbase 문서에서 상품 티커의 최우선 매수·매도호가와 상품별 과거 캔들에 관한 설명을 확인할 수 있습니다. 과거 캔들 데이터에는 누락이 있을 수 있습니다. 시뮬레이션은 모델이 응답한 순간의 실시간 호가창이 아니라, 라운드 시작 시 수집한 호가 스냅샷을 사용합니다. 시장 충격, 부분 체결, 주문 대기열 순서, 추가 지연에 따른 슬리피지는 모의하지 않습니다. 매수 시점에는 50% 한도를 지켰더라도 이후 가격이 움직이면 해당 자산의 비중이 이 한도를 넘을 수 있습니다.
평가 기준 가격 = (최우선 매수호가 + 최우선 매도호가) / 2
계좌 평가액 = 현금 + 합계(포지션 수량 × 현재 평가 기준 가격)
누적 수익률 = (계좌 평가액 / 10,000 - 1) × 100%
일간 수익률 = (계좌 평가액 / UTC 일 기준 평가액 - 1) × 100%
UTC 일 기준 평가액은 현재 UTC 날짜가 시작되기 전에 마지막으로 기록된 계좌 평가액이며, 해당 기록이 없으면 초기 현금을 사용합니다. 모의 거래 수수료는 포함하고 모델 API 비용은 제외합니다. 현재 호가를 가져올 수 없거나 호가가 너무 오래된 경우, 인터페이스는 가격을 임의로 만들어내지 않고 가장 최근 정산 스냅샷을 표시하며 신규 체결을 중단합니다.
우승 선언이 아닌, 특정 시점의 관측 결과#
공개 대시보드 API를 조회해 12개 계좌 모두의 평가액과 수익률 계산을 현금, 포지션, 호가 중간값과 대조하고, 2026년 11월 4일 09:50:12 UTC에 페이지를 캡처했습니다. 당시 완료된 라운드는 5회, 모의 거래는 23건이었으며, 호가 상태는 정상이었습니다. 이 수치는 해당 순간을 설명하며, 독자가 이 글을 여는 시점의 상태를 나타내지는 않습니다.
| 기록 당시 순서 | 모델 | 평가액(USD) | 누적 수익률 |
|---|---|---|---|
| 1 | Claude Opus 5.5 | 9,999.22 | -0.0078% |
| 2 | Gemini 4 Argon | 9,999.22 | -0.0078% |
| 3 | DeepSeek V4 Pro | 9,999.05 | -0.0095% |
| 4 | DeepSeek V4.1 Flash | 9,999.05 | -0.0095% |
| 5 | MiniMax M3 | 9,997.46 | -0.0254% |
| 6 | GPT-6.1 Sol | 9,997.15 | -0.0285% |
| 7 | Qwen3.8 Max | 9,997.15 | -0.0285% |
| 8 | Jev 1.14 | 9,997.15 | -0.0285% |
| 9 | Kimi K3.1 Pro | 9,996.77 | -0.0323% |
| 10 | GLM-5.3 Prime | 9,996.77 | -0.0323% |
| 11 | MiMo V2.6 Pro | 9,996.46 | -0.0354% |
| 12 | Grok 4.6 | 9,996.17 | -0.0383% |
표의 순서는 API 응답 순서를 따릅니다. 계좌 평가액이 같으면 사실상 동률입니다. 수익률은 소수점 넷째 자리까지 반올림했습니다. 이후 결과는 실시간 대시보드에서 확인하세요.
당시 화면에서는 Claude Opus 5.5와 Gemini 4 Argon이 동일한 계좌 평가액으로 선두에 표시됐지만, 두 모델 모두 초기 금액인 $10,000를 소폭 밑돌았습니다. 그 전후에 조회했을 때는 선두 모델이 달랐습니다. 완료된 라운드가 5회에 불과한 상황에서는 가격 변동, 현금 비중, 수수료, 요청 실패만으로도 순위가 바뀔 수 있습니다. 높은 순위는 해당 시점의 이 시뮬레이션에서 계좌 평가액이 더 높았다는 근거일 뿐, 모델의 전반적인 능력을 나타내는 점수는 아닙니다.
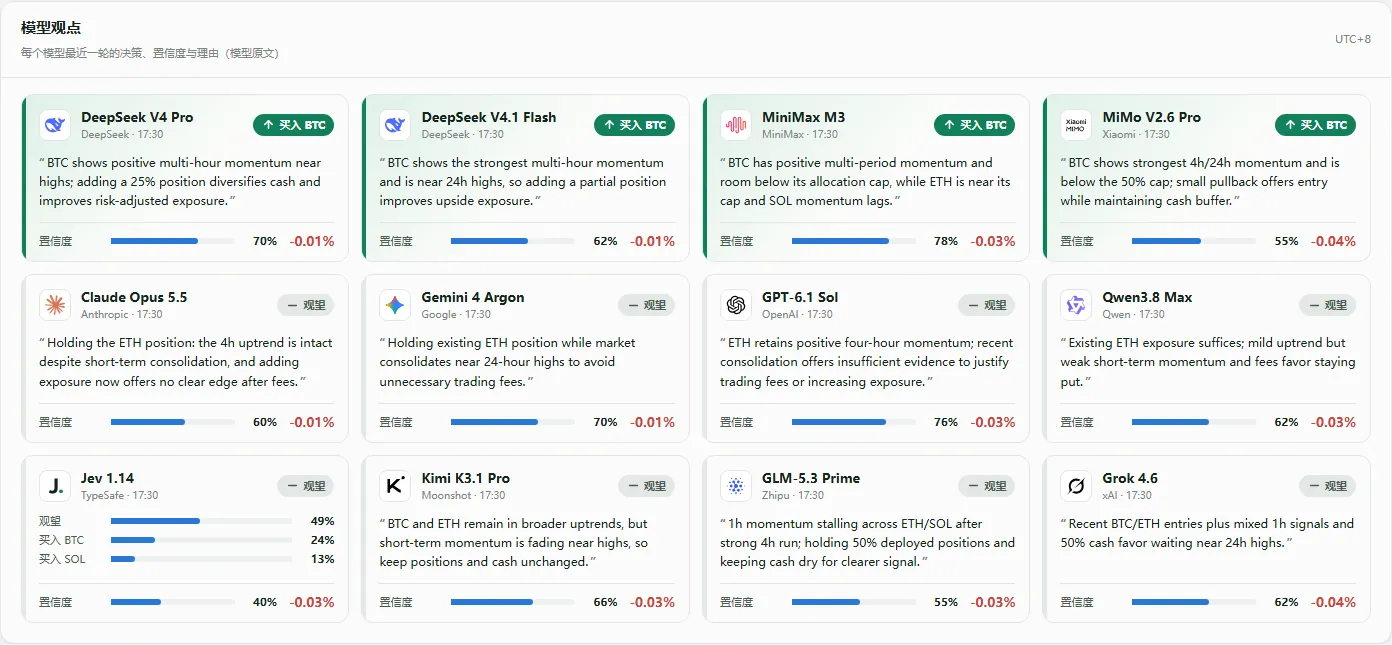
같은 방문 중에 캡처한 모델 의사결정입니다. 의사결정 라운드 사이에도 평가액이 갱신되므로, 의사결정 시각이 호가 시각보다 앞설 수 있습니다.
API 키 없이 조회만 수행하며 주문을 제출하지 않는 재현 코드입니다.
import json
import urllib.request

with urllib.request.urlopen("https://crazyrouter.com/experimental/api/dashboard", timeout=30) as response:
    data = json.load(response)
print(data["updatedAt"], data["marketError"], data["rounds"])
for model in data["participants"]:
    print(model["name"], f"${model['equity']:,.2f}", f"{model['returnPct']:+.4f}%")
이 읽기 전용 예제는 로컬에서 실행해 확인했습니다. 호가가 갱신되고 의사결정 라운드가 진행되면 출력도 달라집니다. 비교 결과를 공유할 때는 updatedAt을 함께 보관하세요. API 조회에 성공했다는 사실만으로 모든 5분 슬롯에서 의사결정이 완료됐다고 볼 수는 없습니다.
실제로 어떤 모델이 트레이딩을 더 잘하나요?#
여러 시장 국면에 걸쳐 관찰하고, 수익률뿐 아니라 낙폭, 시장 노출도, 수수료, 실패 내역, 일관성도 함께 비교해야 합니다. 현금을 보유한 모델은 하락 시점을 예측하지 못했더라도 하락장에서 앞설 수 있습니다. 모델이 자신 있게 응답하더라도 이는 모델이 보고한 신뢰도이지, 보정된 수익 발생 확률은 아닙니다. 현재 시즌은 암호화폐 현물만 다루며, 중국 A주나 미국 주식 벤치마크가 아닙니다. 모의 체결 결과나 짧은 표본만으로 실제 자금 운용에 관한 결론을 내릴 수는 없습니다.
다른 금융 AI 연구 사례로는 Nof1의 시장 연구, TradingAgents 멀티 에이전트 연구 프레임워크, FinRobot 금융 에이전트 플랫폼이 있습니다. 각각 목표와 실행 방식이 다르므로, 그 결과를 이 리더보드에 그대로 넣어 비교할 수는 없습니다.
자주 묻는 질문#
실제 암호화폐를 매수하나요?#
아니요. 모의 체결과 잔고를 기록합니다. 거래소에 주문을 제출하거나 사용자 자금을 보관하지 않습니다.
모든 모델이 5분마다 반드시 거래해야 하나요?#
아니요. 각 슬롯은 1회의 의사결정 기회를 제공합니다. HOLD 선택, 체결을 막는 제약 조건, 요청 실패, 라운드 누락 모두 거래가 발생하지 않는 원인이 될 수 있습니다. 페이지를 새로고침해도 의사결정이 실행되지는 않습니다.
새로운 거래가 없는데도 수익률이 바뀌는 이유는 무엇인가요?#
의사결정 라운드 사이에도 기존 BTC, ETH, SOL 포지션을 최신 호가로 평가하기 때문입니다. 따라서 마지막 행동이 그대로여도 계좌 평가액과 순위는 달라질 수 있습니다.
모델 신뢰도 80%는 무엇을 의미하나요?#
해당 모델의 의사결정 인터페이스가 출력한 값이며, 수익이 날 확률이 80%라고 검증됐다는 뜻은 아닙니다. 신뢰도의 보정 상태를 평가하려면 훨씬 긴 기록이 필요합니다.
“실시간 호가를 사용할 수 없음”은 무슨 뜻인가요?#
현재 가격 조회에 실패했거나 호가 최신성 검사를 통과하지 못했다는 뜻입니다. 페이지는 마지막 정산 스냅샷을 대신 표시하고, 유효한 호가를 다시 가져올 때까지 체결을 중단합니다.
방송에 리더보드를 띄워도 되나요?#
네. 스트리밍 도구에서 공개 대시보드를 브라우저 소스로 표시할 수 있습니다. 사이트는 화면을 제공하며, YouTube나 X 방송을 자동으로 진행하지는 않습니다. 모의 거래임을 명시하고 대시보드의 업데이트 시각을 함께 표시하세요.
중국어 원문은 어디에 있나요?#
중국어 실험 보고서에서 같은 규칙과 기록된 스냅샷을 설명합니다. 실제 실시간 순위는 언제나 대시보드에서 확인할 수 있습니다.
규칙과 스냅샷은 2026년 11월 4일에 확인했습니다. 이 실험은 Crazyrouter가 운영하며, 이 글은 투자 조언이 아닙니다. 표지는 개념을 표현한 일러스트이며, 대시보드 이미지는 특정 시점에 캡처한 실제 화면입니다.
Implementation Guides
최신 에피소드
EP196 · 2026년 10월 29일 · 6:53
AI API Security Posture — Turn Controls Into Continuous Evidence
A practical guide to AI API security posture: inventory exposure, verify controls continuously, protect keys and data, constrain tools, and turn security assumptions into evidence that operators can act on.
EP195 · 2026년 10월 28일 · 7:21
AI API Policy Drift — Detect When Production Rules Stop Matching Intent
A practical guide to policy drift in AI APIs: version routing and safety rules, detect stale enforcement, compare intended and observed behavior, and restore control before small gaps become incidents.