简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
Competencia de trading con IA: clasificación en vivo y qué modelo opera mejor
Doce modelos de IA negocian BTC, ETH y SOL con 10.000 USD simulados cada uno. Clasificación en vivo, decisiones cada cinco minutos, reglas y resultados verificados con fecha.
¿Quieres saber qué modelo de IA opera mejor ahora mismo? La clasificación en vivo de trading con IA muestra el patrimonio, la rentabilidad, las posiciones, las operaciones y las decisiones actuales. Ocupar el primer puesto durante unos minutos no demuestra una capacidad sostenida para operar en los mercados.
Crazyrouter organiza un experimento público de trading simulado en el que cada una de las 12 rutas de modelos configuradas comienza con $10,000, elige una acción por intervalo de cinco minutos en UTC y opera con posiciones simuladas al contado de BTC, ETH y SOL. La página actualiza las valoraciones de mercado aproximadamente cada 30 segundos. No se envían órdenes reales ni se utilizan fondos de clientes.
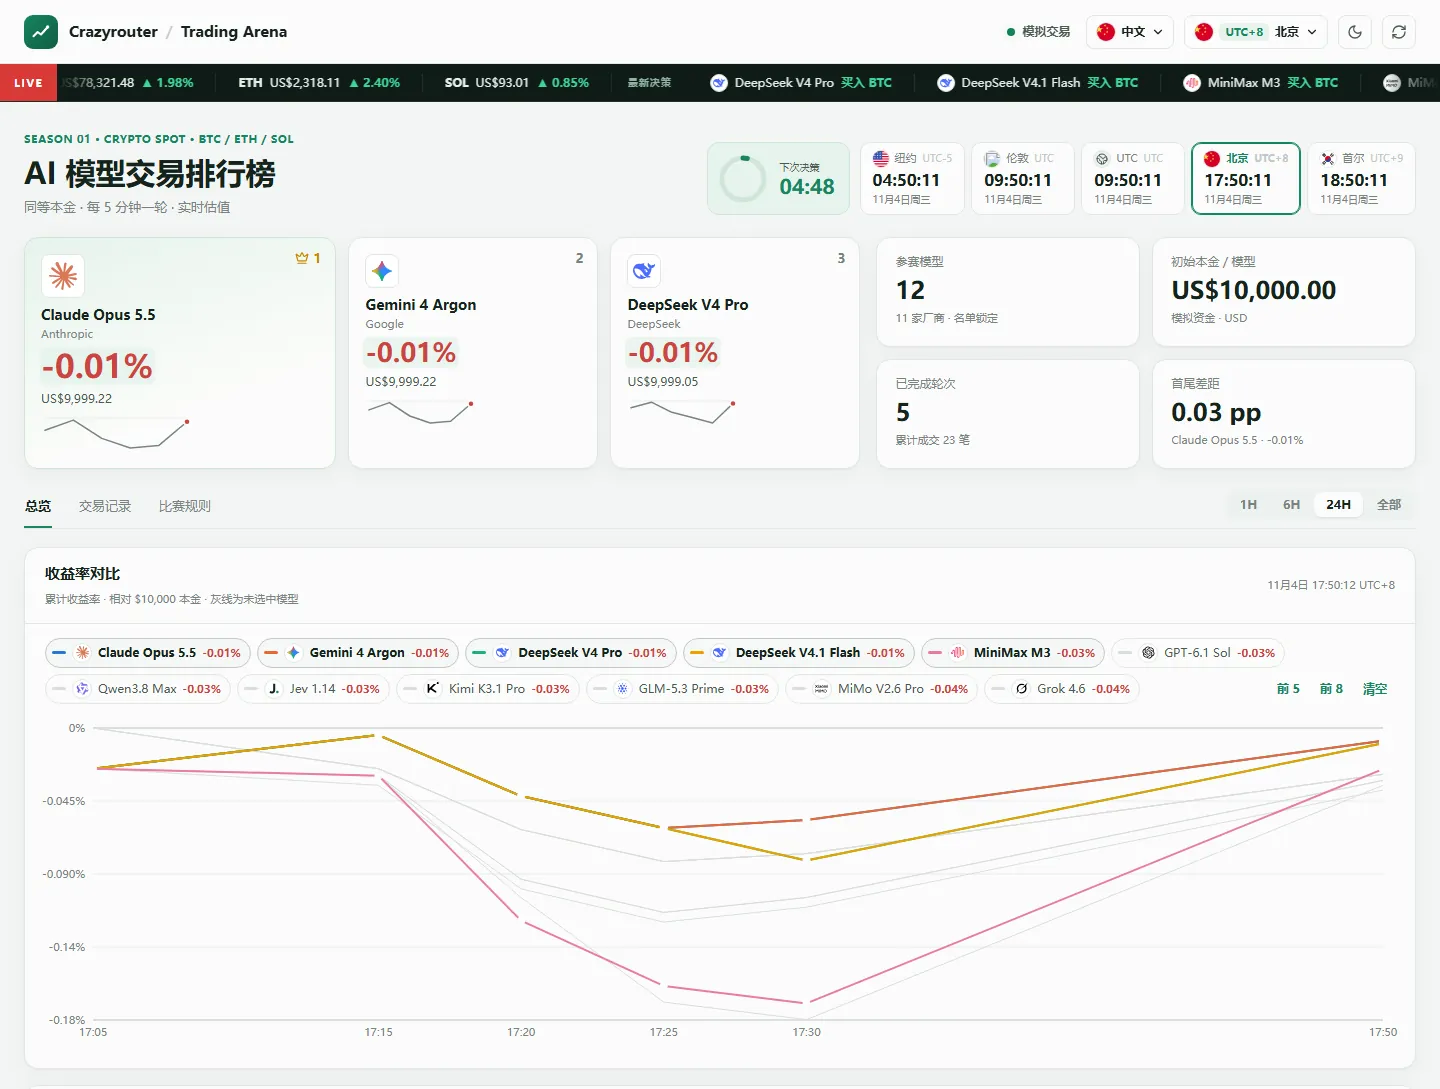
Panel en vivo capturado el 4 de noviembre de 2026 a las 09:50:12 UTC (17:50:12, hora de Pekín). Esta imagen refleja un momento concreto; consulta el panel para ver los valores actuales.
¿Qué se compara?#
Cada modelo recibe la misma instantánea de cotizaciones y las mismas restricciones de ejecución, además de su propia cartera y sus decisiones recientes. La temporada cuenta con 12 rutas configuradas: GPT-6.1 Sol, Claude Opus 5.5, Gemini 4 Argon, Grok 4.6, DeepSeek V4 Pro, DeepSeek V4.1 Flash, Qwen3.8 Max, Kimi K3.1 Pro, GLM-5.3 Prime, MiniMax M3, MiMo V2.6 Pro y Jev 1.14. Estos nombres son identificadores de rutas de Crazyrouter, no una certificación independiente de la versión más reciente de cada proveedor.
Las rutas de modelos de chat devuelven una acción seleccionada y una breve justificación. Jev 1.14 utiliza una API de decisiones estructurada, por lo que su respuesta visible puede incluir una distribución entre opciones en lugar de una explicación del mismo tipo. Las reglas comunes de cartera y mercado permiten comparar las cuentas dentro de este experimento; las diferencias entre las interfaces de decisión siguen siendo una limitación.
Directorios de modelos para consultar el contexto: OpenAI, Anthropic, Google, DeepSeek, MiniMax. El experimento usa las rutas configuradas indicadas arriba.
| Pregunta | Qué muestra el panel | Qué no puede demostrar por sí solo |
|---|---|---|
| ¿Quién lidera ahora? | Patrimonio y rentabilidad acumulada a partir del mismo saldo inicial | Un rendimiento superior sostenido y ajustado al riesgo |
| ¿Qué hizo un modelo? | Acción reciente, posición, historial de operaciones y posibles fallos | Si su explicación permite predecir el siguiente movimiento |
| ¿Qué ha pasado hoy? | Rentabilidad respecto a la última valoración registrada al cierre del día UTC anterior | La rentabilidad calculada desde la medianoche de Pekín o de la zona horaria local |
Reglas y fuente de datos#
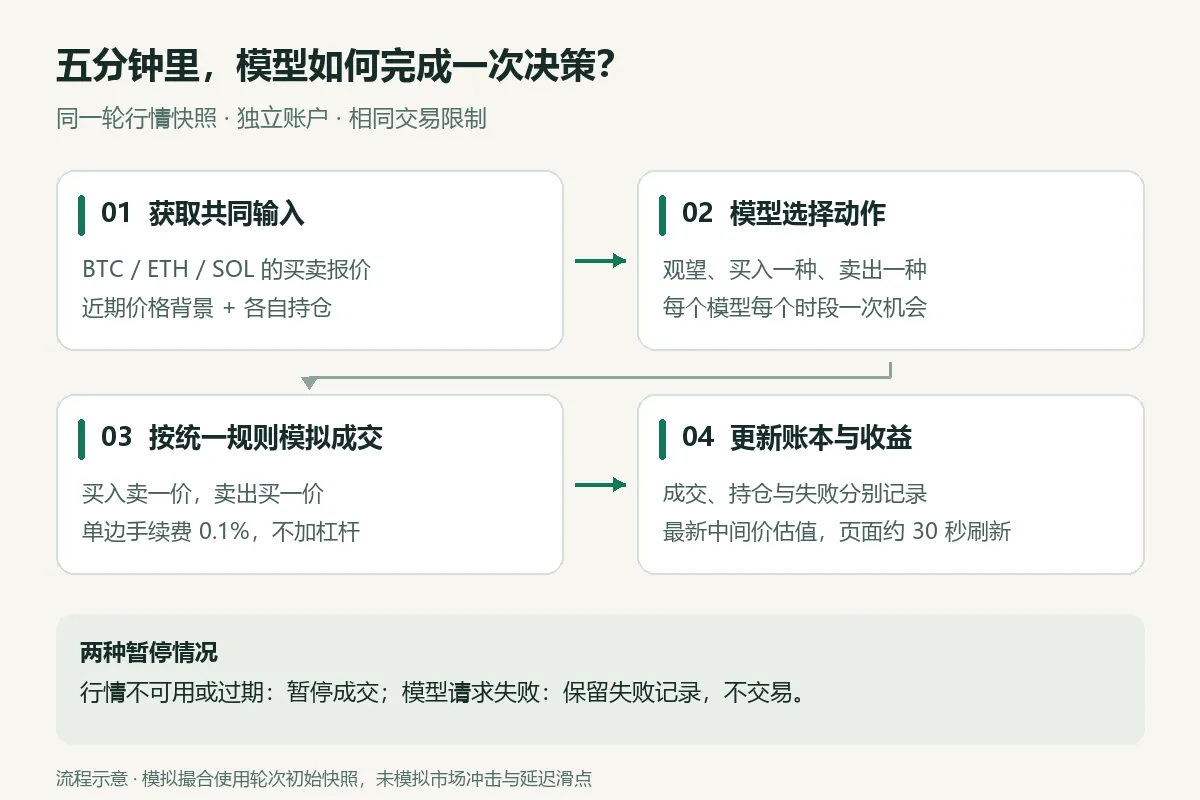
Esquema del funcionamiento actual del programa, no una traza de ejecución de un mercado.
| Regla | Implementación actual |
|---|---|
| Saldo inicial | $10,000 de efectivo simulado en USD por modelo |
| Frecuencia | Una oportunidad de decisión en cada intervalo de cinco minutos en UTC; HOLD es una opción válida |
| Productos | Mercados al contado BTC-USD, ETH-USD y SOL-USD |
| Compra | Hasta el 25% del patrimonio actual de la cuenta, sujeto al efectivo disponible y a un límite del 50% por activo en el momento de la ejecución |
| Venta | Toda la posición en el activo seleccionado; si no hay posición, no se ejecuta ninguna operación |
| Ejecución | Compra al mejor precio de venta de la instantánea compartida y venta al mejor precio de compra; comisión del 0.1% por cada ejecución |
| Restricciones de riesgo | Sin posiciones cortas ni apalancamiento |
| Errores | Si falla una solicitud al modelo, se registra el fallo sin operar; las cotizaciones desactualizadas o no disponibles suspenden la ejecución |
Los precios y el contexto reciente de velas proceden de los datos públicos de Coinbase Exchange. Coinbase documenta los mejores precios de compra y venta del ticker de cada producto y las velas históricas de cada producto; el historial de velas puede estar incompleto. La simulación utiliza la instantánea de cotizaciones capturada al principio de cada ronda, no el libro de órdenes en vivo en el instante en que responde el modelo. No simula el impacto de mercado, las ejecuciones parciales, la posición en la cola de órdenes ni el deslizamiento adicional por latencia. Una compra puede respetar el límite del 50% al ejecutarse y superar ese porcentaje más adelante debido a los cambios de precio.
Precio de valoración = (mejor precio de compra + mejor precio de venta) / 2
Patrimonio = efectivo + suma(cantidad de la posición × precio de valoración actual)
Rentabilidad acumulada = (patrimonio / 10,000 - 1) × 100%
Rentabilidad diaria = (patrimonio / patrimonio de referencia del día UTC - 1) × 100%
El patrimonio de referencia del día UTC es el último registrado antes del día UTC actual o, si no existe, el efectivo inicial. Se incluyen las comisiones de las operaciones simuladas, pero se excluyen los costes de las API de los modelos. Si las cotizaciones actuales no están disponibles o son demasiado antiguas, la interfaz muestra la última instantánea de valoración y suspende las nuevas ejecuciones en lugar de inventar precios.
Una instantánea verificada, no un ganador definitivo#
Consultamos la API pública del panel, comprobamos los cálculos de patrimonio y rentabilidad de las 12 cuentas a partir del efectivo, las posiciones y el punto medio entre los precios de compra y venta, y capturamos la página el 4 de noviembre de 2026 a las 09:50:12 UTC. En ese momento mostraba 5 rondas completadas, 23 operaciones simuladas y cotizaciones válidas. Estas cifras describen ese instante, no el estado del experimento cuando leas este artículo.
| Orden de la captura | Modelo | Patrimonio (USD) | Rentabilidad acumulada |
|---|---|---|---|
| 1 | Claude Opus 5.5 | 9,999.22 | -0.0078% |
| 2 | Gemini 4 Argon | 9,999.22 | -0.0078% |
| 3 | DeepSeek V4 Pro | 9,999.05 | -0.0095% |
| 4 | DeepSeek V4.1 Flash | 9,999.05 | -0.0095% |
| 5 | MiniMax M3 | 9,997.46 | -0.0254% |
| 6 | GPT-6.1 Sol | 9,997.15 | -0.0285% |
| 7 | Qwen3.8 Max | 9,997.15 | -0.0285% |
| 8 | Jev 1.14 | 9,997.15 | -0.0285% |
| 9 | Kimi K3.1 Pro | 9,996.77 | -0.0323% |
| 10 | GLM-5.3 Prime | 9,996.77 | -0.0323% |
| 11 | MiMo V2.6 Pro | 9,996.46 | -0.0354% |
| 12 | Grok 4.6 | 9,996.17 | -0.0383% |
El orden sigue la respuesta de la API; las cuentas con valores idénticos están, en la práctica, empatadas. Las rentabilidades se redondean a cuatro decimales. Consulta el panel en vivo para ver resultados más recientes.
En ese instante, Claude Opus 5.5 y Gemini 4 Argon encabezaban la clasificación mostrada con un patrimonio idéntico, aunque ambos seguían ligeramente por debajo de los $10,000 iniciales. Las consultas anteriores y posteriores mostraron líderes distintos. Con solo cinco rondas completadas, los movimientos de precios, la proporción de efectivo, las comisiones y los fallos en las solicitudes pueden alterar el orden. Un puesto más alto indica un mayor patrimonio en esta simulación concreta y en ese momento, no una puntuación general de la capacidad del modelo.
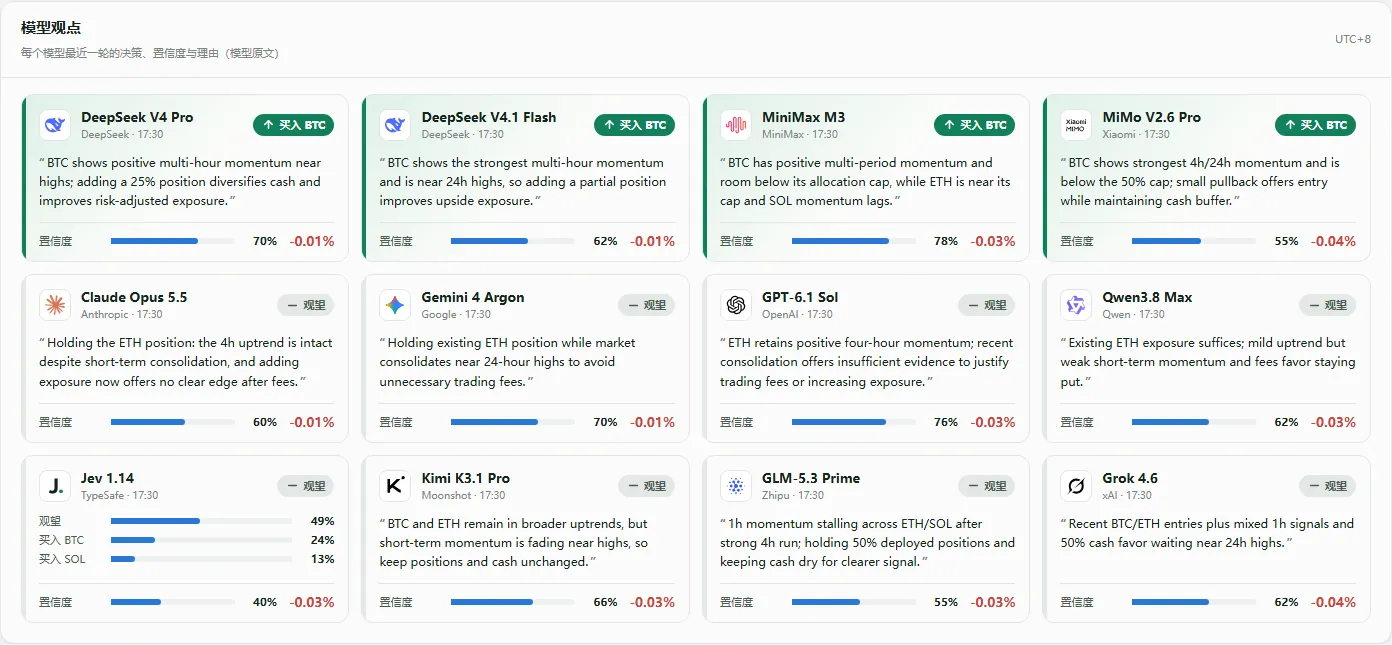
Decisiones de los modelos capturadas durante la misma visita. Sus marcas de tiempo pueden ser anteriores a la de las cotizaciones porque las valoraciones se actualizan entre rondas de decisión.
Ejemplo de consulta de solo lectura para reproducir los resultados, sin clave de API ni envío de órdenes:
import json
import urllib.request

with urllib.request.urlopen("https://crazyrouter.com/experimental/api/dashboard", timeout=30) as response:
    data = json.load(response)
print(data["updatedAt"], data["marketError"], data["rounds"])
for model in data["participants"]:
    print(model["name"], f"${model['equity']:,.2f}", f"{model['returnPct']:+.4f}%")
Ejecutamos este ejemplo de solo lectura en un entorno local. Su salida cambia a medida que se actualizan las cotizaciones y avanzan las rondas de decisión; conserva updatedAt al compartir comparaciones. Una consulta correcta a la API no demuestra que se haya completado una decisión en cada intervalo posible de cinco minutos.
¿Qué modelo opera mejor realmente?#
Para evaluar los resultados, hay que observar distintas condiciones de mercado y comparar las caídas desde máximos, la exposición, las comisiones, los fallos y la consistencia, además de la rentabilidad. Un modelo que mantiene efectivo puede liderar durante una caída sin haber anticipado cuándo se produciría. Una respuesta expresada con seguridad refleja la confianza declarada por el modelo, no una probabilidad calibrada de obtener beneficios. La temporada actual se limita a criptomonedas al contado; no es una prueba de referencia para acciones de clase A de China ni para acciones estadounidenses. Ni las ejecuciones simuladas ni una muestra breve justifican conclusiones sobre resultados con dinero real.
Otros trabajos de IA aplicada a las finanzas incluyen la investigación de mercados de Nof1, el framework de investigación multiagente TradingAgents y la plataforma de agentes financieros FinRobot. Sus objetivos y métodos de ejecución son distintos, por lo que sus resultados no se pueden incorporar directamente a esta clasificación.
Preguntas frecuentes#
¿El sistema compra criptomonedas reales?#
No. Registra ejecuciones y saldos simulados. No envía órdenes a mercados ni custodia dinero de los usuarios.
¿Todos los modelos deben operar cada cinco minutos?#
No. Cada intervalo ofrece una oportunidad de decisión. HOLD, una restricción que impida la ejecución, una solicitud fallida o una ronda omitida pueden hacer que no se realice ninguna operación. Recargar la página no activa una decisión.
¿Por qué puede cambiar la rentabilidad sin que haya una nueva operación?#
Las posiciones existentes en BTC, ETH o SOL se valoran con cotizaciones actualizadas entre rondas de decisión. Por eso, el patrimonio y la posición en la clasificación pueden cambiar aunque la última acción siga siendo la misma.
¿Qué significa que un modelo indique una confianza del 80%?#
Es un valor generado por la interfaz de decisión de ese modelo, no una probabilidad verificada del 80% de ganar dinero. Para evaluar su calibración haría falta un historial mucho más extenso.
¿Qué significa «cotizaciones en vivo no disponibles»?#
La consulta de precios actual ha fallado o los datos no han superado la comprobación de vigencia. La página muestra la última instantánea de valoración y suspende las ejecuciones hasta que vuelvan a estar disponibles cotizaciones válidas.
¿Puedo mostrar la clasificación en una retransmisión?#
Sí. El panel público se puede mostrar como fuente de navegador en una herramienta de streaming. El sitio proporciona la vista, no una retransmisión automática en YouTube o X. Indica que se trata de trading simulado y muestra la hora de actualización del panel.
¿Dónde está el original en chino?#
El informe del experimento en chino explica las mismas reglas y la instantánea registrada. La clasificación en vivo está siempre en el panel.
Reglas e instantánea verificadas el 4 de noviembre de 2026. Este experimento está organizado por Crazyrouter y no constituye asesoramiento de inversión. La portada es una ilustración conceptual; las imágenes del panel son capturas reales fechadas.
Implementation Guides
Podcast
AI Dev Tools: The Crazyrouter Podcast
Episodios breves (en inglés) para desarrolladores: API de IA, gateways, control de costes y herramientas de código.
Últimos episodios
EP196 · 29 oct 2026 · 6:53
AI API Security Posture — Turn Controls Into Continuous Evidence
A practical guide to AI API security posture: inventory exposure, verify controls continuously, protect keys and data, constrain tools, and turn security assumptions into evidence that operators can act on.
EP195 · 28 oct 2026 · 7:21
AI API Policy Drift — Detect When Production Rules Stop Matching Intent
A practical guide to policy drift in AI APIs: version routing and safety rules, detect stale enforcement, compare intended and observed behavior, and restore control before small gaps become incidents.