简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
중국과 미국 AI 모델의 실제 격차는 얼마나 될까? | 프롤로그
2026년 10월 29일 데이터를 바탕으로 최첨단 격차, Opus 4.8 기준, 실제 API 호출 112회를 비교하고 후속 시리즈의 공통 연구 방법을 제시한다.
이 글은 데이터 기준일이 2026-10-29인 동일 연구의 한국어판이다. 테스트 요청 112회는 모두 원래 중국어 프롬프트를 사용했으며, 새로운 다국어 평가는 실시하지 않았다. 그림의 표기는 영어다. 코드 예제는 원래 중국어 프롬프트를 유니코드 이스케이프로 보존하며 실행 시 복원한다.
중국과 미국 AI 모델 비교 시리즈 · 프롤로그. 먼저 텍스트 모델로 비교 방법을 만든 뒤 이미지, 비디오, 음성, 벡터 검색과 리랭킹을 각각 살펴본다. 이번 글은 방법과 질문의 출발점이며, 텍스트 모델 점수가 다른 모달리티의 실력을 대표할 수는 없다.
미국 모델은 현재 최첨단 순위와 상위 라인업에서 앞서 있지만, “중국과 미국 모델의 격차가 계속 벌어지고 있다”는 말은 이번 동일 척도 회고 결과와 맞지 않는다. 개인적 만족도의 참고 기준으로 Opus 4.8을 사용하면, AA가 다룬 표본에서 중국 출시 버전 12개와 미국 출시 버전 21개의 Progress Index 점수가 이를 넘는다. 그렇다고 모든 작업에서 더 쓰기 좋다는 뜻은 아니다.
데이터 기준 시점은 2026년 10월 29일이다. 이 글에서는 서로 혼동하기 쉬운 세 가지 질문을 나눈다. 최강 모델 사이의 격차는 얼마인지, 과거 플래그십 기준을 넘는 선택지는 얼마나 많은지, 실제 요청에서는 어떤 차이가 체감되는지다. 앞의 두 질문에는 Artificial Analysis(AA) 데이터를 사용하고, 세 번째 질문은 Crazyrouter를 통해 모델 7개, 작업 8종, 문제당 2회, 총 112회 호출을 감사해 살펴본다.[1][2]
이 연구는 모델 표본에 관한 연구다. 두 나라의 전체 AI 산업을 평가하지 않으며, 사람의 주관적 블라인드 평가도 진행하지 않았다. “사용 가능” 여부는 궁극적으로 각자의 작업, 대기 시간, 오류 허용 요건에 따라 달라진다.
먼저 결과 보기: 최첨단 우위와 폭넓은 사용 가능성은 별개다#
| 지표 / 척도 | 중국 | 미국 |
|---|---|---|
| 현재 최고점 · Intelligence v5 | 46.0 · Kimi K3.1 Pro | 59.4 · Gemini 4 Carbon |
| Top 5 평균 · Intelligence v5 | 34.74 | 56.68 |
| 글로벌 Top 10 버전 수 · Intelligence v5 | 1 | 9 |
| 현재 최고점 · Progress v1 | 340.70 | 351.65 |
| Opus 4.8 초과 · Progress v1, 역사적 버전 포함 | 12 | 21 |
| 그중 AA가 deprecated로 표시하지 않은 버전 | 9 | 13 |
두 지수의 수치는 서로 빼거나 한 순위에 섞을 수 없다. 현재 v5 최첨단 격차는 13.4점이고, Progress v1의 현재 최첨단 격차는 10.94점이다. 전자는 현재 평가 세트의 성능을 측정하고, 후자는 시기를 넘나드는 능력 변화를 분석하는 데 사용한다.
통계에서는 AA의 추론 구성 716개를 출시 버전 517개로 통합했다. 그중 중국 176개, 미국 257개이며, 나머지는 다른 국가이거나 분류되지 않았다. release.id 기준으로 통합했기 때문에 같은 버전의 high, max, xhigh를 여러 모델로 중복 계산하지 않았다. 지표별로 해당 버전에서 가장 높은 점수를 받은 구성을 사용했으며, 지표마다 최고 구성이 다를 수 있다.
새 v5 순위표에서는 현재 출시 버전 39개만 사용 가능한 총점을 갖고 있다. 중국 12개, 미국 24개, 기타 국가 3개다. 여기서 Top 10과 평균은 측정된 표본의 통계이며, 측정되지 않았다고 0점인 것은 아니다. 순위는 원본 API 반환 정밀도를 기준으로 하고, 동점은 같은 순위를 차지하며 다음 순위는 건너뛴다.[1]
현재 상위 20개: 누가 선두권에 있나?#
| 글로벌 순위(버전 중복 제거) | 출시 버전 | 소속 | v5 점수 | 출시일 |
|---|---|---|---|---|
| 1 | Gemini 4 Carbon | 미국 | 59.4 | 2026-10-28 |
| 2 | Claude Opus 5.5 | 미국 | 58.4 | 2026-09-22 |
| 3 | GPT-6 Astra | 미국 | 56.9 | 2026-09-03 |
| 4 | GPT-6.1 Sol | 미국 | 54.5 | 2026-09-29 |
| 5 | Claude Sonnet 5.5 | 미국 | 54.2 | 2026-09-28 |
| 6 | GPT-6.1 Terra | 미국 | 51.0 | 2026-10-26 |
| 7 | Gemini 4 Argon | 미국 | 50.4 | 2026-09-30 |
| 8 | Muse Wonder Full | 미국 | 49.7 | 2026-10-12 |
| 8 | Claude Fable 5.1 | 미국 | 49.7 | 2026-09-01 |
| 10 | Kimi K3.1 Pro | 중국 | 46.0 | 2026-10-23 |
| 11 | Muse Wonder | 미국 | 43.3 | 2026-10-12 |
| 12 | Muse Spark 1.3 | 미국 | 36.4 | 2026-09-02 |
| 13 | Claude Haiku 5.5 | 미국 | 36.2 | 2026-10-07 |
| 14 | Grok 4.7 | 미국 | 35.0 | 2026-09-21 |
| 15 | Qwen3.8 Max (0902) | 중국 | 33.6 | 2026-09-02 |
| 16 | DeepSeek V4.1 Flash 1017 | 중국 | 32.5 | 2026-10-17 |
| 17 | GLM-5.3 | 중국 | 31.7 | 2026-08-18 |
| 18 | Gemini 3.8 Flash | 미국 | 30.5 | 2026-09-02 |
| 19 | MiMo-V2.6-Pro | 중국 | 29.9 | 2026-09-21 |
| 20 | Ling 3.1 Flash 1019 | 중국 | 29.5 | 2026-10-22 |
상위 20개 중 중국이 6개, 미국이 14개를 차지했다. 상위 10개에서는 각각 1개와 9개다. Top 5 평균인 34.74와 56.68을 함께 보면 개별 최첨단 모델의 추격과 상위 그룹의 두께에는 여전히 차이가 있음을 알 수 있다. 총점이 없는 버전은 순위에서 제외했다.[1]
점수 격차는 점점 더 벌어지고 있나?#
지속적으로 확대되는 것이 아니라 플래그십 출시 주기의 영향을 뚜렷하게 받는다. 같은 번에 수집한 Progress Index v1을 사용해 각 버전의 출시일에 따라 두 나라의 최첨단을 재구성했다. 특정 날짜 이전에 출시된 버전 중 최고점이 그날의 회고적 최첨단이다.
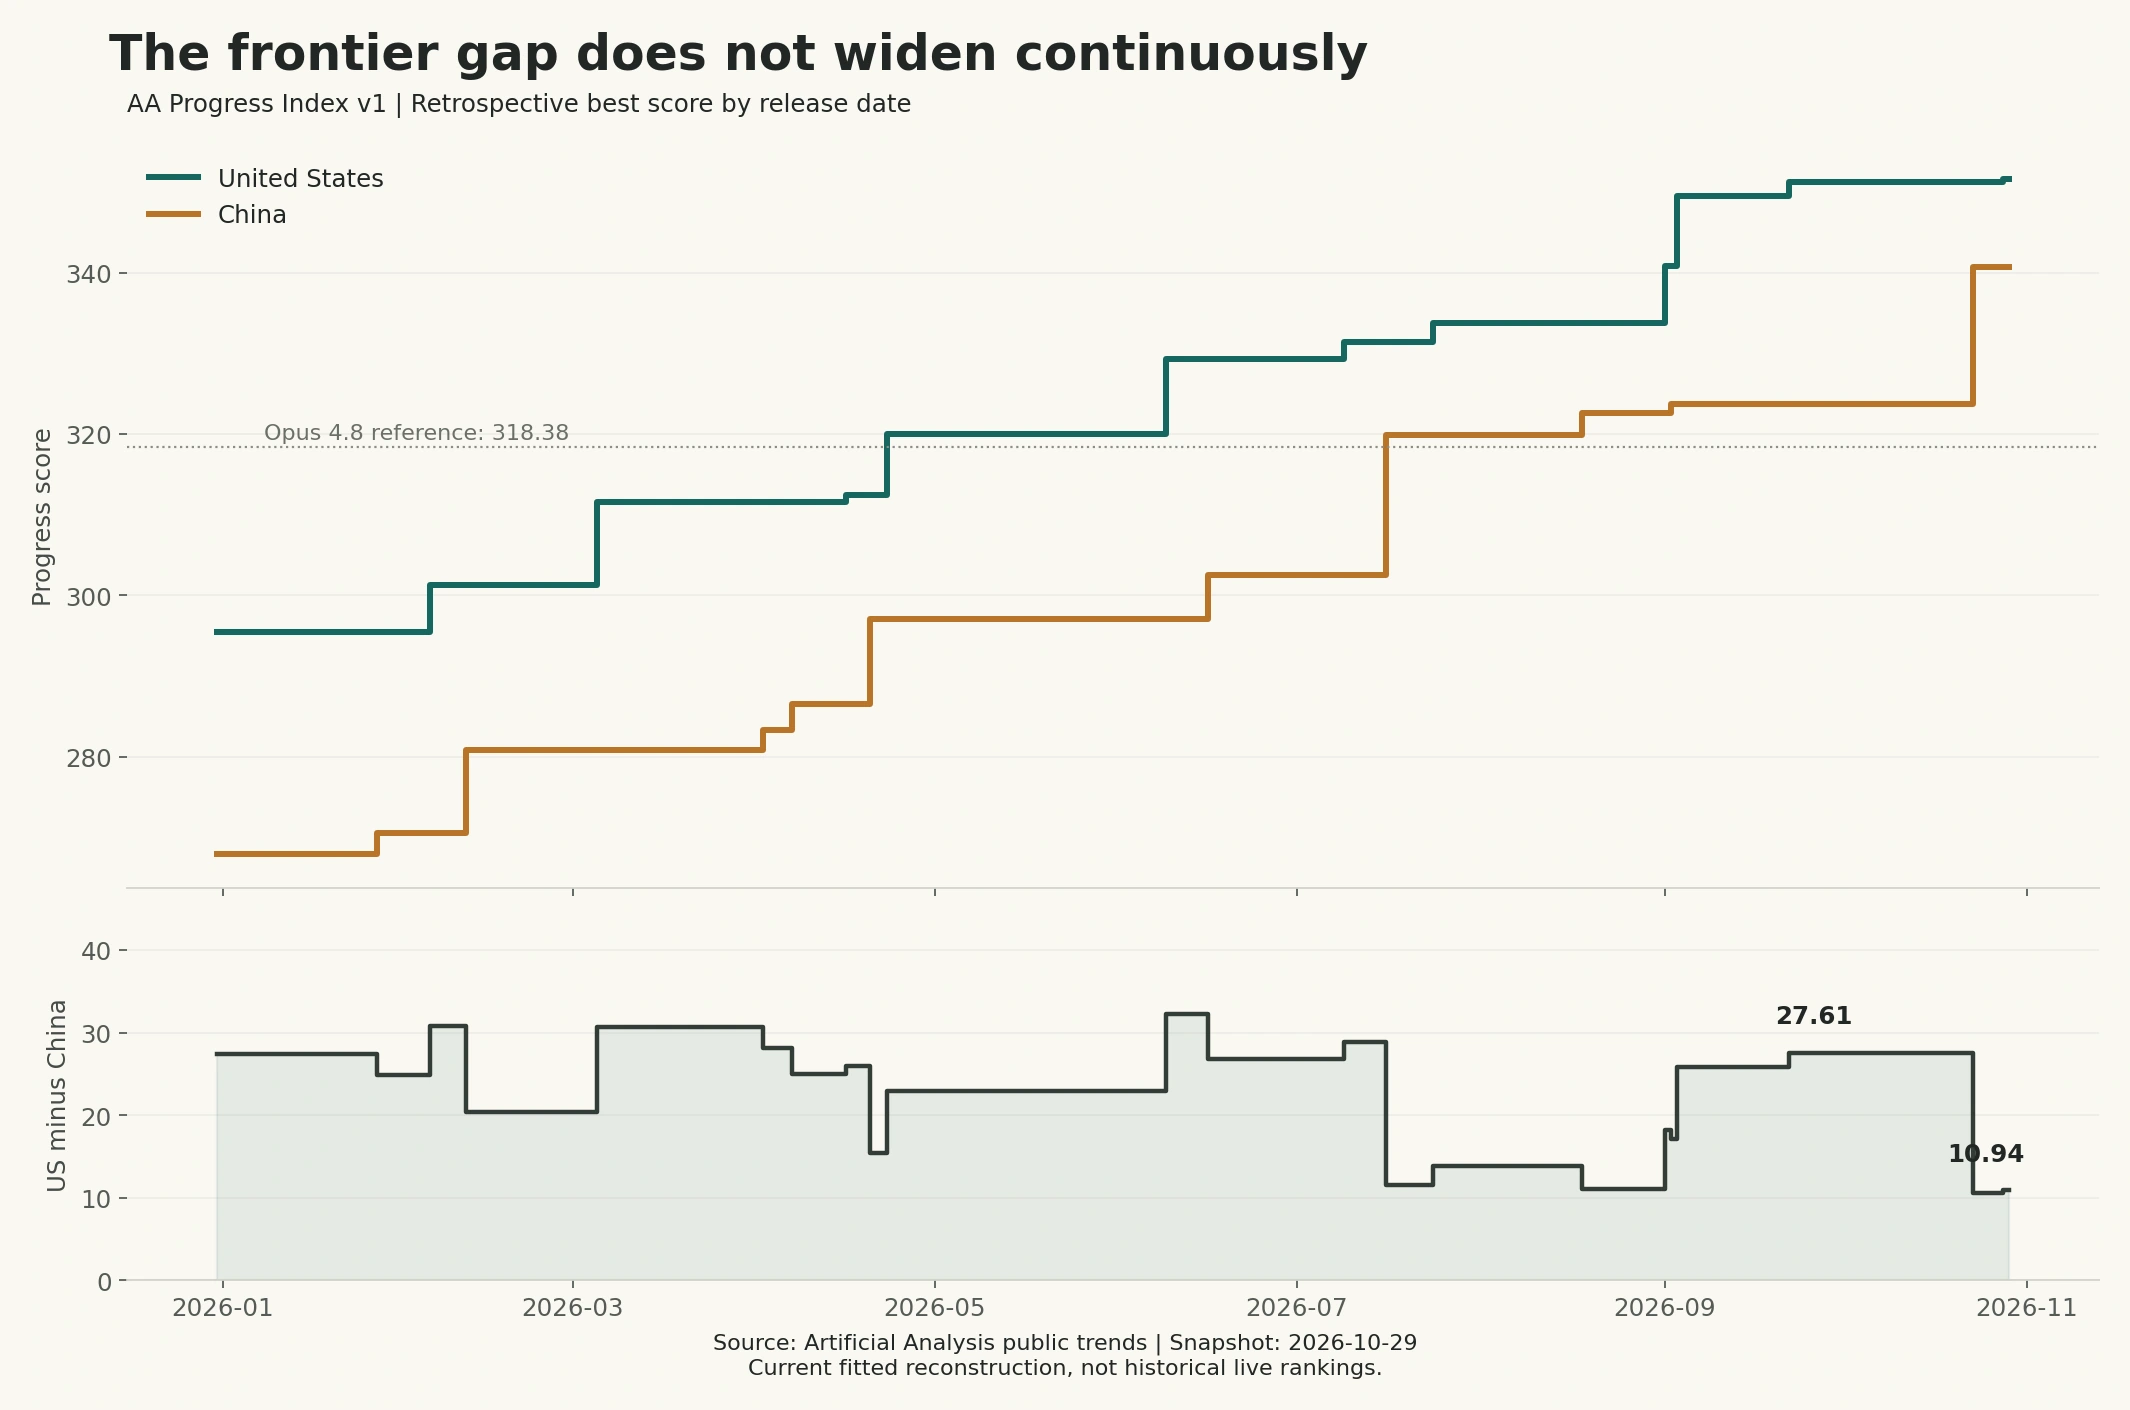
| 회고 날짜 | 중국 최첨단 | 미국 최첨단 | 격차: 미국−중국 |
|---|---|---|---|
| 2025-12-31 | 267.96 | 295.46 | 27.49 |
| 2026-03-31 | 280.87 | 311.55 | 30.69 |
| 2026-06-30 | 302.52 | 329.33 | 26.80 |
| 2026-07-31 | 319.88 | 333.73 | 13.85 |
| 2026-08-31 | 322.66 | 333.73 | 11.07 |
| 2026-09-30 | 323.67 | 351.27 | 27.61 |
| 2026-10-23 | 340.70 | 351.27 | 10.57 |
| 2026-10-29 | 340.70 | 351.65 | 10.94 |
2026년 8월 말의 격차는 11.07이었다. 9월에 미국의 새 플래그십이 집중 출시된 뒤 월말에는 27.61로 벌어졌다. 10월 23일 Kimi K3.1 Pro가 출시되면서 격차는 10.57로 좁혀졌고, 10월 28일 Gemini 4 Carbon이 출시된 뒤 10월 29일 스냅숏에서는 10.94가 되었다.[2]
이에 따라 “어느 기간을 보느냐”도 결론의 일부가 된다. 현재 격차는 30일 전보다 약 16.66점, 90일 전보다 약 2.91점, 180일 전보다 약 12.00점 좁아졌다. 그럼에도 미국은 여전히 두 나라의 최첨단 비교에서 앞서 있다. 격차 축소와 미국의 우위는 동시에 성립할 수 있다.
하지만 이 그래프를 “과거 매일의 실시간 순위표”라고 부를 수는 없다. Progress Index는 현재 확보된 평가를 바탕으로 한 통계적 피팅이며, 향후 추가 측정과 재피팅으로 회고 점수가 바뀔 수 있다. 과거 API 공개 상태도 완전히 복원되지 않았다. 이 그래프가 답하는 것은 “지금 동일한 자로 과거에 출시된 모델을 보면 어떤가”이지, “당시 사용자가 실제로 무엇을 호출할 수 있었나”가 아니다.[3]
왜 어떤 사람은 격차가 갑자기 커졌다고 보는가?#
AA는 2026년 10월 27일 Intelligence Index를 v5로 업그레이드하고 소프트웨어 엔지니어링, 과학 연구, 지식 추론 평가를 추가하거나 개선했다. 공지에 따르면 오픈 웨이트 부문 선두와 최고 모델의 격차는 v4.3의 3점에서 v5의 12점이 되었다.[4]
여기서는 측정 도구를 바꿨을 뿐 아니라 “오픈 웨이트와 최고 모델”이라는 그룹도 사용했다. 따라서 이를 곧바로 “이틀 만에 중국과 미국의 능력 격차가 3점에서 12점으로 벌어졌다”고 바꿔 쓸 수 없다. 해당 공지는 아직 웨이트가 공개되지 않은 Kimi K3.1 Pro도 관련 설명에 포함했으므로, 이 그룹을 당일 이미 다운로드할 수 있었던 모델 집합과 동일시해서는 더더욱 안 된다.
v5는 지식 업무, 프로그래밍, 과학, 범용 네 부문에 각각 25%의 가중치를 둔다. 단순 대화보다 어려운 작업과 다단계 실행을 더 중시하는 방식이다. 따라서 순위표의 격차가 크면서도 일부 일상 작업의 격차는 작을 수 있다. 실제로 그런지는 구체적인 작업 근거가 필요하다.[4][5]
Opus 4.8이면 충분하다면, 이를 넘은 모델은 얼마나 있나?#
먼저 척도를 고정하자. Opus 4.8이 2026년 5월 출시 평가에서 받은 61.4점은 구버전 Intelligence Index에 속한다. 이번 API 스냅숏에서는 v5 총점이 비어 있으므로 빈값을 0으로 처리할 수 없고, 새 순위표를 걸러 내는 데 예전 61.4를 사용할 수도 없다.[1][6]
이 글에서는 대신 Progress Index v1의 Opus 4.8(max): 318.376758998036을 고정 기준으로 사용한다. 엄밀하게 더 커야 초과로 계산하고, 같으면 초과가 아니며, 점수가 없으면 알 수 없음으로 기록한다. 임계값은 전체 정밀도를 사용하고 표에는 소수점 아래 두 자리만 표시한다.[2]
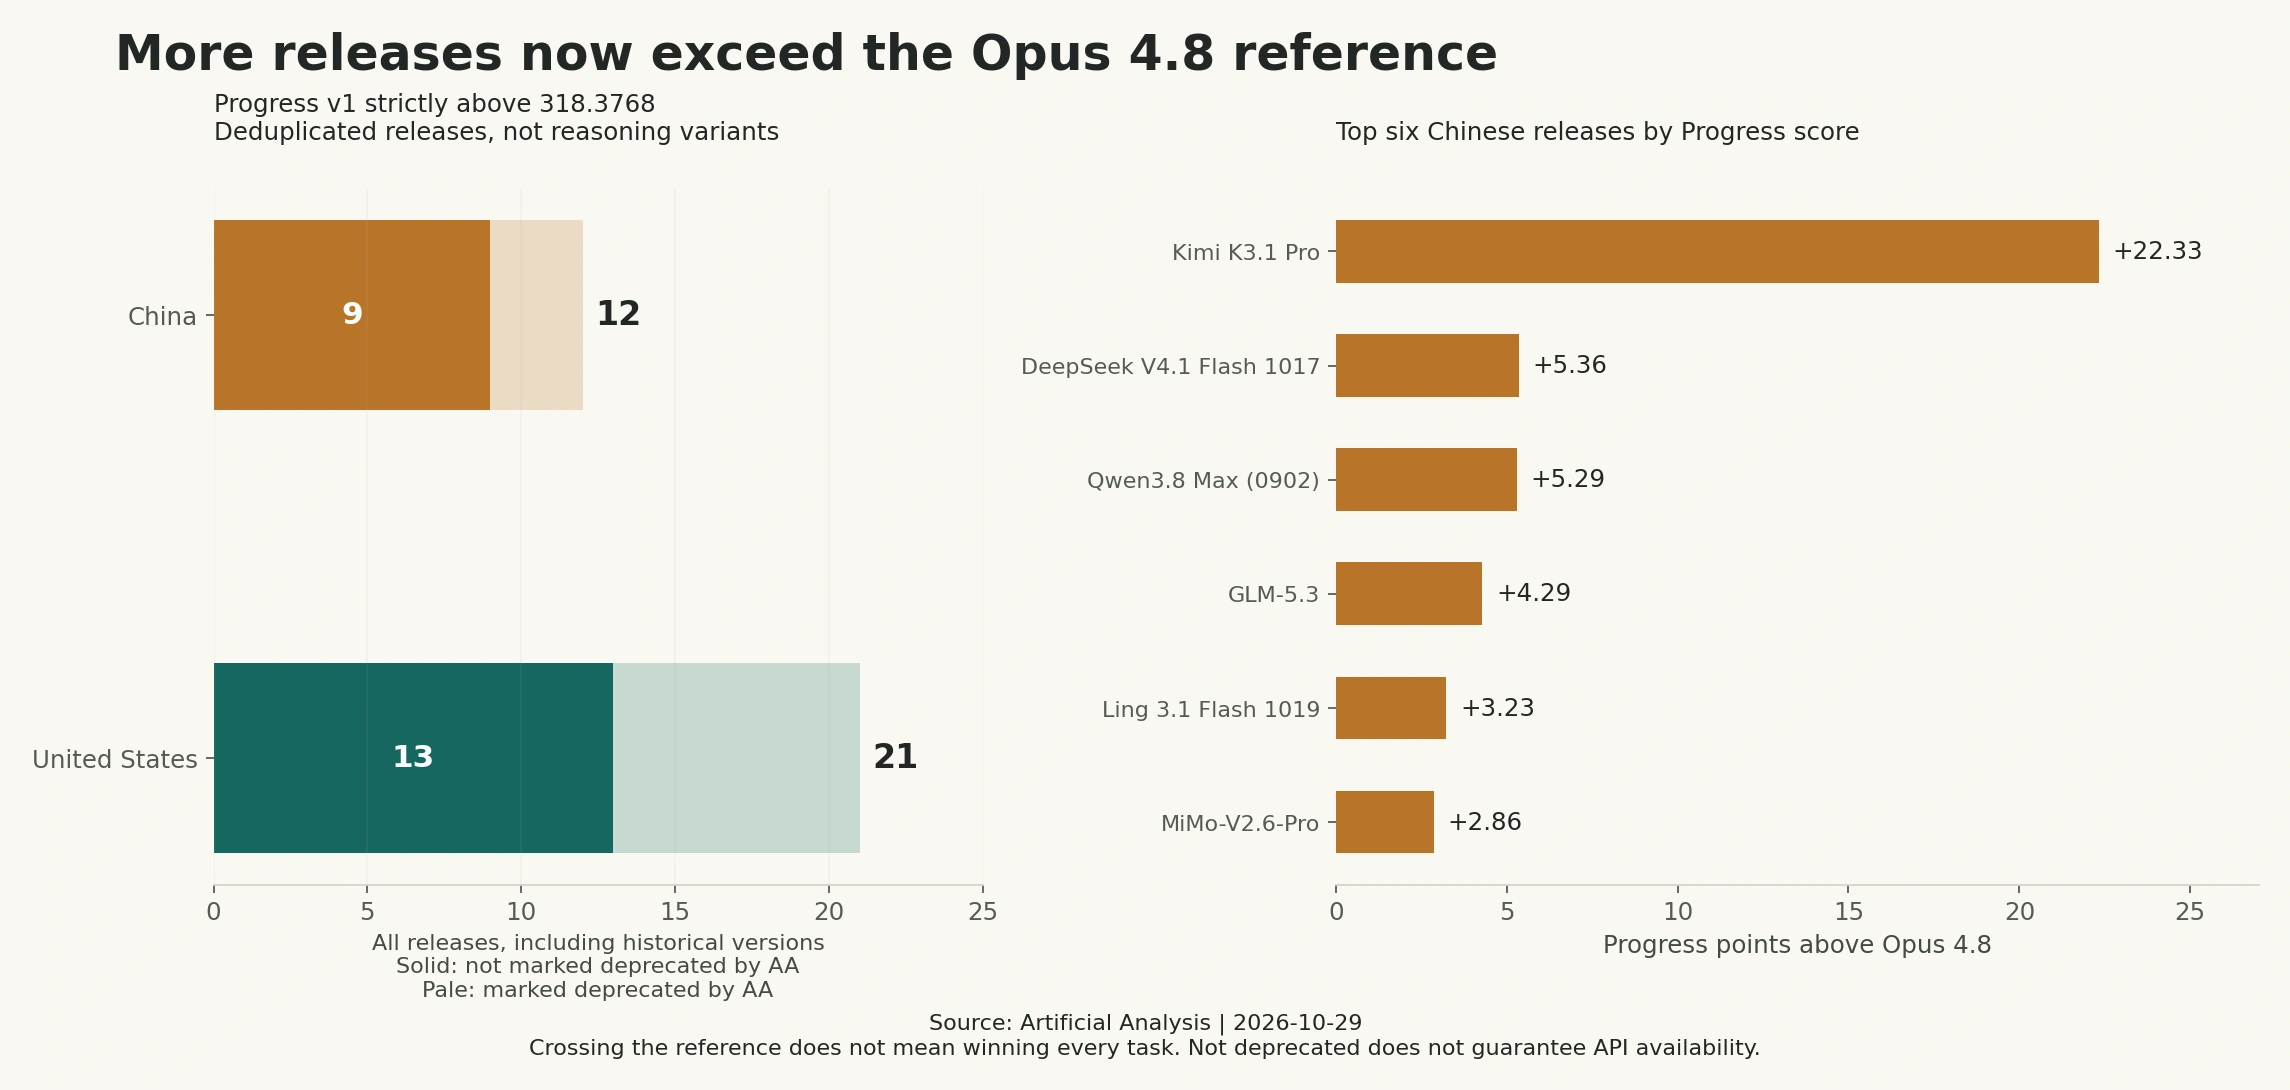
출시 버전 517개 중 전 세계에서 33개가 이 기준을 넘었고, 모두 이번 중국과 미국 그룹에 속했다. 중국 12개, 미국 21개다. AA가 deprecated로 표시하지 않은 버전만 보면 각각 9개와 13개다. AA 표시는 페이지 상태일 뿐이며, 공식 서비스가 종료되었음을 입증하지도, 현재 어떤 게이트웨이에서든 호출할 수 있음을 보장하지도 않는다.
기준을 넘은 중국 모델 전체 명단#
| 중국 모델 출시 버전 | 최고 Progress 점수 | AA가 deprecated로 표시 |
|---|---|---|
| Kimi K3.1 Pro | 340.70 | 아니요 |
| DeepSeek V4.1 Flash 1017 | 323.74 | 아니요 |
| Qwen3.8 Max (0902) | 323.67 | 아니요 |
| GLM-5.3 | 322.66 | 아니요 |
| Ling 3.1 Flash 1019 | 321.61 | 아니요 |
| MiMo-V2.6-Pro | 321.24 | 아니요 |
| DeepSeek V4.1 Flash | 320.25 | 예 |
| Qwen3.8-Flash-Next | 320.23 | 아니요 |
| Ling 3.1 Flash | 320.01 | 아니요 |
| Kimi K3 | 319.88 | 예 |
| Qwen3.8 Max | 319.63 | 예 |
| GLM-5.3-Flash | 318.64 | 아니요 |
기준을 넘은 미국 모델 전체 명단#
| 미국 모델 출시 버전 | 최고 Progress 점수 | AA가 deprecated로 표시 |
|---|---|---|
| Gemini 4 Carbon | 351.65 | 아니요 |
| Claude Opus 5.5 | 351.27 | 아니요 |
| Claude Sonnet 5.5 | 350.50 | 아니요 |
| GPT-6 Astra | 349.57 | 아니요 |
| GPT-6.1 Sol | 348.47 | 아니요 |
| GPT-6.1 Terra | 345.25 | 아니요 |
| Muse Wonder Full | 343.22 | 아니요 |
| Gemini 4 Argon | 341.79 | 아니요 |
| Claude Fable 5.1 | 340.85 | 아니요 |
| Muse Wonder | 335.78 | 아니요 |
| GPT-6 Sol | 334.04 | 예 |
| Claude Opus 5 | 333.73 | 예 |
| GPT-5.6 Sol | 331.46 | 예 |
| Claude Fable 5 | 329.33 | 예 |
| Claude Haiku 5.5 | 326.13 | 아니요 |
| Muse Spark 1.3 | 324.46 | 예 |
| GPT-5.6 Terra | 323.87 | 예 |
| Grok 4.7 | 322.68 | 아니요 |
| Grok 4.6 | 321.54 | 예 |
| Gemini 3.8 Flash | 320.30 | 아니요 |
| GPT-5.5 | 320.00 | 예 |
아슬아슬하게 넘은 경우까지 모두 “뚜렷한 우위”라고 부를 수는 없다. 예를 들어 GLM-5.3-Flash는 기준보다 약 0.27점 높지만, 이번 공개 데이터에는 이 비교를 뒷받침할 만한 신뢰구간이 없다. 따라서 다음 표는 임계값 민감도 분석만 수행하며, 점수 가산 구간은 통계적 유의성 기준이 아니다.
| 기준(Progress v1) | 중국 버전 수 | 미국 버전 수 |
|---|---|---|
| Opus 4.8 + 0점보다 엄밀하게 높음 | 12 | 21 |
| Opus 4.8 + 1점보다 엄밀하게 높음 | 11 | 21 |
| Opus 4.8 + 3점보다 엄밀하게 높음 | 5 | 19 |
| Opus 4.8 + 5점보다 엄밀하게 높음 | 3 | 17 |
| Opus 4.8 + 10점보다 엄밀하게 높음 | 1 | 14 |
이 관점은 두 가지 느낌을 동시에 설명한다. 과거 플래그십 수준에 이른 선택지는 분명 늘었지만, 과거 플래그십을 훨씬 뛰어넘는 최상위 선택지는 여전히 미국 그룹에 집중되어 있다. 기준을 넘은 중국 버전 12개 중 5점 이상 높은 것은 3개뿐이지만, 미국은 17개다. 이상 모두 역사적 버전을 포함하므로 현재 API 재고로 해석해서는 안 된다.
이 능력 기준을 넘은 시점은 며칠 차이인가?#
현재 Progress v1 회고에서 미국이 가장 먼저 기준을 넘은 버전은 2026년 4월 23일 출시된 GPT-5.5이고, 중국은 2026년 7월 16일 출시된 Kimi K3다. 두 최초 초과일의 차이는 84일이다. Opus 4.8 자체의 출시일인 5월 28일부터 Kimi K3까지 계산하면 49일이다.[2]
GPT-5.5가 Opus 4.8보다 먼저 이 회고적 임계값을 넘었다는 사실은 모순이 아니다. Progress와 당시 Intelligence 순위표는 목표, 피팅, 정렬이 다르다. 84일은 지정된 이 임계값 하나의 최초 초과일 차이일 뿐, “중국의 모든 모델이 전반적으로 3개월 뒤처져 있다”는 근거가 아니다.
실제 체감 격차도 점수에서 보이는 만큼 큰가?#
이번 실험이 답할 수 있는 것은 “이 요청 조건에서 어떤 작업이 순조롭게 전달되었는가”이며, 사람의 전반적인 만족도 평가를 대체할 수 없다. Anthropic 시리즈와 OpenAI 시리즈에서 현재 대표 모델을 선택하고 Opus 4.8 기준도 유지했다. 중국 그룹은 Kimi 시리즈, Qwen 시리즈, DeepSeek 시리즈, GLM 시리즈를 포함했다. 목적을 두고 표본을 선택한 것이므로 국가별 평균 승률을 추정하는 데 사용하지 않는다.
테스트는 2026년 10월 29일에 진행했다. 모두 https://cn.crazyrouter.com의 /v1/chat/completions 엔드포인트를 사용했고, 요청은 reasoning_effort="high", max_tokens=8192, 비스트리밍으로 설정했다. 도구는 호출하지 않았고, 읽기 제한 시간은 매회 180초, 무작위 순서, 최대 동시 실행 4개로 했다. 같은 high 라벨이 같은 내부 연산량을 뜻하지는 않으며, AA의 모델별 최고 단계 평가와도 같지 않다.
| 작업 그룹 | 구체적 작업 | 채점 근거 |
|---|---|---|
| 일상 작업, 5종 | 주문 추출 및 중복 제거, 충돌 기록, 중국어 형식 제약, 재고 240개 위치 찾기, 환불 규칙 경계 | 고정된 정답, 필드 유형, 텍스트 형식 |
| 추론 스트레스, 3종 | 순환 제약 개수 세기, 의존성이 있는 일정 계획, 조합 선택 최적화 | 로컬 전수 탐색으로 확인한 유일 최적해 / 지정된 동점 규칙 |
엄격 통과는 HTTP 성공, 정상 종료, 최종 답변과 형식의 완전한 요건 충족을 요구한다. 사전에 약속한 이 주요 지표를 유지했고, 별도로 사후 민감도 점검을 수행했다. 여기서는 바깥쪽 Markdown 코드 펜스 한 겹만 제거하며, 답을 고치거나 재시도하지 않았다. 후자는 “내용을 읽고 이해할 수 있는가”에, 전자는 “프로그램이 곧바로 받아들일 수 있는가”에 더 가깝다.
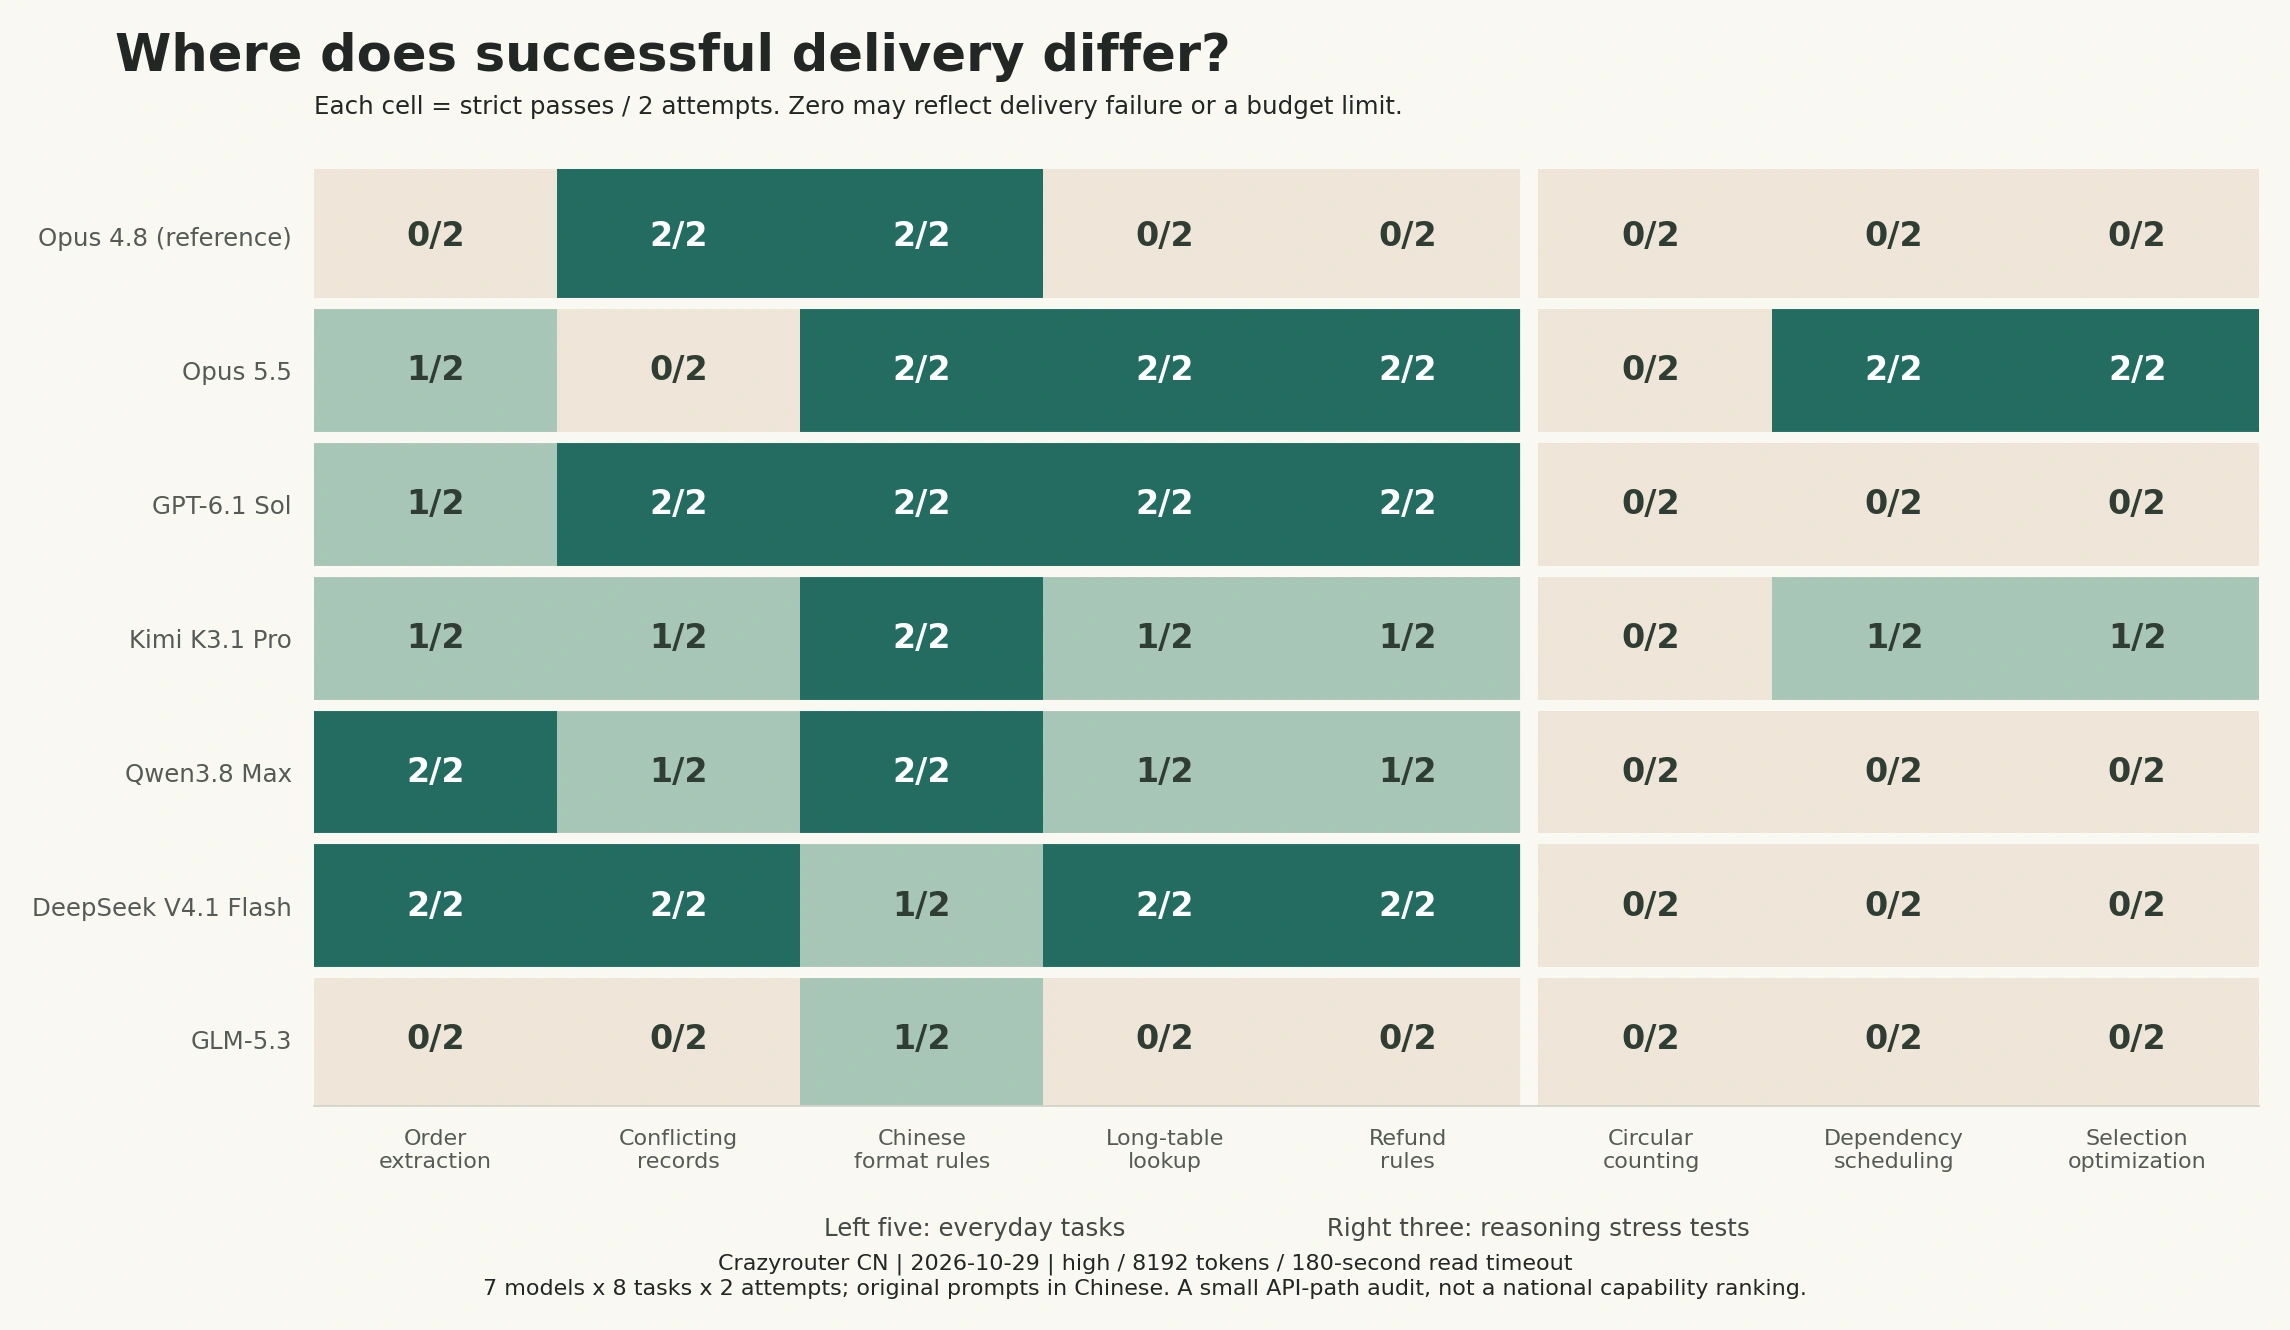
| 요청 모델 | 일상 엄격 통과 / 10 | 스트레스 엄격 통과 / 6 | 전체 엄격 / 16 | 한 겹 펜스 제거 후 / 16 |
|---|---|---|---|---|
| claude-opus-4-8 | 4/10 | 0/6 | 4/16 | 13/16 |
| claude-opus-5-5 | 7/10 | 4/6 | 11/16 | 16/16 |
| gpt-6.1-sol | 9/10 | 0/6 | 9/16 | 9/16 |
| kimi-k3.1-pro | 6/10 | 2/6 | 8/16 | 8/16 |
| qwen3.8-max | 7/10 | 0/6 | 7/16 | 7/16 |
| deepseek-v4.1-flash | 9/10 | 0/6 | 9/16 | 9/16 |
| glm-5.3 | 1/10 | 0/6 | 1/16 | 1/16 |
격차는 어디에서 드러나는가?#
이번 라운드의 DeepSeek V4.1 Flash와 Opus 5.5를 예로 들면, 일상 작업의 엄격 전달은 각각 9/10과 7/10, 스트레스 작업은 0/6과 4/6이었다. 이는 고정 예산에서의 전달 차이이며, 미완료를 모두 “모델이 할 줄 모른다”로 해석할 수는 없다. 특히 스트레스 작업은 출력 예산을 다 쓰거나 대기 상한 전에 끝내지 못할 수 있다.
또 다른 실제 사례는 Opus 4.8에서 나왔다. 주문 추출에서 올바른 필드와 값을 반환했지만 Markdown 코드 펜스로 감싸는 바람에 엄격한 JSON 검사를 통과하지 못했다. 채팅 창에서 읽는다면 오류라고 느끼지 않을 수도 있지만, 결과가 프로그램으로 바로 들어간다면 정제 단계를 추가해야 한다. 같은 출력도 사용 방식에 따라 다르게 체감될 수 있다.
코드 펜스 한 겹만 제거한 결과는 다음과 같다.
| 요청 모델 | 일상: 펜스만 제거 후 / 10 | 스트레스: 펜스만 제거 후 / 6 |
|---|---|---|
| claude-opus-4-8 | 10/10 | 3/6 |
| claude-opus-5-5 | 10/10 | 6/6 |
| gpt-6.1-sol | 9/10 | 0/6 |
| kimi-k3.1-pro | 6/10 | 2/6 |
| qwen3.8-max | 7/10 | 0/6 |
| deepseek-v4.1-flash | 9/10 | 0/6 |
| glm-5.3 | 1/10 | 0/6 |
Opus 4.8과 Opus 5.5의 일상 문제는 모두 10/10이지만, 스트레스 문제는 각각 3/6과 6/6이다. 이는 더 높은 능력의 장점이 주로 더 어려운 작업에서 나타날 수 있음을 보여 주는 구체적 사례다. 여기에는 일상 작업 5종과 스트레스 작업 3종만 있으며, 같은 문제의 호출 2회를 독립적인 두 문제로 계산할 수 없다. 따라서 일상 능력이 이미 동등하다고 증명할 수는 없다.
게이트웨이와 버전 매핑도 경험을 바꾼다#
이번 요청 112회 중 HTTP 오류가 15회, 읽기 시간 초과가 17회, 예산 절단이 7회 발생했다. 이 호출은 모두 고정 예산 전달률의 분모에 남겨 두었고, 다음 표에 별도로 표시했다.
| 요청 모델 | HTTP 오류 | 180초 읽기 시간 초과 | 예산 절단 | 정상 종료된 응답 수 |
|---|---|---|---|---|
| claude-opus-4-8 | 1 | 0 | 2 | 13 |
| claude-opus-5-5 | 0 | 0 | 0 | 16 |
| gpt-6.1-sol | 5 | 0 | 0 | 11 |
| kimi-k3.1-pro | 6 | 2 | 0 | 8 |
| qwen3.8-max | 1 | 8 | 0 | 7 |
| deepseek-v4.1-flash | 0 | 2 | 5 | 9 |
| glm-5.3 | 2 | 5 | 0 | 9 |
예를 들어 Kimi K3.1 Pro의 한 요청은 provider_authentication_failed를 반환했다. 이는 해당 요청이 업스트림에서 올바르게 인증되지 않았다는 뜻이며, 모델이 답을 틀렸다는 근거로 사용할 수 없다. 읽기 시간 초과 역시 클라이언트가 제때 완전한 응답을 받지 못했다는 뜻일 뿐이므로, 모델 연산이 느렸다고 단정할 수 없다.
| 요청 이름 | 실제 측정 응답에 나타난 model 필드 |
|---|---|
| claude-opus-4-8 | claude-opus-4-8 |
| claude-opus-5-5 | claude-opus-5-5 |
| gpt-6.1-sol | gpt-6.1-sol |
| kimi-k3.1-pro | kimi-k3.1-pro |
| qwen3.8-max | qwen3.8-max |
| deepseek-v4.1-flash | deepseek-v4.1-flash, deepseek-v4.1-flash-1017, deepseek/deepseek-flash |
| glm-5.3 | glm-5.3 |
응답의 model 필드는 서버가 밝힌 정보일 뿐, 웨이트의 정체성을 독립적으로 증명하지 않는다. 특히 DeepSeek는 같은 요청 이름으로 서로 다른 버전이나 별칭을 반환했으므로, 이번 라운드에서는 모든 요청이 AA의 동일 출시 버전과 정확히 일치한다고 보장할 수 없다. 따라서 이 결과는 “이번 API 경로의 전달 감사”라고 불러야 하며, AA 점수와 억지로 짝지어 상관계수를 계산할 수도, 이를 바탕으로 어느 나라 모델이 전반적으로 더 강하거나 동등하다고 선언할 수도 없다.
GLM-5.3 경로에서는 JSON 뒤에 추가 텍스트가 붙거나 답변이 반복되고 비정상적인 표시가 나타나는 응답도 있었다. 원본 증거는 보존하지만, 이상이 모델, 템플릿, 업스트림 어댑테이션 중 어디에서 생겼는지는 판단할 수 없다. 특히 낮은 엄격 전달 수를 기반 모델 능력에 대한 결론으로 사용하기는 적절하지 않다. 더 좋은 성적을 얻기 위해 경로를 바꾸거나 실패를 대체해 다시 실행하지도 않았다.
사람 블라인드 평가, 실제 운영 사용자 작업 표본 추출, 장기 부하 테스트, 동일 예산의 다회 Agent 평가는 완료하지 않았다. 따라서 “전반적인 체감이 똑같이 좋은가”에는 이번 증거만으로 답하기 부족하다. 확인할 수 있는 것은 문제 유형, 출력 형식, 요청 예산, 서비스 경로가 실제 경험을 단일 순위표의 순서와 다르게 만들 수 있다는 점이다.
누가 더 빨리 업데이트하나? 출시 수와 능력 도약은 나누어 보자#
다음은 AA가 다룬 표본의 독립 출시 버전을 집계한 것이지, 두 나라 모든 모델의 출시를 빠짐없이 조사한 것은 아니다. 한 버전의 여러 추론 단계는 한 번만 계산한다. 최첨단 갱신은 실제 향상이 일어난 날짜 기준으로 세며, 같은 날 여러 버전이 나와도 여러 번 계산하지 않는다.
| 2026년 월별 | 중국 출시 버전 | 미국 출시 버전 | 중국 최첨단 갱신 날짜 수 | 미국 최첨단 갱신 날짜 수 |
|---|---|---|---|---|
| 2026-01 | 5 | 4 | 1 | 0 |
| 2026-02 | 9 | 7 | 1 | 1 |
| 2026-03 | 12 | 9 | 0 | 1 |
| 2026-04 | 16 | 15 | 3 | 2 |
| 2026-05 | 6 | 4 | 0 | 0 |
| 2026-06 | 6 | 7 | 1 | 1 |
| 2026-07 | 5 | 10 | 2 | 2 |
| 2026-08 | 11 | 10 | 1 | 0 |
| 2026-09 | 8 | 13 | 1 | 3 |
| 2026-10(29일까지) | 5 | 10 | 2 | 1 |
2026년 1월 1일부터 10월 29일까지 표본에서 중국은 83개, 미국은 89개 버전을 출시했다. 최근 90개 달력일(8월 1일부터 10월 29일까지, 양끝 포함)에는 각각 24개와 33개였지만, 두 그룹 모두 자신의 Progress 최첨단을 갱신한 날짜는 4일뿐이었다. 더 많이 출시한다고 최고 능력이 자동으로 더 많이 향상되는 것은 아니다.[2]
이번 스냅숏 기준으로 중국의 가장 최근 최첨단 갱신은 10월 23일의 Kimi K3.1 Pro이고, 미국은 10월 28일의 Gemini 4 Carbon이다. 데이터는 10월 29일에 수집했으므로 수집일을 모델 업데이트일이라고 부를 수는 없다. AA API는 모델별 전체 과거 점수 변경 로그를 제공하지 않으며, 우리도 그런 필드를 지어내지 않았다.
어떻게 다시 계산하고, 다음 라운드에서는 “체감”을 어떻게 검증할까?#
이번 연구의 편집부 보관 자료에는 AA API 응답 4쪽, 공개 추세 그래프 데이터, 통합된 517행 CSV, 통계 스크립트, 작업 정답, 전체 호출 112회와 요약을 보관했다. 정식 블로그의 통계는 모두 이 동결 기록에서 나왔다. 출처는 Artificial Analysis이며, 집계 계산과 Crazyrouter 경로 실측은 이 글에서 수행했다.
핵심 계산은 다음 의사코드로 이해할 수 있다.
# One snapshot and metric version.
# Use AA release_id, not guessed names.
release_score = max(non_null_scores_for_each_release)
baseline = progress_score_of_opus_4_8_max
above_baseline = release_score > baseline
frontier_at_date = max(scores_of_releases_available_by_date)
gap_at_date = us_frontier_at_date - cn_frontier_at_date
예를 들어 주문 추출 작업의 Opus 4.8 응답 ID는 msg_011CgWecKv2YBwoHYumCeURh이며, HTTP 200으로 정상 종료되었다. 원래 답변은 올바른 JSON을 코드 펜스로 감싼 형태였기 때문에 엄격 채점에서는 실패, 형식 민감도 점검에서는 통과했다. Kimi 인증 실패 요청 ID는 608ccc90b353423d036dca779cafcc37다. 두 기록은 각각 “결과를 받았지만 형식이 맞지 않음”과 “모델 답변을 받지 못함”의 차이를 보여 준다.
다음 예제는 업무 규칙 작업 하나를 재생한다. API Key는 환경 변수에서만 읽으며, 엔드포인트에는 UTM이 없다.
import os
import requests

endpoint = "https://cn.crazyrouter.com" + "/v1/chat/completions"
user_content = (
    "\u672a\u62c6\u5c01\u4e14\u7b7e\u6536" "\u6b21\u65e5\u8d777\u65e5\u5185" "\u53ef\u9000\u6b3e\uff1b\u7b2c7" "\u65e5\u5305\u542b\u5728\u5185\u3002"
    "A\u57282026" "-10-20" "\u7b7e\u6536\uff0c202" "6-10-2" "7\u7533\u8bf7\u9000\u6b3e\uff0c"
    "\u65e0\u8d28\u91cf\u7f3a\u9677\u3002" "\u53ea\u8f93\u51faJSO" "N\uff0c\u952eeli" "gible\u4e3a" "\u5e03\u5c14\u503c\u3002"
)

response = requests.post(
    endpoint,
    headers={"Authorization": "Bearer " + os.environ["CRAZYROUTER_API_KEY"]},
    json={
        "model": "claude-opus-4-8",
        "messages": [{"role": "user", "content": user_content}],
        "reasoning_effort": "high", "max_tokens": 8192, "stream": False,
    },
    timeout=(15, 180),
)
response.raise_for_status()
print(response.json())
이것은 본문의 간소화된 재현 예제이며, 공식 테스트 112회에 사용된 완전한 원문 문제가 아니다. 전체 문제 8개, 채점 스크립트, 원본 기록은 편집부에 보관되어 있으며, 이 글은 완전한 원본 연구 패키지의 공개 다운로드를 제공하지 않는다. 이 간소화 문제를 사용해 공식 성적을 추가하거나 대체하지도 않았다.
여기서 available_by_date는 출시일이 해당 날짜보다 늦지 않다는 뜻일 뿐, 당일 공개 API가 있었음을 보장하지 않는다. 점수가 없다고 0을 채우지 않으며, 1점을 고정된 백분율로 취급하지도 않는다. 두 나라의 국적은 AA 연구개발 기관 라벨을 따르며, Google은 AA가 표시한 미국 그룹에 넣는다. 서버 위치나 직원 국적으로 나누지 않는다.[1][3]
다음 라운드에서 “체감 동등성”을 제대로 검증하려면, 먼저 목표 사용자 작업 세 부류와 허용 가능한 차이를 고정한 뒤 익명화하고 좌우 순서를 무작위로 한 쌍대 블라인드 평가를 진행하는 것이 좋다. 주요 지표에는 작업 완성 품질, 중대한 오류, 사람의 재작업, 선호도가 포함되어야 하며, 호출 실패율은 따로 표시해야 한다. 동등성 경계와 표본 크기는 결과를 보기 전에 정하고, 작업별로 묶어 분석해야 한다. “유의한 차이가 검출되지 않았다”를 “경험이 같다”는 뜻으로 사용할 수는 없다.
다음으로 이 시리즈는 무엇을 연구할까?#
이번 글에서는 “점수 격차, 과거 플래그십 기준, 실제 전달은 어떻게 다른가”에 먼저 답했다. 후속편은 능력 유형별로 나누어 각 작업에 맞는 벤치마크, 고정 예산, 실제 API 테스트를 사용한다. 서로 다른 모달리티의 점수를 하나의 “국가 총점”으로 합치지 않는다. 다음은 주제 계획이며, 후속 특집은 아직 발표되지 않았다.
| 편 | 예정 주제 | 중점적으로 답할 질문 |
|---|---|---|
| 1편 · 텍스트 모델 | 플래그십 기준을 넘은 뒤에도 일상 작업에서는 얼마나 차이가 날까? | 중국어 글쓰기, 구조화 출력, 긴 문서, 사실성, 사람 블라인드 평가의 격차 |
| 2편 · 프로그래밍과 Agent | 답할 줄 아는 것과 일을 끝내는 것은 같은가? | 코드 수정, 테스트 통과, 도구 호출, 다단계 작업, 예산 내 완료율 |
| 3편 · 이미지 모델 | 보기 좋은 것을 넘어 누가 요구대로 이미지를 만드는가? | 텍스트-이미지 생성, 이미지 편집, 중국어 문자, 주체 일관성, 반복 생성 안정성 |
| 4편 · 비디오 모델 | 한 장면의 놀라움 뒤에 움직임과 서사가 성립하는가? | 텍스트-비디오 생성, 이미지-비디오 생성, 운동 및 물리 일관성, 캐릭터 연속성, 완성까지의 대기 |
| 5편 · 음성 모델 | 정확히 듣고 자연스럽게 말하며 대화에도 따라올 수 있는가? | 음성 인식, 음성 합성, 실시간 음성을 각각 측정하고 억양과 지연도 함께 고려 |
| 6편 · 벡터와 리랭킹 | 지식 기반 효과의 격차는 정확히 어디에 있는가? | 중국어 및 교차 언어 검색, 긴 문서, Recall@k, nDCG, 리랭킹 향상, 인덱싱 비용 |
| 7편 · 종합 선택 | 같은 예산으로 서로 다른 모델을 어떻게 조합할까? | 앞선 실측을 모아 구체적 상황별 품질, 대기, 비용, 신뢰성 선택안 제시 |
각 편은 “누가 최첨단에 있는가, 누가 실용 기준을 넘었는가, 격차가 실제 작업에 영향을 주는가”라는 세 질문을 유지한다. 다만 기준은 해당 모달리티의 참조 모델이나 업무 검수 조건으로 정의한다. 예를 들어 Opus 4.8은 이번 글의 텍스트 참조가 될 수 있지만, 이미지, 음성, 벡터 모델의 범용 기준이 될 수는 없다.
자주 묻는 질문#
중국과 미국 AI 모델의 실제 격차는 얼마나 되는가?#
이번 스냅숏에서 미국은 AA Intelligence v5 최첨단에서 13.4점 앞서 있다. 같은 Progress v1 척도의 최첨단 격차는 10.94점이다. 둘은 측정 목표가 다르며, 어느 쪽도 능력 백분율이나 사용자 만족도 차이로 직접 환산할 수 없다.
격차는 점점 커지고 있는가?#
현재 회고 데이터는 “지속적 확대”를 뒷받침하지 않는다. 2026년 9월 말 격차는 27.61이었고 10월 29일에는 10.94였으며, 그 사이 새 모델 출시에 따라 뚜렷하게 좁혀졌다. 다만 최첨단 추격이 상위 그룹의 두께까지 같아졌다는 뜻은 아니다.
Opus 4.8을 넘은 중국 모델은 몇 개인가?#
Progress v1, 독립 출시 버전, Opus 4.8(max)보다 엄밀하게 높음을 기준으로 하면 역사적 버전을 포함해 12개다. 그중 9개는 아직 AA가 deprecated로 표시하지 않았다. 평가 참조 기준을 넘었다고 모든 작업에서 Opus 4.8보다 낫다는 보장은 없다.
왜 Opus 4.8의 61.4점을 사용하지 않는가?#
61.4는 출시 당시 구버전 Intelligence Index에서 나온 점수다. 이번 v5에서는 해당 모델의 총점이 없다. 같은 척도로 비교해야 하며, 과거 점수를 새 순위표에 그대로 적용할 수 없다.
중국 모델이면 일상 사용에 이미 충분한가?#
국적만으로 일률적인 답을 할 수 없다. 이번 라운드에서 일부 모델은 일상 작업을 완수했지만, 게이트웨이 오류, 형식 차이, 예산 절단도 결과를 바꿨다. 자신의 작업과 허용 가능한 실패율을 출발점으로 삼아 구체적인 모델과 신뢰할 수 있는 호출 경로를 선택해야 한다.
이번 테스트가 중국과 미국 모델의 체감이 같다는 것을 증명하는가?#
그렇지 않다. 합성 작업 8종을 문제당 2회 수행했을 뿐이며, 일부 요청에서는 버전 별칭과 경로 문제도 나타났다. 사람 블라인드 평가도 없었다. 이 테스트는 순위표와 경험이 갈라질 수 있는 구체적 이유를 보여 줄 뿐, 전반적인 동등성을 증명하지 않는다.
출시 버전, 모델 구성, API 이름은 어떻게 다른가?#
AA의 출시 버전 하나에는 여러 추론 단계가 있을 수 있다. 게이트웨이는 별칭을 사용하거나 새 버전으로 순차 업데이트할 수도 있다. 순위표 집계는 출시 버전 기준으로 중복을 제거하고, 실측은 실제 요청 이름과 반환된 model 필드를 보존한다. 둘이 자동으로 일대일 대응하지는 않는다.
참고 자료#
- Artificial Analysis Data API: 필드, 페이지 나누기, 버전, 결측값 정의. 이번 전체 수집일은 2026-10-29이며, API는 Intelligence 버전 5를 보고했다.
- Artificial Analysis AI Trends: Progress, 국가 소속, 출시 버전. 이번에는 2026-10-29 익명 공개 페이지 스냅숏을 사용했으며, 글의 통계는 저자가 이 스냅숏을 다시 계산한 결과다.
- Artificial Analysis Progress Index v1 방법론. IRT 척도, 단계, 역사적 비교의 경계.
- AA Intelligence Index v5 발표 공지, 2026-10-27. 평가 변화를 설명하는 데 사용하며, 10월 29일 최신 순위표의 대체 자료로 사용하지 않았다.
- AA Intelligence Index 방법론 및 버전 설명.
- AA Opus 4.8 출시 평가, 2026-05-28 및 현재 모델 페이지.
- Anthropic Opus 4.8 공식 출시 페이지.
이 글의 “초과”와 “우위”는 모두 명시된 척도와 다뤄진 표본에 한정되며, 통계적 유의성을 뜻하지 않는다. AA 데이터에 이후 추가 측정, 수정, 신규 모델이 생기면 결과를 다시 계산해야 한다.