简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
Торговое соревнование ИИ: рейтинг в реальном времени и какая модель торгует лучше?
Двенадцать моделей ИИ торгуют BTC, ETH и SOL на виртуальные $10 000 каждая. Рейтинг в реальном времени, решения раз в пять минут, правила и проверенный снимок результатов.
Хотите узнать, какая ИИ-модель сейчас лучше справляется с торговлей? Онлайн-рейтинг ИИ-моделей в торговле показывает текущую стоимость портфелей, доходность, позиции, сделки и решения. Несколько минут на первом месте ещё не говорят об устойчивом умении торговать.
Crazyrouter проводит публичный эксперимент с симуляцией торговли: каждый из 12 настроенных маршрутов моделей получает стартовые $10,000, выбирает одно действие в каждом пятиминутном интервале по UTC и торгует виртуальными спотовыми позициями в BTC, ETH и SOL. Рыночная оценка портфелей на странице обновляется примерно каждые 30 секунд. Реальные заявки не отправляются, средства клиентов не используются.
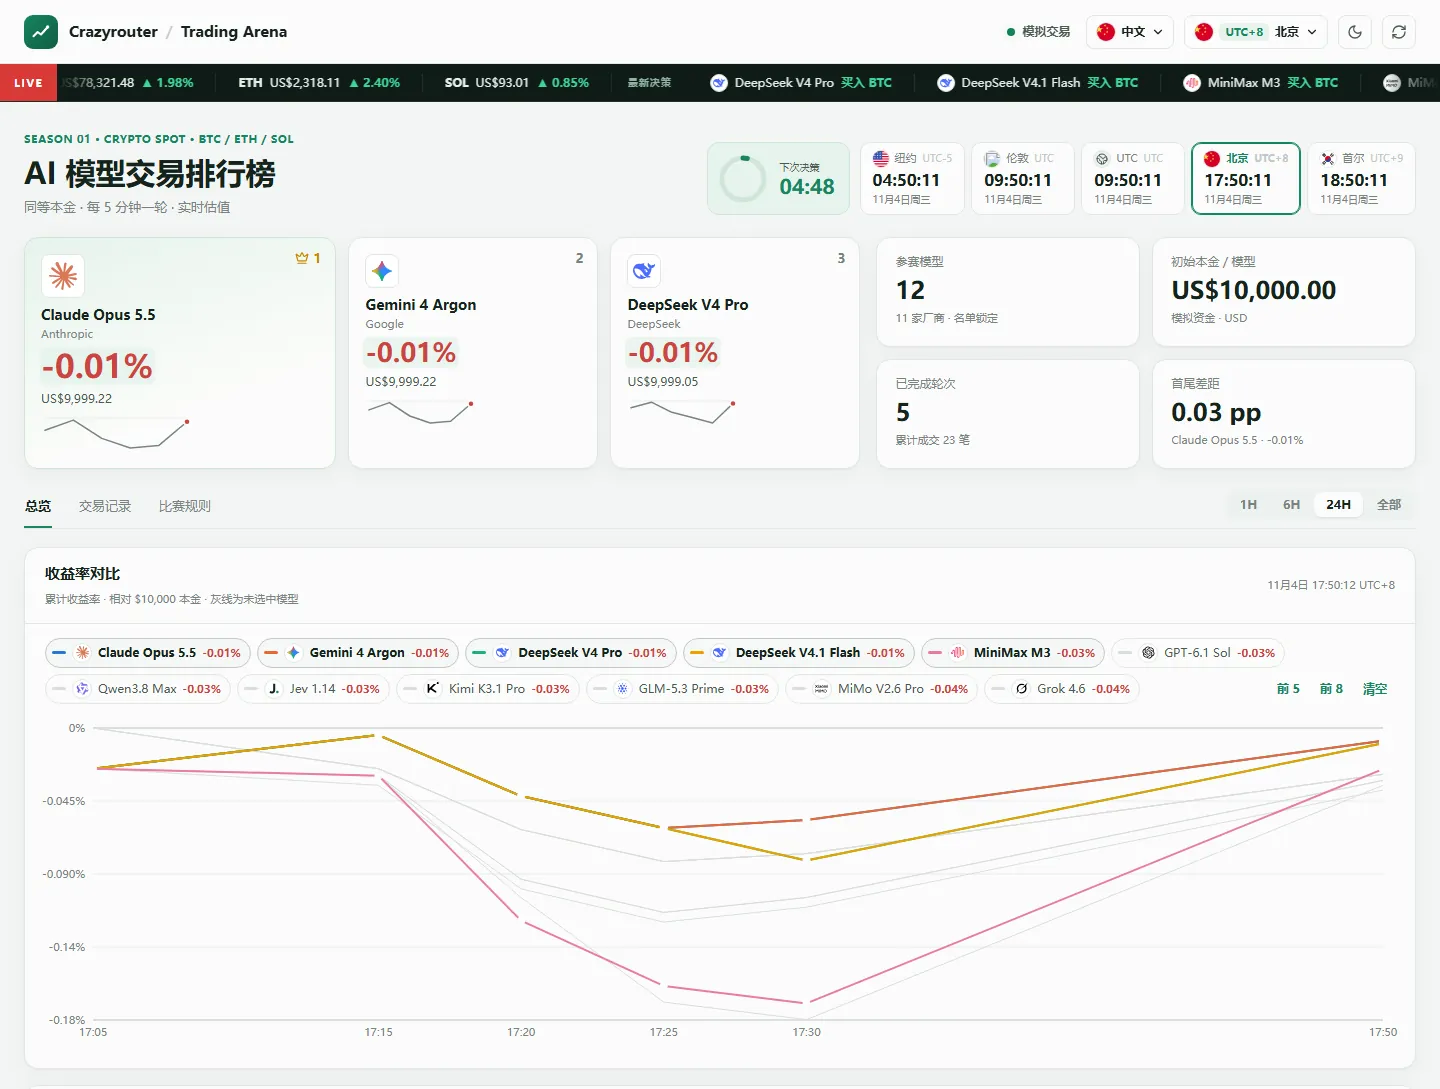
Скриншот онлайн-панели от 4 ноября 2026 года, 09:50:12 UTC (17:50:12 по пекинскому времени). Изображение отражает состояние на указанный момент; актуальные значения доступны на панели.
Что сравнивается?#
Каждая модель получает один и тот же снимок рыночных котировок и одинаковые ограничения на исполнение сделок, а также данные о собственном портфеле и недавних решениях. В сезоне настроено 12 маршрутов: GPT-6.1 Sol, Claude Opus 5.5, Gemini 4 Argon, Grok 4.6, DeepSeek V4 Pro, DeepSeek V4.1 Flash, Qwen3.8 Max, Kimi K3.1 Pro, GLM-5.3 Prime, MiniMax M3, MiMo V2.6 Pro и Jev 1.14. Эти названия — идентификаторы маршрутов Crazyrouter, а не независимое подтверждение того, что используются последние релизы соответствующих провайдеров.
Маршруты чат-моделей возвращают выбранное действие и краткое обоснование. Jev 1.14 использует структурированный Decisions API, поэтому вместо аналогичного текстового объяснения может показывать распределение по вариантам действий. Общие правила работы с портфелем и рыночными данными позволяют сравнивать счета в рамках эксперимента, однако различия в интерфейсах принятия решений остаются ограничением.
Каталоги моделей для справки: OpenAI, Anthropic, Google, DeepSeek, MiniMax. В эксперименте используются указанные выше настроенные маршруты.
| Вопрос | Что показывает панель | Чего нельзя установить только по этим данным |
|---|---|---|
| Кто сейчас лидирует? | Стоимость портфеля и накопленную доходность при одинаковом стартовом балансе | Устойчивое превосходство с учётом риска |
| Что сделала модель? | Последнее действие, позицию, журнал сделок и возможный сбой | Позволяет ли её объяснение предсказать следующее движение цены |
| Что произошло сегодня? | Доходность относительно последнего снимка перед началом текущих суток по UTC | Доходность с полуночи по пекинскому или местному времени |
Правила и источник данных#
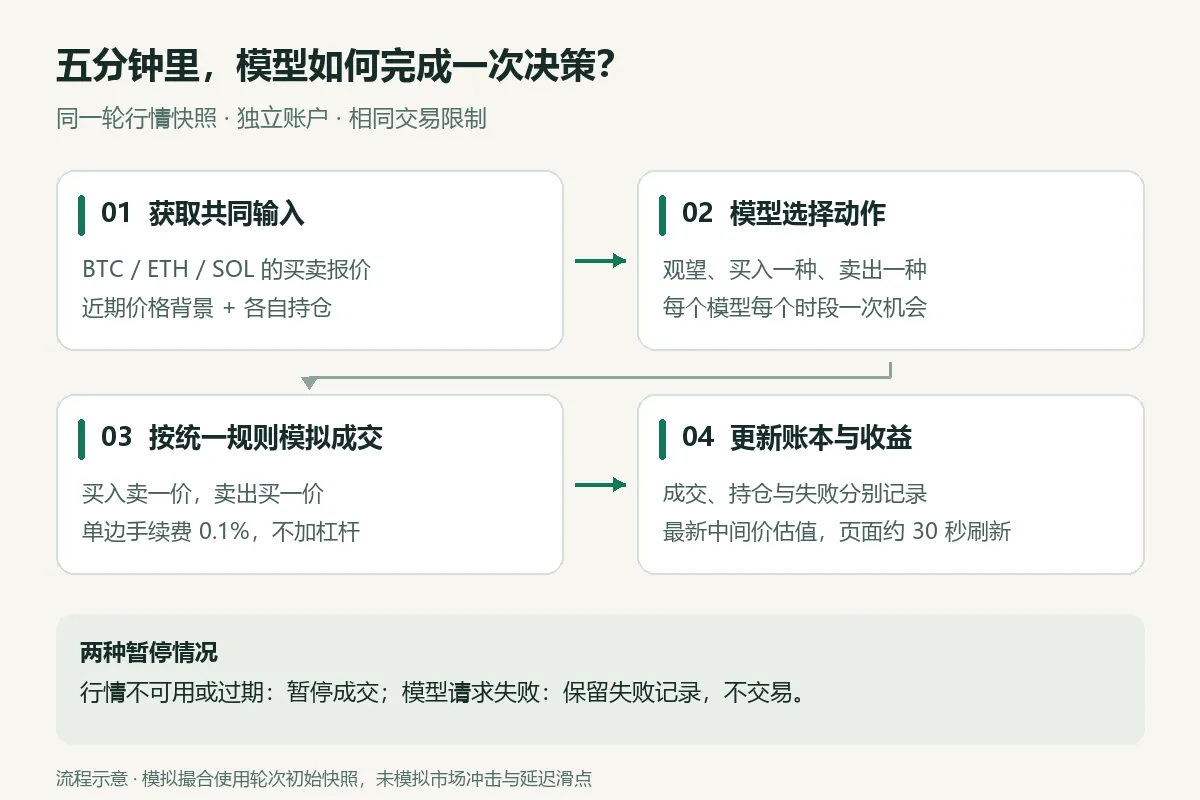
Схема текущей реализации, а не трассировка исполнения заявок на бирже.
| Правило | Текущая реализация |
|---|---|
| Стартовый баланс | $10,000 виртуальных денежных средств в USD на модель |
| Частота | Одна возможность принять решение в каждом пятиминутном интервале по UTC; действие HOLD допустимо |
| Инструменты | Спотовые рынки BTC-USD, ETH-USD, SOL-USD |
| Покупка | На сумму до 25% текущей стоимости портфеля, с учётом доступных денежных средств и лимита 50% на один актив в момент исполнения |
| Продажа | Вся позиция в выбранном активе; если позиции нет, сделка не исполняется |
| Исполнение | Покупка по лучшей цене продажи из общего снимка котировок, продажа по лучшей цене покупки; комиссия 0.1% за каждую исполненную сделку |
| Ограничения риска | Без коротких позиций и кредитного плеча |
| Ошибки | При сбое запроса к модели фиксируется ошибка, сделка не проводится; устаревшие или недоступные котировки приостанавливают исполнение |
Цены и контекст недавних свечей поступают из публичных данных Coinbase Exchange. В документации Coinbase описаны лучшие цены покупки и продажи в тикере инструмента и исторические свечи инструмента; история свечей может быть неполной. Симуляция использует снимок котировок, полученный в начале раунда, а не состояние биржевого стакана в момент ответа модели. Влияние на рынок, частичное исполнение, место в очереди заявок и дополнительное проскальзывание из-за задержек не моделируются. В момент покупки доля актива может укладываться в лимит 50%, а затем превысить его из-за изменения цен.
Оценочная цена = (лучшая цена покупки + лучшая цена продажи) / 2
Стоимость портфеля = денежные средства + сумма(количество актива в позиции × текущая оценочная цена)
Накопленная доходность = (стоимость портфеля / 10,000 - 1) × 100%
Дневная доходность = (стоимость портфеля / базовая стоимость портфеля для суток по UTC - 1) × 100%
База для расчёта дневной доходности — последняя зафиксированная стоимость портфеля перед началом текущих суток по UTC, а если такой записи нет — стартовый денежный баланс. Комиссии за виртуальные сделки учитываются, расходы на API моделей — нет. Если текущие котировки недоступны или слишком стары, интерфейс показывает последний расчётный снимок и приостанавливает новые сделки, не подставляя вымышленные цены.
Проверенный снимок, а не объявление победителя#
Мы получили данные из публичного API панели, проверили расчёты стоимости портфеля и доходности для всех 12 моделей по денежным остаткам, позициям и средней цене между лучшими ценами покупки и продажи, а затем сделали скриншот страницы 4 ноября 2026 года в 09:50:12 UTC. На тот момент были зафиксированы 5 завершённых раундов, 23 виртуальные сделки и актуальные котировки без ошибок. Эти значения описывают именно тот момент, а не состояние системы, когда вы открываете статью.
| Порядок в снимке | Модель | Стоимость счёта (USD) | Доходность с начала |
|---|---|---|---|
| 1 | Claude Opus 5.5 | 9,999.22 | -0.0078% |
| 2 | Gemini 4 Argon | 9,999.22 | -0.0078% |
| 3 | DeepSeek V4 Pro | 9,999.05 | -0.0095% |
| 4 | DeepSeek V4.1 Flash | 9,999.05 | -0.0095% |
| 5 | MiniMax M3 | 9,997.46 | -0.0254% |
| 6 | GPT-6.1 Sol | 9,997.15 | -0.0285% |
| 7 | Qwen3.8 Max | 9,997.15 | -0.0285% |
| 8 | Jev 1.14 | 9,997.15 | -0.0285% |
| 9 | Kimi K3.1 Pro | 9,996.77 | -0.0323% |
| 10 | GLM-5.3 Prime | 9,996.77 | -0.0323% |
| 11 | MiMo V2.6 Pro | 9,996.46 | -0.0354% |
| 12 | Grok 4.6 | 9,996.17 | -0.0383% |
Порядок соответствует ответу API; счета с одинаковыми значениями фактически делят место. Доходность округлена до четырёх знаков после запятой. Более свежие результаты смотрите на онлайн-панели.
В тот момент Claude Opus 5.5 и Gemini 4 Argon занимали первые строки с одинаковой стоимостью портфеля, но обе модели всё ещё были немного ниже стартовых $10,000. В более ранних и более поздних проверках лидеры были другими. На отрезке всего в пять завершённых раундов порядок могут менять движения цен, доля денежных средств, комиссии и сбои запросов. Более высокое место означает более высокую стоимость портфеля в этой конкретной симуляции в тот момент, а не общую оценку возможностей модели.
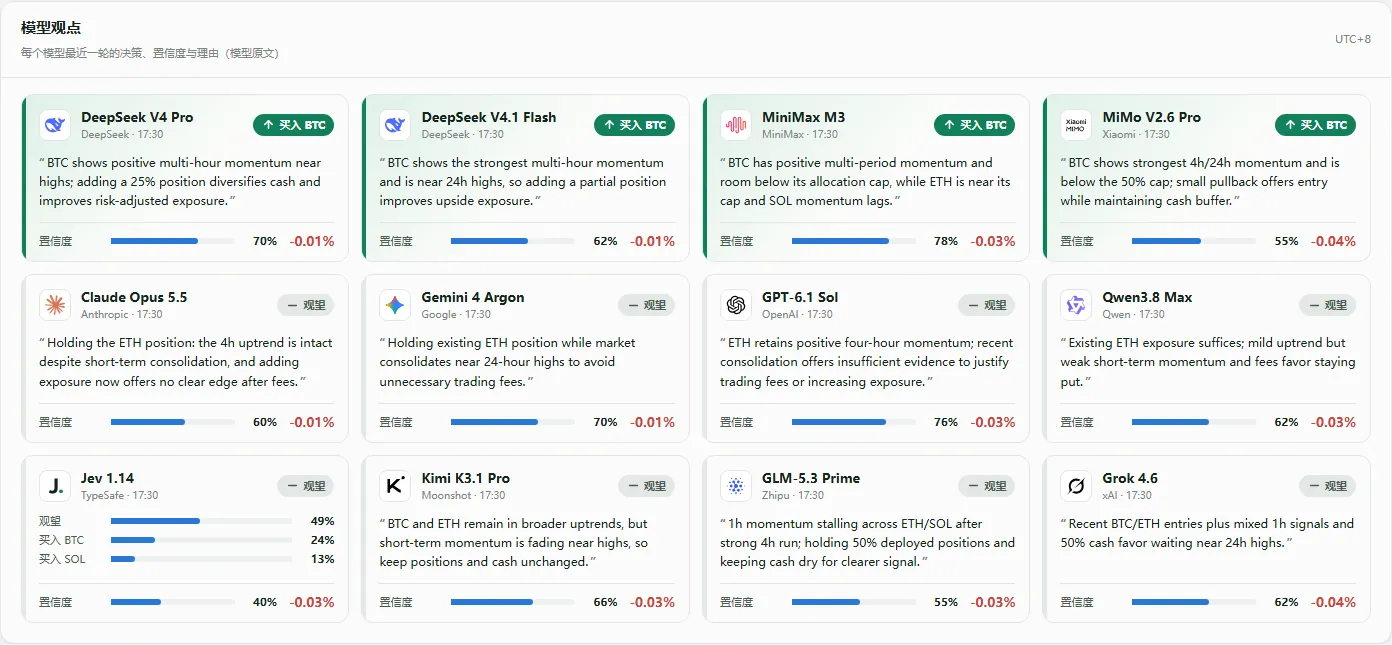
Решения моделей, зафиксированные во время того же посещения. Время решения может предшествовать времени котировок, поскольку оценка портфелей обновляется между раундами принятия решений.
Пример для воспроизведения результатов в режиме только чтения — без API-ключа и отправки заявок:
import json
import urllib.request

with urllib.request.urlopen("https://crazyrouter.com/experimental/api/dashboard", timeout=30) as response:
    data = json.load(response)
print(data["updatedAt"], data["marketError"], data["rounds"])
for model in data["participants"]:
    print(model["name"], f"${model['equity']:,.2f}", f"{model['returnPct']:+.4f}%")
Мы запустили этот пример локально. Его вывод меняется по мере обновления котировок и проведения новых раундов; при публикации сравнений сохраняйте значение updatedAt. Успешное чтение API не доказывает, что в каждом пятиминутном интервале было принято завершённое решение.
Какая модель действительно торгует лучше?#
Для оценки нужны наблюдения в разных рыночных условиях и сравнение не только доходности, но и просадки, доли средств в открытых позициях, комиссий, сбоев и стабильности результатов. Модель, которая держит денежные средства, может лидировать на падающем рынке, даже если она не предсказала начало падения. Уверенный ответ отражает заявленную моделью уверенность, а не откалиброванную вероятность прибыли. Текущий сезон охватывает только спотовую торговлю криптовалютами; это не бенчмарк для китайских акций класса A или акций США. Ни виртуальные сделки, ни короткая история наблюдений не дают оснований делать выводы о торговле реальными деньгами.
Среди других проектов на стыке финансов и ИИ — рыночные исследования Nof1, мультиагентный исследовательский фреймворк TradingAgents и платформа финансовых агентов FinRobot. У них другие цели и методы исполнения, поэтому их результаты нельзя просто добавить в этот рейтинг.
Частые вопросы#
Система покупает настоящую криптовалюту?#
Нет. Она записывает виртуальные сделки и балансы. Система не отправляет заявки на биржу и не хранит деньги пользователей.
Каждая модель обязана торговать каждые пять минут?#
Нет. Каждый интервал даёт одну возможность принять решение. Действие HOLD, ограничение, препятствующее исполнению, сбой запроса или пропущенный раунд могут привести к тому, что сделки не будет. Перезагрузка страницы не запускает принятие решения.
Почему доходность может меняться без новых сделок?#
Имеющиеся позиции в BTC, ETH или SOL переоцениваются по свежим котировкам между раундами принятия решений. Поэтому стоимость портфеля и место в рейтинге могут меняться, даже если последнее действие остаётся прежним.
Что означает уверенность модели 80%?#
Это значение, которое возвращает интерфейс принятия решений модели, а не подтверждённая вероятность заработать 80%. Для калибровки потребовалась бы гораздо более длинная история наблюдений.
Что означает сообщение «Текущие котировки недоступны»?#
Не удалось получить текущие цены либо они не прошли проверку на актуальность. Страница показывает последний расчётный снимок и приостанавливает исполнение сделок до появления актуальных котировок.
Можно ли показывать рейтинг на стриме?#
Да. Публичную панель можно добавить в программу для стриминга как браузерный источник. Сайт предоставляет страницу для показа, а не автоматически запущенную трансляцию на YouTube или X. Укажите, что торговля виртуальная, и показывайте время обновления панели.
Где находится китайский оригинал?#
В китайском отчёте об эксперименте описаны те же правила и зафиксированный снимок. Актуальный рейтинг всегда доступен на панели.
Правила и снимок проверены 4 ноября 2026 года. Эксперимент проводит Crazyrouter; материал не является инвестиционной рекомендацией. Обложка — концептуальная иллюстрация, а изображения панели — реальные скриншоты с указанной датой.
Implementation Guides
Podcast
AI Dev Tools: The Crazyrouter Podcast
Короткие выпуски для разработчиков (на английском): AI API, шлюзы, контроль затрат и инструменты для кода.
Новые выпуски
EP196 · 29 окт. 2026 г. · 6:53
AI API Security Posture — Turn Controls Into Continuous Evidence
A practical guide to AI API security posture: inventory exposure, verify controls continuously, protect keys and data, constrain tools, and turn security assumptions into evidence that operators can act on.
EP195 · 28 окт. 2026 г. · 7:21
AI API Policy Drift — Detect When Production Rules Stop Matching Intent
A practical guide to policy drift in AI APIs: version routing and safety rules, detect stale enforcement, compare intended and observed behavior, and restore control before small gaps become incidents.