 中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
mimo-v2.6-pro против gpt-6-astra: пеликан на велосипеде, коробка конфет и ещё 6 проб — плюс пойманное «поглупение» по API
8 забавных проб (SVG пеликана, коробка конфет, подсчёт букв, акростих) по 3 прогона на mimo-v2.6-pro и gpt-6-astra. 7 из 8 — ничья; на SVG пеликана gpt 3/3, mimo 2/3 с одним пустым ответом. Плюс пойманная инъекция ~4100 токенов на маршруте gpt-6-astra. SVG и логи прилагаются.
Сначала вывод, затем — почему к выводу нужна поправка.
Коротко#
- 8 забавных проб, по 3 прогона, 48 оценённых вызовов: mimo-v2.6-pro 23/24, gpt-6-astra 24/24.
- 7 «классических ловушек» (коробка конфет / теория разума, подсчёт букв r, 9.11 против 9.9, вырожденная переправа через реку, сёстры Алисы, китайский акростих, самоописывающее предложение) обе модели решили правильно во всех прогонах. Эти пробы уже не различают флагманы 2026 года.
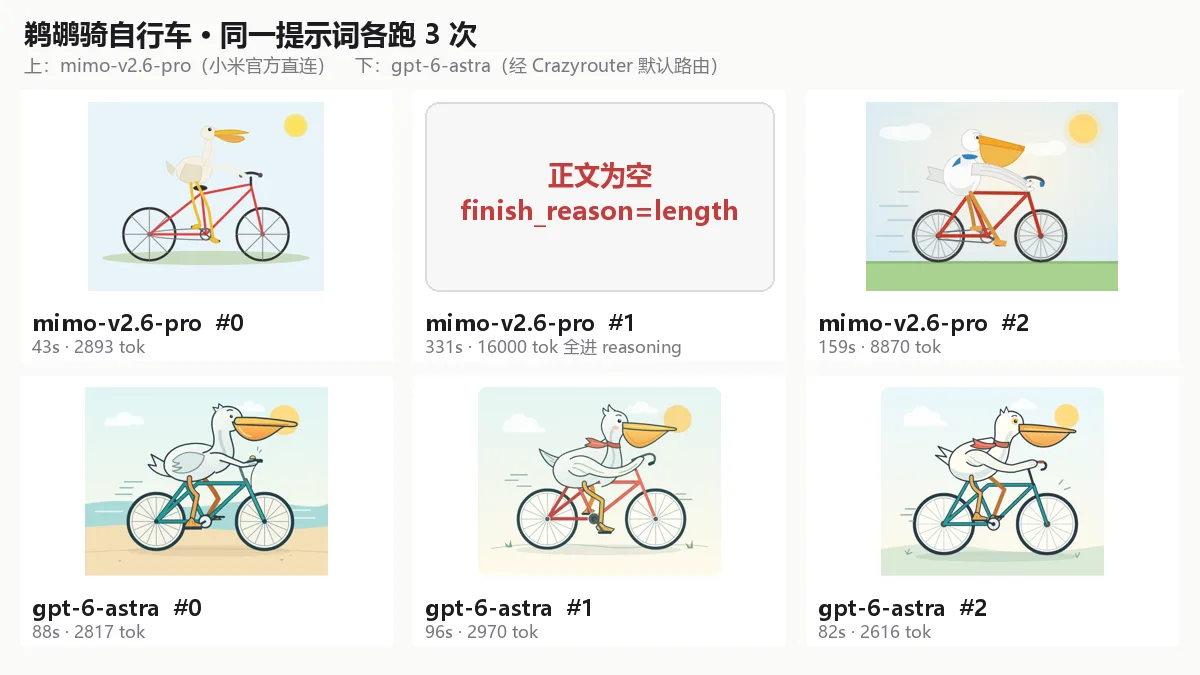
- Единственный разрыв — SVG «пеликан едет на велосипеде»: gpt-6-astra нарисовал 3/3; mimo 2/3, причём один прогон думал 331 секунду, сжёг все 16 000 токенов в рассуждении и вернул пустую строку. Разрыв в стабильности, а не в потолке: лучший рисунок mimo не хуже gpt.
- Реально списано: 28 вызовов gpt-6-astra — 0,028, в 9,3 раза. Заметная доля этого — не цена модели, см. следующий пункт.
- Раскрытие: маршрут по умолчанию, на который попал gpt-6-astra, вставляет примерно 4100 скрытых токенов в каждый запрос (на простое «hi» пришло
prompt_tokens=4121), а разнообразие сэмплирования аномально низкое. Все числа по gpt-6-astra здесь описывают «gpt-6-astra, доступный через этот путь 22.09.2026», а не нативный API OpenAI.
Почему раскрытие идёт первым: то, что вы тестируете через API, не всегда сама модель#
Прежде чем что-либо сравнивать, мы проверили маршрутизацию обеих линий. Большинство бенчмарков этот шаг пропускают, а именно он определяет, чего стоят цифры.
| mimo-v2.6-pro | gpt-6-astra | |
|---|---|---|
| Кандидаты маршрута | 1: напрямую в официальный api.xiaomimimo.com | 18 кандидатов; в тот день победила сторонняя линия с наивысшим приоритетом |
| Формат id ответа | UUID | resp_… (апстрим — Responses API, переведённый обратно в chat completions) |
prompt_tokens на голое «hi» | 8 | 4121 (cached_tokens=3968) |
| Фиксированная вставка на запрос | 0 | ~4100 токенов, одинаково во всех 28 вызовах |
Возвращается ли reasoning_tokens | каждый вызов | в 3 пробах из 8, в 5 — пусто |
| Реальная цена ответа из одного слова | $0,00002 | $0,014 |
Иначе говоря, каждый запрос к gpt-6-astra на этой линии несёт невидимый системный промпт. Это влияет на три вещи: поведение модели может формировать промпт, которого вы не видите; каждый вызов платит около $0,013 фиксированных входных расходов; поля usage передаются лишь частично. Линия mimo — официальное прямое подключение, ноль вставок, полный usage.
Это одна из конкретных форм того, что называют «поглупением по API»: модель не стала хуже, но между вами и официальным API стоит обёртка. Такое может быть у любого шлюза, агрегатора или перепроданной линии — включая наш собственный маршрут по умолчанию. Проверка ровно одна: отправьте «hi» и посмотрите, однозначное ли число в prompt_tokens.
Ещё две общие оговорки: 3 прогона на пробу — маленькая выборка, она показывает только, могла ли линия стабильно решить задачу в тот день; у двух семейств разные токенизаторы, поэтому число токенов нельзя делить между семействами — мы сравниваем только правильность, символы вывода, списанные доллары и секунды.
Модели и цены#
| Модель | Вход $/M | Выход $/M | Списано за 28 вызовов |
|---|---|---|---|
| mimo-v2.6-pro (Xiaomi, контекст 1M, рассуждающая модель) | 0,435 | 0,87 | $0,028 |
| gpt-6-astra (OpenAI) | 5,00 | 25,00 | $0,261 |
Цены — со страницы тарифов Crazyrouter; списания — из потокенного журнала использования.
Условия теста#
Одна и та же OpenAI-совместимая конечная точка, без системного промпта, температура по умолчанию, без стриминга:
curl https://api.crazyrouter.com/v1/chat/completions \
  -H "Authorization: Bearer $CRAZYROUTER_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "mimo-v2.6-pro",
    "messages": [{"role": "user", "content": "Generate an SVG of a pelican riding a bicycle. Output only the SVG code, no explanation, no markdown fences."}],
    "max_tokens": 16000
  }'
Для каждого вызова записывались id, usage (включая reasoning_tokens), finish_reason, время и полный ответ. SVG рендерились в PNG 480px через Playwright для ручной оценки.
8 проб и результаты#
| # | Проба | Что проверяет | mimo-v2.6-pro | gpt-6-astra | Примечание |
|---|---|---|---|---|---|
| 1 | Пеликан на велосипеде в виде SVG | Пространственная композиция, генерация кода, стабильность длинного вывода | 2/3 | 3/3 | См. следующий раздел |
| 2 | Ложное убеждение с коробкой конфет (коробка с надписью «конфеты», внутри карандаши; два вопроса) | Рассуждение с чужой позиции | 3/3 | 3/3 | mimo нарушил условие «по одному предложению» — жирный текст и пояснения |
| 3 | Сколько букв r в «raspberry cranberry strawberry» (ответ 9) | Ловушка токенизатора | 3/3 | 3/3 | Обе потратили токены рассуждения |
| 4 | Что больше, 9.11 или 9.9 | Классическая числовая ловушка | 3/3 | 3/3 | gpt ответил без рассуждения, 7 токенов |
| 5 | Переправа через реку только с фермером и капустой (ответ 1) | Подставляет ли шаблон «волк, коза, капуста»? | 3/3 | 3/3 | Никто не попался |
| 6 | У Алисы 4 брата и 2 сестры; сколько сестёр у её брата (ответ 3) | Подсчёт с включением себя | 3/3 | 3/3 | |
| 7 | Китайский акростих: четыре строки по 5 иероглифов, начинающиеся с 路/由/更/快, без знаков препинания | Жёсткие ограничения на китайском | 3/3 | 3/3 | gpt написал почти одно и то же стихотворение 3 раза; mimo — три разных |
| 8 | Английское предложение, правдиво называющее число своих слов | Самореферентная согласованность | 3/3 | 3/3 | gpt трижды использовал шаблон «exactly seven … words» |
Несколько примеров.
Акростих, mimo, три прогона:
路远山川阔 / 由来天地长 / 更逢春雨后 / 快马踏花香
路途远且长 / 由山入云间 / 更上一重岭 / 快马踏清风
路远行人稀 / 由来秋意深 / 更向孤村去 / 快马踏寒林
Акростих, gpt-6-astra, три прогона:
路远逐晨光 / 由心向远方 / 更登千仞岭 / 快意任翱翔
路远春风近 / 由心逐晓光 / 更登千仞岭 / 快意览朝阳
路远春风近 / 由心逐晓光 / 更登千里岫 / 快意向朝阳
Самоописывающее предложение — mimo: «This sentence has five words.» (5, верно); gpt: «This sentence contains exactly seven English words.» (7, верно).
Пеликан: единственная проба, которая их разделила#
Это классика Саймона Уиллисона: попросить модель написать SVG-код «пеликан едет на велосипеде», не показывая никакой картинки. Проверяется, способна ли модель выразить пространственные отношения двух сложных объектов в координатах.
| Прогон | mimo-v2.6-pro |
|---|---|
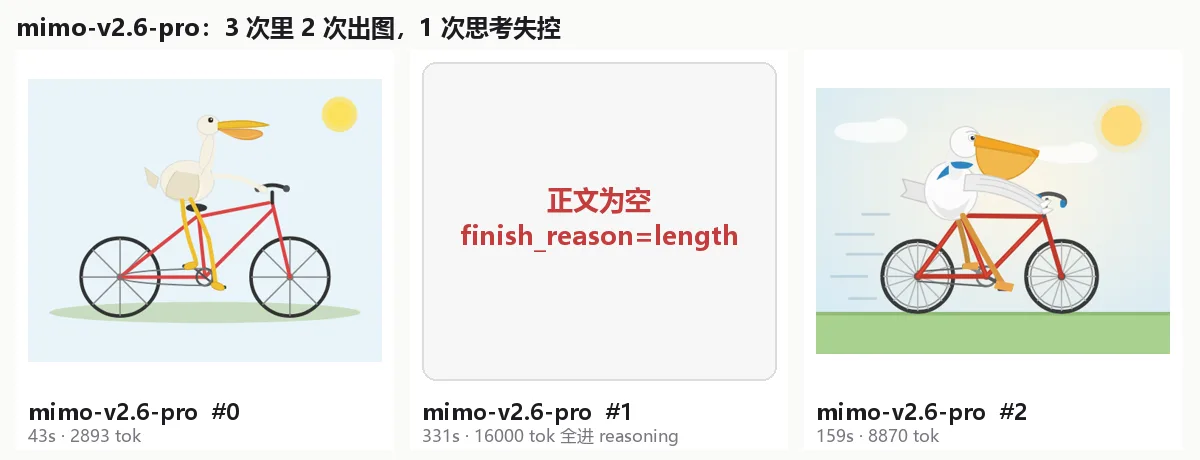
| #0 | 43 с, 2893 токена вывода (111 рассуждения). Пеликан стоит на раме вместо седла; крыло едва дотягивается до руля; у клюва оранжевый мешок. Приемлемо |
| #1 | 331 с, все 16 000 токенов сгорели в рассуждении, пустой контент, finish_reason=length. Рассуждение — 41 656 символов планирования координат и порядка слоёв («крыло перед рулём или за ним?»), до вывода SVG дело так и не дошло |
| #2 | 159 с, 8870 токенов (5147 рассуждения). Облака, линии скорости, синие перья, правильная посадка — лучший рисунок mimo |
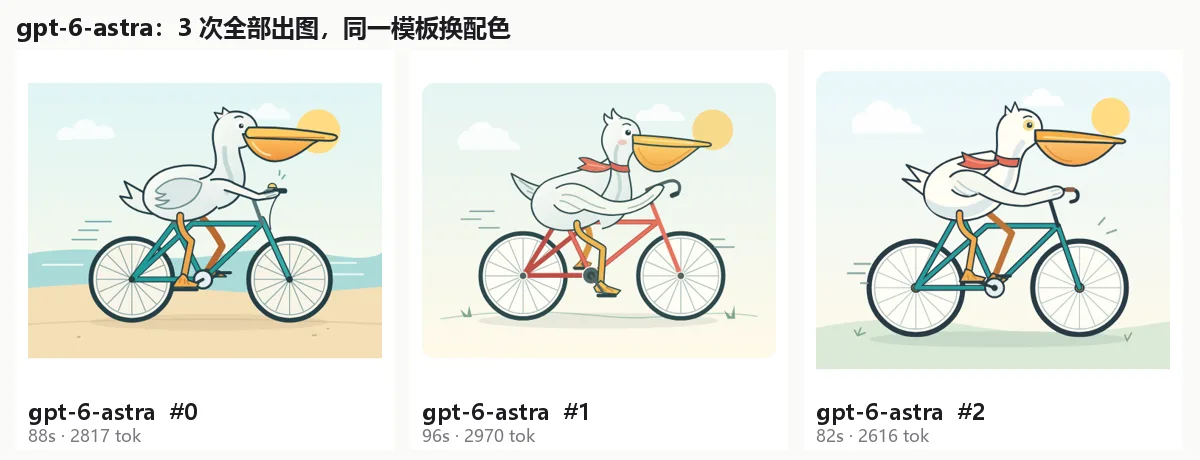
| Прогон | gpt-6-astra |
|---|---|
| #0 | 88 с, 2817 токенов. Пляж, пеликан на седле, крыло на руле, лапы на педалях — самая полная композиция |
| #1 | 96 с, 2970 токенов. Та же композиция плюс красный шарф |
| #2 | 82 с, 2616 токенов. Та же композиция, бирюзовая рама |
Исходные SVG (немодифицированный вывод моделей): mimo #0 · mimo #2 · gpt-6-astra #0 · gpt-6-astra #1 · gpt-6-astra #2
Три наблюдения:
- Три рисунка gpt-6-astra — один шаблон в разных цветах: тот же пляж, облака, форма клюва, шарф. Вместе с почти идентичными акростихами и самоописывающими предложениями это означает, что разнообразие сэмплирования на этой линии близко к нулю, как будто температура зафиксирована обёрткой. Путь это или модель — в этом раунде не разделить.
- mimo сильно варьирует между прогонами: в лучшем случае не уступает gpt, в худшем вызов пропадает целиком. Пропавший прогон стоил $0,0139 — самый дорогой вызов mimo в раунде — и вызывающий получил пустую строку.
- Время: gpt стабильно 82–96 с; mimo от 43 до 331 с.
Задержки#
| Проба | mimo-v2.6-pro | gpt-6-astra |
|---|---|---|
| Среднее по 4 коротким пробам | 3,9 с | 4,8 с |
| Коробка конфет | 8,4 с | 16,3 с |
| Акростих | 13,7 с | 9,2 с |
| Самоописывающее предложение | 9,9 с | 4,6 с |
| SVG пеликана | 177,8 с | 88,6 с |
На коротких ответах mimo чуть быстрее; на длинных выводах gpt стабильнее.
Рекомендации для продакшена#
Если вы интегрируете mimo-v2.6-pro — или любую рассуждающую модель — обрабатывайте случай «рассуждение съело бюджет»:
resp = client.chat.completions.create(model="mimo-v2.6-pro", messages=msgs, max_tokens=8000)
choice = resp.choices[0]
if choice.finish_reason == "length" and not choice.message.content:
    # размышление исчерпало бюджет, тело пустое:
    # повторить с меньшим max_tokens или другой моделью; никогда не сохранять пустую строку как результат
    ...
Больший max_tokens не делает вызов безопаснее автоматически: срыв mimo случился именно потому, что бюджет в 16 000 токенов позволил ей планировать бесконечно. Для детерминированных задач 4000–8000 зачастую стабильнее.
Перед интеграцией любого зарубежного флагмана сделайте одну пробу «hi»: проверьте, что prompt_tokens однозначное, что id в официальном формате и что usage полный. Если хоть что-то не так — между вами есть слой, и бенчмарки вместе с оценкой затрат нужно переделывать. Инспектор маршрутизации Crazyrouter показывает, на какой канал сейчас попадает модель и сколько у неё кандидатов; после регистрации на странице моделей видны конечные точки и цены каждой модели.
Кого выбирать под какую задачу#
- Код или структурированный вывод, который должен приходить всегда: gpt-6-astra 3/3 против mimo 2/3 в этом раунде — явное преимущество в стабильности.
- Массовые короткие вопросы-ответы, чувствительность к цене: одинаковая правильность, mimo в 9 раз дешевле и чуть быстрее.
- Письмо с ограничениями на китайском: обе выполнили жёсткие условия; у mimo больше разнообразия.
- Нужен
reasoning_tokensдля контроля затрат: mimo отдаёт его всегда; линия gpt-6-astra — лишь иногда.
FAQ#
В: Почему забавные пробы, а не стандартный бенчмарк? Стандартные бенчмарки почти наверняка попали в обучающие данные. Забавные пробы — особенно SVG пеликана — заставляют модель кодировать пространственные отношения в координаты прямо сейчас; запомнить нечего. Минус — субъективная оценка, поэтому все исходные файлы опубликованы.
В: Пустой вывод mimo — проблема платформы?
Нет. finish_reason=length, reasoning_tokens=16003 и content="" пришли напрямую от апстрима по официальной прямой линии без вставок. Это известный риск рассуждающих моделей на открытых задачах с длинным выводом.
В: Что за 4100 вставленных токенов у gpt-6-astra?
Префикс, добавляемый промежуточным слоем: 3968 токенов попадают в кэш, одинаково во всех 28 вызовах. Его содержимое мы не видели (в ответе его нет), только вывели из prompt_tokens. Чтобы исключить его влияние, нужен повторный прогон, закреплённый за официальным каналом OpenAI — это следующий раунд.
В: Какая часть разрыва в 9,3 раза — из-за вставки? Около 115K входных токенов за 28 вызовов, из них 111K — попадания в кэш (кэшированный вход тарифицируется как 10% цены входа) — примерно 0,261. Остальное — реальная разница в цене моделей.
В: Почему нет мультимодальных тестов? Разве mimo не омнимодальна? Этот раунд — только текст. Для изображений и видео будет отдельный план.
В: Достаточно ли 3 прогонов? Для вывода «кто умнее» — нет. Для сигналов стабильности вроде «одна линия трижды отвечает одинаково» и «одна модель срывает один прогон из трёх» — да. Дальше добавим длинноконтекстные вопросы с ложной посылкой на 18,7K токенов (по 6 прогонов) и тяжёлые задачи на рассуждение (по 13 прогонов).
Связанные материалы#
- gpt-6-astra vs Claude Fable 5.1: на 60% меньше символов вывода — но отчасти потому, что отвечает меньше
- Claude Fable 5.1 vs Fable 5: эффективность вывода, правильность и ломающие изменения без ошибок
- Почему Crazyrouter, а не OpenRouter? Три конкретных отличия
- Тарифы · Документация
Итог#
По состоянию на сентябрь 2026 года, на этих двух конкретных путях: забавные пробы не различают модели по интеллекту; они различают их по стабильности (gpt стабилен, mimo склонна к срыву) и по цене (mimo дешевле на порядок). Но полезнее всего то, что стоит перед обоими выводами: отправьте «hi» перед бенчмарком и проверьте, с кем вы на самом деле разговариваете.
Следующий раунд: длинный контекст и тяжёлое рассуждение для той же пары; повтор gpt-6-astra через официальный канал, чтобы проверить «три одинаковых ответа»; затем по плану — mimo-v2.6-flash против claude-sonnet-4-6 и kimi-k2.7-code против claude-opus-5.