简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
Kimi K3.1 Pro vs Kimi K3.1 Pro Highspeed: 30 тестов — как выбрать по скорости и стоимости?
30 вызовов в парном тесте на одном интерфейсе и уровне reasoning: итоги задач, полное время ответа, ожидание начала ответа и цены шлюза. Highspeed быстрее в четырёх обычных задачах, но медленнее в планировании; есть данные и код.
Если пользователям приходится ждать выполнения вашей задачи, Kimi K3.1 Pro Highspeed стоит в первую очередь проверить в парном тесте; если Pro уже удовлетворяет требованиям к отклику, обычная версия дешевле за единицу. В этой серии из 30 вызовов каждая модель прошла 15/15; медианы времени выполнения Highspeed в четырёх обычных задачах соответствуют ускорению примерно в 1.78–2.30 раза, но в задаче планирования он оказался примерно вдвое медленнее.
Все исходные промпты теста были на китайском языке. Эта версия описывает те же 30 запросов от 29 октября 2026 года, а не новый тест на русском. Crazyrouter одновременно является использованным API-шлюзом и издателем этого блога.
Поэтому highspeed может быть вариантом ускорения, но не гарантией ускорения каждого запроса. Тем более нельзя, ориентируясь только на название, утверждать, что возможности моделей, процесс рассуждения или фактическая стоимость отдельного запроса полностью одинаковы.
В этой серии через один и тот же интерфейс Chat Completions Crazyrouter было выполнено 30 вызовов двух моделей в парном тесте; сохранены финальные ответы, ID ответов, статусы и расход токенов. Приведённые ниже цены и протестированный путь запросов актуальны на 29 октября 2026 года; они не отражают расценки прямого подключения к Moonshot или производительность штатного развёртывания производителя.
kimi-k3.1-pro vs kimi-k3.1-pro-highspeed: какие различия подтверждены официально?#
Kimi официально описывает Highspeed как версию, более подходящую для быстрого взаимодействия, и заявляет, что её скорость в 2–3 раза выше, чем у обычного Pro. Это заявление производителя о производительности; из него нельзя напрямую заключить, что ожидание каждого прикладного запроса сократится более чем вдвое. [1]
Официальная документация по параметрам прямо указывает, что обе модели подчиняются ограничениям параметров серии K3. [2]
| Параметр сравнения | Kimi K3.1 Pro | Kimi K3.1 Pro Highspeed |
|---|---|---|
| Точное имя модели в API | kimi-k3.1-pro | kimi-k3.1-pro-highspeed |
| Официальный предел контекста | 1,048,576 токенов | Такой же |
reasoning_effort | low / high / max, по умолчанию max | Такой же |
| Уровень рассуждения в этой серии | high | high |
| Бюджет вывода в этой серии | max_tokens=8192 | Такой же |
| Официальное описание скорости | Базовая версия для сравнения | Заявлено ускорение в 2–3 раза относительно Pro |
| Пройдено в этой серии | 15/15 | 15/15 |
Значение контекста взято из официального описания тарификации; в этой статье входные данные размером в миллион токенов не тестировались. [3] Совпадение параметров также не доказывает, что совпадают базовые веса, схема квантования, оборудование или объём вычислений на каждый запрос; собранных материалов недостаточно для выводов об этих деталях реализации.
Если вы сравниваете Pro с K3 предыдущего поколения, это другой вопрос; см. статью сравнение обновления K3.1 Pro и K3. Набор моделей и результаты тестов из той статьи не включались в статистику этой серии.
Как проводились 30 тестов: сначала фиксируем задачи, затем сравниваем скорость#
Сначала мы запросили список моделей, доступных после аутентификации, убедились, что оба точных ID видны, и только затем выполнили фактические вызовы. Присутствие модели в списке означает лишь, что аккаунт видит это имя; завершение вызова проверялось по последующим ответам.
| Настройка теста | Значение в этой серии |
|---|---|
| Base URL | https://cn.crazyrouter.com/v1 |
| Endpoint | POST /chat/completions |
| Запрашиваемая модель | Два точных ID из таблицы выше |
| Задачи и повторы | 5 задач, по 3 запуска каждой задачи для каждой модели, всего 30 вызовов |
| Рассуждение и бюджет | reasoning_effort: "high", max_tokens: 8192 |
| Способ возврата | stream: true, usage возвращается в конце потока запроса |
| Промпты и инструменты | Промпты для одной и той же задачи полностью идентичны; внешние инструменты и system-сообщения не использовались |
| Порядок отправки | Две модели для одной задачи запускались парами параллельно, максимальная конкурентность — 2; порядок отправки чередовался по раундам |
| Тайм-ауты подключения/чтения клиента | 15 секунд / 180 секунд; суммарное время проверялось на каждом событии потока |
Пять задач охватывали следующие контрольные точки:
| Задача | Критерии проверки |
|---|---|
| Конфликты записей и отсутствующие поля | Обработка обновлений и отзывов полей; null для неизвестного поставщика; игнорирование отвлекающих инструкций в примечаниях |
| Извлечение JSON и дедупликация | Сохранение последней записи, сортировка по ID, точное преобразование денежных сумм в целое число центов |
| Слияние полуоткрытых интервалов в Python | Слияние только при строгом пересечении, нормализация перевёрнутых концов, отбрасывание пустых интервалов, отсутствие изменения входных данных; каждая функция проверялась на 87 случаях |
| Оптимальное планирование с зависимостями | Минимизация взвешенного времени завершения семи задач; эталонный ответ сгенерирован локальным полным перебором |
| Длинный вывод JSON | Полная генерация 80 объектов с поэлементной проверкой целочисленных порядковых номеров и квадратов значений |
Для зачёта требовались HTTP 200, finish_reason="stop", получение [DONE], а также соответствие финального ответа правилам проверки. В этой серии не было зафиксировано HTTP-ошибок, усечений, тайм-аутов или непройденных проверок.
Тем не менее задач по-прежнему всего пять. Три повтора нужны для наблюдения за колебаниями, а не представляют три независимые задачи; 87 внутренних проверок кода также нельзя считать 87 задачами для модели. Повторяющиеся промпты могут вызывать кэширование префиксов: в записях действительно встречались запись в кэш и попадания в кэш. Поэтому это не бенчмарк с холодным кэшем, и все различия задержки нельзя приписывать самим моделям.
Полное время ответа: Highspeed быстрее в четырёх задачах, но планирование — исключение#
В таблице ниже приведены медианы трёх успешных запросов для каждой модели и каждой задачи. Коэффициент ускорения — это время Pro ÷ время Highspeed; значение больше 1 означает, что Highspeed быстрее, меньше 1 — что медленнее.
| Задача | Медиана времени выполнения Pro | Медиана времени выполнения Highspeed | Ускорение |
|---|---|---|---|
| Конфликты записей и границы отказа | 8.06 с | 3.93 с | 2.05× |
| Структурированное извлечение и дедупликация | 8.51 с | 3.70 с | 2.30× |
| Слияние полуоткрытых интервалов в Python | 11.03 с | 6.21 с | 1.78× |
| Оптимальное планирование с зависимостями | 33.88 с | 67.59 с | 0.50× |
| Длинный вывод JSON и вычисления | 21.43 с | 9.82 с | 2.18× |
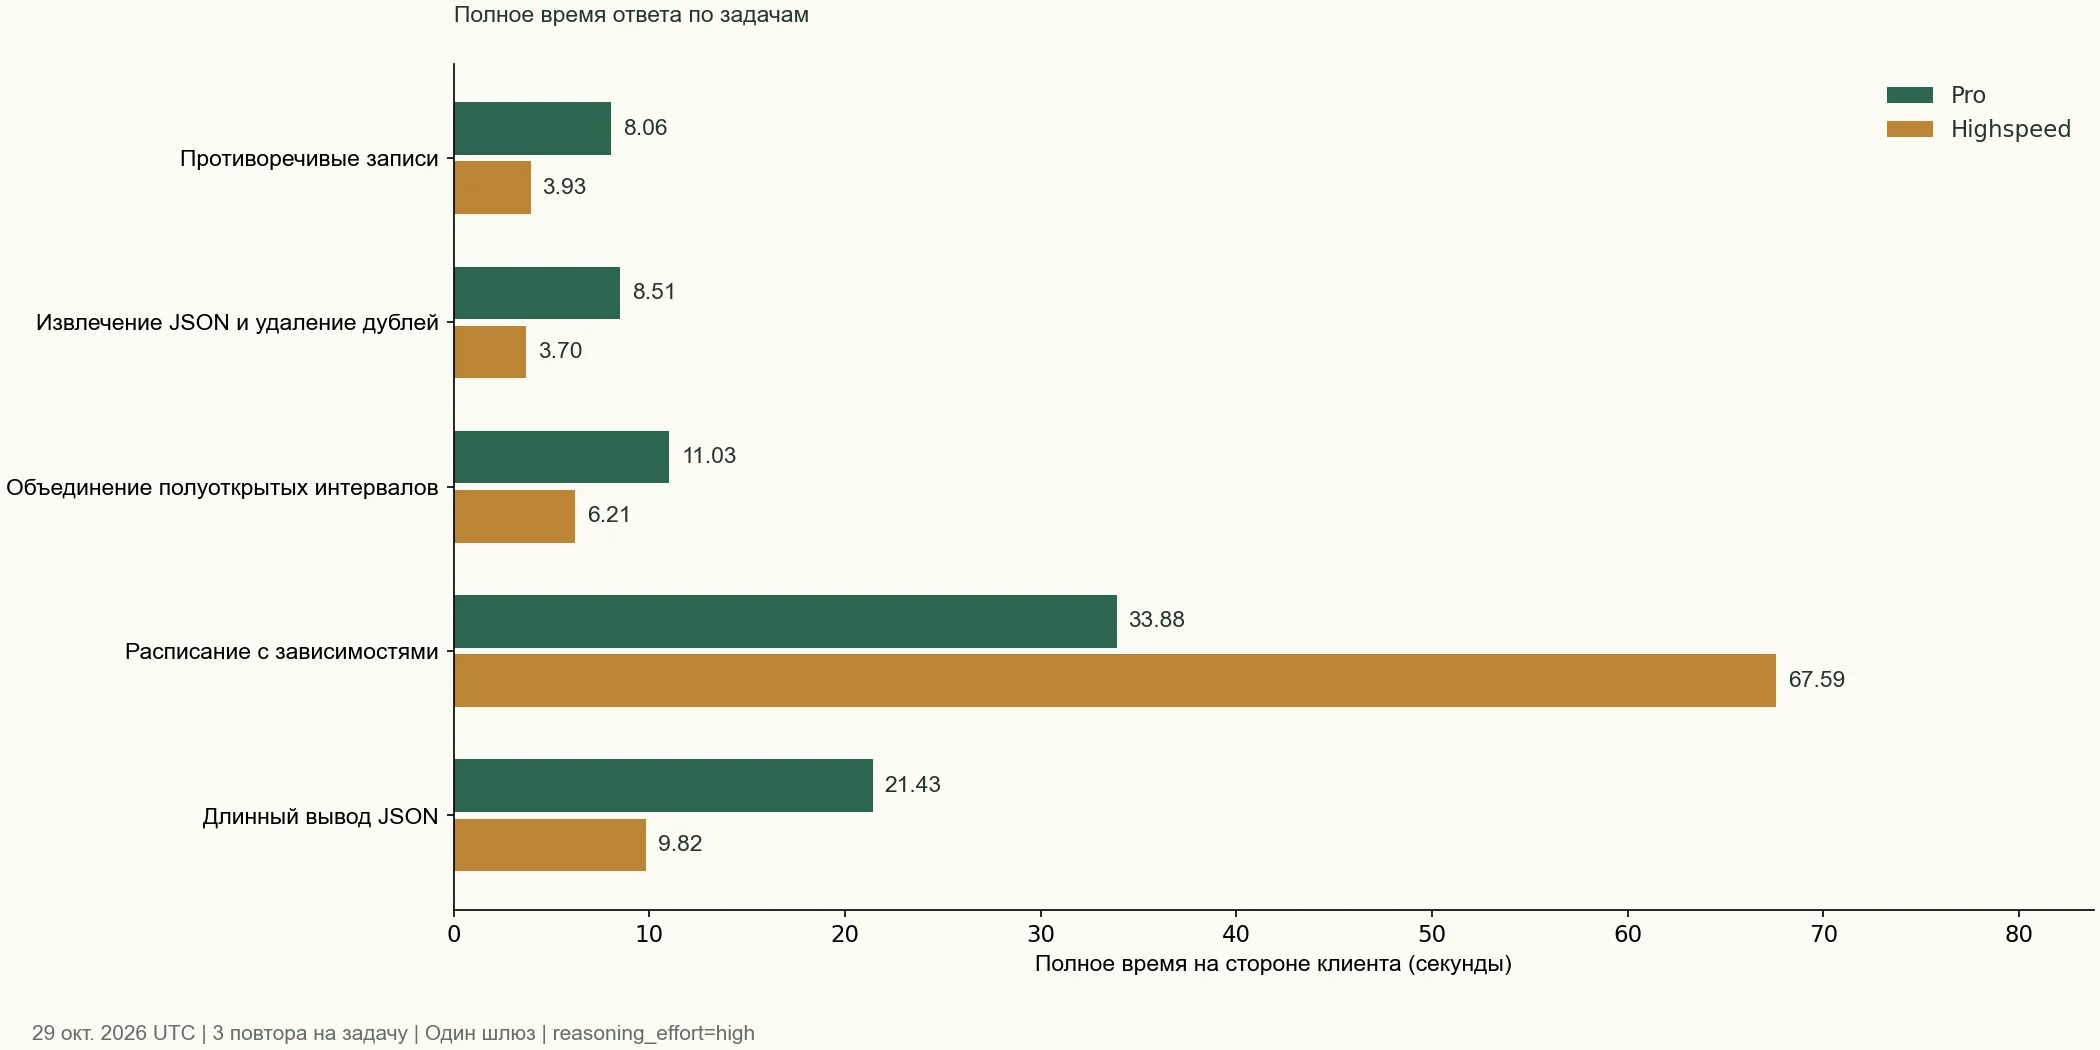
Разница в структурированном извлечении и выводе JSON из 80 элементов наиболее очевидна: при выполнении тех же проверок высокоскоростная версия заметно сократила ожидание. В задаче с кодом тоже есть улучшение, но не до уровня «вдвое быстрее каждый раз»: в первом раунде запросы с кодом заняли 9.59 и 9.14 секунды соответственно, то есть разница была небольшой.
В 15 парах запросов с одинаковой задачей и раундом Highspeed оказался быстрее в 11 парах. Контрпримеры — первая проверка записей и все три запуска планирования. Эта доля описывает только данную выборку, а не вероятность ускорения в производственной среде.
Обе модели выдали приемлемые результаты в этих задачах с однозначными ответами и ограниченным набором условий. Мы не наблюдали снижения качества, которое могли бы выявить проверки этой серии, но этого недостаточно, чтобы доказать эквивалентное качество в открытом письме, сложном программировании или продолжительных задачах агентов.
Почему Highspeed оказался медленнее в задаче планирования?#
Сначала рассмотрим пару реальных ответов из первого раунда:
| Метрика | Pro | Highspeed |
|---|---|---|
| Время выполнения | 39.82 с | 67.59 с |
completion_tokens | 1,097 | 4,178 |
Из них reasoning_tokens | 1,071 | 4,152 |
| Финальный ответ обеих моделей | {"order":"BADGCFE","cost":307} | Такой же |
| Результат проверки | Пройдена | Пройдена |
Соответствующие ID ответов — 8e4f8840-0af2-4981-880b-26f016ec63ba и 38a707dc-c53c-41c4-905f-4204b9c3d499. Ответ по планированию проверен локальным полным перебором, а не оценкой ответа одной модели по ответу другой.
Одинаковый уровень high не означает, что два запроса генерируют одинаковое число reasoning-токенов. В этот раз высокоскоростная версия сгенерировала больше reasoning-токенов, и одновременно увеличилось ожидание. Это наблюдение объясняет, почему «генерирует быстрее» и «завершает задачу раньше» — не одно и то же, но не позволяет установить единственную причину замедления на стороне сервера.
Во втором раунде планирования разрыв был больше: 30.16 секунды у Pro и 121.22 секунды у Highspeed; в третьем — 33.88 и 38.44 секунды. Все три образца подтверждают, что в этой задаче Highspeed медленнее, но их недостаточно, чтобы распространять вывод на утверждение «Highspeed хуже справляется с математикой или планированием».
Более полное клиентское время также включает сетевой обмен, очередь, генерацию рассуждений, генерацию ответа и завершение потока. В этой серии не измерялись серверные очереди или оборудование и не тестировалась конкурентная ёмкость, поэтому всю разницу общего времени нельзя объяснять пропускной способностью декодирования.
Быстрое первое событие потока не означает, что пользователь уже видит ответ#
Для моделей с рассуждением нужно различать как минимум три момента:
- Первое непустое событие рассуждения или ответа: когда после запроса начинает поступать содержимое.
- Первый фрагмент финального ответа: первый непустой
delta.content; далее для краткости — «начало ответа». - Завершение полного ответа: поток получен и обработан, финальный статус записан.
Ниже приведены медианы «начала ответа» для трёх вызовов. Это время получения клиентом первого непустого content, а не время фактического отображения в браузере.
| Задача | Начало ответа Pro | Начало ответа Highspeed |
|---|---|---|
| Конфликты записей и границы отказа | 7.63 с | 3.92 с |
| Структурированное извлечение и дедупликация | 7.65 с | 3.37 с |
| Слияние полуоткрытых интервалов в Python | 9.47 с | 5.55 с |
| Оптимальное планирование с зависимостями | 33.64 с | 67.44 с |
| Длинный вывод JSON и вычисления | 10.91 с | 5.80 с |
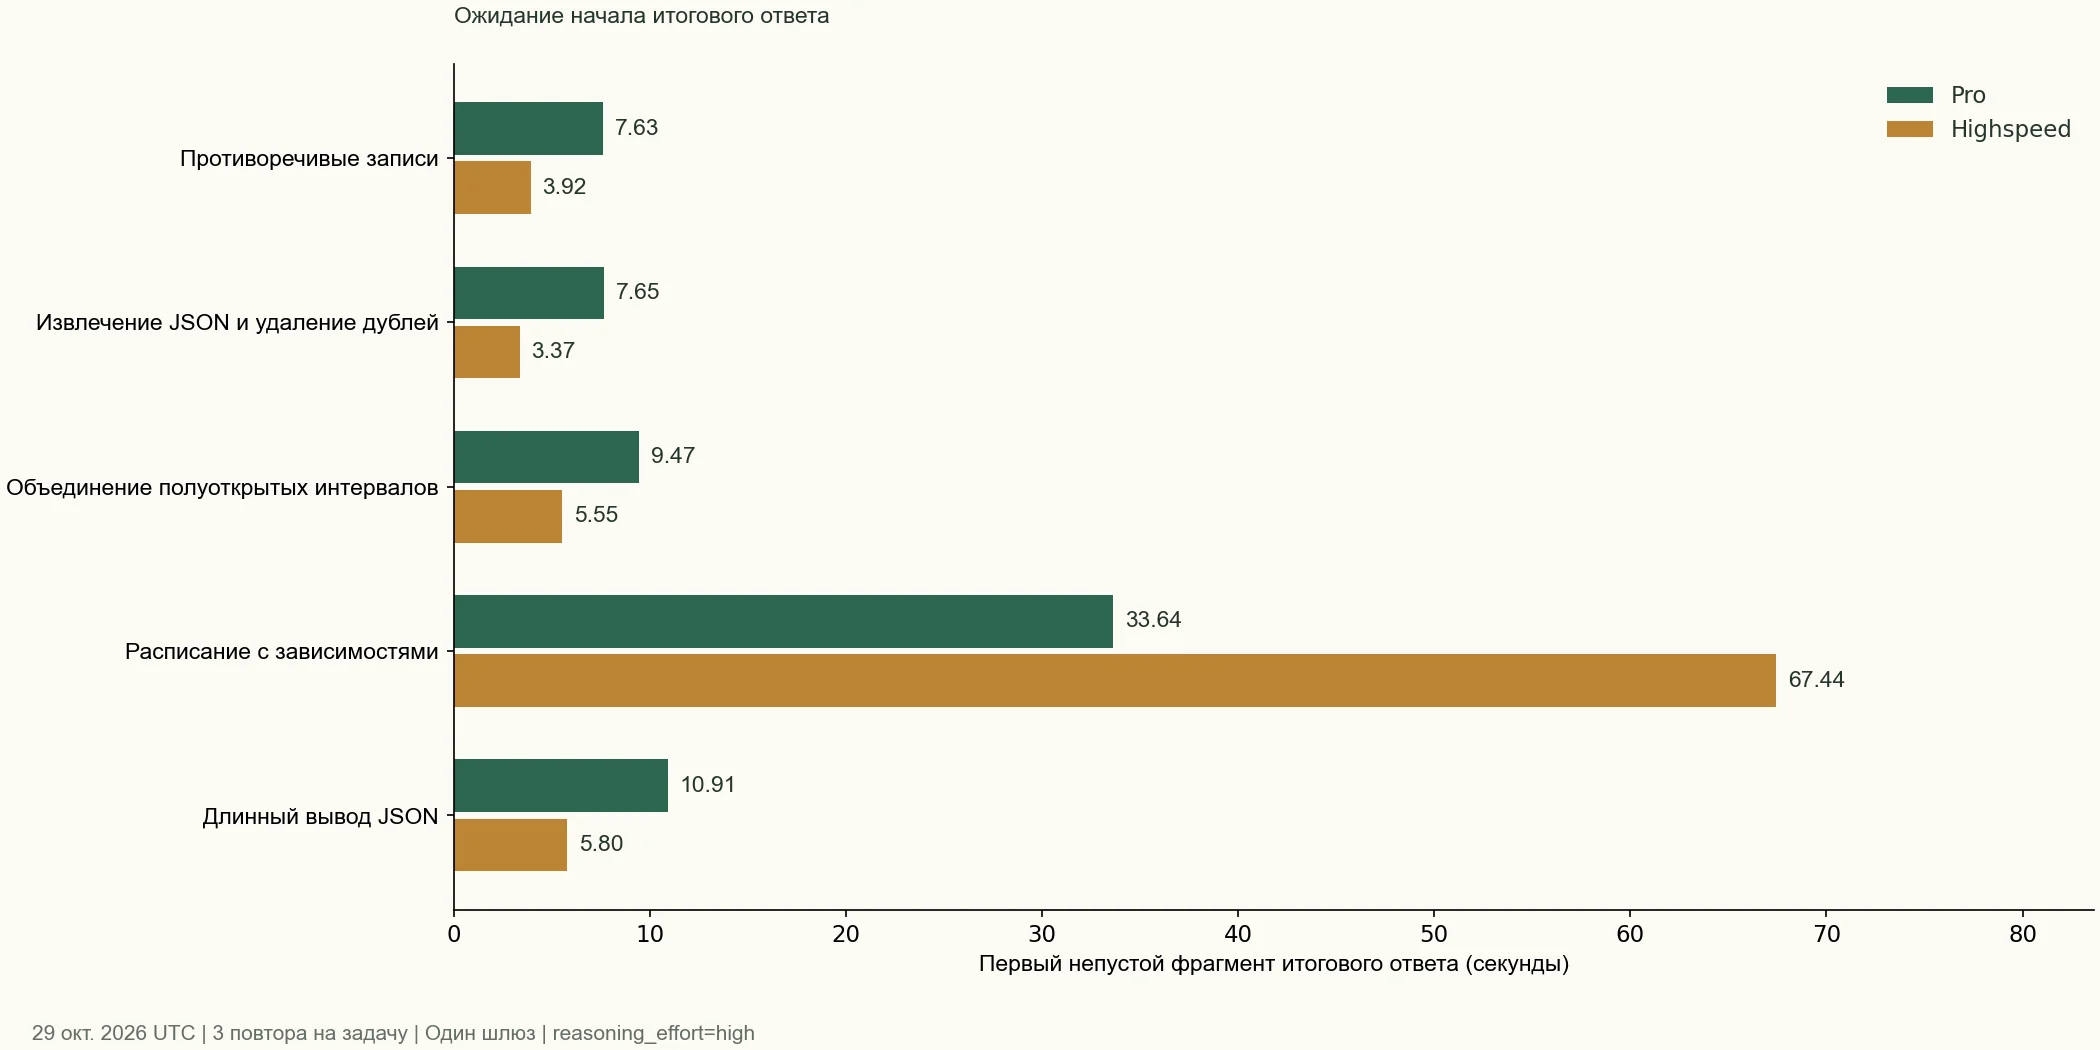
Планирование лучше всего показывает это различие: медиана первого события рассуждения или ответа у Highspeed составила около 2.17 секунды, но финальный ответ начал появляться только через 67.44 секунды. Для Pro соответствующие значения — 3.96 секунды и 33.64 секунды.
Если интерфейс показывает только финальный ответ, пользователь ждёт именно второй срок. Даже если интерфейс показывает «модель размышляет», самый ранний фрагмент рассуждения нельзя считать готовым прикладным результатом. В этой серии полный текст рассуждений не сохранялся и не публиковался; записывались только соответствующие счётчики и время.
Сравнение цен: обычный ввод и вывод вдвое дороже за единицу, чтение кэша стоит столько же#
Ниже приведены публичные расценки Crazyrouter с множителем 1 для группы default, полученные 29 октября 2026 года. Все значения указаны в долларах США за миллион токенов; это прейскурант шлюза, который нельзя выдавать за официальные цены прямого подключения к Moonshot. [4]
| Тарифицируемая операция | kimi-k3.1-pro | kimi-k3.1-pro-highspeed |
|---|---|---|
| Обычный ввод | $2.00 | $4.00 |
| Вывод | $10.00 | $20.00 |
| Чтение кэша | $0.20 | $0.20 |
| Запись в кэш, 5 минут | $2.00 | $4.00 |
| Запись в кэш, 1 час | $4.00 | $8.00 |
Расценки получены из tiered_expr интерфейса цен и сверены с реализацией тарификации в репозитории. Мы не пытались определить цену за единицу по одинаковому у обеих моделей полю совместимости model_ratio. В доступном для чтения тексте официальной страницы тарификации Kimi на этот раз не было проверяемой таблицы цен по конкретным моделям, поэтому мы не дополняем статью предполагаемыми «официальными ценами».
Предположим, запрос полностью обходится без кэша и содержит по 1,000 токенов обычного ввода и тарифицируемого вывода. По таблице Pro обойдётся примерно в 0.024. Но это сравнение при одинаковом расходе токенов; фактический объём рассуждений, попадания в кэш и правила аккаунта изменят счёт.
Первый раунд планирования даёт более полезный пример: prompt_tokens у обеих моделей равен 225, чтение или запись кэша не зафиксированы, а completion_tokens составили 1,097 и 4,178 соответственно. По приведённому прейскуранту теоретическая стоимость составляет примерно 0.08446, то есть различается примерно в 7.40 раза. Это оценка по расходу ответа и прейскуранту, а не подтверждённое списание средств с аккаунта.
Следовательно, «цена Highspeed за единицу вдвое выше» не означает «общая стоимость каждого запроса всегда ровно вдвое выше». В частности, нельзя оценивать стоимость только по объёму короткого финального JSON: в этой серии completion_tokens включает reasoning-токены.
Перед выбором можно проверить текущее сравнение цен на модели и страницу подключения серии Moonshot. Эти страницы дают точки входа для запросов, а числа в статье основаны на сохранённом снимке интерфейса цен для этой серии.
Как переключиться в API? Сохраните параметры и отдельно проверяйте финальные результаты#
В одиночных текстовых запросах этой серии клиенту достаточно было изменить model, чтобы сравнить обе модели через один и тот же интерфейс. Мы использовали reasoning_effort на верхнем уровне, опускали настройки sampling вроде temperature и top_p и не передавали конфигурацию thinking серии K2.
Полный пример на Python ниже был запущен и проверен отдельно для каждой модели; обе вернули {"answer":391}, статус stop, и был получен маркер завершения потока. Эти два вызова — независимые примеры подключения и не входят в описанные выше 30 оценочных вызовов. В соответствии с языковыми требованиями статьи та же задача на умножение в коде ниже сформулирована по-английски и отдельно проверена; это не дословное воспроизведение исходного китайского промпта. Перед запуском установите requests и передайте учётные данные через переменную окружения CRAZYROUTER_API_KEY.
Английский промпт в примере отдельно проверен на обеих моделях. Он задаёт ту же задачу на умножение, что и китайский оригинал, но другими словами. Эти две проверки не входят в 30 запросов теста и не воспроизводят исходный промпт дословно.
"""Endpoint smoke example; set CRAZYROUTER_API_KEY. Separate from 30 benchmark calls."""
import json
import os
import time
import requests

BASE_URL = 'https://cn.crazyrouter.com/v1'
PROMPT = 'Output only a JSON object with the key answer and the integer result of 17 multiplied by 23. No Markdown or explanation.'

def main():
    session = requests.Session()
    session.trust_env = False
    for model in ('kimi-k3.1-pro', 'kimi-k3.1-pro-highspeed'):
        started = time.perf_counter()
        response = session.post(
            BASE_URL + '/chat/completions',
            headers={'Authorization': 'Bearer ' + os.environ['CRAZYROUTER_API_KEY']},
            json={
                'model': model,
                'messages': [{'role': 'user', 'content': PROMPT}],
                'reasoning_effort': 'high',
                'max_tokens': 8192,
                'stream': True,
                'stream_options': {'include_usage': True},
            },
            timeout=(15, 180),
            stream=True,
        )
        response.raise_for_status()
        content, finish_reason, response_id, done = '', None, None, False
        for line in response.iter_lines(chunk_size=1):
            if not line.startswith(b'data:'):
                continue
            raw = line[5:].strip()
            if raw == b'[DONE]':
                done = True
                break
            event = json.loads(raw)
            if event.get('error'):
                raise RuntimeError(event['error'])
            response_id = event.get('id', response_id)
            for choice in event.get('choices', []):
                content += (choice.get('delta') or {}).get('content') or ''
                finish_reason = choice.get('finish_reason') or finish_reason
        response.close()
        assert done and finish_reason == 'stop' and json.loads(content) == {'answer': 391}
        print(json.dumps({'model': model, 'id': response_id, 'finish_reason': finish_reason,
                          'content': content, 'seconds': round(time.perf_counter()-started, 3)},
                         ensure_ascii=False))

if __name__ == '__main__':
    main()
ID ответов для примеров этой серии — 12818d48-89e1-4c2e-b7c8-aeeec5a1bbfa и 8f7e5a17-cc9b-495f-bee6-9e00110f6bee. Повторный запуск создаст новые ID ответов; пробелы в выводе и затраченное время также могут отличаться.
Пример предназначен для проверки ID моделей, разбора потока и финального содержимого. Полная оценка также записывает usage, время первого фрагмента содержимого, парные раунды и обоснование решения; эту простую задачу на умножение нельзя использовать как оценку возможностей моделей.
Многоходовые диалоги требуют дополнительной обработки истории сообщений. Официальные требования предписывают возвращать полное assistant-сообщение и его reasoning_content без изменений; в статье проверен только одноходовый текст, а многоходовые вызовы инструментов не проверялись. При подключении существующего клиента начните с руководства по интеграции и сверьте ID с актуальным списком моделей аккаунта. Не угадывайте параметры интерфейса только по отображаемым именам из каталога моделей.
Для каких задач стоит перейти на Highspeed, а где можно оставить Pro?#
| Ваш сценарий | Выбор, который позволяют сделать данные этой серии |
|---|---|
| Структурированное извлечение и сверка полей, во время которых пользователь ждёт | В первую очередь включите Highspeed в список кандидатов; медианное ожидание в этой серии заметно сократилось, но качество на прикладных образцах всё равно нужно проверять |
| JSON с чёткими правилами и длинным выводом | Highspeed стоит протестировать; полный вывод 80 элементов в этой серии ускорился примерно в 2.18 раза |
| Генерация небольших функций с автоматическими тестами | Стоит сохранить обе модели; сначала добейтесь прохождения тестов, затем сравнивайте ожидание и стоимость |
| Автономные задачи, для которых текущий Pro уже укладывается в сроки | Сначала сравните общую стоимость; более быстрое завершение не обязательно даёт дополнительную прикладную выгоду |
| Комбинаторное планирование, похожее на задачу этой серии | Пока оставьте Pro; во всех трёх парах по этой задаче Highspeed был медленнее, после чего расширьте набор задач для подтверждения |
| Длинный контекст, мультимодальность, агенты с инструментами или высокая конкурентность | Эта серия их не охватывала; создайте соответствующие тесты и не переносите результаты статьи напрямую |
Для существующего приложения надёжнее сохранить конфигурации обеих моделей и сравнить их на выборке реальных задач. Сначала задайте минимальную точность, допустимое ожидание и стоимость одной задачи, а затем решайте, стоит ли переключать определённый тип запросов на Highspeed. Для наблюдения за хвостовой задержкой нужно увеличить выборку: трёх вызовов на задачу недостаточно, чтобы сообщать репрезентативный P95.
FAQ#
kimi-k3.1-pro vs kimi-k3.1-pro-highspeed: какая модель лучше?#
Зависит от вашего бюджета ожидания и задач. В этой серии каждая модель прошла 15/15; у Highspeed меньше медианное время в четырёх задачах, но в планировании он медленнее и генерирует больше выходных токенов. Универсального победителя для всех задач нет.
Highspeed всегда быстрее в 2–3 раза?#
Это не гарантия для каждого запроса. Официально заявлено ускорение в 2–3 раза; в этой серии Highspeed оказался быстрее в 11 из 15 пар, а первая проверка записей и три запуска планирования стали контрпримерами.
Highspeed снижает качество ответов?#
Проверки этой серии не выявили снижения качества: все 15 запусков каждой модели прошли. Однако тестировались только пять ограниченных задач, без субъективного письма, больших репозиториев кода и продолжительных процессов агентов, поэтому одинаковое качество во всех сценариях гарантировать нельзя.
Используют ли обе модели одни и те же веса?#
В статье недостаточно данных для подтверждения. Официально указано, что обе модели имеют одинаковые ограничения параметров серии K3, а Highspeed позиционируется по скорости; совпадение параметров не означает, что мы проверили веса или детали развёртывания.
Одинаковы ли у моделей контекст и уровни рассуждения?#
Согласно официальным параметрам и описанию тарификации, у обеих контекст составляет 1,048,576 токенов, поддерживаются low, high, max, а по умолчанию используется max. В этой серии тестировались только короткие тексты и уровень high; сценарий с миллионом токенов не проверялся.
Насколько дороже Highspeed?#
В расценках группы default Crazyrouter для этой серии обычный ввод и вывод вдвое дороже, чем у Pro, а цена чтения кэша одинакова. Общая стоимость запроса также зависит от фактических выходных и reasoning-токенов, кэша и правил аккаунта, поэтому нельзя просто умножать её на два.
Почему приходится долго ждать, если потоковое содержимое уже появилось?#
Самое раннее содержимое может относиться к reasoning_content, тогда как финальный ответ начинается в content. В задаче планирования этой серии Highspeed начал передавать непустые события рассуждения или ответа примерно через 2.17 секунды, но медиана начала ответа составила 67.44 секунды.
Можно ли считать эти скорости показателями официального API Moonshot?#
Нет. Здесь измерялся полный путь от указанного клиента до шлюза Crazyrouter, включая влияние сетевого маршрута и вышестоящей инфраструктуры; парного контрольного сравнения с прямым подключением к производителю не проводилось.
Рекомендации по выбору#
Плата за Highspeed должна давать поддающееся проверке сокращение ожидания в ваших задачах. В этой серии обработка полей, короткий код и длинный вывод JSON дали положительные результаты; задача планирования показала, что более раннее начало генерации, больше reasoning-токенов и более позднее завершение ответа могут происходить одновременно.
Если в вашем приложении уже есть стабильная конфигурация Pro, одновременно проверяйте на производственных задачах точность, время начала ответа, полное время выполнения и расход токенов. Переключайте категории запросов по очереди только после того, как Highspeed достигнет ваших целей по срокам и стоимости.
Источники и приложения с результатами измерений#
Источники#
- Kimi, официально: примечания к выпуску K3.1 Pro, прочитано 2026-10-29; показатели скорости являются заявлением производителя.
- Kimi, официально: сравнение параметров моделей, прочитано 2026-10-29; в этой серии проверялись только одноходовые текстовые запросы на уровне high.
- Kimi, официально: описание тарификации моделей, использовано для проверки контекста и концепций тарификации, а не как источник цен на конкретные модели в этой статье.
GET https://crazyrouter.com/api/pricing, снимок 2026-10-29 UTC; режим тарификации —tiered_expr, конкретные выражения и исходный снимок архивированы редакцией.
Результаты отдельных запросов#
Все 30 запросов вернули HTTP 200, завершились с stop, выдали [DONE] и прошли проверки. Pro и Highspeed обозначают указанные выше точные идентификаторы моделей. Токены вывода включают токены рассуждения. Повторы нумеруются с 1.
| Задача | Модель | Повтор | Полное время (с) | Начало ответа (с) | Токены вывода | Токены рассуждения |
|---|---|---|---|---|---|---|
| Противоречивые записи | Pro | 1 | 5.32 | 5.03 | 151 | 113 |
| Противоречивые записи | Highspeed | 1 | 6.35 | 6.22 | 172 | 134 |
| Противоречивые записи | Pro | 2 | 9.89 | 8.67 | 342 | 304 |
| Противоречивые записи | Highspeed | 2 | 3.46 | 3.28 | 104 | 66 |
| Противоречивые записи | Pro | 3 | 8.06 | 7.63 | 303 | 265 |
| Противоречивые записи | Highspeed | 3 | 3.93 | 3.92 | 191 | 153 |
| Извлечение JSON и удаление дублей | Pro | 1 | 8.51 | 7.65 | 300 | 235 |
| Извлечение JSON и удаление дублей | Highspeed | 1 | 2.70 | 2.44 | 153 | 88 |
| Извлечение JSON и удаление дублей | Pro | 2 | 7.32 | 6.37 | 159 | 94 |
| Извлечение JSON и удаление дублей | Highspeed | 2 | 3.77 | 3.43 | 162 | 97 |
| Извлечение JSON и удаление дублей | Pro | 3 | 8.91 | 8.24 | 250 | 185 |
| Извлечение JSON и удаление дублей | Highspeed | 3 | 3.70 | 3.37 | 190 | 125 |
| Объединение полуоткрытых интервалов | Pro | 1 | 9.59 | 7.67 | 359 | 227 |
| Объединение полуоткрытых интервалов | Highspeed | 1 | 9.14 | 8.32 | 514 | 384 |
| Объединение полуоткрытых интервалов | Pro | 2 | 12.37 | 10.64 | 369 | 237 |
| Объединение полуоткрытых интервалов | Highspeed | 2 | 6.21 | 5.55 | 377 | 247 |
| Объединение полуоткрытых интервалов | Pro | 3 | 11.03 | 9.47 | 334 | 209 |
| Объединение полуоткрытых интервалов | Highspeed | 3 | 5.72 | 4.98 | 309 | 161 |
| Расписание с зависимостями | Pro | 1 | 39.82 | 39.60 | 1097 | 1071 |
| Расписание с зависимостями | Highspeed | 1 | 67.59 | 67.44 | 4178 | 4152 |
| Расписание с зависимостями | Pro | 2 | 30.16 | 29.96 | 810 | 784 |
| Расписание с зависимостями | Highspeed | 2 | 121.22 | 121.06 | 6704 | 6678 |
| Расписание с зависимостями | Pro | 3 | 33.88 | 33.64 | 980 | 954 |
| Расписание с зависимостями | Highspeed | 3 | 38.44 | 38.34 | 2620 | 2594 |
| Длинный вывод JSON | Pro | 1 | 23.35 | 12.80 | 1214 | 509 |
| Длинный вывод JSON | Highspeed | 1 | 9.82 | 5.80 | 1180 | 475 |
| Длинный вывод JSON | Pro | 2 | 21.43 | 10.91 | 1121 | 416 |
| Длинный вывод JSON | Highspeed | 2 | 10.47 | 5.91 | 1174 | 469 |
| Длинный вывод JSON | Pro | 3 | 21.26 | 10.83 | 1127 | 422 |
| Длинный вывод JSON | Highspeed | 3 | 9.32 | 5.34 | 1148 | 443 |
Редакция хранит исходные китайские промпты, эталонные и итоговые ответы, идентификаторы, код проверки и снимок цен. На странице приведены показатели всех 30 запросов и исполняемый пример подключения. Полный архив не предлагается для скачивания; полный текст рассуждений не публикуется.