简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
Claude Opus 5.5 vs GPT-6.1 Sol: тесты, цены и выбор модели
Сравнение официальных тестов и цен API Claude Opus 5.5 и GPT-6.1 Sol. Данные производителей отделены от 16 запросов Crazyrouter; теста Opus на тех же задачах нет.
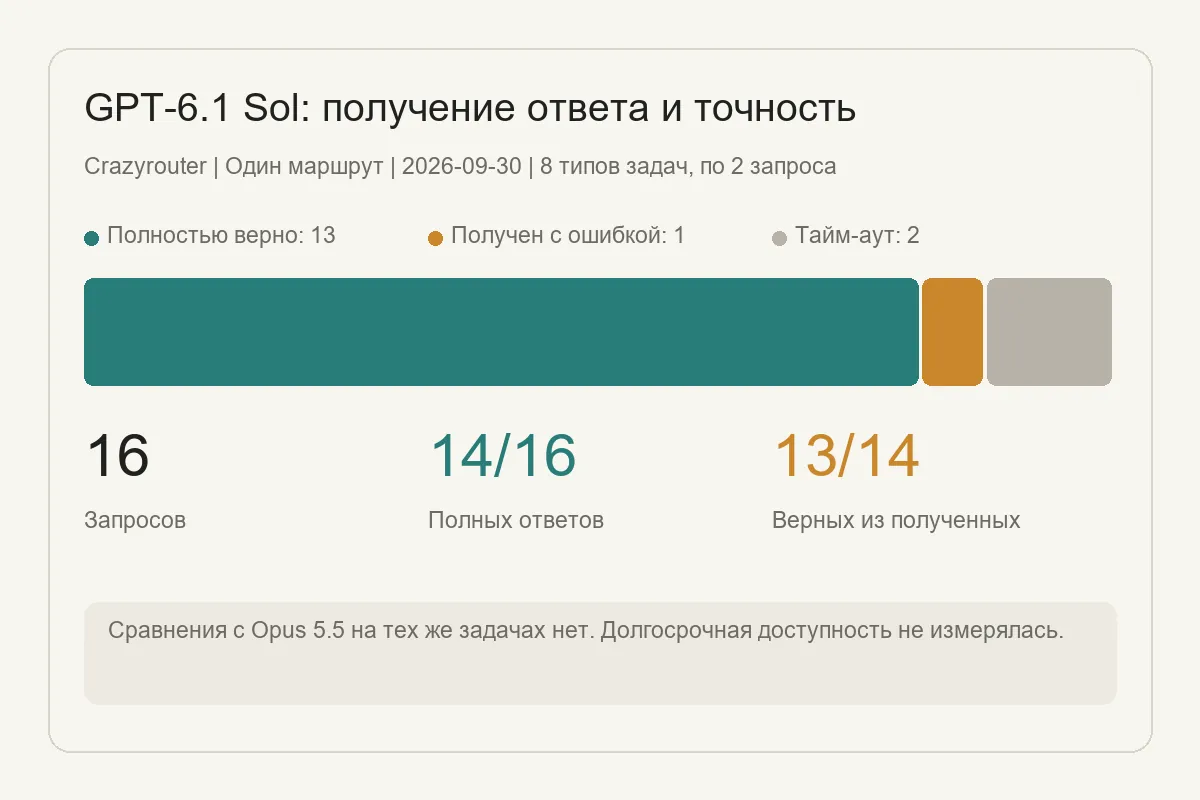
По состоянию на 30 октября 2026 года открытых данных недостаточно, чтобы определить единый рейтинг Claude Opus 5.5 и GPT-6.1 Sol для всех задач. В 16 запросах с задачами к GPT-6.1 Sol через фиксированный канал Crazyrouter зафиксировал 14 полных ответов, из которых 13/14 были полностью правильными; поскольку выборки Opus 5.5 на тех же задачах нет, эти локальные данные не позволяют определить победителя. В официальных материалах OpenAI также утверждается, что на среднем уровне рассуждений GPT-6.1 Sol опережает Opus 5.5 в AutomationBench на 2.2 процентного пункта при стоимости задачи примерно в три раза ниже; Opus 5.5, в свою очередь, демонстрирует высокий потолок возможностей в другой группе тестов по программированию и науке на высоком уровне рассуждений. Эти оценки производителей нельзя считать независимым сравнением в одной лаборатории с одинаковой конфигурацией.
Если для вас важна длительная многошаговая работа программного агента, стоит в первую очередь включить в список кандидатов Opus 5.5; если повседневных задач много и вы хотите контролировать расходы на API, разумнее сначала протестировать GPT-6.1 Sol. Окончательный выбор должен зависеть от доли успешно решенных ваших задач, числа доработок и общего счета, а не только от места в отдельном рейтинге.
Claude Opus 5.5 vs GPT-6.1 Sol: какая модель лучше подходит для повседневной работы?#
Целевые области двух моделей пересекаются, но открытые данные указывают на разные акценты: Opus 5.5 выделяется в опубликованных Anthropic тестах сложного программирования, управления рабочим столом и интеллектуального труда; OpenAI подчеркивает экономическую эффективность GPT-6.1 Sol при работе с профессиональными документами, бизнес-процессами и научными исследованиями. Открытые данные позволяют выбирать модель под нагрузку, но не дают оснований переносить лидерство одного производителя в отдельном тесте на все задачи.
Краткое сравнение#
| Параметр | Claude Opus 5.5 | GPT-6.1 Sol | Что учитывать при интерпретации |
|---|---|---|---|
| Официальное имя модели в API | claude-opus-5-5 | gpt-6.1-sol | При использовании стороннего шлюза ориентируйтесь на его актуальный ответ /v1/models и документацию |
| Стандартная цена официального API за миллион токенов | Ввод 20; чтение кэша $0.20 | Ввод 10; кэшированный ввод $0.10 | Стандартные цены GPT-6.1 Sol на ввод, вывод и кэшированный ввод примерно вдвое ниже, чем у Opus 5.5; фактический счет также зависит от кэша, инструментов и длины вывода |
| Контекстное окно API | 1,000,000 токенов | 1,050,000 токенов | Фактически доступное окно также зависит от продукта, интерфейса и конфигурации запроса |
| Уровень рассуждений по умолчанию | medium; adaptive thinking всегда включен | medium | Одинаковые названия уровней не гарантируют одинаковый бюджет рассуждений или объем вычислений |
| Подмножество Anthropic SWE-bench Pro | medium: 92.8% решенных задач, $0.22 / решенную задачу | Публичного сравнения на том же подмножестве нет | Исходное совместимое подмножество содержит 482 задачи; два запуска Opus 5.5 оценивались по 478 задачам, это не результат публичного рейтинга |
| AutomationBench | Anthropic публикует 40.0%; в этом запуске fallback не использовался | По утверждению OpenAI, на среднем уровне рассуждений результат выше на 2.2 процентного пункта, стоимость задачи примерно втрое ниже | На странице Anthropic также указано, что результат Opus 5.5 получен в ранних тестах Zapier; использование fallback и условия запусков в разных отчетах нужно рассматривать отдельно |
| Профессиональные документы GDP.pdf | Согласно сравнению OpenAI, GPT-6.1 Sol превосходит Opus 5.5 с fallback на всех протестированных уровнях рассуждений при стоимости задачи менее половины | Результаты, заявленные самой OpenAI в материалах выпуска | В опубликованном тексте нет полных оценок этого сравнения; из него нельзя заключить, что GPT-6.1 Sol побеждает во всех задачах с PDF или интеллектуальной работой |
| Terminal-Bench 4.0 | Anthropic сообщает 66.4% при xhigh effort | В таблице Anthropic GPT-6.1 Sol не указан | Модель GPT для сравнения в этой таблице — GPT-6 Astra, а не GPT-6.1 Sol |
| Terminal-Bench Science 0.1 | Anthropic сообщает 58.7%; стандартная ошибка составляет ±3.5–5 процентных пунктов | OpenAI сообщает среднюю стоимость задачи 23.21 у Opus 5.5; точная оценка GPT-6.1 Sol в основном тексте публикации не указана | Доля успешно решенных задач и стоимость задачи — разные показатели; низкую стоимость нельзя напрямую представлять как более высокую точность |
| Небольшая локальная выборка Crazyrouter | Результатов Opus 5.5 на тех же задачах нет | 14 полных ответов на 16 запросов; 13/14 полученных ответов верны, еще 2 запроса завершились тайм-аутом | Отдельная запись рабочей нагрузки через фиксированный канал от 2026-09-30, а не сравнение с Opus и не показатель долгосрочной доступности |
Официальные тесты показывают разные преимущества#
Бизнес-процессы: у GPT-6.1 Sol отчетливее заявлено преимущество по стоимости#
В материалах выпуска от 29 сентября 2026 года OpenAI утверждает, что на среднем уровне рассуждений GPT-6.1 Sol опережает Opus 5.5 в AutomationBench на 2.2 процентного пункта при стоимости задачи примерно втрое ниже. AutomationBench проверяет выполнение агентами сквозных процессов с использованием 47 инструментов в продажах, маркетинге, операционной деятельности, поддержке клиентов, финансах и управлении персоналом.
На странице Opus 5.5 Anthropic указывает результат AutomationBench 40.0% и прямо поясняет, что в этом запуске fallback не использовался; GPT-6 Astra в той же таблице имеет 41.4%. Поэтому при цитировании прямого сравнения OpenAI необходимо сохранять указание, что это сравнительный результат из материалов OpenAI; нельзя объединять числа с двух страниц в независимый эксперимент с полностью одинаковыми контролируемыми условиями. Fallback влияет на долю завершенных задач и стоимость, а также на результат, который фактически получает пользователь.
Программирование: сильные опубликованные результаты Opus 5.5 на высоком уровне, меньше прямых оценок GPT-6.1 Sol#
Anthropic публикует результат Opus 5.5 в Terminal-Bench 4.0 — 66.4%, полученный на уровне рассуждений xhigh; на той же странице указан результат GPT-6 Astra 57.9%, но нет результата GPT-6.1 Sol в этом тесте. Anthropic также публикует оценку Opus 5.5 на основном наборе FrontierCode v1.1 — 54.4%, выше указанных в таблице 53.3% у GPT-6 Astra. Эти числа показывают конкурентоспособность Opus 5.5 в перечисленных тестах программных агентов, но не доказывают, что она обязательно превосходит GPT-6.1 Sol: сравниваемые модели, уровни рассуждений и условия оценки не полностью совпадают.
В руководстве Anthropic по стоимости моделей также опубликован другой, более новый набор данных по программированию: совместимое подмножество SWE-bench Pro изначально включало 482 задачи; из-за проблем с контейнером оценки два запуска Opus 5.5 на medium оценивались по оставшимся 478 задачам. Доля решенных задач составила 92.8%, стоимость одной решенной задачи — около $0.22. Anthropic прямо отмечает, что это подмножество и условия запуска отличаются от публичного рейтинга SWE-bench Pro и результатов в system card Opus 5.5. OpenAI не публиковала сравнительную оценку GPT-6.1 Sol на том же подмножестве, поэтому эти числа лишь дополняют базовые данные о качестве и стоимости самой Opus 5.5.
Заявления OpenAI о GPT-6.1 Sol сосредоточены на DeepSWE v1.1: компания утверждает, что уже на более низком уровне рассуждений GPT-6.1 Sol превосходит максимальный результат GPT-6 Sol на 6.4 процентного пункта и сопоставима с GPT-6 Astra при стоимости задачи примерно в пять раз ниже. Этот результат свидетельствует об улучшении GPT-6.1 Sol относительно предыдущего поколения Sol, а не является сравнительной оценкой с Opus 5.5.
Профессиональные документы и научные задачи: учитывайте стоимость выполнения и наличие оценок#
OpenAI утверждает, что GPT-6.1 Sol превосходит «Opus 5.5 с fallback» в GDP.pdf на всех протестированных уровнях рассуждений при стоимости задачи менее половины. GDP.pdf требует от моделей отвечать на профессиональные вопросы по сложным PDF с таблицами, графиками, схемами и подробными условиями. Поскольку основной текст публикации не содержит одновременно полных оценок по уровням, деталей работы fallback и общего протокола оценки, этот вывод подходит как ориентир при выборе, но не должен превращаться в безусловный вердикт о победителе.
В Terminal-Bench Science 0.1 OpenAI сообщает среднюю стоимость задачи GPT-6.1 Sol на максимальном уровне рассуждений 23.21 у Opus 5.5. Anthropic сообщает результат Opus 5.5 58.7% и указывает стандартную ошибку ±3.5–5 процентных пунктов; однако в основном тексте публикации OpenAI точная оценка GPT-6.1 Sol не приведена. Таким образом, опубликованную информацию о стоимости сравнивать можно, но этих двух утверждений недостаточно, чтобы определить, у какой модели выше доля успешно выполненных научных задач.
Насколько различаются цены API?#
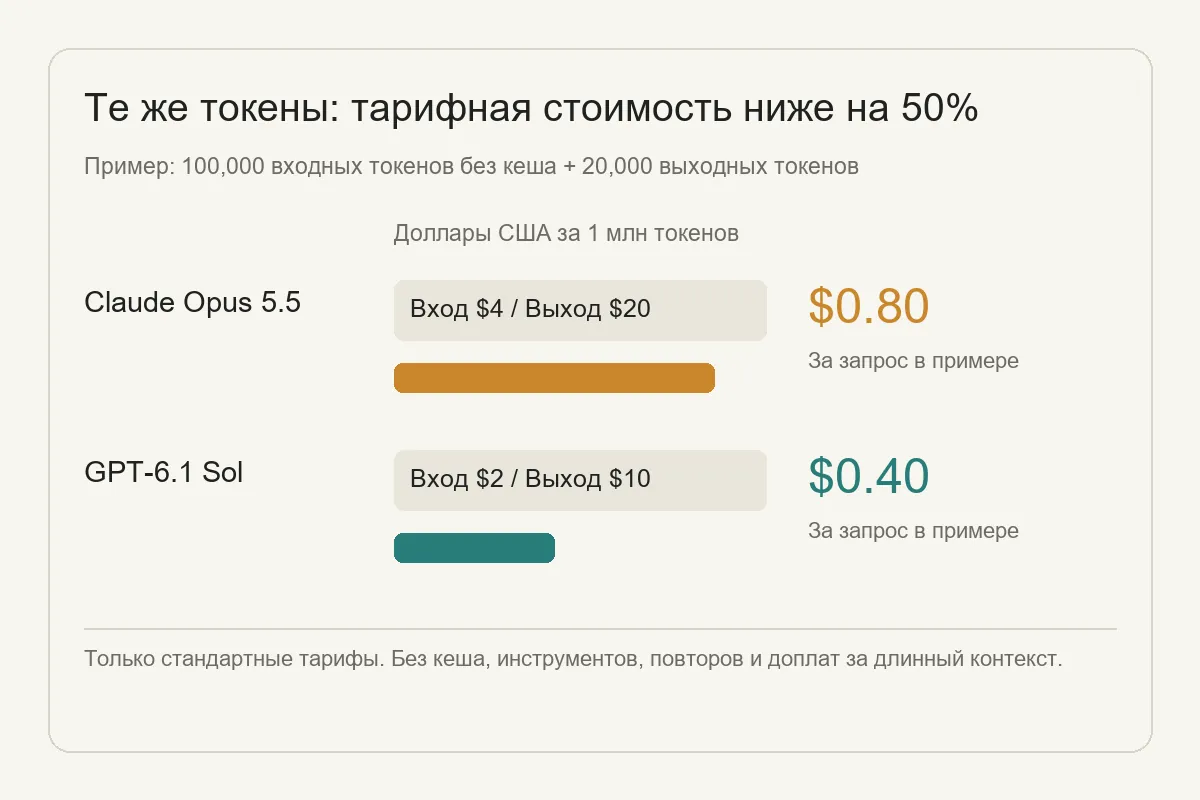
Согласно стандартным ценам API на официальных страницах обеих компаний, Opus 5.5 стоит 20 за миллион выходных; GPT-6.1 Sol — 10 соответственно. Если один запрос использует 100,000 некэшированных входных токенов и 20,000 выходных, расчет по стандартным ценам будет следующим:
input_tokens = 100_000
output_tokens = 20_000

opus55 = input_tokens / 1_000_000 * 4 + output_tokens / 1_000_000 * 20
gpt61 = input_tokens / 1_000_000 * 2 + output_tokens / 1_000_000 * 10

print(f"Opus 5.5: ${opus55:.2f}")
print(f"GPT-6.1 Sol: ${gpt61:.2f}")
В этом примере получаются 0.40 для GPT-6.1 Sol. Сравниваются только цены некэшированных текстовых токенов, без повторных попыток, вызовов инструментов, надбавок за длинный контекст, стратегии кэширования и скидок других платформ размещения. Согласно официальной документации по ценам, если вход API-запроса GPT-6.1 Sol превышает 272,000 токенов, этот запрос тарифицируется по повышенным расценкам для длинного контекста; официальная документация Opus 5.5 указывает стандартную тарификацию для ее контекстного окна 1M. Учет токенов, затраты на рассуждения и конфигурации продуктов Anthropic и OpenAI также могут различаться, поэтому «цена вдвое ниже» не означает, что «общий счет за одинаковый процесс обязательно будет вдвое меньше».
Перед использованием можно посмотреть модели и способы подключения по производителям, а также сравнение цен моделей. Для проверки каталога поставщиков также доступны каталог моделей Anthropic и каталог моделей OpenAI. Скидки и настройки тарификации на разных платформах могут отличаться от стандартных цен производителей.
Что показывают записи Crazyrouter по GPT-6.1 Sol?#
В ходе локального тестирования рабочей нагрузки разработки 30 сентября 2026 года GPT-6.1 Sol использовалась через фиксированный канал с reasoning_effort=high и max_completion_tokens=8192. Для каждой из 8 категорий задач было отправлено по два независимых запроса, всего 16: в 14/16 случаях получен полный ответ, причем 13 полученных ответов были полностью правильными; еще в двух случаях полный ответ не поступил за 240 секунд ожидания. Основная серия включала скрытые проверки для двух задач по программированию; отдельно был выполнен один моделируемый процесс работы с инструментами, не входящий в указанные 16 основных запросов. Такие результаты на небольшой выборке не заменяют длительное тестирование разработки в репозитории.
В этой серии Claude Opus 5.5 не тестировалась на том же наборе задач. Поэтому она показывает, как GPT-6.1 Sol справлялась с выдачей результатов в данной выборке, но не позволяет утверждать, что GPT-6.1 Sol точнее, быстрее или стабильнее Opus 5.5. По сравнению с официальными тестами ценность этой серии — в дополнительной небольшой выборке через реальный шлюз и напоминании учитывать тайм-ауты при оценке получения результатов пользователем.
Эти записи и опубликованные производителями карточки моделей относятся к разным типам свидетельств. Если вы планируете подключить модель к программному агенту, можно сначала изучить руководство по подключению Claude Code и руководство по подключению Codex, а затем составить приемочный набор задач из собственного репозитория.
Запросы и сбои в локальных записях#
В этой серии использовались Base URL https://api.crazyrouter.com/v1, конечная точка POST /chat/completions и модель gpt-6.1-sol. Запросы содержали messages (фиксированный системный промпт и пользовательский промпт одной и той же задачи), reasoning_effort="high", max_completion_tokens=8192; temperature не передавался. Это исторические записи от 2026-09-30, а не повторная проверка доступности в день публикации статьи.
| Пункт | Проверяемый результат |
|---|---|
| Получение результатов | На 14/16 запросов получены полные результаты; из них 13/14 ответов полностью правильные |
| Полученный, но неверный ответ | В одном подсчете правил указано 71 вместо фактических 72 |
| Результат не получен | По одному тайм-ауту после 240 секунд ожидания в поиске по длинному набору правил и выборе оптимального набора с ограничениями; неудачи не заменялись успешными повторными попытками |
| Пример задачи | Дедупликация платежных событий: глобально удалить дубликаты по ID события, сохранить 10 <= ts < 20, исключить внутренних пользователей, вычислить чистую сумму |
| Итоговый статус запроса из примера | HTTP 200, finish_reason=stop, ответ прошел сверку с локальным эталоном |
ID ответа из примера: resp_0a6633bd82c5ee75016abd0e0e8b9887d29ef32e920c8843ba; ID запроса: 202609301326374284700288BdKuu3w. В примере использованы синтетические тестовые данные; полученный итоговый ответ приведен ниже:
{"net_cents_by_user":{"alice":-173,"bob":88},"included_unique_events":12}
Тайм-аут означает лишь то, что клиент не получил полный результат за установленное время ожидания; он не доказывает, что модель не способна решить задачу или что вышестоящий запрос уже отменен. В выборке не измерялись долгосрочная доступность и задержка до первого токена у двух моделей.
Как выбирать: создайте собственный приемочный набор задач#
- В первую очередь оцените Opus 5.5: для масштабных миграций кода, ревью нескольких репозиториев, длительной работы программных агентов и задач, где вы готовы платить более высокую стандартную цену токенов за возможности высокого уровня рассуждений.
- В первую очередь оцените GPT-6.1 Sol: для большого количества повторяющихся повседневных API-запросов, автоматизации бизнес-процессов, извлечения данных из сложных PDF и агентных задач, требующих контроля стоимости одной задачи.
- Проведите параллельный пробный запуск: если задача ценная, цена ошибки высока или результат напрямую используется в продакшене. Зафиксируйте версию модели, уровень рассуждений, инструменты, контекст и условия приемки, сохраняйте записи о тайм-аутах, fallback и повторных попытках.
Для начала рекомендуется составить небольшой приемочный набор из 20–50 реальных задач и для каждой фиксировать полноту результата, долю прохождения автоматических проверок, число ручных доработок, сквозное время выполнения и общую стоимость токенов. Сначала разделите задачи на программирование, документы и процессы с инструментами, а затем считайте результаты; единая итоговая оценка легко скрывает заметные слабости модели в отдельных подзадачах.
Частые вопросы#
Claude Opus 5.5 обязательно сильнее GPT-6.1 Sol?#
Так обобщать нельзя. Opus 5.5 показывает высокие результаты в опубликованных Anthropic тестах, включая Terminal-Bench 4.0; OpenAI, в свою очередь, утверждает, что GPT-6.1 Sol превосходит Opus 5.5 в определенных условиях GDP.pdf и AutomationBench. Организаторы тестов, уровни рассуждений, fallback и наборы задач различаются, поэтому выводы стоит проверять на собственных задачах.
Насколько GPT-6.1 Sol дешевле Opus 5.5?#
По официальным стандартным ценам API миллион входных токенов GPT-6.1 Sol стоит 10; для Opus 5.5 это 20. При одинаковом количестве некэшированных токенов цена примерно на 50% ниже. Фактический счет за задачу также зависит от длины вывода, кэша, повторных попыток и цен платформы.
Какая модель лучше подходит для написания кода?#
Opus 5.5 имеет сильные официально опубликованные результаты в Terminal-Bench 4.0 и FrontierCode; публичные материалы выпуска GPT-6.1 Sol делают акцент на DeepSWE — тесте длительных задач программной инженерии. Поскольку полного открытого сравнения обеих моделей в одной среде тестирования кода с одинаковым бюджетом рассуждений нет, надежнее пробовать их на задачах реального репозитория.
Проводилось ли для этой статьи локальное сравнение Opus 5.5 и GPT-6.1 Sol на одинаковых задачах?#
Нет. Статья ссылается на официальные материалы оценки обеих компаний и дополняет их записями 16 запросов Crazyrouter к GPT-6.1 Sol от 30 сентября 2026 года; в этой серии не было сравнения с Opus 5.5, поэтому ее нельзя называть локальным бенчмарком двух моделей.
На какие показатели смотреть при выборе модели?#
Как минимум одновременно учитывайте долю успешно решенных задач, долю полных результатов, тайм-ауты и fallback, ручные доработки, сквозное время выполнения и общую стоимость токенов. Для агентных процессов также проверяйте завершение вызовов инструментов, корректность обработки сбоев моделью и прохождение итоговым результатом автоматической приемки.
Вывод#
Открытые данные по Opus 5.5 и GPT-6.1 Sol отражают компромиссы для разных задач: результаты Opus 5.5 на высоких уровнях в программировании и науке привлекательны, стандартные цены токенов GPT-6.1 Sol ниже, а OpenAI сообщает о более выгодной стоимости выполнения задач в некоторых бизнес-тестах. Если главное ограничение — стоимость, сначала попробуйте GPT-6.1 Sol; если важнее потолок качества в сложных длительных задачах, включите Opus 5.5 в приемочные испытания на тех же задачах. До тестирования обеих моделей в одинаковых условиях не объединяйте тесты производителей в единый рейтинг с абсолютным победителем.
Источники и условия тестирования#
- Anthropic, Представляем Claude Opus 5.5, 2026-09-22. Содержит официальные цены, данные Terminal-Bench, FrontierCode, AutomationBench и Terminal-Bench Science с пояснениями условий.
- OpenAI, Представляем GPT-6.1 Sol, 2026-09-29. Содержит сравнения GPT-6.1 Sol с Opus 5.5 в GDP.pdf, AutomationBench и Terminal-Bench Science, опубликованные разработчиком, а также цены API.
- Anthropic, Документация по модели Claude Opus 5.5 и ценам и руководство по оптимизации стоимости и возможностей. Включают ограничения модели, цены, методику и результаты исходного совместимого подмножества SWE-bench Pro из 482 задач.
- OpenAI, Документация модели GPT-6.1 Sol API. Включает контекстное окно API, предел вывода, стандартные цены и цены кэшированного ввода, а также порог тарификации длинного контекста.
- Crazyrouter, внутренний архив от 2026-09-30 «GPT-6 Sol и GPT-6.1 Sol в сравнении с GPT-5.6 Sol и GPT-6 Astra: практические тесты и выбор основной модели». В статье опубликованы краткое изложение результатов и один идентификатор ответа; полные запросы, скрипты оценки и ответы хранятся локально в редакции, онлайн-загрузка полного пакета доказательных материалов не предоставлена. Эта серия не содержит результатов Opus 5.5 на тех же задачах.
Статья не представляет заявленные производителями оценки как независимое воспроизведение и не сравнивает задержку до первого токена, долгосрочную надежность или общий рейтинг двух моделей в производственной среде. Официальные цены обеих компаний могут отличаться от фактических цен локального шлюза; перед запуском в эксплуатацию повторно проверьте актуальные тарифы.