简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
Пролог: насколько велика реальная дистанция между ИИ-моделями Китая и США?
Пролог серии: сравнение китайских и американских ИИ-моделей по данным на 2026-10-29 и 112 реальным API-вызовам.
Это русская версия того же исследования со срезом данных на 2026-10-29. Все 112 тестовых запросов использовали исходные промпты на китайском языке; новая многоязычная оценка не проводилась. Подписи на графиках даны на английском. Пример кода сохраняет исходный китайский промпт с помощью Unicode-последовательностей, которые декодируются при выполнении.
Серия о сравнении ИИ-моделей Китая и США · Пролог. Сначала мы выстроим методику сравнения на текстовых моделях, а затем отдельно исследуем изображения, видео, речь, векторный поиск и реранжирование. Эта статья — отправная точка для методики и вопросов; оценки текстовых моделей не отражают возможности других модальностей.
Американские модели лидируют на текущем передовом рубеже рейтинга и по глубине ведущей группы, однако утверждение, что «разрыв между моделями Китая и США постоянно увеличивается», не согласуется с результатами нашей ретроспективной оценки по единой шкале. Если использовать Opus 4.8 как референсный порог личной удовлетворенности, то в охваченной AA выборке Progress Index выше этого уровня оказался у 12 китайских и 21 американской версий релизов; это не означает, что каждая из них удобнее в любой задаче.
Дата среза данных — 2026-10-29. В статье мы разделяем три вопроса, которые легко перепутать: насколько различаются сильнейшие модели, сколько вариантов преодолело порог прежнего флагмана и какие различия ощущаются при реальных запросах. Для первых двух используются данные Artificial Analysis (AA), а третий исследуется через Crazyrouter: аудит 7 моделей, 8 задач, по 2 вызова на задачу — всего 112 вызовов.[1][2]
Это исследование выборки моделей. Оно не оценивает ИИ-отрасли двух стран в целом и не включает слепую субъективную оценку людьми; в конечном счете «пригодность к использованию» зависит от вашей задачи, допустимого времени ожидания и требований к устойчивости к ошибкам.
Сначала результаты: лидерство на передовом рубеже и повсеместная пригодность — разные вещи#
| Показатель / шкала | Китай | США |
|---|---|---|
| Текущий максимум · Intelligence v5 | 46.0 · Kimi K3.1 Pro | 59.4 · Gemini 4 Carbon |
| Среднее Top 5 · Intelligence v5 | 34.74 | 56.68 |
| Число версий в мировом Top 10 · Intelligence v5 | 1 | 9 |
| Текущий максимум · Progress v1 | 340.70 | 351.65 |
| Выше Opus 4.8 · Progress v1, включая исторические версии | 12 | 21 |
| Из них версии, не отмеченные AA как deprecated | 9 | 13 |
Значения двух индексов нельзя вычитать друг из друга или объединять в один рейтинг. Текущий разрыв на передовом рубеже v5 составляет 13.4 балла; текущий разрыв Progress v1 — 10.94 балла. Первый показатель измеряет результаты на текущем наборе оценок, второй служит для анализа изменения возможностей между периодами.
При подсчете 716 конфигураций рассуждения AA были объединены в 517 версий релизов: 176 китайских, 257 американских, остальные относятся к другим странам или не классифицированы. Объединение выполнялось по release.id, поэтому конфигурации high, max и xhigh одной версии не засчитывались как несколько моделей. Для каждого показателя отдельно бралась конфигурация с наивысшим результатом данной версии; это могли быть разные конфигурации.
В новом рейтинге v5 пригодный общий балл пока есть только у 39 версий релизов: 12 китайских, 24 американских и 3 из других стран. Top 10 и средние значения здесь описывают протестированную выборку; отсутствие измерения не означает нулевой балл. Рейтинг построен с точностью исходного ответа API: равные результаты занимают одно место, а следующие места пропускаются.[1]
Текущий Top 20: кто находится в ведущей группе?#
| Место в мире (после дедупликации версий) | Версия релиза | Страна | Балл v5 | Дата релиза |
|---|---|---|---|---|
| 1 | Gemini 4 Carbon | США | 59.4 | 2026-10-28 |
| 2 | Claude Opus 5.5 | США | 58.4 | 2026-09-22 |
| 3 | GPT-6 Astra | США | 56.9 | 2026-09-03 |
| 4 | GPT-6.1 Sol | США | 54.5 | 2026-09-29 |
| 5 | Claude Sonnet 5.5 | США | 54.2 | 2026-09-28 |
| 6 | GPT-6.1 Terra | США | 51.0 | 2026-10-26 |
| 7 | Gemini 4 Argon | США | 50.4 | 2026-09-30 |
| 8 | Muse Wonder Full | США | 49.7 | 2026-10-12 |
| 8 | Claude Fable 5.1 | США | 49.7 | 2026-09-01 |
| 10 | Kimi K3.1 Pro | Китай | 46.0 | 2026-10-23 |
| 11 | Muse Wonder | США | 43.3 | 2026-10-12 |
| 12 | Muse Spark 1.3 | США | 36.4 | 2026-09-02 |
| 13 | Claude Haiku 5.5 | США | 36.2 | 2026-10-07 |
| 14 | Grok 4.7 | США | 35.0 | 2026-09-21 |
| 15 | Qwen3.8 Max (0902) | Китай | 33.6 | 2026-09-02 |
| 16 | DeepSeek V4.1 Flash 1017 | Китай | 32.5 | 2026-10-17 |
| 17 | GLM-5.3 | Китай | 31.7 | 2026-08-18 |
| 18 | Gemini 3.8 Flash | США | 30.5 | 2026-09-02 |
| 19 | MiMo-V2.6-Pro | Китай | 29.9 | 2026-09-21 |
| 20 | Ling 3.1 Flash 1019 | Китай | 29.5 | 2026-10-22 |
В этом Top 20 Китаю принадлежат 6 мест, США — 14; в Top 10 — соответственно 1 и 9. Вместе со средними значениями Top 5, равными 34.74 и 56.68, это показывает: приближение отдельной передовой модели и глубина всей ведущей группы остаются разными характеристиками. Версии без общего балла в рейтинг не входят.[1]
Действительно ли разрыв в баллах продолжает расти?#
Он не увеличивается непрерывно, а заметно зависит от ритма выхода флагманов. Используя Progress Index v1 из того же снимка данных, мы восстановили передовые рубежи двух стран по датам релизов: наивысший балл среди версий, выпущенных до определенного дня, считался ретроспективным рубежом этого дня.
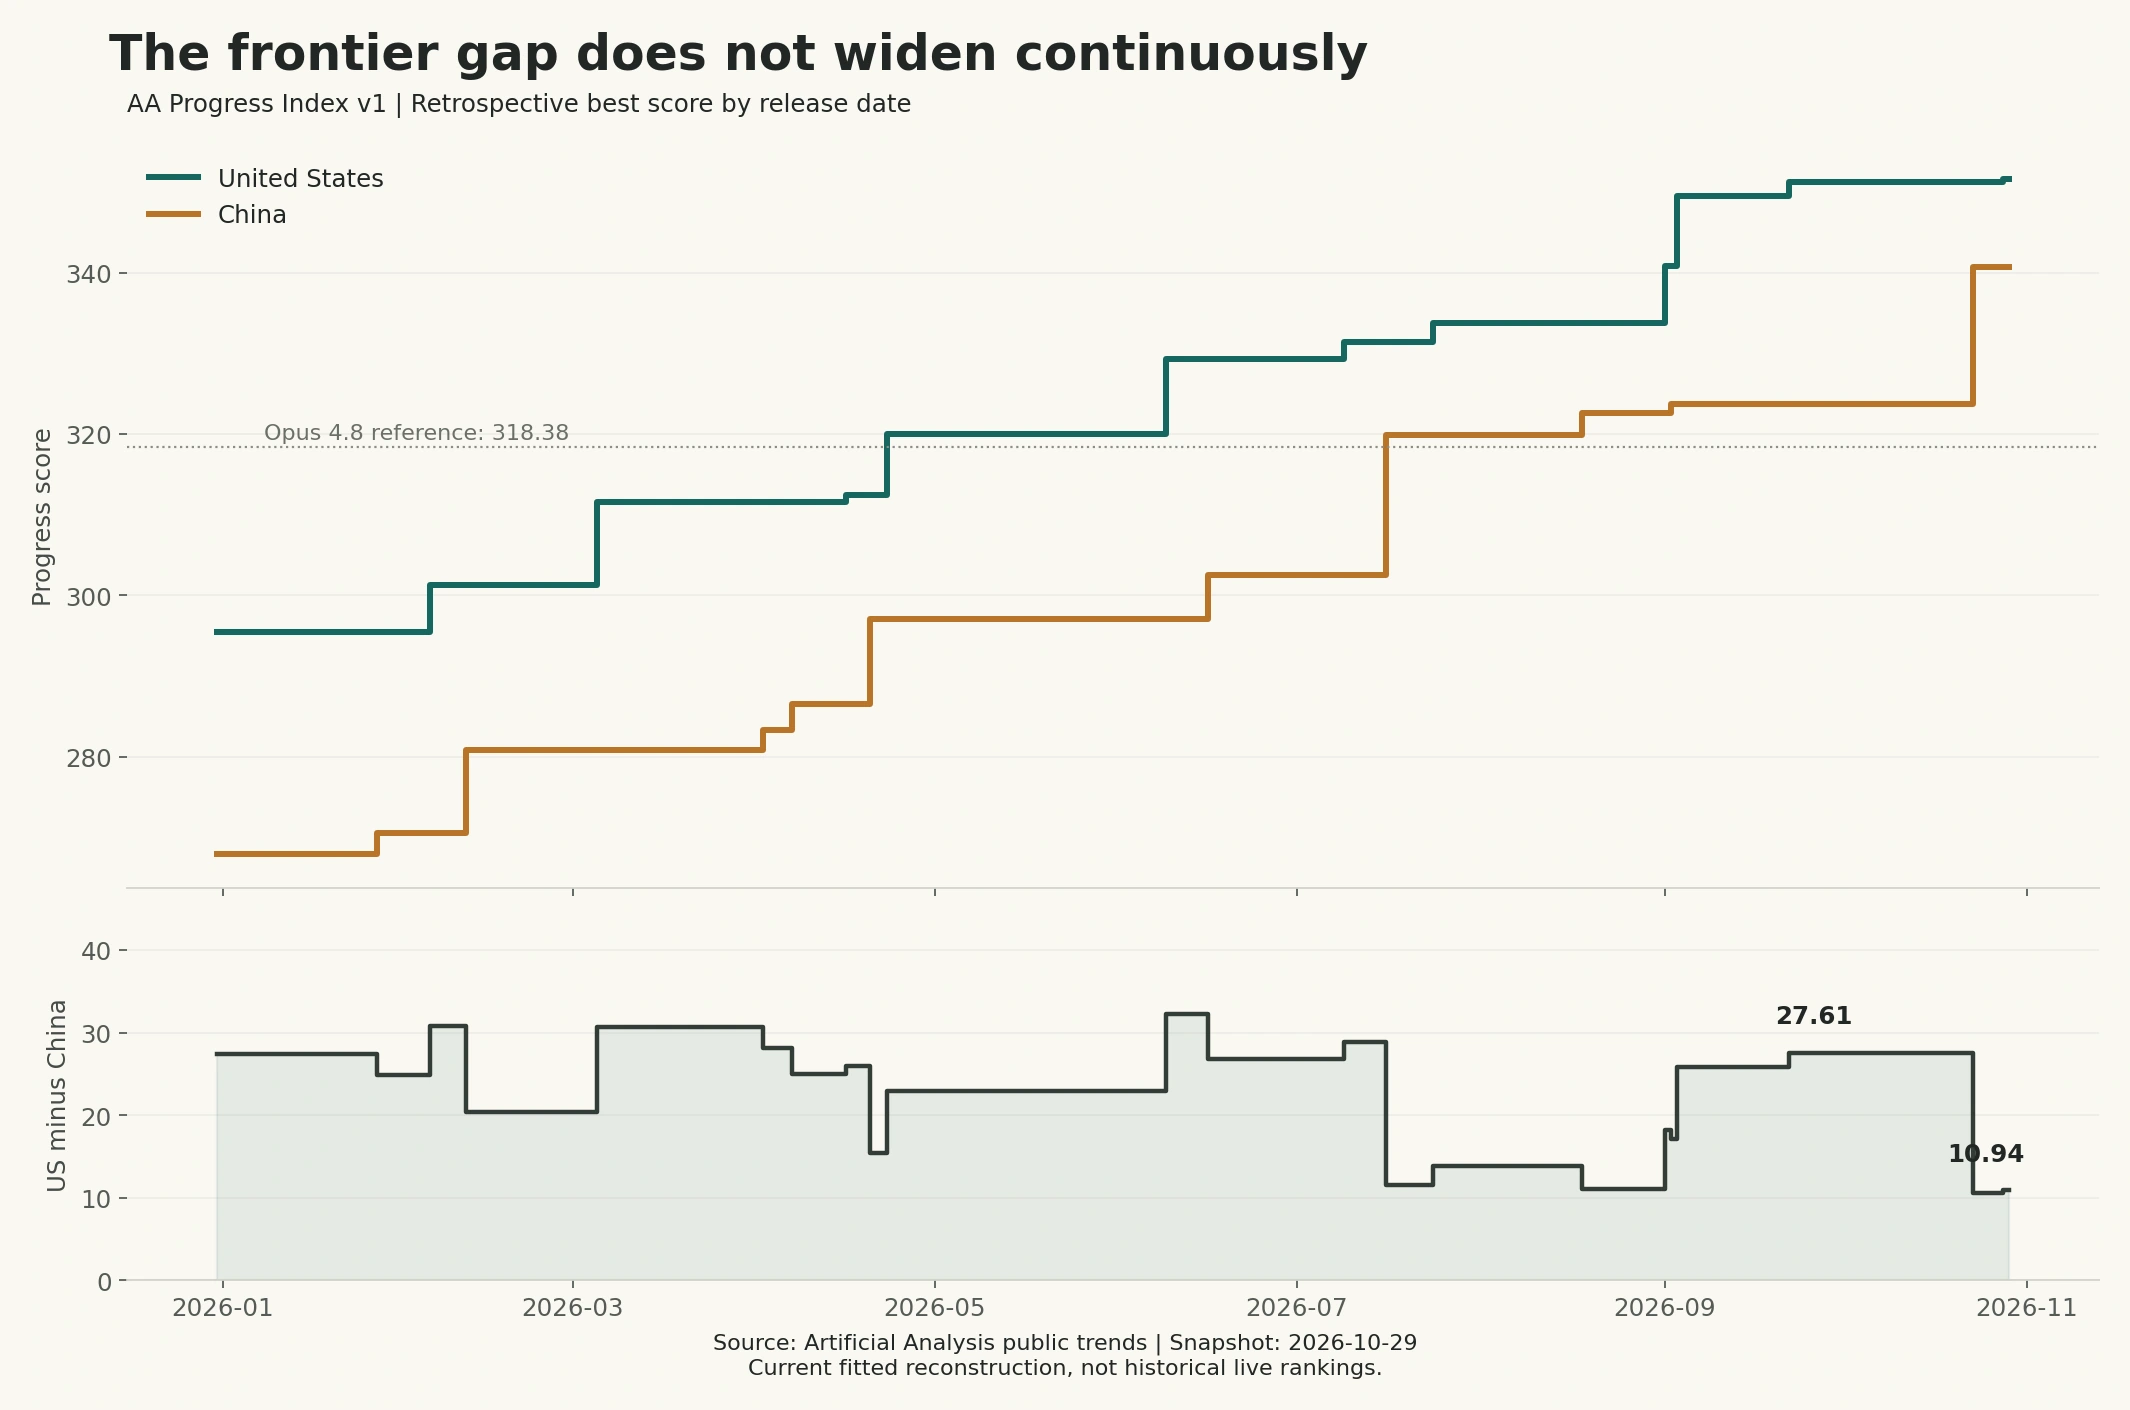
| Ретроспективная дата | Передовой рубеж Китая | Передовой рубеж США | Разрыв: США − Китай |
|---|---|---|---|
| 2025-12-31 | 267.96 | 295.46 | 27.49 |
| 2026-03-31 | 280.87 | 311.55 | 30.69 |
| 2026-06-30 | 302.52 | 329.33 | 26.80 |
| 2026-07-31 | 319.88 | 333.73 | 13.85 |
| 2026-08-31 | 322.66 | 333.73 | 11.07 |
| 2026-09-30 | 323.67 | 351.27 | 27.61 |
| 2026-10-23 | 340.70 | 351.27 | 10.57 |
| 2026-10-29 | 340.70 | 351.65 | 10.94 |
В конце августа 2026 года разрыв составлял 11.07. После сконцентрированного выхода новых американских флагманов в сентябре он вырос до 27.61 к концу месяца; 23 октября релиз Kimi K3.1 Pro сократил его до 10.57; после выхода Gemini 4 Carbon 28 октября снимок от 29 октября показал 10.94.[2]
Поэтому выбор временного окна становится частью вывода. Текущий разрыв примерно на 16.66 балла меньше, чем 30 дней назад, примерно на 2.91 балла меньше, чем 90 дней назад, и примерно на 12.00 балла меньше, чем 180 дней назад. При этом США по-прежнему лидируют в сравнении передовых рубежей двух стран. Сокращение разрыва и сохранение лидерства могут быть верны одновременно.
Однако этот график нельзя называть «рейтингом в реальном времени за каждый прошедший день». Progress Index — это статистическая подгонка на основе оценок, полученных к настоящему моменту; будущие дополнительные тесты и повторная подгонка могут изменить ретроспективные баллы. Историческая доступность API также не восстановлена полностью. График отвечает на вопрос «как сегодня оценить ранее выпущенные модели по одной шкале», а не «какие модели пользователи действительно могли вызвать в то время».[3]
Почему некоторые видят внезапное увеличение разрыва?#
2026-10-27 AA обновила Intelligence Index до v5, добавив или усовершенствовав оценки программной инженерии, научных исследований и рассуждений на основе знаний. В объявлении говорится, что разрыв между лидером категории открытых весов и ведущей моделью вырос с 3 баллов в v4.3 до 12 баллов в v5.[4]
Здесь одновременно изменилась измерительная шкала и использовалась группировка «открытые веса и ведущие модели»; это нельзя напрямую переписать как «разрыв возможностей Китая и США увеличился с 3 до 12 баллов за два дня». В объявлении Kimi K3.1 Pro, веса которого еще не были опубликованы, также упоминается в соответствующем описании, поэтому тем более нельзя отождествлять эту группу с набором моделей, доступных для скачивания в тот день.
В v5 четыре категории — работа со знаниями, программирование, наука и общие задачи — имеют вес по 25% каждая. По сравнению с простым общением это придает больше значения сложным задачам и многоэтапному выполнению. Поэтому разрыв в рейтинге может быть большим, а в некоторых повседневных задачах — небольшим; так ли это, должны показать данные по конкретным задачам.[4][5]
Если Opus 4.8 уже достаточно, сколько моделей превзошли его?#
Сначала зафиксируем шкалу. 61.4 балла, полученные Opus 4.8 в оценке при его выпуске в мае 2026 года, относятся к старой версии Intelligence Index. В текущем снимке API его общий балл v5 отсутствует: пустое значение нельзя считать нулем и тем более использовать старые 61.4 для отбора в новом рейтинге.[1][6]
Вместо этого в статье в качестве фиксированного референса используется Opus 4.8 (max): 318.376758998036 в Progress Index v1. Превышением считается только строго большее значение; равенство не засчитывается, а отсутствие измерения обозначается как неизвестное. Для порога используется полная точность, в таблицах оставлены только два знака после точки.[2]
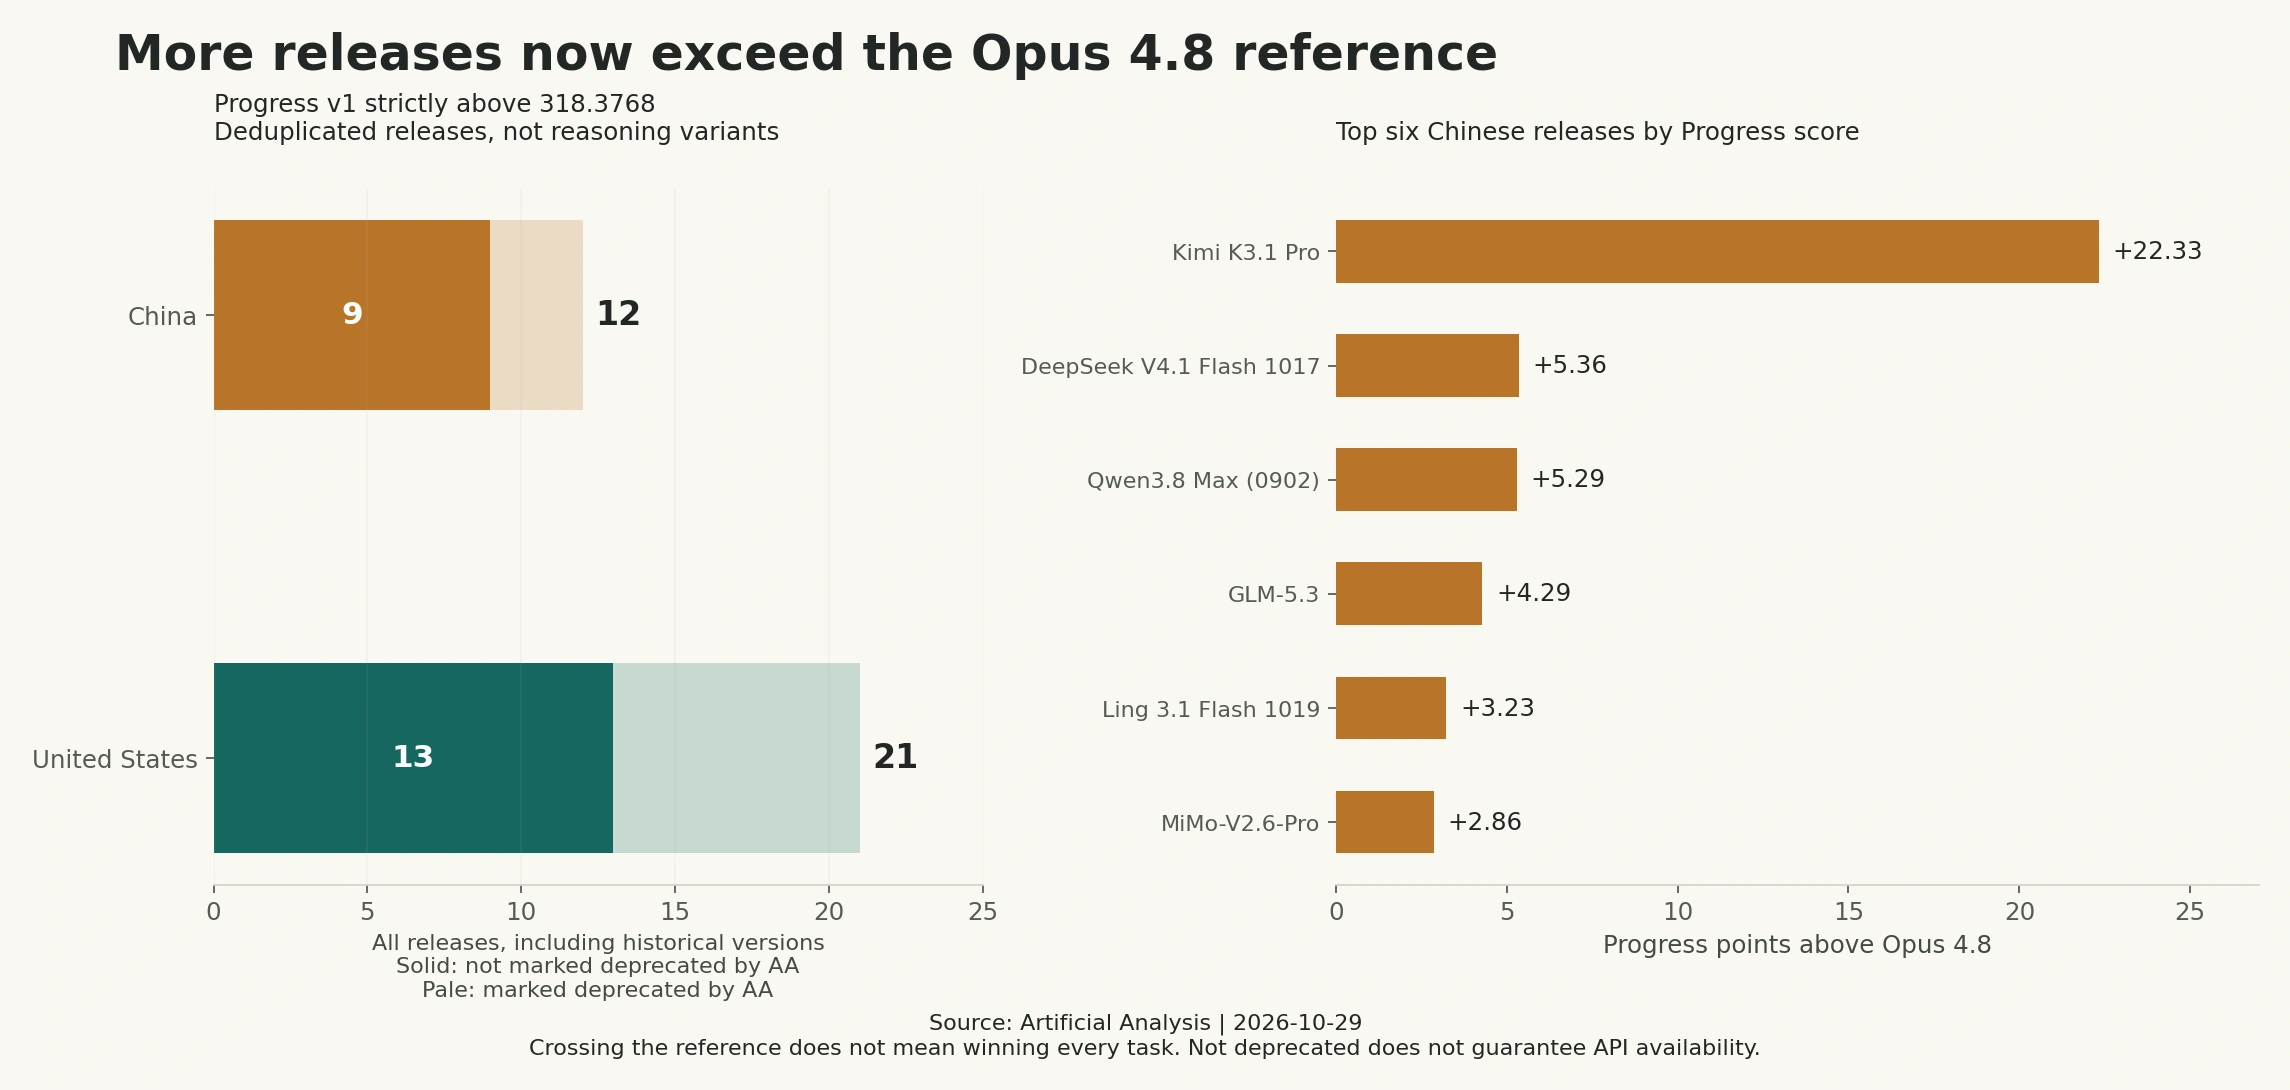
Среди 517 версий релизов во всем мире 33 превысили этот порог, и все они входят в рассматриваемые китайскую и американскую группы. Из них 12 китайских и 21 американская. Если учитывать только версии, которые AA не отметила как deprecated, получается соответственно 9 и 13. Отметка AA описывает состояние страницы: она не доказывает, что официальный сервис уже закрыт, и не гарантирует доступность через какой-либо шлюз в настоящий момент.
Полный список китайских моделей, преодолевших порог#
| Версия китайской модели | Максимальный балл Progress | Отмечено в AA как deprecated |
|---|---|---|
| Kimi K3.1 Pro | 340.70 | Нет |
| DeepSeek V4.1 Flash 1017 | 323.74 | Нет |
| Qwen3.8 Max (0902) | 323.67 | Нет |
| GLM-5.3 | 322.66 | Нет |
| Ling 3.1 Flash 1019 | 321.61 | Нет |
| MiMo-V2.6-Pro | 321.24 | Нет |
| DeepSeek V4.1 Flash | 320.25 | Да |
| Qwen3.8-Flash-Next | 320.23 | Нет |
| Ling 3.1 Flash | 320.01 | Нет |
| Kimi K3 | 319.88 | Да |
| Qwen3.8 Max | 319.63 | Да |
| GLM-5.3-Flash | 318.64 | Нет |
Полный список американских моделей, преодолевших порог#
| Версия американской модели | Максимальный балл Progress | Отмечено в AA как deprecated |
|---|---|---|
| Gemini 4 Carbon | 351.65 | Нет |
| Claude Opus 5.5 | 351.27 | Нет |
| Claude Sonnet 5.5 | 350.50 | Нет |
| GPT-6 Astra | 349.57 | Нет |
| GPT-6.1 Sol | 348.47 | Нет |
| GPT-6.1 Terra | 345.25 | Нет |
| Muse Wonder Full | 343.22 | Нет |
| Gemini 4 Argon | 341.79 | Нет |
| Claude Fable 5.1 | 340.85 | Нет |
| Muse Wonder | 335.78 | Нет |
| GPT-6 Sol | 334.04 | Да |
| Claude Opus 5 | 333.73 | Да |
| GPT-5.6 Sol | 331.46 | Да |
| Claude Fable 5 | 329.33 | Да |
| Claude Haiku 5.5 | 326.13 | Нет |
| Muse Spark 1.3 | 324.46 | Да |
| GPT-5.6 Terra | 323.87 | Да |
| Grok 4.7 | 322.68 | Нет |
| Grok 4.6 | 321.54 | Да |
| Gemini 3.8 Flash | 320.30 | Нет |
| GPT-5.5 | 320.00 | Да |
Нельзя называть любое небольшое превышение «явным лидерством». Например, GLM-5.3-Flash выше референса примерно на 0.27 балла; опубликованные данные не содержат доверительных интервалов, достаточных для такого сравнения. Поэтому следующая таблица представляет только анализ чувствительности к порогу, а добавленные интервалы не являются критериями статистической значимости:
| Порог (Progress v1) | Число китайских версий | Число американских версий |
|---|---|---|
| Строго выше Opus 4.8 + 0 баллов | 12 | 21 |
| Строго выше Opus 4.8 + 1 баллов | 11 | 21 |
| Строго выше Opus 4.8 + 3 баллов | 5 | 19 |
| Строго выше Opus 4.8 + 5 баллов | 3 | 17 |
| Строго выше Opus 4.8 + 10 баллов | 1 | 14 |
Этот ракурс одновременно объясняет два впечатления: вариантов, достигших уровня прежнего флагмана, действительно стало больше; варианты, намного превосходящие его, по-прежнему сосредоточены в американской группе. Среди 12 китайских версий выше порога только 3 превосходят его более чем на 5 баллов; среди американских таких 17. Во всех случаях учитываются исторические версии, поэтому эти данные нельзя трактовать как текущий ассортимент API.
С какой разницей во времени был преодолен этот порог возможностей?#
В текущей ретроспекции Progress v1 первой американской версией выше порога стал GPT-5.5, выпущенный 2026-04-23, а первой китайской — Kimi K3, выпущенный 2026-07-16. Между датами первого преодоления — 84 дня. Если отсчитывать от даты выпуска самого Opus 4.8, 28 мая, то до Kimi K3 прошло 49 дней.[2]
То, что GPT-5.5 преодолел этот ретроспективный порог раньше самого Opus 4.8, не является противоречием: цели, подгонка и порядок Progress отличаются от тогдашнего рейтинга Intelligence. 84 дня — это лишь разница между датами первого преодоления одного заданного порога, а не доказательство того, что «все китайские модели в целом отстают на три месяца».
Действительно ли ощущаемая на практике разница так велика, как кажется по баллам?#
Эксперимент отвечает на вопрос «какие задачи были успешно выполнены при этих условиях запросов», но не заменяет общую оценку удовлетворенности человека. Мы выбрали актуальные представительные модели из серии Anthropic (на английском) и серии OpenAI (на английском), сохранив Opus 4.8 в качестве референса; китайская группа охватывает серию Kimi (на английском), серию Qwen (на английском), серию DeepSeek (на английском) и серию GLM (на английском). Это целенаправленная выборка, не предназначенная для оценки среднего национального процента побед.
Тестирование проводилось 2026-10-29. Все запросы направлялись на endpoint /v1/chat/completions по адресу https://cn.crazyrouter.com с параметрами reasoning_effort="high", max_tokens=8192, без потоковой передачи и без вызова инструментов. Тайм-аут чтения каждого запроса составлял 180 секунд, порядок был случайным, одновременно выполнялось не более 4 запросов. Одинаковая метка high не означает одинаковые внутренние вычислительные ресурсы и не соответствует оценке AA каждой модели на максимальном уровне.
| Группа задач | Конкретные задачи | Основание для оценки |
|---|---|---|
| Повседневные задачи, 5 видов | Извлечение и дедупликация заказов, регистрация конфликтов, соблюдение китайских требований к формату, поиск по 240 записям складских остатков, граничные случаи правил возврата | Фиксированные правильные значения, типы полей, текстовый формат |
| Нагрузка на рассуждение, 3 вида | Подсчет с циклическими ограничениями, планирование с зависимостями, оптимизация комбинаторного выбора | Единственный оптимальный ответ, найденный локальным полным перебором / заданные правила для равных решений |
Для строгого зачета требовались успешный HTTP-ответ, нормальное завершение и полное соответствие итогового ответа и формата требованиям. Мы сохранили этот заранее определенный основной показатель; дополнительно была выполнена постфактум-проверка чувствительности, при которой удалялся только один внешний Markdown-ограждающий блок кода, без исправления ответов и повторных попыток. Последний показатель ближе к вопросу «можно ли понять содержание», первый — «можно ли напрямую подключить результат к программе».
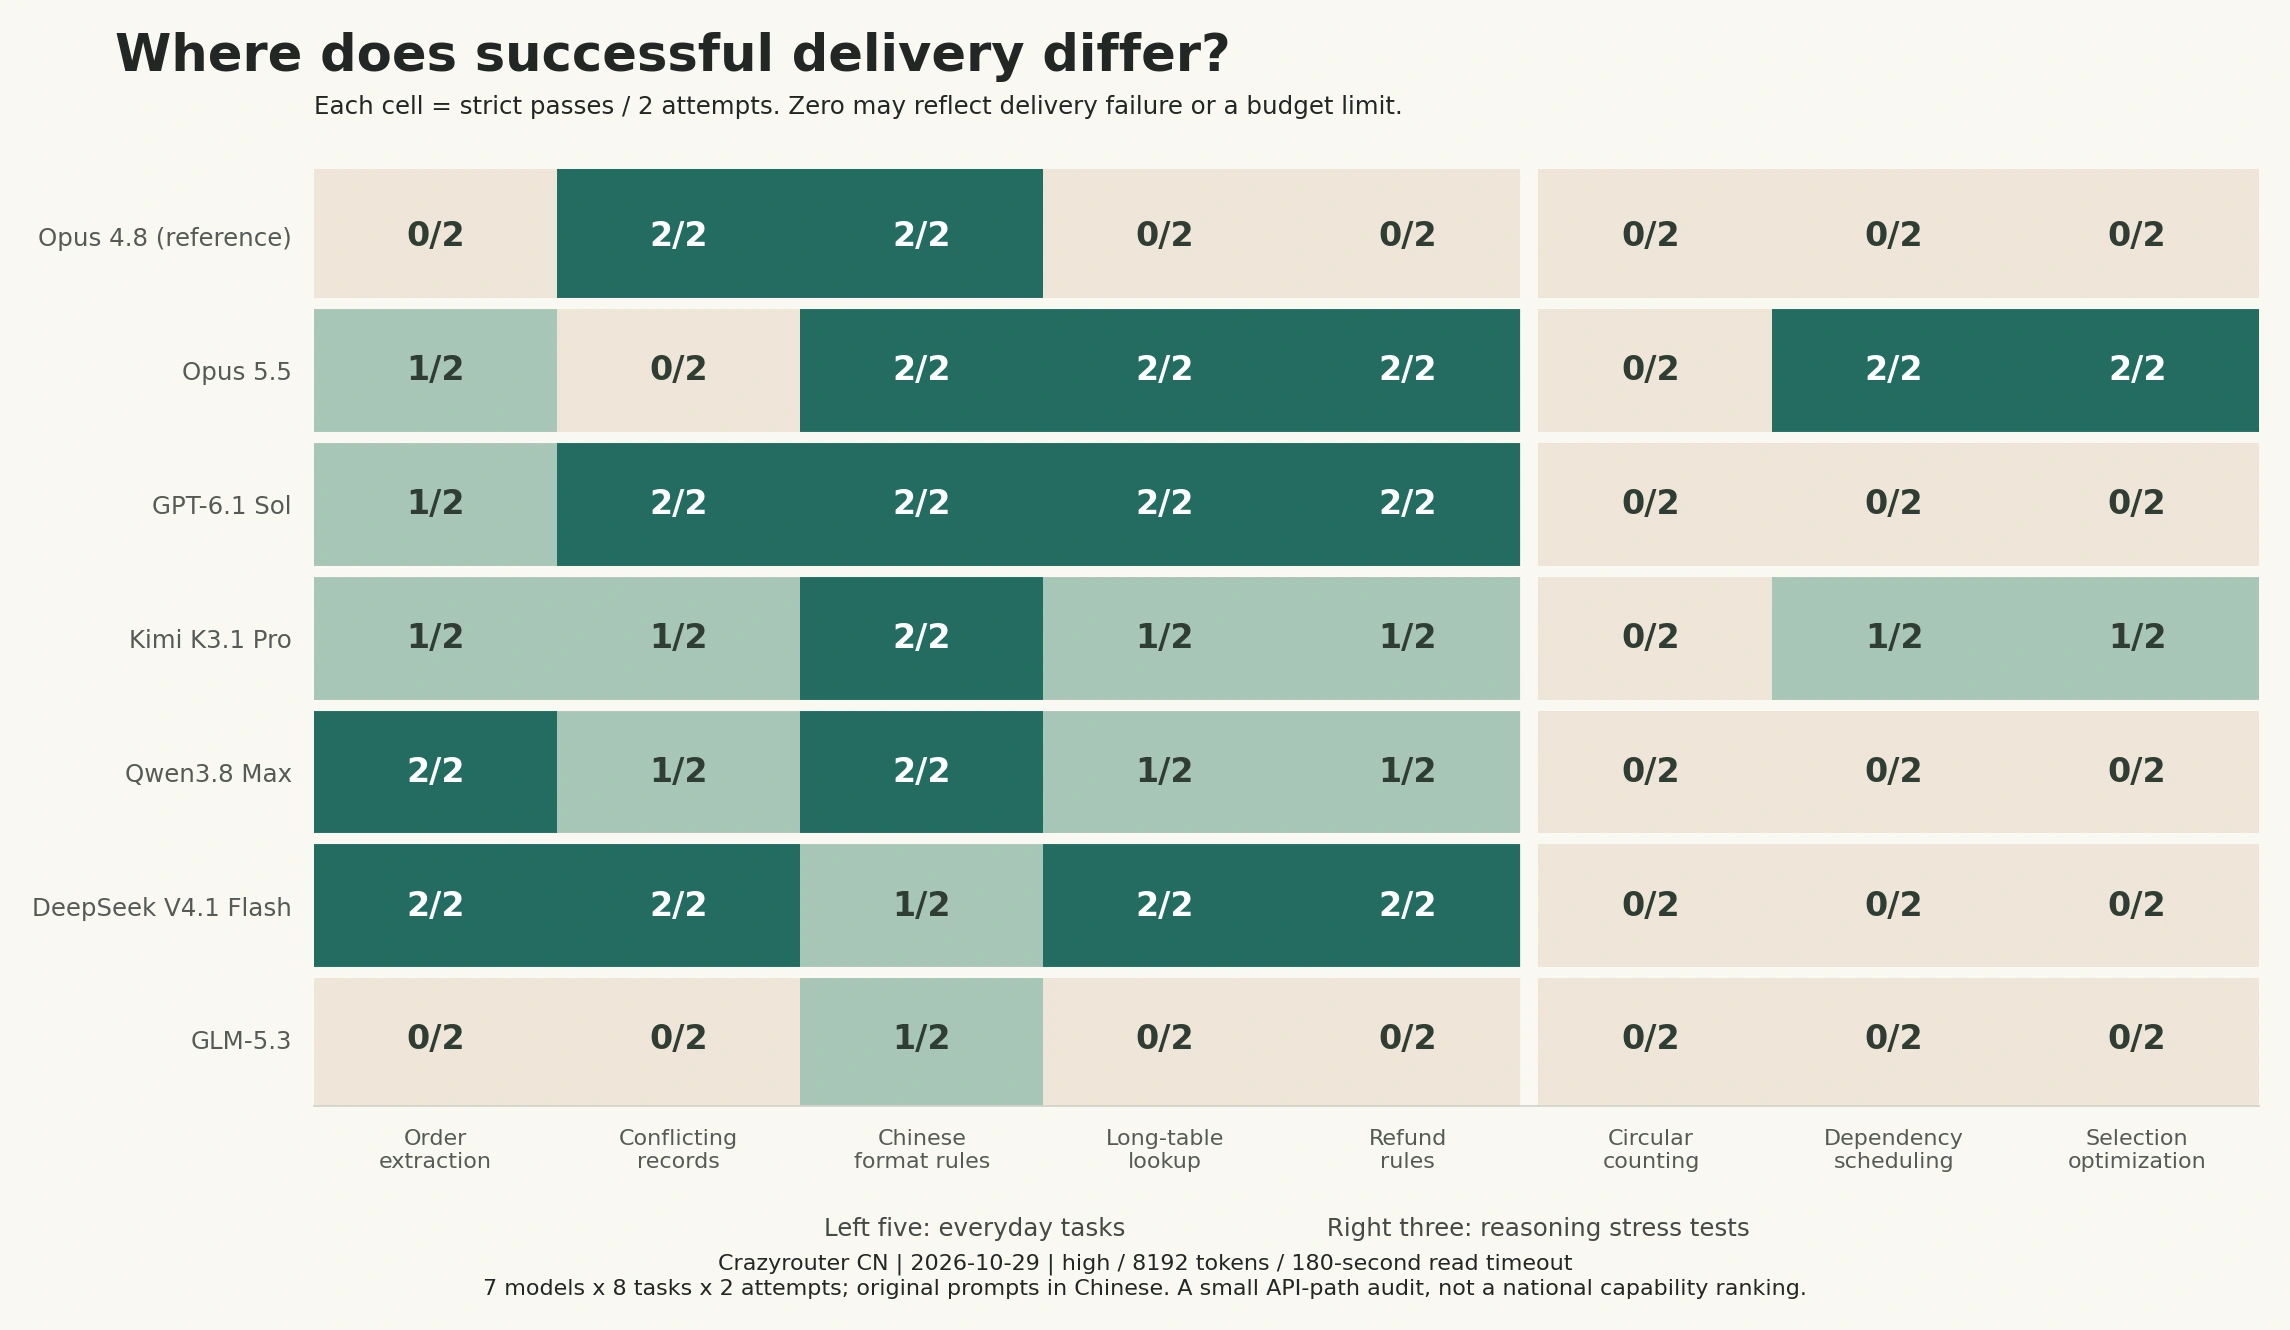
| Запрошенная модель | Повседневные, строгий зачет / 10 | Нагрузочные, строгий зачет / 6 | Все, строгий зачет / 16 | После удаления одного ограждения / 16 |
|---|---|---|---|---|
| claude-opus-4-8 | 4/10 | 0/6 | 4/16 | 13/16 |
| claude-opus-5-5 | 7/10 | 4/6 | 11/16 | 16/16 |
| gpt-6.1-sol | 9/10 | 0/6 | 9/16 | 9/16 |
| kimi-k3.1-pro | 6/10 | 2/6 | 8/16 | 8/16 |
| qwen3.8-max | 7/10 | 0/6 | 7/16 | 7/16 |
| deepseek-v4.1-flash | 9/10 | 0/6 | 9/16 | 9/16 |
| glm-5.3 | 1/10 | 0/6 | 1/16 | 1/16 |
В чем проявляется разница?#
Возьмем DeepSeek V4.1 Flash и Opus 5.5 в этом раунде: строгое выполнение повседневных задач составило соответственно 9/10 и 7/10, нагрузочных — 0/6 и 4/6. Это различие в выполнении при фиксированном бюджете; нельзя объяснять все невыполненные задания тем, что «модель не умеет их решать». В частности, на нагрузочных задачах мог закончиться бюджет вывода или работа могла не завершиться до предела ожидания.
Другой реальный пример связан с Opus 4.8: при извлечении заказа модель вернула правильные поля и значения, но заключила их в Markdown-ограждение кода, из-за чего строгая проверка JSON не была пройдена. При чтении в окне чата это может не показаться ошибкой; если результат напрямую передается программе, потребуется дополнительная очистка. Один и тот же ответ создает разные впечатления при двух способах использования.
После удаления только одного слоя ограждения кода результаты стали такими:
| Запрошенная модель | Повседневные: только после удаления ограждения / 10 | Нагрузочные: только после удаления ограждения / 6 |
|---|---|---|
| claude-opus-4-8 | 10/10 | 3/6 |
| claude-opus-5-5 | 10/10 | 6/6 |
| gpt-6.1-sol | 9/10 | 0/6 |
| kimi-k3.1-pro | 6/10 | 2/6 |
| qwen3.8-max | 7/10 | 0/6 |
| deepseek-v4.1-flash | 9/10 | 0/6 |
| glm-5.3 | 1/10 | 0/6 |
У Opus 4.8 и Opus 5.5 на повседневных задачах результат одинаков — 10/10, но на нагрузочных — соответственно 3/6 и 6/6. Это конкретный пример того, что преимущество более способной модели может проявляться главным образом на более сложных задачах. Здесь только 5 повседневных и 3 нагрузочных задачи; два вызова одной задачи не считаются двумя независимыми задачами, поэтому эти данные не доказывают эквивалентность повседневных возможностей.
Шлюз и сопоставление версий также меняют впечатления#
Из 112 запросов этого раунда 15 завершились HTTP-ошибками, 17 — тайм-аутами чтения и 7 — обрезкой из-за бюджета. Все эти вызовы остаются в знаменателе показателя выполнения при фиксированном бюджете и отдельно перечислены в таблице.
| Запрошенная модель | HTTP-ошибки | Тайм-аут чтения 180 секунд | Обрезка из-за бюджета | Число нормально завершенных ответов |
|---|---|---|---|---|
| claude-opus-4-8 | 1 | 0 | 2 | 13 |
| claude-opus-5-5 | 0 | 0 | 0 | 16 |
| gpt-6.1-sol | 5 | 0 | 0 | 11 |
| kimi-k3.1-pro | 6 | 2 | 0 | 8 |
| qwen3.8-max | 1 | 8 | 0 | 7 |
| deepseek-v4.1-flash | 0 | 2 | 5 | 9 |
| glm-5.3 | 2 | 5 | 0 | 9 |
Например, один запрос к Kimi K3.1 Pro вернул provider_authentication_failed. Это означает, что запрос не был правильно аутентифицирован вышестоящим провайдером, и не может служить доказательством неправильного ответа модели. Тайм-аут чтения также означает лишь, что клиент своевременно не получил полный ответ; нельзя на этом основании локализовать проблему как медленные вычисления модели.
| Имя запроса | Поле model, встречавшееся в фактических ответах |
|---|---|
| claude-opus-4-8 | claude-opus-4-8 |
| claude-opus-5-5 | claude-opus-5-5 |
| gpt-6.1-sol | gpt-6.1-sol |
| kimi-k3.1-pro | kimi-k3.1-pro |
| qwen3.8-max | qwen3.8-max |
| deepseek-v4.1-flash | deepseek-v4.1-flash、deepseek-v4.1-flash-1017、deepseek/deepseek-flash |
| glm-5.3 | glm-5.3 |
Поле model в ответе — только декларация сервера, а не независимое доказательство идентичности весов. В частности, одно и то же имя запроса DeepSeek возвращало разные версии или псевдонимы, поэтому в этом раунде нельзя гарантировать, что все запросы точно соответствовали одной и той же версии релиза AA. Следовательно, эти результаты следует называть «аудитом выполнения по данному API-пути»; их нельзя жестко сопоставлять с баллами AA для расчета коэффициента корреляции и тем более использовать для заявления, что модели какой-либо страны в целом сильнее или эквивалентны.
На пути GLM-5.3 также встречались ответы с дополнительным текстом после JSON, повторяющимися ответами и аномальными метками. Мы сохранили исходные свидетельства, но не можем определить, возникли ли аномалии в модели, шаблоне или адаптации вышестоящего провайдера. Его низкое число строгих выполнений особенно непригодно для выводов о возможностях базовой модели; ради лучшего результата мы не меняли канал и не перезапускали тесты для замены неудачных попыток.
Мы не проводили слепую оценку людьми, выборку задач производственных пользователей, длительное нагрузочное тестирование или многоэтапную оценку Agent при одинаковом бюджете. Поэтому имеющихся свидетельств все еще недостаточно, чтобы ответить, «одинаково ли хороши модели по общему впечатлению». Уже можно подтвердить другое: тип задачи, формат вывода, бюджет запроса и сервисная цепочка способны сделать практический опыт отличным от порядка в отдельном рейтинге.
Кто обновляется быстрее? Количество релизов и прорывы возможностей следует рассматривать отдельно#
Ниже учитываются отдельные версии релизов в выборке, охваченной AA, а не полная перепись всех моделей двух стран. Несколько уровней рассуждения одной версии засчитываются один раз. Обновления передового рубежа считаются по датам, когда происходило улучшение; несколько версий в один день не засчитываются как несколько обновлений.
| Месяц 2026 года | Версии релизов Китая | Версии релизов США | Число дат обновления передового рубежа Китаем | Число дат обновления передового рубежа США |
|---|---|---|---|---|
| 2026-01 | 5 | 4 | 1 | 0 |
| 2026-02 | 9 | 7 | 1 | 1 |
| 2026-03 | 12 | 9 | 0 | 1 |
| 2026-04 | 16 | 15 | 3 | 2 |
| 2026-05 | 6 | 4 | 0 | 0 |
| 2026-06 | 6 | 7 | 1 | 1 |
| 2026-07 | 5 | 10 | 2 | 2 |
| 2026-08 | 11 | 10 | 1 | 0 |
| 2026-09 | 8 | 13 | 1 | 3 |
| 2026-10 (до 29-го) | 5 | 10 | 2 | 1 |
С 2026-01-01 по 2026-10-29 в выборке вышло 83 китайские и 89 американских версий. За последние 90 календарных дней, с 1 августа по 29 октября включительно, — соответственно 24 и 33, но каждая группа обновляла собственный передовой рубеж Progress только в 4 даты. Большее число релизов не означает автоматически больший рост максимальных возможностей.[2]
На момент снимка последним обновлением передового рубежа Китая был Kimi K3.1 Pro 23 октября, США — Gemini 4 Carbon 28 октября. Данные собраны 29 октября, поэтому день сбора нельзя называть днем обновления модели. AA API не предоставляет полный исторический журнал изменений оценок каждой модели; мы не выдумываем такое поле.
Как повторить расчеты и как в следующем раунде проверить «ощущаемую» разницу#
В редакционном исследовательском архиве сохранены ответы четырех страниц AA API, данные общедоступных графиков трендов, объединенный CSV на 517 строк, статистические скрипты, правильные ответы задач, все 112 вызовов и сводки. Статистика в официальном блоге получена только из этих замороженных записей. Источник данных — Artificial Analysis; агрегированные расчеты и фактические тесты пути Crazyrouter выполнены авторами статьи.
Основные вычисления можно понять по следующему псевдокоду:
# One snapshot and metric version.
# Use AA release_id, not guessed names.
release_score = max(non_null_scores_for_each_release)
baseline = progress_score_of_opus_4_8_max
above_baseline = release_score > baseline
frontier_at_date = max(scores_of_releases_available_by_date)
gap_at_date = us_frontier_at_date - cn_frontier_at_date
Например, ID ответа Opus 4.8 на задачу извлечения заказа — msg_011CgWecKv2YBwoHYumCeURh; HTTP 200, нормальное завершение. Исходный ответ представлял собой правильный JSON, заключенный в ограждение кода: строгая оценка — незачет, проверка чувствительности к формату — зачет. ID запроса с ошибкой аутентификации Kimi — 608ccc90b353423d036dca779cafcc37. Эти две записи показывают разницу между «результат получен, но формат не соответствует требованиям» и «ответ модели не получен».
Следующий пример повторяет одну задачу на бизнес-правила; API Key считывается только из переменной окружения, а endpoint не содержит UTM:
import os
import requests

endpoint = "https://cn.crazyrouter.com" + "/v1/chat/completions"
user_content = (
    "\u672a\u62c6\u5c01\u4e14\u7b7e\u6536" "\u6b21\u65e5\u8d777\u65e5\u5185" "\u53ef\u9000\u6b3e\uff1b\u7b2c7" "\u65e5\u5305\u542b\u5728\u5185\u3002"
    "A\u57282026" "-10-20" "\u7b7e\u6536\uff0c202" "6-10-2" "7\u7533\u8bf7\u9000\u6b3e\uff0c"
    "\u65e0\u8d28\u91cf\u7f3a\u9677\u3002" "\u53ea\u8f93\u51faJSO" "N\uff0c\u952eeli" "gible\u4e3a" "\u5e03\u5c14\u503c\u3002"
)

response = requests.post(
    endpoint,
    headers={"Authorization": "Bearer " + os.environ["CRAZYROUTER_API_KEY"]},
    json={
        "model": "claude-opus-4-8",
        "messages": [{"role": "user", "content": user_content}],
        "reasoning_effort": "high", "max_tokens": 8192, "stream": False,
    },
    timeout=(15, 180),
)
response.raise_for_status()
print(response.json())
Это упрощенный пример воспроизведения для основного текста, а не полная исходная задача из 112 официальных тестов. Полные 8 задач, скрипты оценки и исходные записи хранятся в редакционном архиве; полный исходный исследовательский пакет не опубликован для скачивания. Упрощенная задача не использовалась для добавления или замены официальных результатов.
Здесь available_by_date означает только то, что дата релиза не позже указанного дня, и не гарантирует наличие публичного API в тот день. Отсутствующие баллы не заменяются нулями, а один балл не трактуется как фиксированный процент. Принадлежность к странам соответствует меткам исследовательских организаций AA: Google отнесена к обозначенной ею американской группе; местоположение серверов и гражданство сотрудников не используются для классификации.[1][3]
Если следующий раунд должен действительно проверить «эквивалентность впечатлений», рекомендуется сначала зафиксировать три категории целевых пользовательских задач и допустимые различия, а затем провести парное слепое сравнение с анонимизацией и случайным порядком слева и справа. Основные показатели должны включать качество выполнения задачи, серьезные ошибки, объем ручной доработки и предпочтения; частота сбоев вызовов указывается отдельно. Границы эквивалентности и размер выборки определяются до просмотра результатов, анализ проводится с кластеризацией по задачам. Нельзя считать «отсутствие обнаруженной значимой разницы» доказательством «одинакового опыта».
Что эта серия планирует исследовать дальше?#
Эта статья сначала отвечает на вопрос, чем различаются разрыв в баллах, порог прежнего флагмана и фактическое выполнение. Следующие материалы будут разделены по типам возможностей; в каждом используются подходящие задаче бенчмарки, фиксированный бюджет и реальные API-тесты. Баллы разных модальностей не будут складываться в единый «национальный общий балл». Ниже приведен план тем; последующие специальные выпуски еще не опубликованы.
| Выпуск | Планируемая тема | Главный вопрос |
|---|---|---|
| Первый · Текстовые модели | После преодоления флагманского порога насколько велика разница в повседневных задачах? | Различия в китайскоязычном письме, структурированном выводе, работе с длинными документами, фактологической точности и слепой оценке людьми |
| Второй · Программирование и Agent | Если модель умеет отвечать, может ли она довести дело до конца? | Изменение кода, прохождение тестов, вызов инструментов, многоэтапные задачи, процент завершения в пределах бюджета |
| Третий · Модели изображений | Кто лучше следует требованиям, а не просто создает красивую картинку? | Генерация изображений по тексту, редактирование изображений, китайский текст, согласованность объектов и стабильность повторных генераций |
| Четвертый · Видеомодели | После впечатляющего отдельного кадра работают ли движение и повествование? | Генерация видео по тексту и изображению, согласованность движения и физики, непрерывность персонажей, ожидание готового ролика |
| Пятый · Речевые модели | Насколько точно модель слышит, естественно говорит и успевает за диалогом? | Отдельное измерение распознавания речи, синтеза речи и речи в реальном времени с учетом акцентов и задержки |
| Шестой · Векторы и реранжирование | Где именно находится разница в качестве базы знаний? | Китайскоязычный и межъязыковой поиск, длинные документы, Recall@k, nDCG, прирост от реранжирования и стоимость индексации |
| Седьмой · Комплексный выбор | Как комбинировать разные модели при одинаковом бюджете? | Сведение предыдущих практических тестов в выбор качества, ожидания, стоимости и надежности для конкретных сценариев |
В каждом выпуске сохранятся три вопроса: «кто находится на передовом рубеже, кто преодолел практический порог и влияет ли разница на реальные задачи». Однако порог будет определяться референсной моделью данной модальности или условиями приемки бизнес-задачи. Например, Opus 4.8 может служить текстовым референсом в этой статье, но не универсальным порогом для моделей изображений, речи или векторов.
Частые вопросы#
Насколько велика реальная дистанция между ИИ-моделями Китая и США?#
В текущем снимке США лидируют на передовом рубеже AA Intelligence v5 на 13.4 балла; разрыв передовых рубежей по шкале Progress v1 составляет 10.94 балла. Эти показатели измеряют разное, и ни один из них нельзя напрямую перевести в процент возможностей или разницу в удовлетворенности пользователей.
Увеличивается ли разрыв?#
Текущие ретроспективные данные не подтверждают «постоянное увеличение». В конце сентября 2026 года разрыв составлял 27.61, а 29 октября — 10.94; между этими датами он заметно сократился вслед за выходом новых моделей. Однако сближение передовых рубежей не означает, что ведущие группы уже имеют одинаковую глубину.
Сколько китайских моделей уже превзошли Opus 4.8?#
По Progress v1, при подсчете отдельных версий релизов и строгом превышении Opus 4.8(max), их 12, включая исторические версии. Из них 9 пока не отмечены AA как deprecated. Превышение референсного порога оценки не гарантирует победу над ним в каждой вашей задаче.
Почему не используются 61.4 балла Opus 4.8?#
61.4 получены по старому Intelligence Index на момент его выпуска; в текущем раунде v5 у этой модели нет общего балла. Сравнивать нужно по одной шкале, нельзя напрямую переносить историческое значение в новый рейтинг.
Достаточно ли китайские модели хороши для повседневного использования?#
Единого ответа только по признаку страны дать нельзя. В этом раунде некоторые модели справлялись с повседневными задачами, но ошибки шлюза, различия формата и обрезка из-за бюджета также меняли результаты. Исходите из собственных задач и допустимой частоты сбоев, выбирая конкретную модель и надежный путь вызова.
Доказывает ли этот тест, что китайские и американские модели ощущаются одинаково?#
Нет. Здесь были только 8 синтетических задач, по 2 вызова на каждую; у части запросов возникали псевдонимы версий и проблемы цепочки, а слепой оценки людьми не проводилось. Тест показал конкретные причины, по которым рейтинг и впечатления могут расходиться, но не доказал общую эквивалентность.
Чем отличаются версия релиза, конфигурация модели и имя API?#
У одной версии релиза AA может быть несколько уровней рассуждения; шлюз, в свою очередь, может использовать псевдонимы или постепенно переходить на новую версию. В рейтинге подсчет ведется после дедупликации версий релизов, а в практических тестах сохраняются фактическое имя запроса и возвращенное поле model; автоматического взаимно однозначного соответствия между ними нет.
Ссылки#
- Artificial Analysis Data API: поля, разбиение на страницы, версии и определения отсутствующих значений. Полный сбор данных выполнен 2026-10-29; API сообщает Intelligence версии 5.
- Artificial Analysis AI Trends: Progress, принадлежность к странам и версии релизов. Анонимный снимок общедоступной страницы от 2026-10-29; статистика в статье — повторные расчеты автора по этому снимку.
- Методология Artificial Analysis Progress Index v1. Шкала IRT, уровни и границы исторических сравнений.
- Объявление AA о выпуске Intelligence Index v5, 2026-10-27. Используется для объяснения изменений оценки, а не как замена актуальному рейтингу на 29 октября.
- Методология AA Intelligence Index и описание версий.
- Оценка AA при выпуске Opus 4.8, 2026-05-28 и текущая страница модели.
- Официальная страница выпуска Anthropic Opus 4.8.
Термины «превзошли» и «лидируют» в статье ограничены явно указанными шкалами и охваченной выборкой и не означают статистическую значимость. После дополнительных тестов, исправлений или добавления новых моделей в данные AA результаты потребуется пересчитать.