简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
Kimi K3.1 Pro frente a Kimi K3.1 Pro Highspeed: 30 pruebas reales para elegir entre velocidad y coste
En 30 llamadas emparejadas con la misma interfaz y nivel de razonamiento, comparamos aciertos, tiempos, espera hasta la respuesta y precios. Highspeed acelera cuatro tareas, pero no la de planificación.
Si tu tarea obliga al usuario a esperar, merece la pena empezar por una prueba emparejada de Kimi K3.1 Pro Highspeed; si Pro ya cumple tus requisitos de respuesta, la versión normal tiene un precio unitario menor. En las 30 llamadas de esta ronda, ambos modelos superaron 15/15 pruebas cada uno; en cuatro tareas habituales, las medianas del tiempo de finalización de Highspeed equivalen a una aceleración aproximada de 1,78–2,30 veces, pero en la tarea de planificación fue aproximadamente el doble de lento.
Todos los prompts de la evaluación estaban en chino. Esta edición presenta las mismas 30 solicitudes del 29 de octubre de 2026; no es una nueva evaluación en español. Crazyrouter es tanto la pasarela utilizada como el editor de este blog.
Por tanto, highspeed puede ser una opción para ganar velocidad, pero no garantiza que cada solicitud se acelere. Tampoco se puede deducir de su nombre que ambos modelos tengan exactamente las mismas capacidades, procesos de razonamiento o coste real por solicitud.
En esta ronda completamos 30 llamadas emparejadas con ambos modelos mediante la misma interfaz Chat Completions de Crazyrouter, y conservamos las respuestas finales, los ID de respuesta, los estados y el uso de tokens. Los precios y las rutas de las pruebas descritas a continuación corresponden al 29 de octubre de 2026; no representan las tarifas de conexión directa de Moonshot ni el rendimiento de una implementación del fabricante.
kimi-k3.1-pro frente a kimi-k3.1-pro-highspeed: ¿qué diferencias ha confirmado el fabricante?#
Kimi describe oficialmente Highspeed como una versión más adecuada para interacciones rápidas y afirma que su velocidad es de 2 a 3 veces la de Pro normal. Se trata de una afirmación de rendimiento del fabricante, que no puede traducirse directamente en una reducción de más de la mitad del tiempo de espera para cada solicitud de negocio. [1]
La documentación oficial de parámetros especifica que ambos se rigen por las restricciones de parámetros de la serie K3. [2]
| Elemento comparado | Kimi K3.1 Pro | Kimi K3.1 Pro Highspeed |
|---|---|---|
| Nombre exacto del modelo en la API | kimi-k3.1-pro | kimi-k3.1-pro-highspeed |
| Límite oficial de contexto | 1,048,576 tokens | Igual |
reasoning_effort | low / high / max, con max como valor predeterminado | Igual |
| Nivel de razonamiento de esta ronda | high | high |
| Presupuesto de salida de esta ronda | max_tokens=8192 | Igual |
| Descripción oficial de la velocidad | Versión de referencia | Se afirma que es de 2 a 3 veces la de Pro |
| Pruebas superadas en esta ronda | 15/15 | 15/15 |
La cifra de contexto procede de la documentación oficial de facturación; este artículo no probó entradas de un millón de tokens. [3] Que los parámetros coincidan tampoco demuestra que los pesos subyacentes, el esquema de cuantización, el hardware o la cantidad de cómputo utilizada en cada solicitud sean iguales; el material de esta prueba no basta para extraer conclusiones sobre esos detalles de implementación.
Si lo que quieres comparar es Pro con la generación anterior K3, se trata de otra cuestión; puedes consultar esta comparación de la actualización de K3.1 Pro frente a K3. La combinación de modelos y los resultados de ese artículo no se han mezclado con las estadísticas de esta ronda.
Cómo realizamos las 30 pruebas: primero controlamos las tareas y después comparamos la velocidad#
Primero consultamos la lista de modelos autorizados para confirmar que los dos ID exactos estaban visibles y después realizamos las llamadas. Que un modelo aparezca en la lista solo indica que la cuenta puede ver ese nombre; la finalización de la llamada se verificó mediante las respuestas posteriores.
| Configuración de la prueba | Valor utilizado en esta ronda |
|---|---|
| Base URL | https://cn.crazyrouter.com/v1 |
| Endpoint | POST /chat/completions |
| Modelos solicitados | Los dos ID exactos de la tabla anterior |
| Tareas y repeticiones | 5 tareas, 3 repeticiones por tarea y modelo, 30 llamadas en total |
| Razonamiento y presupuesto | reasoning_effort: "high", max_tokens: 8192 |
| Forma de devolución | stream: true, con usage devuelto al finalizar el flujo de la solicitud |
| Prompts y herramientas | Prompts idénticos para la misma tarea; sin herramientas externas ni mensajes system |
| Método de envío | Los dos modelos se ejecutaron en paralelo por pares para la misma tarea, con una concurrencia máxima de 2; el orden de envío se alternó por rondas |
| Tiempos de espera de conexión/lectura del cliente | 15 segundos / 180 segundos; se comprobó el tiempo acumulado en cada evento del flujo |
Las cinco tareas cubrieron los siguientes puntos de comprobación:
| Tarea | Criterio de evaluación |
|---|---|
| Conflictos entre registros y campos ausentes | Procesar actualizaciones y retractaciones de campos; usar null para proveedores desconocidos; ignorar instrucciones distractores incluidas en las notas |
| Extracción y deduplicación de JSON | Conservar el registro más reciente, ordenar por ID y convertir los importes con precisión a enteros expresados en céntimos |
| Combinación de intervalos semiabiertos en Python | Combinar solo solapamientos estrictos, normalizar extremos invertidos, descartar intervalos vacíos y no modificar la entrada; cada función se comprobó con 87 casos |
| Planificación óptima con dependencias | Minimizar el tiempo de finalización ponderado de siete tareas; la respuesta de referencia se generó mediante una búsqueda exhaustiva local |
| Salida JSON extensa | Generar íntegramente 80 objetos y comprobar uno por uno los números de secuencia enteros y sus valores al cuadrado |
Para considerar una prueba superada, se exigía HTTP 200, finish_reason="stop", recepción de [DONE] y una respuesta final que cumpliera las reglas de comprobación. No se registraron fallos HTTP, truncamientos, tiempos de espera agotados ni evaluaciones no superadas.
Aun así, solo hubo cinco tareas. Las tres repeticiones sirvieron para observar la variabilidad, no son tres problemas independientes; tampoco pueden contarse las 87 comprobaciones internas del código como 87 problemas para el modelo. La repetición de prompts puede generar almacenamiento en caché de prefijos, y los registros efectivamente muestran escrituras y lecturas de caché. Por tanto, este artículo no constituye una prueba comparativa con caché fría y no permite atribuir todas las diferencias de latencia al propio modelo.
Tiempo de respuesta completo: la versión rápida acelera cuatro tipos de tareas, pero la planificación es la excepción#
La tabla siguiente muestra la mediana de las tres solicitudes satisfactorias para cada modelo y tarea. La «aceleración» se calcula como tiempo de Pro ÷ tiempo de Highspeed; un valor mayor que 1 indica que Highspeed es más rápido y uno menor que 1, que es más lento.
| Tarea | Mediana del tiempo de finalización de Pro | Mediana del tiempo de finalización de Highspeed | Aceleración |
|---|---|---|---|
| Conflictos entre registros y límites de rechazo | 8,06 segundos | 3,93 segundos | 2,05× |
| Extracción estructurada y deduplicación | 8,51 segundos | 3,70 segundos | 2,30× |
| Combinación de intervalos semiabiertos en Python | 11,03 segundos | 6,21 segundos | 1,78× |
| Planificación óptima con dependencias | 33,88 segundos | 67,59 segundos | 0,50× |
| Salida JSON extensa y cálculo | 21,43 segundos | 9,82 segundos | 2,18× |
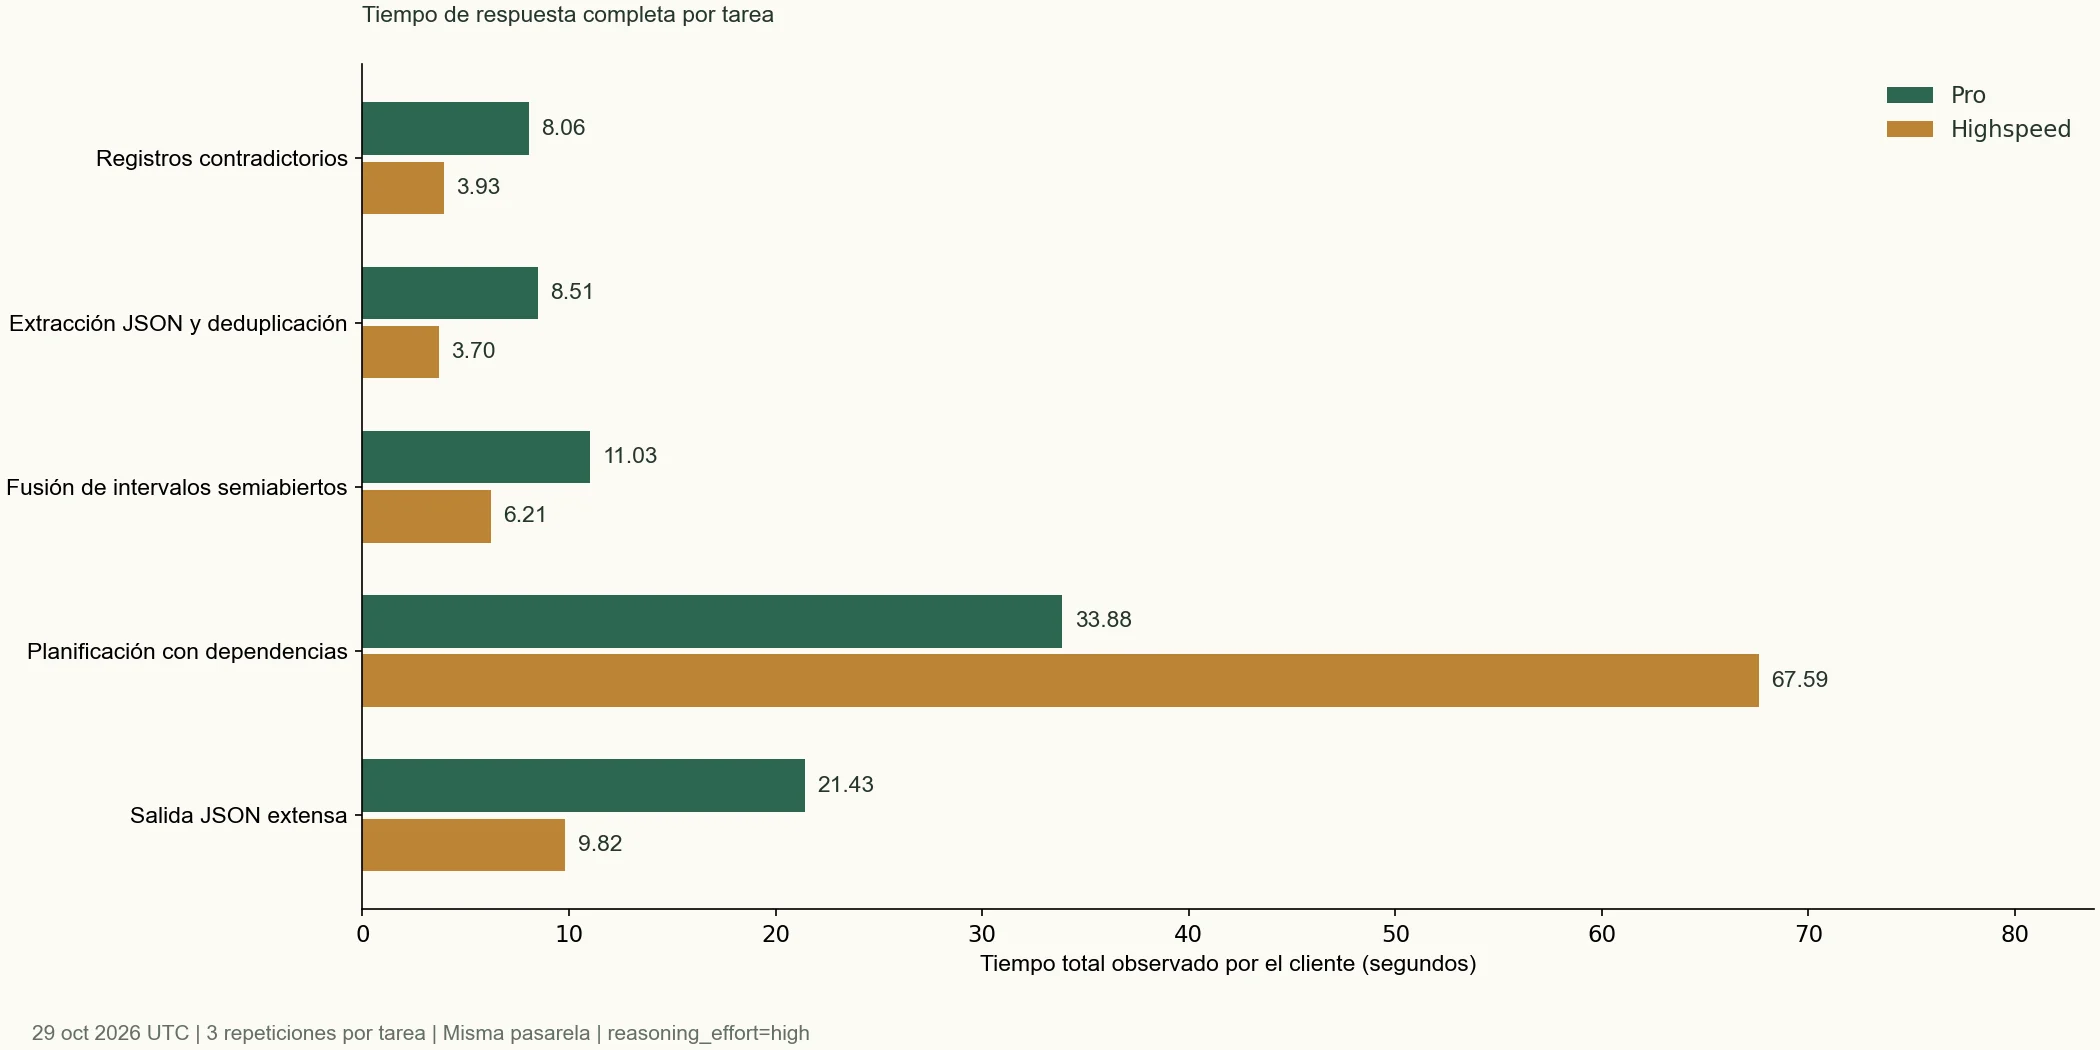
Las diferencias en la extracción estructurada y en la salida JSON de 80 elementos son las más fáciles de interpretar: al completar las mismas comprobaciones, la versión rápida redujo claramente la espera. La tarea de código también mejoró, pero sin llegar a ser «el doble de rápida cada vez»; en la primera ronda, las solicitudes de código tardaron 9,59 y 9,14 segundos, respectivamente, una diferencia muy pequeña.
En los 15 pares de solicitudes con la misma tarea y ronda, Highspeed fue más rápido en 11 pares. Entre los contraejemplos figuran la primera comprobación de registros y las tres pruebas de planificación. Esta proporción solo describe esta muestra; no representa la probabilidad de aceleración en un entorno de producción.
Ambos modelos entregaron resultados válidos en estas tareas con respuestas definidas y restricciones limitadas. No observamos ninguna degradación de calidad que las comprobaciones de esta ronda pudieran identificar, pero esto no basta para demostrar una calidad equivalente en redacción abierta, programación compleja o tareas prolongadas con agentes.
¿Por qué Highspeed fue más lento en la tarea de planificación?#
Veamos primero un par de respuestas reales de la primera ronda:
| Métrica | Pro | Highspeed |
|---|---|---|
| Tiempo de finalización | 39,82 segundos | 67,59 segundos |
completion_tokens | 1,097 | 4,178 |
De ellos, reasoning_tokens | 1,071 | 4,152 |
| Respuesta final de ambos | {"order":"BADGCFE","cost":307} | Igual |
| Evaluación | Superada | Superada |
Los ID de respuesta correspondientes son 8e4f8840-0af2-4981-880b-26f016ec63ba y 38a707dc-c53c-41c4-905f-4204b9c3d499. La respuesta de planificación se verificó mediante una búsqueda exhaustiva local; no se utilizó la respuesta de un modelo para juzgar la del otro.
El mismo nivel high no implica que las dos solicitudes generen la misma cantidad de tokens de razonamiento. En esta ocasión, la versión rápida generó más tokens de razonamiento, coincidiendo con una espera más larga. Esta observación explica por qué «generar más deprisa» y «terminar antes la tarea» no son equivalentes, pero no permite determinar que esta sea la única causa de la ralentización en el servidor.
La diferencia fue mayor en la segunda ronda de planificación: Pro tardó 30,16 segundos y la versión rápida, 121,22 segundos; en la tercera ronda, los tiempos fueron de 33,88 y 38,44 segundos. Las tres muestras respaldan que «la versión rápida fue más lenta en esta tarea», pero siguen sin bastar para generalizar que «la versión rápida no es buena en matemáticas o planificación».
El tiempo total medido en el cliente también incluye el trayecto de red, la espera en cola, la generación del razonamiento, la generación de la respuesta y el cierre del flujo. En esta ronda no medimos las colas del servidor ni el hardware, ni evaluamos la capacidad de concurrencia, por lo que no podemos interpretar toda la diferencia de tiempo total como throughput de decodificación.
Que el primer evento del flujo llegue pronto no significa que el usuario ya vea la respuesta#
En los modelos de razonamiento hay que distinguir al menos tres momentos:
- Primer evento no vacío de razonamiento o respuesta: cuándo empieza a llegar contenido después de la solicitud.
- Primer fragmento de la respuesta final: la primera vez que
delta.contentno está vacío; en este artículo lo denominamos «inicio de la respuesta». - Final de la respuesta completa: se ha recibido y procesado todo el flujo y se registra el estado final.
A continuación figuran las medianas del «inicio de la respuesta» en las tres llamadas. Es el momento en que el cliente recibe el primer content no vacío, no el momento en que el navegador lo renderiza.
| Tarea | Inicio de la respuesta de Pro | Inicio de la respuesta de Highspeed |
|---|---|---|
| Conflictos entre registros y límites de rechazo | 7,63 segundos | 3,92 segundos |
| Extracción estructurada y deduplicación | 7,65 segundos | 3,37 segundos |
| Combinación de intervalos semiabiertos en Python | 9,47 segundos | 5,55 segundos |
| Planificación óptima con dependencias | 33,64 segundos | 67,44 segundos |
| Salida JSON extensa y cálculo | 10,91 segundos | 5,80 segundos |
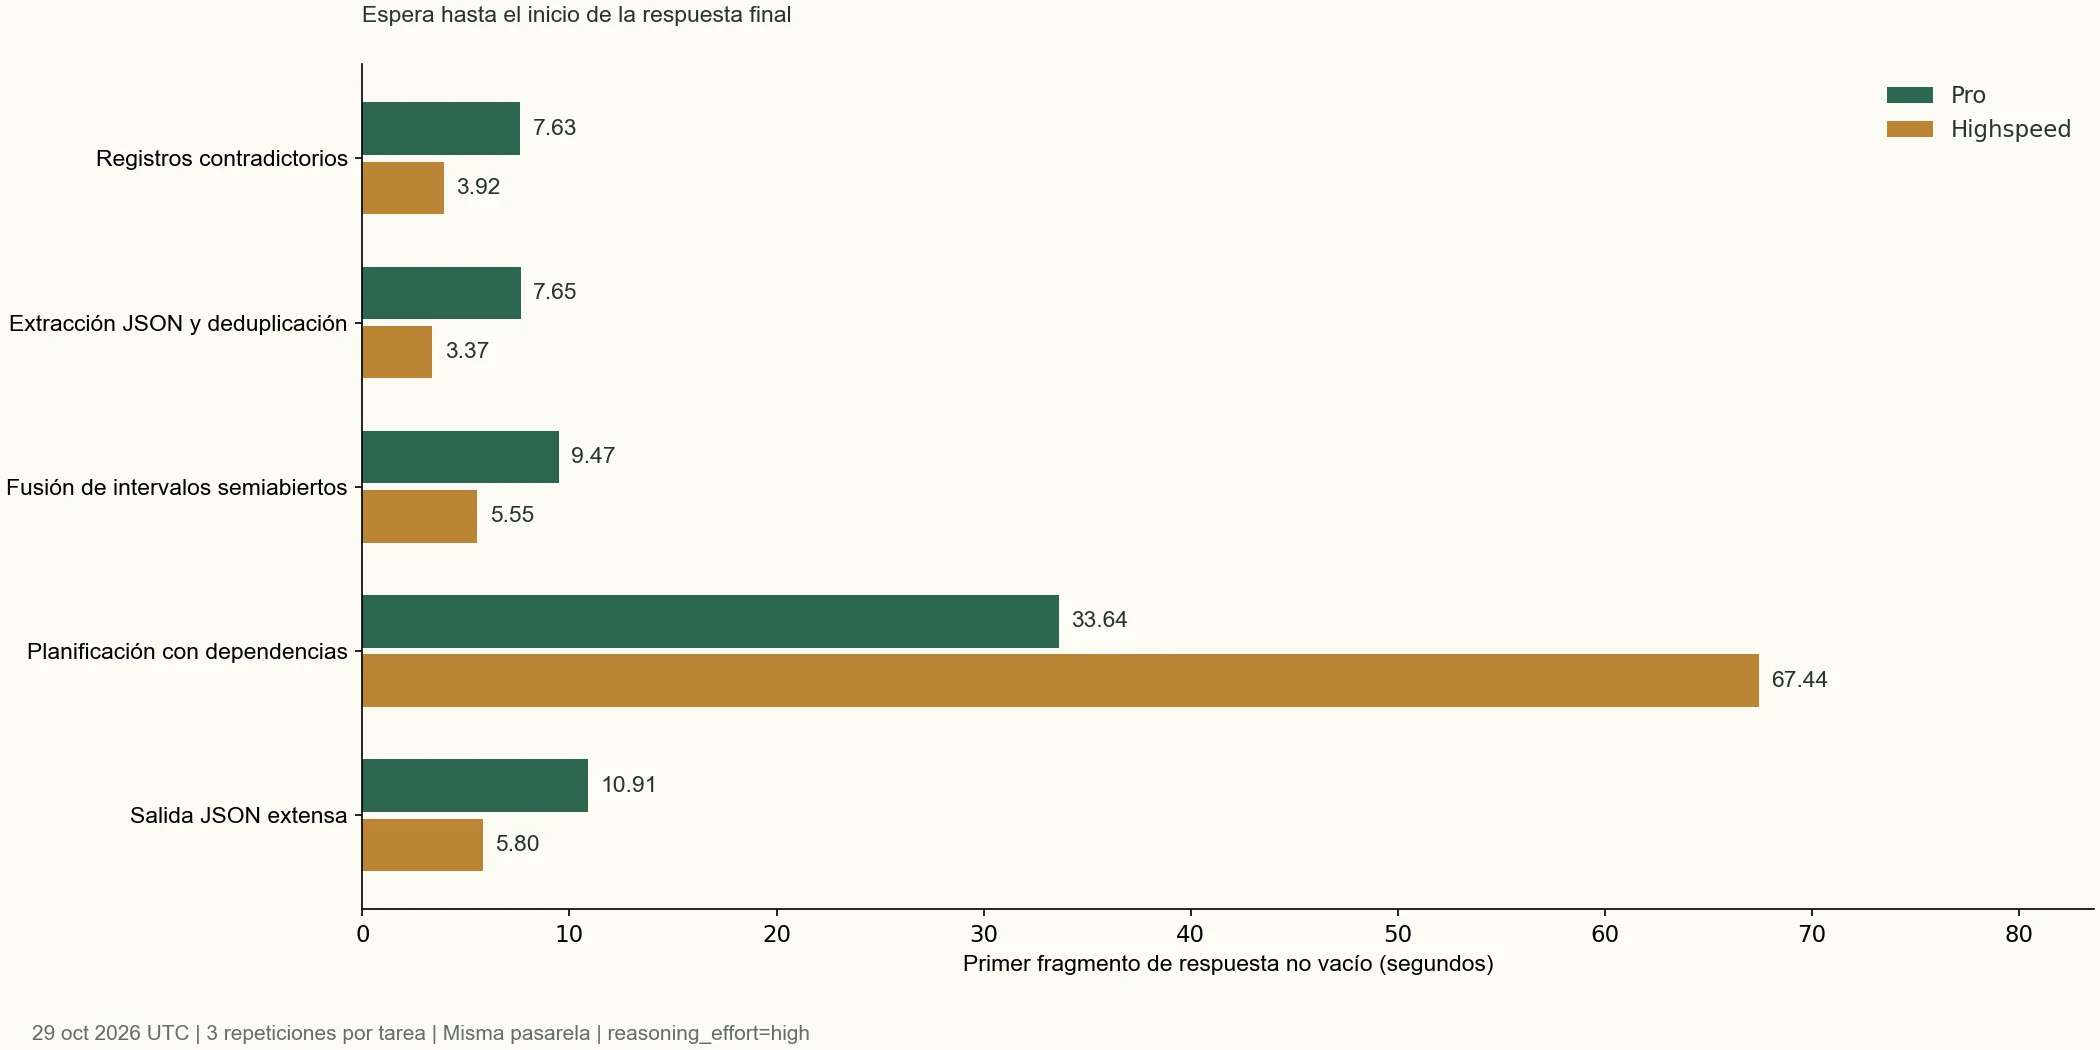
La planificación ilustra mejor esta distinción: la mediana hasta el primer evento de razonamiento o respuesta de Highspeed fue de aproximadamente 2,17 segundos, pero la respuesta final no empezó a aparecer hasta los 67,44 segundos. En Pro, las cifras correspondientes fueron 3,96 segundos y 33,64 segundos.
Si la interfaz solo muestra la respuesta final, el usuario experimenta esta última espera. Aunque la interfaz muestre «pensando», no se puede considerar que el fragmento de razonamiento más temprano signifique que el resultado de negocio ya está disponible. En esta ronda no conservamos ni publicamos el texto completo del razonamiento; solo registramos los recuentos y tiempos pertinentes.
Comparación de precios: el doble por unidad en entrada y salida normales, y el mismo precio de lectura de caché#
A continuación figuran las tarifas públicas de Crazyrouter leídas el 29 de octubre de 2026, con un multiplicador de 1 para el grupo default. Todas las unidades son USD por millón de tokens. Se trata de precios de lista de la pasarela, que no deben presentarse como tarifas oficiales de conexión directa de Moonshot. [4]
| Concepto facturable | kimi-k3.1-pro | kimi-k3.1-pro-highspeed |
|---|---|---|
| Entrada normal | $2.00 | $4.00 |
| Salida | $10.00 | $20.00 |
| Lectura de caché | $0.20 | $0.20 |
| Escritura en caché, 5 minutos | $2.00 | $4.00 |
| Escritura en caché, 1 hora | $4.00 | $8.00 |
Las tarifas proceden del campo tiered_expr de la interfaz de precios y se cotejaron con la implementación de facturación del repositorio. No se dedujeron precios unitarios a partir del campo de compatibilidad model_ratio, que tiene el mismo valor en ambos modelos. El texto legible de la página oficial de facturación de Kimi no ofrecía en esta ocasión una tabla verificable de precios unitarios por modelo, por lo que este artículo no añade unos supuestos «precios oficiales».
Supongamos una solicitud sin ninguna caché, con 1,000 tokens de entrada normal y 1,000 tokens de salida facturable. Según la tabla, Pro costaría aproximadamente 0.024. Pero esto solo compara un uso idéntico de tokens; en una solicitud real, la cantidad de razonamiento, los aciertos de caché y las reglas de la cuenta modificarán la factura.
La primera ronda de planificación ofrece un ejemplo más útil: prompt_tokens fue de 225 en ambos modelos, sin lecturas ni escrituras de caché registradas, pero completion_tokens fue de 1,097 y 4,178, respectivamente. Aplicando la tabla anterior, el coste teórico sería de aproximadamente 0.08446, una diferencia de alrededor de 7,40 veces. Es una estimación basada en el uso de la respuesta y los precios de lista, no un cargo liquidado en la cuenta.
Por tanto, que «la versión rápida tenga un precio unitario doble» no significa que «el coste total de cada solicitud sea siempre el doble». En particular, no se debe estimar el coste solo por la longitud del pequeño fragmento final de JSON; en esta ronda, completion_tokens incluye los tokens de razonamiento.
Antes de elegir, puedes consultar la comparación de precios actual de los modelos y la página de integración de la serie Moonshot. Estas páginas ofrecen puntos de consulta; las cifras de este artículo se basan en la instantánea de la interfaz de precios conservada durante esta ronda.
¿Cómo cambiar en la API? Conserva los parámetros y valida por separado el resultado final#
En las solicitudes de texto individuales de esta ronda, el cliente solo tuvo que cambiar model para comparar ambos modelos mediante la misma interfaz. Utilizamos reasoning_effort en el nivel superior, omitimos ajustes de muestreo como temperature y top_p, y no pasamos la configuración thinking de la serie K2.
El ejemplo completo de Python que aparece a continuación se ejecutó y verificó por separado; ambos modelos devolvieron {"answer":391}, con estado stop y recepción del marcador de fin del flujo. Estas dos llamadas son ejemplos independientes de conectividad y no se incluyeron en las 30 evaluaciones anteriores. Las 30 solicitudes originales de la evaluación utilizaron prompts en chino el 29 de octubre de 2026. Para cumplir los requisitos lingüísticos de este artículo, el código siguiente plantea en inglés el mismo problema de multiplicación y se verificó por separado; no reproduce literalmente la entrada del prompt original en chino. Antes de ejecutarlo, instala requests y proporciona las credenciales mediante la variable de entorno CRAZYROUTER_API_KEY.
El prompt en inglés del ejemplo se verificó por separado con ambos modelos. Plantea la misma multiplicación que el ejemplo chino original, con otra redacción. Estas dos comprobaciones no forman parte de las 30 solicitudes ni reproducen literalmente el prompt original.
"""Endpoint smoke example; set CRAZYROUTER_API_KEY. Separate from 30 benchmark calls."""
import json
import os
import time
import requests

BASE_URL = 'https://cn.crazyrouter.com/v1'
PROMPT = 'Output only a JSON object with the key answer and the integer result of 17 multiplied by 23. No Markdown or explanation.'

def main():
    session = requests.Session()
    session.trust_env = False
    for model in ('kimi-k3.1-pro', 'kimi-k3.1-pro-highspeed'):
        started = time.perf_counter()
        response = session.post(
            BASE_URL + '/chat/completions',
            headers={'Authorization': 'Bearer ' + os.environ['CRAZYROUTER_API_KEY']},
            json={
                'model': model,
                'messages': [{'role': 'user', 'content': PROMPT}],
                'reasoning_effort': 'high',
                'max_tokens': 8192,
                'stream': True,
                'stream_options': {'include_usage': True},
            },
            timeout=(15, 180),
            stream=True,
        )
        response.raise_for_status()
        content, finish_reason, response_id, done = '', None, None, False
        for line in response.iter_lines(chunk_size=1):
            if not line.startswith(b'data:'):
                continue
            raw = line[5:].strip()
            if raw == b'[DONE]':
                done = True
                break
            event = json.loads(raw)
            if event.get('error'):
                raise RuntimeError(event['error'])
            response_id = event.get('id', response_id)
            for choice in event.get('choices', []):
                content += (choice.get('delta') or {}).get('content') or ''
                finish_reason = choice.get('finish_reason') or finish_reason
        response.close()
        assert done and finish_reason == 'stop' and json.loads(content) == {'answer': 391}
        print(json.dumps({'model': model, 'id': response_id, 'finish_reason': finish_reason,
                          'content': content, 'seconds': round(time.perf_counter()-started, 3)},
                         ensure_ascii=False))

if __name__ == '__main__':
    main()
Los ID de respuesta del ejemplo de esta ronda son 12818d48-89e1-4c2e-b7c8-aeeec5a1bbfa y 8f7e5a17-cc9b-495f-bee6-9e00110f6bee. Una nueva ejecución generará otros ID de respuesta, y los espacios de la salida y los tiempos también pueden variar.
El ejemplo sirve para comprobar los ID de modelo, el análisis del flujo y el contenido final. La evaluación completa también registró usage, el tiempo hasta el primer fragmento de contenido, las rondas emparejadas y los motivos de la evaluación; esta sencilla multiplicación no debe utilizarse como evaluación de capacidades.
Las conversaciones de varios turnos requieren un tratamiento adicional del historial de mensajes. La documentación oficial exige devolver intactos el mensaje completo de assistant y su reasoning_content; este artículo solo verificó texto de un turno, no llamadas a herramientas en varios turnos. Al integrarlo en un cliente existente, puedes empezar por la guía de integración y comprobar los ID en la lista actual de modelos de tu cuenta. No deduzcas los parámetros de la interfaz únicamente a partir de los nombres mostrados en el catálogo de modelos.
¿Qué tareas justifican cambiar a Highspeed y cuáles pueden seguir usando Pro?#
| Tu escenario | Decisión que permiten las pruebas de esta ronda |
|---|---|
| Extracción estructurada y comprobación de campos con usuarios esperando | Prioriza Highspeed entre los candidatos; la mediana de espera se redujo claramente en esta ronda, pero aún debes comprobar la calidad con muestras de tu negocio |
| JSON con reglas claras y salida extensa | Merece la pena probar Highspeed; la salida completa de 80 elementos mostró una aceleración aproximada de 2,18 veces |
| Generación de funciones pequeñas con pruebas automáticas | Conviene conservar ambos; primero deben superar las pruebas y después se comparan espera y coste |
| Tareas sin conexión en las que Pro ya cumple el plazo actual | Compara primero el coste total; terminar antes no siempre aporta un beneficio empresarial adicional |
| Planificación combinatoria similar a la de esta ronda | Conserva Pro por ahora; la versión rápida fue más lenta en los tres pares de esta tarea, y conviene ampliar el conjunto para confirmarlo |
| Contexto extenso, multimodalidad, agentes con herramientas o alta concurrencia | Esta ronda no los cubrió; debes crear pruebas específicas y no aplicar directamente estos resultados |
Para una aplicación existente, lo más prudente es conservar las configuraciones de ambos modelos y compararlos con una muestra de tareas reales. Define primero la precisión mínima, la espera admisible y el coste por tarea, y después decide si alguna categoría de solicitudes debe pasar a la versión rápida. Para observar la latencia de cola, aumenta la muestra; tres llamadas por tarea no permiten informar de un P95 representativo.
FAQ#
kimi-k3.1-pro frente a kimi-k3.1-pro-highspeed: ¿cuál es mejor?#
Depende de tu presupuesto de espera y de la tarea. En esta ronda, ambos superaron 15/15 pruebas; la versión rápida tuvo medianas de tiempo menores en cuatro tareas, pero fue más lenta en planificación y generó más tokens de salida. No hay un ganador universal para todas las tareas.
¿Highspeed es siempre de 2 a 3 veces más rápido?#
No es una garantía para cada solicitud. El fabricante formula una afirmación de rendimiento de 2 a 3 veces; en esta ronda, 11 de los 15 pares de llamadas fueron más rápidos, mientras que la primera comprobación de registros y las tres pruebas de planificación fueron contraejemplos.
¿Highspeed reduce la calidad de las respuestas?#
Las comprobaciones de esta ronda no detectaron una degradación de calidad: las 15 pruebas de cada modelo se superaron. Sin embargo, solo hubo cinco tareas limitadas, sin redacción subjetiva, grandes repositorios de código ni agentes de flujos prolongados, por lo que no se puede garantizar la misma calidad en todos los escenarios.
¿Los dos modelos utilizan los mismos pesos?#
Este artículo no dispone de pruebas suficientes para confirmarlo. La documentación oficial indica que ambos tienen las mismas restricciones de parámetros de la serie K3 y destaca el posicionamiento de Highspeed en velocidad; que los parámetros coincidan no significa que hayamos verificado los pesos o los detalles de implementación.
¿Tienen el mismo contexto y los mismos niveles de razonamiento?#
Según los parámetros oficiales y la documentación de facturación, ambos ofrecen un contexto de 1,048,576 tokens y admiten low, high y max, con max como valor predeterminado. Esta ronda solo probó textos cortos con el nivel high; no verificó escenarios de un millón de tokens.
¿Cuánto más cara es la versión rápida?#
En las tarifas del grupo default de Crazyrouter de esta ronda, los precios unitarios de entrada y salida normales son el doble que los de Pro, mientras que la lectura de caché cuesta lo mismo. El coste total de una solicitud también depende de los tokens reales de salida y razonamiento, de la caché y de las reglas de la cuenta; no basta con multiplicar por dos.
Si ya aparece contenido en streaming, ¿por qué hay que seguir esperando tanto?#
El primer contenido puede ser reasoning_content, mientras que la respuesta final comienza en content. En la planificación de esta ronda, la versión rápida empezó a entregar eventos no vacíos de razonamiento o respuesta a los 2,17 segundos aproximadamente, pero la mediana del inicio de la respuesta fue de 67,44 segundos.
¿Se pueden atribuir directamente estas velocidades a la API oficial de Moonshot?#
No. Este artículo midió la ruta completa desde el cliente especificado hasta la pasarela Crazyrouter, incluidos los efectos del enlace y del proveedor upstream; no se realizó un control emparejado con una conexión directa al fabricante.
Recomendación de adopción#
Pagar por Highspeed debería traducirse en una reducción verificable de la espera de negocio. En esta ronda, el tratamiento de campos, el código breve y la salida JSON extensa dieron resultados positivos; la tarea de planificación demuestra que pueden coincidir un inicio de generación más temprano, más tokens de razonamiento y una respuesta que termina más tarde.
Si tu aplicación ya tiene una configuración estable de Pro, utiliza problemas de producción para comprobar simultáneamente la precisión, el tiempo hasta el inicio de la respuesta, el tiempo de finalización completo y el uso de tokens. Cambia por categorías solo después de que la versión rápida cumpla tus objetivos de plazo y coste.
Fuentes y anexos de las pruebas#
Fuentes#
- Kimi oficial: notas de publicación de K3.1 Pro, consultado el 2026-10-29; las cifras de velocidad son declaraciones del fabricante.
- Kimi oficial: comparación de parámetros de los modelos, consultado el 2026-10-29; esta ronda solo verificó solicitudes de texto de un turno con el nivel high.
- Kimi oficial: documentación de facturación de modelos, utilizada para comprobar el contexto y los conceptos de facturación, no como fuente de los precios unitarios por modelo de este artículo.
GET https://crazyrouter.com/api/pricing, instantánea UTC del 2026-10-29; el modo de facturación estiered_expr, y las expresiones concretas y la instantánea original están archivadas por la redacción.
Resultados de cada solicitud#
Las 30 solicitudes devolvieron HTTP 200, terminaron con stop, emitieron [DONE] y superaron las comprobaciones. Pro y Highspeed corresponden a los identificadores exactos indicados arriba. Los tokens de salida incluyen los de razonamiento. Las rondas empiezan en 1.
| Tarea | Modelo | Ronda | Total (s) | Inicio de respuesta (s) | Tokens de salida | Tokens de razonamiento |
|---|---|---|---|---|---|---|
| Registros contradictorios | Pro | 1 | 5.32 | 5.03 | 151 | 113 |
| Registros contradictorios | Highspeed | 1 | 6.35 | 6.22 | 172 | 134 |
| Registros contradictorios | Pro | 2 | 9.89 | 8.67 | 342 | 304 |
| Registros contradictorios | Highspeed | 2 | 3.46 | 3.28 | 104 | 66 |
| Registros contradictorios | Pro | 3 | 8.06 | 7.63 | 303 | 265 |
| Registros contradictorios | Highspeed | 3 | 3.93 | 3.92 | 191 | 153 |
| Extracción JSON y deduplicación | Pro | 1 | 8.51 | 7.65 | 300 | 235 |
| Extracción JSON y deduplicación | Highspeed | 1 | 2.70 | 2.44 | 153 | 88 |
| Extracción JSON y deduplicación | Pro | 2 | 7.32 | 6.37 | 159 | 94 |
| Extracción JSON y deduplicación | Highspeed | 2 | 3.77 | 3.43 | 162 | 97 |
| Extracción JSON y deduplicación | Pro | 3 | 8.91 | 8.24 | 250 | 185 |
| Extracción JSON y deduplicación | Highspeed | 3 | 3.70 | 3.37 | 190 | 125 |
| Fusión de intervalos semiabiertos | Pro | 1 | 9.59 | 7.67 | 359 | 227 |
| Fusión de intervalos semiabiertos | Highspeed | 1 | 9.14 | 8.32 | 514 | 384 |
| Fusión de intervalos semiabiertos | Pro | 2 | 12.37 | 10.64 | 369 | 237 |
| Fusión de intervalos semiabiertos | Highspeed | 2 | 6.21 | 5.55 | 377 | 247 |
| Fusión de intervalos semiabiertos | Pro | 3 | 11.03 | 9.47 | 334 | 209 |
| Fusión de intervalos semiabiertos | Highspeed | 3 | 5.72 | 4.98 | 309 | 161 |
| Planificación con dependencias | Pro | 1 | 39.82 | 39.60 | 1097 | 1071 |
| Planificación con dependencias | Highspeed | 1 | 67.59 | 67.44 | 4178 | 4152 |
| Planificación con dependencias | Pro | 2 | 30.16 | 29.96 | 810 | 784 |
| Planificación con dependencias | Highspeed | 2 | 121.22 | 121.06 | 6704 | 6678 |
| Planificación con dependencias | Pro | 3 | 33.88 | 33.64 | 980 | 954 |
| Planificación con dependencias | Highspeed | 3 | 38.44 | 38.34 | 2620 | 2594 |
| Salida JSON extensa | Pro | 1 | 23.35 | 12.80 | 1214 | 509 |
| Salida JSON extensa | Highspeed | 1 | 9.82 | 5.80 | 1180 | 475 |
| Salida JSON extensa | Pro | 2 | 21.43 | 10.91 | 1121 | 416 |
| Salida JSON extensa | Highspeed | 2 | 10.47 | 5.91 | 1174 | 469 |
| Salida JSON extensa | Pro | 3 | 21.26 | 10.83 | 1127 | 422 |
| Salida JSON extensa | Highspeed | 3 | 9.32 | 5.34 | 1148 | 443 |
El archivo editorial conserva los prompts originales en chino, las respuestas esperadas y finales, los identificadores, los evaluadores y la instantánea de precios. Esta página publica las métricas de las 30 solicitudes y un ejemplo ejecutable de conexión. No ofrece la descarga del expediente completo ni expone el razonamiento íntegro.