简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
Kimi K3.1 Pro vs Kimi K3.1 Pro Highspeed:30回の実測で速度とコストを比較
同一API・同一推論設定で30回呼び出し、タスク合格率、完了時間、回答開始までの待ち時間、ゲートウェイ価格を比較。Highspeedは4類の通常タスクで高速だった一方、スケジューリングでは逆転。全データと再現コード付き。
ユーザーに待ち時間が発生するタスクなら、Kimi K3.1 Pro Highspeedをまずペアテストする価値があります。Proですでに応答要件を満たしているなら、通常版の方が単価は低くなります。今回の30回の呼び出しでは、両モデルとも15/15回に合格。Highspeedは4類の通常タスクで、完了時間の中央値から約1.78~2.30倍の高速化が見られましたが、スケジューリング問題では約2倍遅くなりました。
元のベンチマークでは、すべて中国語のプロンプトを使用しました。本記事は2026年10月29日の同じ30件の結果を日本語で紹介するもので、日本語による追加テストではありません。Crazyrouterは検証に使ったAPIゲートウェイであり、本ブログの発行者でもあります。
したがって、highspeedは高速化の選択肢にはなっても、すべてのリクエストで高速になる保証ではありません。名称だけを見て、両モデルの能力、推論過程、実際の1回あたりの費用が完全に同じだと断定することもできません。
今回はCrazyrouterの同一Chat Completions APIを使い、両モデルのペア呼び出しを計30回行い、最終回答、レスポンスID、ステータス、トークン使用量を保存しました。以下の価格と実測経路は2026年10月29日時点のものであり、Moonshotへの直接接続時の料金や、純正環境でのデプロイ性能を示すものではありません。
kimi-k3.1-pro vs kimi-k3.1-pro-highspeed:公式に確認できる違いは?#
Kimi公式はHighspeedを高速なインタラクションにより適したバージョンと説明し、通常のProの2~3倍の速度だと主張しています。これはベンダーによる性能主張であり、すべての業務リクエストで待ち時間が半分以上短くなると直接換算できるものではありません。 [1]
公式のパラメータドキュメントでは、両者ともK3シリーズのパラメータ制約に従うことが明記されています。 [2]
| 比較項目 | Kimi K3.1 Pro | Kimi K3.1 Pro Highspeed |
|---|---|---|
| 正確なAPIモデル名 | kimi-k3.1-pro | kimi-k3.1-pro-highspeed |
| 公式コンテキスト上限 | 1,048,576 tokens | 同じ |
reasoning_effort | low / high / max、デフォルトはmax | 同じ |
| 今回の推論設定 | high | high |
| 今回の出力上限 | max_tokens=8192 | 同じ |
| 公式の速度説明 | 比較対象のバージョン | Proの2~3倍と主張 |
| 今回の合格状況 | 15/15 | 15/15 |
コンテキストの数値は公式の課金説明に基づきます。本記事では100万トークンの入力はテストしていません。 [3] また、パラメータが一致していても、基盤となる重み、量子化方式、ハードウェア、リクエストごとの計算量が同じだとは証明できません。今回の資料では、これらの実装詳細について結論を出すには不十分です。
Proと前世代のK3を比較したい場合は、別の論点です。K3.1 ProとK3のアップグレード比較を参照してください。そちらのモデル組み合わせとテスト結果は、今回の統計には含めていません。
30回のテスト方法:タスク条件をそろえてから速度を比較#
まず認証済みのモデル一覧を照会し、2つの正確なIDが表示されることを確認してから、実際に呼び出しました。モデル一覧に表示されることは、そのアカウントで名称を確認できることを意味するだけです。呼び出しが完了したかどうかは、後続のレスポンスで検証しました。
| テスト設定 | 今回使用した値 |
|---|---|
| Base URL | https://cn.crazyrouter.com/v1 |
| Endpoint | POST /chat/completions |
| リクエストモデル | 上表の2つの正確なID |
| タスクと反復 | 5タスク、各モデル・各問題を3回、計30回 |
| 推論と出力上限 | reasoning_effort: "high"、max_tokens: 8192 |
| 返却方式 | stream: true、リクエストストリームの終了時にusageを返却 |
| プロンプトとツール | 同一問題のプロンプトは完全に同一。外部ツールやsystemメッセージはなし |
| 投入方式 | 同一問題の2モデルをペアで並列実行、最大同時実行数2。投入順はラウンドごとに交代 |
| クライアントの接続/読み取りタイムアウト | 15秒/180秒。各ストリームイベントで累計経過時間を確認 |
5つのタスクで確認した内容は次のとおりです。
| タスク | 判定内容 |
|---|---|
| レコードの競合と欠落フィールド | フィールドの更新と撤回を処理。未知のサプライヤーはnullとし、付注内の妨害指示は無視 |
| JSON抽出と重複排除 | 最新レコードを保持し、ID順に並べ、金額を整数のセントへ正確に変換 |
| Pythonによる半開区間の統合 | 厳密に重なる場合のみ統合、逆転した端点を正規化、空区間を破棄、入力を変更しない。各関数を87件のケースで確認 |
| 依存関係付き最適スケジューリング | 7タスクの加重完了時間を最小化。正解はローカルの全探索で生成 |
| 長いJSON出力 | 80個のオブジェクトを完全に生成し、整数の連番と平方値を項目ごとに照合 |
「合格」には、HTTP 200、finish_reason="stop"、[DONE]の受信に加え、最終回答が検査ルールを満たすことが必要です。今回、HTTPエラー、切り詰め、タイムアウト、判定不合格の記録はありませんでした。
それでもタスクは5問だけです。3回の反復はばらつきを観察するためのもので、独立した3問ではありません。コードの87件の内部検査を、87問のモデル課題として数えることもできません。プロンプトの反復によりプレフィックスキャッシュが生じる可能性があり、実際、記録にはキャッシュ書き込みとキャッシュヒットが見られました。したがって、本記事はコールドキャッシュのベンチマークではなく、レイテンシ差のすべてをモデル自体に帰属させることもできません。
完全なレスポンス時間:Highspeedは4類のタスクで高速、例外はスケジューリング#
下表は、モデル・問題ごとに成功した3回のリクエストの中央値です。「高速化倍率」はProの所要時間÷Highspeedの所要時間で、1より大きければHighspeedが高速、1より小さければ低速です。
| タスク | Pro完了時間の中央値 | Highspeed完了時間の中央値 | 高速化倍率 |
|---|---|---|---|
| レコード競合と拒否応答の境界 | 8.06秒 | 3.93秒 | 2.05× |
| 構造化抽出と重複排除 | 8.51秒 | 3.70秒 | 2.30× |
| Pythonによる半開区間の統合 | 11.03秒 | 6.21秒 | 1.78× |
| 依存関係付き最適スケジューリング | 33.88秒 | 67.59秒 | 0.50× |
| 長いJSON出力と計算 | 21.43秒 | 9.82秒 | 2.18× |
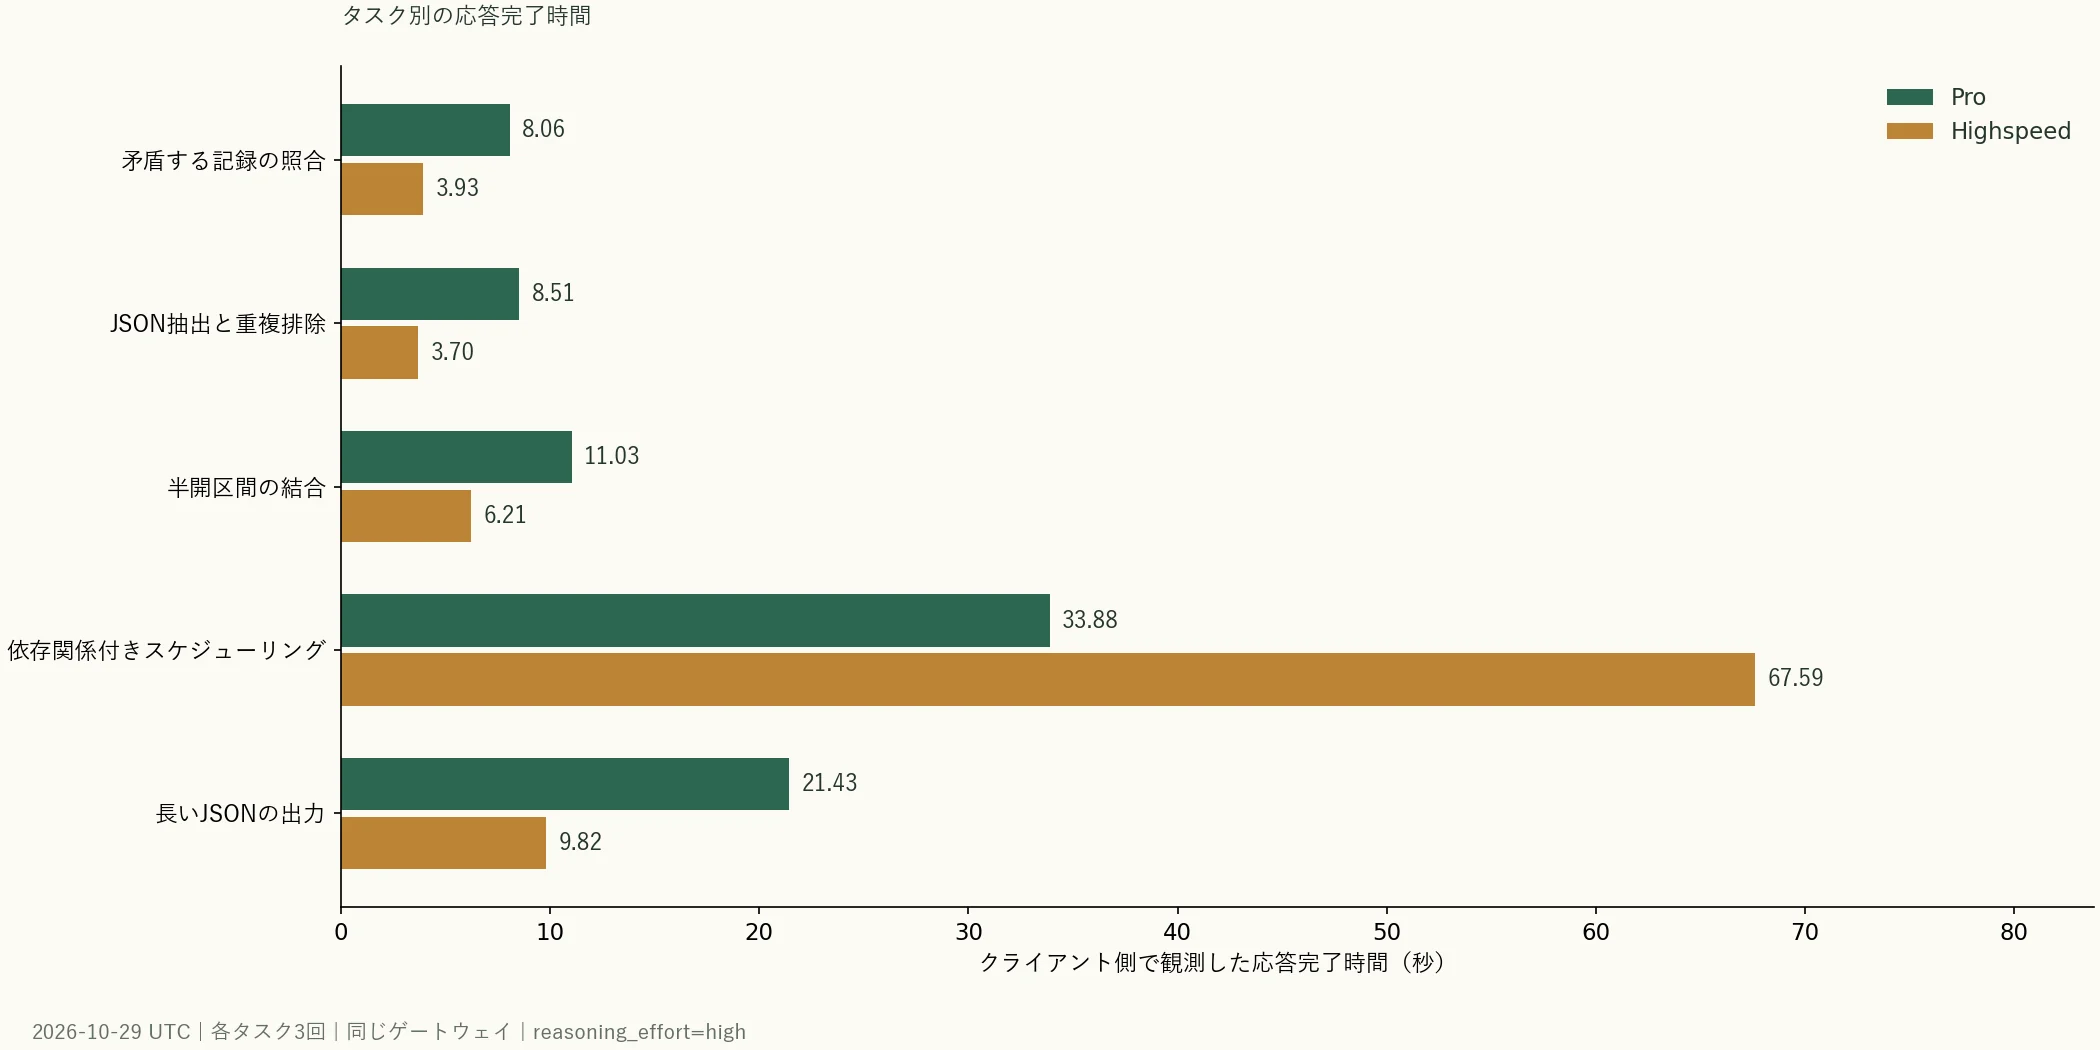
構造化抽出と80項目のJSON出力では、差が最も分かりやすく表れました。同じ検査に合格しながら、Highspeedは待ち時間を大幅に短縮しています。コード問題でも改善はありましたが、「毎回2倍高速」には届きませんでした。第1ラウンドのコードリクエストはそれぞれ9.59秒と9.14秒で、差はごくわずかでした。
同一問題・同一ラウンドの15ペアのうち、Highspeedが高速だったのは11ペアです。反例には、1回目のレコード照合と、3回すべてのスケジューリングが含まれます。この比率は今回のサンプル群を説明するものにすぎず、本番環境で高速化する確率ではありません。
両モデルとも、回答が明確で制約が限定的なこれらのタスクでは、合格水準の結果を出力しました。今回の検査で識別できる品質低下は観察されませんでしたが、これだけでは、自由記述、複雑なコーディング、長時間のAgentタスクで品質が同等だとは証明できません。
なぜHighspeedはスケジューリング問題でかえって遅くなったのか?#
まず、第1ラウンドの実際のレスポンスのペアを見ます。
| 指標 | Pro | Highspeed |
|---|---|---|
| 完了時間 | 39.82秒 | 67.59秒 |
completion_tokens | 1,097 | 4,178 |
うちreasoning_tokens | 1,071 | 4,152 |
| 両者の最終回答 | {"order":"BADGCFE","cost":307} | 同じ |
| 判定 | 合格 | 合格 |
対応するレスポンスIDは、それぞれ8e4f8840-0af2-4981-880b-26f016ec63baと38a707dc-c53c-41c4-905f-4204b9c3d499です。スケジューリングの回答はローカルの全探索で検証しており、一方のモデルの回答でもう一方を評価したわけではありません。
**同じhigh設定でも、2回のリクエストで生成される推論トークン数が同じになるわけではありません。**今回、Highspeedはより多くの推論トークンを生成し、同時に待ち時間も長くなりました。この観察結果は、「生成速度が速いこと」と「タスクが早く終わること」が等しくない理由を説明できます。ただし、これだけでサーバー側が遅くなった唯一の原因を特定することはできません。
第2ラウンドのスケジューリングでは差がさらに開き、Proが30.16秒、Highspeedが121.22秒でした。第3ラウンドは33.88秒と38.44秒です。3つのサンプルはいずれも「この問題ではHighspeedが低速」であることを裏づけますが、「Highspeedは数学や計画が苦手」と一般化するには不十分です。
クライアント側のより完全な所要時間には、ネットワーク往復、キュー待ち、推論生成、回答生成、ストリームの終了処理も含まれます。今回はサーバー側のキュー待ちやハードウェアの計測を行っておらず、同時実行容量も測定していません。そのため、総所要時間の差をすべてデコードスループットで説明することはできません。
最初のストリームイベントが速くても、ユーザーが回答を見たことにはならない#
推論モデルでは、少なくとも次の3つの時点を区別する必要があります。
- 最初の空でない推論または回答イベント:リクエスト後、いつコンテンツの受信が始まるか。
- 最終回答の最初の断片:
delta.contentが初めて空でなくなる時点。本記事では「回答開始」と略称。 - 完全なレスポンスの終了:ストリームの受信と処理を完了し、最終ステータスを記録した時点。
以下は、3回の呼び出しにおける「回答開始」の中央値です。クライアントが最初の空でないcontentを受信した時点であり、ブラウザで実際にレンダリングされた時点ではありません。
| タスク | Pro回答開始 | Highspeed回答開始 |
|---|---|---|
| レコード競合と拒否応答の境界 | 7.63秒 | 3.92秒 |
| 構造化抽出と重複排除 | 7.65秒 | 3.37秒 |
| Pythonによる半開区間の統合 | 9.47秒 | 5.55秒 |
| 依存関係付き最適スケジューリング | 33.64秒 | 67.44秒 |
| 長いJSON出力と計算 | 10.91秒 | 5.80秒 |
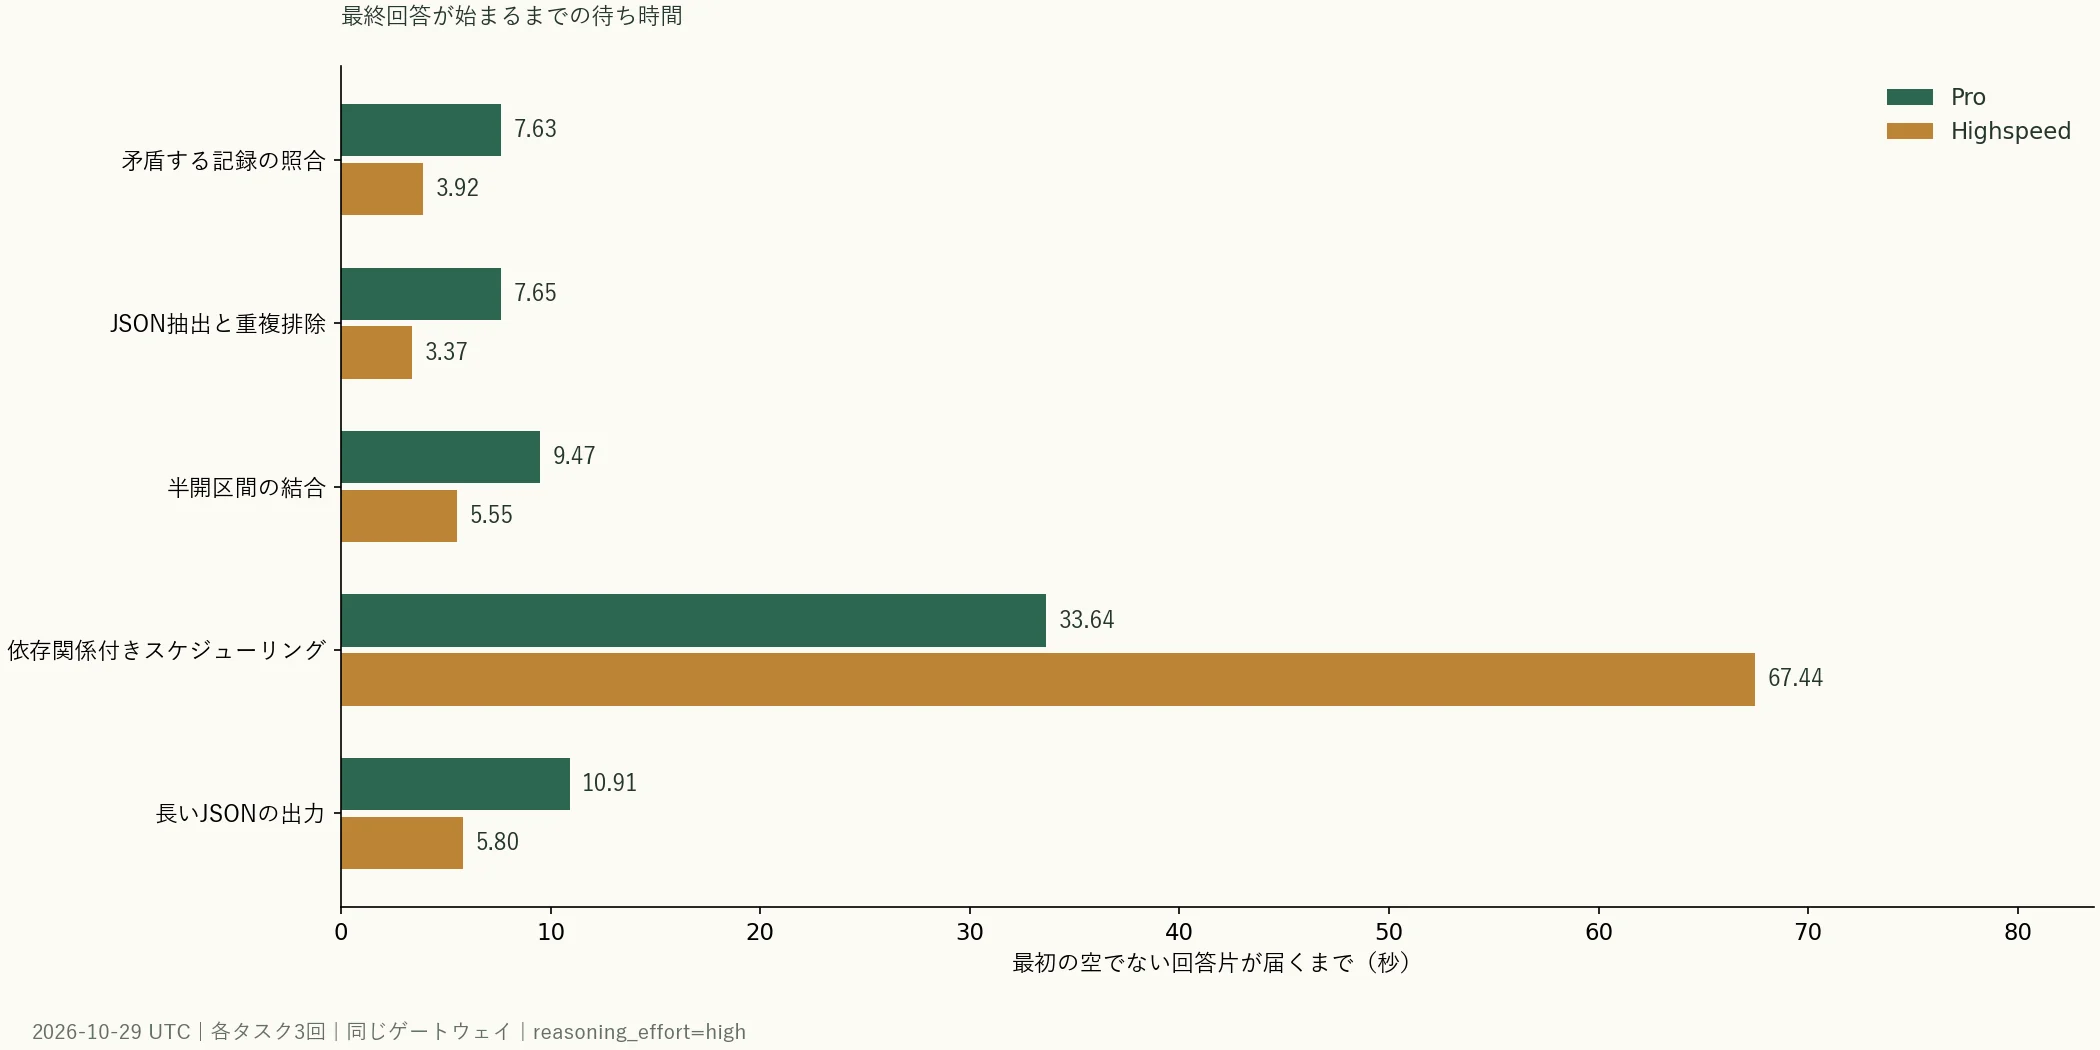
スケジューリングは、この違いが最もよく表れた例です。Highspeedは最初の推論または回答イベントまでの中央値が約2.17秒でしたが、最終回答が出始めたのは67.44秒でした。Proでは、それぞれ3.96秒と33.64秒でした。
UIが最終回答だけを表示する場合、ユーザーが経験するのは後者の待ち時間です。UIに「思考中」と表示していても、最初に到着した推論の断片を、業務上利用可能な結果とみなすことはできません。今回、完全な推論テキストは保存・公開せず、関連するカウントと時刻だけを記録しました。
価格比較:通常入力と出力は単価2倍、キャッシュ読み取りは同額#
以下は2026年10月29日に取得したCrazyrouterの公開価格で、defaultグループの倍率は1です。単位はいずれもUSD/100万トークンで、ゲートウェイの表示価格です。Moonshot公式の直接接続価格として扱うことはできません。 [4]
| 課金項目 | kimi-k3.1-pro | kimi-k3.1-pro-highspeed |
|---|---|---|
| 通常入力 | $2.00 | $4.00 |
| 出力 | $10.00 | $20.00 |
| キャッシュ読み取り | $0.20 | $0.20 |
| キャッシュ書き込み、5分 | $2.00 | $4.00 |
| キャッシュ書き込み、1時間 | $4.00 | $8.00 |
価格は料金APIのtiered_exprから取得し、リポジトリの課金実装とも照合しました。両モデルで同じ互換フィールドmodel_ratioから単価を推測することはしていません。今回読み取れたKimi公式課金ページの本文には、検証可能なモデル別単価表がなかったため、本記事では「公式価格」を補って記載しません。
キャッシュをまったく使用せず、通常入力と課金対象出力がそれぞれ1,000 tokensのリクエストを想定すると、表に基づく計算ではProが約**0.024**です。ただし、これはトークン使用量が同じ場合の比較にすぎません。実際のリクエストでは、推論量、キャッシュヒット、アカウントのルールによって請求額が変わります。
第1ラウンドのスケジューリングは、より有用な例です。両モデルのprompt_tokensはともに225で、キャッシュの読み書きは記録されませんでした。一方、completion_tokensはそれぞれ1,097と4,178です。上表を当てはめると、理論上の費用は約**0.08446で、差は約7.40倍**です。これはレスポンス使用量と表示価格に基づく推定であり、アカウントで確定・請求された金額ではありません。
したがって、「Highspeedの単価は2倍」でも、「リクエストごとの総費用が常に2倍」という意味ではありません。特に、最後の短いJSONの文字数だけでコストを見積もるべきではありません。今回のcompletion_tokensには推論トークンも含まれます。
選定前には、現在のモデル価格比較とMoonshotシリーズ接続ページを確認できます。これらのページは照会入口を提供するもので、本記事の数値は今回保存した料金APIのスナップショットに基づきます。
APIの切り替え方法:パラメータを保ち、最終結果を個別に検証#
今回の単一テキストリクエストでは、クライアント側でmodelを切り替えるだけで、同一APIを使って両モデルを比較できました。トップレベルのreasoning_effortを使用し、temperatureやtop_pなどのサンプリング設定は省略しました。K2シリーズのthinking設定も渡していません。
以下の完全なPythonサンプルは、それぞれ実行して検証済みです。両モデルとも{"answer":391}を返し、ステータスはstop、ストリーム終了マーカーも受信しました。この2回は独立した接続確認用のサンプルで、上記30回の評価には含めていません。本記事の言語要件に合わせるため、以下のコードでは同じ乗算問題を英語で表現し、個別に検証しています。元の中国語プロンプトの逐語的な入力を再現するものではありません。実行前にrequestsをインストールし、環境変数CRAZYROUTER_API_KEYで認証情報を指定してください。
以下のサンプルは英語のプロンプトに差し替え、両モデルで別途動作確認しました。元の中国語サンプルと同じ掛け算を尋ねますが、入力文は異なります。この2件は30件のベンチマークに含まれず、元のプロンプトをそのまま再現するものではありません。
"""Endpoint smoke example; set CRAZYROUTER_API_KEY. Separate from 30 benchmark calls."""
import json
import os
import time
import requests

BASE_URL = 'https://cn.crazyrouter.com/v1'
PROMPT = 'Output only a JSON object with the key answer and the integer result of 17 multiplied by 23. No Markdown or explanation.'

def main():
    session = requests.Session()
    session.trust_env = False
    for model in ('kimi-k3.1-pro', 'kimi-k3.1-pro-highspeed'):
        started = time.perf_counter()
        response = session.post(
            BASE_URL + '/chat/completions',
            headers={'Authorization': 'Bearer ' + os.environ['CRAZYROUTER_API_KEY']},
            json={
                'model': model,
                'messages': [{'role': 'user', 'content': PROMPT}],
                'reasoning_effort': 'high',
                'max_tokens': 8192,
                'stream': True,
                'stream_options': {'include_usage': True},
            },
            timeout=(15, 180),
            stream=True,
        )
        response.raise_for_status()
        content, finish_reason, response_id, done = '', None, None, False
        for line in response.iter_lines(chunk_size=1):
            if not line.startswith(b'data:'):
                continue
            raw = line[5:].strip()
            if raw == b'[DONE]':
                done = True
                break
            event = json.loads(raw)
            if event.get('error'):
                raise RuntimeError(event['error'])
            response_id = event.get('id', response_id)
            for choice in event.get('choices', []):
                content += (choice.get('delta') or {}).get('content') or ''
                finish_reason = choice.get('finish_reason') or finish_reason
        response.close()
        assert done and finish_reason == 'stop' and json.loads(content) == {'answer': 391}
        print(json.dumps({'model': model, 'id': response_id, 'finish_reason': finish_reason,
                          'content': content, 'seconds': round(time.perf_counter()-started, 3)},
                         ensure_ascii=False))

if __name__ == '__main__':
    main()
今回のサンプルのレスポンスIDは、12818d48-89e1-4c2e-b7c8-aeeec5a1bbfaと8f7e5a17-cc9b-495f-bee6-9e00110f6beeです。再実行すると新しいレスポンスIDが生成され、出力の空白や所要時間も異なる場合があります。
このサンプルは、モデルID、ストリーム解析、最終コンテンツを確認するためのものです。完全な評価では、usage、最初のコンテンツ断片の時刻、ペアのラウンド、判定理由も記録します。この単純な乗算問題を能力評価として扱うことはできません。
マルチターン会話では、履歴メッセージの追加処理が必要です。公式では、完全なassistantメッセージとそのreasoning_contentをそのまま返すよう求めています。本記事で検証したのはシングルターンのテキストのみで、マルチターンのツール呼び出しは検証していません。既存クライアントへ組み込む場合は、接続ガイドから確認し、アカウントの現在のモデル一覧でIDを照合してください。モデルカタログの表示名だけからAPIパラメータを推測してはいけません。
Highspeedに切り替える価値があるタスクと、Proを使い続けられるタスク#
| 利用シーン | 今回の証拠から導ける選択 |
|---|---|
| ユーザーが待つ構造化抽出やフィールド照合 | Highspeedを優先的に候補へ。今回は待ち時間の中央値が明確に短縮。それでも業務サンプルの品質確認は必要 |
| ルールが明確で出力が長いJSON | Highspeedを試す価値あり。今回の完全な80項目出力では約2.18倍の高速化 |
| 自動テスト付きの小さな関数生成 | 両者を候補に残す。まずテストに合格させ、その後で待ち時間と費用を比較 |
| オフライン処理で、現在のProが期限内に完了している | まず総コストを比較。完了が速くなっても、追加の業務効果があるとは限らない |
| 今回に似た組み合わせスケジューリング | まずProを維持。この問題では3ペアすべてでHighspeedが低速だったため、問題セットを広げて再確認 |
| 長いコンテキスト、マルチモーダル、ツールAgent、高同時実行 | 今回は対象外。対応するテストを構築し、本記事の結果をそのまま適用しない |
既存アプリケーションでは、2つのモデル設定を残し、実際のタスクをサンプリングして比較する方が安全です。最低正答率、許容待ち時間、タスクあたりの費用を先に設定してから、特定種別のリクエストをHighspeedへ切り替えるか判断します。テールレイテンシを観察するにはサンプルを増やす必要があります。各問題3回の呼び出しでは、代表的なP95を報告するのに適しません。
FAQ#
kimi-k3.1-pro vs kimi-k3.1-pro-highspeed、どちらが優れている?#
待ち時間の予算とタスク次第です。今回は両者とも15/15回に合格し、Highspeedは4類のタスクで所要時間の中央値が短くなりました。一方、スケジューリング問題では低速で、出力トークンも多くなりました。全タスクに共通する優位なモデルはありません。
Highspeedは毎回2~3倍高速?#
すべてのリクエストについて保証されるものではありません。公式は2~3倍という性能主張を示していますが、今回の15ペアのうち高速だったのは11ペアで、1回目のレコード照合と3回のスケジューリングは反例でした。
Highspeedは回答品質を低下させる?#
今回の検査では品質低下は見つからず、両者とも15回すべてに合格しました。ただし、テストしたのは限定された5タスクだけで、主観的な文章作成、大規模コードリポジトリ、長い工程のAgentは対象外です。したがって、すべての場面で品質が同じだと保証することはできません。
両モデルは同じ重みを使っている?#
本記事では確認するだけの十分な証拠がありません。公式は、両者が同じK3シリーズのパラメータ制約を持つこと、Highspeedが速度を重視した位置づけであることを説明しています。パラメータの一致は、重みやデプロイ詳細を検証済みであることを意味しません。
両モデルのコンテキストと推論設定は同じ?#
公式のパラメータと課金説明では、両者とも1,048,576-tokenのコンテキストで、low、high、maxをサポートし、デフォルトはmaxです。今回テストしたのは短いテキストとhigh設定のみで、100万トークンの場面は検証していません。
Highspeedはどのくらい高い?#
今回のCrazyrouter defaultグループの価格では、通常入力と出力の単価がProの2倍で、キャッシュ読み取りの単価は同じです。1回の総費用は、実際の出力・推論トークン、キャッシュ、アカウントのルールにも左右されるため、単純に2倍にはできません。
ストリーミングコンテンツが出ているのに、なぜ長く待つ必要がある?#
最初に到着するコンテンツはreasoning_contentの場合があり、最終回答はcontentから始まります。今回のスケジューリングでは、Highspeedで空でない推論または回答イベントの受信が約2.17秒に始まった一方、回答開始の中央値は67.44秒でした。
この速度をMoonshot公式APIの性能とみなせる?#
みなせません。本記事で測定したのは、指定クライアントからCrazyrouterゲートウェイまでの完全な経路で、ネットワークと上流の影響を含みます。純正環境への直接接続とのペア比較は行っていません。
導入の推奨事項#
**Highspeedに追加費用を支払うなら、検証可能な業務待ち時間の短縮を得るべきです。**今回、フィールド処理、短いコード、長いJSON出力では良い結果が得られました。一方、スケジューリング問題は、生成開始が早く、推論トークンが多く、回答完了が遅いという状況が同時に起こり得ることを示しました。
安定したPro設定をすでに運用しているなら、本番の問題を使って、正答率、回答開始時間、完全な完了時間、トークン使用量を同時に確認してください。Highspeedが所要時間と費用の目標を満たしたことを確認してから、種類ごとに段階的に切り替えます。
出典と実測付属資料#
参考資料#
- Kimi公式:K3.1 Proリリースノート、2026-10-29取得。速度の数値はベンダーの声明。
- Kimi公式:モデルパラメータ比較、2026-10-29取得。今回検証したのは、そのうちシングルターンのテキスト、high設定のリクエストのみ。
- Kimi公式:モデル課金説明。コンテキストと課金概念の照合に使用し、本記事のモデル別単価の出典とはしていない。
GET https://crazyrouter.com/api/pricing、2026-10-29 UTCのスナップショット。課金モードはtiered_expr。具体的な式と元のスナップショットは編集部がアーカイブ。
リクエストごとの結果#
以下の30件はすべてHTTP 200を返し、stopで終了し、[DONE]を受信したうえでタスクの検証に合格しました。ProとHighspeedは上記の正確なモデルIDを指します。出力トークンには推論トークンが含まれます。試行回数は1から数えます。
| タスク | モデル | 回 | 完了時間(秒) | 回答開始(秒) | 出力トークン | 推論トークン |
|---|---|---|---|---|---|---|
| 矛盾する記録の照合 | Pro | 1 | 5.32 | 5.03 | 151 | 113 |
| 矛盾する記録の照合 | Highspeed | 1 | 6.35 | 6.22 | 172 | 134 |
| 矛盾する記録の照合 | Pro | 2 | 9.89 | 8.67 | 342 | 304 |
| 矛盾する記録の照合 | Highspeed | 2 | 3.46 | 3.28 | 104 | 66 |
| 矛盾する記録の照合 | Pro | 3 | 8.06 | 7.63 | 303 | 265 |
| 矛盾する記録の照合 | Highspeed | 3 | 3.93 | 3.92 | 191 | 153 |
| JSON抽出と重複排除 | Pro | 1 | 8.51 | 7.65 | 300 | 235 |
| JSON抽出と重複排除 | Highspeed | 1 | 2.70 | 2.44 | 153 | 88 |
| JSON抽出と重複排除 | Pro | 2 | 7.32 | 6.37 | 159 | 94 |
| JSON抽出と重複排除 | Highspeed | 2 | 3.77 | 3.43 | 162 | 97 |
| JSON抽出と重複排除 | Pro | 3 | 8.91 | 8.24 | 250 | 185 |
| JSON抽出と重複排除 | Highspeed | 3 | 3.70 | 3.37 | 190 | 125 |
| 半開区間の結合 | Pro | 1 | 9.59 | 7.67 | 359 | 227 |
| 半開区間の結合 | Highspeed | 1 | 9.14 | 8.32 | 514 | 384 |
| 半開区間の結合 | Pro | 2 | 12.37 | 10.64 | 369 | 237 |
| 半開区間の結合 | Highspeed | 2 | 6.21 | 5.55 | 377 | 247 |
| 半開区間の結合 | Pro | 3 | 11.03 | 9.47 | 334 | 209 |
| 半開区間の結合 | Highspeed | 3 | 5.72 | 4.98 | 309 | 161 |
| 依存関係付きスケジューリング | Pro | 1 | 39.82 | 39.60 | 1097 | 1071 |
| 依存関係付きスケジューリング | Highspeed | 1 | 67.59 | 67.44 | 4178 | 4152 |
| 依存関係付きスケジューリング | Pro | 2 | 30.16 | 29.96 | 810 | 784 |
| 依存関係付きスケジューリング | Highspeed | 2 | 121.22 | 121.06 | 6704 | 6678 |
| 依存関係付きスケジューリング | Pro | 3 | 33.88 | 33.64 | 980 | 954 |
| 依存関係付きスケジューリング | Highspeed | 3 | 38.44 | 38.34 | 2620 | 2594 |
| 長いJSONの出力 | Pro | 1 | 23.35 | 12.80 | 1214 | 509 |
| 長いJSONの出力 | Highspeed | 1 | 9.82 | 5.80 | 1180 | 475 |
| 長いJSONの出力 | Pro | 2 | 21.43 | 10.91 | 1121 | 416 |
| 長いJSONの出力 | Highspeed | 2 | 10.47 | 5.91 | 1174 | 469 |
| 長いJSONの出力 | Pro | 3 | 21.26 | 10.83 | 1127 | 422 |
| 長いJSONの出力 | Highspeed | 3 | 9.32 | 5.34 | 1148 | 443 |
編集部では中国語の元プロンプト、正解、最終回答、応答ID、判定スクリプト、料金スナップショットを保存しています。本ページでは30件すべての指標と実行可能な接続サンプルを掲載しています。証拠資料一式のダウンロードや推論全文の公開は行っていません。