简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
Kimi K3.1 Pro vs Kimi K3.1 Pro Highspeed:30 次實測,速度與成本怎麼選?
在同一介面、相同推理檔位下完成 30 次呼叫,比較 Kimi K3.1 Pro 與 Highspeed 的任務通過情況、完整回應時間、首個答案等待時間及目前閘道報價。高速版在四類常規任務中更快,但排程題出現反例,並附逐次資料與可重現程式碼。
如果你的任務需要使用者等待,Kimi K3.1 Pro Highspeed 值得先進行配對測試;如果 Pro 已符合回應要求,一般版的單價較低。本輪 30 次呼叫中,兩款模型各通過 15/15 次;Highspeed 在四類常規任務上的完成時間中位數對應約 1.78–2.30 倍提速,但排程題約慢一倍。
原始評測的所有提示均為簡體中文。本版呈現2026年10月29日同一批30次請求,並非另做繁體中文效能測試。Crazyrouter既是本次使用的API閘道,也是本部落格的發布者。
因此,highspeed 可以是提速選項,卻不能視為每次請求的加速保證。更不能只看名稱,就斷言兩款模型的能力、推理過程或實際單次費用完全一樣。
**本輪透過 Crazyrouter 的同一個 Chat Completions 介面完成兩款模型的 30 次配對呼叫,並保留最終答案、回應 ID、狀態和 token 用量。**下文的價格與實測路徑截至 2026 年 10 月 29 日,不代表 Moonshot 直連報價或原廠部署效能。
kimi-k3.1-pro vs kimi-k3.1-pro-highspeed,官方確認了哪些差異?#
Kimi 官方將 Highspeed 描述為更適合快速互動的版本,並聲稱其速度為一般 Pro 的 2–3 倍。這屬於廠商效能主張,不能直接換算成每個業務請求都能少等一半以上。 [1]
官方參數文件則明確指出:兩者都遵循 K3 系列的參數限制。 [2]
| 比較項目 | Kimi K3.1 Pro | Kimi K3.1 Pro Highspeed |
|---|---|---|
| 精確 API 模型名稱 | kimi-k3.1-pro | kimi-k3.1-pro-highspeed |
| 官方上下文上限 | 1,048,576 tokens | 相同 |
reasoning_effort | low / high / max,預設 max | 相同 |
| 本輪推理檔位 | high | high |
| 本輪輸出預算 | max_tokens=8192 | 相同 |
| 官方速度描述 | 對照版本 | 聲稱為 Pro 的 2–3 倍 |
| 本輪通過情況 | 15/15 | 15/15 |
上下文數值來自官方計費說明,本文沒有測試百萬 token 輸入。 [3] 參數一致也無法證明底層權重、量化方案、硬體或每次請求使用的運算量相同;本次資料不足以對這些實作細節下結論。
如果你比較的是 Pro 與上一代 K3,那是另一個問題,可以參考這篇 K3.1 Pro 與 K3 的升級比較。該文的模型組合和測試結果並未混入本輪統計。
30 次測試怎麼做:先控制任務,再比較速度#
我們先查詢通過驗證的模型清單,確認兩個精確 ID 可見,再實際呼叫。模型清單可見只代表帳戶能看到該名稱,呼叫是否完成仍由後續回應驗證。
| 測試設定 | 本輪使用值 |
|---|---|
| Base URL | https://cn.crazyrouter.com/v1 |
| Endpoint | POST /chat/completions |
| 請求模型 | 上表兩個精確 ID |
| 任務與重複次數 | 5 個任務,每個模型每題 3 次,共 30 次 |
| 推理與預算 | reasoning_effort: "high",max_tokens: 8192 |
| 回傳方式 | stream: true,請求串流結束時回傳 usage |
| 提示與工具 | 同題提示完全相同;沒有外部工具或 system 訊息 |
| 提交方式 | 同題兩個模型配對並行,最大並發數 2;按輪次交替提交順序 |
| 用戶端連線/讀取逾時 | 15 秒/180 秒;每個串流事件均檢查累計耗時 |
五個任務涵蓋的檢查重點如下:
| 任務 | 判定內容 |
|---|---|
| 記錄衝突與缺漏欄位 | 處理欄位更新和撤回;未知供應商填入 null;忽略附註中的干擾指令 |
| JSON 擷取與去重 | 保留最新記錄,按 ID 排序,將金額精確轉換為整數分 |
| Python 半開區間合併 | 僅在嚴格重疊時合併、端點反轉時正規化、捨棄空區間、不修改輸入;每份函式檢查 87 個測試案例 |
| 具有相依關係的最佳排程 | 七個任務的加權完成時間最小化;標準答案由本機窮舉產生 |
| 長 JSON 輸出 | 完整產生 80 個物件,逐項核對整數序號和平方值 |
「通過」要求 HTTP 200、finish_reason="stop"、收到 [DONE],且最終答案符合檢查規則。這次沒有 HTTP 失敗、截斷、逾時或判定未通過的記錄。
這仍然只有五道任務。三次重複用於觀察波動,並非三道獨立題目;程式碼的 87 個內部檢查也不能算成 87 道模型題。重複提示可能產生前綴快取,記錄中確實出現快取寫入與快取命中,因此本文不是冷快取基準測試,也不能將所有延遲差異歸因於模型本身。
完整回應時間:高速版在四類任務提速,排程是例外#
下表取每個模型、每道題三次成功請求的中位數。「提速比」為 Pro 耗時 ÷ Highspeed 耗時;大於 1 表示 Highspeed 更快,小於 1 表示更慢。
| 任務 | Pro 完成時間中位數 | Highspeed 完成時間中位數 | 提速比 |
|---|---|---|---|
| 記錄衝突與拒答邊界 | 8.06 秒 | 3.93 秒 | 2.05× |
| 結構化擷取與去重 | 8.51 秒 | 3.70 秒 | 2.30× |
| Python 半開區間合併 | 11.03 秒 | 6.21 秒 | 1.78× |
| 具有相依關係的最佳排程 | 33.88 秒 | 67.59 秒 | 0.50× |
| 長 JSON 輸出與計算 | 21.43 秒 | 9.82 秒 | 2.18× |
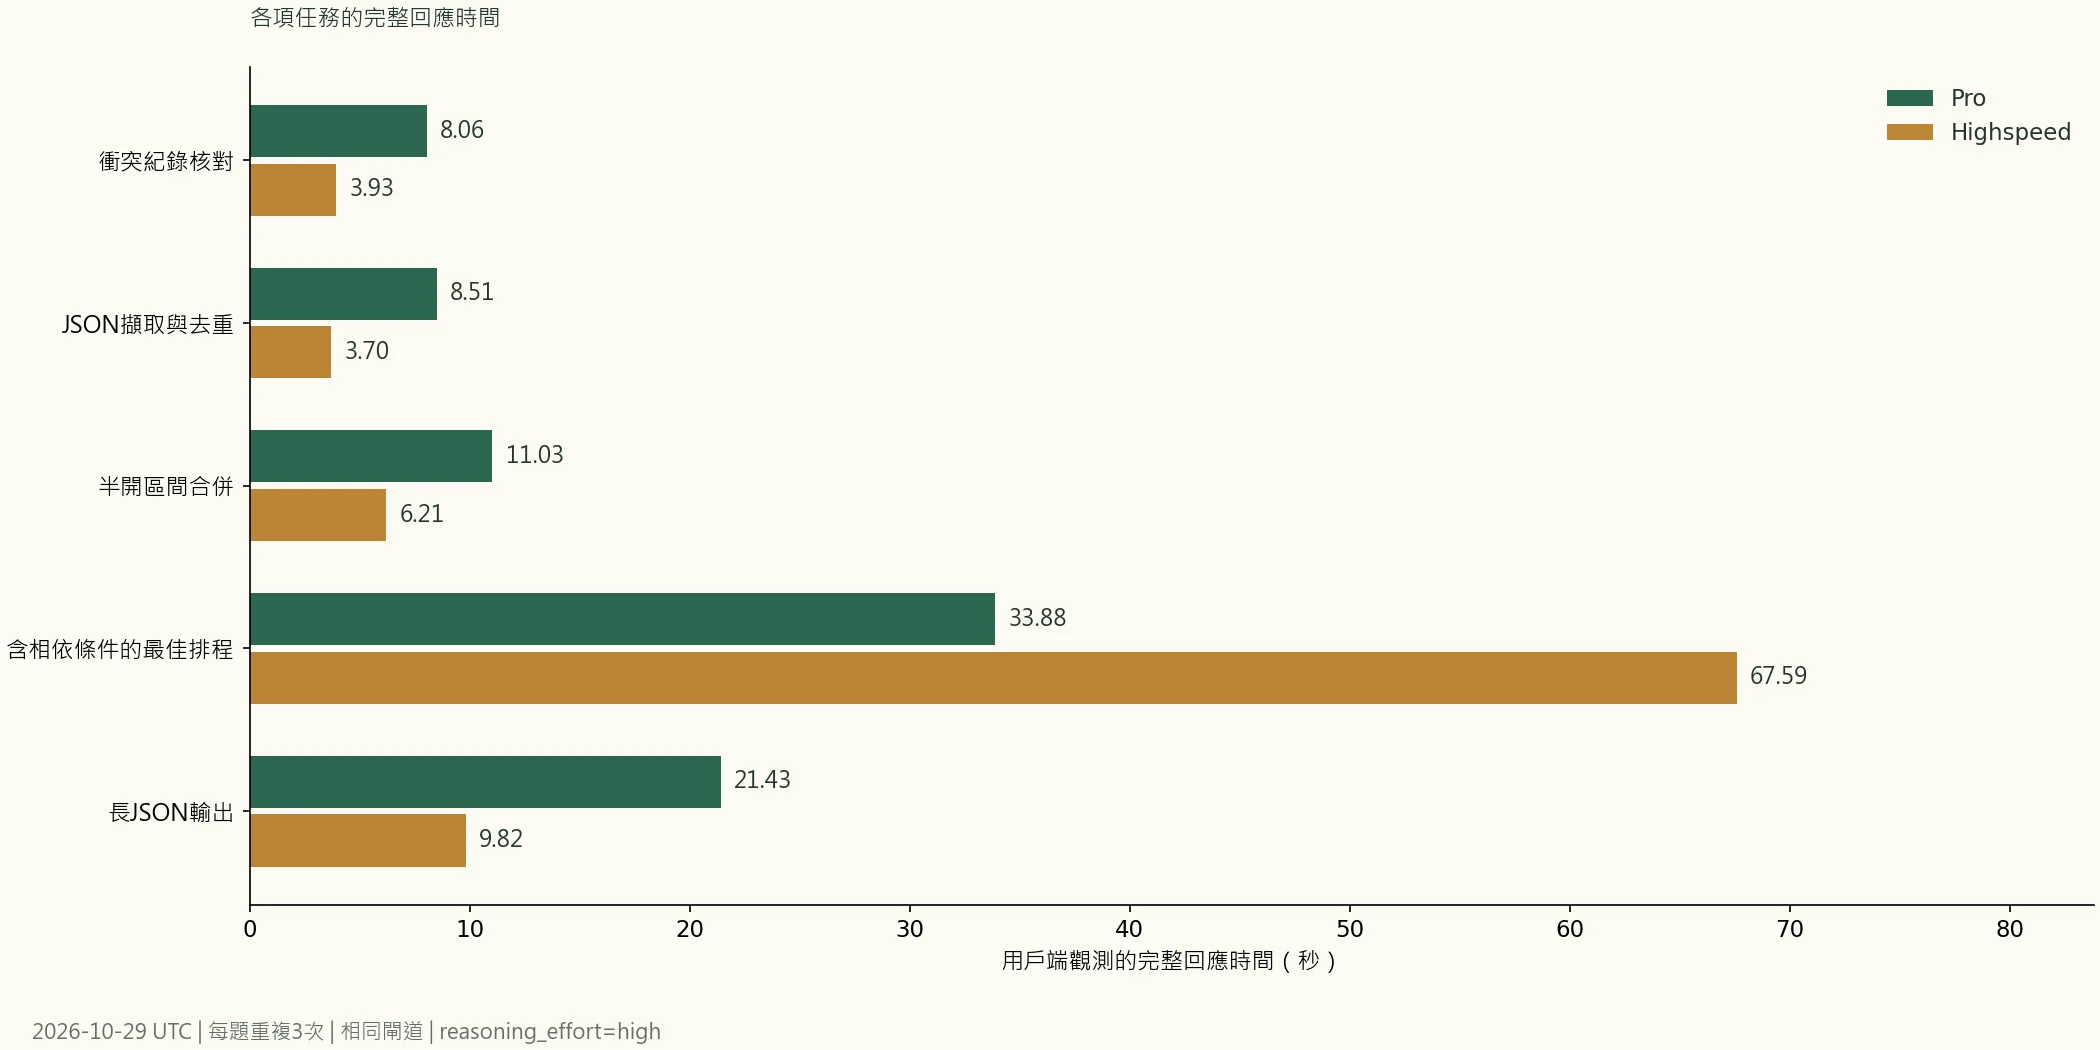
結構化擷取和 80 項 JSON 輸出的差距最容易理解:同樣完成檢查,高速版明顯縮短了等待時間。程式碼題也有改善,但未達到「每次快兩倍」;第一輪程式碼請求分別為 9.59 秒和 9.14 秒,差距很小。
在 15 對同題同輪請求中,Highspeed 有 11 對更快。反例包括第一次記錄核對,以及全部三次排程。這個比例只描述本組樣本,不是生產環境下的加速機率。
兩款模型在這些答案明確、限制條件有限的任務上,都交付了合格結果。我們沒有觀察到本輪檢查可辨識的品質下降,但這不足以證明兩者在開放式寫作、複雜編碼或長時間 Agent 任務上的品質相等。
為什麼 Highspeed 在排程題上反而更慢?#
先看第一輪的一對實際回應:
| 指標 | Pro | Highspeed |
|---|---|---|
| 完成時間 | 39.82 秒 | 67.59 秒 |
completion_tokens | 1,097 | 4,178 |
其中 reasoning_tokens | 1,071 | 4,152 |
| 兩者的最終答案 | {"order":"BADGCFE","cost":307} | 相同 |
| 判定 | 通過 | 通過 |
對應回應 ID 分別是 8e4f8840-0af2-4981-880b-26f016ec63ba 和 38a707dc-c53c-41c4-905f-4204b9c3d499。排程答案由本機窮舉驗證,不是拿其中一個模型的答案評判另一個。
**相同 high 檔位,不等於兩次請求會產生相同數量的推理 token。**這次高速版產生了更多推理 token,並同時出現更長的等待時間。這項觀察可以解釋為什麼「產生得更快」和「任務更早結束」不能畫上等號,但不能據此判定服務端變慢的唯一原因。
第二輪排程差距更大:Pro 為 30.16 秒,高速版為 121.22 秒;第三輪則是 33.88 秒和 38.44 秒。三個樣本都支持「本題高速版更慢」,仍不足以推廣為「高速版不擅長數學或規劃」。
更完整的用戶端耗時還包括網路往返、排隊、產生推理、產生答案和串流收尾。本輪沒有服務端排隊或硬體計時,也沒有測試並發容量,不能將總耗時差異全部解釋為解碼吞吐量。
首個串流事件很快,不等於使用者已看到答案#
對推理模型,至少要區分三個時間點:
- 首個非空推理或答案事件:請求後何時開始收到內容。
- 首個最終答案片段:
delta.content首次非空,本文簡稱「答案開始」。 - 完整回應結束:接收並處理完整串流,記錄最終狀態。
以下是三次呼叫的「答案開始」中位數。它是用戶端收到首個非空 content 的時間,不是瀏覽器實際顯示時間。
| 任務 | Pro 答案開始 | Highspeed 答案開始 |
|---|---|---|
| 記錄衝突與拒答邊界 | 7.63 秒 | 3.92 秒 |
| 結構化擷取與去重 | 7.65 秒 | 3.37 秒 |
| Python 半開區間合併 | 9.47 秒 | 5.55 秒 |
| 具有相依關係的最佳排程 | 33.64 秒 | 67.44 秒 |
| 長 JSON 輸出與計算 | 10.91 秒 | 5.80 秒 |
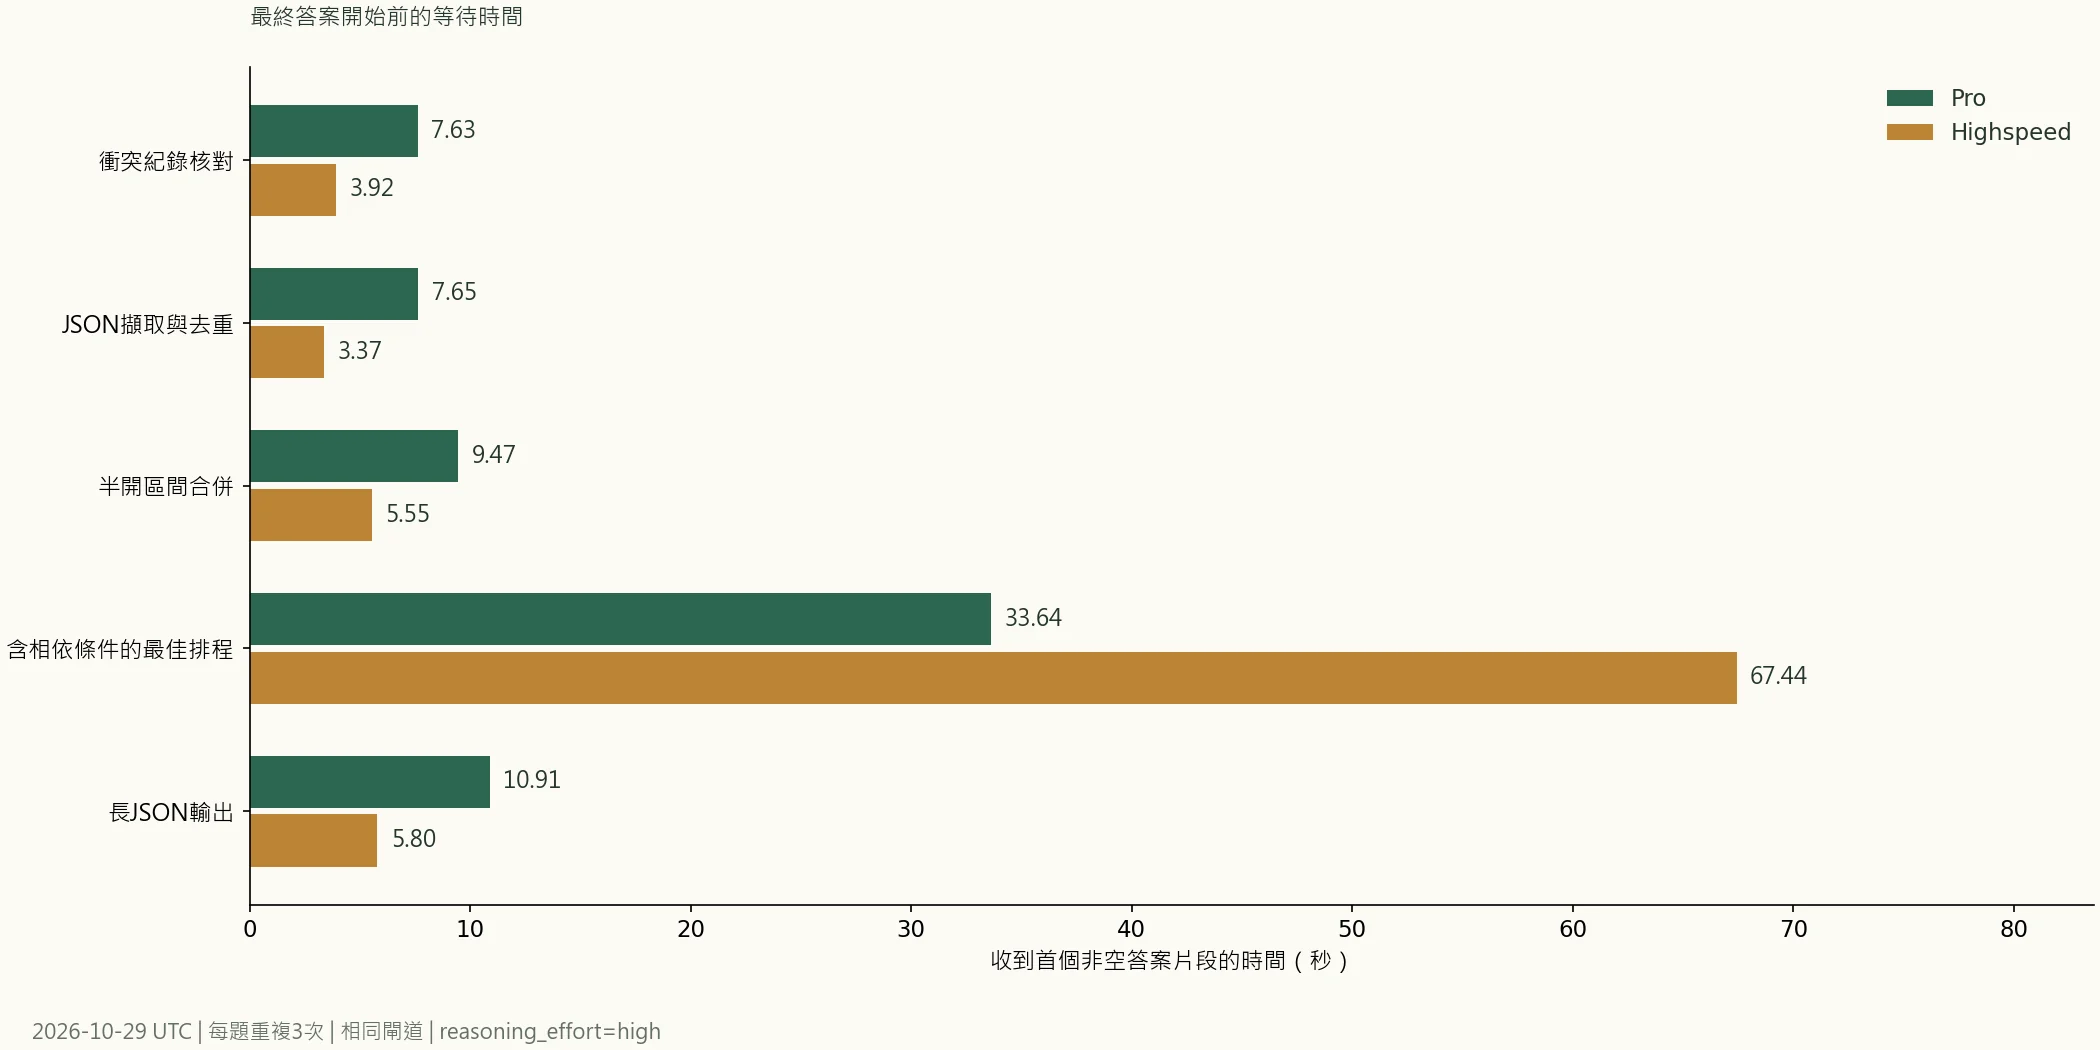
排程最能體現這個差別:Highspeed 首個推理或答案事件的中位時間約為 2.17 秒,但最終答案直到 67.44 秒才開始出現。Pro 對應數值為 3.96 秒和 33.64 秒。
如果介面只顯示最終答案,使用者經歷的是後面這段等待。即使介面顯示「正在思考」,也不能把最早到達的推理片段視為業務結果已可使用。本輪不保存或公開完整推理文字,只記錄相關計數和時間。
價格比較:一般輸入與輸出為兩倍單價,快取讀取價格相同#
以下是 2026 年 10 月 29 日讀取的 Crazyrouter 公開報價,default 分組倍率為 1。單位均為美元/百萬 token,屬於閘道標價,不能標示為 Moonshot 官方直連價。 [4]
| 計費項目 | kimi-k3.1-pro | kimi-k3.1-pro-highspeed |
|---|---|---|
| 一般輸入 | $2.00 | $4.00 |
| 輸出 | $10.00 | $20.00 |
| 快取讀取 | $0.20 | $0.20 |
| 快取寫入,5 分鐘 | $2.00 | $4.00 |
| 快取寫入,1 小時 | $4.00 | $8.00 |
報價來自價格介面的 tiered_expr,並與儲存庫的計費實作核對。沒有利用兩個模型相同的相容欄位 model_ratio 推測單價。Kimi 官方計費頁本次可讀取的正文沒有提供可驗證的型號單價表,因此本文不補寫「官方價格」。
假設一次請求完全沒有快取,一般輸入和計費輸出各為 1,000 tokens,那麼依上表計算,Pro 約 0.024。但這只是相同 token 用量下的比較;實際請求的推理量、快取命中和帳戶規則都會改變帳單。
第一輪排程就提供了更有用的例子:兩款模型的 prompt_tokens 都是 225,未記錄快取讀取或寫入;completion_tokens 卻分別為 1,097 和 4,178。按上表換算,理論費用約為 0.08446,相差約 7.40 倍。這是根據回應用量與標價所作的估算,不是帳戶已結算的扣款。
因此,「高速版單價兩倍」不代表「每次請求總費用固定為兩倍」。尤其不能只按最後那一小段 JSON 的字數估算成本;本輪 completion_tokens 包含推理 token。
選型前可以核對 目前模型價格比較和 Moonshot 系列接入頁。這兩個頁面提供查詢入口,本文數字以本輪保存的價格介面快照為準。
API 怎麼切換?保留參數,分別驗證最終結果#
在本輪單次文字請求中,用戶端只需切換 model,即可使用同一介面比較兩款模型。我們使用頂層 reasoning_effort,省略 temperature、top_p 等取樣設定,也沒有傳入 K2 系列的 thinking 設定。
下面的完整 Python 範例已分別執行驗證;兩款模型都回傳 {"answer":391},狀態為 stop,並收到串流結束標記。這兩次是獨立的連線範例,沒有計入上述 30 次評測。為符合本文語言要求,下方程式碼改用英語表述同一道乘法題,並單獨驗證;這不會重現原中文提示的逐字輸入。執行前請安裝 requests,並透過環境變數 CRAZYROUTER_API_KEY 提供憑證。
下方程式範例改以英文提示表達原本的乘法題,並已分別在兩款模型上驗證。這兩次檢查未計入30次評測,也不代表逐字重現原始中文提示。
"""Endpoint smoke example; set CRAZYROUTER_API_KEY. Separate from 30 benchmark calls."""
import json
import os
import time
import requests

BASE_URL = 'https://cn.crazyrouter.com/v1'
PROMPT = 'Output only a JSON object with the key answer and the integer result of 17 multiplied by 23. No Markdown or explanation.'

def main():
    session = requests.Session()
    session.trust_env = False
    for model in ('kimi-k3.1-pro', 'kimi-k3.1-pro-highspeed'):
        started = time.perf_counter()
        response = session.post(
            BASE_URL + '/chat/completions',
            headers={'Authorization': 'Bearer ' + os.environ['CRAZYROUTER_API_KEY']},
            json={
                'model': model,
                'messages': [{'role': 'user', 'content': PROMPT}],
                'reasoning_effort': 'high',
                'max_tokens': 8192,
                'stream': True,
                'stream_options': {'include_usage': True},
            },
            timeout=(15, 180),
            stream=True,
        )
        response.raise_for_status()
        content, finish_reason, response_id, done = '', None, None, False
        for line in response.iter_lines(chunk_size=1):
            if not line.startswith(b'data:'):
                continue
            raw = line[5:].strip()
            if raw == b'[DONE]':
                done = True
                break
            event = json.loads(raw)
            if event.get('error'):
                raise RuntimeError(event['error'])
            response_id = event.get('id', response_id)
            for choice in event.get('choices', []):
                content += (choice.get('delta') or {}).get('content') or ''
                finish_reason = choice.get('finish_reason') or finish_reason
        response.close()
        assert done and finish_reason == 'stop' and json.loads(content) == {'answer': 391}
        print(json.dumps({'model': model, 'id': response_id, 'finish_reason': finish_reason,
                          'content': content, 'seconds': round(time.perf_counter()-started, 3)},
                         ensure_ascii=False))

if __name__ == '__main__':
    main()
本輪範例的回應 ID 為 12818d48-89e1-4c2e-b7c8-aeeec5a1bbfa 與 8f7e5a17-cc9b-495f-bee6-9e00110f6bee。再次執行會產生新的回應 ID,輸出空白與耗時也可能不同。
範例用於檢查模型 ID、串流解析和最終內容。完整評測還記錄 usage、首個內容片段時間、配對輪次及判定理由,不能拿這道簡單乘法題當作能力評估。
多輪對話需要額外處理歷史訊息。官方要求將完整 assistant 訊息及其 reasoning_content 原樣傳回;本文只驗證單輪文字,沒有驗證多輪工具呼叫。接入現有用戶端時,可從 接入指南開始查閱,並在帳戶目前的模型清單中核對 ID,不要僅憑 模型目錄的顯示名稱猜測介面參數。
哪些任務值得改用 Highspeed,哪些可以繼續使用 Pro?#
| 你的情境 | 根據本輪證據可作出的選擇 |
|---|---|
| 需要使用者等待的結構化擷取、欄位核對 | 優先將 Highspeed 列入候選;本輪中位等待時間明顯縮短,仍須檢查業務樣本品質 |
| 規則明確、輸出較長的 JSON | 值得測試 Highspeed;本輪完整 80 項輸出約有 2.18 倍提速 |
| 小型函式產生並有自動測試 | 兩者都值得保留;先通過測試,再比較等待時間與費用 |
| 離線任務,目前 Pro 已符合時限 | 先比較總成本;完成得更快未必帶來額外業務效益 |
| 類似本輪的組合排程 | 先保留 Pro;該題三個配對中高速版都較慢,再擴大題集確認 |
| 長上下文、多模態、工具 Agent 或高並發 | 本輪未涵蓋,應建立對應測試,不能直接套用本文結果 |
對現有應用,更穩妥的做法是保留兩個模型設定,使用真實任務抽樣比較。先設定最低正確率、可接受等待時間和單任務費用,再決定是否將某類請求切換至高速版。若要觀察尾部延遲,應增加樣本;每題只有三次呼叫,不適合報告具有代表性的 P95。
FAQ#
kimi-k3.1-pro vs kimi-k3.1-pro-highspeed,哪個更好?#
取決於你的等待預算和任務。本輪兩者各通過 15/15 次,高速版在四類任務的中位耗時較短,但排程題更慢、輸出 token 更多;沒有跨任務的通用贏家。
Highspeed 是不是每次都快 2–3 倍?#
這不是每次請求的保證。官方提出 2–3 倍的效能主張;本輪 15 對呼叫中有 11 對更快,第一輪記錄核對和三次排程都是反例。
Highspeed 會不會降低答案品質?#
本輪檢查沒有發現品質下降,兩者各 15 次全部通過。但測試只有五個有限任務,沒有涵蓋主觀寫作、大型程式碼儲存庫或長流程 Agent,因此不能保證所有情境的品質相同。
兩款模型是不是同一套權重?#
本文沒有足夠證據確認。官方說明兩者具有相同的 K3 系列參數限制,並強調 Highspeed 的速度定位;參數一致不等於我們已核驗權重或部署細節。
兩款模型的上下文和推理檔位一樣嗎?#
在官方參數和計費說明中,兩者都是 1,048,576-token 上下文,支援 low、high、max,預設為 max。本輪僅測試短文字、high 檔位,沒有驗證百萬 token 情境。
高速版貴多少?#
在本輪 Crazyrouter default 分組報價中,一般輸入和輸出單價是 Pro 的兩倍,快取讀取單價相同。單次總費用還取決於實際輸出與推理 token、快取和帳戶規則,不能直接乘以二。
已經出現串流內容,為什麼還要等很久?#
最早到達的內容可能是 reasoning_content,而最終答案從 content 開始。本輪排程中,高速版約 2.17 秒開始收到非空推理或答案事件,但答案開始的中位時間為 67.44 秒。
能直接把這些速度視為 Moonshot 官方 API 的表現嗎?#
不能。本文測量的是指定用戶端到 Crazyrouter 閘道的完整路徑,包含鏈路和上游影響;沒有與原廠直連進行配對控制。
採用建議#
**為 Highspeed 付費,應換來可驗證的業務等待時間縮短。**本輪欄位處理、短程式碼和長 JSON 輸出給出了正面結果;排程題則說明,更早開始產生、更多推理 token 和更晚完成答案可以同時發生。
如果你的應用已有穩定的 Pro 設定,就用生產題目同時檢查正確率、答案開始時間、完整完成時間和 token 用量。高速版達到你的時限與費用目標後,再逐類切換。
來源與實測附件#
參考資料#
- Kimi 官方:K3.1 Pro 發布說明,2026-10-29 讀取;速度數字屬於廠商聲明。
- Kimi 官方:模型參數對照,2026-10-29 讀取;本輪只驗證其中單輪文字、high 檔位的請求。
- Kimi 官方:模型計費說明,用於核對上下文與計費概念,不作為本文型號單價來源。
GET https://crazyrouter.com/api/pricing,2026-10-29 UTC 快照;計費模式為tiered_expr,具體表達式與原始快照由編輯部歸檔。
逐次請求紀錄#
以下30次請求皆回傳HTTP 200,以stop結束、收到[DONE],且通過答案檢查。Pro與Highspeed分別代表上方列出的精確模型ID。輸出token包含推理token,輪次從1開始。
| 任務 | 模型 | 輪次 | 完成時間(秒) | 答案開始(秒) | 輸出token | 推理token |
|---|---|---|---|---|---|---|
| 衝突紀錄核對 | Pro | 1 | 5.32 | 5.03 | 151 | 113 |
| 衝突紀錄核對 | Highspeed | 1 | 6.35 | 6.22 | 172 | 134 |
| 衝突紀錄核對 | Pro | 2 | 9.89 | 8.67 | 342 | 304 |
| 衝突紀錄核對 | Highspeed | 2 | 3.46 | 3.28 | 104 | 66 |
| 衝突紀錄核對 | Pro | 3 | 8.06 | 7.63 | 303 | 265 |
| 衝突紀錄核對 | Highspeed | 3 | 3.93 | 3.92 | 191 | 153 |
| JSON擷取與去重 | Pro | 1 | 8.51 | 7.65 | 300 | 235 |
| JSON擷取與去重 | Highspeed | 1 | 2.70 | 2.44 | 153 | 88 |
| JSON擷取與去重 | Pro | 2 | 7.32 | 6.37 | 159 | 94 |
| JSON擷取與去重 | Highspeed | 2 | 3.77 | 3.43 | 162 | 97 |
| JSON擷取與去重 | Pro | 3 | 8.91 | 8.24 | 250 | 185 |
| JSON擷取與去重 | Highspeed | 3 | 3.70 | 3.37 | 190 | 125 |
| 半開區間合併 | Pro | 1 | 9.59 | 7.67 | 359 | 227 |
| 半開區間合併 | Highspeed | 1 | 9.14 | 8.32 | 514 | 384 |
| 半開區間合併 | Pro | 2 | 12.37 | 10.64 | 369 | 237 |
| 半開區間合併 | Highspeed | 2 | 6.21 | 5.55 | 377 | 247 |
| 半開區間合併 | Pro | 3 | 11.03 | 9.47 | 334 | 209 |
| 半開區間合併 | Highspeed | 3 | 5.72 | 4.98 | 309 | 161 |
| 含相依條件的最佳排程 | Pro | 1 | 39.82 | 39.60 | 1097 | 1071 |
| 含相依條件的最佳排程 | Highspeed | 1 | 67.59 | 67.44 | 4178 | 4152 |
| 含相依條件的最佳排程 | Pro | 2 | 30.16 | 29.96 | 810 | 784 |
| 含相依條件的最佳排程 | Highspeed | 2 | 121.22 | 121.06 | 6704 | 6678 |
| 含相依條件的最佳排程 | Pro | 3 | 33.88 | 33.64 | 980 | 954 |
| 含相依條件的最佳排程 | Highspeed | 3 | 38.44 | 38.34 | 2620 | 2594 |
| 長JSON輸出 | Pro | 1 | 23.35 | 12.80 | 1214 | 509 |
| 長JSON輸出 | Highspeed | 1 | 9.82 | 5.80 | 1180 | 475 |
| 長JSON輸出 | Pro | 2 | 21.43 | 10.91 | 1121 | 416 |
| 長JSON輸出 | Highspeed | 2 | 10.47 | 5.91 | 1174 | 469 |
| 長JSON輸出 | Pro | 3 | 21.26 | 10.83 | 1127 | 422 |
| 長JSON輸出 | Highspeed | 3 | 9.32 | 5.34 | 1148 | 443 |
編輯部保留原始簡體中文提示、標準答案、最終答案、回應ID、判分程式與報價快照。本頁公開30次逐筆指標與可執行的連線範例,不提供完整證據包下載,也不公開完整推理文字。