 中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
mimo-v2.6-pro 对比 gpt-6-astra:鹈鹕骑车、糖果盒等 8 道趣味探针实测,顺带抓到一次 API 路径"降智"
用鹈鹕骑车 SVG、糖果盒错误信念、字母计数、藏头诗等 8 道趣味探针各跑 3 次,实测小米 mimo-v2.6-pro 与 gpt-6-astra。7 道两边全对;鹈鹕 SVG 上 gpt 3/3、mimo 2/3 且一次正文为空。另抓到 gpt-6-astra 默认路由每次被注入约 4100 token。附 SVG 原件与原始记录。
先说结论,再说为什么这个结论要打折。
TL;DR#
- 8 道趣味探针、每题各跑 3 次、共 48 次正式调用:mimo-v2.6-pro 23/24,gpt-6-astra 24/24。
- 7 道"经典陷阱题"(糖果盒心智理论、r 计数、9.11 vs 9.9、退化过河、Alice 姐妹、藏头诗、自指词数句)两边全部答对——这批题已经区分不出 2026 年旗舰的差距。
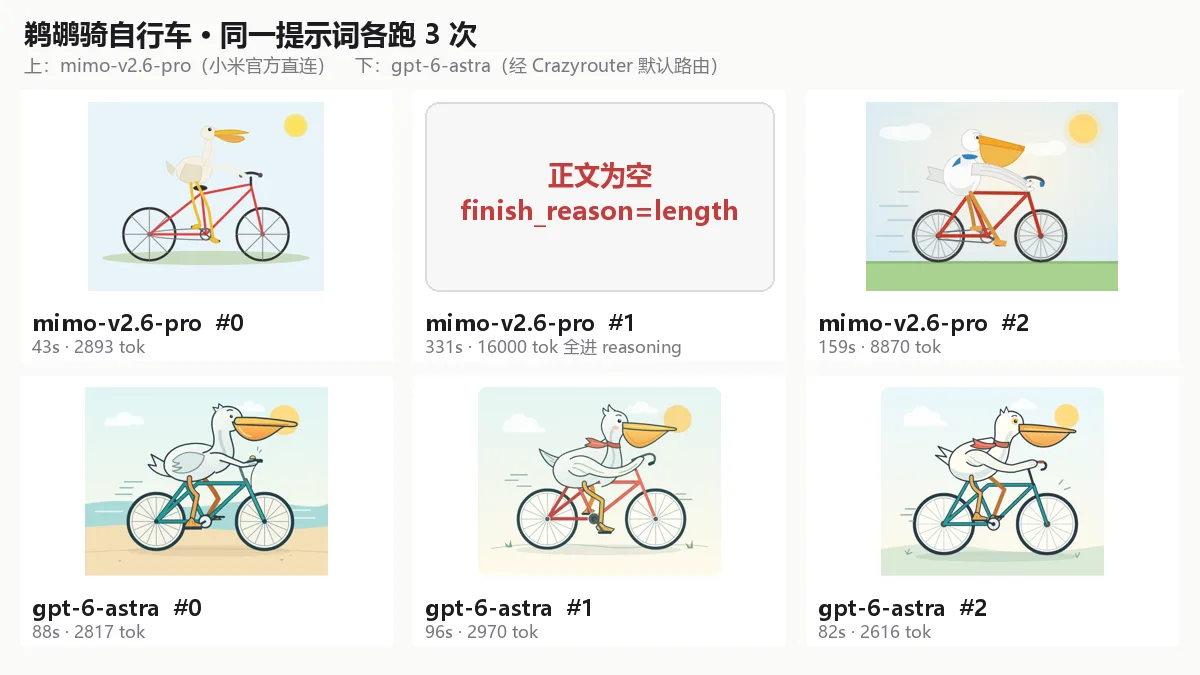
- 唯一拉开的是鹈鹕骑自行车 SVG:gpt-6-astra 3/3 稳定出图;mimo 2/3,其中一次思考 331 秒、16000 token 全部烧在 reasoning、正文返回空字符串。差距在稳定性,不在上限——mimo 最好的一张不输 gpt。
- 实付成本:28 次 gpt-6-astra 0.028,9.3 倍。但这 9.3 倍里有相当一部分不是模型价差,见下一条。
- 必须声明:本次 gpt-6-astra 走的默认路由每个请求被中间层塞进约 4100 token 的前置指令(一句 "hi" 的
prompt_tokens=4121),采样多样性也异常低。文中所有 gpt-6-astra 数据只代表"2026-09-22 经该路径访问到的 gpt-6-astra",不代表 OpenAI 原生 API。
为什么先声明:API 上测到的不一定是模型本体#
做模型对比之前,我们先查了两条线各自的路由。这一步很多评测文章不做,但它决定了后面所有数字的含金量。
| mimo-v2.6-pro | gpt-6-astra | |
|---|---|---|
| 路由候选 | 1 条:小米官方 api.xiaomimimo.com 直连 | 18 条候选,当日命中优先级最高的一条第三方线 |
| 响应 id 形态 | UUID | resp_…(上游是 Responses API,再翻译成 chat completions) |
一句 "hi" 的 prompt_tokens | 8 | 4121(cached_tokens=3968) |
| 每次请求固定注入 | 0 | 约 4100 token,28 次全部一致 |
reasoning_tokens 是否返回 | 每次都返回 | 8 道题里 3 道返回、5 道为空 |
| 一个单词回答的实付 | $0.00002 | $0.014 |
也就是说 gpt-6-astra 这条线每个请求都背着一段看不见的系统提示。它会影响三件事:模型行为可能被那段提示改变;每次输入固定多付约 $0.013;usage 透传不完整。mimo 那条线是官方直连、零注入、usage 完整。
这就是大家常说的"API 降智"的一种具体形态:不是模型变笨了,而是你调用到的东西和官方 API 之间隔了一层你看不见的封装。任何网关、聚合站、转售线都可能有这个问题,包括我们自己的默认路由。排查方法只有一个:发一句 "hi",看 prompt_tokens 是不是个位数。
另外两条通用声明:每题只跑 3 次,样本小,只能说明"当天这条路径上能否稳定做对";两族分词器不同,token 数不能跨族相除,本文只比正确率、输出字符数、实付美元和秒数。
测试对象与价格#
| 模型 | 输入 $/M | 输出 $/M | 本轮 28 次实付 |
|---|---|---|---|
| mimo-v2.6-pro(小米,1M 上下文,推理模型) | 0.435 | 0.87 | $0.028 |
| gpt-6-astra(OpenAI) | 5.00 | 25.00 | $0.261 |
价格来自 Crazyrouter 定价页,实付来自后台按 token 计费的日志。
测试环境#
统一走 OpenAI 兼容端点,无 system prompt,默认温度,非流式:
curl https://api.crazyrouter.com/v1/chat/completions \
  -H "Authorization: Bearer $CRAZYROUTER_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "mimo-v2.6-pro",
    "messages": [{"role": "user", "content": "Generate an SVG of a pelican riding a bicycle. Output only the SVG code, no explanation, no markdown fences."}],
    "max_tokens": 16000
  }'
每次调用记录 id、usage(含 reasoning_tokens)、finish_reason、耗时和完整正文。SVG 用 Playwright 渲染成 480px PNG 供人工判读。
8 道题与结果#
| # | 题目 | 考什么 | mimo-v2.6-pro | gpt-6-astra | 备注 |
|---|---|---|---|---|---|
| 1 | 鹈鹕骑自行车 SVG | 空间构图、代码生成、长输出稳定性 | 2/3 | 3/3 | 见下节 |
| 2 | 糖果盒错误信念(标着"糖果"的盒子装铅笔,两问) | 他人视角推理 | 3/3 | 3/3 | mimo 违反"一句话"约束,加粗+解释 |
| 3 | "raspberry cranberry strawberry" 有几个 r(答案 9) | 分词陷阱 | 3/3 | 3/3 | 两边都用了推理 token |
| 4 | 9.11 和 9.9 哪个大 | 经典数值陷阱 | 3/3 | 3/3 | gpt 不推理直接答,7 token |
| 5 | 只有农夫和白菜的过河题(答案 1) | 是否套"狼羊菜"模板 | 3/3 | 3/3 | 均未被带偏 |
| 6 | Alice 有 4 兄 2 姐妹,兄弟有几个姐妹(答案 3) | 自指计数 | 3/3 | 3/3 | |
| 7 | 藏头五言诗"路由更快",每句恰 5 字无标点 | 中文硬约束 | 3/3 | 3/3 | gpt 三次几乎同一首;mimo 三首各异 |
| 8 | 写一句真实陈述自身词数的英文句 | 自指一致性 | 3/3 | 3/3 | gpt 三次同模板 "exactly seven … words" |
几个有意思的样本:
藏头诗,mimo 三次:
路远山川阔 / 由来天地长 / 更逢春雨后 / 快马踏花香
路途远且长 / 由山入云间 / 更上一重岭 / 快马踏清风
路远行人稀 / 由来秋意深 / 更向孤村去 / 快马踏寒林
藏头诗,gpt-6-astra 三次:
路远逐晨光 / 由心向远方 / 更登千仞岭 / 快意任翱翔
路远春风近 / 由心逐晓光 / 更登千仞岭 / 快意览朝阳
路远春风近 / 由心逐晓光 / 更登千里岫 / 快意向朝阳
自指句,mimo:"This sentence has five words."(5,真);gpt:"This sentence contains exactly seven English words."(7,真)。
鹈鹕实验:唯一拉开差距的一题#
这道题来自 Simon Willison 的经典基准:让模型直接写 SVG 代码画"鹈鹕骑自行车",考的是不看图的情况下把两个复杂物体的空间关系用坐标表达出来。
| 次 | mimo-v2.6-pro |
|---|---|
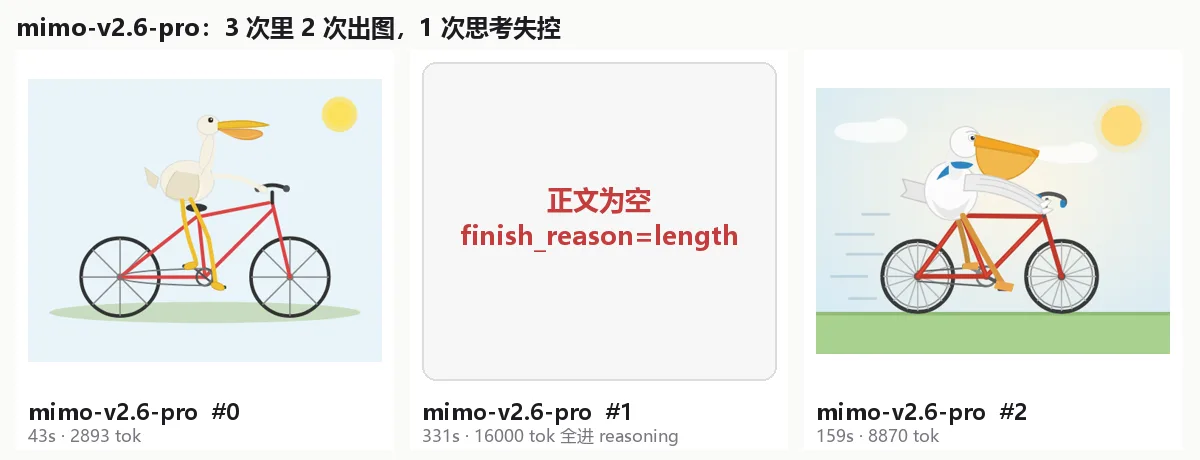
| #0 | 43s,2893 输出 token(111 推理)。鹈鹕站在车架上而非坐鞍,翅膀勉强搭到把手;喙有橙色喉囊。及格 |
| #1 | 331s,16000 token 全部烧在 reasoning,正文为空,finish_reason=length。reasoning 长 41,656 字符,一直在规划坐标和图层顺序("翅膀该在把手前还是后"),到预算耗尽也没开始输出 |
| #2 | 159s,8870 token(5147 推理)。云、速度线、蓝色翼羽、坐姿正确,是 mimo 最好的一张 |
| 次 | gpt-6-astra |
|---|---|
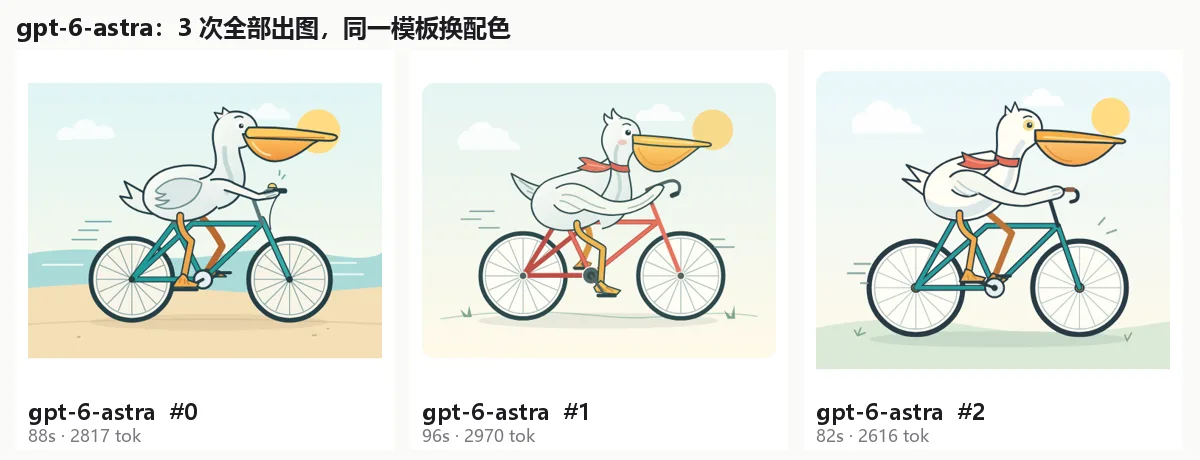
| #0 | 88s,2817 token。海滩场景,鹈鹕坐鞍、翅膀握把、腿踩踏板,构图最完整 |
| #1 | 96s,2970 token。同一构图,加了红围巾 |
| #2 | 82s,2616 token。同一构图,青色车架 |
SVG 原件可直接下载(都是模型原始输出,未经修改): mimo #0 · mimo #2 · gpt-6-astra #0 · gpt-6-astra #1 · gpt-6-astra #2
三个观察:
- gpt-6-astra 三张图是同一个模板换配色——同样的海滩、云、喙形、围巾。结合藏头诗和自指句的"三次同答",这条线的采样多样性接近零,像是温度被中间层固定了。这是路径问题还是模型特性,本轮无法区分。
- mimo 三次差异大:好的时候不输 gpt,坏的时候整次作废。作废那次实付 $0.0139,是 mimo 本轮最贵的一次,而用户拿到的是空字符串。
- 耗时:gpt 三次 82–96s 稳定;mimo 43–331s,方差极大。
延迟#
| 题 | mimo-v2.6-pro | gpt-6-astra |
|---|---|---|
| 短答题 4 道平均 | 3.9s | 4.8s |
| 糖果盒 | 8.4s | 16.3s |
| 藏头诗 | 13.7s | 9.2s |
| 自指句 | 9.9s | 4.6s |
| 鹈鹕 SVG | 177.8s | 88.6s |
短答题 mimo 略快;长输出 gpt 更稳。
生产接入建议#
接 mimo-v2.6-pro(以及任何推理模型)必须处理"reasoning 吃光预算":
resp = client.chat.completions.create(model="mimo-v2.6-pro", messages=msgs, max_tokens=8000)
choice = resp.choices[0]
if choice.finish_reason == "length" and not choice.message.content:
    # 思考耗尽预算、正文为空——重试时收紧 max_tokens 或换模型,别把空串当结果存下去
    ...
max_tokens 不是越大越安全:mimo 那次失控恰恰是因为给了 16000 的预算让它"想得起"。对确定性任务给 4000–8000 反而更稳。
接任何海外旗舰前,先做一次 "hi" 探针:看 prompt_tokens 是否个位数、id 是不是官方形态、usage 字段是否齐全。这三项任何一项异常,都说明中间隔了一层,你的评测和成本估算都得重算。Crazyrouter 后台的路由检查工具可以直接看到某个模型当前落在哪条渠道、有几条候选,注册后在模型页能查到每个模型的可用端点和价格。
什么场景选谁#
- 代码/结构化生成要稳定出结果:本轮 gpt-6-astra 3/3 vs mimo 2/3,稳定性优势明确。
- 高频短问答、成本敏感:两边正确率相同,mimo 便宜 9 倍以上且延迟略低。
- 中文约束写作:两边都满足硬约束,mimo 多样性更好。
- 需要看 reasoning 用量做成本控制:mimo 每次都回
reasoning_tokens;gpt-6-astra 这条线时有时无。
FAQ#
Q:为什么用这些"趣味题"而不是标准 benchmark? 标准 benchmark 大概率进了训练集,趣味探针(尤其鹈鹕 SVG)需要模型现场把空间关系编成坐标,没法背。缺点是主观判读,所以我们把原件全放出来。
Q:mimo 那次空输出是不是平台的问题?
不是。finish_reason=length、reasoning_tokens=16003、content="" 都是上游原样返回,且是小米官方直连、零注入。这是推理模型在开放式长输出任务上的已知风险。
Q:gpt-6-astra 的 4100 token 注入是什么?
一段中间层加的前置指令,缓存命中 3968 token,28 次恒定。我们没有看到它的内容(它不在响应里),只能从 prompt_tokens 反推。要排除它的影响,需要用 OpenAI 官方渠道钉线复测,这是下一轮的事。
Q:9.3 倍成本差有多少是注入造成的? 28 次里注入部分约 115K prompt token,其中 111K 命中缓存(缓存价为输入价的 10%),折算约 0.261 的 29%。剩下的才是模型本身的价差。
Q:为什么不测多模态?mimo 不是全模态吗? 本轮只测纯文本。图片/视频输入另立计划。
Q:3 次够吗? 不够下"谁更强"的结论,够发现"某条线三次同答"和"某模型三次里一次失控"这类稳定性信号。后续会补 18.7K 长上下文假前提题(各 6 次)和重推理题(各 13 次)。
相关文章#
- gpt-6-astra 对比 Claude Fable 5.1:输出少了 60%,但有一部分是答少了
- Claude Fable 5.1 对比 Fable 5:同题实测输出效率、正确性与那些不会报错的破坏性变更
- 为什么选择 Crazyrouter 而不是 OpenRouter?三个实打实的差异
- 模型定价页 · 接入文档
最终判断#
在 2026 年 9 月这个时间点、这两条具体路径上:趣味探针分不出两者的智力差距,分得出的是稳定性(gpt 稳、mimo 有失控风险)和成本(mimo 便宜一个数量级)。而比这两条更值得带走的是:评测之前先发一句 "hi",看看你调用的到底是谁。
下一轮:mimo-v2.6-pro 与 gpt-6-astra 补长上下文和重推理题;gpt-6-astra 换官方渠道钉线复测"三次同答";之后按计划推进 mimo-v2.6-flash vs claude-sonnet-4-6、kimi-k2.7-code vs claude-opus-5。