 简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
Cómo solucionar los errores 500, 502 y 524 en las API de IA
Guía práctica para solucionar los errores 500, 502 y 524 en las API de IA. Aprende qué suele significar cada error, cómo diagnosticar tiempos de espera agotados y fallos de los servicios de origen, y cómo incorporar reintentos, mecanismos de respaldo y registro de eventos en aplicaciones de IA en producción.
Cómo solucionar los errores 500, 502 y 524 en las API de IA#
Los errores de las API de IA son frustrantes porque suelen aparecer en el peor momento: durante una demostración, un flujo de trabajo en producción, la ejecución de un agente de programación o una tarea automatizada de atención al cliente.
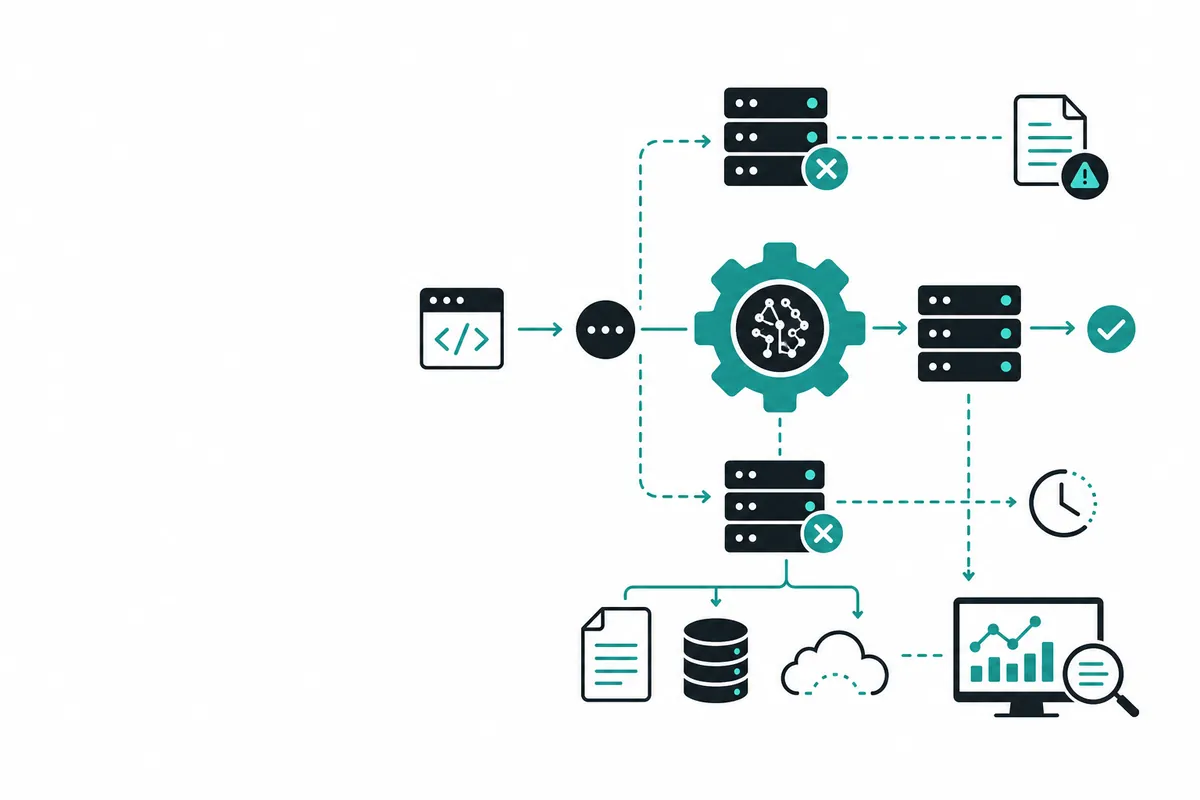
En conversaciones reales de soporte, hay tres familias de errores que aparecen una y otra vez:
500— fallo del servidor o del servicio de origen;502— fallo de la puerta de enlace o respuesta no válida del servicio de origen;524— tiempo de espera agotado, a menudo debido a una solicitud de larga duración.
El error está en tratar los tres de la misma manera.
Un reintento puede resolver una solicitud. No resolverá un diseño frágil en producción.
Esta guía explica qué suelen significar estos errores, qué comprobar primero y cómo hacer que las llamadas a las API de IA sean más resilientes mediante registros, reintentos, modelos alternativos y endpoints alternativos.
Tabla rápida de errores#
| Error | Qué suele significar | Primera medida | Solución para producción |
|---|---|---|---|
| 500 | Fallo interno del servidor o del proveedor de origen | Reintenta una vez y registra los detalles de la solicitud | Añade reintentos con espera progresiva y un modelo alternativo |
| 502 | La puerta de enlace no pudo obtener una respuesta válida del servicio de origen | Prueba un modelo similar u otra ruta | Añade modelos/proveedores alternativos |
| 524 | La solicitud agotó el tiempo de espera | Reduce el contexto/la salida o usa streaming | Añade controles del tiempo de espera y divide las tareas largas |
| 429 | Problema con el límite de solicitudes o la cuota | Reduce la frecuencia y comprueba los límites | Pon las solicitudes en cola, limita su frecuencia o solicita límites más altos |
| 401/403 | Problema de autenticación o permisos | Comprueba la clave de API y el acceso al modelo | Valida la configuración antes del despliegue |
Si solo te quedas con una cosa: registra el modelo, el endpoint, la hora de la solicitud, el código de error y si el streaming estaba habilitado. Sin esos datos, diagnosticar el problema se convierte en un ejercicio de conjeturas.
Qué suele significar un error 500 en una API de IA#
Un error 500 suele indicar que algo ha fallado en el servidor.
En un flujo de trabajo con una API de IA, puede deberse a lo siguiente:
- la puerta de enlace encontró un error interno;
- el proveedor del modelo de origen devolvió un fallo inesperado;
- la ruta del modelo estaba temporalmente inestable;
- el cuerpo de la solicitud desencadenó un caso límite;
- una solicitud larga o compleja falló durante el procesamiento.
Un 500 aislado suele ser temporal.
Si el 500 se repite con la misma solicitud, normalmente necesitas revisar su estructura.
Comprueba:
- el nombre del modelo;
- la ruta del endpoint;
- el formato de los mensajes;
- el esquema de llamadas a herramientas/funciones;
- el formato de los datos de imagen/vídeo/audio;
- el tamaño del contexto;
- si la misma solicitud funciona con otro modelo.
Qué suele significar un error 502 en una API de IA#
Un 502 Bad Gateway significa que la puerta de enlace no recibió una respuesta válida del servicio de origen.
En las API de IA, las causas habituales incluyen:
- inestabilidad del proveedor de origen;
- sobrecarga de la ruta del modelo;
- respuesta incorrecta o incompleta del servicio de origen;
- interrupción de la red;
- fallo específico de una ruta;
- incompatibilidad entre la puerta de enlace y el proveedor para una función especial del modelo.
Si se produce un 502 una sola vez, puede bastar con reintentar.
Si se repite con un modelo, prueba uno similar.
Por ejemplo, si un modelo de razonamiento de gama alta está inestable, envía temporalmente el mismo prompt a:
- una versión cercana del modelo;
- un modelo más rápido de la misma familia;
- un proveedor diferente con capacidades similares;
- un modelo alternativo más económico para tareas no críticas.
Aquí es donde resulta útil una puerta de enlace: puedes cambiar de ruta de modelo sin reescribir la aplicación.
Qué suele significar un error 524 por tiempo de espera agotado#
Un 524 suele indicar que la conexión agotó el tiempo de espera mientras esperaba una respuesta.
Es habitual con:
- prompts muy largos;
- ventanas de contexto grandes;
- salidas previstas de gran tamaño;
- tareas de razonamiento complejas;
- trabajos de generación de imágenes o vídeos;
- solicitudes sin streaming que tardan demasiado;
- flujos de trabajo de agentes de programación que piden al modelo resolver demasiado en una sola llamada.
Soluciones inmediatas:
- reduce el tamaño de la entrada;
- reduce
max_tokenso la longitud de la salida; - usa streaming para las respuestas de texto;
- divide la tarea en pasos más pequeños;
- elige un modelo más rápido;
- evita pedir una salida JSON enorme en una sola respuesta.
Un tiempo de espera agotado no siempre indica una caída de la plataforma. A veces significa que la solicitud es demasiado grande o tarda demasiado para una llamada síncrona a la API.
Lista de comprobaciones inmediatas para diagnosticar problemas#
Cuando falle una solicitud a una API de IA, haz estas comprobaciones antes de cambiar toda la configuración.
| Paso | Qué hacer | Por qué ayuda |
|---|---|---|
| 1 | Reintenta una vez | Permite resolver fallos temporales del servicio de origen |
| 2 | Guarda el cuerpo completo del error | El texto del error suele dar pistas sobre la autenticación, el modelo o el cuerpo de la solicitud |
| 3 | Registra la hora de la solicitud | El equipo de soporte puede correlacionarla con los registros de la ruta o del proveedor |
| 4 | Registra el nombre del modelo | Muchos fallos son específicos de la ruta del modelo |
| 5 | Comprueba la URL base | Un endpoint incorrecto provoca fallos confusos |
| 6 | Prueba un prompt más pequeño | Permite distinguir los problemas de tamaño del cuerpo de la solicitud de los problemas de ruta |
| 7 | Prueba el streaming | Reduce el riesgo de agotar el tiempo de espera en respuestas de texto largas |
| 8 | Prueba un modelo similar | Confirma si el problema es específico del modelo |
| 9 | Prueba un endpoint regional si es necesario | Ayuda cuando el acceso al endpoint global es inestable |
| 10 | Elimina funciones opcionales | Las llamadas a herramientas, las imágenes y los esquemas JSON largos pueden añadir puntos de fallo |
Para los clientes compatibles con OpenAI que usan Crazyrouter, las URL base habituales son:
https://crazyrouter.com/v1
y:
https://cn.crazyrouter.com/v1
No añadas parámetros UTM ni cadenas de seguimiento a los endpoints de la API.
Cómo implementar una estrategia de reintentos segura#
Los reintentos ayudan, pero reintentar a ciegas puede empeorar una interrupción del servicio.
Usa una espera exponencial con variación aleatoria:
import random
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_CRAZYROUTER_API_KEY",
    base_url="https://crazyrouter.com/v1"
)

def call_with_retry(messages, model="gpt-5-mini", max_retries=3):
    last_error = None

    for attempt in range(max_retries):
        try:
            return client.chat.completions.create(
                model=model,
                messages=messages,
                timeout=60,
            )
        except Exception as exc:
            last_error = exc
            wait = (2 ** attempt) + random.random()
            time.sleep(wait)

    raise last_error
Esto es mejor que reintentar inmediatamente en un bucle sin pausas.
Ejemplo de uso de modelos alternativos ante fallos#
Una aplicación en producción no debería depender de una sola ruta de modelo para todas las tareas.
Puedes definir una lista de alternativas:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_CRAZYROUTER_API_KEY",
    base_url="https://crazyrouter.com/v1"
)

MODELS = [
    "gpt-5-mini",
    "claude-sonnet-4-6",
    "gemini-2.5-flash",
]

def call_with_model_fallback(messages):
    errors = []

    for model in MODELS:
        try:
            return client.chat.completions.create(
                model=model,
                messages=messages,
                timeout=60,
            )
        except Exception as exc:
            errors.append({"model": model, "error": str(exc)})

    raise RuntimeError(f"All model routes failed: {errors}")
Este patrón es especialmente útil para:
- bots de soporte;
- automatización interna;
- agentes de programación;
- flujos de procesamiento para generar resúmenes;
- flujos de trabajo de contenido por lotes;
- aplicaciones en producción con requisitos de latencia de cara al usuario.
Ejemplo de uso de endpoints alternativos ante fallos#
Si tus usuarios o servidores tienen a veces un acceso inestable a una región, puedes probar un endpoint alternativo.
from openai import OpenAI

ENDPOINTS = [
    "https://crazyrouter.com/v1",
    "https://cn.crazyrouter.com/v1",
]

API_KEY = "YOUR_CRAZYROUTER_API_KEY"

for base_url in ENDPOINTS:
    client = OpenAI(api_key=API_KEY, base_url=base_url)
    try:
        response = client.chat.completions.create(
            model="gpt-5-mini",
            messages=[{"role": "user", "content": "Health check"}],
            timeout=30,
        )
        print("working endpoint:", base_url)
        break
    except Exception as exc:
        print("failed endpoint:", base_url, exc)
No cambies de endpoint al azar en cada solicitud. Usa los endpoints alternativos de forma deliberada y registra qué ruta funcionó.
Qué enviar al equipo de soporte#
Si el problema persiste, el equipo de soporte podrá ayudarte mucho más rápido si incluyes la información adecuada.
Envía:
- el correo electrónico de la cuenta;
- el nombre del modelo;
- la URL base utilizada;
- la ruta del endpoint;
- la hora de la solicitud y la zona horaria;
- el código de error;
- el cuerpo del error o una captura de pantalla;
- si el streaming estaba habilitado;
- si la misma solicitud funciona con otro modelo;
- una versión simplificada del cuerpo de la solicitud sin secretos.
No envíes tu clave de API completa en canales públicos.
Cómo ayuda una puerta de enlace a mejorar la fiabilidad de las API de IA#
Una puerta de enlace de API de IA no puede hacer que todos los proveedores de origen sean perfectos.
Pero sí puede hacer que tu aplicación sea más flexible.
Con una puerta de enlace, puedes:
- cambiar de modelo sin reescribir el código del SDK;
- dirigir las tareas sencillas a modelos más económicos;
- dirigir las tareas críticas a modelos más potentes;
- añadir alternativas entre distintas familias de modelos;
- mantener una única interfaz de integración compatible con OpenAI;
- supervisar los costes y el uso de forma más centralizada.
Con Crazyrouter, los clientes compatibles con OpenAI pueden usar:
https://crazyrouter.com/v1
o, cuando sea necesario:
https://cn.crazyrouter.com/v1
Así, tu aplicación puede centrarse en la lógica de reintentos, la política de alternativas ante fallos y una buena observabilidad.
Lista de comprobaciones para producción#
Antes de depender de una API de IA en producción, aplica esta lista de comprobaciones.
| Área | Recomendación |
|---|---|
| Tiempo de espera | Establece tiempos de espera explícitos para las solicitudes |
| Reintentos | Usa una espera exponencial con variación aleatoria |
| Alternativas ante fallos | Prepara al menos un modelo alternativo |
| Registros | Registra el endpoint, el modelo, la latencia, el código de error y el ID de la solicitud si está disponible |
| Tamaño del cuerpo de la solicitud | Limita el tamaño del contexto y de la salida |
| Streaming | Usa streaming para las respuestas de texto largas |
| Límites de solicitudes | Supervisa el uso de RPM y TPM |
| Coste | Supervisa los tokens de entrada/salida y el comportamiento de la caché |
| Experiencia de usuario | Muestra mensajes adecuados cuando se recurra a una alternativa |
| Soporte | Guarda suficientes metadatos para depurar los fallos más adelante |
Enlaces útiles#
- Guía de configuración de la URL base: https://crazyrouter.com/blog/openai-compatible-api-base-url-explained?utm_source=blog&utm_medium=article&utm_campaign=api_error_guide
- Lista de modelos: https://crazyrouter.com/models?utm_source=blog&utm_medium=article&utm_campaign=api_error_guide
- Calculadora de precios: https://crazyrouter.com/tools/pricing-calculator/?utm_source=blog&utm_medium=article&utm_campaign=api_error_guide
- Comparación de modelos: https://crazyrouter.com/tools/model-comparison/?utm_source=blog&utm_medium=article&utm_campaign=api_error_guide
- Documentación de la API: https://docs.crazyrouter.com
Preguntas frecuentes#
¿Qué significa un error 500 en una API de IA?#
Un error 500 en una API de IA suele indicar un fallo interno del servidor o del proveedor de origen. Reintenta una vez y después comprueba el modelo, el endpoint, el formato de la solicitud y si el mismo prompt funciona con otro modelo.
¿Qué significa un error 502 en una API de IA?#
Un error 502 suele indicar que la puerta de enlace no pudo obtener una respuesta válida del proveedor del modelo de origen. A menudo es temporal, pero si los errores 502 se repiten, puede ser necesario recurrir a un modelo o una ruta alternativos.
¿Qué significa un error 524 por tiempo de espera agotado?#
Un error 524 por tiempo de espera agotado suele indicar que la solicitud tardó demasiado. Reduce el tamaño del contexto, acorta la salida prevista, usa streaming, divide la tarea o elige un modelo más rápido.
¿Debo reintentar todas las solicitudes fallidas a una API de IA?#
No. Reintenta los errores temporales del servidor, de la puerta de enlace y de tiempo de espera agotado con una espera progresiva. No reintentes a ciegas los errores de autenticación, los errores de modelo no válido ni las solicitudes con un cuerpo incorrecto.
¿Cómo puedo hacer que las llamadas a una API de IA sean más fiables?#
Usa tiempos de espera explícitos, reintentos con espera progresiva, modelos alternativos, endpoints alternativos, registros de solicitudes, límites del tamaño del cuerpo de las solicitudes y supervisión de la latencia, el uso de tokens y las tasas de error.
Implementation Guides
Available in other languages: