简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
GPT-6.2 Astra frente a GPT-6 Astra: 32 pruebas, ¿vale la pena actualizar?
32 pruebas con la misma ruta y prompts: precisión igualada. Comparamos latencia, precios oficiales y costes reales para decidir cuándo probar GPT-6.2 Astra.
Si ya usas GPT-6 Astra, es probable que GPT-6.2 Astra te plantee tres preguntas. ¿Resolverá las tareas en las que antes fallaba el modelo? ¿Tendrás que esperar menos? ¿Subirá la factura?
En las 32 pruebas realizadas a través del mismo canal de Crazyrouter, ambos modelos resolvieron correctamente 16/16 tareas completas. GPT-6.2 Astra redujo un 54.3% el tiempo medio en la tarea de optimización con restricciones, pero registró una mediana de tiempo de respuesta más alta para el conjunto de solicitudes y un coste real un 37.6% mayor. Si ya usas GPT-6 Astra, estos resultados apuntan a probar primero el nuevo modelo en tareas concretas antes de sustituir el modelo predeterminado.
Esta prueba de muestra reducida se centra en tareas habituales de desarrollo. Contrastamos las especificaciones oficiales, la configuración de facturación vigente en Crazyrouter y el importe cobrado por cada solicitud. A continuación se detallan los tres datos por separado.
¿Qué cambia en las especificaciones oficiales?#
A fecha del 20 de noviembre de 2026, las páginas de OpenAI de ambos modelos indicaban lo siguiente. [1][2]
| Especificación | GPT-6.2 Astra | GPT-6 Astra |
|---|---|---|
| Nombre del modelo en la API | gpt-6.2-astra | gpt-6-astra |
| Modalidades de entrada / salida | Entrada de texto e imágenes, salida de texto | Entrada de texto e imágenes, salida de texto |
| Ventana de contexto | 1,050,000 tokens | 1,050,000 tokens |
| Entrada máxima | 922,000 tokens | 922,000 tokens |
| Salida máxima | 128,000 tokens | 128,000 tokens |
| Fecha de corte del conocimiento | 2026-05-18 | 2026-04-30 |
| Precio oficial de entrada sin caché | $8 / millón de tokens | $10 / millón de tokens |
| Precio oficial de lectura de caché | $0.40 / millón de tokens | $1 / millón de tokens |
| Precio oficial de salida | $40 / millón de tokens | $50 / millón de tokens |
Los precios de la tabla corresponden a la tarifa oficial Standard para entradas de hasta 272K tokens. Por encima de ese umbral, las tarifas de entrada y de lectura de caché se duplican en ambos modelos y las de salida se multiplican por 1.5. Por tanto, la tabla solo se aplica a las solicitudes dentro de ese límite. [1][2]
Con 6.2 Astra, los precios unitarios oficiales de entrada sin caché y de salida bajan un 20%, y la ventana de contexto nominal se mantiene. La fecha de corte del conocimiento es más reciente, pero eso no implica que el modelo tenga acceso en tiempo real a información posterior.
La documentación oficial también enumera herramientas y funciones de la Responses API. Esta prueba verificó las llamadas de texto a Chat Completions a través de Crazyrouter. La lista de funciones oficiales por sí sola no acredita que se hayan probado todos los endpoints de Crazyrouter.
Cómo se hizo la prueba en un mismo canal con 8 tipos de tareas y dos rondas por tarea#
Las pruebas se realizaron en la madrugada del 20 de noviembre de 2026, hora de Pekín, correspondiente al 19 de noviembre de 2026 en UTC. Antes de la prueba principal se verificó la disponibilidad de ambos modelos mediante /v1/models.
| Condición | Configuración de la prueba |
|---|---|
| Punto de acceso | Crazyrouter, https://api.crazyrouter.com/v1 |
| Endpoint | POST /chat/completions |
| Enrutamiento | Se fijó el mismo canal del proveedor. Se comprobó uno por uno que los 32 registros de consumo correspondían a ese canal. |
| Prompts | Los mensajes system y user eran idénticos para cada tarea. |
| Nivel de razonamiento | reasoning_effort: high |
| Presupuesto de salida | max_completion_tokens: 8192 |
| Modo de respuesta | Sin streaming, stream: false |
| Muestra y orden | 8 tipos de tareas × 2 ejecuciones por modelo, en orden aleatorio y con una concurrencia total de 2 |
| Evaluación | Se fijó de antemano la respuesta esperada y se comparó el JSON campo por campo. Se exigieron HTTP 200 y finish_reason=stop. |
Las pruebas incluyeron búsquedas en un conjunto de 360 reglas, comprobación de premisas erróneas, optimización de un grafo de dependencias, selección de un conjunto bajo restricciones, reconstrucción de una facturación a partir de eventos, visibilidad de transacciones, orden de deduplicación y límites de intervalos. Las primeras seis tareas procedían de un conjunto de pruebas interno anterior y las dos últimas ampliaban la cobertura de los casos límite. Tanto las entradas como las respuestas esperadas se conservaron en los archivos de respaldo. Las respuestas esperadas no se enviaron a los modelos.
Las tareas reflejan actividades habituales de desarrollo como interpretar reglas, calcular resultados y detectar casos límite. La prueba no abarcó cambios en repositorios de código completos ni incluyó la ejecución de programas generados por los modelos. Por eso, estos resultados no permiten elaborar una clasificación general de agentes de programación.
El tiempo se midió desde que el cliente envió la solicitud hasta que recibió la respuesta completa, e incluye la red, la espera en cola, la inferencia y la generación de la salida. Esta medición es distinta de la latencia hasta el primer token y de la tasa en tokens/s.
Ambos acertaron por igual. ¿En qué tareas cambió más el tiempo de respuesta?#
| Tarea | Aciertos de 6.2 Astra | Aciertos de 6 Astra | Tiempo medio de 6.2 | Tiempo medio de 6 |
|---|---|---|---|---|
| Búsqueda en una tabla extensa de reglas | 2/2 | 2/2 | 10.05 segundos | 10.20 segundos |
| Corrección de una premisa errónea | 2/2 | 2/2 | 9.95 segundos | 7.16 segundos |
| Grafo de dependencias y optimización de un solo punto | 2/2 | 2/2 | 9.05 segundos | 8.42 segundos |
| Selección del conjunto óptimo bajo restricciones | 2/2 | 2/2 | 18.49 segundos | 40.46 segundos |
| Deduplicación y reconstrucción de la facturación | 2/2 | 2/2 | 10.28 segundos | 10.41 segundos |
| Visibilidad de transacciones de base de datos | 2/2 | 2/2 | 4.94 segundos | 9.66 segundos |
| Deduplicación antes del filtrado por tiempo | 2/2 | 2/2 | 3.81 segundos | 7.18 segundos |
| Razonamiento sobre límites de intervalos semiabiertos | 2/2 | 2/2 | 4.12 segundos | 7.08 segundos |
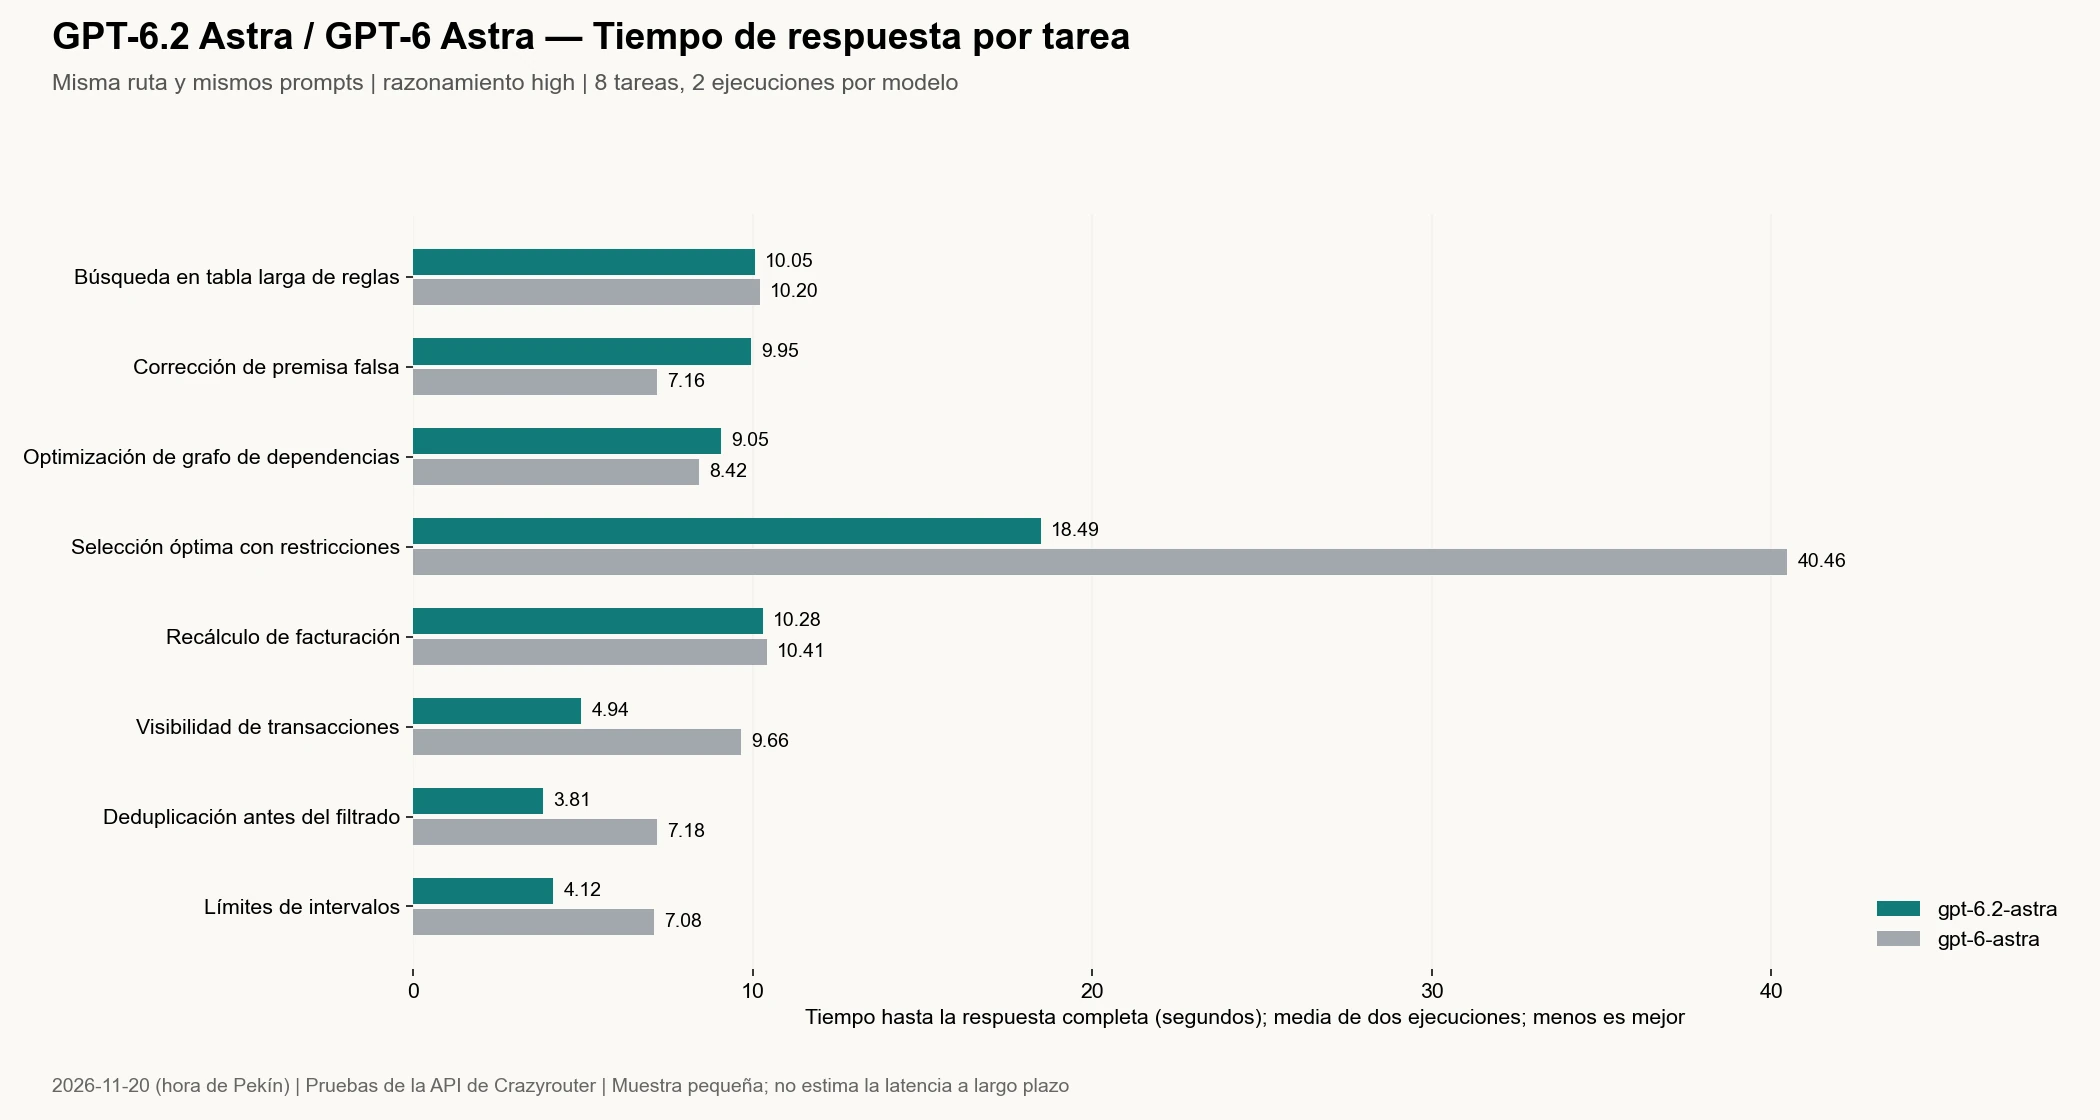
Cada celda representa solo dos solicitudes. Cuando las cifras son cercanas, no conviene interpretarlas como una ventaja estable. Ambos modelos devolvieron un JSON completo y acorde con la respuesta esperada en todas las tareas de esta ronda.
La mayor diferencia apareció en la selección de un conjunto bajo restricciones. El problema ofrecía 12 candidatos y pedía enumerar todas las soluciones óptimas que respetaran a la vez el peso total, la cantidad máxima de elementos, las dependencias y las incompatibilidades. Ambos modelos hallaron el único conjunto óptimo, [0, 2, 6, 9, 11], con un valor total de 78.
6.2 Astra tardó 18.21 y 18.78 segundos en las dos rondas. 6 Astra tardó 37.52 y 43.41 segundos. El tiempo medio de espera en esta tarea se redujo un 54.3%, por lo que vale la pena incluir problemas similares de optimización combinatoria en las pruebas antes de actualizar. Dos rondas, sin embargo, no bastan para afirmar que «todo razonamiento complejo va el doble de rápido».
La tarea de deduplicación comprobaba otro error frecuente. La primera aparición de un evento quedaba fuera de la ventana temporal y una aparición posterior con el mismo ID quedaba dentro. La tarea exigía «deduplicar primero todo el conjunto y después filtrar por tiempo», así que el evento repetido no debía volver a contabilizarse. Ambos modelos calcularon correctamente un saldo neto de 25 centavos para Alice y excluyeron a Bob, cuyo saldo neto final era cero.
En estos casos límite no hubo diferencias de acierto. Un resultado de 16/16 frente a 16/16 solo demuestra que ambos modelos superaron este conjunto de tareas. No demuestra que tengan el mismo límite de capacidad.
¿Por qué bajó la media y subió la mediana?#
| Estadísticas de las 16 solicitudes de cada modelo | GPT-6.2 Astra | GPT-6 Astra |
|---|---|---|
| Respuestas completas y correctas | 16/16 | 16/16 |
| Tiempo medio | 8.84 segundos | 12.57 segundos |
| Mediana del tiempo | 9.57 segundos | 8.16 segundos |
| Mínimo / máximo | 3.39 / 18.78 segundos | 6.67 / 43.41 segundos |
Ambas estadísticas son correctas. Las dos solicitudes de selección de un conjunto bajo restricciones tardaron bastante más con GPT-6 Astra y elevaron su media. 6.2 Astra acortó esas dos esperas, lo que redujo el promedio general.
Al ordenar todas las solicitudes por tiempo de respuesta, el valor central de 6.2 Astra queda en unos 9.57 segundos y el de 6 Astra, en unos 8.16 segundos. 6.2 Astra tampoco fue más rápido en la comprobación de premisas erróneas ni en la tarea del grafo de dependencias.
Para elegir modelo conviene tener en cuenta el tipo de tarea. Si la mayor parte de la espera se concentra en la optimización combinatoria, la mejora de la media tiene un efecto práctico. Si la mayoría de tus solicitudes habituales son consultas breves sobre reglas, estos datos no bastan para justificar un cambio generalizado de modelo.
El precio oficial baja, pero la factura de esta prueba en Crazyrouter sube#
La tarifa oficial y el precio que pagan los usuarios de Crazyrouter son distintos. En la configuración del grupo default consultada para estas pruebas, GPT-6 Astra tenía un descuento del 35% (se pagaba el 65% de la tarifa) y GPT-6.2 Astra se cobraba a tarifa íntegra. Para las solicitudes con entradas de hasta 272K tokens, las tarifas aplicables eran las siguientes.
| Tarifa de Crazyrouter por millón de tokens | GPT-6.2 Astra | GPT-6 Astra |
|---|---|---|
| Entrada sin caché | $8.00 | $6.50 |
| Lectura de caché | $0.40 | $0.65 |
| Salida | $40.00 | $32.50 |
Así, 6.2 Astra tiene actualmente la tarifa más baja de lectura de caché, mientras que 6 Astra tiene las tarifas más bajas de entrada sin caché y de salida. La «bajada de precio de la nueva versión» en la tarifa oficial no basta para determinar qué modelo sale más barato en Crazyrouter. Antes de contratar o integrar el servicio, vuelve a consultar las tarifas, ya que los cambios de grupo y de descuentos pueden afectar al resultado. Página de precios de Crazyrouter.
Localizamos los 32 registros de consumo real mediante sus identificadores de solicitud y convertimos los importes a dólares con el parámetro quota_per_unit=500000 de Crazyrouter.
| Consumo real de la prueba principal | GPT-6.2 Astra | GPT-6 Astra |
|---|---|---|
| Solicitudes | 16 | 16 |
| Tokens de entrada reportados por el proveedor | 128,692 | 108,708 |
| De ellos, tokens leídos de la caché | 49,536 | 48,512 |
| Porcentaje de entrada leído de la caché | 38.5% | 44.6% |
| Tokens de salida (incluidos los de razonamiento) | 2,625 | 3,946 |
| Coste real | $0.758064 | $0.551052 |
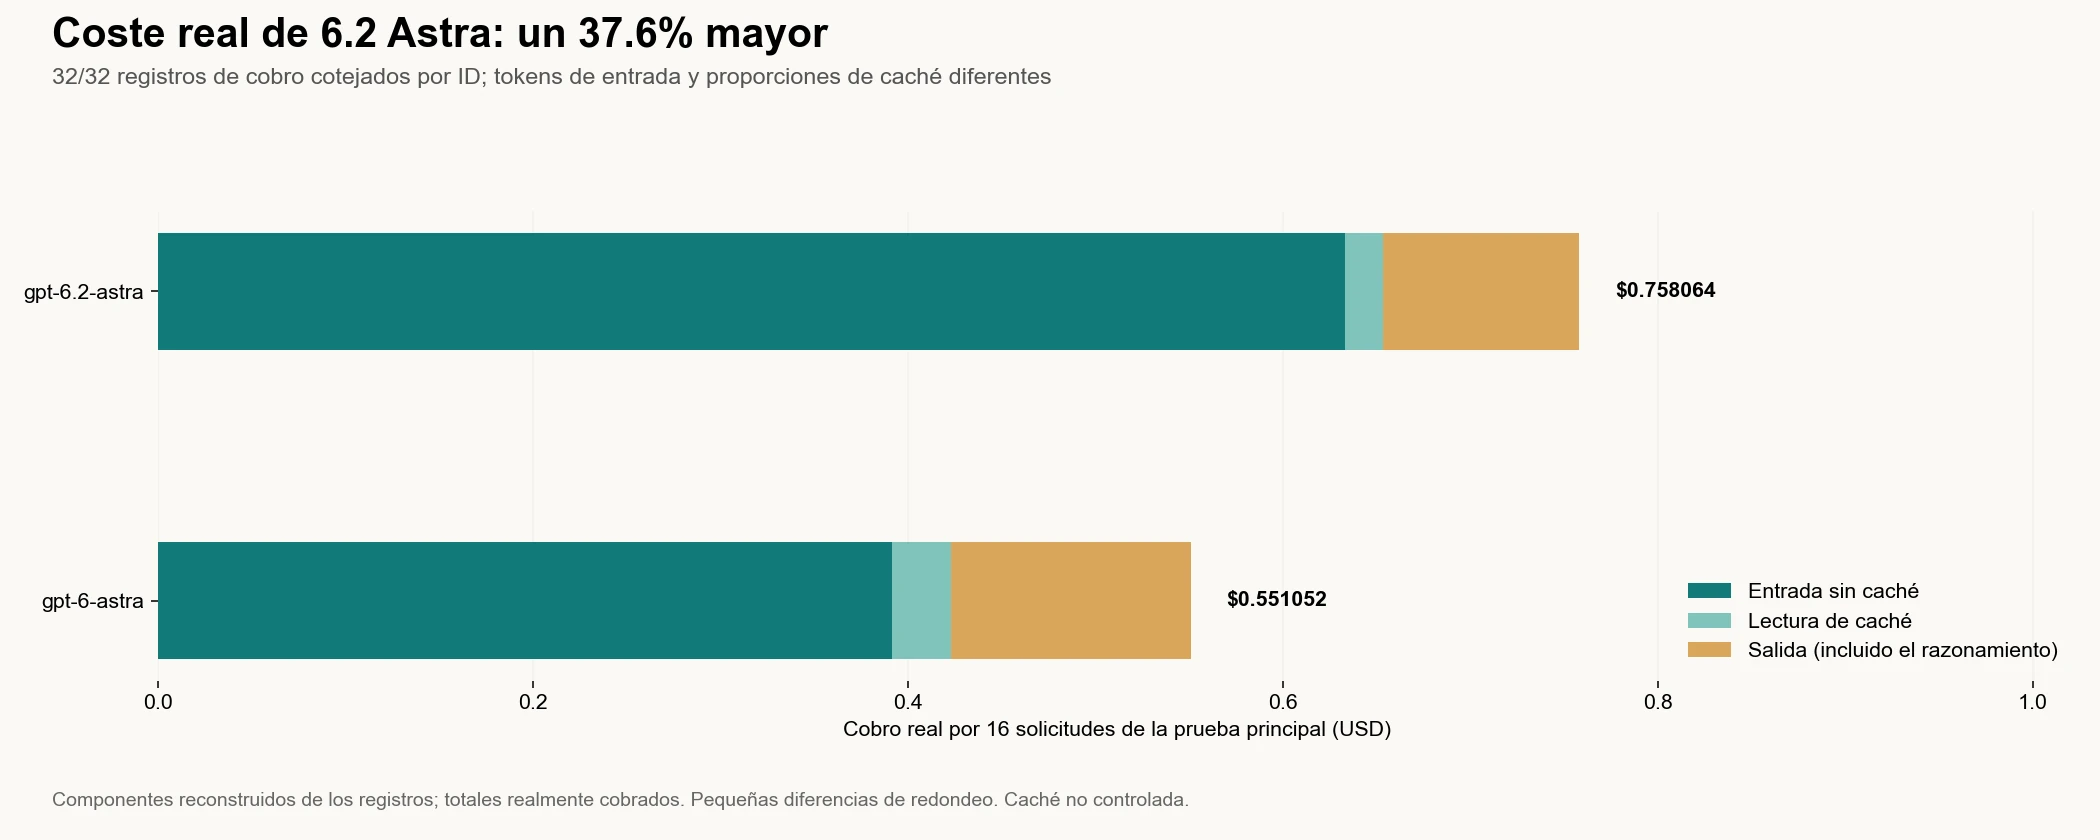
Los totales corresponden a los cargos reales. El desglose del gráfico se reconstruyó a partir de los registros de facturación. Las pequeñas diferencias con los totales se deben al redondeo. Se excluyen las dos llamadas independientes del ejemplo que aparece más adelante.
6.2 Astra utilizó menos tokens de salida en esta ronda, pero la factura fue un 37.6% más alta por el efecto combinado de las tarifas, el volumen de entrada reportado y la proporción leída de la caché. Incluso con prompts visibles idénticos, el proveedor reportó cantidades distintas de tokens de entrada. La prueba no determinó la causa de esa diferencia.
No se vació la caché y algunas tareas procedían de un conjunto de pruebas anterior. Estas cifras reflejan el coste de una carga de trabajo real. La prueba no se realizó con una caché vacía para todas las solicitudes, y de sus resultados no se puede extrapolar que cada usuario gastará un 37.6% más al mes.
Integración práctica con un modelo intercambiable y tus propias pruebas de regresión#
Si ya tienes llamadas a GPT-6 Astra, puedes mantenerlo como modelo predeterminado, cambiar el campo model en el entorno de pruebas y comparar ambos con tus propias tareas. El ejemplo siguiente usa la misma URL base para llamar a los dos modelos y les pide que fusionen intervalos semiabiertos.
Antes de ejecutarlo, instala requests y guarda tu clave de API en la variable de entorno CRAZYROUTER_API_KEY. El código no imprime la clave.
import json
import os
import requests

BASE_URL = "https://api.crazyrouter.com/v1"
MODELS = ["gpt-6.2-astra", "gpt-6-astra"]
PROMPT = ('Merge half-open intervals [[-3,2],[1,5],[5,9]]. '
          'Return JSON only: {"merged":[[start,end]],"length":integer}.')


def run():
    session = requests.Session()
    session.trust_env = False
    results = []
    for model in MODELS:
        response = session.post(
            BASE_URL + "/chat/completions",
            headers={"Authorization": "Bearer " + os.environ["CRAZYROUTER_API_KEY"]},
            json={
                "model": model,
                "messages": [{"role": "user", "content": PROMPT}],
                "reasoning_effort": "high",
                "max_completion_tokens": 8192,
                "stream": False,
            },
            timeout=(15, 180),
        )
        response.raise_for_status()
        data = response.json()
        choice = data["choices"][0]
        if choice["finish_reason"] != "stop":
            raise RuntimeError("Incomplete output: " + str(choice["finish_reason"]))
        answer = json.loads(choice["message"]["content"])
        assert answer == {"merged": [[-3, 9]], "length": 12}, answer
        result = {"model": model, "answer": answer,
                  "request_id": response.headers.get("x-oneapi-request-id")}
        print(json.dumps(result, ensure_ascii=False))
        results.append(result)
    return results


if __name__ == "__main__":
    run()
Este código se ejecutó por separado. Ambos modelos devolvieron {"merged":[[-3,9]],"length":12} con motivo de finalización stop. Estas dos llamadas no se incluyen entre las 32 de la evaluación anterior. El ejemplo usa el enrutamiento habitual de un usuario. En la prueba principal se fijó el canal para reducir las diferencias de enrutamiento.
Puedes consultar los campos de integración en la documentación de la API de Crazyrouter. Los equipos que usen las configuraciones de integración de Codex o Cursor también deberían hacer pruebas de regresión con su cadena de herramientas real. Las llamadas de texto de este artículo no verifican todas las funciones de esas herramientas. Configuración de Codex y configuración de Cursor.
Si ya usas GPT-6 Astra, ¿te conviene actualizar a 6.2 Astra?#
Puedes tomar la decisión según el tipo de tarea.
| Tu necesidad principal | Qué hacer según los datos de esta prueba |
|---|---|
| Las tareas actuales de comprobación de reglas y organización de datos ya se resuelven de forma estable, y el coste es prioritario | Mantén GPT-6 Astra. En Crazyrouter, su tarifa actual con descuento es más favorable para la entrada sin caché y la salida. |
| Las tareas de optimización combinatoria tardan demasiado | Prueba primero GPT-6.2 Astra y comprueba con más tareas reales si se mantiene la mejora de velocidad. |
| Trabajas a menudo con el orden de deduplicación, la semántica de las transacciones o los casos límite | Incluye 6.2 Astra en las pruebas de regresión comparativas. En esta ronda fue más rápido en esas tareas y ambos modelos acertaron. |
| Esperas una mayor tasa de acierto solo por el número de versión | Esta ronda no aporta pruebas de esa mejora. Incluye tareas que el modelo actual haya resuelto mal. |
| Necesitas comprensión de imágenes, agentes de larga duración o coordinación con herramientas | Haz pruebas específicas. Esta ronda no abarcó esos escenarios. |
También puedes empezar en Model Arena para comparar los modelos con las mismas tareas. Si vas a migrar, conserva los prompts exactos, las reglas de evaluación y los registros de consumo. Puedes consultar la configuración anterior en la página del modelo. Para decidir si migras, usa los resultados de tus propias pruebas de regresión. Página de GPT-6 Astra.
Cómo reproducir la tarea de optimización con restricciones#
A continuación se reproduce el prompt completo de usuario para esta tarea. En la prueba principal se usó el nivel de razonamiento high y un presupuesto de salida de 8192. El mensaje system pedía devolver solo JSON. La respuesta esperada se usó únicamente para la evaluación local y no se envió a los modelos.
Items IDs 0..11 have weights [4, 7, 2, 9, 5, 3, 8, 6, 4, 7, 1, 5] and values [13, 18, 7, 26, 14, 9, 23, 16, 12, 20, 4, 15]. Select total weight <=26 and at most 5 items. Constraints: selecting 3 requires 1; 6 and 7 cannot both be selected; selecting 9 requires 2; at least one of 0 and 4 must be selected. Maximize total value. Return JSON with best_value and optimal_sets (ALL optimal ID lists sorted ascending, and lists lexicographically sorted).
La respuesta esperada se calculó de antemano y se muestra a continuación.
{"best_value": 78, "optimal_sets": [[0, 2, 6, 9, 11]]}
Para verificar la solución óptima, enumera todos los subconjuntos de los 12 candidatos y filtra los que incumplan las condiciones de peso, cantidad, dependencia o incompatibilidad. Se archivaron las solicitudes y respuestas originales y los registros de consumo de cada solicitud para su comprobación. Las tablas y los gráficos del artículo proceden de esos registros.
Estos son los identificadores de las dos solicitudes independientes del ejemplo mínimo de llamada.
gpt-6.2-astra:83b6190a33a5765d75070b0cf645e4ca.gpt-6-astra:6a229d1cd68136b18781f531d8a5d77e.
Preguntas frecuentes#
¿GPT-6.2 Astra es necesariamente más inteligente que GPT-6 Astra?#
Esta ronda no permite llegar a esa conclusión. Se probaron 8 tipos de tareas en dos rondas por tipo y ambos modelos resolvieron correctamente 16/16 tareas completas. Para evaluar si hay una mejora de capacidad hacen falta más tareas difíciles, casos reales de fallo y una evaluación independiente.
¿Cuánto más rápido es GPT-6.2 Astra que GPT-6 Astra?#
Depende de la tarea y de la métrica. En esta ronda, el tiempo medio en la selección bajo restricciones se redujo un 54.3%. Para el conjunto de solicitudes, la media bajó de 12.57 a 8.84 segundos, pero la mediana subió de 8.16 a 9.57 segundos. La mejora no se puede generalizar a todas las llamadas.
¿GPT-6.2 Astra es más barato?#
En el tramo oficial Standard para entradas cortas, los precios unitarios de entrada sin caché y de salida son un 20% más bajos. En esta prueba, el modelo anterior tenía un descuento del 35% en Crazyrouter (se pagaba el 65% de la tarifa). Además, el consumo de tokens y el uso de la caché fueron distintos entre ambos modelos. Al completar el mismo conjunto de tareas, el coste total real de 6.2 Astra fue mayor.
¿GPT-6.2 Astra tiene una ventana de contexto más amplia?#
Según las páginas oficiales consultadas, ambos modelos tienen una ventana de 1,050,000 tokens y admiten una entrada máxima de 922,000 tokens. [1][2] El mayor volumen de entrada reportado en nuestras solicitudes fue de 14,326 tokens, así que no se comprobó el rendimiento con un contexto de un millón de tokens.
¿Devolver JSON demuestra que se probó la función de salidas estructuradas?#
No. En esta ronda se pidió mediante un prompt que la respuesta se diera en JSON. Después, un programa analizó el resultado y lo cotejó con la respuesta esperada. No se probaron las restricciones obligatorias mediante JSON Schema ni se verificaron el streaming, las llamadas a herramientas o la Responses API.
¿Que las 32 solicitudes hayan salido bien demuestra estabilidad a largo plazo?#
Solo demuestra que estas 32 solicitudes de la prueba principal no tuvieron fallos HTTP, truncamientos ni errores en las respuestas. La muestra corresponde a un solo periodo y a un solo canal, con únicamente dos ejecuciones por tarea. No sirve como medida de disponibilidad a largo plazo ni como SLA de producción.
Fuentes y material de reproducción
- OpenAI — Documentación del modelo GPT-6.2 Astra, consultada el 2026-11-20.
- OpenAI — Documentación del modelo GPT-6 Astra, consultada el 2026-11-20.
- PostgreSQL — Aislamiento de transacciones y Read Committed, consultada para verificar las reglas de la tarea sobre transacciones.
Por Boluo Z. Las pruebas se ejecutaron con un script automatizado. El artículo documenta el rendimiento del servicio a través del enrutamiento de Crazyrouter. No se realizó una auditoría independiente de los pesos de los modelos del proveedor. Está previsto volver a comprobar la información sobre precios y capacidades, que puede cambiar, el 2026-12-20.
Implementation Guides
Podcast
AI Dev Tools: The Crazyrouter Podcast
Episodios breves (en inglés) para desarrolladores: API de IA, gateways, control de costes y herramientas de código.
Últimos episodios
EP196 · 29 oct 2026 · 6:53
AI API Security Posture — Turn Controls Into Continuous Evidence
A practical guide to AI API security posture: inventory exposure, verify controls continuously, protect keys and data, constrain tools, and turn security assumptions into evidence that operators can act on.
EP195 · 28 oct 2026 · 7:21
AI API Policy Drift — Detect When Production Rules Stop Matching Intent
A practical guide to policy drift in AI APIs: version routing and safety rules, detect stale enforcement, compare intended and observed behavior, and restore control before small gaps become incidents.