简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
GPT-6.2 Sol frente a GPT-6 Sol en 32 pruebas: ¿vale la pena pagar más por una mayor precisión?
32 pruebas por el mismo canal: GPT-6.2 Sol 16/16, GPT-6 Sol 13/16. Tres fallos, tiempos por tarea, descuento, coste real y migración de reasoning_effort.
Si GPT-6 Sol ya resuelve el trabajo del día a día, la decisión de pasar a GPT-6.2 Sol debería basarse en tareas concretas. ¿Corrige los resultados que antes solían salir mal? ¿Reduce el tiempo de espera? ¿Compensa el coste adicional?
En las 32 pruebas realizadas por el mismo canal de Crazyrouter, GPT-6.2 Sol superó 16/16 pruebas completas y GPT-6 Sol, 13/16. El nuevo modelo redujo un 38.4% el tiempo medio en el problema de optimización con restricciones, pero su coste real fue un 53.2% mayor. Estos resultados respaldan probar primero 6.2 Sol en trabajos que exigen recuentos exactos y soluciones óptimas. Si las tareas actuales ya se superan de forma estable y el coste es prioritario, sigue mereciendo la pena conservar 6 Sol.
En esta comparativa se mantuvieron los ocho tipos de tareas y el método de evaluación del artículo anterior sobre Astra, pero todas las solicitudes de Sol se ejecutaron de nuevo. Las dos series se probaron en momentos distintos y con estados de caché diferentes, por lo que no conviene combinar los costes de ambos artículos en una clasificación entre series.
Cambios oficiales: misma ventana y mismos precios de entrada y salida#
La información se comprobó el 20 de noviembre de 2026. Los datos siguientes proceden de la documentación oficial de ambos modelos y no se han inferido de sus números de versión.[1][2]
| Característica | GPT-6.2 Sol | GPT-6 Sol |
|---|---|---|
| Nombre del modelo | gpt-6.2-sol | gpt-6-sol |
| Entrada / salida | Texto e imágenes de entrada, texto de salida | Texto e imágenes de entrada, texto de salida |
| Ventana de contexto | 1,050,000 tokens | 1,050,000 tokens |
| Entrada máxima / salida máxima | 922,000 / 128,000 tokens | 922,000 / 128,000 tokens |
| Fecha de corte del conocimiento | 2026-06-01 | 2026-04-20 |
| Tarifa oficial de entrada sin caché | $2 / millón de tokens | $2 / millón de tokens |
| Tarifa oficial de lectura de caché | $0.10 / millón de tokens | $0.20 / millón de tokens |
| Tarifa oficial de salida | $10 / millón de tokens | $10 / millón de tokens |
reasoning_effort: none | La documentación oficial indica que se rechaza este valor | La documentación oficial lo incluye entre los valores admitidos |
Los precios corresponden al nivel Standard para entradas de hasta 272K tokens. La documentación de ambos modelos indica que, al superar los 272K tokens de entrada, las tarifas de entrada y de caché se duplican y la tarifa de salida pasa a ser 1.5 veces la del tramo de entradas más cortas.[1][2]
Es fácil interpretar estos datos como que «el nuevo modelo es más barato». Los dos modelos Sol tienen los mismos precios oficiales de entrada sin caché y de salida. El precio unitario que baja es el de lectura de caché, con una reducción del 50%. El ahorro depende de la proporción de tokens leídos de la caché, del consumo real de tokens y de los descuentos de la plataforma que utilices.
Las fichas oficiales también enumeran las capacidades de procesamiento de imágenes y de uso de herramientas. En este artículo solo probamos Chat Completions con texto. La lista de capacidades oficiales no acredita que todas esas funciones se hayan verificado en Crazyrouter.
Configuración de las pruebas: comprobaciones de parámetros y código aparte de las 32 solicitudes principales#
La prueba principal se ejecutó el 20 de noviembre de 2026, de 12:55 a 12:59, hora de Pekín. Primero se verificó la disponibilidad de ambos modelos mediante /v1/models y después se compararon a través del mismo canal del proveedor.
| Condición | Configuración de la prueba |
|---|---|
| Punto de acceso | Crazyrouter, https://api.crazyrouter.com/v1 |
| Endpoint | POST /chat/completions |
| Control de enrutamiento | Se fijó el mismo canal del proveedor y se comprobó que coincidía en cada uno de los 32 registros de consumo |
| Prompts | Se usaron exactamente los mismos mensajes system y user para cada tarea |
| Razonamiento / presupuesto de salida | reasoning_effort: high, max_completion_tokens: 8192 |
| Modo de respuesta | Sin streaming, stream: false |
| Distribución de solicitudes | 8 tipos de tareas × 2 rondas por modelo, con orden aleatorio y concurrencia total de 2 |
| Criterio para superar la prueba completa | HTTP 200, finish_reason=stop, JSON válido y coincidencia campo por campo con la respuesta de referencia fijada de antemano |
Las tareas abarcaron la búsqueda en tablas de reglas, la comprobación de premisas erróneas, la optimización con grafos de dependencias, la selección con restricciones, la reconstrucción de una factura, la visibilidad de transacciones, el orden de deduplicación y los límites de intervalos. Las respuestas de referencia se fijaron antes de enviar las solicitudes y se excluyeron de los prompts enviados a los modelos.
El tiempo se midió desde el envío de la solicitud por el cliente hasta la recepción de la respuesta completa. Incluye la red, la espera en cola, el razonamiento y la generación de la salida, y no corresponde a la latencia hasta el primer token. Las seis primeras tareas procedían de un conjunto de pruebas anterior y la caché no se vació. Por tanto, los costes corresponden a la ejecución real y no a un experimento con caché fría.
La compatibilidad de los parámetros y el ejemplo de este artículo se probaron por separado y no se incluyen en las 32 solicitudes principales. Algunas solicitudes adicionales coincidieron con el periodo de la prueba principal, de modo que la medición de rendimiento no se hizo en condiciones de aislamiento estricto. El mayor volumen de entrada reportado en la prueba principal fue de 14,377 tokens. No se verificó el contexto de un millón de tokens ni se probó la modificación de un repositorio completo o la ejecución de código generado por los modelos.
Resultados: 6.2 Sol superó todas las pruebas y 6 Sol falló en dos tipos de tareas#
| Tarea | 6.2 Sol, aciertos | 6 Sol, aciertos | Tiempo medio de 6.2 | Tiempo medio de 6 |
|---|---|---|---|---|
| Búsqueda en una tabla extensa de reglas | 2/2 | 2/2 | 15.60 segundos | 15.12 segundos |
| Corrección de una premisa errónea | 2/2 | 0/2 | 15.39 segundos | 19.60 segundos |
| Optimización con un grafo de dependencias | 2/2 | 2/2 | 8.43 segundos | 9.74 segundos |
| Selección de un conjunto óptimo con restricciones | 2/2 | 1/2 | 20.24 segundos | 32.86 segundos |
| Reconstrucción de una factura | 2/2 | 2/2 | 14.44 segundos | 11.32 segundos |
| Visibilidad de transacciones | 2/2 | 2/2 | 8.54 segundos | 6.20 segundos |
| Deduplicación antes del filtrado | 2/2 | 2/2 | 8.79 segundos | 6.52 segundos |
| Razonamiento sobre los límites de intervalos | 2/2 | 2/2 | 8.51 segundos | 5.70 segundos |
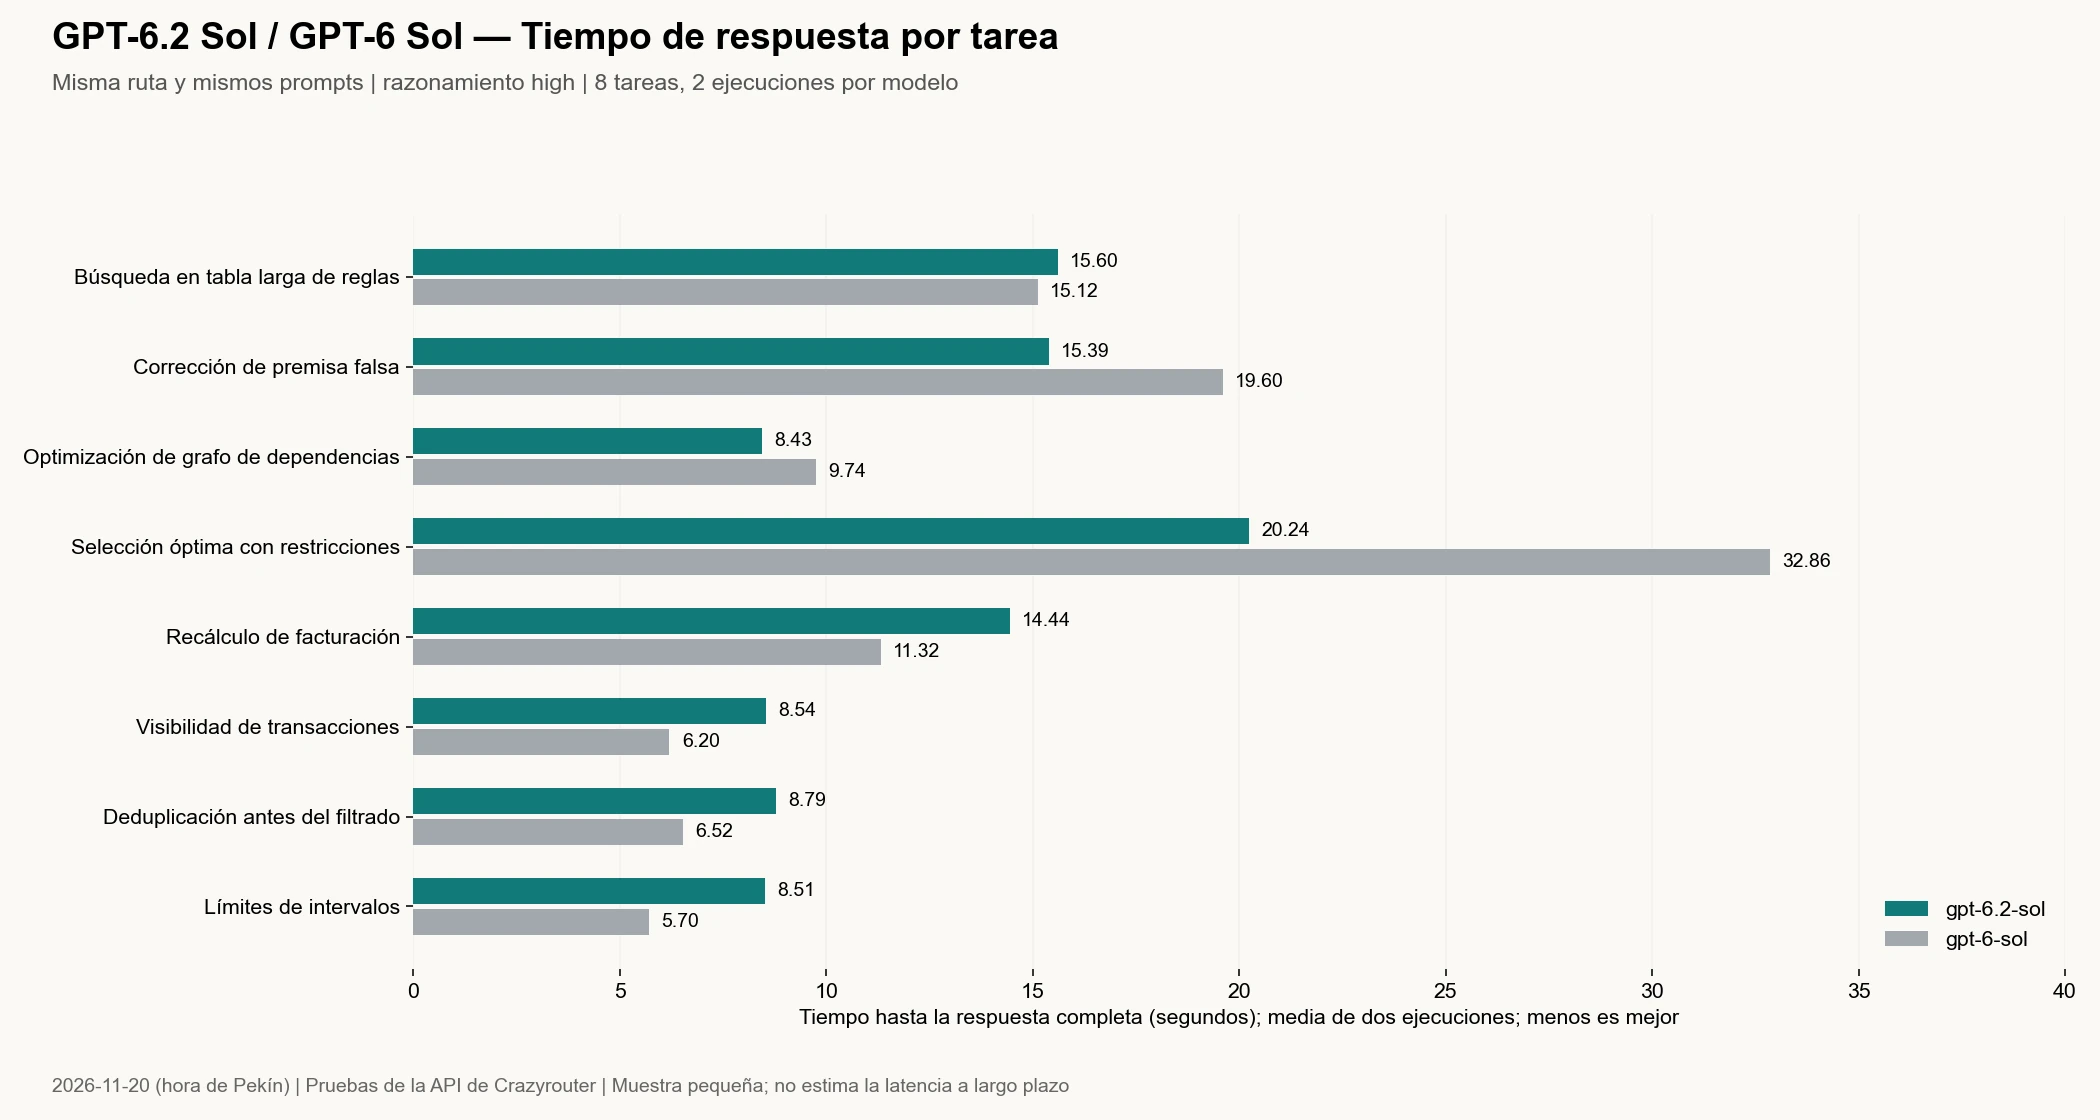
Los tiempos incluyen las solicitudes con respuestas incorrectas. Cada celda recoge solo dos mediciones, por lo que tiempos similares no indican una ventaja estable.
Las 32 solicitudes de ambos modelos devolvieron HTTP 200 y un JSON válido, y todas finalizaron con stop. La diferencia estuvo en la corrección de las respuestas. Los tres fallos de GPT-6 Sol fueron errores semánticos.
Primer error: rechazó la premisa errónea, pero no acertó el recuento#
La tarea proporcionaba 360 reglas y pedía comprobar la afirmación de que «se activan exactamente dos reglas SETTLED con delay=8» y devolver el total de reglas que cumplían la condición.
El estado de las reglas sigue un ciclo de cinco entradas, por lo que hay 72 reglas SETTLED. Todos los valores de delay_gt están entre 1 y 7, así que con delay=8 las 72 reglas cumplen la condición de activación.
Ambos modelos negaron correctamente que fueran «exactamente dos», pero dieron recuentos distintos.
| Campo devuelto | Respuesta de referencia | Dos rondas de GPT-6.2 Sol | Dos rondas de GPT-6 Sol |
|---|---|---|---|
exactly_two | false | false en ambas | false en ambas |
matching_count | 72 | 72, 72 | 69, 71 |
winner_policy_specified | false | Correcto en ambas | Correcto en ambas |
max_days_among_matches | 116 | Correcto en ambas | Correcto en ambas |
Si solo se comprueba si el modelo contradijo al compañero, las cuatro respuestas parecen correctas. Al verificar cada campo, el modelo anterior se quedó corto en el recuento en ambas rondas y por eso no superó ninguna de las dos pruebas completas.
Este tipo de diferencia importa al cotejar facturas, auditar reglas o filtrar datos por lotes. Una respuesta bien redactada no sustituye un recuento exacto, del mismo modo que un JSON válido no sustituye la validación de negocio.
Segundo error: propuso una solución factible, pero pasó por alto el óptimo#
El problema de selección con restricciones pedía elegir, entre 12 elementos, el conjunto de mayor valor total sin superar el límite de peso ni seleccionar más de 5 elementos, y respetando las dependencias y las incompatibilidades.
Al enumerar los 4,096 subconjuntos posibles se obtuvo una única solución óptima.
{"best_value":78,"optimal_sets":[[0,2,6,9,11]]}
GPT-6.2 Sol acertó en ambas rondas. GPT-6 Sol acertó en la primera y devolvió lo siguiente en la segunda.
{"best_value":77,"optimal_sets":[[0,2,4,6,9],[0,4,6,8,11]]}
La solución de la segunda ronda satisface las restricciones y tiene efectivamente un valor de 77, pero el modelo no encontró la solución de valor 78. Encontró una buena solución factible y dejó sin resolver lo que pedía la tarea, que era hallar el óptimo.
En esta tarea, 6.2 Sol tardó 20.24 segundos de media y 6 Sol, 32.86 segundos, una reducción de aproximadamente el 38.4%. Estos resultados respaldan incluir tareas similares con restricciones en las pruebas del nuevo modelo, aunque dos rondas no bastan para demostrar que todos los problemas de optimización se resolverán con más rapidez o precisión.
La ventaja en velocidad no es general: media algo menor y mediana mayor#
| Estadísticas de las 16 solicitudes principales por modelo | GPT-6.2 Sol | GPT-6 Sol |
|---|---|---|
| HTTP 200 / JSON válido | 16/16 | 16/16 |
| Pruebas completas superadas | 16/16 | 13/16 |
| Proporción de pruebas completas superadas en esta ronda | 100% | 81.25% |
| Tiempo medio de respuesta completa | 12.49 segundos | 13.38 segundos |
| Mediana del tiempo de respuesta completa | 12.48 segundos | 11.14 segundos |
| Tiempo mínimo / máximo | 5.29 / 20.28 segundos | 5.58 / 34.79 segundos |
6.2 Sol fue más rápido de media en tres tipos de tareas: premisas erróneas, grafos de dependencias y selección con restricciones. En las otras cinco no obtuvo un tiempo medio menor. El ahorro de tiempo en la selección con restricciones redujo la media global, mientras que la mediana siguió la tendencia contraria.
La razón para actualizar se puede formular así: «En esta ronda, 6.2 Sol fue más preciso en tareas concretas y redujo la espera en la resolución de un problema con restricciones que llevaba más tiempo». Los resultados no respaldan afirmar que «6.2 Sol es más rápido en general». Del mismo modo, el 100% y el 81.25% corresponden a esta muestra y no constituyen una evaluación general de las capacidades ni una garantía de fiabilidad a largo plazo.
Costes: mismos precios oficiales, distinta factura según el descuento de Crazyrouter y el consumo real#
En el grupo default de Crazyrouter que se comprobó para esta comparativa, GPT-6 Sol tiene un 35% de descuento (se paga el 65%) y GPT-6.2 Sol mantiene la tarifa original. Estos son los precios de Crazyrouter para el tramo de entradas más cortas, con el descuento aplicado cuando corresponde.
| Por millón de tokens | GPT-6.2 Sol | GPT-6 Sol |
|---|---|---|
| Entrada sin caché | $2.00 | $1.30 |
| Lectura de caché | $0.10 | $0.13 |
| Salida | $10.00 | $6.50 |
La lectura de caché es más barata con el nuevo modelo, mientras que la entrada sin caché y la salida cuestan menos con el anterior. Para calcular tu propio coste, vuelve a consultar la página de precios de Crazyrouter. Comparar solo los números de versión o los precios oficiales no basta.
Las 32 solicitudes principales se vincularon con sus registros de consumo mediante el ID de solicitud. Los importes de la tabla se obtuvieron dividiendo los cargos reales por el valor quota_per_unit=500000 de Crazyrouter.
| Consumo y coste reales | GPT-6.2 Sol | GPT-6 Sol |
|---|---|---|
| Número de solicitudes principales | 16 | 16 |
| Tokens de entrada reportados por el proveedor | 125,998 | 112,964 |
| De ellos, tokens leídos de la caché | 56,576 | 55,168 |
| Proporción de tokens de entrada leídos de la caché | 44.9% | 48.8% |
| Tokens de salida (incluye el consumo de razonamiento) | 5,460 | 7,325 |
| Coste real | $0.199104 | $0.129922 |
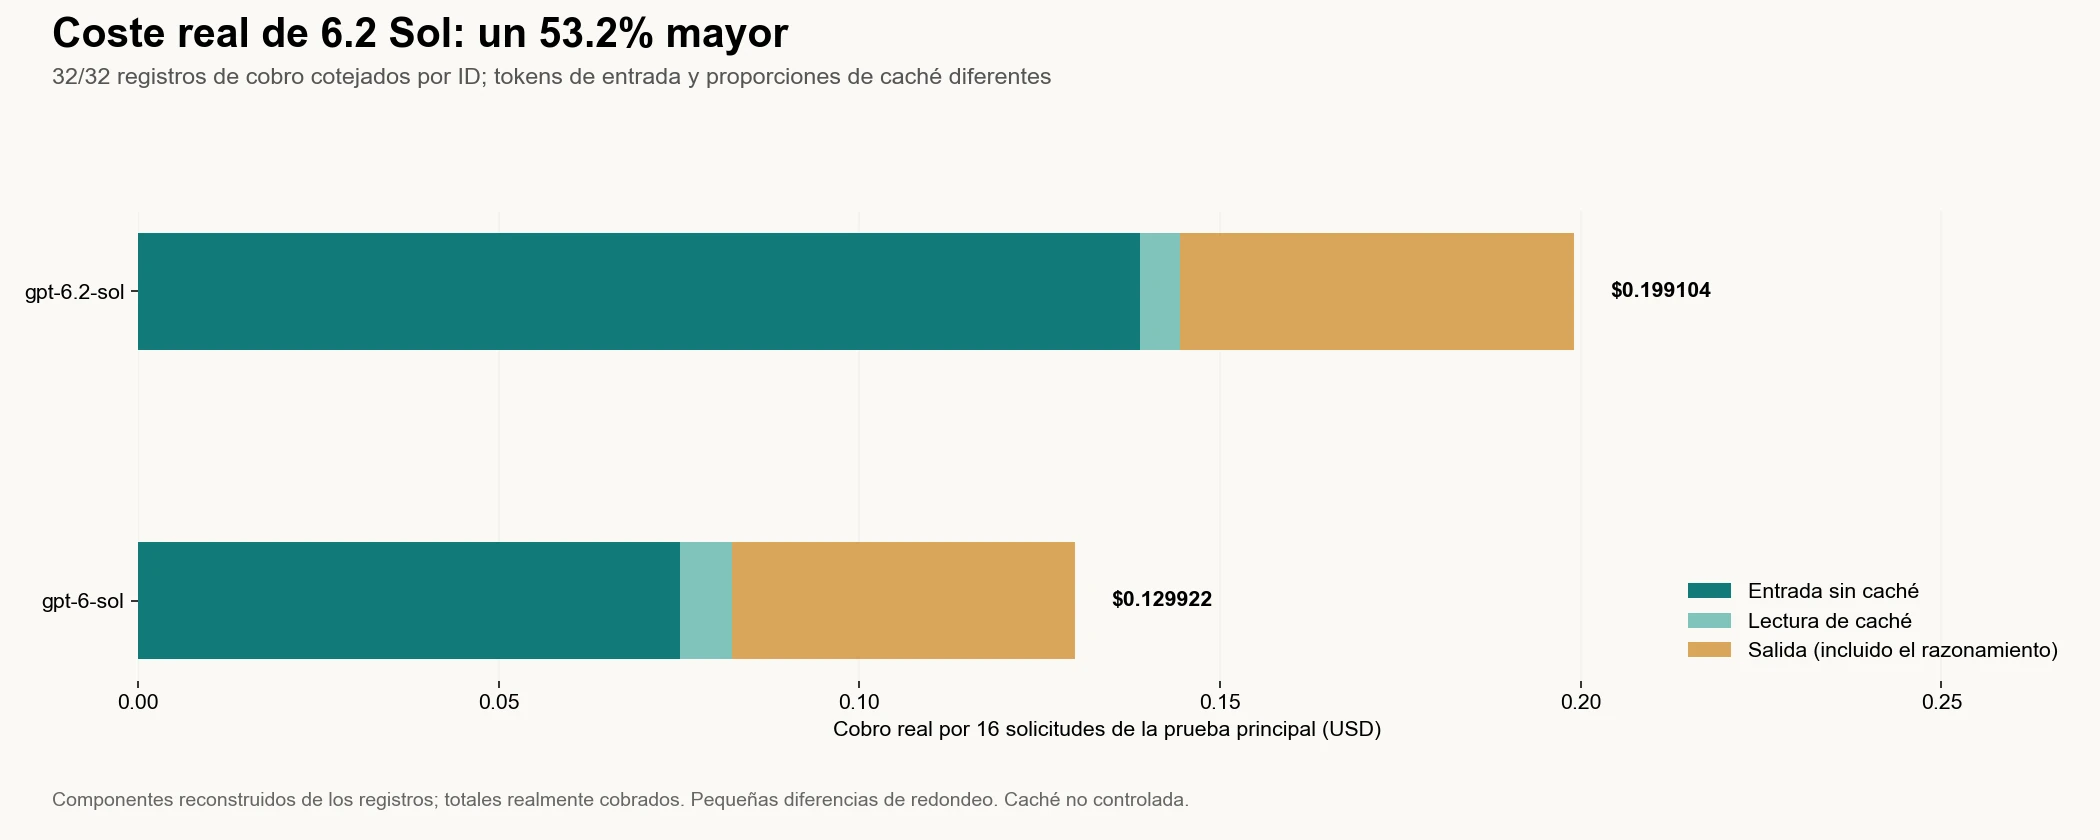
El total corresponde al importe efectivamente cobrado y las partidas se reconstruyeron a partir de los registros. Las pequeñas diferencias se deben al redondeo. Los costes incluyen las solicitudes con respuestas incorrectas y excluyen la comprobación de parámetros, el ejemplo de código y la generación de la portada.
El nuevo modelo costó un 53.2% más en esta ronda, aunque también resolvió correctamente las tareas en las que la versión anterior falló alguna vez. Los tres errores de la versión anterior también generaron cargos. La tabla no incluye el coste de la revisión manual, los reintentos ni las correcciones en condiciones reales de trabajo.
Con los mismos prompts visibles, el proveedor reportó volúmenes de entrada distintos, y el nuevo modelo registró menos tokens de salida. No se determinó la causa concreta de la diferencia en el volumen de entrada reportado ni se igualó el estado de la caché. Por tanto, el 53.2% describe esta ejecución y no se puede tomar como un incremento fijo para todos los usuarios en el futuro.
Comprobación previa a la migración: el valor none de la configuración anterior no se puede conservar sin cambios#
La documentación oficial indica que GPT-6 Sol admite reasoning_effort: none y que GPT-6.2 Sol rechaza ese valor.[1][2] Por el mismo canal se envió además una solicitud breve de JSON a cada modelo, configurando none de forma explícita.
| Comprobación adicional del parámetro | GPT-6.2 Sol | GPT-6 Sol |
|---|---|---|
| Estado HTTP | 400 | 200 |
| Respuesta | provider_temporarily_unavailable, mensaje genérico de servicio no disponible | {"ok":true}, finalización normal |
El resultado coincide con la diferencia de compatibilidad descrita en la documentación oficial, pero Crazyrouter tradujo el error de 6.2 a un mensaje genérico que no señalaba explícitamente none. El mensaje «servicio temporalmente no disponible» no basta para determinar la causa del fallo, y tampoco conviene reintentar indefinidamente con la misma configuración incompatible.
Antes de migrar, revisa los parámetros de las solicitudes existentes y prueba un nivel de razonamiento que esté expresamente admitido. Tanto la prueba principal como el ejemplo de este artículo usan high. Además, la ficha oficial de GPT-6 Sol indica restricciones en el nivel de razonamiento para las llamadas a funciones desde Chat Completions. Las aplicaciones que usan herramientas necesitan pruebas de regresión por separado. En este artículo no se verificaron las llamadas a herramientas ni la Responses API.
Un ejemplo ejecutado con ambos modelos#
El siguiente ejemplo pide fusionar intervalos semiabiertos que se solapan o son adyacentes. Instala requests, configura tu propia clave en la variable de entorno CRAZYROUTER_API_KEY y ejecuta el ejemplo. La URL de la API no lleva parámetros UTM.
import json
import os
import requests

BASE_URL = "https://api.crazyrouter.com/v1"
MODELS = ["gpt-6.2-sol", "gpt-6-sol"]
PROMPT = ('Merge overlapping OR TOUCHING half-open intervals [[-3,2],[1,5],[5,9]] into maximal intervals. '
          'Return JSON only: {"merged":[[start,end]],"length":integer}.')


def run():
    session = requests.Session()
    session.trust_env = False
    results = []
    for model in MODELS:
        response = session.post(
            BASE_URL + "/chat/completions",
            headers={"Authorization": "Bearer " + os.environ["CRAZYROUTER_API_KEY"]},
            json={
                "model": model,
                "messages": [{"role": "user", "content": PROMPT}],
                "reasoning_effort": "high",
                "max_completion_tokens": 8192,
                "stream": False,
            },
            timeout=(15, 180),
        )
        response.raise_for_status()
        data = response.json()
        choice = data["choices"][0]
        if choice["finish_reason"] != "stop":
            raise RuntimeError("Incomplete output: " + str(choice["finish_reason"]))
        answer = json.loads(choice["message"]["content"])
        assert answer == {"merged": [[-3, 9]], "length": 12}, answer
        result = {"model": model, "answer": answer,
                  "request_id": response.headers.get("x-oneapi-request-id")}
        print(json.dumps(result, ensure_ascii=False))
        results.append(result)
    return results


if __name__ == "__main__":
    run()
La versión final se verificó mediante una llamada a cada modelo. Ambos devolvieron {"merged":[[-3,9]],"length":12} con finish_reason=stop. Las dos llamadas utilizaron el enrutamiento habitual de usuario y se contabilizaron por separado de la prueba principal con canal fijo.
El prompt del ejemplo también requirió un ajuste. Al principio solo decía «fusiona los intervalos semiabiertos» y 6.2 Sol devolvió [[-3,5],[5,9]]. La longitud seguía siendo 12, pero la salida no satisfacía la aserción del programa que exigía un solo intervalo. Una vez especificado «fusiona los intervalos que se solapen o sean adyacentes para obtener intervalos maximales», ambos modelos superaron la prueba. Se conservó el registro de esa revisión del ejemplo. En la tarea de intervalos de la prueba principal se exigía desde el principio fusionar los intervalos adyacentes. No se modificó el enunciado ni se repitió la prueba para sustituir sus resultados.
Puedes consultar los campos de la interfaz en la documentación de la API de Crazyrouter. Los equipos que usan Codex o Cursor deberían ejecutar pruebas de regresión con sus propias tareas y herramientas. Superar un ejemplo de texto no equivale a verificar todo el flujo de trabajo con agentes.
¿Cuándo vale la pena cambiar a GPT-6.2 Sol?#
| Caso de uso | Opción respaldada por los resultados de esta ronda |
|---|---|
| Recuentos exactos o filtrado de reglas con problemas de omisiones | Probar primero 6.2 Sol y mantener la verificación mediante código |
| Selección óptima con dependencias e incompatibilidades | Probar 6.2 Sol, que acertó en ambas rondas y redujo la espera media |
| Procesamiento habitual de datos que ya supera las pruebas de regresión de negocio, con prioridad en el coste | Mantener 6 Sol es una opción, ya que la tarifa con descuento de Crazyrouter es actualmente más baja |
| La prioridad es reducir el tiempo de respuesta | Probar primero con tus propios tipos de tareas. En esta ronda el modelo nuevo solo fue más rápido de media en tres tipos |
Las solicitudes anteriores usan siempre reasoning_effort: none | Adaptar primero el nivel de razonamiento y después cambiar el nombre del modelo |
| Se necesita interpretar imágenes, llamar a herramientas o ejecutar agentes durante periodos prolongados | Verificar esas capacidades por separado, ya que no se pueden deducir de los resultados de esta ronda |
Puedes usar Model Arena para una primera comparación con las mismas tareas y después reunir los casos reales que hayan fallado en un conjunto fijo de pruebas de regresión. Definir un criterio de aceptación para cada campo importante ayuda más a determinar si la actualización resuelve el problema real que juzgar la fluidez de una sola respuesta.
Cómo reproducir el problema de optimización con restricciones#
A continuación figura el prompt completo del usuario. En la prueba principal se utilizó el nivel de razonamiento high y un presupuesto de salida de 8192, y el mensaje system pidió que se devolviera únicamente JSON. La respuesta de referencia se utilizó solo para la evaluación local y no se envió al modelo.
Items IDs 0..11 have weights [4, 7, 2, 9, 5, 3, 8, 6, 4, 7, 1, 5] and values [13, 18, 7, 26, 14, 9, 23, 16, 12, 20, 4, 15]. Select total weight <=26 and at most 5 items. Constraints: selecting 3 requires 1; 6 and 7 cannot both be selected; selecting 9 requires 2; at least one of 0 and 4 must be selected. Maximize total value. Return JSON with best_value and optimal_sets (ALL optimal ID lists sorted ascending, and lists lexicographically sorted).
Esta es la respuesta de referencia calculada de antemano.
{"best_value": 78, "optimal_sets": [[0, 2, 6, 9, 11]]}
Para verificar la solución óptima, basta con enumerar todos los subconjuntos de los 12 candidatos y descartar los que incumplan las condiciones de peso, cantidad, dependencia o incompatibilidad. Las solicitudes y respuestas originales y los registros de cada cargo se han archivado para su comprobación. Todas las tablas y gráficos de este artículo proceden de esos registros.
Estos son los ID de las dos solicitudes independientes del ejemplo mínimo de llamada de este artículo.
gpt-6.2-sol:8f830a249943b0b13a1ec388dbf882f6.gpt-6-sol:f08d86841a979c9bf2d8928816e31789.
Preguntas frecuentes#
¿Es GPT-6.2 Sol más preciso que GPT-6 Sol?#
En esta ronda se hicieron dos pruebas por cada uno de los ocho tipos de tareas. El nuevo modelo obtuvo 16/16 y el anterior, 13/16. La diferencia se concentró en el recuento de reglas y en la optimización con restricciones. Estos resultados no se pueden extrapolar a una tasa de acierto para todo tipo de tareas.
¿Cuánto más rápido es GPT-6.2 Sol que GPT-6 Sol?#
En esta ronda, el tiempo medio de selección con restricciones se redujo un 38.4% y el tiempo medio de todas las solicitudes bajó aproximadamente un 6.6%. Sin embargo, la mediana pasó de 11.14 segundos a 12.48 segundos. El nuevo modelo no es más rápido en todos los tipos de tareas.
¿Ha bajado el precio de la API de GPT-6.2 Sol?#
Los precios oficiales de entrada sin caché y de salida se mantienen. La lectura de caché baja de 0.10 por millón de tokens. En Crazyrouter, el modelo anterior tiene actualmente un 35% de descuento (se paga el 65%), por lo que el coste total real del nuevo modelo fue mayor en esta ronda.
¿Compensa el coste adicional?#
Si un recuento incompleto o una solución subóptima del modelo anterior puede ocasionar pérdidas para el negocio, conviene incluir el nuevo modelo entre los candidatos que se van a probar. Si las tareas actuales ya se superan de forma estable, se puede mantener el modelo anterior. En esta ronda no se midió el coste de los reintentos ni de la corrección manual, por lo que no se puede calcular el beneficio para todos los casos de uso.
¿Por qué se considera incorrecta una respuesta si la llamada a la API tuvo éxito?#
HTTP 200, un JSON válido y una finalización normal solo confirman que se completó la solicitud. En los tres fallos del modelo anterior, la estructura de la respuesta era correcta, pero los valores de los campos no coincidían con la respuesta de referencia fijada de antemano. Por ello, las pruebas completas se consideraron fallidas.
¿Puedo cambiar directamente el nombre del modelo a gpt-6.2-sol?#
Puedes conservar la URL base y el método de llamada con texto, pero revisa primero el parámetro de razonamiento. La documentación oficial indica expresamente que el nuevo modelo no acepta el valor none, y la comprobación en Crazyrouter también devolvió HTTP 400. El streaming, las herramientas, las imágenes y otras funciones todavía deben probarse por separado.
Fuentes
- Documentación del modelo GPT-6.2 Sol, consultada el 2026-11-20. OpenAI.
- Documentación del modelo GPT-6 Sol, consultada el 2026-11-20. OpenAI.
- Documentación sobre aislamiento de transacciones y Read Committed, utilizada para verificar las reglas de la tarea de transacciones. PostgreSQL.
Por Brian J. Las pruebas se ejecutaron mediante scripts automatizados. El artículo documenta el rendimiento real del servicio con el enrutamiento de Crazyrouter. No se realizó una auditoría independiente de los pesos de los modelos del proveedor. Cada tarea solo se ejecutó dos veces por modelo, en un único canal y durante un único periodo, y no se aisló la caché de ejecuciones anteriores. Se archivaron las solicitudes y respuestas originales, las respuestas de referencia y los registros de costes anonimizados. Está previsto revisar la información sujeta a cambios el 2026-12-20.
Implementation Guides
Podcast
AI Dev Tools: The Crazyrouter Podcast
Episodios breves (en inglés) para desarrolladores: API de IA, gateways, control de costes y herramientas de código.
Últimos episodios
EP196 · 29 oct 2026 · 6:53
AI API Security Posture — Turn Controls Into Continuous Evidence
A practical guide to AI API security posture: inventory exposure, verify controls continuously, protect keys and data, constrain tools, and turn security assumptions into evidence that operators can act on.
EP195 · 28 oct 2026 · 7:21
AI API Policy Drift — Detect When Production Rules Stop Matching Intent
A practical guide to policy drift in AI APIs: version routing and safety rules, detect stale enforcement, compare intended and observed behavior, and restore control before small gaps become incidents.