简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
Claude Opus 5.5 vs GPT-6.1 Sol: pruebas, precios y elección
Compara las pruebas oficiales y los precios API de Claude Opus 5.5 y GPT-6.1 Sol, junto con 16 solicitudes de Crazyrouter. Se distinguen los datos de los proveedores de la muestra local, sin comparación con Opus.
A fecha de 30 de octubre de 2026, las pruebas públicas no bastan para establecer una clasificación general de Claude Opus 5.5 y GPT-6.1 Sol válida para todas las tareas. En 16 solicitudes de tareas a GPT-6.1 Sol mediante un canal fijo, Crazyrouter registró 14 entregas, con 13/14 respuestas entregadas completamente correctas; al no disponer de una muestra de Opus 5.5 con las mismas tareas, estos datos locales no permiten determinar un ganador. Por separado, los materiales oficiales de lanzamiento afirman que GPT-6.1 Sol supera a Opus 5.5 en 2.2 puntos porcentuales en AutomationBench con un nivel de razonamiento medio, a un coste por tarea de aproximadamente un tercio; Opus 5.5, por su parte, muestra un techo de capacidad elevado en otro conjunto de pruebas de programación y ciencia con niveles altos de razonamiento. Estas evaluaciones de los proveedores no equivalen a una comparativa independiente realizada en el mismo laboratorio y con la misma configuración.
Si das prioridad al trabajo de agentes de programación prolongado y de varios pasos, puedes incluir Opus 5.5 entre tus primeras opciones; si tienes un gran volumen de tareas diarias y quieres controlar el coste de la API, merece la pena probar primero GPT-6.1 Sol. La elección final debe basarse en la tasa de éxito de tus propias tareas, las correcciones necesarias y la factura total, no solo en una clasificación concreta.
Claude Opus 5.5 vs GPT-6.1 Sol: ¿cuál encaja mejor en el trabajo diario?#
Ambos modelos se dirigen a ámbitos que se solapan, pero los datos públicos reflejan prioridades distintas: Opus 5.5 destaca en las pruebas de programación exigente, manejo de escritorio y trabajo del conocimiento publicadas por Anthropic; OpenAI enfatiza la eficiencia de costes de GPT-6.1 Sol en documentos profesionales, flujos de negocio e investigación científica. Las pruebas públicas respaldan una elección según la carga de trabajo, pero no permiten extrapolar la ventaja de un proveedor en una prueba concreta a una superioridad general.
Comparación rápida#
| Aspecto | Claude Opus 5.5 | GPT-6.1 Sol | Precauciones al interpretar los datos |
|---|---|---|---|
| Nombre oficial del modelo en la API | claude-opus-5-5 | gpt-6.1-sol | Al utilizar una pasarela de terceros, deben prevalecer su respuesta actual de /v1/models y su documentación |
| Precio estándar de la API / millón de tokens | Entrada 20; lectura de caché $0.20 | Entrada 10; entrada en caché $0.10 | Los precios estándar de entrada, salida y entrada en caché de GPT-6.1 Sol son aproximadamente la mitad de los de Opus 5.5; la factura real también depende de la caché, las herramientas y la longitud de la salida |
| Ventana de contexto de la API | 1,000,000 tokens | 1,050,000 tokens | La ventana realmente disponible también depende del producto, la interfaz y la configuración de la solicitud |
| Nivel de razonamiento predeterminado | medium; adaptive thinking siempre activado | medium | Que los niveles tengan el mismo nombre no garantiza el mismo presupuesto de razonamiento ni la misma cantidad de cómputo |
| Subconjunto SWE-bench Pro de Anthropic | medium: 92.8% de resolución, $0.22 / tarea resuelta | No hay una comparación pública en el mismo subconjunto | El subconjunto compatible original tenía 482 problemas; las dos ejecuciones de Opus 5.5 se puntuaron sobre 478 problemas y no equivalen al resultado de la clasificación pública |
| AutomationBench | Anthropic publica 40.0%; esa ejecución no utilizó fallback | OpenAI afirma que, con razonamiento medio, obtiene 2.2 puntos porcentuales más, a un coste por tarea de aproximadamente un tercio | La página de Anthropic también indica que su resultado de Opus 5.5 procede de pruebas tempranas de Zapier; deben distinguirse las condiciones de fallback y ejecución de los distintos informes |
| Documentos profesionales GDP.pdf | La comparación de OpenAI afirma que GPT-6.1 Sol supera a Opus 5.5 con fallback en todos los niveles de razonamiento probados, con un coste por tarea inferior a la mitad | Resultados declarados por OpenAI en sus materiales de lanzamiento | El texto publicado no enumera las puntuaciones completas de esta comparación; no permite deducir que GPT-6.1 Sol gane en todos los PDF o trabajos del conocimiento |
| Terminal-Bench 4.0 | Anthropic informa de 66.4%, con xhigh effort | La tabla de Anthropic no incluye GPT-6.1 Sol | El modelo GPT de referencia en esa tabla es GPT-6 Astra, no GPT-6.1 Sol |
| Terminal-Bench Science 0.1 | Anthropic informa de 58.7%; el error estándar es de ±3.5–5 puntos porcentuales | OpenAI informa de un coste medio por tarea de 23.21 de Opus 5.5; el texto del lanzamiento no proporciona la puntuación exacta de GPT-6.1 Sol | La tasa de éxito de las tareas y el coste por tarea son dos métricas distintas; un coste menor no puede describirse directamente como una precisión superior a la del otro modelo |
| Pequeña muestra local de Crazyrouter | No hay resultados de Opus 5.5 en las mismas tareas | 14 entregas de 16 solicitudes; 13/14 respuestas entregadas correctas y otras 2 solicitudes con tiempo de espera agotado | Registro independiente de una carga de trabajo del 2026-09-30 en un canal fijo; no es una comparación con Opus ni una medida de disponibilidad a largo plazo |
Las pruebas oficiales muestran ventajas distintas#
Flujos de negocio: la propuesta de costes de GPT-6.1 Sol es más explícita#
En sus materiales de lanzamiento del 29 de septiembre de 2026, OpenAI afirma que GPT-6.1 Sol supera a Opus 5.5 en 2.2 puntos porcentuales en AutomationBench con un nivel de razonamiento medio, a un coste por tarea de aproximadamente un tercio. AutomationBench evalúa a agentes que utilizan 47 herramientas para completar flujos de trabajo de principio a fin en ventas, marketing, operaciones, atención al cliente, finanzas y recursos humanos.
La página de Opus 5.5 de Anthropic, por su parte, indica un 40.0% en AutomationBench y especifica que esa ejecución no utilizó fallback; en la misma tabla, GPT-6 Astra obtiene 41.4%. Por tanto, al citar la comparación directa de OpenAI, debe mantenerse su atribución como resultado comparativo de los materiales de lanzamiento de OpenAI; no se pueden combinar las cifras de las páginas de ambos proveedores como si fueran un experimento independiente con condiciones de control idénticas. El fallback afecta a la tasa de finalización y al coste, así como a los resultados que recibe realmente el usuario.
Programación: Opus 5.5 destaca en los resultados públicos con razonamiento alto; hay menos puntuaciones directas de GPT-6.1 Sol#
Anthropic publica una puntuación de 66.4% para Opus 5.5 en Terminal-Bench 4.0, evaluado con el nivel de razonamiento xhigh; la misma página incluye un 57.9% de GPT-6 Astra, pero no un resultado de GPT-6.1 Sol en esa prueba. Anthropic también publica un 54.4% de Opus 5.5 en el conjunto principal de FrontierCode v1.1, por encima del 53.3% de GPT-6 Astra que figura en la tabla. Estas cifras muestran que Opus 5.5 es competitivo en las pruebas de agentes de programación enumeradas, pero no demuestran directamente que supere necesariamente a GPT-6.1 Sol, ya que los modelos de referencia, los niveles de razonamiento o las condiciones de evaluación no coinciden por completo.
La guía de costes de modelos de Anthropic también publica otro conjunto más reciente de datos de programación: su subconjunto compatible de SWE-bench Pro seleccionó inicialmente 482 problemas; debido a problemas con el contenedor de evaluación, las dos ejecuciones de Opus 5.5 en medium se puntuaron sobre los 478 problemas restantes, con una tasa de resolución de 92.8% y un coste aproximado de $0.22 por tarea resuelta. Anthropic señala expresamente que este subconjunto y sus condiciones de ejecución difieren de la clasificación pública de SWE-bench Pro y de los resultados de la ficha del sistema de Opus 5.5. OpenAI no ha publicado una puntuación de referencia de GPT-6.1 Sol en el mismo subconjunto, por lo que estas cifras solo aportan una referencia adicional de calidad y coste del propio Opus 5.5.
Las afirmaciones de OpenAI sobre GPT-6.1 Sol se centran en DeepSWE v1.1: según la empresa, GPT-6.1 Sol supera en 6.4 puntos porcentuales la puntuación máxima de GPT-6 Sol incluso con un nivel de razonamiento inferior, e iguala los resultados de GPT-6 Astra con un coste por tarea de aproximadamente una quinta parte. Este resultado aporta pruebas de la mejora de GPT-6.1 Sol respecto a la generación anterior de Sol, no una puntuación comparativa frente a Opus 5.5.
Documentos profesionales y tareas científicas: atender al coste de entrega y a si se publican las puntuaciones#
OpenAI afirma que GPT-6.1 Sol supera a "Opus 5.5 con fallback" en todos los niveles de razonamiento probados en GDP.pdf, con un coste por tarea inferior a la mitad. GDP.pdf exige responder preguntas profesionales a partir de PDF complejos con tablas, gráficos, diagramas y disposiciones detalladas. Como el texto del lanzamiento no proporciona a la vez las puntuaciones completas de cada nivel, los detalles de ejecución del fallback y un registro común de evaluación, esta conclusión sirve como orientación para elegir, pero no debe reformularse como un veredicto incondicional.
En Terminal-Bench Science 0.1, OpenAI informa de un coste medio por tarea de 23.21 para Opus 5.5. Anthropic informa de una puntuación de 58.7% para Opus 5.5 y señala un error estándar de ±3.5–5 puntos porcentuales; sin embargo, el texto del lanzamiento de OpenAI no enumera la puntuación exacta de GPT-6.1 Sol. Por tanto, es posible comparar la información pública sobre costes, pero esas dos afirmaciones no bastan para determinar qué modelo tiene una tasa de éxito superior en tareas científicas.
¿Qué diferencia hay entre los precios de las API?#
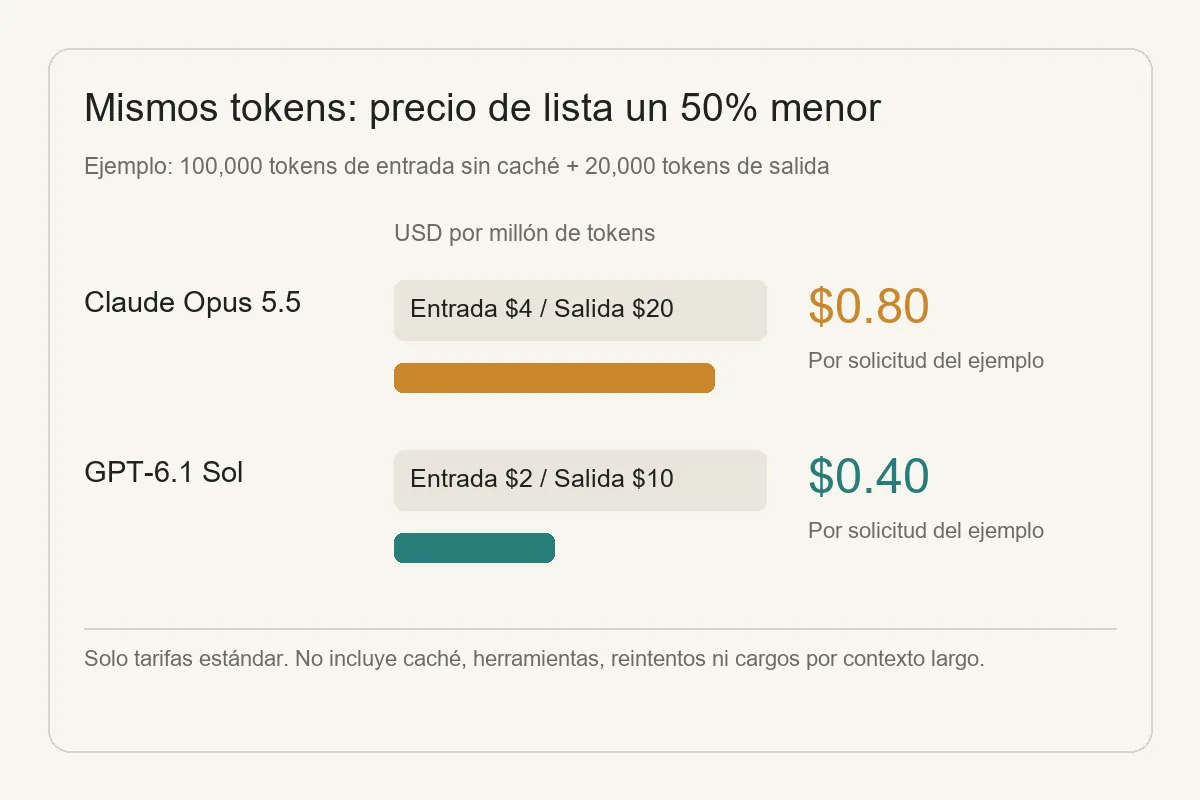
Según los precios estándar de las API publicados en las páginas oficiales de ambos proveedores, Opus 5.5 cuesta 20 por millón de tokens de salida; GPT-6.1 Sol cuesta 10. Si una solicitud utiliza 100,000 tokens de entrada sin caché y 20,000 tokens de salida, la estimación con los precios estándar es:
input_tokens = 100_000
output_tokens = 20_000

opus55 = input_tokens / 1_000_000 * 4 + output_tokens / 1_000_000 * 20
gpt61 = input_tokens / 1_000_000 * 2 + output_tokens / 1_000_000 * 10

print(f"Opus 5.5: ${opus55:.2f}")
print(f"GPT-6.1 Sol: ${gpt61:.2f}")
Este ejemplo da como resultado 0.40 para GPT-6.1 Sol. Solo compara los precios de tokens de texto sin caché; no incluye reintentos, llamadas a herramientas, recargos por contexto largo, estrategias de caché ni otros descuentos de plataformas de alojamiento. Cuando la entrada de una solicitud API a GPT-6.1 Sol supera los 272,000 tokens, la documentación oficial de precios indica que esa solicitud se factura con tarifas superiores de contexto largo; la documentación oficial de Opus 5.5, por su parte, indica que su ventana de contexto de 1M se factura a precios estándar. La medición de tokens, el consumo asociado al razonamiento y la configuración de producto de Anthropic y OpenAI tampoco tienen por qué ser idénticos, por lo que "la mitad del precio de lista" no significa que "la factura total del mismo flujo de trabajo sea necesariamente la mitad".
Antes de utilizarlos, puedes consultar modelos y formas de integración por proveedor, así como la comparación de precios de modelos. Para comprobar los catálogos de proveedores, también puedes consultar el catálogo de modelos de Anthropic y el catálogo de modelos de OpenAI. Los descuentos y las configuraciones de facturación de cada plataforma pueden diferir de los precios estándar de los proveedores.
¿Qué permiten concluir los registros de GPT-6.1 Sol de Crazyrouter?#
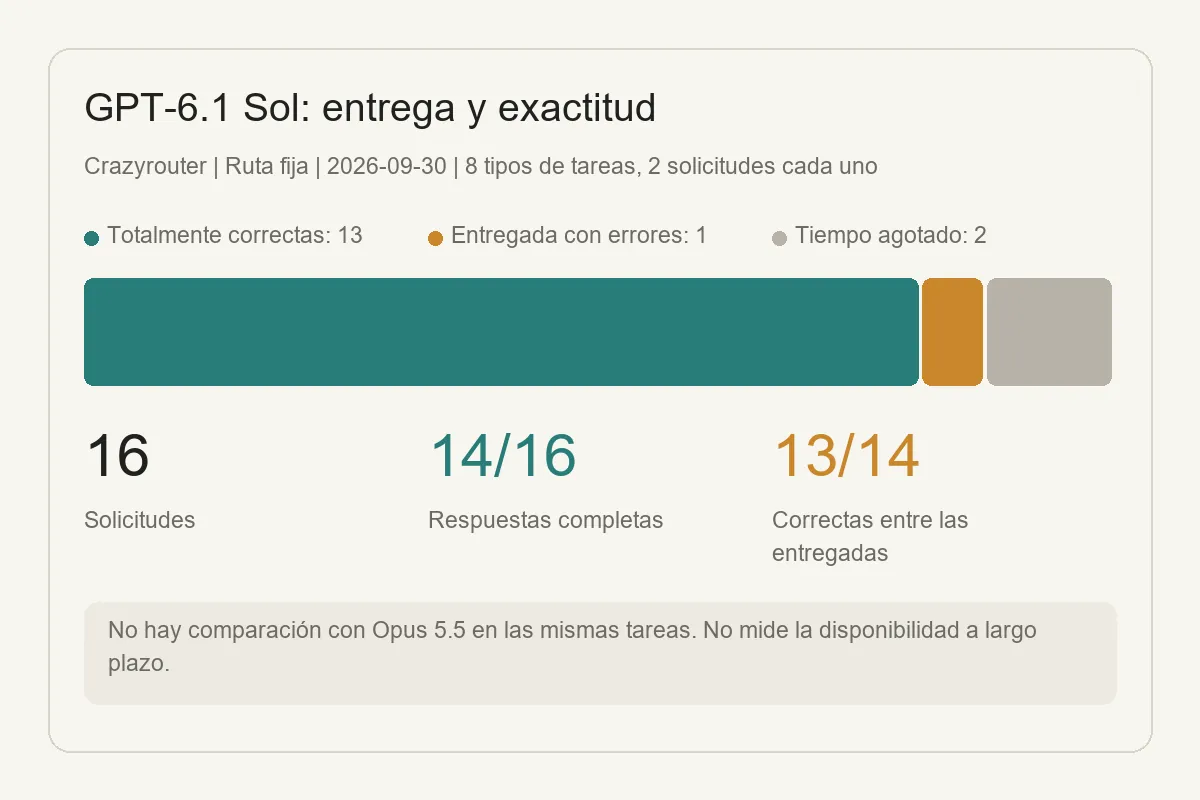
En una ronda de pruebas de cargas de trabajo de desarrollo local del 30 de septiembre de 2026, GPT-6.1 Sol utilizó un canal fijo, reasoning_effort=high y max_completion_tokens=8192. Se hicieron dos solicitudes independientes para cada una de 8 categorías de tareas, 16 en total: 14/16 produjeron respuestas completas, y 13 de las respuestas entregadas resolvieron correctamente la tarea completa; las otras dos solicitudes no obtuvieron una respuesta completa tras esperar 240 segundos. El lote principal incluía comprobaciones ocultas para dos problemas de programación; también se realizó un flujo independiente con herramientas simuladas, que no forma parte de las 16 tareas principales anteriores. Una muestra tan pequeña no sustituye a las pruebas prolongadas de desarrollo en repositorios.
Esta ronda no incluyó a Claude Opus 5.5 en el mismo conjunto de tareas. Por tanto, permite describir las entregas de GPT-6.1 Sol en esas tareas, pero no afirmar que GPT-6.1 Sol sea más preciso, más rápido o más estable que Opus 5.5. Frente a las pruebas oficiales, su valor consiste en aportar un pequeño registro de una ruta real a través de una pasarela y recordar que los tiempos de espera agotados también deben contabilizarse en la experiencia de entrega.
Estos registros no constituyen el mismo tipo de evidencia que una ficha de modelo publicada por un proveedor. Si planeas integrar el modelo en un agente de programación, puedes consultar primero la guía de integración de Claude Code y la guía de integración de Codex, y después crear un conjunto de pruebas de aceptación con tareas de tus propios repositorios.
Detalles de las solicitudes y los fallos del registro local#
La URL base de esta ronda fue https://api.crazyrouter.com/v1, el endpoint fue POST /chat/completions y el modelo fue gpt-6.1-sol. Las solicitudes utilizaron messages (un mensaje system fijo y un mensaje user con la misma tarea), reasoning_effort="high" y max_completion_tokens=8192, sin enviar temperature. Se trata de un registro histórico del 2026-09-30, no de una nueva prueba de disponibilidad realizada en la fecha de publicación de este artículo.
| Elemento | Resultado comprobable |
|---|---|
| Entregas | 14/16 solicitudes recibieron resultados completos; de ellas, 13/14 respuestas resolvieron correctamente la tarea completa |
| Entregada pero incorrecta | En un recuento de reglas, indicó 71 cuando en realidad había 72 |
| Sin entrega | Una tarea de búsqueda en reglas extensas y otra de selección óptima con restricciones agotaron cada una el tiempo de espera de 240 segundos; los fallos no se sustituyeron por reintentos exitosos |
| Tarea de ejemplo | Eliminación de duplicados en eventos de facturación: deduplicar globalmente por ID de evento, conservar 10 <= ts < 20, excluir a los usuarios internos y calcular el importe neto |
| Estado final de la solicitud de ejemplo | HTTP 200, finish_reason=stop; la respuesta superó la comparación con la solución de referencia local |
ID de respuesta del ejemplo: resp_0a6633bd82c5ee75016abd0e0e8b9887d29ef32e920c8843ba; ID de solicitud: 202609301326374284700288BdKuu3w. El ejemplo utiliza datos de prueba sintéticos y devolvió la siguiente respuesta final:
{"net_cents_by_user":{"alice":-173,"bob":88},"included_unique_events":12}
Un tiempo de espera agotado solo indica que el cliente no recibió una entrega completa dentro del límite de espera; no demuestra que el modelo no pueda resolver la tarea ni que la solicitud al proveedor ya se haya cancelado. La muestra no midió la disponibilidad a largo plazo ni la latencia hasta el primer token de ambos modelos.
Cómo elegir: crear un conjunto de pruebas de aceptación según tus tareas#
- Evaluar primero Opus 5.5: para grandes migraciones de código, revisiones de varios repositorios, agentes de programación de larga duración y trabajos en los que estés dispuesto a pagar tarifas estándar por token más altas por una capacidad de razonamiento de nivel alto.
- Evaluar primero GPT-6.1 Sol: para grandes volúmenes de solicitudes API diarias repetitivas, automatización de procesos de negocio, extracción de PDF complejos y tareas de agentes que requieran controlar el coste por tarea.
- Realizar pruebas en paralelo: cuando las tareas tengan un valor alto, los errores sean costosos o los resultados se utilicen directamente en producción. Fija la versión del modelo, el nivel de razonamiento, las herramientas, el contexto y las condiciones de aceptación, y conserva los registros de tiempos de espera agotados, fallback y reintentos.
Se recomienda empezar con un pequeño conjunto de aceptación de 20–50 tareas reales y registrar para cada una si se entregó completa, la proporción que supera las comprobaciones automáticas, el número de correcciones manuales, el tiempo de principio a fin y el coste total de tokens. Clasifica las tareas en programación, documentos y flujos con herramientas antes de calcular los resultados; una puntuación global puede ocultar deficiencias claras de un modelo en subtareas concretas.
Preguntas frecuentes#
¿Claude Opus 5.5 es necesariamente mejor que GPT-6.1 Sol?#
No se puede generalizar así. Opus 5.5 destaca en Terminal-Bench 4.0 y otras pruebas publicadas por Anthropic; OpenAI, por su parte, afirma que GPT-6.1 Sol supera a Opus 5.5 bajo determinadas condiciones de GDP.pdf y AutomationBench. Las entidades evaluadoras, los niveles de razonamiento, el fallback y los conjuntos de tareas son distintos, por lo que conviene validarlos con tus propias tareas.
¿Cuánto más barato es GPT-6.1 Sol que Opus 5.5?#
Según los precios estándar oficiales de las API, GPT-6.1 Sol cuesta 10 por millón de tokens de salida, frente a 20 de Opus 5.5; para la misma cantidad de tokens sin caché, el precio de lista es aproximadamente un 50% menor. La factura real de una tarea también depende de la longitud de la salida, la caché, los reintentos y los precios de la plataforma.
¿Cuál es mejor para programar?#
Opus 5.5 obtiene resultados sólidos en las puntuaciones oficiales publicadas de Terminal-Bench 4.0 y FrontierCode; los materiales públicos de lanzamiento de GPT-6.1 Sol destacan la prueba de ingeniería de software de larga duración DeepSWE. Como no existe una comparación pública completa de ambos modelos con el mismo entorno de evaluación de programación y el mismo presupuesto de razonamiento, resulta más fiable probarlos con tareas de repositorios reales.
¿Este artículo realizó pruebas locales de Opus 5.5 y GPT-6.1 Sol con las mismas tareas?#
No. Este artículo cita los materiales de evaluación oficiales de ambos proveedores y añade los registros de 16 solicitudes a GPT-6.1 Sol realizadas por Crazyrouter el 30 de septiembre de 2026; ese lote no incluyó a Opus 5.5 como referencia y no puede describirse como una prueba local de ambos modelos.
¿Qué métricas conviene observar al elegir un modelo?#
Como mínimo, hay que considerar conjuntamente la tasa de éxito de las tareas, la tasa de entrega completa, los tiempos de espera agotados y el fallback, las correcciones manuales, el tiempo de principio a fin y el coste total de tokens. En los flujos de agentes también hay que comprobar si se completaron las llamadas a herramientas, si el modelo gestionó correctamente los fallos y si el resultado final superó la aceptación automática.
Conclusión#
Los datos públicos de Opus 5.5 y GPT-6.1 Sol muestran compromisos distintos según la tarea: los resultados de Opus 5.5 en programación y ciencia con razonamiento alto son atractivos; GPT-6.1 Sol tiene precios estándar por token más bajos, y OpenAI informa de mejores costes por tarea en algunas pruebas de negocio. Si el coste es la principal limitación, prueba primero GPT-6.1 Sol; si importa más el techo de calidad en tareas complejas y prolongadas, incluye Opus 5.5 en pruebas de aceptación con las mismas tareas. Hasta disponer de pruebas de ambos bajo las mismas condiciones, no combines las evaluaciones de los proveedores para proclamar un campeón general.
Fuentes y condiciones de evaluación#
- Anthropic, Presentación de Claude Opus 5.5, 2026-09-22. Incluye precios oficiales y datos y condiciones de Terminal-Bench, FrontierCode, AutomationBench y Terminal-Bench Science.
- OpenAI, Presentación de GPT-6.1 Sol, 2026-09-29. Incluye comparaciones del proveedor entre GPT-6.1 Sol y Opus 5.5 en GDP.pdf, AutomationBench y Terminal-Bench Science, así como los precios de la API.
- Anthropic, Documentación del modelo Claude Opus 5.5 y sus precios y guía de optimización de coste y capacidad. Incluye límites del modelo, precios y el método y los resultados del subconjunto compatible original de SWE-bench Pro de 482 problemas.
- OpenAI, Documentación del modelo GPT-6.1 Sol en la API. Incluye la ventana de contexto de la API, el límite de salida, los precios de entrada estándar y en caché, y el umbral de facturación de contexto largo.
- Crazyrouter, archivo interno del 2026-09-30, "GPT-6 Sol y GPT-6.1 Sol frente a GPT-5.6 Sol y GPT-6 Astra: pruebas prácticas y elección del modelo principal". Este artículo publica un resumen de resultados y un identificador de respuesta; las solicitudes completas, los scripts de evaluación y las respuestas se conservan localmente en la redacción, sin ofrecer una descarga en línea del conjunto completo de evidencias. Ese lote no incluye resultados de Opus 5.5 en las mismas tareas.
Este artículo no presenta las evaluaciones declaradas por los proveedores como reproducciones independientes ni compara la latencia hasta el primer token, la fiabilidad a largo plazo o la clasificación general de ambos modelos en producción. Los precios oficiales de ambos proveedores pueden diferir de los precios reales de la pasarela local; vuelve a comprobar las tarifas vigentes antes de poner el sistema en producción.