简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
Prólogo: ¿Qué distancia real separa a los modelos de IA chinos y estadounidenses?
Prólogo de una serie comparativa sobre IA china y estadounidense: brecha de vanguardia, umbral de Opus 4.8 y 112 llamadas reales a API.
Esta es la edición en español del mismo estudio, con datos hasta el 2026-10-29. Las 112 solicitudes de prueba utilizaron los prompts originales en chino; no se realizó una nueva evaluación multilingüe. Las figuras tienen etiquetas en inglés. El ejemplo de código conserva el prompt original en chino mediante escapes Unicode que se decodifican al ejecutarse.
Serie comparativa de modelos de IA chinos y estadounidenses · Prólogo. Primero estableceremos el método de comparación con modelos de texto y después estudiaremos por separado imágenes, vídeo, voz, búsqueda vectorial y reclasificación. Este artículo es el punto de partida del método y de las preguntas; las puntuaciones de los modelos de texto no representan su capacidad en otras modalidades.
Los modelos estadounidenses lideran la clasificación actual de vanguardia y el grupo de cabeza, pero la afirmación de que «la brecha entre China y Estados Unidos sigue ampliándose» no coincide con esta reconstrucción retrospectiva bajo una misma escala. Tomando Opus 4.8 como umbral de referencia para la satisfacción personal, entre las muestras cubiertas por AA hay 12 versiones chinas y 21 estadounidenses cuya puntuación del Progress Index es superior; esto no significa que sean mejores en todas las tareas.
La fecha de corte de los datos es 2026-10-29. Este artículo separa tres cuestiones que suelen confundirse: cuánto distan los modelos más potentes, cuántas opciones superan el umbral de un antiguo modelo insignia y qué diferencias pueden percibirse en solicitudes reales. Las dos primeras utilizan datos de Artificial Analysis (AA); la tercera se examina mediante una auditoría de 7 modelos, 8 tareas y 2 ejecuciones por tarea, con 112 llamadas en total, realizada a través de Crazyrouter.[1][2]
Se trata de un estudio de una muestra de modelos. No evalúa el conjunto de la industria de IA de ambos países ni incluye una prueba subjetiva a ciegas con personas; en última instancia, que un modelo sea «utilizable» depende de tu tarea, del tiempo de espera y de tu tolerancia a los errores.
Primero, los resultados: liderar la vanguardia y estar disponible para un uso generalizado son cosas distintas#
| Indicador / escala | China | Estados Unidos |
|---|---|---|
| Puntuación máxima actual · Intelligence v5 | 46.0 · Kimi K3.1 Pro | 59.4 · Gemini 4 Carbon |
| Media del Top 5 · Intelligence v5 | 34.74 | 56.68 |
| Número de versiones en el Top 10 mundial · Intelligence v5 | 1 | 9 |
| Puntuación máxima actual · Progress v1 | 340.70 | 351.65 |
| Superan a Opus 4.8 · Progress v1, incluidas versiones históricas | 12 | 21 |
| De ellas, versiones no marcadas como deprecated por AA | 9 | 13 |
Los valores de los dos índices no pueden restarse ni mezclarse en una misma clasificación. La diferencia actual en la vanguardia de v5 es de 13.4 puntos; en Progress v1 es de 10.94 puntos. El primero mide el rendimiento en el conjunto de evaluación actual; el segundo sirve para analizar los cambios de capacidad entre periodos.
El análisis combina las 716 configuraciones de razonamiento de AA en 517 versiones publicadas: 176 chinas, 257 estadounidenses y el resto de otros países o sin clasificar. La agrupación se realiza por release.id, de modo que las configuraciones high, max y xhigh de una misma versión no se cuentan como varios modelos. Para cada indicador se toma por separado la configuración con la puntuación más alta de esa versión, que puede ser distinta en cada caso.
Por ahora, la nueva clasificación v5 solo dispone de una puntuación total válida para 39 versiones publicadas: 12 chinas, 24 estadounidenses y 3 de otros países. El Top 10 y las medias se refieren a la muestra evaluada; la ausencia de una medición no equivale a una puntuación de cero. La clasificación utiliza la precisión original devuelta por la API; los empates comparten puesto y los puestos posteriores se saltan.[1]
Las 20 primeras posiciones actuales: ¿quién está en cabeza?#
| Puesto mundial (versiones sin duplicar) | Versión publicada | País | Puntuación v5 | Fecha de publicación |
|---|---|---|---|---|
| 1 | Gemini 4 Carbon | Estados Unidos | 59.4 | 2026-10-28 |
| 2 | Claude Opus 5.5 | Estados Unidos | 58.4 | 2026-09-22 |
| 3 | GPT-6 Astra | Estados Unidos | 56.9 | 2026-09-03 |
| 4 | GPT-6.1 Sol | Estados Unidos | 54.5 | 2026-09-29 |
| 5 | Claude Sonnet 5.5 | Estados Unidos | 54.2 | 2026-09-28 |
| 6 | GPT-6.1 Terra | Estados Unidos | 51.0 | 2026-10-26 |
| 7 | Gemini 4 Argon | Estados Unidos | 50.4 | 2026-09-30 |
| 8 | Muse Wonder Full | Estados Unidos | 49.7 | 2026-10-12 |
| 8 | Claude Fable 5.1 | Estados Unidos | 49.7 | 2026-09-01 |
| 10 | Kimi K3.1 Pro | China | 46.0 | 2026-10-23 |
| 11 | Muse Wonder | Estados Unidos | 43.3 | 2026-10-12 |
| 12 | Muse Spark 1.3 | Estados Unidos | 36.4 | 2026-09-02 |
| 13 | Claude Haiku 5.5 | Estados Unidos | 36.2 | 2026-10-07 |
| 14 | Grok 4.7 | Estados Unidos | 35.0 | 2026-09-21 |
| 15 | Qwen3.8 Max (0902) | China | 33.6 | 2026-09-02 |
| 16 | DeepSeek V4.1 Flash 1017 | China | 32.5 | 2026-10-17 |
| 17 | GLM-5.3 | China | 31.7 | 2026-08-18 |
| 18 | Gemini 3.8 Flash | Estados Unidos | 30.5 | 2026-09-02 |
| 19 | MiMo-V2.6-Pro | China | 29.9 | 2026-09-21 |
| 20 | Ling 3.1 Flash 1019 | China | 29.5 | 2026-10-22 |
En este Top 20, China ocupa 6 puestos y Estados Unidos 14; en el Top 10, 1 y 9 respectivamente. Junto con las medias del Top 5 de 34.74 y 56.68, se observa que acercarse con un único modelo de vanguardia no es lo mismo que igualar la profundidad del grupo de cabeza. Las versiones sin puntuación total no participan en la clasificación.[1]
¿La diferencia de puntuaciones se está ampliando cada vez más?#
No aumenta de forma sostenida, sino que depende claramente del ritmo de lanzamiento de los modelos insignia. Con el Progress Index v1 obtenido en la misma extracción, reconstruimos la vanguardia de ambos países según las fechas de publicación: la puntuación más alta entre las versiones publicadas antes de un día determinado constituye la vanguardia retrospectiva de esa fecha.
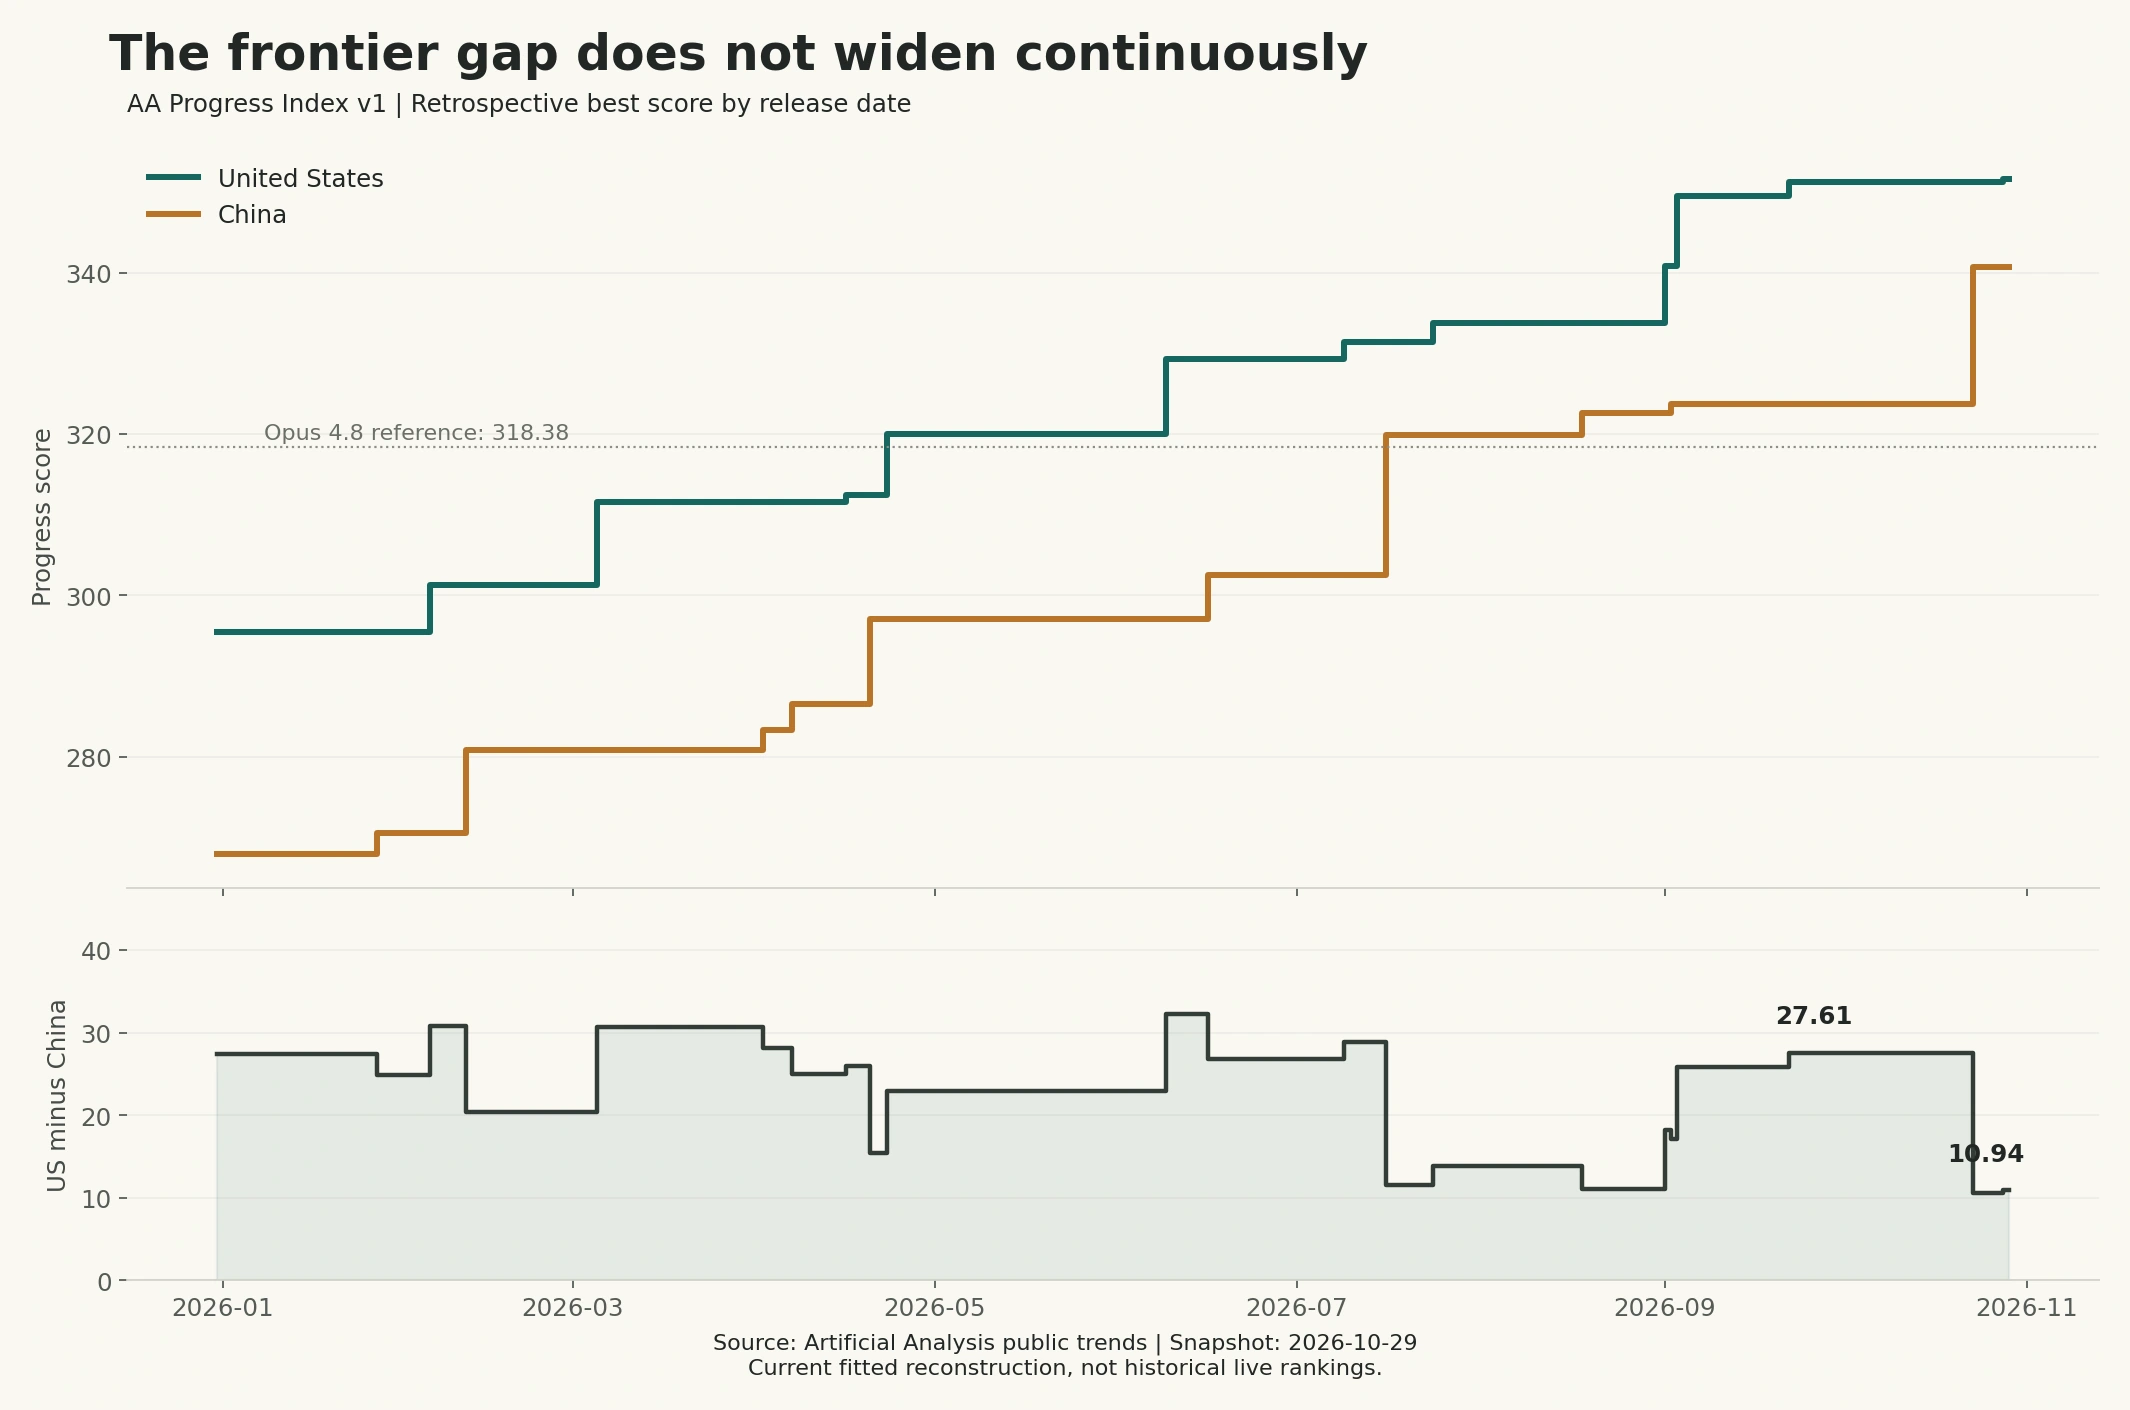
| Fecha retrospectiva | Vanguardia china | Vanguardia estadounidense | Diferencia: Estados Unidos−China |
|---|---|---|---|
| 2025-12-31 | 267.96 | 295.46 | 27.49 |
| 2026-03-31 | 280.87 | 311.55 | 30.69 |
| 2026-06-30 | 302.52 | 329.33 | 26.80 |
| 2026-07-31 | 319.88 | 333.73 | 13.85 |
| 2026-08-31 | 322.66 | 333.73 | 11.07 |
| 2026-09-30 | 323.67 | 351.27 | 27.61 |
| 2026-10-23 | 340.70 | 351.27 | 10.57 |
| 2026-10-29 | 340.70 | 351.65 | 10.94 |
A finales de agosto de 2026, la diferencia era de 11.07. Tras la concentración de nuevos modelos insignia estadounidenses en septiembre, aumentó hasta 27.61 al final del mes; el 23 de octubre, la publicación de Kimi K3.1 Pro la redujo a 10.57; tras la llegada de Gemini 4 Carbon el 28 de octubre, la instantánea del 29 de octubre muestra 10.94.[2]
Esto convierte la ventana temporal elegida en parte de la conclusión. La diferencia actual es unos 16.66 puntos menor que hace 30 días, unos 2.91 puntos menor que hace 90 días y unos 12.00 puntos menor que hace 180 días. Al mismo tiempo, Estados Unidos sigue liderando la comparación de vanguardia entre ambos países. La reducción de la brecha y el liderazgo pueden darse a la vez.
Sin embargo, este gráfico no puede describirse como «la clasificación en tiempo real de todos los días del pasado». Progress Index es un ajuste estadístico basado en las evaluaciones obtenidas actualmente; futuras evaluaciones adicionales y nuevos ajustes pueden modificar las puntuaciones retrospectivas, y el estado histórico de apertura de las API tampoco se ha reconstruido por completo. Responde a «cómo se ven hoy, con una misma escala, los modelos publicados en el pasado», no a «qué podían llamar realmente los usuarios en aquel momento».[3]
¿Por qué algunas personas perciben un aumento repentino de la brecha?#
El 27 de octubre de 2026, AA actualizó Intelligence Index a v5 e incorporó o mejoró evaluaciones de ingeniería de software, investigación científica y razonamiento sobre conocimientos. Su anuncio señala que la diferencia entre la cabeza de la categoría de pesos abiertos y los modelos líderes pasó de 3 puntos en v4.3 a 12 puntos en v5.[4]
Aquí se cambió el instrumento de medición y se utilizó la agrupación «pesos abiertos frente a modelos líderes»; no puede reformularse directamente como «la brecha de capacidad entre China y Estados Unidos pasó de 3 a 12 puntos en dos días». El anuncio también incluye a Kimi K3.1 Pro, cuyos pesos aún no se habían publicado, en la descripción correspondiente, por lo que este grupo tampoco puede equipararse al conjunto de modelos descargables aquel día.
v5 asigna un peso del 25% a cada una de las cuatro categorías: trabajo del conocimiento, programación, ciencia y capacidad general. Así se da más importancia a las tareas difíciles y a la ejecución en varios pasos que a una conversación sencilla. Por ello, la brecha en la clasificación puede ser grande mientras que en ciertas tareas cotidianas sea menor; para saber si ocurre así hacen falta pruebas sobre tareas concretas.[4][5]
Si Opus 4.8 ya es suficiente, ¿cuántos modelos lo han superado?#
Primero hay que fijar la escala. La puntuación de 61.4 obtenida por Opus 4.8 en la evaluación publicada en mayo de 2026 pertenece a una versión antigua de Intelligence Index. En la instantánea de la API utilizada aquí, su puntuación total v5 está vacía: el valor ausente no puede tratarse como 0 y, menos aún, puede usarse el antiguo 61.4 para filtrar la nueva clasificación.[1][6]
Este artículo utiliza en su lugar como referencia fija Opus 4.8 (max): 318.376758998036 en Progress Index v1. Solo se considera superado si el valor es estrictamente mayor; la igualdad no cuenta y la ausencia de medición se registra como desconocida. El umbral usa la precisión completa, aunque las tablas solo muestran dos decimales.[2]
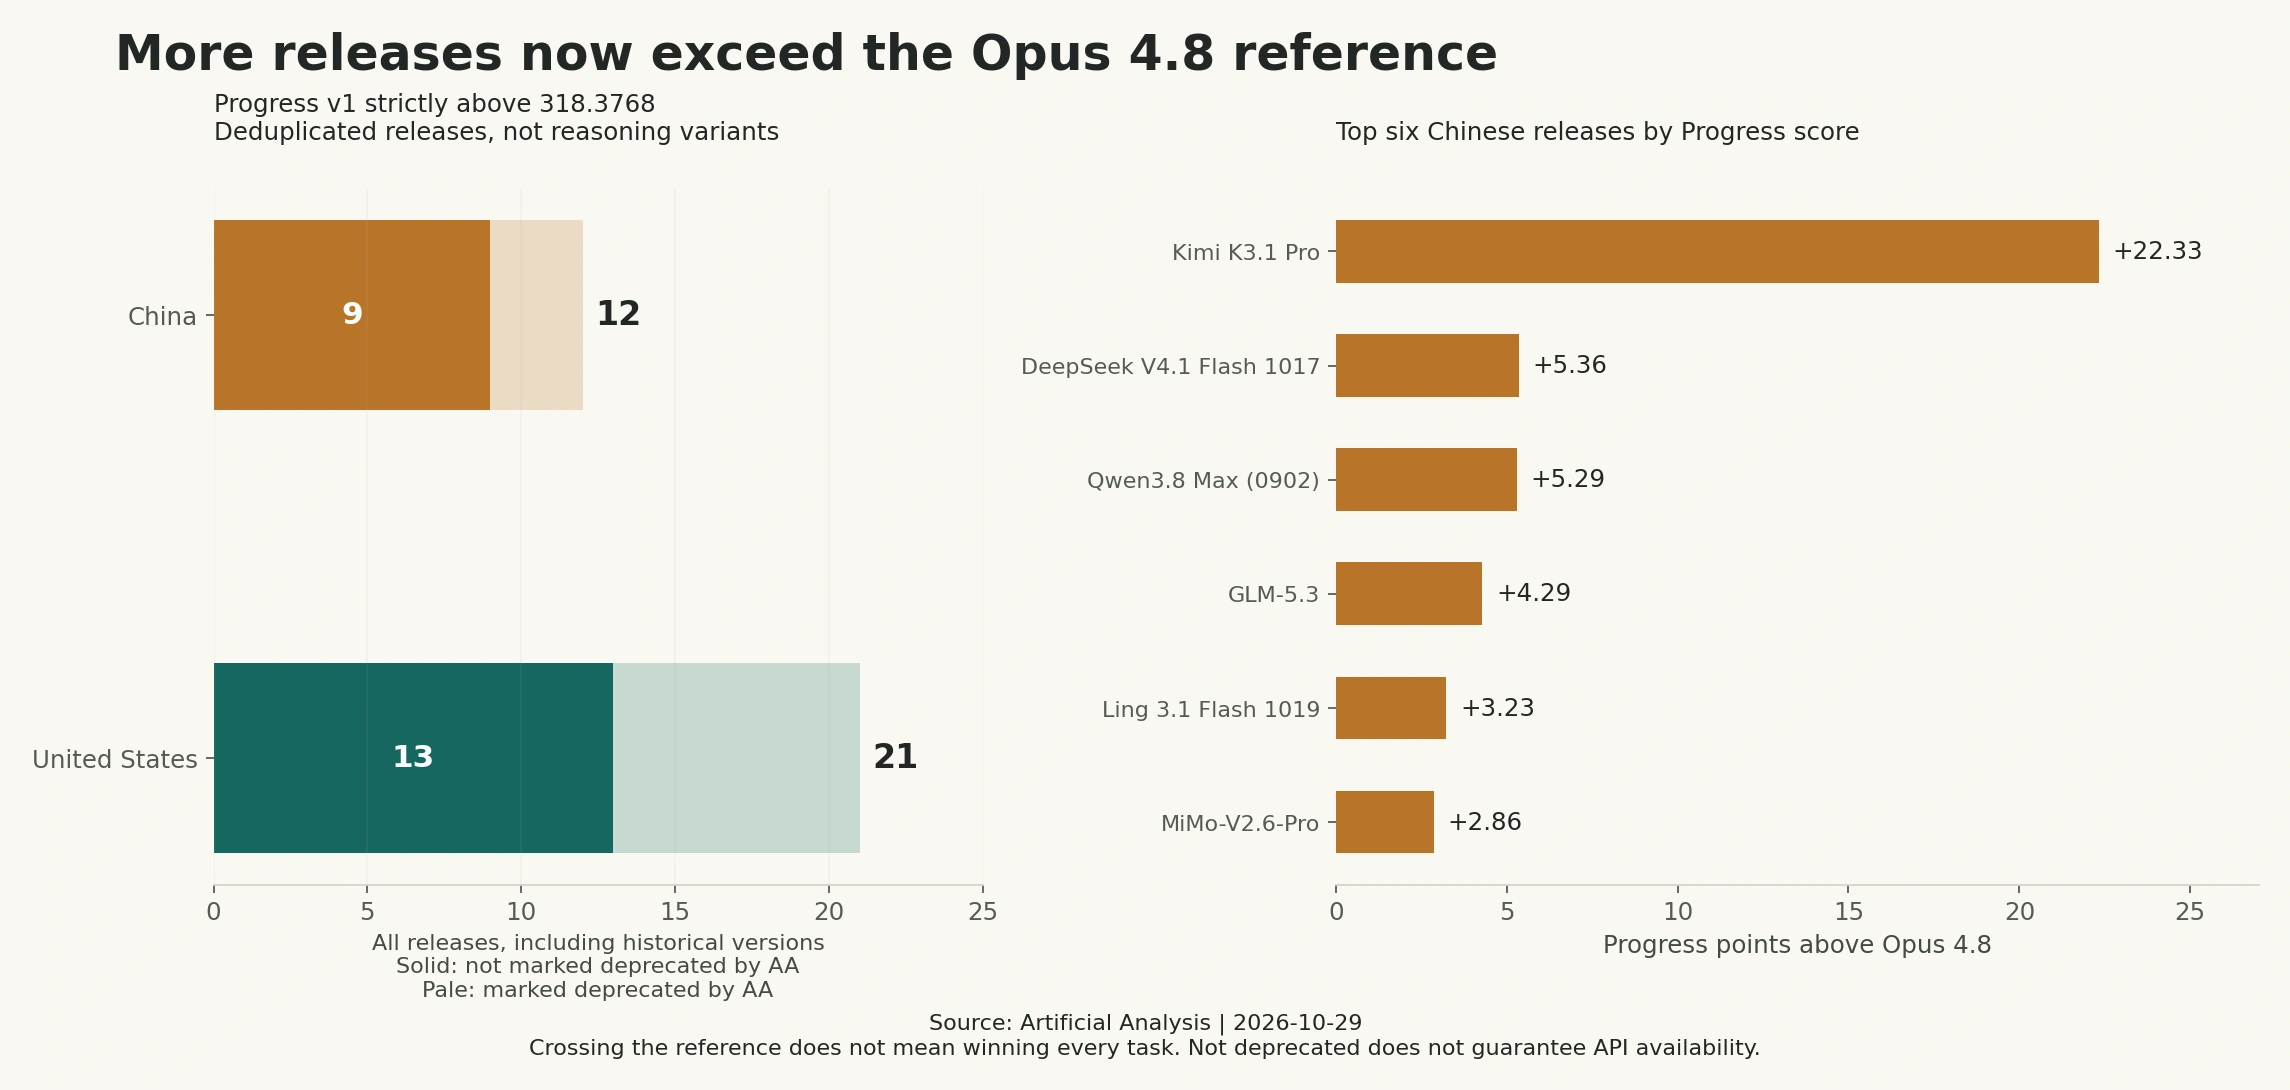
Entre las 517 versiones publicadas, 33 en todo el mundo superan este umbral y todas pertenecen a los grupos chino y estadounidense analizados: 12 chinas y 21 estadounidenses. Si solo se consideran las versiones que AA no ha marcado como deprecated, las cifras son 9 y 13 respectivamente. La marca de AA es un estado de la página: no demuestra que el proveedor oficial lo haya retirado ni garantiza que actualmente pueda llamarse desde cualquier pasarela.
Lista completa de versiones chinas que superan el umbral#
| Versión china publicada | Puntuación Progress máxima | Marcada como deprecated por AA |
|---|---|---|
| Kimi K3.1 Pro | 340.70 | No |
| DeepSeek V4.1 Flash 1017 | 323.74 | No |
| Qwen3.8 Max (0902) | 323.67 | No |
| GLM-5.3 | 322.66 | No |
| Ling 3.1 Flash 1019 | 321.61 | No |
| MiMo-V2.6-Pro | 321.24 | No |
| DeepSeek V4.1 Flash | 320.25 | Sí |
| Qwen3.8-Flash-Next | 320.23 | No |
| Ling 3.1 Flash | 320.01 | No |
| Kimi K3 | 319.88 | Sí |
| Qwen3.8 Max | 319.63 | Sí |
| GLM-5.3-Flash | 318.64 | No |
Lista completa de versiones estadounidenses que superan el umbral#
| Versión estadounidense publicada | Puntuación Progress máxima | Marcada como deprecated por AA |
|---|---|---|
| Gemini 4 Carbon | 351.65 | No |
| Claude Opus 5.5 | 351.27 | No |
| Claude Sonnet 5.5 | 350.50 | No |
| GPT-6 Astra | 349.57 | No |
| GPT-6.1 Sol | 348.47 | No |
| GPT-6.1 Terra | 345.25 | No |
| Muse Wonder Full | 343.22 | No |
| Gemini 4 Argon | 341.79 | No |
| Claude Fable 5.1 | 340.85 | No |
| Muse Wonder | 335.78 | No |
| GPT-6 Sol | 334.04 | Sí |
| Claude Opus 5 | 333.73 | Sí |
| GPT-5.6 Sol | 331.46 | Sí |
| Claude Fable 5 | 329.33 | Sí |
| Claude Haiku 5.5 | 326.13 | No |
| Muse Spark 1.3 | 324.46 | Sí |
| GPT-5.6 Terra | 323.87 | Sí |
| Grok 4.7 | 322.68 | No |
| Grok 4.6 | 321.54 | Sí |
| Gemini 3.8 Flash | 320.30 | No |
| GPT-5.5 | 320.00 | Sí |
No toda ventaja mínima puede calificarse de «liderazgo claro». Por ejemplo, GLM-5.3-Flash supera la referencia por unos 0.27 puntos; los datos públicos de este estudio no ofrecen intervalos de confianza suficientes para respaldar esa comparación. Por eso, la siguiente tabla presenta únicamente un análisis de sensibilidad del umbral; estos incrementos no constituyen criterios de significación estadística:
| Umbral (Progress v1) | Número de versiones chinas | Número de versiones estadounidenses |
|---|---|---|
| Estrictamente superior a Opus 4.8 + 0 puntos | 12 | 21 |
| Estrictamente superior a Opus 4.8 + 1 punto | 11 | 21 |
| Estrictamente superior a Opus 4.8 + 3 puntos | 5 | 19 |
| Estrictamente superior a Opus 4.8 + 5 puntos | 3 | 17 |
| Estrictamente superior a Opus 4.8 + 10 puntos | 1 | 14 |
Esta perspectiva explica dos percepciones a la vez: realmente hay más opciones que alcanzan el nivel del antiguo modelo insignia, pero las opciones de cabeza que lo superan por un margen amplio siguen concentradas en el grupo estadounidense. De las 12 versiones chinas que cruzan la línea, solo 3 la superan por más de 5 puntos; en el caso estadounidense son 17. Todas las cifras incluyen versiones históricas y no deben interpretarse como el inventario actual de API.
Al superar este umbral de capacidad, ¿cuántos días de diferencia hay?#
En la reconstrucción actual de Progress v1, la primera versión estadounidense que cruzó la línea fue GPT-5.5, publicada el 23 de abril de 2026; en China fue Kimi K3, publicada el 16 de julio de 2026. Entre ambas fechas hay 84 días. Si se cuenta desde la fecha de publicación del propio Opus 4.8, el 28 de mayo, hasta Kimi K3 transcurren 49 días.[2]
No es contradictorio que GPT-5.5 cruzara antes este umbral retrospectivo que Opus 4.8: los objetivos, el ajuste y el orden de Progress difieren de los de la clasificación Intelligence de aquel momento. Los 84 días representan únicamente la diferencia entre las primeras fechas de cruce de este umbral concreto, no una prueba de que «todos los modelos chinos vayan en conjunto tres meses por detrás».
¿La diferencia percibida en la práctica es realmente tan grande como sugieren las puntuaciones?#
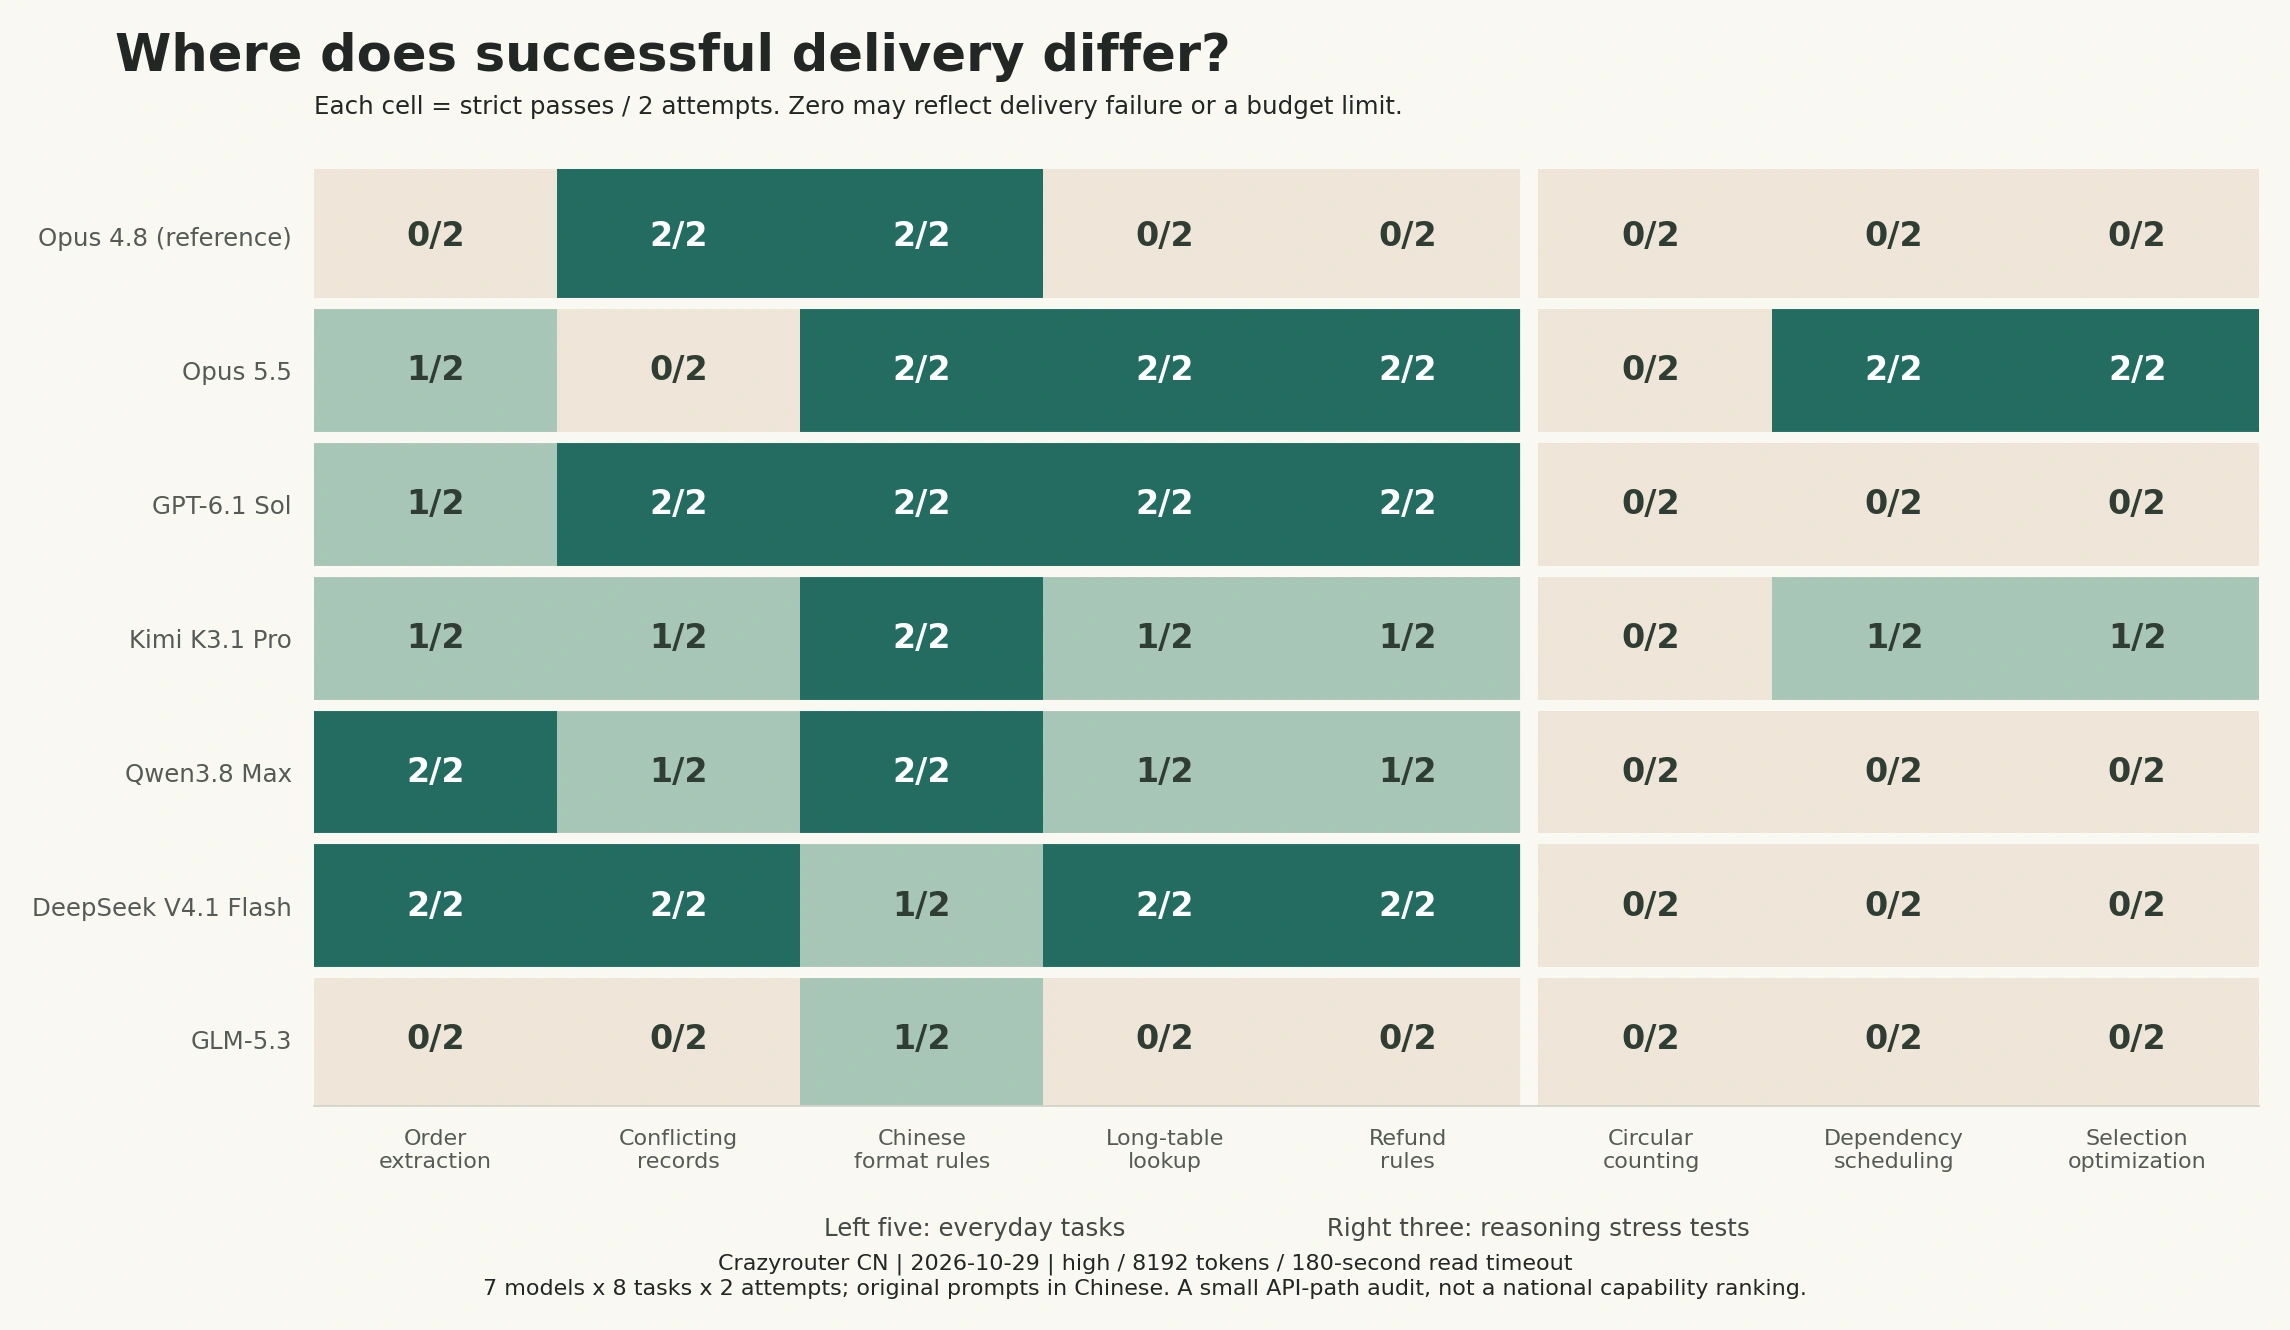
Este experimento puede responder «qué tareas se entregaron correctamente bajo estas condiciones de solicitud», pero no sustituye una evaluación humana de la satisfacción general. Seleccionamos modelos representativos actuales de las series de Anthropic y de OpenAI, conservando Opus 4.8 como referencia; el grupo chino abarca las series Kimi, Qwen, DeepSeek y GLM. Es un muestreo intencionado y no sirve para estimar una tasa media de victorias por país.
Las pruebas se realizaron el 29 de octubre de 2026, todas mediante el extremo /v1/chat/completions de https://cn.crazyrouter.com, con reasoning_effort="high", max_tokens=8192, modo no streaming, sin herramientas, un tiempo de espera de lectura de 180 segundos por llamada, orden aleatorio y un máximo de 4 solicitudes simultáneas. La misma etiqueta high no implica la misma capacidad de cálculo interna ni equivale a la configuración máxima utilizada por AA para evaluar cada modelo.
| Grupo de tareas | Tareas concretas | Criterio de puntuación |
|---|---|---|
| Tareas cotidianas, 5 tipos | Extracción y deduplicación de pedidos, registro de conflictos, restricciones de formato en chino, localización de 240 registros de inventario, límites de las reglas de reembolso | Valores verdaderos fijos, tipos de campo y formato del texto |
| Presión de razonamiento, 3 tipos | Recuento con restricciones circulares, planificación con dependencias, optimización de selección combinatoria | Única respuesta óptima obtenida por enumeración exhaustiva local / regla de empate especificada |
Un aprobado estricto exige éxito HTTP, finalización normal y una respuesta final que cumpla todos los requisitos de contenido y formato. Conservamos este indicador principal acordado previamente; además, realizamos una comprobación de sensibilidad a posteriori que elimina únicamente una valla exterior de código Markdown, sin corregir respuestas ni repetir llamadas. La segunda se aproxima más a «si el contenido es legible» y la primera a «si un programa puede integrarlo directamente».
| Modelo solicitado | Aprobados estrictos cotidianos / 10 | Aprobados estrictos de presión / 6 | Total estricto / 16 | Tras eliminar una sola valla / 16 |
|---|---|---|---|---|
| claude-opus-4-8 | 4/10 | 0/6 | 4/16 | 13/16 |
| claude-opus-5-5 | 7/10 | 4/6 | 11/16 | 16/16 |
| gpt-6.1-sol | 9/10 | 0/6 | 9/16 | 9/16 |
| kimi-k3.1-pro | 6/10 | 2/6 | 8/16 | 8/16 |
| qwen3.8-max | 7/10 | 0/6 | 7/16 | 7/16 |
| deepseek-v4.1-flash | 9/10 | 0/6 | 9/16 | 9/16 |
| glm-5.3 | 1/10 | 0/6 | 1/16 | 1/16 |
¿Dónde se manifiestan las diferencias?#
Tomemos como ejemplo DeepSeek V4.1 Flash y Opus 5.5 en esta ronda: en tareas cotidianas entregaron respectivamente 9/10 y 7/10 aprobados estrictos; en tareas de presión, 0/6 y 4/6. Son diferencias de entrega con un presupuesto fijo, y no todos los intentos incompletos pueden interpretarse como «el modelo no sabe hacerlo»; en particular, una tarea de presión puede agotar el presupuesto de salida o no terminar antes del límite de espera.
Otro ejemplo real procede de Opus 4.8: en la extracción de pedidos devolvió los campos y valores correctos, pero los envolvió en una valla de código Markdown, por lo que no superó la comprobación estricta de JSON. Quien lo lea en una ventana de conversación puede no percibirlo como un error; si el resultado entra directamente en un programa, será necesario añadir un paso de limpieza. La misma salida puede generar percepciones distintas según cómo se utilice.
Tras eliminar únicamente una capa de valla de código, los resultados son:
| Modelo solicitado | Cotidianas: solo sin valla / 10 | Presión: solo sin valla / 6 |
|---|---|---|
| claude-opus-4-8 | 10/10 | 3/6 |
| claude-opus-5-5 | 10/10 | 6/6 |
| gpt-6.1-sol | 9/10 | 0/6 |
| kimi-k3.1-pro | 6/10 | 2/6 |
| qwen3.8-max | 7/10 | 0/6 |
| deepseek-v4.1-flash | 9/10 | 0/6 |
| glm-5.3 | 1/10 | 0/6 |
Opus 4.8 y Opus 5.5 obtuvieron 10/10 en las tareas cotidianas, pero 3/6 y 6/6 respectivamente en las de presión. Es un ejemplo concreto de que la ventaja de una mayor capacidad puede aparecer sobre todo en tareas más difíciles. Aquí solo hay 5 tipos de tareas cotidianas y 3 de presión; dos llamadas a una misma tarea no cuentan como dos tareas independientes, por lo que estos datos no demuestran que la capacidad cotidiana ya sea equivalente.
La pasarela y la asignación de versiones también cambian la experiencia#
En las 112 solicitudes hubo 15 errores HTTP, 17 tiempos de espera de lectura agotados y 7 truncamientos por presupuesto. Todas estas llamadas permanecen en el denominador de la tasa de entrega con presupuesto fijo y se desglosan por separado en la tabla siguiente.
| Modelo solicitado | Errores HTTP | Tiempos de espera de lectura de 180 segundos | Truncamientos por presupuesto | Respuestas con finalización normal |
|---|---|---|---|---|
| claude-opus-4-8 | 1 | 0 | 2 | 13 |
| claude-opus-5-5 | 0 | 0 | 0 | 16 |
| gpt-6.1-sol | 5 | 0 | 0 | 11 |
| kimi-k3.1-pro | 6 | 2 | 0 | 8 |
| qwen3.8-max | 1 | 8 | 0 | 7 |
| deepseek-v4.1-flash | 0 | 2 | 5 | 9 |
| glm-5.3 | 2 | 5 | 0 | 9 |
Por ejemplo, una solicitud a Kimi K3.1 Pro devolvió provider_authentication_failed. Esto indica que esa solicitud no fue autenticada correctamente por el proveedor ascendente y no constituye una prueba de que el modelo respondiera mal. Un tiempo de espera de lectura agotado tampoco significa más que el cliente no recibió a tiempo una respuesta completa; no permite atribuir la lentitud al cálculo del modelo.
| Nombre solicitado | Campo model observado en las respuestas reales |
|---|---|
| claude-opus-4-8 | claude-opus-4-8 |
| claude-opus-5-5 | claude-opus-5-5 |
| gpt-6.1-sol | gpt-6.1-sol |
| kimi-k3.1-pro | kimi-k3.1-pro |
| qwen3.8-max | qwen3.8-max |
| deepseek-v4.1-flash | deepseek-v4.1-flash, deepseek-v4.1-flash-1017, deepseek/deepseek-flash |
| glm-5.3 | glm-5.3 |
El campo model de una respuesta es solo una declaración del servidor, no una prueba independiente de la identidad de los pesos. En particular, el mismo nombre de solicitud de DeepSeek devolvió distintas versiones o alias, de modo que esta ronda no puede garantizar que todas las solicitudes correspondan exactamente a una única versión publicada en AA. Por tanto, estos resultados deben describirse como una «auditoría de entrega de la ruta de API utilizada»; no pueden emparejarse rígidamente con las puntuaciones de AA para calcular una correlación ni permiten proclamar que los modelos de un país sean en general mejores o equivalentes.
En la ruta de GLM-5.3 también aparecieron respuestas con texto adicional después del JSON, respuestas repetidas y marcadores anómalos. Conservamos las pruebas originales, pero no podemos determinar si la anomalía procede del modelo, de la plantilla o de la adaptación ascendente. Su bajo número de entregas estrictas resulta especialmente inadecuado para extraer conclusiones sobre la capacidad del modelo base; en esta ronda no se cambió de canal ni se repitieron pruebas para sustituir fallos con el fin de mejorar los resultados.
No completamos pruebas humanas a ciegas, muestreo de tareas de usuarios en producción, pruebas de carga prolongadas ni evaluaciones de Agent en varias rondas con el mismo presupuesto. Por tanto, las pruebas siguen siendo insuficientes para afirmar que «la experiencia general sea igual de buena». Sí podemos confirmar que el tipo de tarea, el formato de salida, el presupuesto de la solicitud y la cadena de servicio pueden hacer que la experiencia real difiera del orden de una única clasificación.
¿Quién se actualiza más rápido? Conviene separar el número de lanzamientos de los avances de capacidad#
Las cifras siguientes contabilizan versiones publicadas independientes dentro de la muestra cubierta por AA, no un censo completo de todos los modelos de ambos países. Las distintas configuraciones de razonamiento de una versión se cuentan una sola vez. Las renovaciones de la vanguardia se cuentan por la fecha en que se produce una mejora; varias versiones publicadas el mismo día no generan conteos repetidos.
| Mes de 2026 | Versiones chinas publicadas | Versiones estadounidenses publicadas | Fechas en que China renovó la vanguardia | Fechas en que Estados Unidos renovó la vanguardia |
|---|---|---|---|---|
| 2026-01 | 5 | 4 | 1 | 0 |
| 2026-02 | 9 | 7 | 1 | 1 |
| 2026-03 | 12 | 9 | 0 | 1 |
| 2026-04 | 16 | 15 | 3 | 2 |
| 2026-05 | 6 | 4 | 0 | 0 |
| 2026-06 | 6 | 7 | 1 | 1 |
| 2026-07 | 5 | 10 | 2 | 2 |
| 2026-08 | 11 | 10 | 1 | 0 |
| 2026-09 | 8 | 13 | 1 | 3 |
| 2026-10 (hasta el día 29) | 5 | 10 | 2 | 1 |
Entre el 1 de enero y el 29 de octubre de 2026, la muestra registra 83 versiones chinas y 89 estadounidenses. En los últimos 90 días naturales, del 1 de agosto al 29 de octubre inclusive, las cifras son 24 y 33, pero cada grupo solo renovó su propia vanguardia de Progress en 4 fechas. Publicar más no implica automáticamente mejorar más la capacidad máxima.[2]
Hasta esta instantánea, la renovación china más reciente de la vanguardia fue Kimi K3.1 Pro, el 23 de octubre, y la estadounidense Gemini 4 Carbon, el 28 de octubre. Los datos se recopilaron el 29 de octubre, por lo que la fecha de recopilación no puede denominarse fecha de actualización de los modelos. La API de AA no proporciona un registro histórico completo de cambios de puntuación para cada modelo y tampoco inventamos ese campo.
Cómo repetir los cálculos y cómo verificar la «experiencia» en la próxima ronda#
El archivo de investigación editorial conserva las respuestas de las cuatro páginas de la API de AA, los datos públicos de los gráficos de tendencias, el CSV de 517 filas ya consolidado, los scripts estadísticos, los valores verdaderos de las tareas y las 112 llamadas completas con sus resúmenes. Las estadísticas del blog formal proceden exclusivamente de estos registros congelados. La fuente es Artificial Analysis; los cálculos agregados y las pruebas reales de la ruta de Crazyrouter fueron realizados para este artículo.
El cálculo central puede entenderse mediante el siguiente pseudocódigo:
# One snapshot and metric version.
# Use AA release_id, not guessed names.
release_score = max(non_null_scores_for_each_release)
baseline = progress_score_of_opus_4_8_max
above_baseline = release_score > baseline
frontier_at_date = max(scores_of_releases_available_by_date)
gap_at_date = us_frontier_at_date - cn_frontier_at_date
Por ejemplo, el ID de respuesta de Opus 4.8 en la tarea de extracción de pedidos es msg_011CgWecKv2YBwoHYumCeURh, con HTTP 200 y finalización normal; la respuesta original era un JSON correcto envuelto en una valla de código, por lo que falló la evaluación estricta y aprobó la comprobación de sensibilidad de formato. El ID de la solicitud de Kimi cuya autenticación falló es 608ccc90b353423d036dca779cafcc37. Estos dos registros ilustran respectivamente la diferencia entre «se obtuvo un resultado, pero el formato no cumple» y «no se obtuvo una respuesta del modelo».
El siguiente ejemplo reproduce una tarea de reglas empresariales; la clave de API solo se lee desde variables de entorno y el extremo no incluye UTM:
import os
import requests

endpoint = "https://cn.crazyrouter.com" + "/v1/chat/completions"
user_content = (
    "\u672a\u62c6\u5c01\u4e14\u7b7e\u6536" "\u6b21\u65e5\u8d777\u65e5\u5185" "\u53ef\u9000\u6b3e\uff1b\u7b2c7" "\u65e5\u5305\u542b\u5728\u5185\u3002"
    "A\u57282026" "-10-20" "\u7b7e\u6536\uff0c202" "6-10-2" "7\u7533\u8bf7\u9000\u6b3e\uff0c"
    "\u65e0\u8d28\u91cf\u7f3a\u9677\u3002" "\u53ea\u8f93\u51faJSO" "N\uff0c\u952eeli" "gible\u4e3a" "\u5e03\u5c14\u503c\u3002"
)

response = requests.post(
    endpoint,
    headers={"Authorization": "Bearer " + os.environ["CRAZYROUTER_API_KEY"]},
    json={
        "model": "claude-opus-4-8",
        "messages": [{"role": "user", "content": user_content}],
        "reasoning_effort": "high", "max_tokens": 8192, "stream": False,
    },
    timeout=(15, 180),
)
response.raise_for_status()
print(response.json())
Se trata de un ejemplo simplificado de reproducción para el texto, no de una pregunta original completa de las 112 pruebas formales. Las 8 preguntas completas, los scripts de puntuación y los registros originales están archivados por la redacción; este artículo no ofrece una descarga pública del paquete completo de investigación. La tarea simplificada no se utilizó para añadir resultados ni sustituir las puntuaciones formales.
Aquí available_by_date solo significa que la fecha de publicación no es posterior al día indicado; no garantiza que existiera una API pública ese día. Las puntuaciones ausentes no se sustituyen por cero y un punto no se interpreta como un porcentaje fijo. La atribución nacional sigue las etiquetas de las instituciones de investigación y desarrollo de AA; Google se incluye en el grupo estadounidense que AA le asigna, sin clasificar por ubicación de servidores ni nacionalidad de los empleados.[1][3]
Para comprobar realmente la «equivalencia de experiencia» en la próxima ronda, recomendamos fijar primero tres tipos de tareas de usuarios objetivo y las diferencias aceptables, y después realizar una evaluación comparativa a ciegas, anónima y con el orden izquierda-derecha aleatorio. Los indicadores principales deberían incluir calidad de finalización, errores graves, retrabajo humano y preferencia; la tasa de fallos de llamada debe mostrarse por separado. Los límites de equivalencia y el tamaño de la muestra deben determinarse antes de ver los resultados, con un análisis agrupado por tarea. «No se detectó una diferencia significativa» no puede utilizarse como sinónimo de «la experiencia es la misma».
¿Qué temas investigará esta serie a continuación?#
Este artículo ha respondido primero a «en qué se diferencian la brecha de puntuaciones, el umbral del antiguo modelo insignia y la entrega real». Los próximos artículos se organizarán por tipo de capacidad y utilizarán evaluaciones adecuadas a cada tarea, presupuestos fijos y pruebas de API reales, sin combinar puntuaciones de distintas modalidades en una «puntuación nacional total». Lo que sigue es un plan de temas; los artículos posteriores aún no se han publicado.
| Artículo | Tema previsto | Pregunta principal |
|---|---|---|
| Primero · Modelos de texto | Tras superar el umbral del modelo insignia, ¿cuánto falta en las tareas cotidianas? | Diferencias en escritura en chino, salida estructurada, documentos largos, exactitud factual y evaluación humana a ciegas |
| Segundo · Programación y Agent | Si sabe responder, ¿también puede terminar el trabajo? | Modificación de código, pruebas superadas, llamadas a herramientas, tareas en varios pasos y tasa de finalización dentro del presupuesto |
| Tercero · Modelos de imagen | Más allá de la estética, ¿quién sigue mejor las instrucciones? | Texto a imagen, edición de imágenes, texto en chino, coherencia del sujeto y estabilidad entre generaciones |
| Cuarto · Modelos de vídeo | Después de un fotograma impresionante, ¿funcionan el movimiento y la narración? | Texto a vídeo, imagen a vídeo, coherencia de movimiento y física, continuidad de personajes y espera hasta el vídeo final |
| Quinto · Modelos de voz | ¿Escuchan con precisión, hablan con naturalidad y siguen el ritmo de la conversación? | Medición separada de reconocimiento, síntesis y voz en tiempo real, teniendo en cuenta acentos y latencia |
| Sexto · Vectores y reclasificación | ¿Dónde está realmente la diferencia en el rendimiento de una base de conocimientos? | Recuperación en chino y entre idiomas, documentos largos, Recall@k, nDCG, ganancia de reclasificación y coste de indexación |
| Séptimo · Selección integral | Con el mismo presupuesto, ¿cómo combinar distintos modelos? | Integrar las pruebas anteriores en decisiones de calidad, espera, coste y fiabilidad para escenarios concretos |
Cada artículo conservará tres preguntas: «quién está en la vanguardia, quién supera un umbral práctico y si la diferencia afecta a tareas reales», pero el umbral lo definirá un modelo de referencia de esa modalidad o las condiciones de aceptación del negocio. Por ejemplo, Opus 4.8 puede servir como referencia de texto en este artículo, pero no como umbral universal para modelos de imagen, voz o vectores.
Preguntas frecuentes#
¿Qué distancia real separa a los modelos de IA chinos y estadounidenses?#
En esta instantánea, Estados Unidos lidera la vanguardia de AA Intelligence v5 por 13.4 puntos; con la misma escala Progress v1, la diferencia de vanguardia es de 10.94 puntos. Los objetivos de medición son distintos y ninguno de los dos valores puede convertirse directamente en un porcentaje de capacidad o en una diferencia de satisfacción del usuario.
¿La brecha es cada vez mayor?#
Los datos retrospectivos actuales no respaldan un «aumento sostenido». La diferencia era de 27.61 a finales de septiembre de 2026 y de 10.94 el 29 de octubre, con una reducción clara entre ambas fechas a medida que se publicaban nuevos modelos. Sin embargo, acercarse en la vanguardia no significa que el grupo de cabeza ya tenga la misma profundidad.
¿Cuántos modelos chinos han superado a Opus 4.8?#
Según Progress v1, contando versiones publicadas independientes y exigiendo una puntuación estrictamente superior a Opus 4.8(max), son 12, incluidas versiones históricas. De ellas, 9 aún no han sido marcadas como deprecated por AA. Superar un umbral de referencia de evaluación no garantiza vencerlo en todas tus tareas.
¿Por qué no se utiliza la puntuación de 61.4 de Opus 4.8?#
61.4 procede del antiguo Intelligence Index vigente cuando se publicó; en la v5 de esta ronda, el modelo no tiene puntuación total. Las comparaciones deben usar la misma escala y no puede aplicarse directamente un valor histórico a la nueva clasificación.
¿Los modelos chinos ya son suficientes para el uso cotidiano?#
No puede darse una respuesta uniforme basada únicamente en el país. En esta ronda, algunos modelos completaron tareas cotidianas, pero los errores de pasarela, las diferencias de formato y los truncamientos por presupuesto también alteraron los resultados. Hay que partir de las tareas propias y de la tasa de fallos aceptable para elegir un modelo concreto y una ruta de llamada fiable.
¿Esta prueba demuestra que la experiencia con modelos chinos y estadounidenses es la misma?#
No. Solo se probaron 8 tareas sintéticas, con 2 llamadas por tarea, y algunas solicitudes presentaron alias de versión y problemas en la cadena de servicio; no hubo evaluación humana a ciegas. La prueba muestra razones concretas por las que la clasificación y la experiencia pueden separarse, pero no demuestra una equivalencia general.
¿Qué diferencia hay entre una versión publicada, una configuración de modelo y un nombre de API?#
Una versión publicada en AA puede tener varias configuraciones de razonamiento; una pasarela puede usar alias o actualizaciones continuas hacia una nueva versión. El recuento de la clasificación deduplica por versión publicada, mientras que las pruebas reales conservan el nombre solicitado y el campo model devuelto; ambos no se corresponden automáticamente de forma biunívoca.
Referencias#
- API de datos de Artificial Analysis: campos, paginación, versiones y definición de valores ausentes. La recopilación completa de este estudio se realizó el 2026-10-29 y la API informó de la versión 5 de Intelligence.
- Artificial Analysis AI Trends: Progress, atribución por país y versiones publicadas. Instantánea anónima de la página pública del 2026-10-29; las estadísticas del artículo son recálculos del autor a partir de esa instantánea.
- Metodología de Artificial Analysis Progress Index v1. Escala IRT, configuraciones y límites de las comparaciones históricas.
- Anuncio de AA Intelligence Index v5, 2026-10-27. Se utiliza para explicar los cambios de evaluación, no como sustituto de la clasificación más reciente del 29 de octubre.
- Metodología y notas de versión de AA Intelligence Index.
- Evaluación de lanzamiento de AA Opus 4.8, 2026-05-28 y página actual del modelo.
- Página oficial de lanzamiento de Anthropic Opus 4.8.
En este artículo, «superar» y «liderar» siempre se limitan a una escala explícita y a la muestra cubierta, y no implican significación estadística. Si AA añade evaluaciones, revisa datos o incorpora nuevos modelos, los resultados deberán recalcularse.