简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
DeepSeek en 4 NVIDIA Spark: pruebas de un despliegue propio frente a Crazyrouter V4.1 Flash 1017
Pruebas del 3–4 de noviembre de 2026: DeepSeek en 4 Spark frente a Crazyrouter V4.1 Flash 1017. Velocidad, caché, cortes y latencia. Pesos sin cotejar.
¿Puede un despliegue propio de DeepSeek en cuatro NVIDIA Spark ofrecer un rendimiento similar al de una API ya disponible? Revisamos las pruebas del 3 y 4 de noviembre de 2026. En la misma ronda, la referencia de Crazyrouter generó la salida más rápido. En las pruebas posteriores, el rendimiento de Spark varió notablemente según la hora, con una diferencia considerable entre los periodos de baja y alta carga.
En la comparación del 3 de noviembre, con una muestra reducida, las medianas de velocidad de salida de la referencia DeepSeek V4.1 Flash 1017 de Crazyrouter fueron de 147.31 y 136.87 token/s con entradas cortas y largas, respectivamente. En el despliegue propio con cuatro Spark fueron de 41.46 y 10.02 token/s. Ambos servicios completaron 6/6 solicitudes de la prueba de velocidad.1
Este artículo analiza el rendimiento del servicio una vez desplegado. Mide cuánto tarda en llegar el primer fragmento de texto, a qué velocidad se genera la salida en streaming, si el contexto repetido puede aprovechar la caché y si las solicitudes se completan dentro del plazo de prueba en horas de alta carga. Los datos proceden de registros históricos. No corresponden a pruebas nuevas del 20 de noviembre ni constituyen un compromiso sobre el estado actual del servicio. Todas las horas se indican en horario de Pekín.
¿La referencia 1017 y el despliegue propio en Spark usaban la misma versión?#
Para conocer la familia de modelos, consulta la página de modelos DeepSeek de Crazyrouter. Para más información sobre Spark, consulta la página oficial de NVIDIA DGX Spark. Estas páginas ofrecen información complementaria. Las conclusiones sobre el rendimiento histórico se basan en los registros de las pruebas de este artículo.
Ambos servicios recibieron solicitudes con el nombre de modelo deepseek-v4.1-flash, pero devolvieron identificadores distintos.
| Servicio comparado | Nombre del modelo en la respuesta | Qué se pudo confirmar entonces |
|---|---|---|
| DeepSeek de referencia de Crazyrouter | deepseek-v4.1-flash-1017 | El identificador de la respuesta incluía el sufijo 1017 |
| DeepSeek desplegado en cuatro Spark | deepseek-v4.1-flash | La inspección confirmó que los cuatro nodos GB10 ejecutaban procesos de inferencia correspondientes a los ranks |
Los registros históricos no documentaban por completo el hash de los pesos, la revisión exacta ni la configuración de cuantización del despliegue propio. Por eso, en este artículo DeepSeek V4.1 Flash 1017 designa el identificador devuelto por el servicio de referencia. La identidad de los pesos de ambos servicios no se verificó. El nombre que figura en la respuesta tampoco permite verificar los pesos de forma independiente.2
Al buscar «despliegue propio de deepseekv4.1flash1017 en NVIDIA Spark», conviene distinguir dos verificaciones. Comprobar que el despliegue ofrece una interfaz compatible y demostrar que ejecuta exactamente la misma versión del modelo son requisitos distintos. La comparación abarca dos rutas de servicio tal como funcionaban en ese momento. Una clasificación del rendimiento del hardware de GPU requeriría controlar todas las variables.
Metodología de la prueba: mismo punto de acceso, canales fijos y presupuesto de salida fijo#
En la prueba principal del 3 de noviembre se utilizó el mismo punto de acceso de Crazyrouter para enviar solicitudes a dos canales fijos. Uno llevaba al servicio de referencia y el otro, al despliegue propio en cuatro Spark. Durante la prueba no se incluyeron respuestas de otros canales en los resultados ni se modificó la configuración de los canales.
La dirección utilizada en la prueba histórica fue la siguiente.
Base URL: https://crazyrouter.com/v1
Endpoint: POST /chat/completions
Model: deepseek-v4.1-flash
A continuación figuran los parámetros principales de medición. La solicitud completa incluía también el mismo texto de la tarea y un prefijo para distinguir las rondas.
{
  "model": "deepseek-v4.1-flash",
  "stream": true,
  "temperature": 0,
  "max_tokens": 768,
  "thinking": { "type": "disabled" }
}
La entrada corta tenía 64 tokens y la larga, 6,230 tokens. Se hicieron tres solicitudes de cada tipo. Se repitió el texto de la entrada larga para observar los aciertos de caché. Entre el final de cada solicitud y el inicio de la siguiente se dejaron seis segundos. Los canales se probaron en paralelo y, dentro de cada canal, las solicitudes se enviaron en serie.
La ronda histórica completa abarcó cuatro canales y 26 solicitudes formales. Este artículo se centra en las 12 de la referencia y Spark. Los otros dos canales sirvieron para contrastar el rango de resultados. Una prueba preliminar de funcionamiento realizada por separado quedó fuera de las estadísticas. Se cotejaron el canal y el número de tokens de todas las solicitudes formales con los registros de consumo.
Todas las solicitudes de la prueba principal generaron 768 tokens de salida y cero tokens de razonamiento. Una solicitud se consideró completada cuando el cliente recibió el fin normal del flujo y el registro de uso. Alcanzar el presupuesto con finish_reason=length era el resultado esperado en esta prueba de velocidad. El resultado de 6/6 mide cuántas solicitudes de la prueba terminaron correctamente a nivel de transporte. No mide la exactitud de las respuestas ni implica que el modelo haya concluido por sí solo una tarea real.
Se midieron dos intervalos por separado. La espera hasta el primer fragmento se contó desde que el cliente envió la solicitud. Para calcular la velocidad de salida, se dividió el número de tokens de salida por el tiempo transcurrido entre el primer bloque de texto y el último. La velocidad es una estimación del lado del cliente, incluye los tokens del primer bloque y excluye el tiempo previo de conexión y espera en cola. Las medianas de las tablas se calcularon a partir de tres solicitudes.1
Resultados de la misma ronda: espera inicial similar con entradas cortas y una clara diferencia en la generación#
| Métrica | Referencia 1017 de Crazyrouter | Despliegue propio en cuatro Spark |
|---|---|---|
| Solicitudes completadas | 6/6 | 6/6 |
| Mediana de espera hasta el primer fragmento con entrada corta | 3.31 segundos | 3.25 segundos |
| Mediana de velocidad de salida con entrada corta | 147.31 token/s | 41.46 token/s |
| Mediana de tiempo total con entrada corta | 9.05 segundos | 21.78 segundos |
| Mediana de espera hasta el primer fragmento con entrada larga | 3.36 segundos | 7.73 segundos |
| Mediana de velocidad de salida con entrada larga | 136.87 token/s | 10.02 token/s |
| Mediana de tiempo total con entrada larga | 9.09 segundos | 84.40 segundos |
| Tiempo total de la solicitud más lenta | 10.26 segundos | 156.11 segundos |
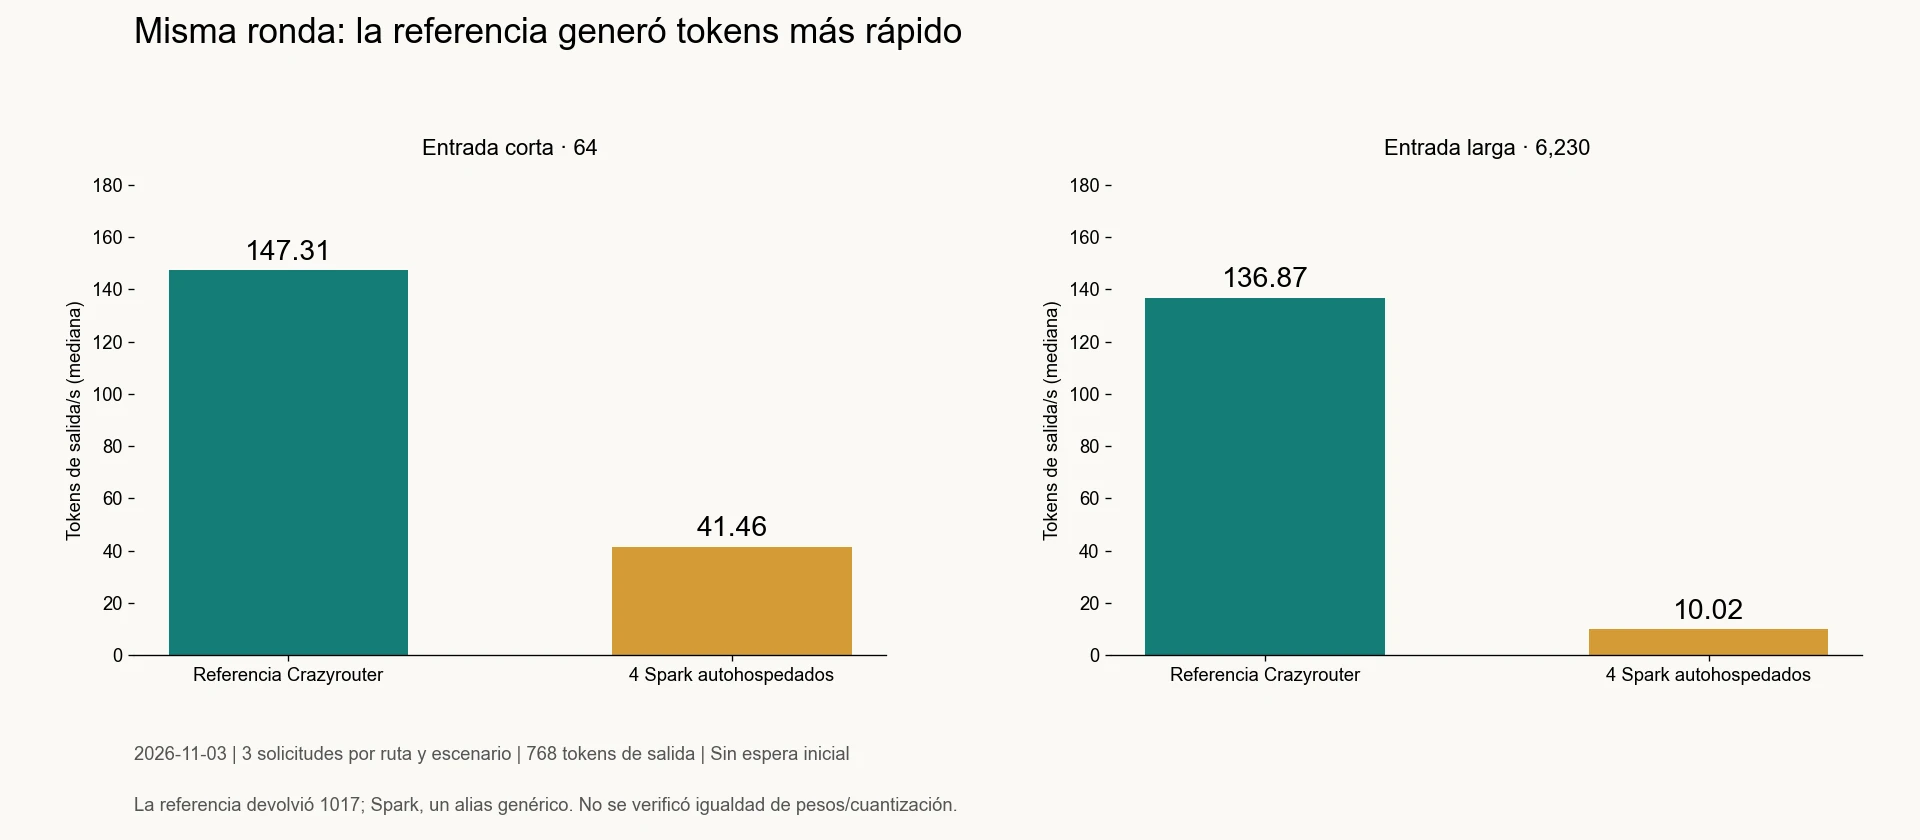
Figura 1. El 3 de noviembre de 2026 se hicieron tres solicitudes por servicio y escenario. La velocidad de salida excluye la espera hasta el primer fragmento. No se verificó que ambos servicios usaran los mismos pesos y la misma cuantización.
Con la entrada corta, Spark tardó incluso un poco menos en enviar el primer fragmento. Después generó la salida más despacio y el tiempo total fue mayor. Según las medianas de velocidad de salida, la referencia alcanzó aproximadamente 3.55 veces la velocidad de Spark con la entrada corta y 13.66 veces con la larga. Estas proporciones describen el estado de los servicios en esa ronda y no permiten determinar el límite de rendimiento del hardware de los cuatro Spark.
Spark también tuvo una solicitud notablemente lenta. La tercera con entrada corta tardó unos 105.38 segundos y generó alrededor de 7.47 token/s, aunque llegó a completarse. Por eso, la ausencia de errores y la estabilidad de la experiencia de uso deben evaluarse por separado. En los otros dos canales de referencia, las medianas de velocidad de salida fueron de 143.69–148.13 token/s con la entrada corta y de 130.20–141.49 token/s con la larga. La velocidad de la referencia quedó dentro del rango observado en los cuatro canales de la ronda.1
¿Por qué varía la velocidad incluso con aciertos de caché?#
Estos fueron los registros de caché de las entradas largas en la prueba principal.
| Ruta del servicio | Tokens en caché en las tres solicitudes con entrada larga | Porcentaje de la entrada en caché en la última solicitud |
|---|---|---|
| Referencia de Crazyrouter | 0 → 6,144 → 6,144 | 98.62% |
| Despliegue propio en cuatro Spark | 0 → 0 → 0 | 0% |
Si solo se mirara esta ronda, podría parecer que Spark no admite caché. Los registros posteriores mostraron lo contrario. En la repetición de la prueba del 4 de noviembre a la 01:04, se registraron 0 → 6,234 → 6,234 tokens en caché con la entrada larga. En la última solicitud representaron el 99.98% de la entrada. Aun así, la mediana de velocidad de salida con la entrada larga fue de solo 13.37 token/s. Las tres solicitudes alcanzaron 13.37, 12.90 y 45.15 token/s, respectivamente. La velocidad de las dos solicitudes con aciertos de caché siguió siendo muy distinta.3
En la repetición de las 14:14, el 82.13% de la última entrada larga estaba en caché, pero la mediana de velocidad de salida llegó a 57.91 token/s. La proporción de tokens en caché, por sí sola, no explica la velocidad de la respuesta completa. Tampoco equivale a un porcentaje de ahorro. En esta prueba no se utilizó esa cifra para calcular una ventaja de costes.
¿Cuánto variaron los resultados del mismo despliegue Spark en cuatro horarios?#
En las pruebas posteriores se mantuvieron el mismo texto de la tarea y los mismos parámetros de salida. Se usó un prefijo distinto en cada ronda, por lo que las entradas cortas tenían aproximadamente 64–69 tokens y las largas, unos 6,230–6,235 tokens. Las solicitudes no eran idénticas token por token.
| Fecha y hora de la prueba | Solicitudes completadas | Velocidad de salida con entrada corta | Velocidad de salida con entrada larga | Espera hasta el primer fragmento con entrada corta | Espera hasta el primer fragmento con entrada larga |
|---|---|---|---|---|---|
| 3 de noviembre, 23:43 | 6/6 | 41.46 token/s | 10.02 token/s | 3.25 segundos | 7.73 segundos |
| 4 de noviembre, 01:04 | 6/6 | 50.69 token/s | 13.37 token/s | 4.25 segundos | 3.61 segundos |
| 4 de noviembre, 14:14 | 6/6 | 56.70 token/s | 57.91 token/s | 2.04 segundos | 5.31 segundos |
| 4 de noviembre, 20:24 | 3/6 | 16.84 token/s* | 7.07 token/s* | 51.96 segundos* | 37.59 segundos* |
Las cifras de la noche solo incluyen las solicitudes completadas. Terminaron 2/3 con entrada corta y 1/3 con entrada larga. Las otras tres se interrumpieron y quedaron fuera de las medianas de velocidad y de espera hasta el primer fragmento.
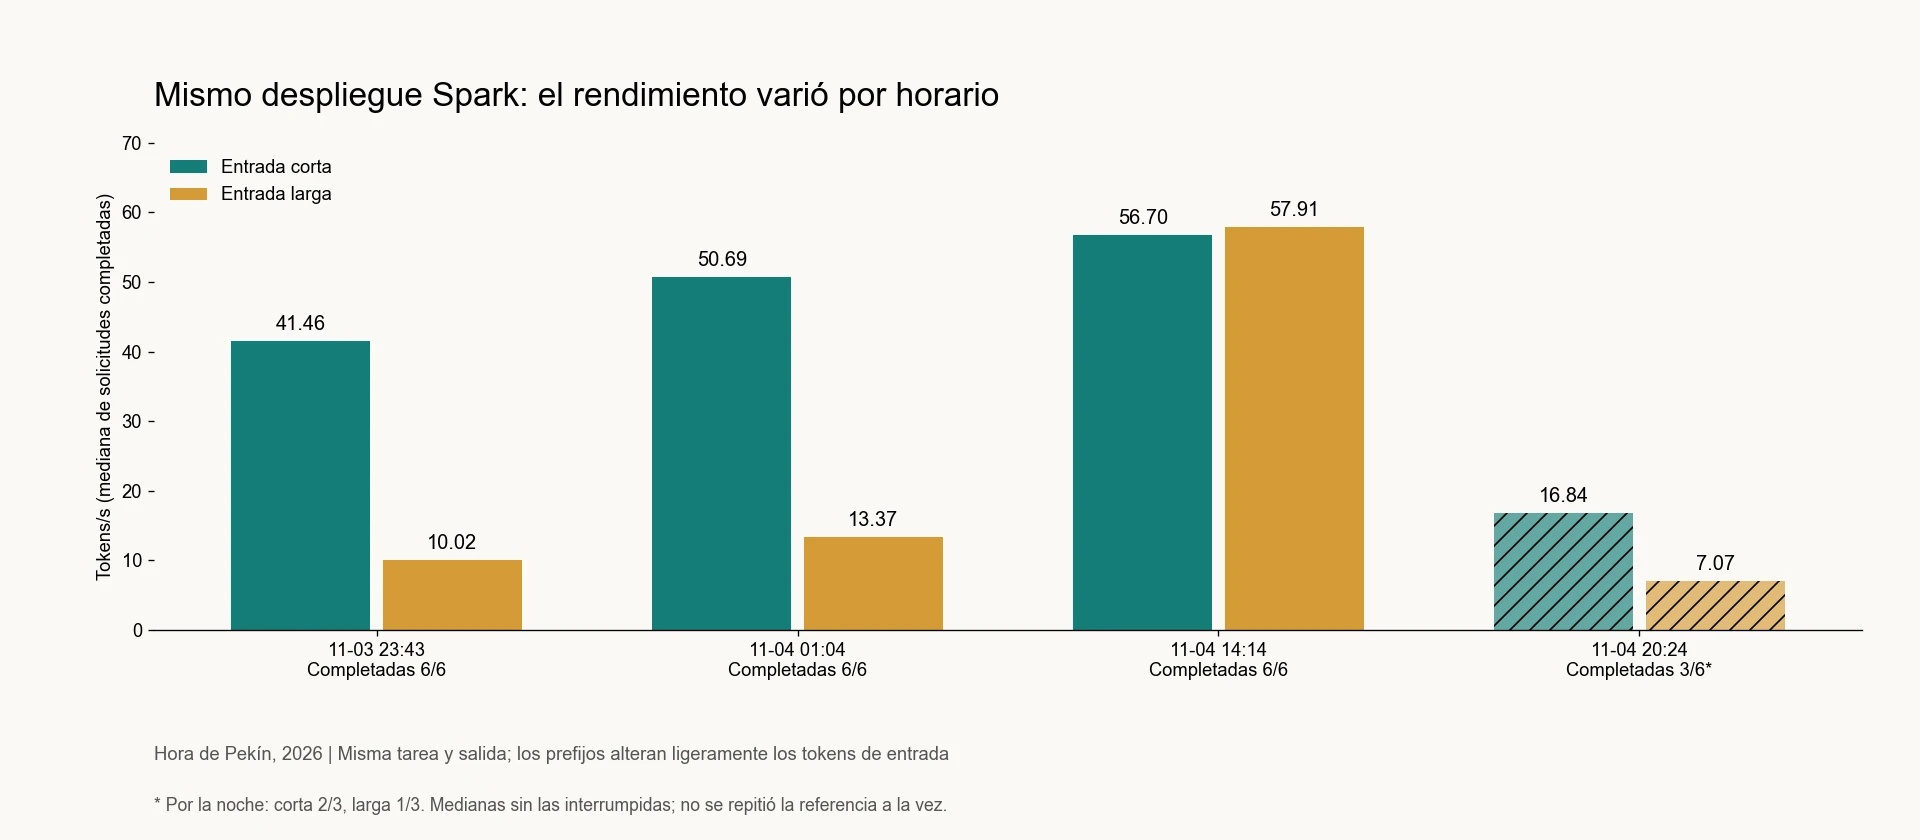
Figura 2. Las tres últimas rondas solo se repitieron con Spark, sin volver a ejecutar en paralelo la prueba con la referencia de Crazyrouter. Los resultados anteriores de la referencia y los de los nuevos horarios no constituyen una misma ronda de comparación controlada.
Las tres solicitudes que se interrumpieron por la noche recibieron cabeceras HTTP 200 y parte del contenido en streaming, pero no terminaron con normalidad. El cliente cerró las llamadas al cabo de unos 166–187 segundos y los registros del sitio anotaron el código 499, correspondiente a la desconexión del cliente. Contar solo las respuestas HTTP 200 habría dado erróneamente un resultado de 6/6 solicitudes completadas.3
En la ronda nocturna solo se completaron tres de seis solicitudes. También cayó la velocidad de las que sí terminaron. La muestra de esa ronda es demasiado pequeña para estimar la disponibilidad a largo plazo.
¿Dónde se produjo la demora? La carga y las colas son la explicación más probable#
La inspección de solo lectura confirmó que los cuatro nodos GB10 ejecutaban procesos de inferencia. La instantánea de capacidad del servicio mostraba slots=4 y peak_batch=4. Estos valores describen la configuración del motor en ese momento y no establecen un límite fijo de capacidad para cuatro Spark con cualquier software o modelo.
El mismo servicio en funcionamiento dejó dos tipos de registros con distintos niveles de carga.
- 4 de noviembre a las 19:44, con una carga relativamente baja. Los registros del servidor mostraron que las solicitudes de 32 o 59 tokens de entrada y 256 tokens de salida alcanzaron 104.8–156.8 token/s, con un tiempo hasta el primer fragmento de 0.115–0.148 segundos. La reconstrucción de ese momento solo reveló una solicitud sin terminar y ninguna entrada larga de más de 10,000 tokens.
- A las 20:24, al comenzar la prueba en la que se observaron las demoras. A partir de las horas de finalización y la duración de las solicitudes que terminaron, se infirió que al menos 12 solicitudes con entradas de más de 10,000 tokens seguían pendientes y sumaban alrededor de 1.53 millones de tokens de entrada. A las 20:33, otra instantánea indicaba que al menos 16 solicitudes de ese tipo seguían sin terminar.4
Estos recuentos son mínimos estimados a partir de los registros históricos e incluyen solicitudes tanto en espera como en ejecución. No indican que 12 o 16 solicitudes estuvieran usando simultáneamente la GPU para la decodificación. Los registros tampoco permiten determinar de dónde procedía el resto del tráfico.
Con una carga relativamente baja, Spark pudo generar texto con rapidez. Cuando quedan muchas solicitudes con contextos largos por terminar, el cliente puede pasar mucho tiempo sin recibir contenido. Las solicitudes directas al modelo también sufrieron demoras durante el periodo de alta carga, así que solo una parte de la latencia puede atribuirse a la pasarela de Crazyrouter.
La carga de contextos largos y la competencia en cola son la explicación más probable según los registros disponibles. Sin trazas completas de cada etapa, no se puede determinar con precisión cuánto tiempo correspondió al planificador, al precálculo del contexto, a la decodificación o a la transmisión. La velocidad de las 19:44 se midió en el servidor, con instrucciones de entrada cortas y 256 tokens de salida. Esa medición no se puede combinar directamente con la prueba principal de 768 tokens medida desde el cliente.
¿Aumentó la latencia al pasar por Crazyrouter? Sí, en las dos pruebas por pares#
El 4 de noviembre a las 22:16, con una carga relativamente baja, se hicieron dos pruebas por pares. En cada par se enviaron solicitudes simultáneamente a la misma instancia de DeepSeek desplegada en Spark, una por conexión directa a través de la red pública y la otra mediante Crazyrouter. Ambas usaron la misma entrada de 26 tokens y un presupuesto de salida de 256 tokens.
| Par | Ruta | Espera hasta el primer fragmento | Tiempo total |
|---|---|---|---|
| 1 | Conexión directa a Spark | 0.786 segundos | 3.779 segundos |
| 1 | Al mismo Spark a través de Crazyrouter | 6.150 segundos | 8.307 segundos |
| 2 | Conexión directa a Spark | 1.031 segundos | 4.301 segundos |
| 2 | Al mismo Spark a través de Crazyrouter | 3.704 segundos | 7.496 segundos |
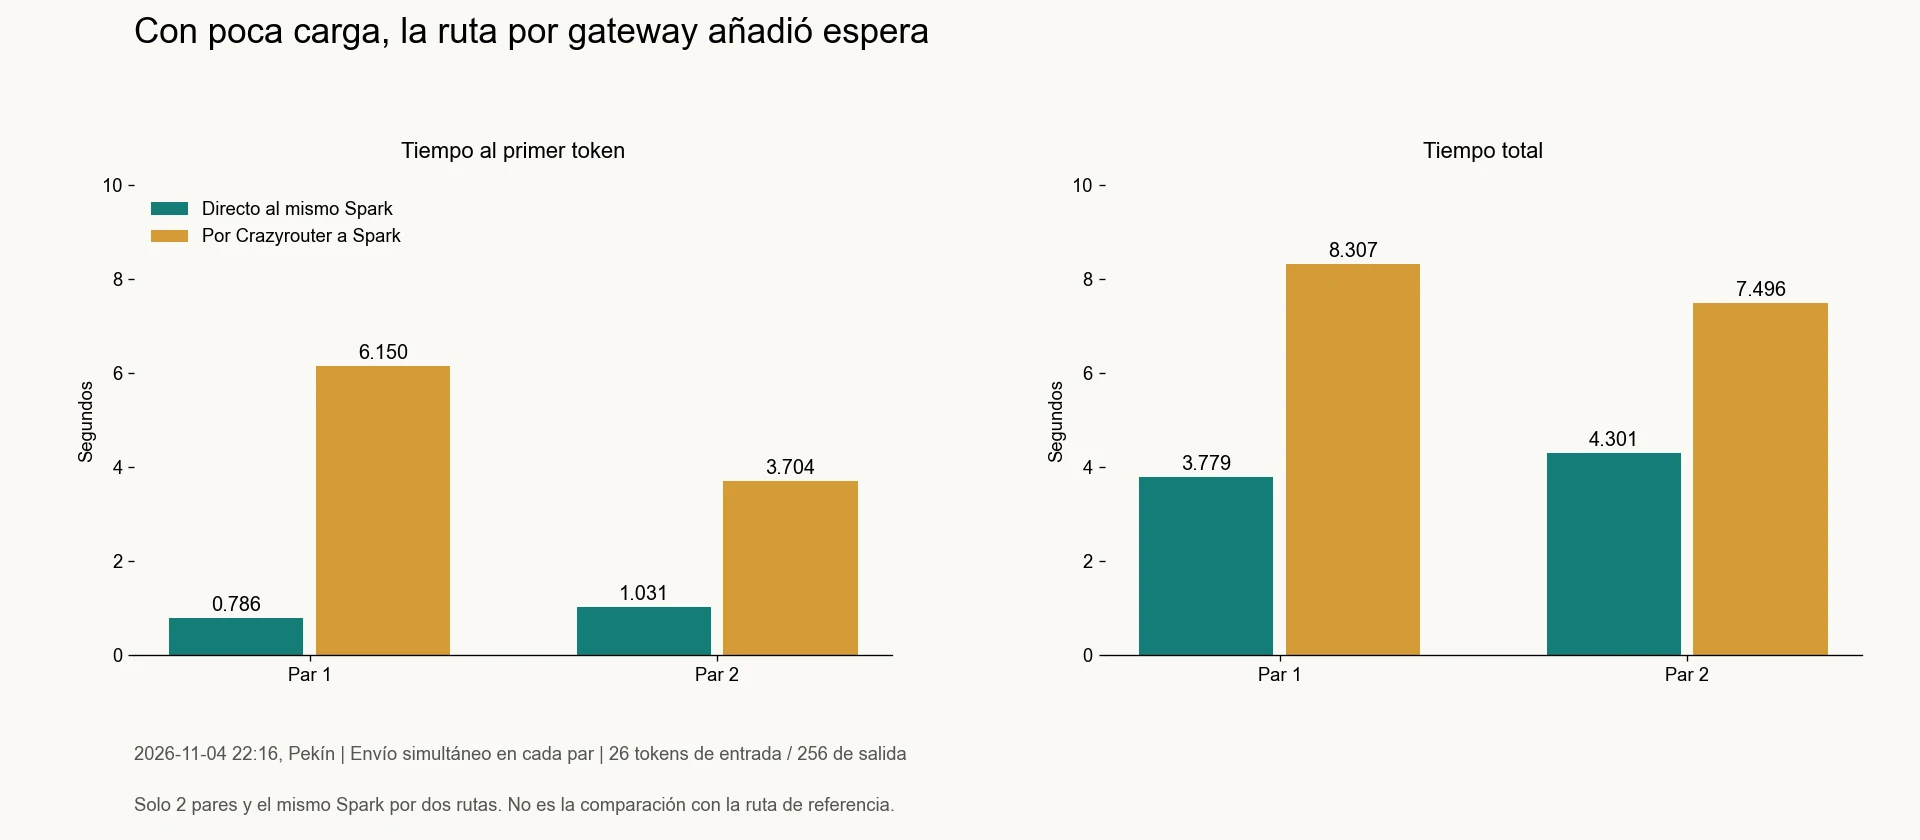
Figura 3. Se comparan dos rutas de acceso al mismo servicio Spark. La referencia 1017 de las secciones anteriores no intervino en esta comparación. Las solicitudes de cada par se enviaron a la vez, aunque pudieron llegar al servicio de inferencia en momentos distintos.
El tiempo total por la pasarela fue 4.528 segundos mayor en el primer par y 3.195 segundos mayor en el segundo. Los tiempos de procesamiento registrados en el servidor fueron bastante similares, lo que sugiere que parte de la diferencia se debió a una espera adicional antes de que la solicitud llegara al servicio de inferencia. Dos pares de solicitudes no bastan para determinar qué parte corresponde al procesamiento de la pasarela, a la conexión saliente y al mapeo de la red pública. Tampoco permiten tratar esa diferencia como una sobrecarga fija de la pasarela.5
Elegir un servicio de referencia más rápido y añadir una capa de reenvío al mismo servicio de inferencia propio son dos decisiones distintas. En la comparación anterior, la referencia fue más rápida en la misma ronda. En estas dos pruebas adicionales, la conexión directa a Spark tuvo un tiempo total menor de extremo a extremo.
¿Cómo utilizar estos resultados al preparar un despliegue propio?#
Los registros muestran que cuatro Spark pueden ejecutar este servicio de DeepSeek. Para ofrecer tiempos de respuesta previsibles, una sola medición de velocidad con poca carga no basta como prueba de aceptación.
Para los equipos que estén preparando un despliegue, recomendamos incluir cuatro medidas en la próxima ronda de validación.
- Fijar primero la versión. Registrar la revisión de los pesos, su hash, la cuantización, la versión del motor de inferencia y la topología. El alias de la API por sí solo no basta para confirmar que la versión es idéntica.
- Probar con una mezcla de cargas representativa del uso real. Incluir conversaciones cortas, contextos de unos 6K tokens y las solicitudes largas que se esperan en producción. Observar si la carga retrasa las solicitudes cortas.
- Registrar la espera, la velocidad y la tasa de finalización. Conservar todas las muestras que se interrumpan y calcular P95/P99 cuando haya suficientes datos. Mostrar solo la salida más rápida dejaría fuera la variabilidad.
- Alinear las mediciones del servidor y del cliente. Comparar por separado el acceso directo y el acceso por pasarela, tanto en periodos de baja como de alta carga, para identificar qué tramo conviene optimizar.
Si la prioridad es la velocidad de respuesta en las condiciones de este artículo, la referencia de Crazyrouter obtuvo mejores resultados en la misma ronda. Si el objetivo es controlar el entorno de despliegue y la política de planificación, los registros de Spark sirven de base para las pruebas de aceptación. La decisión de adoptar un despliegue propio requiere además datos de capacidad, calidad, recuperación ante fallos y costes operativos.
No medimos los gastos de compra o alquiler de las cuatro máquinas, el coste de la electricidad, la potencia, la utilización ni las horas de mantenimiento. Tampoco puntuamos la calidad de las respuestas. Este artículo no permite concluir que el despliegue propio sea más barato ni que alguno de los modelos sea más inteligente.
Preguntas frecuentes#
¿Puede un despliegue propio de DeepSeek V4.1 Flash 1017 en cuatro NVIDIA Spark sustituir a la API?#
Estos registros demuestran que el servicio en los cuatro nodos GB10 puede responder a solicitudes de DeepSeek. No permiten confirmar que el despliegue propio usara los pesos de la misma revisión 1017. Sustituir la API en producción depende de la carga real, los plazos de respuesta, la calidad y los requisitos operativos. El resultado nocturno de 3/6 solicitudes completadas indica que hace falta validar el servicio en horas de alta carga.
¿La diferencia de 13.66 veces de la prueba principal se debe al rendimiento del hardware?#
Esa cifra es el cociente entre las medianas de velocidad de salida con entradas largas en la misma ronda. Refleja, entre otras cosas, diferencias en la caché, la carga, el servicio de inferencia y las rutas de acceso en ese momento. No permite inferir cuántas veces más capacidad de cómputo tenía una GPU con respecto a otra.
¿Por qué la respuesta seguía siendo lenta con un 99.98% de la entrada en caché?#
En esa ronda casi toda la entrada pudo recuperarse de la caché, pero la mediana de velocidad de salida con la entrada larga siguió siendo de 13.37 token/s. El porcentaje de aciertos de caché por sí solo no representa la velocidad de la respuesta completa. Los registros históricos no incluyen mediciones por etapa suficientes para cuantificar la contribución de cada factor.
¿Puede Spark generar más de cien tokens por segundo?#
Los registros históricos del servidor muestran 104.8–156.8 token/s con una carga relativamente baja, entradas cortas y 256 tokens de salida. Las condiciones de medición fueron distintas de las de la prueba principal de 768 tokens medida desde el cliente. Esa cifra no constituye una garantía de rendimiento sostenido bajo cualquier carga.
¿Se puede contar una respuesta HTTP 200 como una llamada completada?#
En la prueba nocturna, tres solicitudes recibieron HTTP 200 y parte del contenido antes de interrumpirse sin un cierre normal. Por eso se registraron 3/6 solicitudes completadas en lugar de 6/6.
¿Qué sale más barato, el despliegue propio o Crazyrouter?#
No se puede llegar a una conclusión sin datos de costes completos y comparables. Para calcularlos, conviene comparar el hardware, la utilización, la operación y los reintentos tras fallos con las facturas reales de la API para el mismo volumen de trabajo. Las tarifas vigentes se pueden consultar en la página de precios de Crazyrouter. Los precios actuales no equivalen a los costes reales de la prueba histórica.
Material de las pruebas y lecturas adicionales#
Para integrar aplicaciones, consulta la guía de integración de Crazyrouter. Si te interesa comparar la exactitud de las respuestas y el consumo real, consulta la prueba independiente Comparación en la nube de GPT-6.2 Sol y DeepSeek V4.1 Flash (en chino). Utiliza tareas y métodos de evaluación distintos de los de esta prueba de velocidad, por lo que sus resultados no se pueden combinar con los de este artículo.
El artículo se elaboró a partir del archivo histórico de pruebas de Crazyrouter. Las estadísticas se recalcularon el 20 de noviembre de 2026. Las muestras originales, los registros de verificación de canales y el índice de diagnósticos de las máquinas se archivaron internamente. Las notas siguientes detallan el origen de los datos y qué solicitudes se incluyeron en cada cálculo.
Autora: Sophie M · Fecha de elaboración: 20 de noviembre de 2026 · Fecha de los datos: 3–4 de noviembre de 2026.
Footnotes#
-
Prueba principal del 2026-11-03 con cuatro canales y 26 solicitudes formales. El artículo incluye seis solicitudes del servicio de referencia y seis de Spark. Se cotejaron los registros de cada solicitud, los datos agregados y los registros de consumo. ↩ ↩2 ↩3
-
Campo del modelo devuelto en las respuestas de la prueba principal e inspección de los cuatro nodos del 2026-11-04. Solo se confirmaron los identificadores devueltos y los procesos del despliegue. No se verificó que los pesos fueran idénticos. ↩
-
Tres rondas de repetición con Spark el 2026-11-04 a la 01:04, las 14:14 y las 20:24, con seis solicitudes por ronda. Se conservaron por separado las tres interrupciones del cliente en la ronda nocturna. ↩ ↩2
-
Registros de diagnóstico de las máquinas del 2026-11-04. El número de solicitudes pendientes se estimó retrospectivamente a partir de la duración de las solicitudes completadas e incluye tanto las que estaban en espera como las que se estaban ejecutando. ↩
-
Prueba adicional del 2026-11-04 a las 22:16 con dos pares de solicitudes, por conexión directa y por pasarela. Se usaron 26 tokens de entrada y 256 tokens de salida. ↩
Implementation Guides
Podcast
AI Dev Tools: The Crazyrouter Podcast
Episodios breves (en inglés) para desarrolladores: API de IA, gateways, control de costes y herramientas de código.
Últimos episodios
EP196 · 29 oct 2026 · 6:53
AI API Security Posture — Turn Controls Into Continuous Evidence
A practical guide to AI API security posture: inventory exposure, verify controls continuously, protect keys and data, constrain tools, and turn security assumptions into evidence that operators can act on.
EP195 · 28 oct 2026 · 7:21
AI API Policy Drift — Detect When Production Rules Stop Matching Intent
A practical guide to policy drift in AI APIs: version routing and safety rules, detect stale enforcement, compare intended and observed behavior, and restore control before small gaps become incidents.