简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
中美 AI 模型真實差距到底有多遠?|序章
中美 AI 模型比較系列序章:以 2026 年 10 月 29 日 Artificial Analysis 資料為基礎,比較前沿分差、Opus 4.8 門檻與 112 次真實 API 呼叫;建立後續文本、程式設計、圖像、影片、語音、向量與重排專題的共同研究方法。
本篇為同一項研究的繁體中文版,資料截點為 2026-10-29。全部 112 次測試使用原始中文提示詞,未另行執行多語言評測。配圖統一使用英文標籤;程式範例以 Unicode 跳脫序列保留原始中文提示詞,執行時會還原。
中美 AI 模型比較系列 · 序章。我們先從文本模型建立比較方法,再分別研究圖像、影片、語音、向量檢索與重排。本篇是方法和問題的起點,文本模型的分數不能代表其他模態的實力。
美國模型在目前的前沿榜單和領先陣容上占優,但「中美模型差距正在持續擴大」不符合本次同標尺回溯結果。以 Opus 4.8 作為個人滿意度的參考門檻,AA 已涵蓋樣本中有 12 個中國發布版本、21 個美國發布版本的 Progress Index 分數高於它;這不意味著每個任務都更好用。
資料截點為 2026 年 10 月 29 日。本文把三個容易混淆的問題拆開:最強模型之間差多少、跨過舊旗艦門檻的選擇有多少,以及實際請求中哪些差距能夠被感受到。前兩個問題使用 Artificial Analysis(AA)資料,第三個問題透過 Crazyrouter 進行 7 款模型、8 種任務、每題 2 次,共 112 次呼叫稽核。[1][2]
這是一份模型樣本研究。它不評判兩國整體 AI 產業,也沒有進行人類主觀盲評;「可用」最終取決於你的任務、等待時間和容錯要求。
先看結果:前沿領先與普遍可用,是兩件事#
| 指標/標尺 | 中國 | 美國 |
|---|---|---|
| 目前最高分 · Intelligence v5 | 46.0 · Kimi K3.1 Pro | 59.4 · Gemini 4 Carbon |
| Top 5 均分 · Intelligence v5 | 34.74 | 56.68 |
| 全球 Top 10 版本數 · Intelligence v5 | 1 | 9 |
| 目前最高分 · Progress v1 | 340.70 | 351.65 |
| 超過 Opus 4.8 · Progress v1,含歷史版本 | 12 | 21 |
| 其中 AA 未標記 deprecated 的版本 | 9 | 13 |
兩種指數的數值不能相減或混排。目前 v5 前沿分差為 13.4 分;Progress v1 的目前前沿分差為 10.94 分。前者衡量目前評測集的表現,後者用於分析跨時期的能力變化。
統計將 AA 的 716 條推理配置合併為 517 個發布版本,其中中國 176 個、美國 257 個,其餘為其他國家或未分類。按 release.id 合併,同一版本的 high、max、xhigh 不重複算成多個模型。每項指標分別取該版本的最高得分配置,最高配置可能不同。
新 v5 榜單目前只有 39 個發布版本有可用總分,其中中國 12 個、美國 24 個、其他國家 3 個。這裡的 Top 10 和均分是已測樣本的統計,缺測不代表零分。排名按原始 API 回傳精度,並列占同名次,後續名次跳位。[1]
目前前 20 名:誰在領先陣容?#
| 全球名次(版本去重) | 發布版本 | 歸屬 | v5 分數 | 發布日期 |
|---|---|---|---|---|
| 1 | Gemini 4 Carbon | 美國 | 59.4 | 2026-10-28 |
| 2 | Claude Opus 5.5 | 美國 | 58.4 | 2026-09-22 |
| 3 | GPT-6 Astra | 美國 | 56.9 | 2026-09-03 |
| 4 | GPT-6.1 Sol | 美國 | 54.5 | 2026-09-29 |
| 5 | Claude Sonnet 5.5 | 美國 | 54.2 | 2026-09-28 |
| 6 | GPT-6.1 Terra | 美國 | 51.0 | 2026-10-26 |
| 7 | Gemini 4 Argon | 美國 | 50.4 | 2026-09-30 |
| 8 | Muse Wonder Full | 美國 | 49.7 | 2026-10-12 |
| 8 | Claude Fable 5.1 | 美國 | 49.7 | 2026-09-01 |
| 10 | Kimi K3.1 Pro | 中國 | 46.0 | 2026-10-23 |
| 11 | Muse Wonder | 美國 | 43.3 | 2026-10-12 |
| 12 | Muse Spark 1.3 | 美國 | 36.4 | 2026-09-02 |
| 13 | Claude Haiku 5.5 | 美國 | 36.2 | 2026-10-07 |
| 14 | Grok 4.7 | 美國 | 35.0 | 2026-09-21 |
| 15 | Qwen3.8 Max (0902) | 中國 | 33.6 | 2026-09-02 |
| 16 | DeepSeek V4.1 Flash 1017 | 中國 | 32.5 | 2026-10-17 |
| 17 | GLM-5.3 | 中國 | 31.7 | 2026-08-18 |
| 18 | Gemini 3.8 Flash | 美國 | 30.5 | 2026-09-02 |
| 19 | MiMo-V2.6-Pro | 中國 | 29.9 | 2026-09-21 |
| 20 | Ling 3.1 Flash 1019 | 中國 | 29.5 | 2026-10-22 |
這份前 20 名中,中國占 6 席、美國占 14 席;前 10 名分別為 1 席和 9 席。結合 Top 5 均分 34.74 與 56.68,可以看到單一前沿模型追近與領先梯隊厚度仍有差別。總分缺測的版本不參與排名。[1]
分數差距是在越拉越大嗎?#
不是持續擴大,而是明顯受旗艦發布節奏影響。 我們用同一次擷取的 Progress Index v1,按各版本發布日期重建兩國前沿:某天之前已發布版本的最高分,就是那天的回溯前沿。
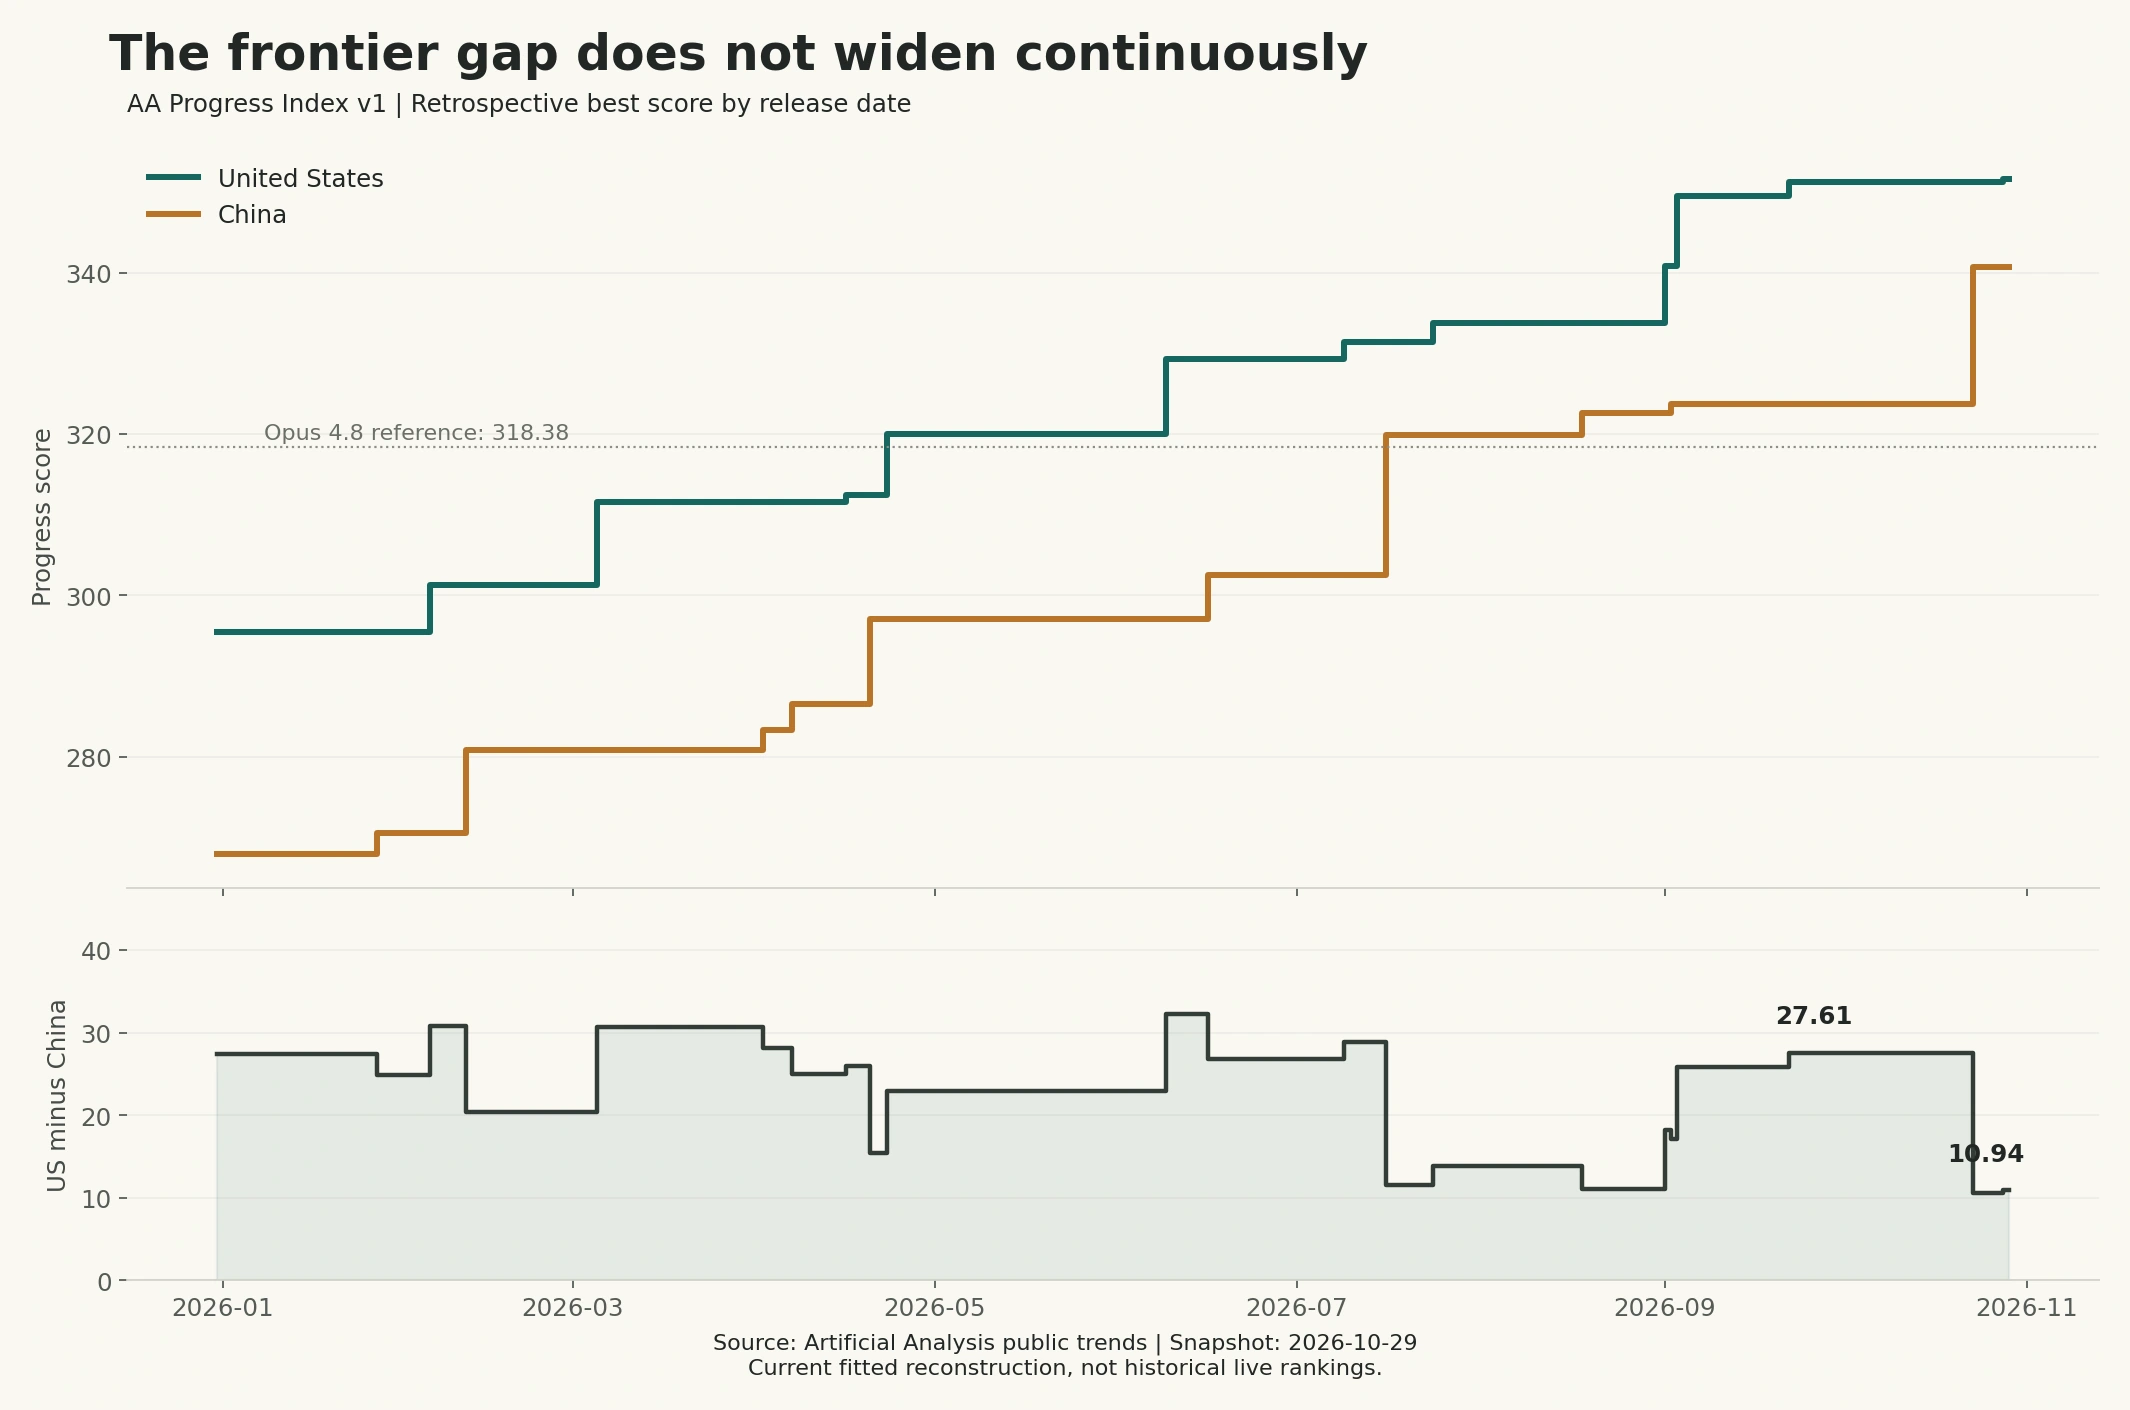
| 回溯日期 | 中國前沿 | 美國前沿 | 分差:美國−中國 |
|---|---|---|---|
| 2025-12-31 | 267.96 | 295.46 | 27.49 |
| 2026-03-31 | 280.87 | 311.55 | 30.69 |
| 2026-06-30 | 302.52 | 329.33 | 26.80 |
| 2026-07-31 | 319.88 | 333.73 | 13.85 |
| 2026-08-31 | 322.66 | 333.73 | 11.07 |
| 2026-09-30 | 323.67 | 351.27 | 27.61 |
| 2026-10-23 | 340.70 | 351.27 | 10.57 |
| 2026-10-29 | 340.70 | 351.65 | 10.94 |
2026 年 8 月底的分差是 11.07。9 月美國新旗艦集中推出後,月底擴大至 27.61;10 月 23 日 Kimi K3.1 Pro 發布,將差距收窄至 10.57;10 月 28 日 Gemini 4 Carbon 發布後,10 月 29 日快照為 10.94。[2]
這使「看哪個時間窗口」成為結論的一部分。目前分差比 30 天前縮小約 16.66 分,比 90 天前縮小約 2.91 分,比 180 天前縮小約 12.00 分。與此同時,美國依然在兩國前沿比較中領先。收窄與領先可以同時成立。
但不能把這張圖稱為「過去每一天的即時榜單」。Progress Index 是基於目前已取得評測的統計擬合,未來補測與重新擬合可能改變回溯分數;歷史 API 開放狀態也沒有完整復原。它回答的是「現在用同一把尺子看過去發布的模型」,不是「當時使用者實際能呼叫到什麼」。[3]
為什麼有人會看到差距突然變大?#
AA 在 2026 年 10 月 27 日將 Intelligence Index 升級至 v5,新增或升級了軟體工程、科研和知識推理評測。其公告提到,開放權重類別領先群與領先模型的差距,從 v4.3 的 3 分變成 v5 的 12 分。[4]
這裡既更換了測量尺子,又使用了「開放權重與領先模型」的分組;不能把它直接改寫為「兩天內中美能力差距從 3 分擴大到 12 分」。該公告還將權重尚未發布的 Kimi K3.1 Pro 納入相關描述,更不能把這一分組等同於當日已經可以下載的模型集合。
v5 給知識工作、程式設計、科學和通用四類各 25% 權重。這會比單純聊天更重視困難任務和多步驟執行。因此,榜單差距可以很大,同時某些日常任務的差距較小;是否如此,需要具體任務證據。[4][5]
如果 Opus 4.8 已經夠用,有多少模型跨過了它?#
先固定標尺。Opus 4.8 在 2026 年 5 月發布評測中的 61.4 分屬於舊版 Intelligence Index。本次 API 快照中,它的 v5 總分為空,不能把空值當 0,更不能拿舊 61.4 篩選新榜單。[1][6]
本文改用 Progress Index v1 中的 Opus 4.8(max):318.376758998036 作為固定參考,嚴格大於才算超過;相等不算,缺測記未知。閾值取完整精度,表格只保留兩位小數。[2]
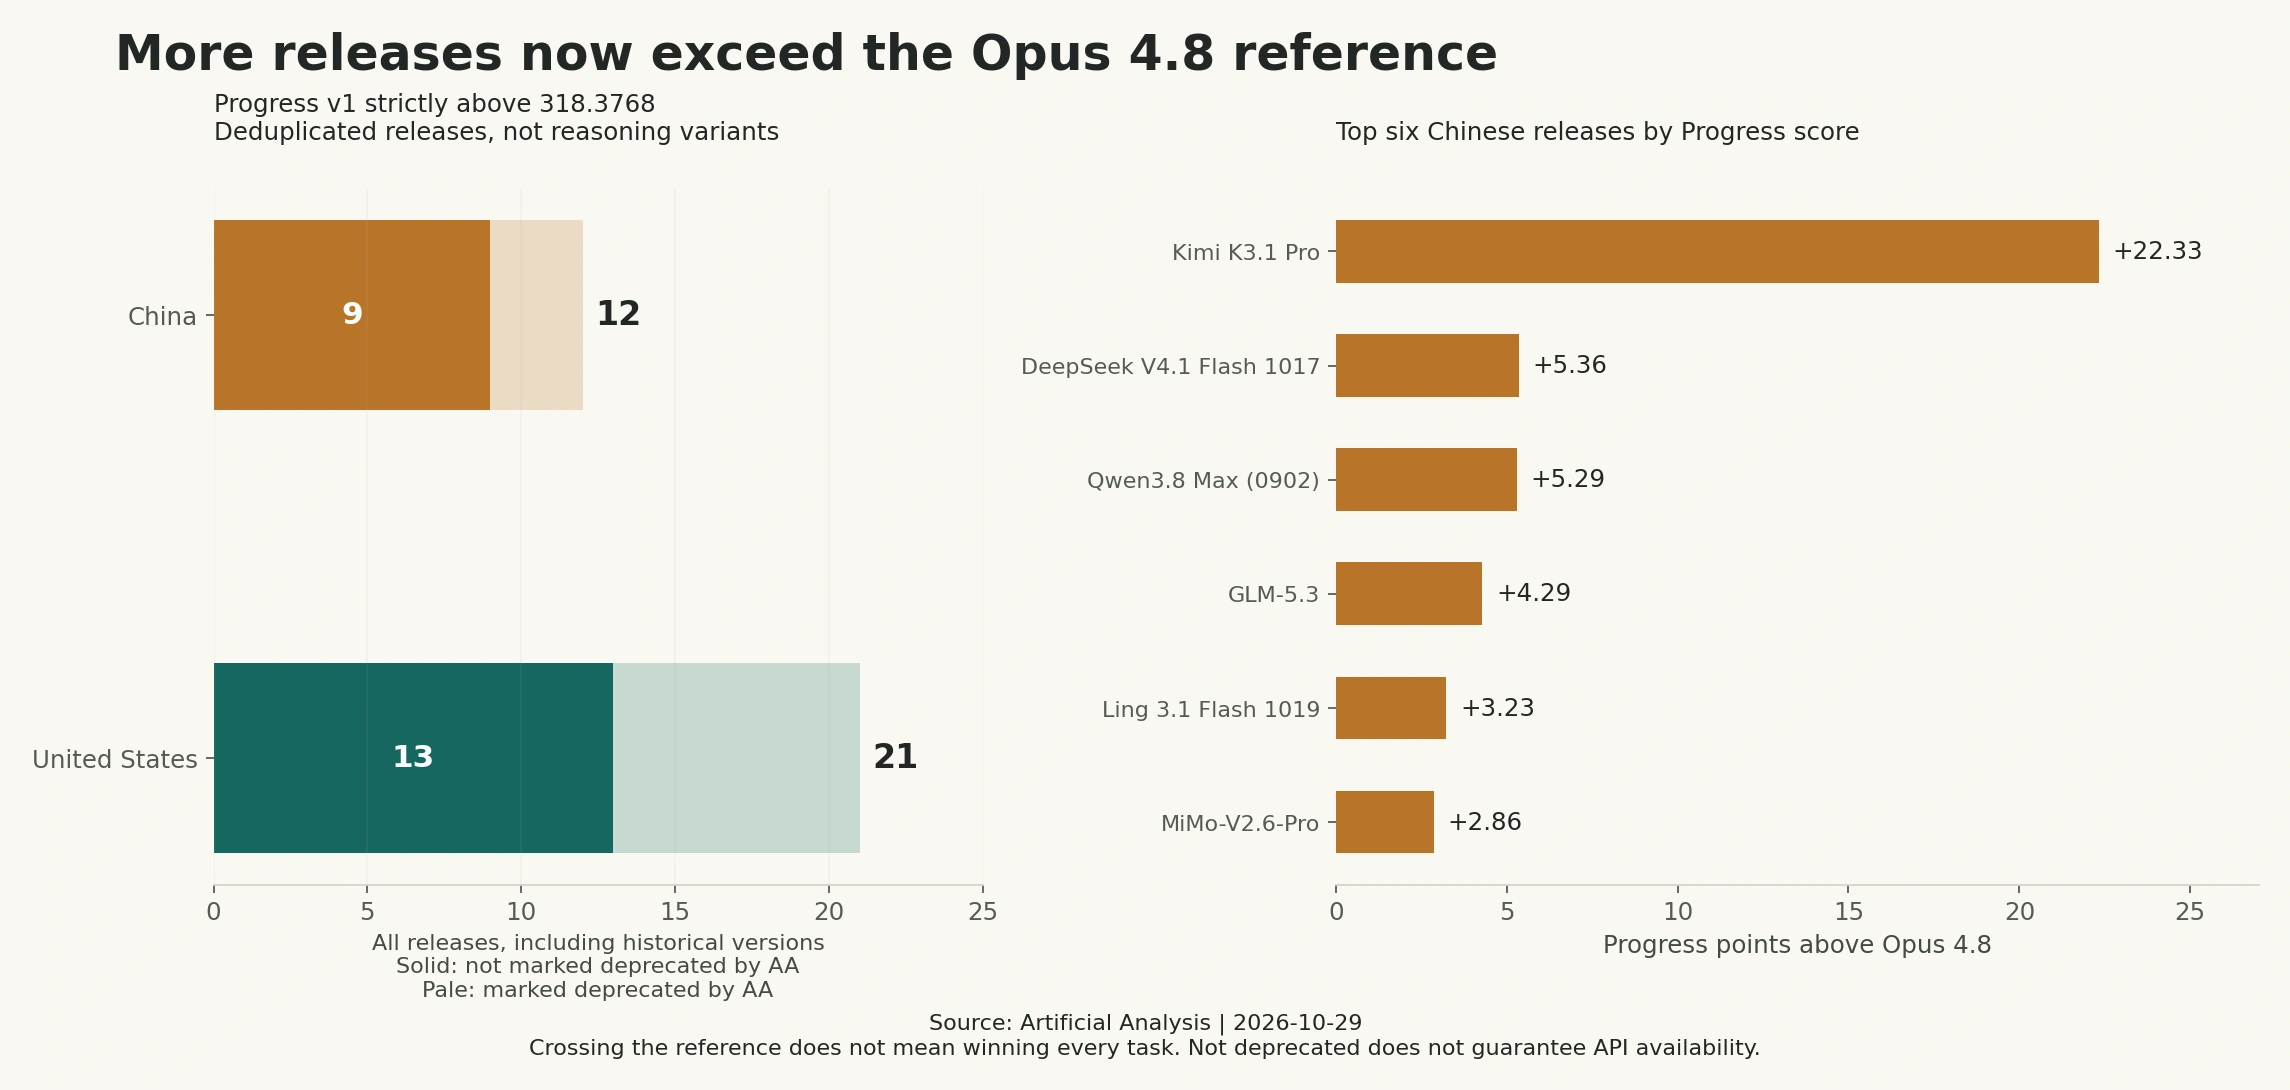
在 517 個發布版本中,全球共 33 個超過此門檻,全部落在本次中美兩組內。其中中國 12 個、美國 21 個。僅看 AA 沒有標記 deprecated 的版本,分別為 9 個和 13 個。AA 標記是頁面狀態,不證明官方已經關停,也不保證目前任何閘道都可呼叫。
中國跨過門檻的完整名單#
| 中國模型發布版本 | 最高 Progress 分數 | AA 已標記 deprecated |
|---|---|---|
| Kimi K3.1 Pro | 340.70 | 否 |
| DeepSeek V4.1 Flash 1017 | 323.74 | 否 |
| Qwen3.8 Max (0902) | 323.67 | 否 |
| GLM-5.3 | 322.66 | 否 |
| Ling 3.1 Flash 1019 | 321.61 | 否 |
| MiMo-V2.6-Pro | 321.24 | 否 |
| DeepSeek V4.1 Flash | 320.25 | 是 |
| Qwen3.8-Flash-Next | 320.23 | 否 |
| Ling 3.1 Flash | 320.01 | 否 |
| Kimi K3 | 319.88 | 是 |
| Qwen3.8 Max | 319.63 | 是 |
| GLM-5.3-Flash | 318.64 | 否 |
美國跨過門檻的完整名單#
| 美國模型發布版本 | 最高 Progress 分數 | AA 已標記 deprecated |
|---|---|---|
| Gemini 4 Carbon | 351.65 | 否 |
| Claude Opus 5.5 | 351.27 | 否 |
| Claude Sonnet 5.5 | 350.50 | 否 |
| GPT-6 Astra | 349.57 | 否 |
| GPT-6.1 Sol | 348.47 | 否 |
| GPT-6.1 Terra | 345.25 | 否 |
| Muse Wonder Full | 343.22 | 否 |
| Gemini 4 Argon | 341.79 | 否 |
| Claude Fable 5.1 | 340.85 | 否 |
| Muse Wonder | 335.78 | 否 |
| GPT-6 Sol | 334.04 | 是 |
| Claude Opus 5 | 333.73 | 是 |
| GPT-5.6 Sol | 331.46 | 是 |
| Claude Fable 5 | 329.33 | 是 |
| Claude Haiku 5.5 | 326.13 | 否 |
| Muse Spark 1.3 | 324.46 | 是 |
| GPT-5.6 Terra | 323.87 | 是 |
| Grok 4.7 | 322.68 | 否 |
| Grok 4.6 | 321.54 | 是 |
| Gemini 3.8 Flash | 320.30 | 否 |
| GPT-5.5 | 320.00 | 是 |
不能把微弱超出都叫「明顯領先」。例如,GLM-5.3-Flash 高於基準約 0.27 分;本次公開資料未提供足以支持此比較的信賴區間。所以下表只做閾值敏感性分析,這些加分檔不是統計顯著性標準:
| 門檻(Progress v1) | 中國版本數 | 美國版本數 |
|---|---|---|
| 嚴格高於 Opus 4.8 + 0 分 | 12 | 21 |
| 嚴格高於 Opus 4.8 + 1 分 | 11 | 21 |
| 嚴格高於 Opus 4.8 + 3 分 | 5 | 19 |
| 嚴格高於 Opus 4.8 + 5 分 | 3 | 17 |
| 嚴格高於 Opus 4.8 + 10 分 | 1 | 14 |
這個角度能同時解釋兩種感受:達到舊旗艦水準的選擇確實增加了;遠高於舊旗艦的領先選擇仍集中在美國組。 中國 12 個跨線版本中,只有 3 個高出 5 分以上;美國則有 17 個。以上都含歷史版本,不能解讀為目前 API 庫存。
跨過這個能力門檻,相差多少天?#
在目前 Progress v1 回溯中,美國最早越線的版本是 2026 年 4 月 23 日發布的 GPT-5.5,中國是 2026 年 7 月 16 日發布的 Kimi K3,兩次越線日期相差 84 天。若從 Opus 4.8 自身發布日 5 月 28 日起算,到 Kimi K3 是 49 天。[2]
GPT-5.5 比 Opus 4.8 更早跨過這條回溯閾值並不矛盾:Progress 與當時 Intelligence 榜單的目標、擬合和排序不同。84 天只是這一條指定閾值的首次跨越日期差,不是「中國所有模型整體落後三個月」的證據。
實際體感差距,真的有分數看起來那麼大嗎?#
本次實驗能回答的是「在這套請求條件下,哪些任務順利交付」,不能替代人的總體滿意度評價。我們從Anthropic 系列(英文)和OpenAI 系列(英文)選取目前代表模型,並保留 Opus 4.8 基準;中國組涵蓋Kimi 系列(英文)、Qwen 系列(英文)、DeepSeek 系列(英文)與GLM 系列(英文)。這是有目的選樣,不用於估計國家平均勝率。
測試在 2026 年 10 月 29 日進行,統一走 https://cn.crazyrouter.com 的 /v1/chat/completions 端點,請求設定為 reasoning_effort="high"、max_tokens=8192、非串流,不呼叫工具,每次讀取逾時 180 秒,隨機順序,最多 4 並行。相同 high 標籤不代表相同內部算力,也不等同 AA 各模型的最高檔評測。
| 任務組 | 具體任務 | 判分依據 |
|---|---|---|
| 日常任務,5 種 | 訂單提取去重、衝突記錄、中文格式約束、240 條庫存定位、退款規則邊界 | 固定真值、欄位類型、文本格式 |
| 推理壓力,3 種 | 環形約束計數、帶依賴排程、組合選擇最佳化 | 本地窮舉的唯一最佳答案/指定並列規則 |
嚴格通過要求 HTTP 成功、正常結束、最終答案及格式全部符合要求。我們保留預先約定的這一主指標;另外做事後敏感性檢查,僅去掉一個外層 Markdown 程式碼圍欄,不修答案、不重試。後者更接近「內容是否可讀懂」,前者更接近「程式能否直接接入」。
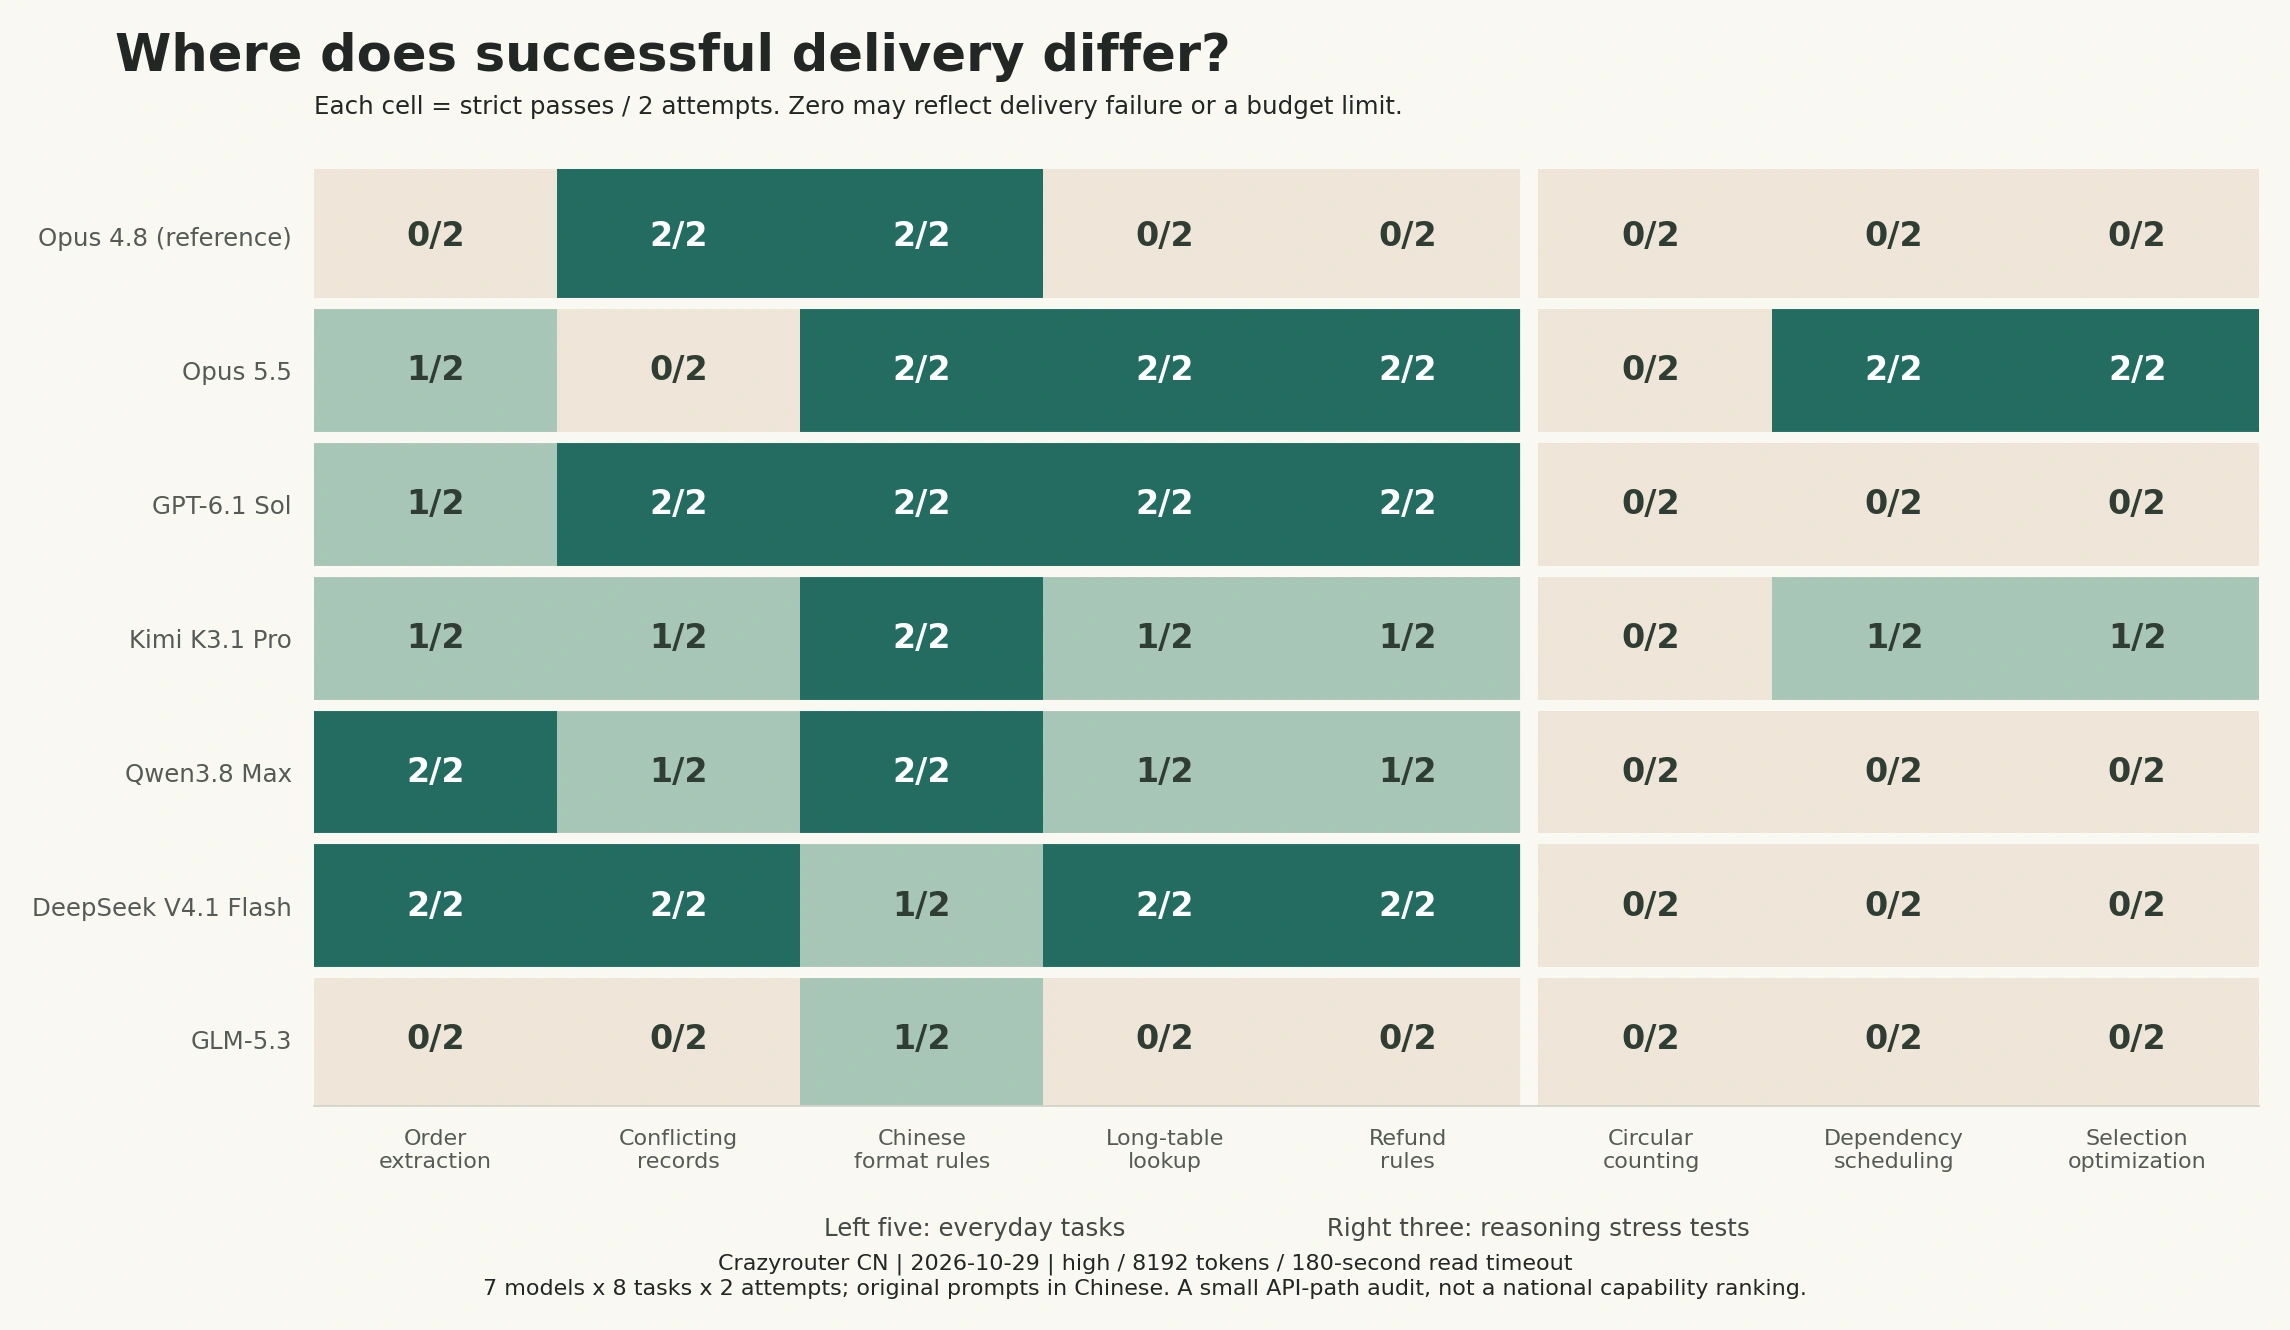
| 請求模型 | 日常嚴格通過/10 | 壓力嚴格通過/6 | 全部嚴格/16 | 去單層圍欄後/16 |
|---|---|---|---|---|
| claude-opus-4-8 | 4/10 | 0/6 | 4/16 | 13/16 |
| claude-opus-5-5 | 7/10 | 4/6 | 11/16 | 16/16 |
| gpt-6.1-sol | 9/10 | 0/6 | 9/16 | 9/16 |
| kimi-k3.1-pro | 6/10 | 2/6 | 8/16 | 8/16 |
| qwen3.8-max | 7/10 | 0/6 | 7/16 | 7/16 |
| deepseek-v4.1-flash | 9/10 | 0/6 | 9/16 | 9/16 |
| glm-5.3 | 1/10 | 0/6 | 1/16 | 1/16 |
差距體現在哪裡?#
以本輪 DeepSeek V4.1 Flash 與 Opus 5.5 為例:日常任務嚴格交付分別為 9/10 與 7/10,壓力任務為 0/6 與 4/6。這是固定預算下的交付差別,不能將未完成全部解釋成「模型不會做」;特別是壓力任務可能耗盡輸出預算或在等待上限前未完成。
另一個真實例子來自 Opus 4.8:它在訂單提取中回傳了正確欄位和值,卻包裹了 Markdown 程式碼圍欄,導致嚴格 JSON 檢查未通過。若你在聊天視窗閱讀,可能並不覺得這是錯誤;若結果直接進入程式,就需要增加清理步驟。同一份輸出,在兩種使用方式下會產生不同的體感。
只移除單層程式碼圍欄後,結果變為:
| 請求模型 | 日常:只去圍欄後/10 | 壓力:只去圍欄後/6 |
|---|---|---|
| claude-opus-4-8 | 10/10 | 3/6 |
| claude-opus-5-5 | 10/10 | 6/6 |
| gpt-6.1-sol | 9/10 | 0/6 |
| kimi-k3.1-pro | 6/10 | 2/6 |
| qwen3.8-max | 7/10 | 0/6 |
| deepseek-v4.1-flash | 9/10 | 0/6 |
| glm-5.3 | 1/10 | 0/6 |
Opus 4.8 與 Opus 5.5 的日常題均為 10/10,但壓力題分別為 3/6 與 6/6。這提供了一個具體例子:更高能力的優勢可能主要在更難的任務上出現。這裡只有 5 種日常任務和 3 種壓力任務,同題兩次呼叫不算兩道獨立題,不能據此證明日常能力已經等效。
閘道和版本映射也會改變體驗#
本次 112 次請求中,HTTP 錯誤 15 次、讀取逾時 17 次、預算截斷 7 次。這些呼叫都保留在固定預算交付率的分母裡,並在下表獨立列出。
| 請求模型 | HTTP 錯誤 | 180 秒讀取逾時 | 預算截斷 | 正常結束的回應數 |
|---|---|---|---|---|
| claude-opus-4-8 | 1 | 0 | 2 | 13 |
| claude-opus-5-5 | 0 | 0 | 0 | 16 |
| gpt-6.1-sol | 5 | 0 | 0 | 11 |
| kimi-k3.1-pro | 6 | 2 | 0 | 8 |
| qwen3.8-max | 1 | 8 | 0 | 7 |
| deepseek-v4.1-flash | 0 | 2 | 5 | 9 |
| glm-5.3 | 2 | 5 | 0 | 9 |
例如,Kimi K3.1 Pro 的一次請求回傳 provider_authentication_failed。這說明該次請求未被上游正確鑑權,不能作為模型答錯的證據。讀取逾時同樣只表示用戶端沒有及時拿到完整回應,不能定位為模型計算慢。
| 請求名稱 | 實測回應中出現的 model 欄位 |
|---|---|
| claude-opus-4-8 | claude-opus-4-8 |
| claude-opus-5-5 | claude-opus-5-5 |
| gpt-6.1-sol | gpt-6.1-sol |
| kimi-k3.1-pro | kimi-k3.1-pro |
| qwen3.8-max | qwen3.8-max |
| deepseek-v4.1-flash | deepseek-v4.1-flash、deepseek-v4.1-flash-1017、deepseek/deepseek-flash |
| glm-5.3 | glm-5.3 |
回應 model 欄位只是伺服端聲明,不是權重身分的獨立證明。尤其 DeepSeek 的同一請求名回傳過不同版本/別名,本輪無法保證所有請求精確對應 AA 的同一個發布版本。因此,這些結果應稱為「本次 API 路徑的交付稽核」,不能與 AA 分數硬配對計算相關係數,更不能由它宣布某國模型整體更強或等效。
GLM-5.3 路徑還出現 JSON 後附加額外文本、重複答案和異常標記的回應。本文保留原始證據,但不能判斷異常來自模型、範本還是上游適配。它的低嚴格交付數尤其不適合作為基礎模型能力結論;本輪沒有為獲得更好成績而修改通道或重跑替換失敗。
我們沒有完成真人盲評、生產使用者任務抽樣、長週期負載測試或同預算的多輪 Agent 評測。所以,對「總體體感是否一樣好」,本次證據仍然不足。已經能確認的是:題目類型、輸出格式、請求預算和服務鏈路,會使實際體驗與單一榜單順序不同。
誰更新更快?發布數量與能力突破分開看#
以下統計的是 AA 涵蓋樣本中的獨立發布版本,不是兩國所有模型的完整發布普查。一個版本的多個推理檔位只算一次。刷新前沿按發生提升的日期計數,同日多個版本不重複算多次。
| 2026 年月度 | 中國發布版本 | 美國發布版本 | 中國刷新前沿日期數 | 美國刷新前沿日期數 |
|---|---|---|---|---|
| 2026-01 | 5 | 4 | 1 | 0 |
| 2026-02 | 9 | 7 | 1 | 1 |
| 2026-03 | 12 | 9 | 0 | 1 |
| 2026-04 | 16 | 15 | 3 | 2 |
| 2026-05 | 6 | 4 | 0 | 0 |
| 2026-06 | 6 | 7 | 1 | 1 |
| 2026-07 | 5 | 10 | 2 | 2 |
| 2026-08 | 11 | 10 | 1 | 0 |
| 2026-09 | 8 | 13 | 1 | 3 |
| 2026-10(截至 29 日) | 5 | 10 | 2 | 1 |
2026 年 1 月 1 日至 10 月 29 日,樣本中中國發布 83 個版本,美國 89 個。最近 90 個日曆日(8 月 1 日至 10 月 29 日,首尾均計入),分別為 24 個與 33 個,但兩組各只有 4 個日期刷新自己的 Progress 前沿。發布得更多,不自動意味著最高能力提升得更多。[2]
截至本次快照,中國最近一次刷新前沿是 10 月 23 日的 Kimi K3.1 Pro,美國是 10 月 28 日的 Gemini 4 Carbon。資料採集於 10 月 29 日,不能把採集日稱作模型更新日。AA API 沒有提供每個模型完整的歷史評分變更日誌;我們也不臆造該欄位。
如何複算,以及下一輪如何驗證「體感」#
本次在編輯部研究歸檔中保留了 AA 四頁 API 回應、公開趨勢圖表資料、歸併後的 517 行 CSV、統計腳本、任務真值、全部 112 次呼叫及摘要。正式部落格裡的統計只來自這些凍結記錄。來源為 Artificial Analysis;聚合計算和 Crazyrouter 路徑實測由本文完成。
核心計算可以用以下虛擬碼理解:
# One snapshot and metric version.
# Use AA release_id, not guessed names.
release_score = max(non_null_scores_for_each_release)
baseline = progress_score_of_opus_4_8_max
above_baseline = release_score > baseline
frontier_at_date = max(scores_of_releases_available_by_date)
gap_at_date = us_frontier_at_date - cn_frontier_at_date
例如,訂單提取任務的 Opus 4.8 回應 ID 為 msg_011CgWecKv2YBwoHYumCeURh,HTTP 200 且正常結束;原答案是正確 JSON 外包程式碼圍欄,嚴格判失敗、格式敏感性檢查判通過。Kimi 鑑權失敗的請求 ID 為 608ccc90b353423d036dca779cafcc37。這兩個記錄分別說明「拿到結果但格式不符」和「未得到模型答案」的區別。
以下範例重放一項業務規則任務,API Key 只從環境變數讀取,端點不帶 UTM:
import os
import requests

endpoint = "https://cn.crazyrouter.com" + "/v1/chat/completions"
user_content = (
    "\u672a\u62c6\u5c01\u4e14\u7b7e\u6536" "\u6b21\u65e5\u8d777\u65e5\u5185" "\u53ef\u9000\u6b3e\uff1b\u7b2c7" "\u65e5\u5305\u542b\u5728\u5185\u3002"
    "A\u57282026" "-10-20" "\u7b7e\u6536\uff0c202" "6-10-2" "7\u7533\u8bf7\u9000\u6b3e\uff0c"
    "\u65e0\u8d28\u91cf\u7f3a\u9677\u3002" "\u53ea\u8f93\u51faJSO" "N\uff0c\u952eeli" "gible\u4e3a" "\u5e03\u5c14\u503c\u3002"
)

response = requests.post(
    endpoint,
    headers={"Authorization": "Bearer " + os.environ["CRAZYROUTER_API_KEY"]},
    json={
        "model": "claude-opus-4-8",
        "messages": [{"role": "user", "content": user_content}],
        "reasoning_effort": "high", "max_tokens": 8192, "stream": False,
    },
    timeout=(15, 180),
)
response.raise_for_status()
print(response.json())
這是正文的簡化複現範例,不是 112 次正式測試中的完整原題。完整 8 道題、判分腳本與原始記錄由編輯部歸檔;本文未提供完整原始研究包的公開下載。沒有用此簡化題追加或替代正式成績。
這裡的 available_by_date 僅指發布日期不晚於該天,不保證當日有公開 API。缺分不填零,不把一分當作固定百分比。兩國國別沿用 AA 研發機構標籤,Google 歸入其標記的美國組,不以伺服器位置或員工國籍劃分。[1][3]
下一輪如果要真正檢驗「體感等效」,建議先固定三類目標使用者任務與可接受差異,再進行匿名、隨機左右順序的配對盲評。主指標應包含任務完成品質、重大錯誤、人工返工和偏好;呼叫失敗率單列。等效界限與樣本量在看結果前確定,按任務聚類分析。不能用「沒有檢驗出顯著差異」當作「體驗相同」。
接下來,這個系列準備研究什麼?#
本篇先回答「分數差距、舊旗艦門檻與實際交付有什麼不同」。後續將按能力類型分篇,分別使用適合該任務的基準、固定預算和真實 API 測試,不把不同模態的分數拼成一個「國家總分」。以下為選題規劃,後續專題尚未發布。
| 篇章 | 擬定主題 | 重點回答的問題 |
|---|---|---|
| 第一篇 · 文本模型 | 跨過旗艦門檻之後,日常任務還差多少? | 中文寫作、結構化輸出、長文件、事實性與人類盲評的差距 |
| 第二篇 · 程式設計與 Agent | 會回答,是否也能把事情做完? | 程式碼修改、測試通過、工具呼叫、多步驟任務、預算內完成率 |
| 第三篇 · 圖像模型 | 好看之外,誰更能按要求出圖? | 文生圖、圖像編輯、中文文字、主體一致性與多次生成穩定性 |
| 第四篇 · 影片模型 | 單幀驚豔之後,動作和敘事能否成立? | 文生影片、圖生影片、運動與物理一致性、角色連續性、成片等待 |
| 第五篇 · 語音模型 | 聽得準、說得自然、對話跟得上嗎? | 語音辨識、語音合成、即時語音分別測量,兼顧口音與延遲 |
| 第六篇 · 向量與重排 | 知識庫效果的差距,究竟在哪裡? | 中文與跨語言檢索、長文件、Recall@k、nDCG、重排增益和索引成本 |
| 第七篇 · 綜合選型 | 同樣預算下,怎樣組合不同模型? | 把前述實測彙整為具體情境的品質、等待、成本與可靠性選擇 |
每篇都會保留「誰在前沿、誰跨過實用門檻、差距是否影響真實任務」三個問題,但門檻由該模態的參考模型或業務驗收條件定義。例如,Opus 4.8 可以作為本篇的文本參考,不能成為圖像、語音或向量模型的通用門檻。
常見問題#
中美 AI 模型真實差距到底有多遠?#
本次快照中,美國在 AA Intelligence v5 前沿領先 13.4 分;同一 Progress v1 標尺上的前沿差距為 10.94 分。二者測量目標不同,都不能直接換算成能力百分比或使用者滿意度差。
差距是否越來越大?#
目前回溯資料不支持「持續擴大」。2026 年 9 月底分差 27.61,10 月 29 日為 10.94,中間隨新模型發布明顯收窄。但前沿追近不等於領先梯隊已經一樣厚。
多少中國模型已經超過 Opus 4.8?#
按 Progress v1、獨立發布版本、嚴格高於 Opus 4.8(max) 計數,是 12 個,包含歷史版本。其中 9 個尚未被 AA 標記 deprecated。超過評測參考門檻不保證在你的每種任務上都勝過它。
為什麼不用 Opus 4.8 的 61.4 分?#
61.4 來自它發布時的舊 Intelligence Index;本輪 v5 中該模型沒有總分。必須使用同一標尺比較,不能把歷史分值直接套到新榜單。
中國模型是不是已經足夠日常使用?#
不能僅憑國別給出統一答案。本輪部分模型能完成日常任務,但閘道錯誤、格式差異與預算截斷也改變結果。應從自己的任務與可接受失敗率出發,選擇具體模型及可靠呼叫路徑。
這次測試能證明中美模型體感相同嗎?#
不能。這裡只做了 8 種合成任務、每題 2 次,且部分請求出現版本別名和鏈路問題,沒有人類盲評。它展示了榜單與體驗可能分離的具體原因,沒有證明總體等效。
發布版本、模型配置與 API 名稱有什麼區別?#
AA 的一個發布版本可能有多個推理檔位;閘道又可能使用別名或滾動更新到新版本。榜單計數按發布版本去重,實測則保留實際請求名與回傳 model 欄位,兩者不自動一一對應。
參考資料#
- Artificial Analysis Data API:欄位、分頁、版本與缺值定義。本次完整採集 2026-10-29,API 報告 Intelligence 版本 5。
- Artificial Analysis AI Trends:Progress、國家歸屬與發布版本。本次 2026-10-29 匿名公開頁面快照;文中統計為作者對該快照的再計算。
- Artificial Analysis Progress Index v1 方法。IRT 標尺、檔位與歷史比較的邊界。
- AA Intelligence Index v5 發布公告,2026-10-27。用於解釋評測變化,不作為 10 月 29 日最新榜單替代品。
- AA Intelligence Index 方法與版本說明。
- AA Opus 4.8 發布評測,2026-05-28與目前模型頁。
- Anthropic Opus 4.8 官方發布頁。
本文的「超過」「領先」均限定於明確標尺和已涵蓋樣本,不代表統計顯著性。AA 資料後續補測、修訂或新增模型後,結果需要重新計算。