简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
中国と米国のAIモデル、実際の差はどれほどあるのか?|プロローグ
中国・米国のAIモデル比較シリーズの序章。2026年10月29日のデータと112回のAPI監査から、最前線の差、Opus 4.8の基準、実際の利用体験を検証する。
本稿は同一研究の日本語版で、データの基準日は2026-10-29です。112回のテストはすべて元の中国語プロンプトで実施しており、新たな多言語評価は行っていません。図のラベルは英語です。コード例では元の中国語プロンプトをUnicodeエスケープで保持し、実行時に復元します。
中国・米国AIモデル比較シリーズ・プロローグ。まずテキストモデルで比較手法を確立し、その後、画像、動画、音声、ベクトル検索、リランキングをそれぞれ検討します。本稿は手法と問いの出発点であり、テキストモデルのスコアが他のモダリティの実力を表すわけではありません。
米国モデルは現在の最前線ランキングと上位陣の層の厚さでリードしていますが、「中国と米国のモデルの差が拡大し続けている」という見方は、今回の同一基準による遡及結果には合致しません。Opus 4.8を個人的な満足度の参考基準とした場合、AAがカバーするサンプルでは、中国の12リリース、米国の21リリースがそれを上回るProgress Indexスコアを示しています。ただし、これはあらゆるタスクで使いやすいことを意味しません。
データの基準日は2026年10月29日です。本稿では、混同されやすい3つの問いを切り分けます。最強モデル同士の差はどれほどか、旧フラッグシップの基準を超える選択肢はどれほどあるか、そして実際のリクエストではどの差を感じられるか、です。最初の2つにはArtificial Analysis(AA)のデータを使い、3つ目はCrazyrouter経由で7モデル、8種類のタスク、各題2回、合計112回の呼び出し監査を行います。[1][2]
これはモデルサンプルの研究です。両国のAI産業全体を評価するものではなく、人間による主観的なブラインド評価も行っていません。「使える」かどうかは、最終的には各ユーザーのタスク、待ち時間、許容できる誤りの条件によって決まります。
まず結果を見る:最前線でのリードと広く使えることは別問題#
| 指標 / 基準 | 中国 | 米国 |
|---|---|---|
| 現在の最高スコア・Intelligence v5 | 46.0・Kimi K3.1 Pro | 59.4・Gemini 4 Carbon |
| 上位5モデルの平均・Intelligence v5 | 34.74 | 56.68 |
| 世界上位10に入るリリース数・Intelligence v5 | 1 | 9 |
| 現在の最高スコア・Progress v1 | 340.70 | 351.65 |
| Opus 4.8超え・Progress v1、過去のリリースを含む | 12 | 21 |
| うちAAがdeprecatedとマークしていないリリース | 9 | 13 |
2種類の指数の数値を引いたり、同じ順位表に混ぜたりすることはできません。現在のv5における最前線の差は13.4ポイント、Progress v1における現在の最前線の差は10.94ポイントです。前者は現在の評価セットでの性能を測り、後者は時期をまたぐ能力の変化を分析するためのものです。
集計では、AAの716件の推論構成を517リリースに統合しました。内訳は中国176、米国257で、残りはその他の国または未分類です。release.idで統合し、同一リリースのhigh、max、xhighを複数モデルとして重複計上していません。各指標について、そのリリースで最も高いスコアの構成を個別に採用しているため、最高スコアの構成は指標ごとに異なる場合があります。
新しいv5ランキングでは、現時点で利用可能な総合スコアがあるのは39リリースだけです。内訳は中国12、米国24、その他の国3です。ここでの上位10と平均は、測定済みサンプルの統計であり、未測定を0点とするものではありません。順位はAPIが返した元の精度に基づき、同点は同順位とし、後続の順位は飛ばします。[1]
現在の上位20:上位を占めるのは誰か?#
| 世界順位(リリース単位で重複排除) | リリース | 所属 | v5スコア | リリース日 |
|---|---|---|---|---|
| 1 | Gemini 4 Carbon | 米国 | 59.4 | 2026-10-28 |
| 2 | Claude Opus 5.5 | 米国 | 58.4 | 2026-09-22 |
| 3 | GPT-6 Astra | 米国 | 56.9 | 2026-09-03 |
| 4 | GPT-6.1 Sol | 米国 | 54.5 | 2026-09-29 |
| 5 | Claude Sonnet 5.5 | 米国 | 54.2 | 2026-09-28 |
| 6 | GPT-6.1 Terra | 米国 | 51.0 | 2026-10-26 |
| 7 | Gemini 4 Argon | 米国 | 50.4 | 2026-09-30 |
| 8 | Muse Wonder Full | 米国 | 49.7 | 2026-10-12 |
| 8 | Claude Fable 5.1 | 米国 | 49.7 | 2026-09-01 |
| 10 | Kimi K3.1 Pro | 中国 | 46.0 | 2026-10-23 |
| 11 | Muse Wonder | 米国 | 43.3 | 2026-10-12 |
| 12 | Muse Spark 1.3 | 米国 | 36.4 | 2026-09-02 |
| 13 | Claude Haiku 5.5 | 米国 | 36.2 | 2026-10-07 |
| 14 | Grok 4.7 | 米国 | 35.0 | 2026-09-21 |
| 15 | Qwen3.8 Max (0902) | 中国 | 33.6 | 2026-09-02 |
| 16 | DeepSeek V4.1 Flash 1017 | 中国 | 32.5 | 2026-10-17 |
| 17 | GLM-5.3 | 中国 | 31.7 | 2026-08-18 |
| 18 | Gemini 3.8 Flash | 米国 | 30.5 | 2026-09-02 |
| 19 | MiMo-V2.6-Pro | 中国 | 29.9 | 2026-09-21 |
| 20 | Ling 3.1 Flash 1019 | 中国 | 29.5 | 2026-10-22 |
この上位20では中国が6、米国が14を占め、上位10ではそれぞれ1と9です。上位5の平均34.74と56.68も合わせると、単一の最前線モデルが近づくことと、上位グループの層の厚さには依然として違いがあることが分かります。総合スコアが未測定のリリースは順位付けの対象外です。[1]
スコアの差は広がり続けているのか?#
継続的に拡大しているのではなく、フラッグシップのリリース节奏の影響を強く受けています。 同じ取得データのProgress Index v1を使い、各リリースの公開日から両国の最前線を再構築しました。ある日までに公開されたリリースの最高スコアを、その日の遡及的な最前線としています。
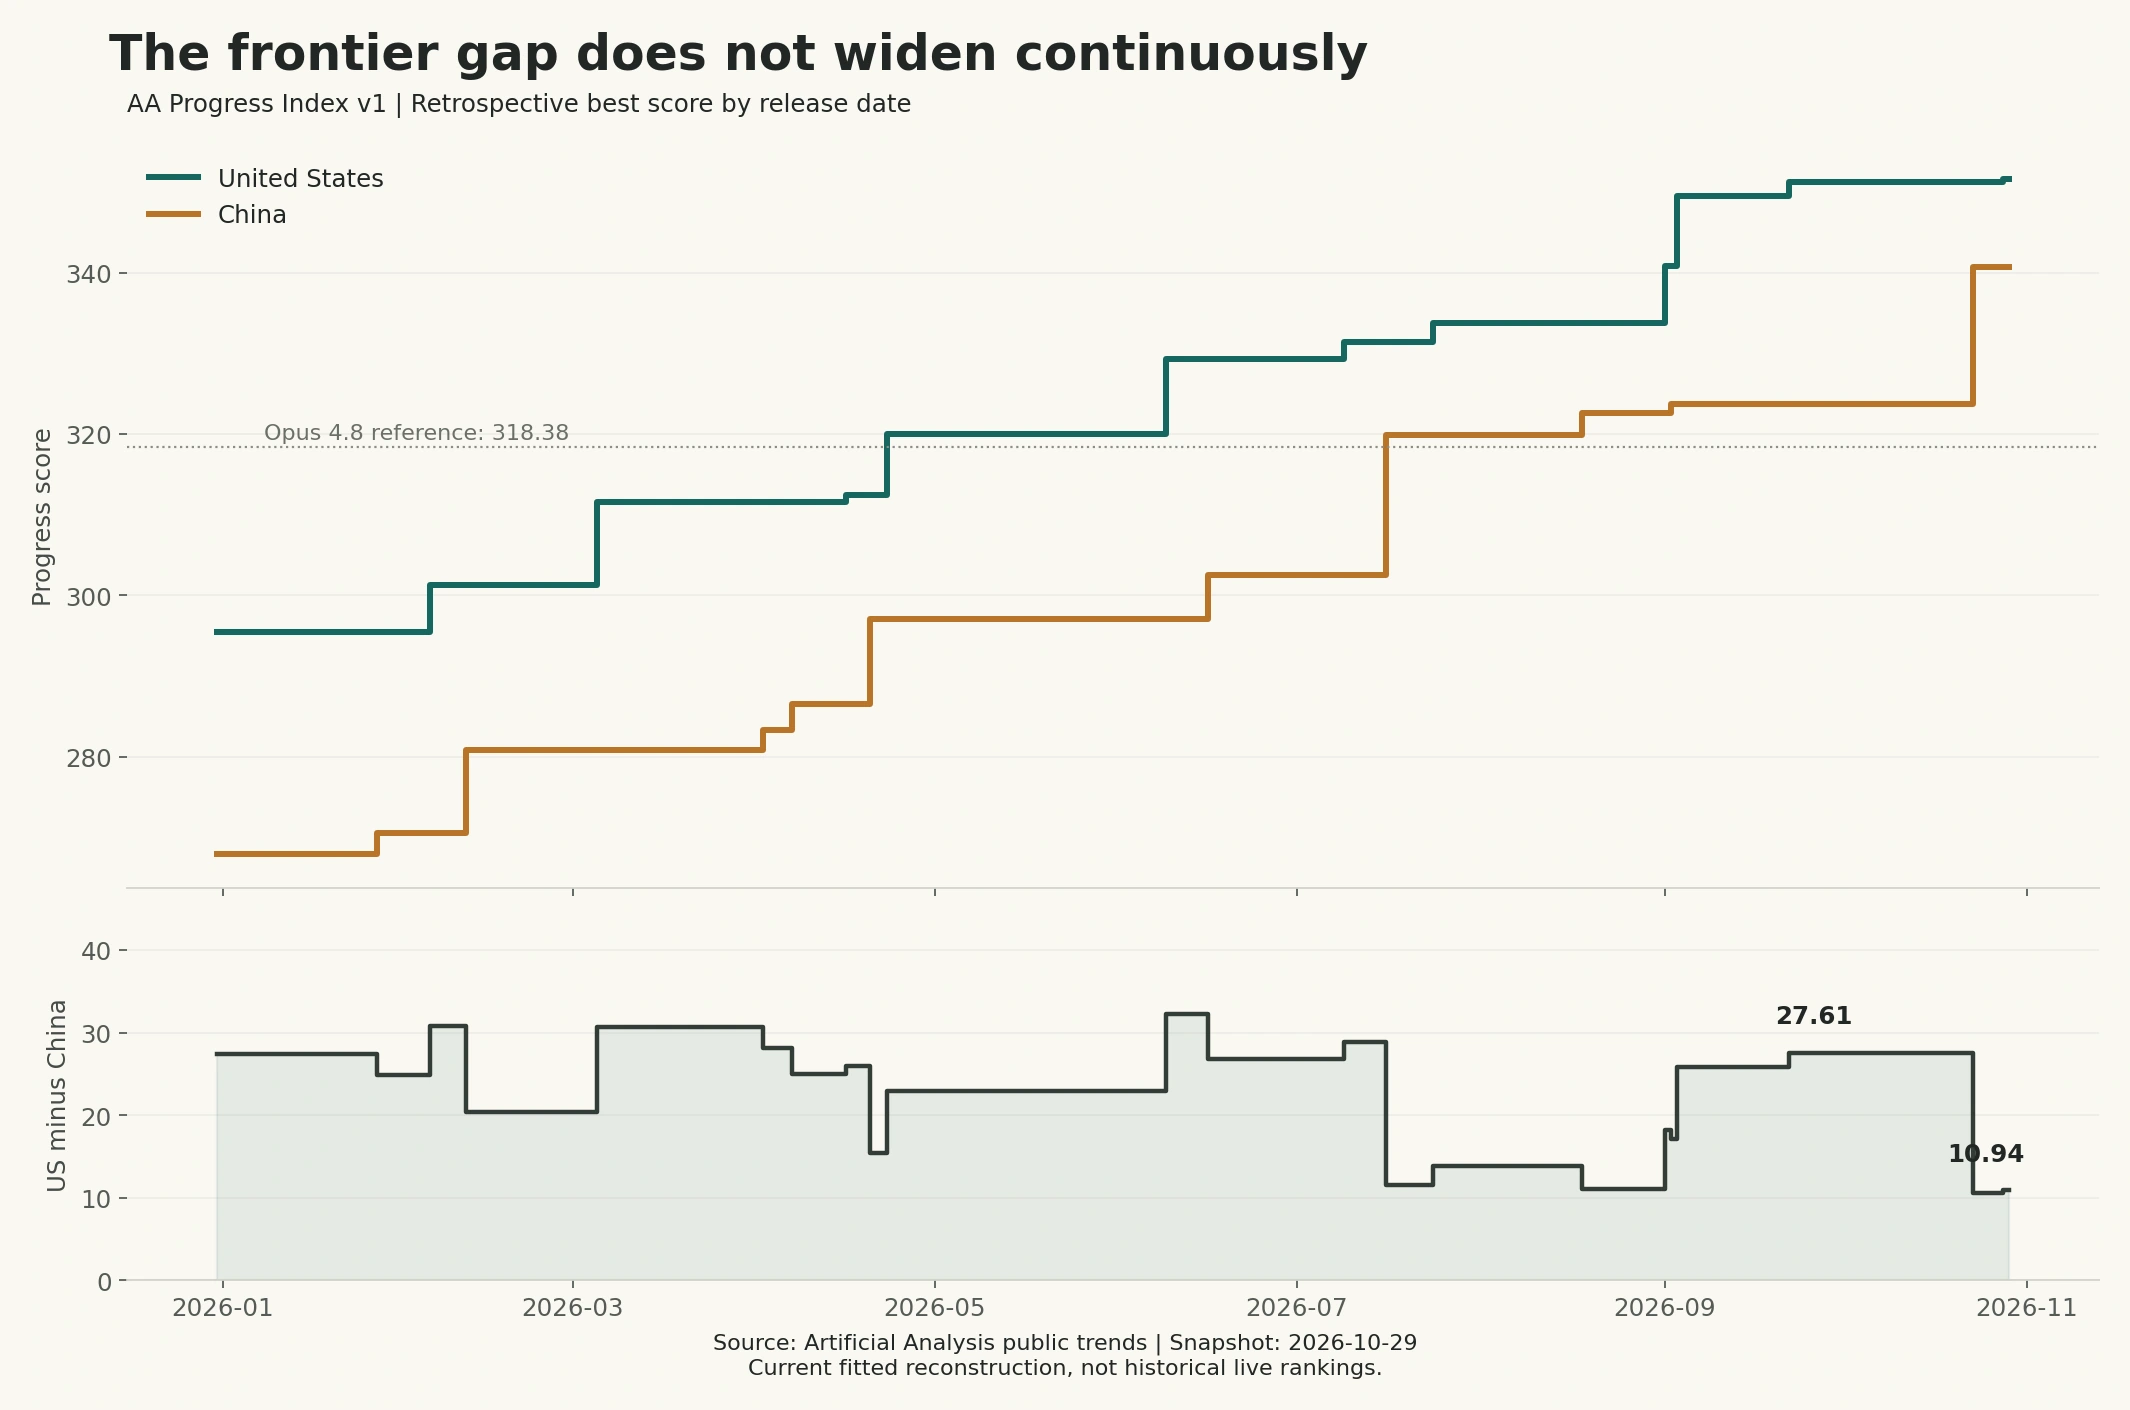
| 遡及日 | 中国の最前線 | 米国の最前線 | 差:米国−中国 |
|---|---|---|---|
| 2025-12-31 | 267.96 | 295.46 | 27.49 |
| 2026-03-31 | 280.87 | 311.55 | 30.69 |
| 2026-06-30 | 302.52 | 329.33 | 26.80 |
| 2026-07-31 | 319.88 | 333.73 | 13.85 |
| 2026-08-31 | 322.66 | 333.73 | 11.07 |
| 2026-09-30 | 323.67 | 351.27 | 27.61 |
| 2026-10-23 | 340.70 | 351.27 | 10.57 |
| 2026-10-29 | 340.70 | 351.65 | 10.94 |
2026年8月末の差は11.07でした。9月に米国の新フラッグシップが集中して登場し、月末には27.61へ拡大。10月23日のKimi K3.1 Pro公開で10.57まで縮小し、10月28日のGemini 4 Carbon公開後、10月29日のスナップショットでは10.94となりました。[2]
このため、「どの期間を見るか」も結論の一部になります。現在の差は30日前より約16.66ポイント、90日前より約2.91ポイント、180日前より約12.00ポイント縮小しています。同時に、米国は依然として両国の最前線比較でリードしています。差の縮小と米国のリードは、同時に成り立ちます。
ただし、この図を「過去の毎日のリアルタイムランキング」と呼ぶことはできません。Progress Indexは、現在取得できている評価に基づく統計的フィッティングであり、将来の追加測定や再フィッティングによって遡及スコアが変わる可能性があります。また、過去のAPI公開状態も完全には復元していません。この図が答えるのは「現在の同じ物差しで、過去に公開されたモデルを見るとどうか」であり、「当時、ユーザーが実際に何を呼び出せたか」ではありません。[3]
なぜ差が急に広がったように見える人がいるのか?#
AAは2026年10月27日にIntelligence Indexをv5へ更新し、ソフトウェア工学、科学研究、知識推論の評価を追加または高度化しました。その発表では、オープンウェイトカテゴリーの先頭とリードモデルの差が、v4.3の3ポイントからv5の12ポイントになったと述べています。[4]
ここでは測定する物差しが変わったうえに、「オープンウェイトとリードモデル」というグループ分けを使っています。したがって、これを「2日間で中米の能力差が3ポイントから12ポイントへ拡大した」と言い換えることはできません。さらに、この発表ではウェイトが未公開のKimi K3.1 Proも関連する説明に含めており、このグループを、その日時点ですでにダウンロード可能なモデルの集合と同一視することもできません。
v5では、知識労働、プログラミング、科学、汎用の4分類にそれぞれ25%の重みを付けています。単なるチャットよりも、難しいタスクや複数ステップの実行を重視する構成です。そのため、ランキング上の差が大きくても、一部の日常タスクでは差が小さい可能性があります。実際にそうかどうかは、個別タスクの証拠が必要です。[4][5]
Opus 4.8で十分なら、それを超えたモデルはどれだけあるのか?#
まず物差しを固定します。Opus 4.8が2026年5月の公開時評価で記録した61.4は、旧版Intelligence Indexのスコアです。今回のAPIスナップショットではv5総合スコアが空欄であり、空欄を0とみなすことも、旧スコア61.4で新しいランキングを選別することもできません。[1][6]
本稿では代わりに、Progress Index v1におけるOpus 4.8(max):318.376758998036を固定基準とし、厳密に上回る場合のみ「超過」とします。同値は超過に含めず、未測定は不明とします。しきい値には完全な精度を使い、表では小数第2位まで表示します。[2]
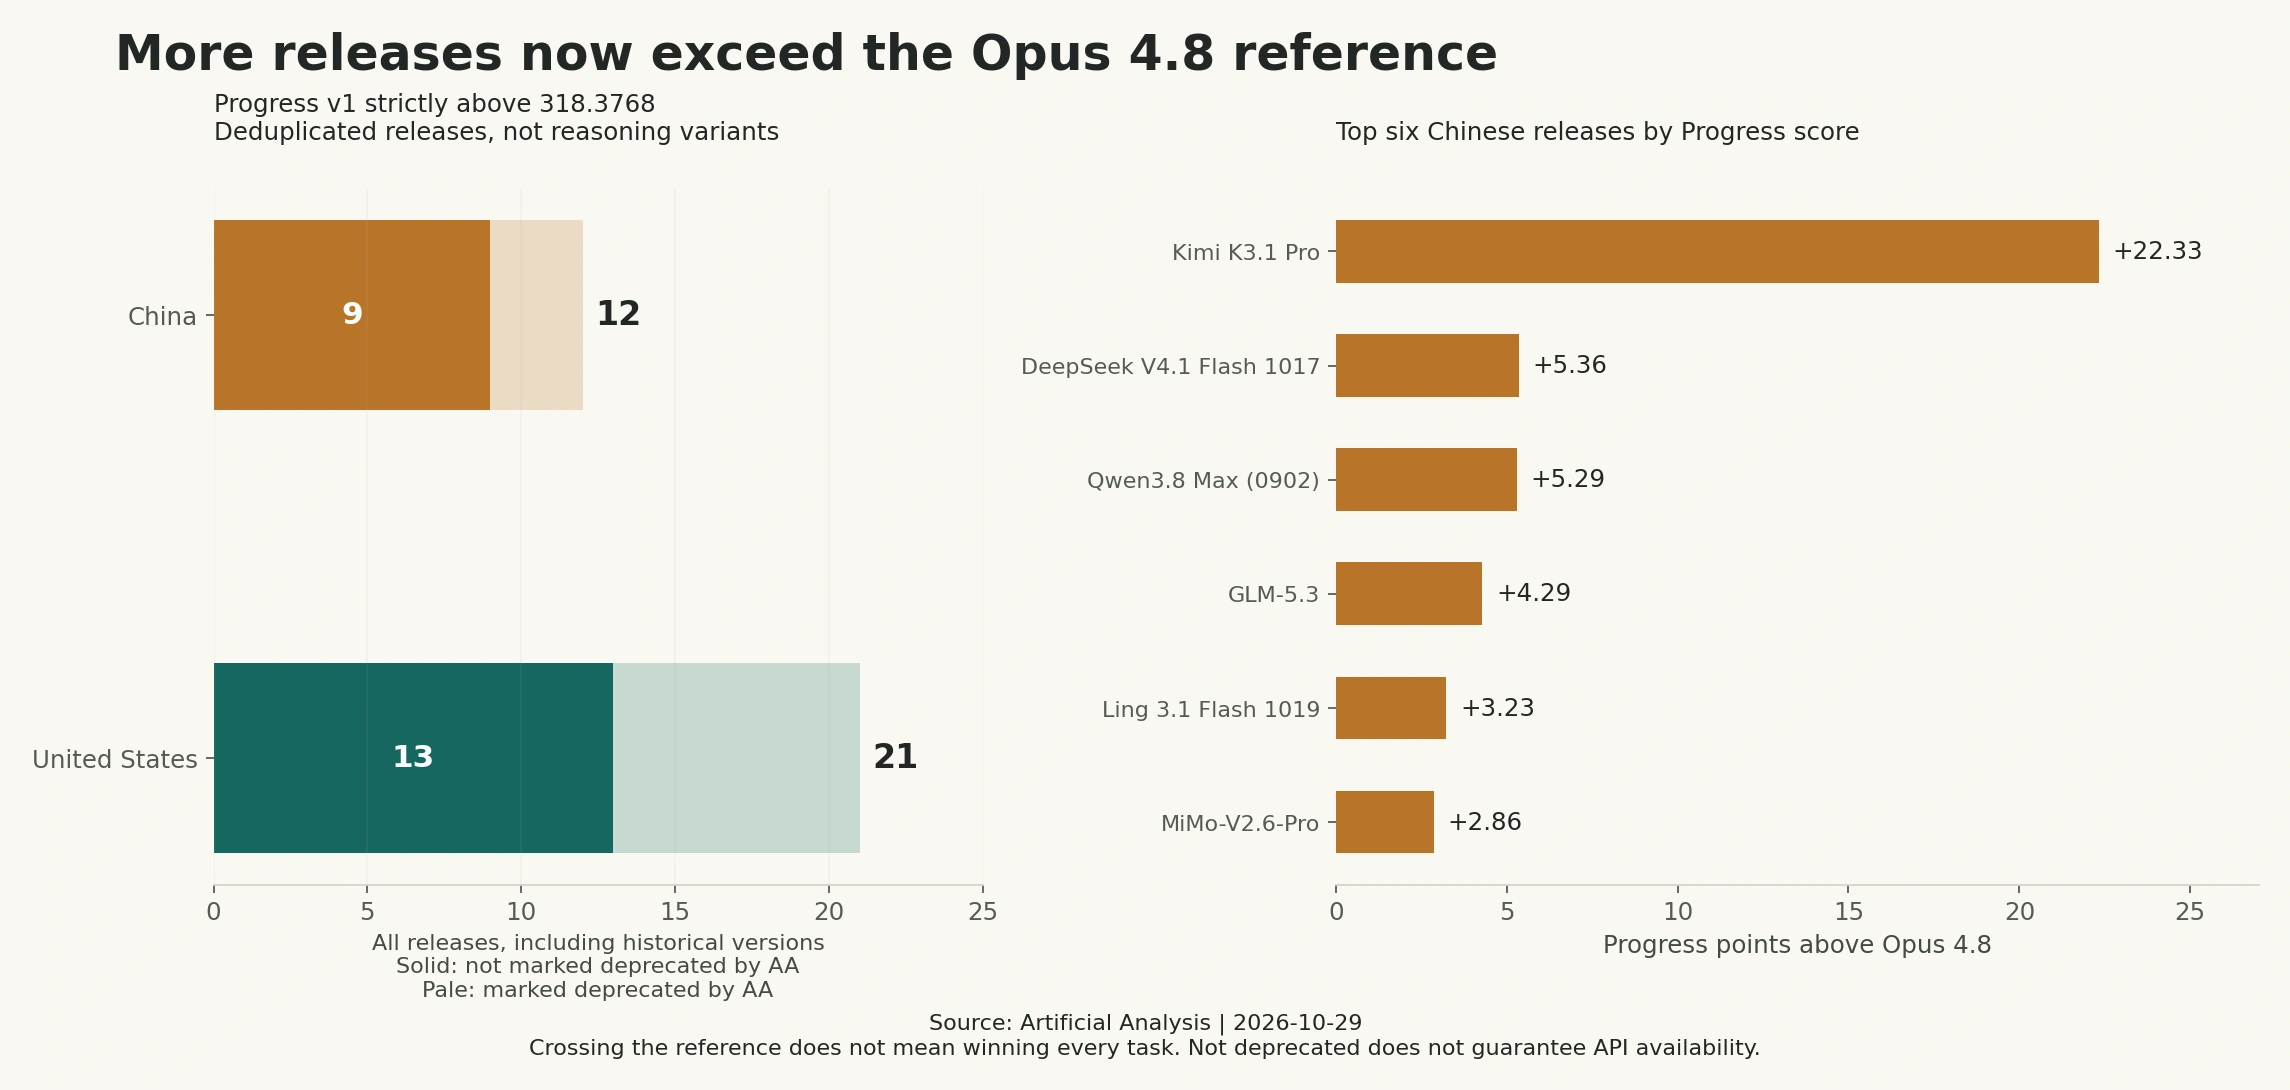
517リリースのうち、世界でこの基準を上回ったのは合計33で、すべて今回の中国・米国の2グループに含まれています。内訳は中国12、米国21です。AAがdeprecatedとマークしていないリリースだけに限ると、それぞれ9と13です。AAのマークはページ上の状態を示すもので、公式提供の終了を証明するものではなく、現在どのゲートウェイでも呼び出せることを保証するものでもありません。
基準を超えた中国モデルの全リスト#
| 中国モデルのリリース | 最高Progressスコア | AAがdeprecatedとマーク済み |
|---|---|---|
| Kimi K3.1 Pro | 340.70 | いいえ |
| DeepSeek V4.1 Flash 1017 | 323.74 | いいえ |
| Qwen3.8 Max (0902) | 323.67 | いいえ |
| GLM-5.3 | 322.66 | いいえ |
| Ling 3.1 Flash 1019 | 321.61 | いいえ |
| MiMo-V2.6-Pro | 321.24 | いいえ |
| DeepSeek V4.1 Flash | 320.25 | はい |
| Qwen3.8-Flash-Next | 320.23 | いいえ |
| Ling 3.1 Flash | 320.01 | いいえ |
| Kimi K3 | 319.88 | はい |
| Qwen3.8 Max | 319.63 | はい |
| GLM-5.3-Flash | 318.64 | いいえ |
基準を超えた米国モデルの全リスト#
| 米国モデルのリリース | 最高Progressスコア | AAがdeprecatedとマーク済み |
|---|---|---|
| Gemini 4 Carbon | 351.65 | いいえ |
| Claude Opus 5.5 | 351.27 | いいえ |
| Claude Sonnet 5.5 | 350.50 | いいえ |
| GPT-6 Astra | 349.57 | いいえ |
| GPT-6.1 Sol | 348.47 | いいえ |
| GPT-6.1 Terra | 345.25 | いいえ |
| Muse Wonder Full | 343.22 | いいえ |
| Gemini 4 Argon | 341.79 | いいえ |
| Claude Fable 5.1 | 340.85 | いいえ |
| Muse Wonder | 335.78 | いいえ |
| GPT-6 Sol | 334.04 | はい |
| Claude Opus 5 | 333.73 | はい |
| GPT-5.6 Sol | 331.46 | はい |
| Claude Fable 5 | 329.33 | はい |
| Claude Haiku 5.5 | 326.13 | いいえ |
| Muse Spark 1.3 | 324.46 | はい |
| GPT-5.6 Terra | 323.87 | はい |
| Grok 4.7 | 322.68 | いいえ |
| Grok 4.6 | 321.54 | はい |
| Gemini 3.8 Flash | 320.30 | いいえ |
| GPT-5.5 | 320.00 | はい |
わずかな超過をすべて「明確なリード」と呼ぶことはできません。例えば、GLM-5.3-Flashは基準を約0.27ポイント上回っていますが、今回の公開データには、この比較を裏付けるのに十分な信頼区間がありません。したがって、次の表はしきい値の感度分析にとどめ、加点した各段階を統計的有意性の基準とはしません。
| しきい値(Progress v1) | 中国のリリース数 | 米国のリリース数 |
|---|---|---|
| Opus 4.8 + 0ポイントを厳密に上回る | 12 | 21 |
| Opus 4.8 + 1ポイントを厳密に上回る | 11 | 21 |
| Opus 4.8 + 3ポイントを厳密に上回る | 5 | 19 |
| Opus 4.8 + 5ポイントを厳密に上回る | 3 | 17 |
| Opus 4.8 + 10ポイントを厳密に上回る | 1 | 14 |
この視点からは、2つの実感を同時に説明できます。旧フラッグシップ水準に達する選択肢は確かに増えましたが、旧フラッグシップを大きく上回る最上位の選択肢は、依然として米国グループに集中しています。 基準を超えた中国の12リリースのうち、5ポイントを超えて上回るのは3だけで、米国には17あります。以上はいずれも過去のリリースを含んでおり、現在利用可能なAPIの在庫と解釈してはいけません。
この能力基準を超えるまで、日数の差はどれほどか?#
現在のProgress v1による遡及では、米国で最初に基準を超えたのは2026年4月23日公開のGPT-5.5、中国では2026年7月16日公開のKimi K3で、初超過日の差は84日です。Opus 4.8自身の公開日である5月28日からKimi K3までを数えると49日です。[2]
GPT-5.5がOpus 4.8より先にこの遡及しきい値を超えたことは矛盾ではありません。Progressと当時のIntelligenceランキングでは、目的、フィッティング、順位付けが異なります。84日は、あくまで指定したこの1つのしきい値を初めて超えた日付の差であり、「中国の全モデルが全体として3か月遅れている」ことの証拠ではありません。
実際に感じる差は、スコアほど大きいのか?#
今回の実験で答えられるのは「このリクエスト条件で、どのタスクが問題なく完了したか」であり、人間の全体的な満足度評価の代替にはなりません。AnthropicシリーズとOpenAIシリーズから現在の代表的モデルを選び、Opus 4.8の基準も残しました。中国グループでは、Kimiシリーズ、Qwenシリーズ、DeepSeekシリーズ、GLMシリーズをカバーしています。これは目的を持ったサンプリングであり、国別の平均勝率を推定するものではありません。
テストは2026年10月29日に実施し、すべてhttps://cn.crazyrouter.comの/v1/chat/completionsエンドポイントを使用しました。リクエスト設定はreasoning_effort="high"、max_tokens=8192、非ストリーミング、ツール呼び出しなし、読み取りタイムアウトは各回180秒、順序はランダム、最大同時実行数は4です。同じhighラベルでも内部の計算量が同じとは限らず、AAによる各モデルの最高設定での評価とも同じではありません。
| タスクグループ | 具体的なタスク | 採点基準 |
|---|---|---|
| 日常タスク、5種類 | 注文情報の抽出と重複排除、矛盾する記録、中国語の書式制約、240件の在庫位置特定、返金ルールの境界 | 固定された正解、フィールド型、テキスト書式 |
| 推論負荷、3種類 | 円環制約のカウント、依存関係を伴うスケジューリング、組合せ選択の最適化 | ローカル全探索による唯一の最適解 / 指定された同点ルール |
厳格な合格には、HTTP成功、正常終了、最終回答と書式のすべてが要件を満たすことが必要です。事前に決めたこの主要指標を維持し、さらに事後の感度チェックとして、外側のMarkdownコードフェンスを1層だけ取り除く処理を行いました。回答の修正や再試行はしていません。後者は「内容を読み取れるか」に近く、前者は「プログラムへ直接組み込めるか」に近い指標です。
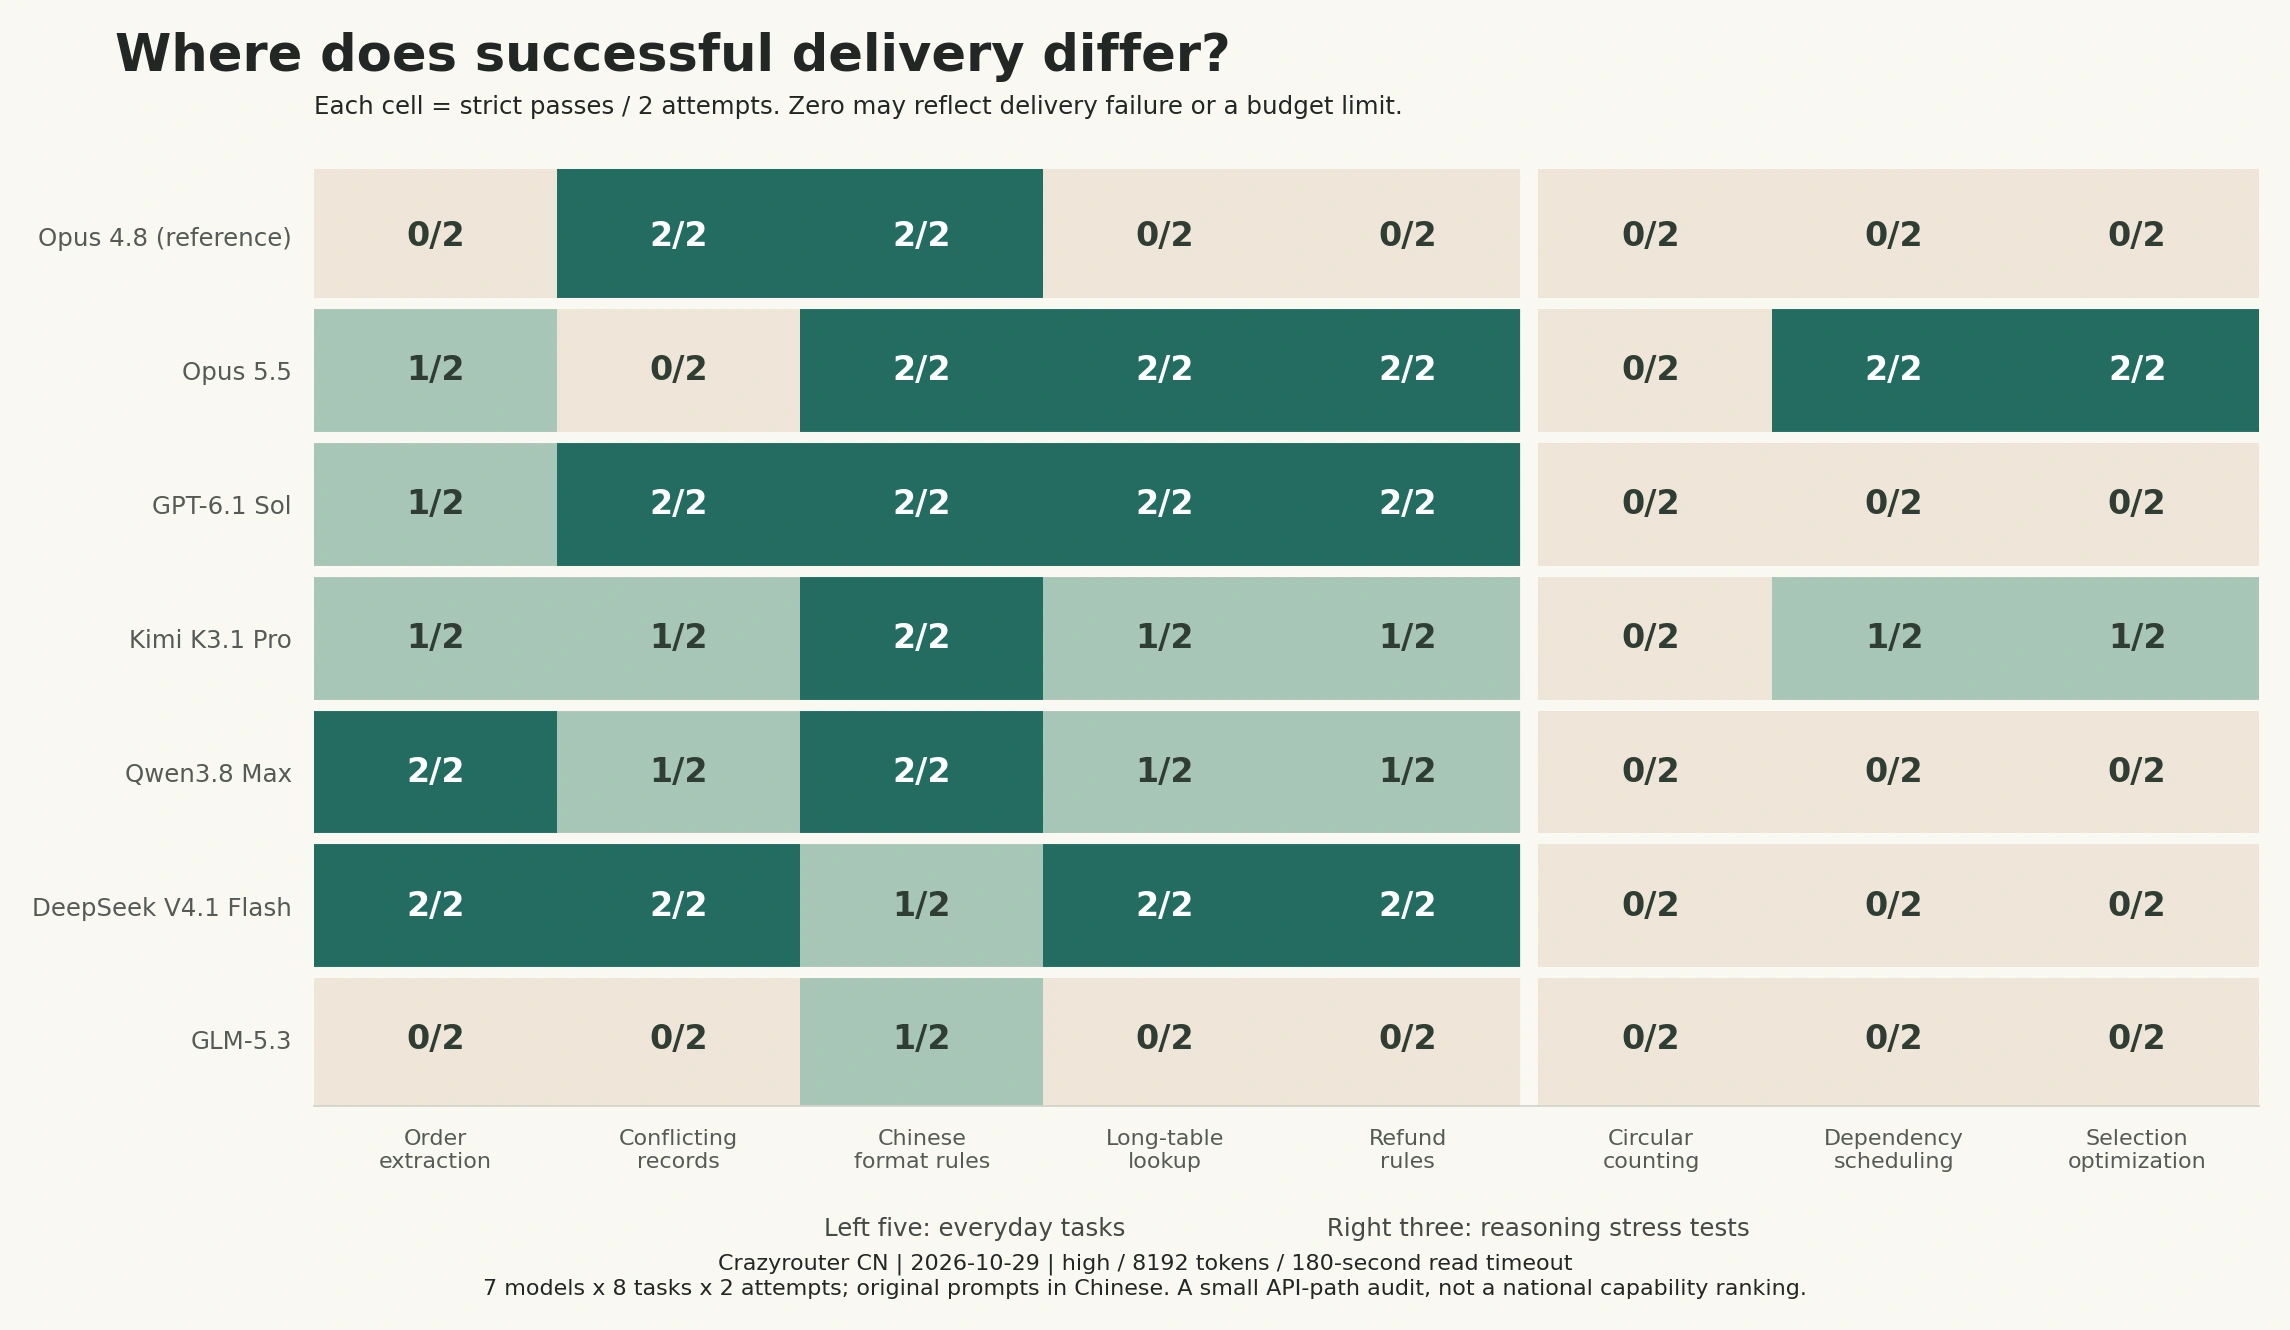
| リクエストモデル | 日常タスクの厳格な合格 / 10 | 負荷タスクの厳格な合格 / 6 | 全体の厳格な合格 / 16 | コードフェンス1層除去後 / 16 |
|---|---|---|---|---|
| claude-opus-4-8 | 4/10 | 0/6 | 4/16 | 13/16 |
| claude-opus-5-5 | 7/10 | 4/6 | 11/16 | 16/16 |
| gpt-6.1-sol | 9/10 | 0/6 | 9/16 | 9/16 |
| kimi-k3.1-pro | 6/10 | 2/6 | 8/16 | 8/16 |
| qwen3.8-max | 7/10 | 0/6 | 7/16 | 7/16 |
| deepseek-v4.1-flash | 9/10 | 0/6 | 9/16 | 9/16 |
| glm-5.3 | 1/10 | 0/6 | 1/16 | 1/16 |
差はどこに表れるのか?#
今回のDeepSeek V4.1 FlashとOpus 5.5を例にすると、日常タスクの厳格な完了はそれぞれ9/10と7/10、負荷タスクは0/6と4/6でした。これは固定予算下での完了の違いであり、未完了をすべて「モデルに解けない」と説明することはできません。特に負荷タスクでは、出力予算を使い切るか、待機時間の上限までに完了しない可能性があります。
もう1つの実例はOpus 4.8です。注文情報の抽出で正しいフィールドと値を返したものの、Markdownコードフェンスで囲んだため、厳格なJSONチェックに合格しませんでした。チャット画面で読むなら誤りとは感じないかもしれませんが、結果をそのままプログラムへ渡すなら、クリーニングの工程を追加する必要があります。同じ出力でも、使い方によって実感が変わります。
コードフェンスを1層だけ取り除いた結果は次のとおりです。
| リクエストモデル | 日常タスク:コードフェンスのみ除去後 / 10 | 負荷タスク:コードフェンスのみ除去後 / 6 |
|---|---|---|
| claude-opus-4-8 | 10/10 | 3/6 |
| claude-opus-5-5 | 10/10 | 6/6 |
| gpt-6.1-sol | 9/10 | 0/6 |
| kimi-k3.1-pro | 6/10 | 2/6 |
| qwen3.8-max | 7/10 | 0/6 |
| deepseek-v4.1-flash | 9/10 | 0/6 |
| glm-5.3 | 1/10 | 0/6 |
Opus 4.8とOpus 5.5の日常タスクはともに10/10ですが、負荷タスクはそれぞれ3/6と6/6です。これは、より高い能力の利点が、主に難しいタスクで表れる可能性を示す具体例です。ただし、日常タスクは5種類、負荷タスクは3種類しかなく、同じ問題への2回の呼び出しを2つの独立した問題と数えることはできません。これだけで日常能力が同等になったと証明することはできません。
ゲートウェイとバージョンマッピングも体験を変える#
今回の112回のリクエストでは、HTTPエラーが15回、読み取りタイムアウトが17回、予算による打ち切りが7回発生しました。これらの呼び出しはすべて、固定予算での完了率の分母に残し、次の表でも個別に示しています。
| リクエストモデル | HTTPエラー | 180秒の読み取りタイムアウト | 予算による打ち切り | 正常終了した応答数 |
|---|---|---|---|---|
| claude-opus-4-8 | 1 | 0 | 2 | 13 |
| claude-opus-5-5 | 0 | 0 | 0 | 16 |
| gpt-6.1-sol | 5 | 0 | 0 | 11 |
| kimi-k3.1-pro | 6 | 2 | 0 | 8 |
| qwen3.8-max | 1 | 8 | 0 | 7 |
| deepseek-v4.1-flash | 0 | 2 | 5 | 9 |
| glm-5.3 | 2 | 5 | 0 | 9 |
例えば、Kimi K3.1 Proへの1回のリクエストではprovider_authentication_failedが返されました。これは、そのリクエストが上流で正しく認証されなかったことを示すもので、モデルが回答を誤った証拠にはなりません。読み取りタイムアウトも、クライアントが完全な応答を時間内に受け取れなかったことだけを示し、モデルの計算が遅いと特定できるものではありません。
| リクエスト名 | 実測応答に現れたmodelフィールド |
|---|---|
| claude-opus-4-8 | claude-opus-4-8 |
| claude-opus-5-5 | claude-opus-5-5 |
| gpt-6.1-sol | gpt-6.1-sol |
| kimi-k3.1-pro | kimi-k3.1-pro |
| qwen3.8-max | qwen3.8-max |
| deepseek-v4.1-flash | deepseek-v4.1-flash、deepseek-v4.1-flash-1017、deepseek/deepseek-flash |
| glm-5.3 | glm-5.3 |
応答のmodelフィールドはサーバー側の申告にすぎず、ウェイトの同一性を独立に証明するものではありません。特にDeepSeekでは、同じリクエスト名から異なるバージョンやエイリアスが返されており、今回のすべてのリクエストがAAの同一リリースに正確に対応するとは保証できません。したがって、これらの結果は「今回のAPI経路における完了監査」と呼ぶべきであり、AAスコアと機械的に対応付けて相関係数を計算したり、それによって特定国のモデル全体が優れている、または同等だと宣言したりすることはできません。
GLM-5.3経路では、JSONの後に余分なテキストが付く応答、回答の重複、異常なマーカーも見られました。本稿では原本の証拠を保持していますが、異常の原因がモデル、テンプレート、上流の適合処理のいずれにあるかは判断できません。特に厳格な完了数の少なさを、基盤モデルの能力に関する結論とするのは不適切です。今回、より良い成績を得るために経路を変更したり、失敗を差し替えて再実行したりはしていません。
人間によるブラインド評価、本番ユーザーのタスクサンプリング、長期間の負荷テスト、同一予算での複数ラウンドのAgent評価は実施していません。そのため、「全体的な使い心地が同じくらい良いか」については、今回の証拠だけでは不十分です。現時点で確認できるのは、問題の種類、出力書式、リクエスト予算、サービス経路によって、実際の体験が単一ランキングの順序とは異なり得ることです。
更新が速いのはどちらか?リリース数と能力の躍進を分けて見る#
以下で数えるのは、AAがカバーするサンプル内の独立したリリースであり、両国の全モデルを網羅したリリース調査ではありません。1つのリリースに複数の推論設定があっても1回だけ数えます。最前線の更新は改善が起きた日付単位で数え、同日の複数リリースを重複して複数回とは数えません。
| 2026年の月 | 中国のリリース | 米国のリリース | 中国が最前線を更新した日数 | 米国が最前線を更新した日数 |
|---|---|---|---|---|
| 2026-01 | 5 | 4 | 1 | 0 |
| 2026-02 | 9 | 7 | 1 | 1 |
| 2026-03 | 12 | 9 | 0 | 1 |
| 2026-04 | 16 | 15 | 3 | 2 |
| 2026-05 | 6 | 4 | 0 | 0 |
| 2026-06 | 6 | 7 | 1 | 1 |
| 2026-07 | 5 | 10 | 2 | 2 |
| 2026-08 | 11 | 10 | 1 | 0 |
| 2026-09 | 8 | 13 | 1 | 3 |
| 2026-10(29日まで) | 5 | 10 | 2 | 1 |
2026年1月1日から10月29日まで、サンプル内のリリースは中国が83、米国が89でした。直近90暦日(8月1日から10月29日まで、両端を含む)ではそれぞれ24と33ですが、各グループが自国のProgress最前線を更新したのは、ともに4日間だけでした。リリース数が多いことが、自動的に最高能力の大幅な向上を意味するわけではありません。[2]
今回のスナップショット時点で、中国が最後に最前線を更新したのは10月23日のKimi K3.1 Pro、米国は10月28日のGemini 4 Carbonです。データ収集日は10月29日であり、収集日をモデルの更新日と呼ぶことはできません。AA APIには、各モデルの完全な過去のスコア変更ログがありません。本稿でも、そのようなフィールドを推測で作っていません。
再計算方法と、次回「使い心地」を検証する方法#
今回、編集部の研究アーカイブには、AAの4ページ分のAPI応答、公開トレンドグラフのデータ、統合後の517行CSV、集計スクリプト、タスクの正解、112回すべての呼び出しと要約を保存しています。正式なブログ記事の統計は、これらの凍結記録だけから算出しています。出典はArtificial Analysisで、集計計算とCrazyrouter経路の実測は本稿で行いました。
中心的な計算は、次の擬似コードで理解できます。
# One snapshot and metric version.
# Use AA release_id, not guessed names.
release_score = max(non_null_scores_for_each_release)
baseline = progress_score_of_opus_4_8_max
above_baseline = release_score > baseline
frontier_at_date = max(scores_of_releases_available_by_date)
gap_at_date = us_frontier_at_date - cn_frontier_at_date
例えば、注文情報抽出タスクにおけるOpus 4.8の応答IDはmsg_011CgWecKv2YBwoHYumCeURhで、HTTP 200かつ正常終了でした。元の回答は正しいJSONをコードフェンスで囲んだもので、厳格判定では不合格、書式の感度チェックでは合格でした。Kimiの認証失敗リクエストIDは608ccc90b353423d036dca779cafcc37です。この2つの記録は、「結果は得られたが書式が合わない」ことと「モデルの回答を得られなかった」ことの違いを示しています。
次の例では、業務ルールのタスクを1つ再実行します。API Keyは環境変数からのみ読み取り、エンドポイントにはUTMを付けていません。
import os
import requests

endpoint = "https://cn.crazyrouter.com" + "/v1/chat/completions"
user_content = (
    "\u672a\u62c6\u5c01\u4e14\u7b7e\u6536" "\u6b21\u65e5\u8d777\u65e5\u5185" "\u53ef\u9000\u6b3e\uff1b\u7b2c7" "\u65e5\u5305\u542b\u5728\u5185\u3002"
    "A\u57282026" "-10-20" "\u7b7e\u6536\uff0c202" "6-10-2" "7\u7533\u8bf7\u9000\u6b3e\uff0c"
    "\u65e0\u8d28\u91cf\u7f3a\u9677\u3002" "\u53ea\u8f93\u51faJSO" "N\uff0c\u952eeli" "gible\u4e3a" "\u5e03\u5c14\u503c\u3002"
)

response = requests.post(
    endpoint,
    headers={"Authorization": "Bearer " + os.environ["CRAZYROUTER_API_KEY"]},
    json={
        "model": "claude-opus-4-8",
        "messages": [{"role": "user", "content": user_content}],
        "reasoning_effort": "high", "max_tokens": 8192, "stream": False,
    },
    timeout=(15, 180),
)
response.raise_for_status()
print(response.json())
これは本文のための簡略化した再現例であり、112回の正式テストで使った完全な原題ではありません。8問すべて、採点スクリプト、原本記録は編集部がアーカイブしており、完全な研究パッケージの公開ダウンロードは提供していません。この簡略問題を使って正式な成績を追加または置き換えてもいません。
ここでのavailable_by_dateは、公開日がその日以前であることだけを意味し、当日に公開APIがあったことを保証しません。欠測スコアを0で埋めず、1ポイントを固定の割合ともみなしません。両国の国別分類はAAの研究開発機関ラベルに従い、GoogleはAAがマークする米国グループに含めています。サーバー所在地や従業員の国籍では分けていません。[1][3]
次回、本当に「使い心地の同等性」を検証するなら、まず3種類の対象ユーザータスクと許容できる差を固定し、その後、匿名で左右の順序をランダムにしたペア型ブラインド評価を行うことを提案します。主要指標には、タスクの完了品質、重大な誤り、人間による手直し、選好を含め、呼び出し失敗率は別に示すべきです。同等性の限界とサンプルサイズは結果を見る前に決め、タスクごとにクラスター化して分析します。「有意差が検出されなかった」ことを「体験が同じ」とすることはできません。
今後、このシリーズでは何を研究するのか?#
本稿ではまず、「スコアの差、旧フラッグシップの基準、実際の完了結果はどう違うのか」に答えました。今後は能力の種類ごとに分け、各タスクに適したベンチマーク、固定予算、実際のAPIテストを使用します。異なるモダリティのスコアを1つの「国家総合スコア」にまとめることはしません。以下は选题計画であり、後続の特集はまだ公開されていません。
| 篇章 | 予定テーマ | 中心となる問い |
|---|---|---|
| 第1回・テキストモデル | フラッグシップの基準を超えた後、日常タスクの差はどれほど残るのか? | 中国語作文、構造化出力、長文書、事実性、人間によるブラインド評価での差 |
| 第2回・プログラミングとAgent | 答えられるだけでなく、仕事を最後までやり遂げられるのか? | コード修正、テスト合格、ツール呼び出し、複数ステップのタスク、予算内完了率 |
| 第3回・画像モデル | 見た目の良さに加え、要求どおりの画像を生成できるのはどちらか? | テキストから画像、画像編集、中国語文字、被写体の一貫性、複数回生成の安定性 |
| 第4回・動画モデル | 1コマの驚きの後、動きと物語は成立するのか? | テキストから動画、画像から動画、動きと物理の一貫性、キャラクターの連続性、完成までの待ち時間 |
| 第5回・音声モデル | 正確に聞き取り、自然に話し、会話についていけるのか? | 音声認識、音声合成、リアルタイム音声を個別に測定し、アクセントと遅延も考慮 |
| 第6回・ベクトルとリランキング | ナレッジベースの効果の差は、どこにあるのか? | 中国語とクロスリンガル検索、長文書、Recall@k、nDCG、リランキングによる改善、インデックスコスト |
| 第7回・総合的なモデル選定 | 同じ予算で、異なるモデルをどう組み合わせるか? | 前述の実測をまとめ、具体的な場面ごとの品質、待ち時間、コスト、信頼性から選択 |
各回で「誰が最前線にいるか」「誰が実用基準を超えたか」「差が実際のタスクに影響するか」という3つの問いを維持しますが、基準は、そのモダリティの参照モデルまたは業務上の受け入れ条件で定義します。例えば、Opus 4.8は本稿のテキスト参照には使えますが、画像、音声、ベクトルモデルに共通する基準にはできません。
よくある質問#
中国と米国のAIモデル、実際の差はどれほどあるのか?#
今回のスナップショットでは、AA Intelligence v5の最前線で米国が13.4ポイントリードしています。同じProgress v1の物差しでの最前線の差は10.94ポイントです。両者は測定目的が異なり、どちらも能力の割合やユーザー満足度の差へ直接換算できません。
差はますます広がっているのか?#
現在の遡及データは「継続的な拡大」を裏付けていません。2026年9月末の差は27.61、10月29日には10.94で、その間に新モデルの公開によって明らかに縮小しました。ただし、最前線が近づくことと、上位グループの層がすでに同じ厚さになったことは別です。
Opus 4.8を超えた中国モデルはいくつあるのか?#
Progress v1を使い、独立したリリース単位で、Opus 4.8(max)を厳密に上回るものを数えると12です。過去のリリースを含みます。このうち9は、まだAAにdeprecatedとマークされていません。評価上の参照基準を超えても、あらゆるタスクでOpus 4.8に勝つとは保証されません。
なぜOpus 4.8の61.4を使わないのか?#
61.4は公開時の旧Intelligence Indexによるもので、今回のv5ではこのモデルに総合スコアがありません。同じ物差しで比較する必要があり、過去のスコアを新しいランキングにそのまま当てはめることはできません。
中国モデルは日常利用に十分な水準なのか?#
国別だけで一律の答えは出せません。今回、一部のモデルは日常タスクを完了できましたが、ゲートウェイエラー、書式の違い、予算による打ち切りも結果を変えました。自分のタスクと許容できる失敗率を出発点に、具体的なモデルと信頼できる呼び出し経路を選ぶべきです。
今回のテストで、中国と米国のモデルの使い心地が同じだと証明できるか?#
できません。実施したのは8種類の合成タスクを各題2回だけで、一部のリクエストにはバージョンのエイリアスや経路の問題もあり、人間によるブラインド評価は行っていません。ランキングと体験が分かれ得る具体的な理由は示しましたが、全体的な同等性は証明していません。
リリース、モデル構成、API名にはどんな違いがあるのか?#
AAの1つのリリースには複数の推論設定があり得ます。また、ゲートウェイではエイリアスを使ったり、新しいバージョンへ逐次更新したりする場合があります。ランキングの集計はリリース単位で重複を排除し、実測では実際のリクエスト名と返されたmodelフィールドを保持しています。両者が自動的に一対一で対応するわけではありません。
参考資料#
- Artificial Analysis Data API:フィールド、ページネーション、バージョン、欠測値の定義。今回の完全な収集日は2026-10-29で、APIはIntelligenceバージョン5を報告しています。
- Artificial Analysis AI Trends:Progress、国別所属、リリース。2026-10-29に取得した匿名の公開ページスナップショット。本文の統計は、著者がこのスナップショットを再計算したものです。
- Artificial Analysis Progress Index v1の方法。IRTスケール、設定段階、過去比較の限界。
- AA Intelligence Index v5の公開発表、2026-10-27。評価の変化を説明するためのもので、10月29日時点の最新ランキングの代替ではありません。
- AA Intelligence Indexの方法とバージョン説明。
- AA Opus 4.8公開時評価、2026-05-28と現在のモデルページ。
- Anthropic Opus 4.8公式公開ページ。
本稿の「超過」「リード」は、いずれも明示した物差しとカバー済みサンプルに限定されるもので、統計的有意性を意味しません。AAデータに後から追加測定、修正、新モデルが加わった場合、結果を再計算する必要があります。