简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
Prolog: Wie weit liegen chinesische und US-amerikanische KI-Modelle wirklich auseinander?
Prolog zur Modellstudie: Frontabstände, Opus-4.8-Schwelle und 112 reale API-Aufrufe auf Basis des Datenstands vom 2026-10-29.
Dies ist die deutsche Fassung derselben Studie mit Datenstand 2026-10-29. Alle 112 Testanfragen verwendeten die ursprünglichen chinesischen Prompts; eine neue mehrsprachige Evaluation wurde nicht durchgeführt. Die Abbildungen sind auf Englisch beschriftet. Das Codebeispiel bewahrt den ursprünglichen chinesischen Prompt als Unicode-Escapes, die zur Laufzeit dekodiert werden.
Serie zum Vergleich chinesischer und US-amerikanischer KI-Modelle · Prolog. Wir entwickeln die Vergleichsmethode zunächst anhand von Textmodellen und untersuchen anschließend Bilder, Video, Sprache, Vektorsuche und Reranking. Dieser Beitrag ist der Ausgangspunkt für Methodik und Fragestellungen; die Ergebnisse von Textmodellen sagen nichts über die Stärke in anderen Modalitäten aus.
US-Modelle führen derzeit sowohl an der Spitze der Rangliste als auch bei der Breite der führenden Modellgruppe. Die Aussage, der Abstand zwischen chinesischen und US-Modellen vergrößere sich kontinuierlich, wird jedoch durch diese rückblickende Betrachtung mit einheitlichem Maßstab nicht bestätigt. Nimmt man Opus 4.8 als Referenzschwelle für persönliche Zufriedenheit, liegen in der von AA erfassten Stichprobe 12 chinesische und 21 US-amerikanische Veröffentlichungsversionen mit ihrem Progress-Index-Wert darüber. Das bedeutet nicht, dass sie bei jeder Aufgabe besser funktionieren.
Der Datenstichtag ist der 2026-10-29. Dieser Beitrag trennt drei leicht zu verwechselnde Fragen: Wie groß ist der Abstand zwischen den stärksten Modellen, wie viele Optionen überschreiten die Schwelle eines früheren Spitzenmodells, und welche Unterschiede lassen sich bei tatsächlichen Anfragen wahrnehmen? Für die ersten beiden Fragen werden Daten von Artificial Analysis (AA) verwendet. Die dritte wird über Crazyrouter mit einer Prüfung von 7 Modellen, 8 Aufgabenarten und jeweils 2 Aufrufen pro Aufgabe, insgesamt also 112 Aufrufen, untersucht.[1][2]
Dies ist eine Untersuchung einer Modellstichprobe. Sie bewertet weder die gesamte KI-Industrie der beiden Länder noch wurde ein subjektiver Blindtest mit Menschen durchgeführt. Ob ein Modell „brauchbar“ ist, hängt letztlich von der Aufgabe, der akzeptablen Wartezeit und den Anforderungen an die Fehlertoleranz ab.
Zunächst die Ergebnisse: Führung an der Spitze und breite praktische Nutzbarkeit sind zwei verschiedene Dinge#
| Kennzahl / Maßstab | China | USA |
|---|---|---|
| Aktueller Höchstwert · Intelligence v5 | 46.0 · Kimi K3.1 Pro | 59.4 · Gemini 4 Carbon |
| Durchschnitt der Top 5 · Intelligence v5 | 34.74 | 56.68 |
| Anzahl der Versionen in den globalen Top 10 · Intelligence v5 | 1 | 9 |
| Aktueller Höchstwert · Progress v1 | 340.70 | 351.65 |
| Über Opus 4.8 · Progress v1, einschließlich historischer Versionen | 12 | 21 |
| Davon bei AA nicht als deprecated markierte Versionen | 9 | 13 |
Die Werte der beiden Indizes dürfen weder voneinander subtrahiert noch in einer gemeinsamen Rangliste vermischt werden. Der aktuelle v5-Abstand an der Spitze beträgt 13.4 Punkte; bei Progress v1 beträgt er 10.94 Punkte. Der erste Index misst die Leistung im aktuellen Bewertungsset, der zweite dient der Analyse von Fähigkeitsveränderungen über verschiedene Zeiträume.
Für die Auswertung wurden die 716 Inferenzkonfigurationen von AA zu 517 Veröffentlichungsversionen zusammengeführt: 176 aus China, 257 aus den USA und der Rest aus anderen Ländern oder ohne Zuordnung. Die Zusammenführung erfolgt über release.id; high, max und xhigh derselben Version werden nicht als mehrere Modelle gezählt. Für jede Kennzahl wird jeweils die Konfiguration der Version mit der höchsten Punktzahl verwendet, wobei dies für verschiedene Kennzahlen unterschiedliche Konfigurationen sein können.
In der neuen v5-Rangliste besitzen derzeit nur 39 Veröffentlichungsversionen eine verwertbare Gesamtpunktzahl: 12 aus China, 24 aus den USA und 3 aus anderen Ländern. Die Top 10 und die Durchschnittswerte beziehen sich hier auf die getestete Stichprobe; eine fehlende Messung bedeutet nicht null Punkte. Die Rangfolge nutzt die unveränderte Genauigkeit der API-Antwort. Gleichstände erhalten denselben Rang, und die folgenden Ränge werden entsprechend übersprungen.[1]
Die aktuellen Top 20: Wer steht an der Spitze?#
| Globaler Rang (Versionen dedupliziert) | Veröffentlichungsversion | Zuordnung | v5-Wert | Veröffentlichungsdatum |
|---|---|---|---|---|
| 1 | Gemini 4 Carbon | USA | 59.4 | 2026-10-28 |
| 2 | Claude Opus 5.5 | USA | 58.4 | 2026-09-22 |
| 3 | GPT-6 Astra | USA | 56.9 | 2026-09-03 |
| 4 | GPT-6.1 Sol | USA | 54.5 | 2026-09-29 |
| 5 | Claude Sonnet 5.5 | USA | 54.2 | 2026-09-28 |
| 6 | GPT-6.1 Terra | USA | 51.0 | 2026-10-26 |
| 7 | Gemini 4 Argon | USA | 50.4 | 2026-09-30 |
| 8 | Muse Wonder Full | USA | 49.7 | 2026-10-12 |
| 8 | Claude Fable 5.1 | USA | 49.7 | 2026-09-01 |
| 10 | Kimi K3.1 Pro | China | 46.0 | 2026-10-23 |
| 11 | Muse Wonder | USA | 43.3 | 2026-10-12 |
| 12 | Muse Spark 1.3 | USA | 36.4 | 2026-09-02 |
| 13 | Claude Haiku 5.5 | USA | 36.2 | 2026-10-07 |
| 14 | Grok 4.7 | USA | 35.0 | 2026-09-21 |
| 15 | Qwen3.8 Max (0902) | China | 33.6 | 2026-09-02 |
| 16 | DeepSeek V4.1 Flash 1017 | China | 32.5 | 2026-10-17 |
| 17 | GLM-5.3 | China | 31.7 | 2026-08-18 |
| 18 | Gemini 3.8 Flash | USA | 30.5 | 2026-09-02 |
| 19 | MiMo-V2.6-Pro | China | 29.9 | 2026-09-21 |
| 20 | Ling 3.1 Flash 1019 | China | 29.5 | 2026-10-22 |
In diesen Top 20 entfallen 6 Plätze auf China und 14 auf die USA; in den Top 10 sind es 1 beziehungsweise 9. Zusammen mit den Top-5-Durchschnittswerten von 34.74 und 56.68 zeigt sich, dass das Aufholen eines einzelnen Spitzenmodells und die Breite der führenden Modellgruppe weiterhin auseinanderfallen. Versionen ohne Gesamtwert nehmen nicht an der Rangfolge teil.[1]
Wird der Punkteabstand immer größer?#
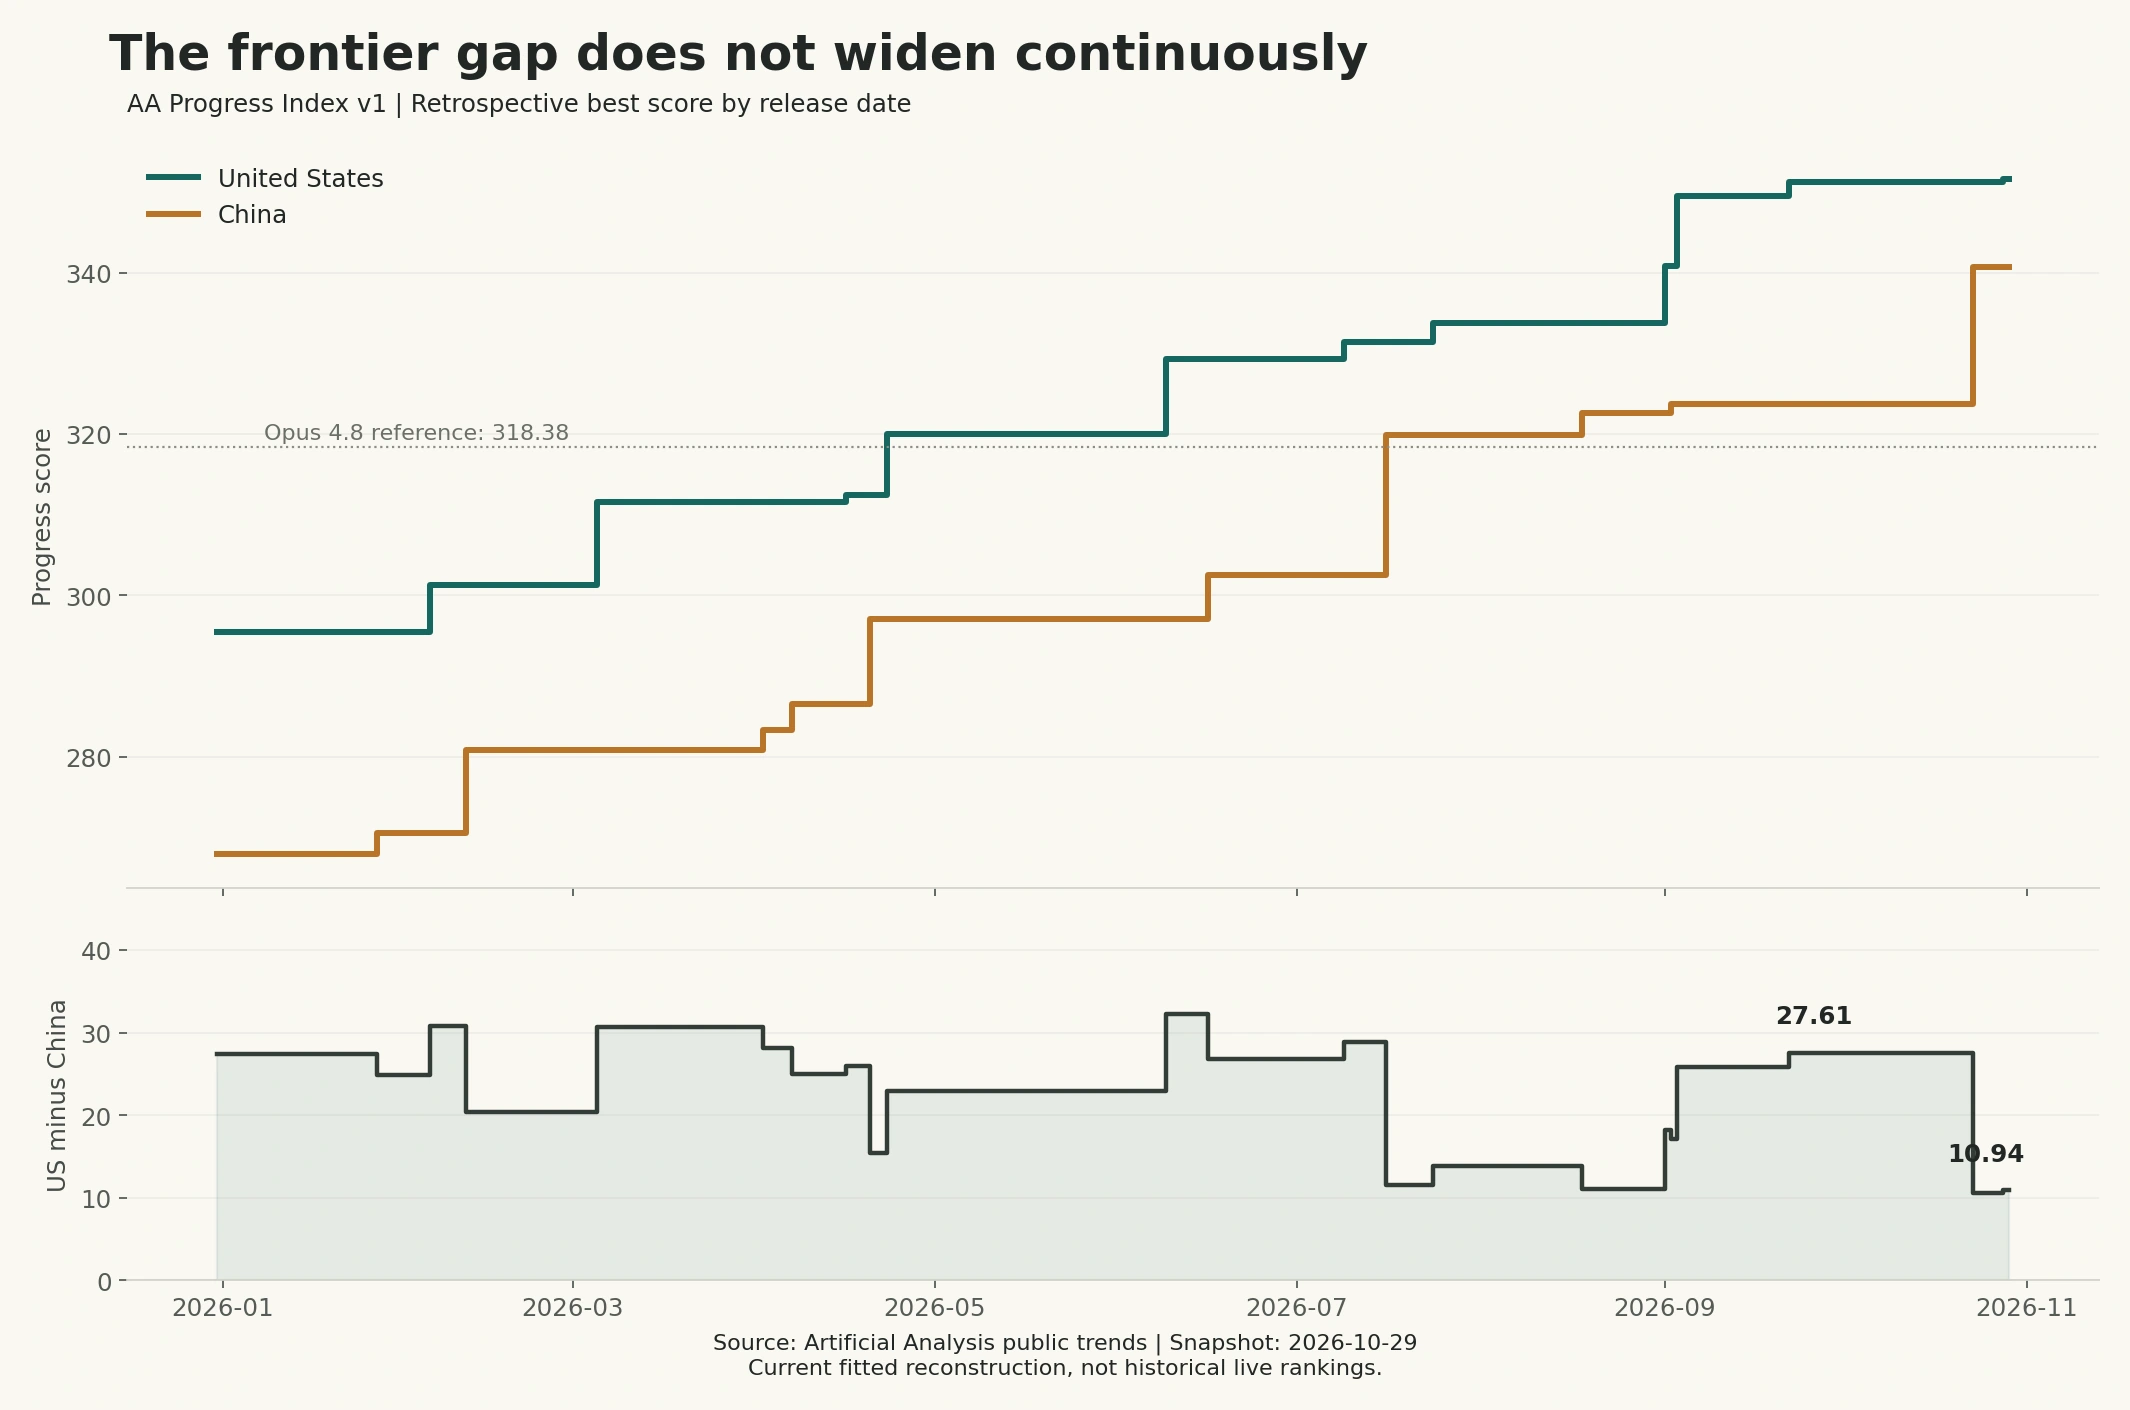
Er vergrößert sich nicht kontinuierlich, sondern wird deutlich vom Veröffentlichungsrhythmus der Spitzenmodelle beeinflusst. Mit dem Progress Index v1 aus derselben Datenerfassung rekonstruieren wir die Spitzenposition beider Länder anhand der Veröffentlichungsdaten der Versionen: Der höchste Wert aller bis zu einem bestimmten Tag veröffentlichten Versionen bildet die rückblickend berechnete Spitze dieses Tages.
| Rückblickdatum | Chinesische Spitze | US-Spitze | Abstand: USA−China |
|---|---|---|---|
| 2025-12-31 | 267.96 | 295.46 | 27.49 |
| 2026-03-31 | 280.87 | 311.55 | 30.69 |
| 2026-06-30 | 302.52 | 329.33 | 26.80 |
| 2026-07-31 | 319.88 | 333.73 | 13.85 |
| 2026-08-31 | 322.66 | 333.73 | 11.07 |
| 2026-09-30 | 323.67 | 351.27 | 27.61 |
| 2026-10-23 | 340.70 | 351.27 | 10.57 |
| 2026-10-29 | 340.70 | 351.65 | 10.94 |
Ende August 2026 betrug der Abstand 11.07. Nach der konzentrierten Veröffentlichung neuer US-Spitzenmodelle im September weitete er sich zum Monatsende auf 27.61 aus. Die Veröffentlichung von Kimi K3.1 Pro am 2026-10-23 verringerte ihn auf 10.57; nach der Veröffentlichung von Gemini 4 Carbon am 2026-10-28 betrug er im Schnappschuss vom 2026-10-29 10.94.[2]
Damit wird die Wahl des Zeitfensters zu einem Bestandteil des Ergebnisses. Der aktuelle Abstand ist gegenüber vor 30 Tagen um etwa 16.66 Punkte kleiner, gegenüber vor 90 Tagen um etwa 2.91 Punkte und gegenüber vor 180 Tagen um etwa 12.00 Punkte. Gleichzeitig führen die USA im Vergleich der beiden Spitzen weiterhin. Ein kleiner werdender Abstand und eine fortbestehende Führung können gleichzeitig zutreffen.
Diese Grafik darf jedoch nicht als „Live-Rangliste für jeden vergangenen Tag“ bezeichnet werden. Der Progress Index beruht auf einer statistischen Anpassung anhand der derzeit verfügbaren Bewertungen. Nachträgliche Tests und eine erneute Anpassung können die rückblickenden Werte verändern; auch der historische Status des API-Zugangs wurde nicht vollständig rekonstruiert. Die Grafik beantwortet die Frage, wie früher veröffentlichte Modelle heute mit demselben Maßstab aussehen, und nicht, welche Modelle Nutzer damals tatsächlich aufrufen konnten.[3]
Warum kann der Abstand plötzlich größer erscheinen?#
AA hat den Intelligence Index am 2026-10-27 auf v5 aktualisiert und dabei Bewertungen für Softwareentwicklung, wissenschaftliche Forschung und wissensbasiertes Schlussfolgern neu aufgenommen oder erweitert. In der Ankündigung heißt es, dass sich der Abstand zwischen der Spitze der Kategorie offener Gewichte und den führenden Modellen von 3 Punkten in v4.3 auf 12 Punkte in v5 vergrößert habe.[4]
Hier wurde sowohl der Messmaßstab gewechselt als auch die Gruppierung „offene Gewichte gegenüber führenden Modellen“ verwendet. Daraus lässt sich nicht unmittelbar ableiten, dass sich der Fähigkeitsabstand zwischen China und den USA innerhalb von zwei Tagen von 3 auf 12 Punkte vergrößert habe. Die Ankündigung bezieht außerdem Kimi K3.1 Pro, dessen Gewichte noch nicht veröffentlicht waren, in die entsprechende Beschreibung ein. Diese Gruppierung darf daher erst recht nicht mit der Menge der an jenem Tag tatsächlich herunterladbaren Modelle gleichgesetzt werden.
v5 gewichtet Wissensarbeit, Programmierung, Wissenschaft und allgemeine Fähigkeiten jeweils mit 25%. Dadurch erhalten schwierige Aufgaben und mehrstufige Ausführung mehr Gewicht als beim bloßen Chatten. Der Abstand in der Rangliste kann deshalb groß sein, während er bei bestimmten Alltagsaufgaben kleiner ausfällt; ob das zutrifft, erfordert Belege für die jeweiligen Aufgaben.[4][5]
Wenn Opus 4.8 bereits ausreicht: Wie viele Modelle liegen darüber?#
Zunächst muss der Maßstab festgelegt werden. Die 61.4 Punkte von Opus 4.8 in der Bewertung zu seiner Veröffentlichung im Mai 2026 gehören zum alten Intelligence Index. Im vorliegenden API-Schnappschuss ist sein v5-Gesamtwert leer. Ein fehlender Wert darf weder als 0 behandelt noch der alte Wert 61.4 zum Filtern der neuen Rangliste verwendet werden.[1][6]
Dieser Beitrag verwendet stattdessen Opus 4.8 (max): 318.376758998036 aus Progress Index v1 als feste Referenz. Nur ein strikt höherer Wert gilt als Überschreitung; Gleichstand zählt nicht, und fehlende Werte werden als unbekannt vermerkt. Die Schwelle wird mit voller Genauigkeit verwendet, in den Tabellen sind lediglich zwei Dezimalstellen dargestellt.[2]
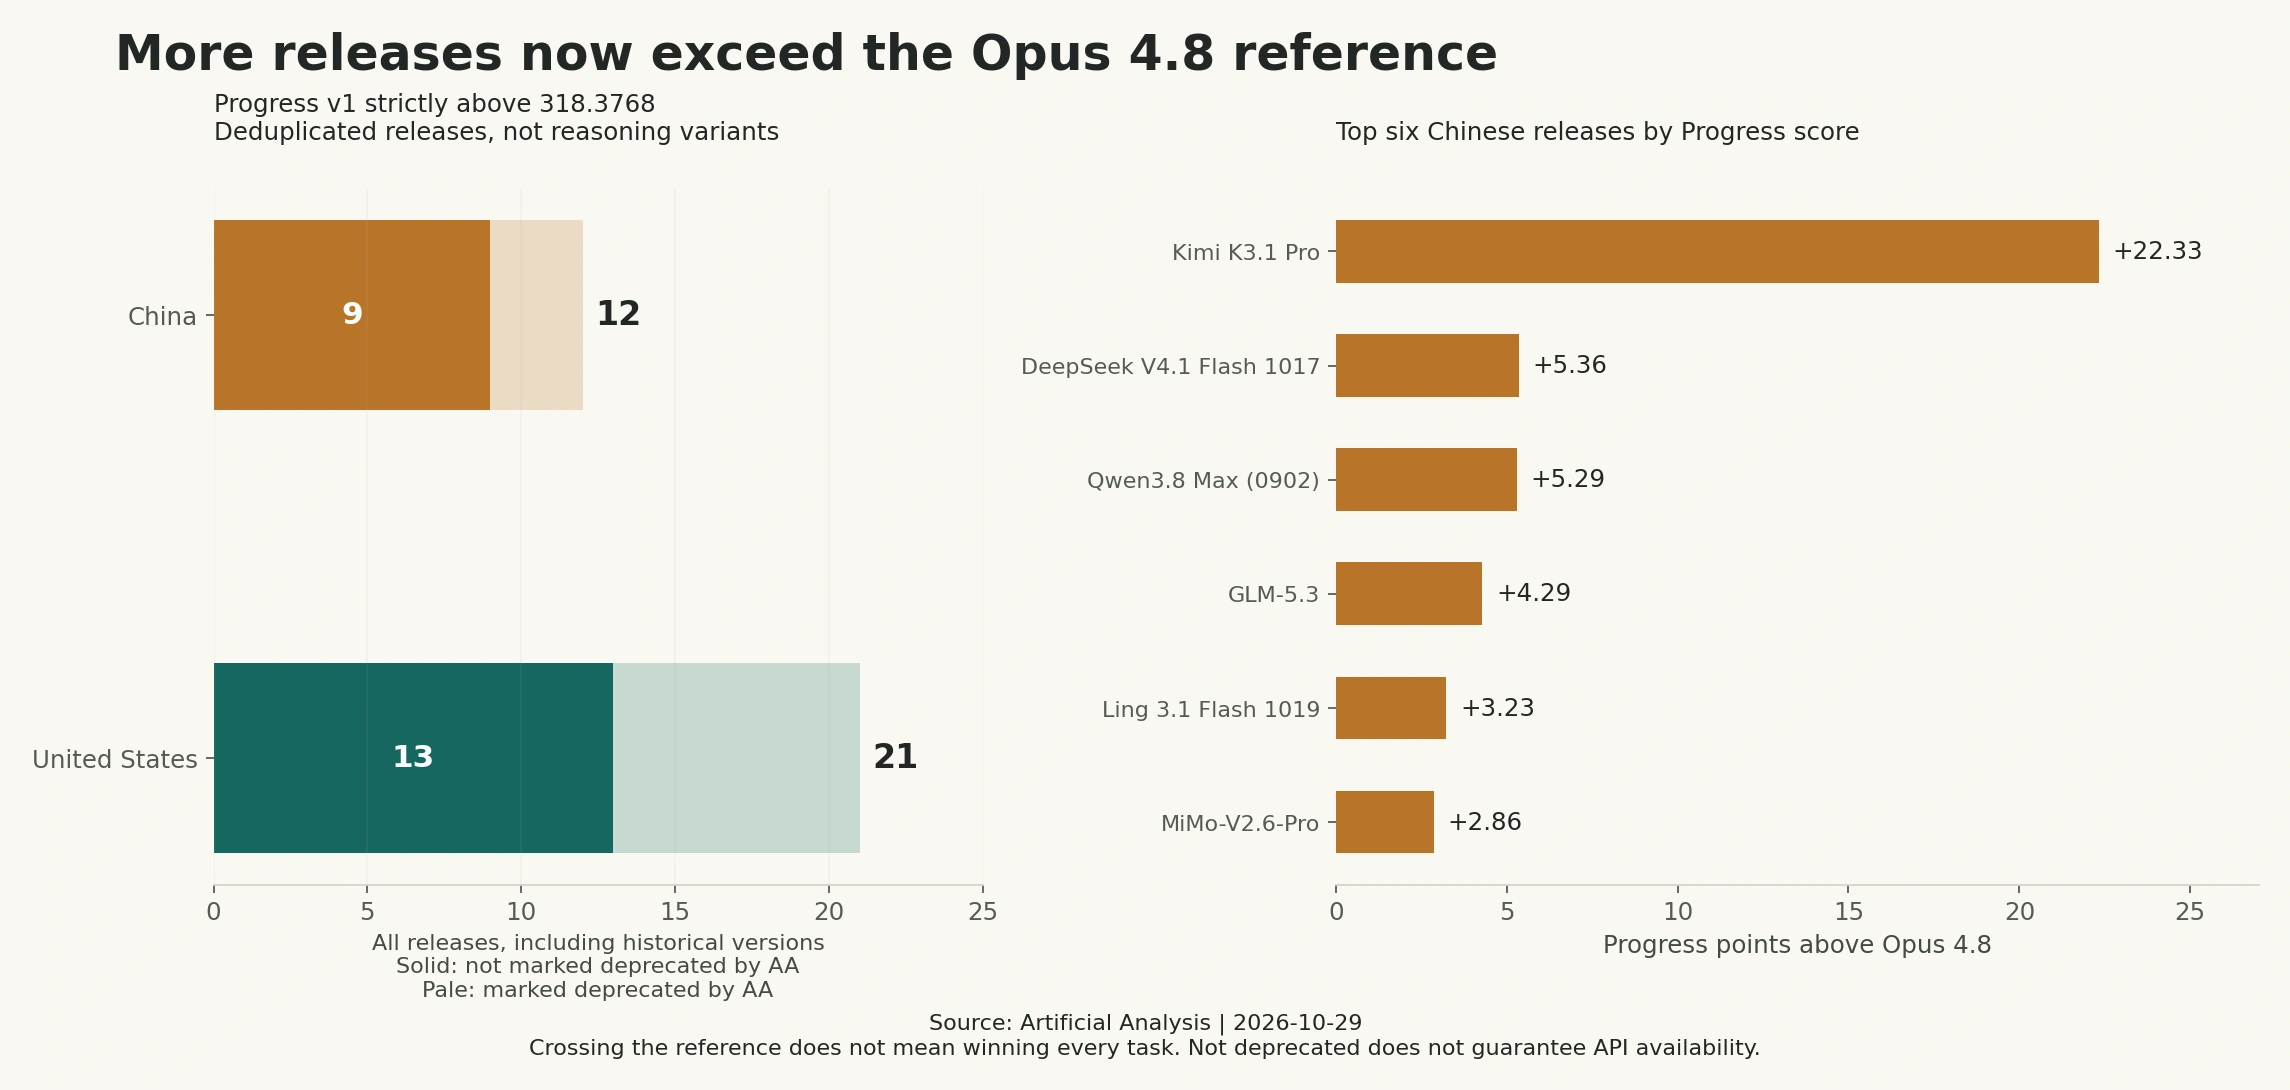
Von den 517 Veröffentlichungsversionen liegen weltweit 33 über dieser Schwelle, und alle gehören zu den hier untersuchten Gruppen aus China und den USA. Davon sind 12 chinesische und 21 US-amerikanische. Betrachtet man nur Versionen, die AA nicht mit deprecated markiert hat, sind es 9 beziehungsweise 13. Die AA-Markierung ist ein Seitenstatus: Sie beweist nicht, dass der offizielle Dienst eingestellt wurde, und garantiert auch nicht, dass die Version derzeit über jedes Gateway aufrufbar ist.
Vollständige Liste der chinesischen Versionen über der Schwelle#
| Chinesische Modellversion | Höchster Progress-Wert | Bei AA als deprecated markiert |
|---|---|---|
| Kimi K3.1 Pro | 340.70 | Nein |
| DeepSeek V4.1 Flash 1017 | 323.74 | Nein |
| Qwen3.8 Max (0902) | 323.67 | Nein |
| GLM-5.3 | 322.66 | Nein |
| Ling 3.1 Flash 1019 | 321.61 | Nein |
| MiMo-V2.6-Pro | 321.24 | Nein |
| DeepSeek V4.1 Flash | 320.25 | Ja |
| Qwen3.8-Flash-Next | 320.23 | Nein |
| Ling 3.1 Flash | 320.01 | Nein |
| Kimi K3 | 319.88 | Ja |
| Qwen3.8 Max | 319.63 | Ja |
| GLM-5.3-Flash | 318.64 | Nein |
Vollständige Liste der US-Versionen über der Schwelle#
| US-Modellversion | Höchster Progress-Wert | Bei AA als deprecated markiert |
|---|---|---|
| Gemini 4 Carbon | 351.65 | Nein |
| Claude Opus 5.5 | 351.27 | Nein |
| Claude Sonnet 5.5 | 350.50 | Nein |
| GPT-6 Astra | 349.57 | Nein |
| GPT-6.1 Sol | 348.47 | Nein |
| GPT-6.1 Terra | 345.25 | Nein |
| Muse Wonder Full | 343.22 | Nein |
| Gemini 4 Argon | 341.79 | Nein |
| Claude Fable 5.1 | 340.85 | Nein |
| Muse Wonder | 335.78 | Nein |
| GPT-6 Sol | 334.04 | Ja |
| Claude Opus 5 | 333.73 | Ja |
| GPT-5.6 Sol | 331.46 | Ja |
| Claude Fable 5 | 329.33 | Ja |
| Claude Haiku 5.5 | 326.13 | Nein |
| Muse Spark 1.3 | 324.46 | Ja |
| GPT-5.6 Terra | 323.87 | Ja |
| Grok 4.7 | 322.68 | Nein |
| Grok 4.6 | 321.54 | Ja |
| Gemini 3.8 Flash | 320.30 | Nein |
| GPT-5.5 | 320.00 | Ja |
Eine knappe Überschreitung darf nicht pauschal als „deutliche Führung“ bezeichnet werden. GLM-5.3-Flash liegt beispielsweise nur etwa 0.27 Punkte über der Referenz; die öffentlich verfügbaren Daten enthalten keine Konfidenzintervalle, die einen solchen Vergleich ausreichend stützen würden. Die folgende Tabelle ist deshalb ausschließlich eine Sensitivitätsanalyse der Schwelle. Diese zusätzlichen Punktstufen sind keine Kriterien für statistische Signifikanz:
| Schwelle (Progress v1) | Anzahl chinesischer Versionen | Anzahl US-Versionen |
|---|---|---|
| Strikt über Opus 4.8 + 0 Punkten | 12 | 21 |
| Strikt über Opus 4.8 + 1 Punkt | 11 | 21 |
| Strikt über Opus 4.8 + 3 Punkten | 5 | 19 |
| Strikt über Opus 4.8 + 5 Punkten | 3 | 17 |
| Strikt über Opus 4.8 + 10 Punkten | 1 | 14 |
Diese Betrachtung erklärt beide Eindrücke zugleich: Es gibt tatsächlich mehr Optionen auf dem Niveau des früheren Spitzenmodells, während die Auswahl deutlich darüber weiterhin überwiegend in der US-Gruppe liegt. Von den 12 chinesischen Versionen über der Schwelle liegen nur 3 mehr als 5 Punkte darüber; in den USA sind es 17. Alle diese Zahlen schließen historische Versionen ein und dürfen nicht als aktueller API-Bestand interpretiert werden.
Wie viele Tage liegen zwischen dem Überschreiten dieser Fähigkeitsschwelle?#
In der aktuellen Progress-v1-Rekonstruktion war GPT-5.5, veröffentlicht am 2026-04-23, die erste US-Version über der Schwelle. Bei China war es Kimi K3 vom 2026-07-16. Zwischen den beiden ersten Überschreitungen liegen 84 Tage. Rechnet man ab dem Veröffentlichungsdatum von Opus 4.8 selbst, dem 2026-05-28, sind es bis Kimi K3 49 Tage.[2]
Es ist kein Widerspruch, dass GPT-5.5 diese rückblickend bestimmte Schwelle früher als Opus 4.8 überschreitet: Progress und die damalige Intelligence-Rangliste unterscheiden sich in Zielsetzung, Anpassung und Sortierung. Die 84 Tage sind lediglich die Differenz zwischen den ersten Überschreitungsdaten für diese eine festgelegte Schwelle und kein Beleg dafür, dass sämtliche chinesischen Modelle insgesamt drei Monate zurückliegen.
Ist der wahrgenommene Unterschied in der Praxis wirklich so groß, wie die Punktzahlen vermuten lassen?#
Dieses Experiment kann beantworten, welche Aufgaben unter den verwendeten Anfragebedingungen erfolgreich geliefert wurden. Es ersetzt keine Bewertung der allgemeinen Zufriedenheit durch Menschen. Wir wählten aktuelle repräsentative Modelle aus den Anthropic-Serien (auf Englisch) und OpenAI-Serien (auf Englisch) und behielten Opus 4.8 als Referenz bei. Die chinesische Gruppe deckte die Kimi-Serien (auf Englisch), Qwen-Serien (auf Englisch), DeepSeek-Serien (auf Englisch) und GLM-Serien (auf Englisch) ab. Dies ist eine gezielte Auswahl und nicht dazu geeignet, eine durchschnittliche nationale Gewinnquote zu schätzen.
Die Tests fanden am 2026-10-29 statt. Alle Anfragen verwendeten den Endpunkt /v1/chat/completions unter https://cn.crazyrouter.com mit reasoning_effort="high", max_tokens=8192, ohne Streaming und ohne Werkzeugaufrufe. Das Lese-Timeout betrug jeweils 180 Sekunden, die Reihenfolge war zufällig und es waren höchstens 4 gleichzeitige Anfragen erlaubt. Dasselbe high-Label bedeutet nicht dieselben internen Rechenressourcen und entspricht auch nicht unbedingt der jeweils höchsten Bewertungsstufe bei AA.
| Aufgabengruppe | Konkrete Aufgaben | Bewertungsgrundlage |
|---|---|---|
| Alltagsaufgaben, 5 Arten | Bestellungen extrahieren und deduplizieren, widersprüchliche Angaben erfassen, chinesische Formatvorgaben einhalten, einen Bestand unter 240 Einträgen lokalisieren, Grenzfälle der Erstattungsregeln bestimmen | Feste Sollwerte, Feldtypen, Textformat |
| Schlussfolgerungen unter Belastung, 3 Arten | Zählen mit zyklischen Bedingungen, Planung mit Abhängigkeiten, kombinatorische Auswahloptimierung | Durch lokale vollständige Suche bestimmte eindeutige optimale Antwort / festgelegte Regel für Gleichstände |
Für ein striktes Bestehen waren ein erfolgreicher HTTP-Aufruf, ein normaler Abschluss sowie eine vollständig den Vorgaben entsprechende Endantwort und Formatierung erforderlich. Wir behielten diese vorab festgelegte Hauptkennzahl bei. Zusätzlich erfolgte eine nachträgliche Sensitivitätsprüfung, bei der lediglich ein äußerer Markdown-Codezaun entfernt wurde; Antworten wurden nicht korrigiert und Aufrufe nicht wiederholt. Die zweite Kennzahl kommt der Frage näher, ob der Inhalt verständlich ist, die erste der Frage, ob ein Programm das Ergebnis unmittelbar übernehmen kann.
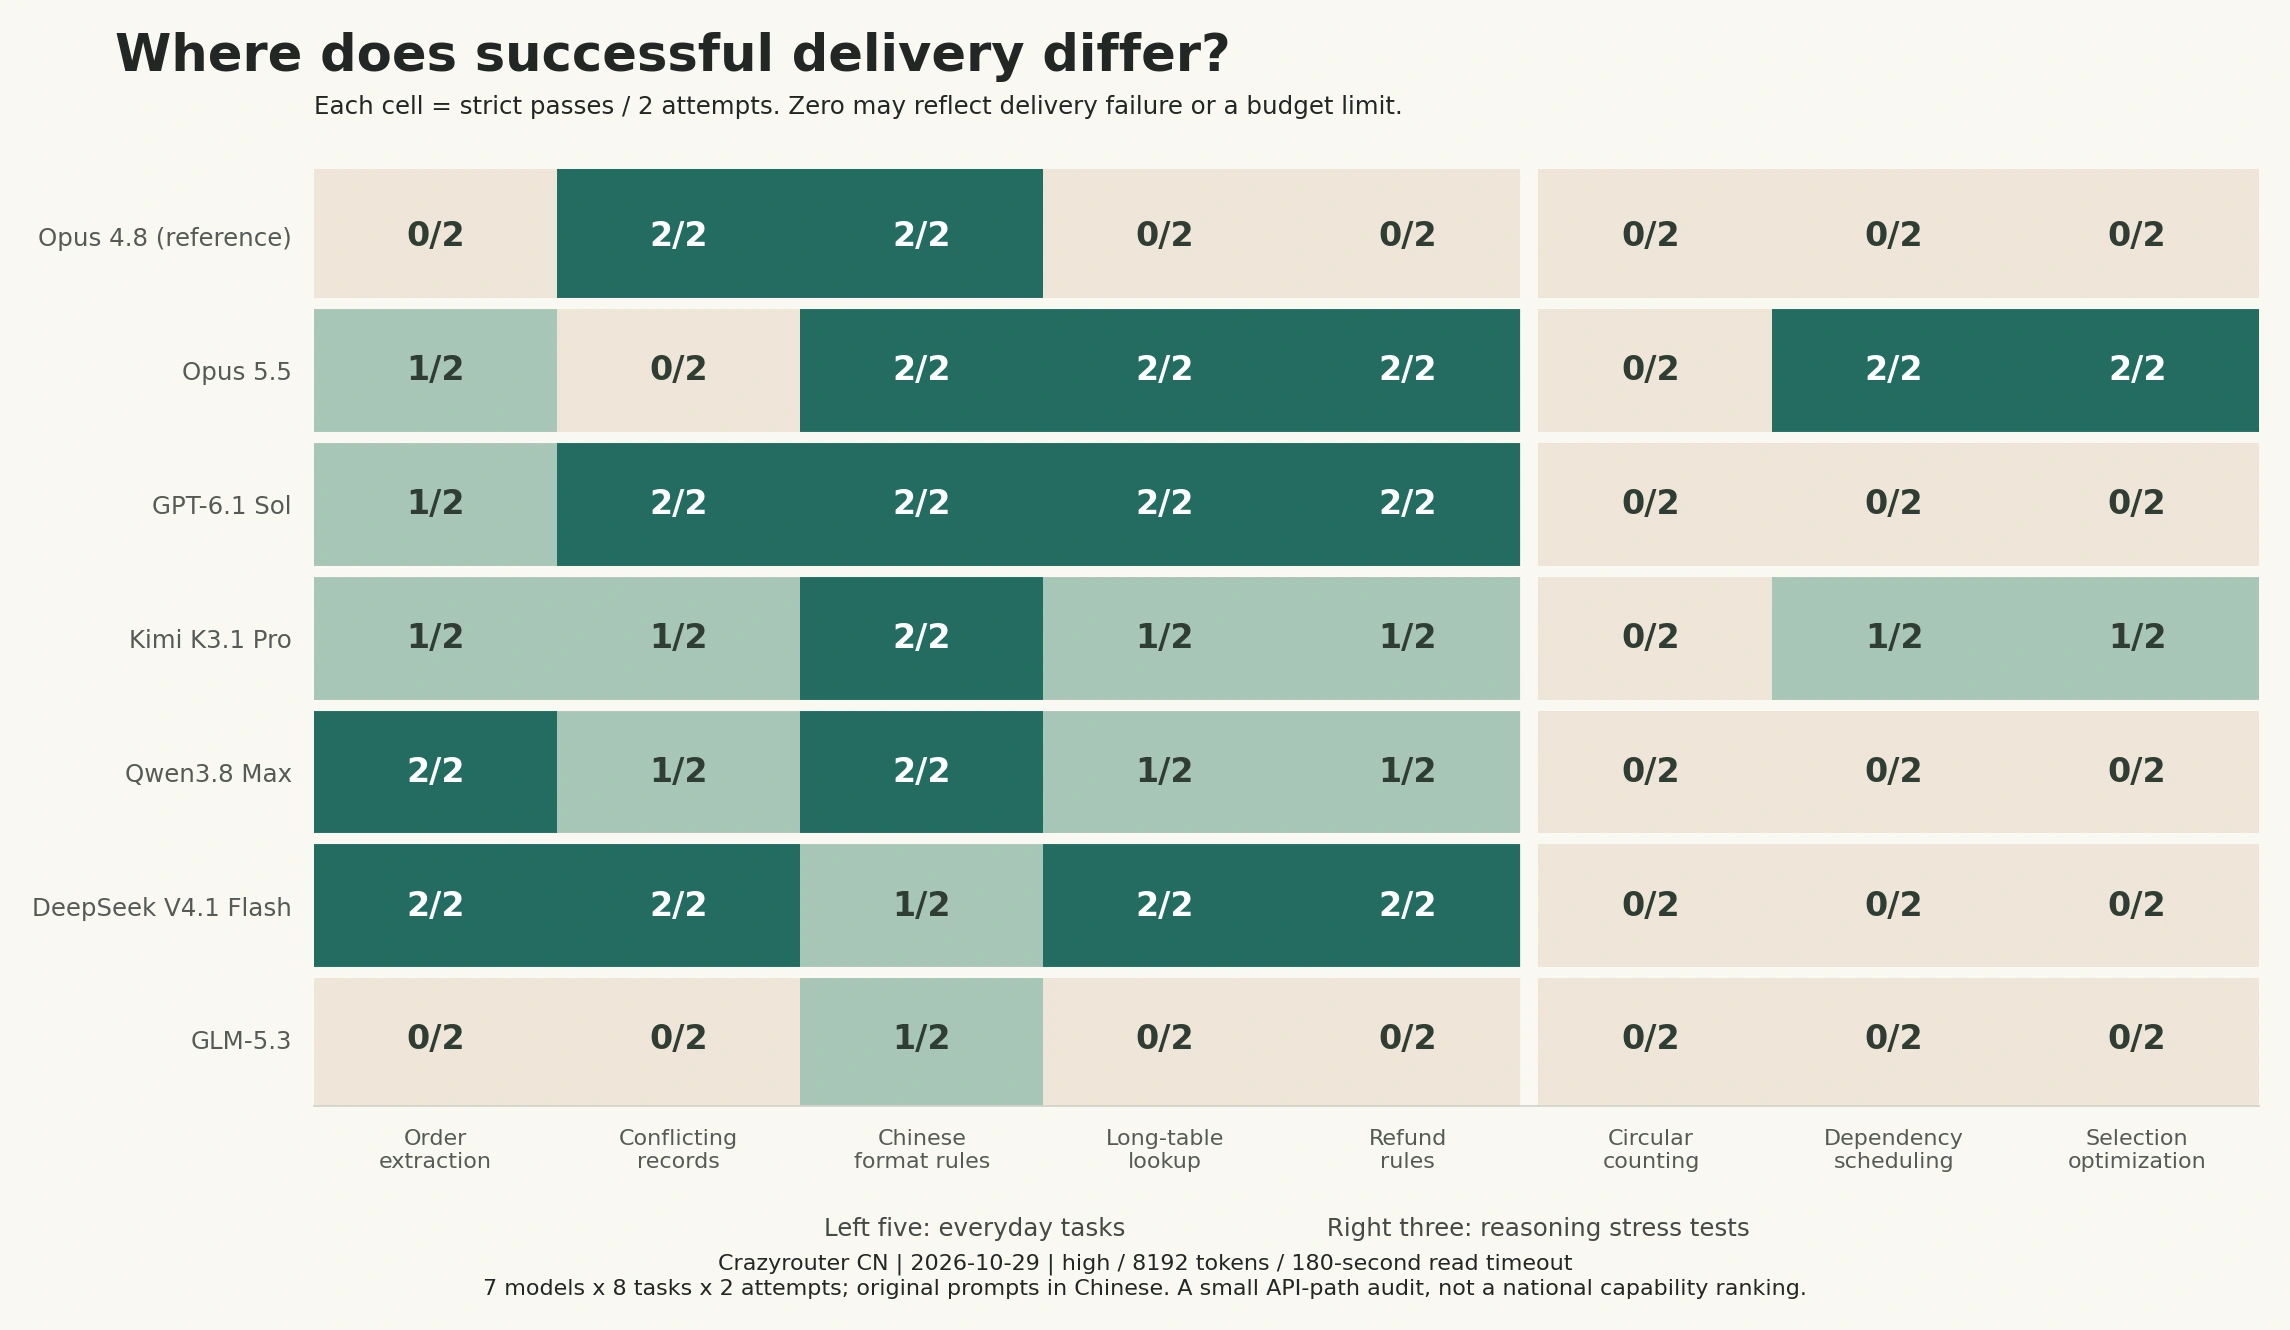
| Angefragtes Modell | Alltag strikt bestanden / 10 | Belastung strikt bestanden / 6 | Insgesamt strikt / 16 | Nach Entfernen eines Codezauns / 16 |
|---|---|---|---|---|
| claude-opus-4-8 | 4/10 | 0/6 | 4/16 | 13/16 |
| claude-opus-5-5 | 7/10 | 4/6 | 11/16 | 16/16 |
| gpt-6.1-sol | 9/10 | 0/6 | 9/16 | 9/16 |
| kimi-k3.1-pro | 6/10 | 2/6 | 8/16 | 8/16 |
| qwen3.8-max | 7/10 | 0/6 | 7/16 | 7/16 |
| deepseek-v4.1-flash | 9/10 | 0/6 | 9/16 | 9/16 |
| glm-5.3 | 1/10 | 0/6 | 1/16 | 1/16 |
Wo zeigen sich die Unterschiede?#
Nehmen wir DeepSeek V4.1 Flash und Opus 5.5 aus diesem Durchlauf: Bei den Alltagsaufgaben lagen die strikt erfolgreichen Lieferungen bei 9/10 beziehungsweise 7/10, bei den Belastungsaufgaben bei 0/6 beziehungsweise 4/6. Dies sind Unterschiede in der Lieferung unter einem festen Budget. Nicht abgeschlossene Aufgaben dürfen nicht durchgehend als „das Modell kann es nicht“ interpretiert werden; insbesondere bei Belastungsaufgaben kann das Ausgabebudget erschöpft sein oder die Aufgabe vor Erreichen der Wartezeitgrenze unvollendet geblieben sein.
Ein weiteres reales Beispiel stammt von Opus 4.8: Bei der Bestellungsextraktion lieferte das Modell die richtigen Felder und Werte, schloss sie jedoch in einen Markdown-Codezaun ein, wodurch die strikte JSON-Prüfung scheiterte. Wer die Antwort in einem Chatfenster liest, empfindet dies möglicherweise nicht als Fehler. Wird das Ergebnis direkt an ein Programm übergeben, ist dagegen ein zusätzlicher Bereinigungsschritt nötig. Dieselbe Ausgabe kann sich bei beiden Nutzungsarten unterschiedlich anfühlen.
Nach dem alleinigen Entfernen eines Codezauns ergeben sich folgende Werte:
| Angefragtes Modell | Alltag: nur Codezaun entfernt / 10 | Belastung: nur Codezaun entfernt / 6 |
|---|---|---|
| claude-opus-4-8 | 10/10 | 3/6 |
| claude-opus-5-5 | 10/10 | 6/6 |
| gpt-6.1-sol | 9/10 | 0/6 |
| kimi-k3.1-pro | 6/10 | 2/6 |
| qwen3.8-max | 7/10 | 0/6 |
| deepseek-v4.1-flash | 9/10 | 0/6 |
| glm-5.3 | 1/10 | 0/6 |
Opus 4.8 und Opus 5.5 erreichen bei den Alltagsaufgaben jeweils 10/10, bei den Belastungsaufgaben dagegen 3/6 beziehungsweise 6/6. Dies liefert ein konkretes Beispiel dafür, dass sich der Vorteil höherer Fähigkeiten vor allem bei schwierigeren Aufgaben zeigen kann. Hier wurden nur 5 Alltagsaufgabenarten und 3 Belastungsaufgabenarten getestet. Zwei Aufrufe derselben Aufgabe gelten nicht als zwei unabhängige Aufgaben; daraus lässt sich nicht beweisen, dass die Alltagsfähigkeiten bereits gleichwertig sind.
Auch Gateway und Versionszuordnung verändern die Erfahrung#
Bei den 112 Anfragen traten 15 HTTP-Fehler, 17 Lese-Timeouts und 7 Budgetabschneidungen auf. Alle diese Aufrufe bleiben im Nenner der Lieferquote bei festem Budget und werden in der folgenden Tabelle gesondert ausgewiesen.
| Angefragtes Modell | HTTP-Fehler | Lese-Timeout nach 180 Sekunden | Budgetabschneidungen | Normal beendete Antworten |
|---|---|---|---|---|
| claude-opus-4-8 | 1 | 0 | 2 | 13 |
| claude-opus-5-5 | 0 | 0 | 0 | 16 |
| gpt-6.1-sol | 5 | 0 | 0 | 11 |
| kimi-k3.1-pro | 6 | 2 | 0 | 8 |
| qwen3.8-max | 1 | 8 | 0 | 7 |
| deepseek-v4.1-flash | 0 | 2 | 5 | 9 |
| glm-5.3 | 2 | 5 | 0 | 9 |
Eine Anfrage an Kimi K3.1 Pro gab beispielsweise provider_authentication_failed zurück. Das zeigt, dass diese Anfrage upstream nicht ordnungsgemäß authentifiziert wurde; sie ist kein Beleg für eine falsche Modellantwort. Ebenso bedeutet ein Lese-Timeout nur, dass der Client nicht rechtzeitig eine vollständige Antwort erhalten hat. Es lässt nicht darauf schließen, dass das Modell selbst langsam gerechnet hat.
| Anfragename | In den gemessenen Antworten vorkommende model-Felder |
|---|---|
| claude-opus-4-8 | claude-opus-4-8 |
| claude-opus-5-5 | claude-opus-5-5 |
| gpt-6.1-sol | gpt-6.1-sol |
| kimi-k3.1-pro | kimi-k3.1-pro |
| qwen3.8-max | qwen3.8-max |
| deepseek-v4.1-flash | deepseek-v4.1-flash、deepseek-v4.1-flash-1017、deepseek/deepseek-flash |
| glm-5.3 | glm-5.3 |
Das model-Feld einer Antwort ist lediglich eine Angabe des Servers und kein unabhängiger Nachweis der Identität der Gewichte. Insbesondere lieferte derselbe DeepSeek-Anfragename verschiedene Versionen beziehungsweise Aliase zurück. In diesem Durchlauf kann daher nicht gewährleistet werden, dass alle Anfragen exakt derselben Veröffentlichungsversion bei AA entsprachen. Diese Ergebnisse sind deshalb als Lieferungsaudit des verwendeten API-Pfads zu verstehen. Sie dürfen nicht fest mit AA-Werten verknüpft werden, um Korrelationskoeffizienten zu berechnen, und schon gar nicht, um zu erklären, die Modelle eines Landes seien insgesamt stärker oder gleichwertig.
Auf dem GLM-5.3-Pfad traten außerdem Antworten mit zusätzlichem Text nach dem JSON, wiederholten Antworten und anomalen Markierungen auf. Wir bewahren die Originalbelege auf, können jedoch nicht bestimmen, ob die Anomalien vom Modell, vom Template oder von der Upstream-Anpassung stammen. Gerade die niedrige Zahl strikter Lieferungen eignet sich daher nicht als Grundlage für Aussagen über die Fähigkeiten des Basismodells. Um bessere Ergebnisse zu erzielen, wurde in diesem Durchlauf weder der Kanal geändert noch wurden fehlgeschlagene Anfragen durch Wiederholungen ersetzt.
Wir haben weder einen Blindtest mit Menschen noch eine Stichprobe realer Produktionsaufgaben, einen Langzeit-Lasttest oder eine mehrstufige Agent-Bewertung mit gleichem Budget durchgeführt. Für die Frage, ob sich die Modelle insgesamt gleich gut anfühlen, reichen die Belege daher nicht aus. Belegt ist bereits, dass Aufgabenart, Ausgabeformat, Anfragebudget und Servicepfad dazu führen können, dass die praktische Erfahrung von der Reihenfolge einer einzelnen Rangliste abweicht.
Wer aktualisiert schneller? Veröffentlichungszahl und Fähigkeitsfortschritte getrennt betrachten#
Im Folgenden werden eigenständige Veröffentlichungsversionen in der von AA erfassten Stichprobe gezählt, nicht sämtliche Modellveröffentlichungen beider Länder in einer vollständigen Bestandsaufnahme. Mehrere Inferenzstufen einer Version zählen nur einmal. Eine Verbesserung der Spitze wird nach dem Datum gezählt, an dem sie eintritt; mehrere Versionen am selben Tag werden nicht mehrfach gezählt.
| Monat 2026 | Chinesische Veröffentlichungsversionen | US-Veröffentlichungsversionen | Tage mit neuer chinesischer Spitze | Tage mit neuer US-Spitze |
|---|---|---|---|---|
| 2026-01 | 5 | 4 | 1 | 0 |
| 2026-02 | 9 | 7 | 1 | 1 |
| 2026-03 | 12 | 9 | 0 | 1 |
| 2026-04 | 16 | 15 | 3 | 2 |
| 2026-05 | 6 | 4 | 0 | 0 |
| 2026-06 | 6 | 7 | 1 | 1 |
| 2026-07 | 5 | 10 | 2 | 2 |
| 2026-08 | 11 | 10 | 1 | 0 |
| 2026-09 | 8 | 13 | 1 | 3 |
| 2026-10 (bis zum 29.) | 5 | 10 | 2 | 1 |
Vom 2026-01-01 bis zum 2026-10-29 umfasste die Stichprobe 83 chinesische und 89 US-Veröffentlichungsversionen. In den letzten 90 Kalendertagen, vom 2026-08-01 bis zum 2026-10-29 einschließlich beider Enddaten, waren es 24 beziehungsweise 33. Dennoch verbesserte jede Gruppe ihre eigene Progress-Spitze nur an jeweils 4 Tagen. Mehr Veröffentlichungen bedeuten also nicht automatisch größere Verbesserungen der höchsten Fähigkeiten.[2]
Zum Zeitpunkt dieses Schnappschusses erfolgte die letzte Verbesserung der chinesischen Spitze durch Kimi K3.1 Pro am 2026-10-23 und die der US-Spitze durch Gemini 4 Carbon am 2026-10-28. Die Daten wurden am 2026-10-29 erfasst; dieses Erfassungsdatum darf nicht als Modellaktualisierungsdatum bezeichnet werden. Die AA-API stellt kein vollständiges historisches Änderungsprotokoll der Bewertungen jedes Modells bereit, und wir erfinden ein solches Feld nicht.
Wie lassen sich die Ergebnisse nachrechnen, und wie sollte die nächste Runde die praktische Erfahrung prüfen?#
Im Forschungsarchiv der Redaktion liegen die API-Antworten der vier AA-Seiten, die Daten der öffentlichen Trenddiagramme, die zusammengeführte CSV-Datei mit 517 Zeilen, die Statistikskripte, die Sollwerte der Aufgaben sowie alle 112 Aufrufe und deren Zusammenfassungen. Die Statistiken im offiziellen Blog stammen ausschließlich aus diesen eingefrorenen Aufzeichnungen. Quelle ist Artificial Analysis; die Aggregationsberechnungen und die praktischen Tests über den Crazyrouter-Pfad wurden für diesen Beitrag durchgeführt.
Die zentralen Berechnungen lassen sich anhand des folgenden Pseudocodes nachvollziehen:
# One snapshot and metric version.
# Use AA release_id, not guessed names.
release_score = max(non_null_scores_for_each_release)
baseline = progress_score_of_opus_4_8_max
above_baseline = release_score > baseline
frontier_at_date = max(scores_of_releases_available_by_date)
gap_at_date = us_frontier_at_date - cn_frontier_at_date
Bei der Aufgabe zur Bestellungsextraktion lautet die Antwort-ID von Opus 4.8 beispielsweise msg_011CgWecKv2YBwoHYumCeURh. Der Aufruf endete mit HTTP 200 und regulär; die ursprüngliche Antwort bestand aus korrektem JSON innerhalb eines Codezauns. Sie scheiterte daher an der strikten Prüfung und bestand die Sensitivitätsprüfung des Formats. Die Anfrage-ID des fehlgeschlagenen Kimi-Authentifizierungsaufrufs lautet 608ccc90b353423d036dca779cafcc37. Diese beiden Datensätze verdeutlichen den Unterschied zwischen „Ergebnis erhalten, aber Format nicht konform“ und „keine Modellantwort erhalten“.
Das folgende Beispiel wiederholt eine Aufgabe mit Geschäftsregeln. Der API-Schlüssel wird ausschließlich aus einer Umgebungsvariable gelesen, und der Endpunkt enthält keine UTM-Parameter:
import os
import requests

endpoint = "https://cn.crazyrouter.com" + "/v1/chat/completions"
user_content = (
    "\u672a\u62c6\u5c01\u4e14\u7b7e\u6536" "\u6b21\u65e5\u8d777\u65e5\u5185" "\u53ef\u9000\u6b3e\uff1b\u7b2c7" "\u65e5\u5305\u542b\u5728\u5185\u3002"
    "A\u57282026" "-10-20" "\u7b7e\u6536\uff0c202" "6-10-2" "7\u7533\u8bf7\u9000\u6b3e\uff0c"
    "\u65e0\u8d28\u91cf\u7f3a\u9677\u3002" "\u53ea\u8f93\u51faJSO" "N\uff0c\u952eeli" "gible\u4e3a" "\u5e03\u5c14\u503c\u3002"
)

response = requests.post(
    endpoint,
    headers={"Authorization": "Bearer " + os.environ["CRAZYROUTER_API_KEY"]},
    json={
        "model": "claude-opus-4-8",
        "messages": [{"role": "user", "content": user_content}],
        "reasoning_effort": "high", "max_tokens": 8192, "stream": False,
    },
    timeout=(15, 180),
)
response.raise_for_status()
print(response.json())
Dies ist ein vereinfachtes Reproduktionsbeispiel für den Fließtext und keine der vollständigen Originalaufgaben aus den 112 offiziellen Tests. Die vollständigen 8 Aufgaben, Bewertungsskripte und Originalaufzeichnungen sind im Redaktionsarchiv hinterlegt; dieser Beitrag bietet keinen öffentlichen Download des vollständigen Forschungspakets. Die vereinfachte Aufgabe wurde nicht verwendet, um offizielle Ergebnisse zu ergänzen oder zu ersetzen.
available_by_date bedeutet hier lediglich, dass das Veröffentlichungsdatum nicht nach dem jeweiligen Tag liegt; ein öffentlicher API-Zugang an diesem Tag ist damit nicht garantiert. Fehlende Werte werden nicht mit null aufgefüllt, und ein Punkt wird nicht als fester Prozentsatz behandelt. Die Länderzuordnung folgt den AA-Labels der Entwicklungsorganisationen. Google wird der von AA markierten US-Gruppe zugeordnet; Serverstandort oder Staatsangehörigkeit der Beschäftigten sind nicht maßgeblich.[1][3]
Um „gleichwertige praktische Erfahrung“ in der nächsten Runde tatsächlich zu prüfen, sollten zunächst drei Kategorien von Zielnutzeraufgaben und akzeptable Unterschiede festgelegt werden. Anschließend wären anonyme paarweise Blindtests mit randomisierter Links-rechts-Reihenfolge durchzuführen. Die Hauptkennzahlen sollten Qualität der Aufgabenerfüllung, schwerwiegende Fehler, manuellen Nacharbeitsaufwand und Präferenz umfassen; die Ausfallquote der Aufrufe ist separat auszuweisen. Äquivalenzgrenzen und Stichprobenumfang sind vor der Auswertung festzulegen, und die Analyse sollte nach Aufgaben clustern. „Kein signifikanter Unterschied festgestellt“ darf nicht mit „gleiche Erfahrung“ gleichgesetzt werden.
Welche Themen plant diese Serie als Nächstes?#
Dieser Beitrag hat zunächst untersucht, worin sich Punkteabstände, die Schwelle eines früheren Spitzenmodells und die tatsächliche Lieferung unterscheiden. Künftige Beiträge werden nach Fähigkeitsarten gegliedert und jeweils geeignete Benchmarks, feste Budgets und reale API-Tests verwenden. Werte aus verschiedenen Modalitäten werden nicht zu einem „nationalen Gesamtwert“ zusammengesetzt. Die folgende Liste ist eine Themenplanung; die späteren Beiträge sind noch nicht veröffentlicht.
| Beitrag | Geplantes Thema | Zentrale Frage |
|---|---|---|
| Erster Beitrag · Textmodelle | Wie groß ist der Abstand bei Alltagsaufgaben nach dem Überschreiten der Spitzenmodellschwelle? | Unterschiede bei chinesischem Schreiben, strukturierter Ausgabe, langen Dokumenten, Faktentreue und menschlichen Blindtests |
| Zweiter Beitrag · Programmierung und Agenten | Können Modelle, die antworten, auch Aufgaben vollständig erledigen? | Codeänderungen, bestandene Tests, Werkzeugaufrufe, mehrstufige Aufgaben, Abschlussquote innerhalb des Budgets |
| Dritter Beitrag · Bildmodelle | Wer erfüllt die Vorgaben jenseits eines ansprechenden Aussehens besser? | Text-zu-Bild, Bildbearbeitung, chinesische Schrift, Motivkonsistenz und Stabilität über mehrere Generierungen |
| Vierter Beitrag · Videomodelle | Funktionieren Bewegung und Erzählung nach einem beeindruckenden Einzelbild? | Text-zu-Video, Bild-zu-Video, Bewegungs- und physikalische Konsistenz, Figurenkontinuität und Wartezeit bis zum fertigen Film |
| Fünfter Beitrag · Sprachmodelle | Wie genau ist das Verstehen, wie natürlich das Sprechen und wie gut folgt der Dialog? | Spracherkennung, Sprachsynthese und Echtzeitsprache getrennt messen, einschließlich Akzenten und Latenz |
| Sechster Beitrag · Vektoren und Reranking | Wo liegen die Unterschiede in der Qualität von Wissensdatenbanken? | Chinesische und sprachübergreifende Suche, lange Dokumente, Recall@k, nDCG, Gewinn durch Reranking und Indexierungskosten |
| Siebter Beitrag · Gesamtauswahl | Wie lassen sich verschiedene Modelle bei gleichem Budget kombinieren? | Zusammenführung der vorangegangenen Praxistests zu Entscheidungen über Qualität, Wartezeit, Kosten und Zuverlässigkeit für konkrete Szenarien |
Jeder Beitrag behält die drei Fragen bei: Wer steht an der Spitze, wer überschreitet eine praktisch relevante Schwelle, und wirkt sich der Abstand auf reale Aufgaben aus? Die Schwelle wird jedoch durch ein Referenzmodell der jeweiligen Modalität oder durch geschäftliche Abnahmebedingungen definiert. Opus 4.8 kann beispielsweise als Textreferenz dieses Beitrags dienen, aber nicht als allgemeine Schwelle für Bild-, Sprach- oder Vektormodelle.
Häufige Fragen#
Wie weit liegen chinesische und US-amerikanische KI-Modelle wirklich auseinander?#
In diesem Schnappschuss führen die USA an der Spitze des AA Intelligence v5 mit 13.4 Punkten; beim gemeinsamen Progress-v1-Maßstab beträgt der Spitzenabstand 10.94 Punkte. Die beiden Messgrößen verfolgen unterschiedliche Ziele, und keine lässt sich unmittelbar in einen prozentualen Fähigkeitsunterschied oder eine Differenz der Nutzerzufriedenheit umrechnen.
Wird der Abstand immer größer?#
Die aktuellen rückblickenden Daten stützen kein „kontinuierliches Auseinanderdriften“. Ende September 2026 betrug der Abstand 27.61, am 2026-10-29 dagegen 10.94; zwischenzeitlich verringerte er sich mit neuen Modellveröffentlichungen deutlich. Das Aufholen an der Spitze bedeutet jedoch nicht, dass die führenden Modellgruppen bereits gleich breit sind.
Wie viele chinesische Modelle liegen bereits über Opus 4.8?#
Nach Progress v1, gezählt als eigenständige Veröffentlichungsversionen und strikt über Opus 4.8(max), sind es 12, einschließlich historischer Versionen. Davon sind 9 bei AA nicht als deprecated markiert. Das Überschreiten einer Bewertungsreferenz garantiert nicht, dass das Modell bei jeder Ihrer Aufgaben besser ist.
Warum werden die 61.4 Punkte von Opus 4.8 nicht verwendet?#
61.4 stammt aus dem alten Intelligence Index zum Zeitpunkt der Veröffentlichung; in der aktuellen v5-Runde besitzt das Modell keinen Gesamtwert. Verglichen werden muss mit demselben Maßstab, ein historischer Wert darf nicht direkt auf die neue Rangliste angewendet werden.
Sind chinesische Modelle für den Alltag bereits ausreichend gut?#
Eine einheitliche Antwort lässt sich nicht allein anhand des Landes geben. Einige Modelle konnten in diesem Durchlauf Alltagsaufgaben erledigen, doch Gateway-Fehler, Formatunterschiede und Budgetabschneidungen veränderten die Ergebnisse ebenfalls. Ausgehend von den eigenen Aufgaben und der akzeptablen Ausfallquote sollten ein konkretes Modell und ein zuverlässiger Aufrufpfad gewählt werden.
Beweist dieser Test, dass sich chinesische und US-Modelle gleich anfühlen?#
Nein. Getestet wurden nur 8 synthetische Aufgabenarten mit jeweils 2 Aufrufen. Bei einigen Anfragen traten zudem Versionsaliase und Pfadprobleme auf, und es gab keinen Blindtest mit Menschen. Der Test zeigt konkrete Gründe, warum Rangliste und Erfahrung auseinanderfallen können; er beweist keine allgemeine Gleichwertigkeit.
Was unterscheidet Veröffentlichungsversion, Modellkonfiguration und API-Name?#
Eine AA-Veröffentlichungsversion kann mehrere Inferenzstufen besitzen, und ein Gateway kann Aliase verwenden oder fortlaufend auf neue Versionen aktualisieren. Für die Rangliste wird nach Veröffentlichungsversionen dedupliziert; im Praxistest bleiben der tatsächliche Anfragename und das zurückgegebene model-Feld erhalten. Beide entsprechen einander nicht automatisch eins zu eins.
Referenzen#
- Artificial Analysis Data API: Felder, Paginierung, Versionen und Definition fehlender Werte. Vollständige Erfassung am 2026-10-29; die API meldet Intelligence Version 5.
- Artificial Analysis AI Trends: Progress, Länderzuordnung und Veröffentlichungsversionen. Anonymer öffentlicher Seitenschnappschuss vom 2026-10-29; die Statistiken im Text sind Neuberechnungen des Autors auf Grundlage dieses Schnappschusses.
- Methodik des Artificial Analysis Progress Index v1. IRT-Skala, Stufen und Grenzen historischer Vergleiche.
- AA-Ankündigung des Intelligence Index v5, 2026-10-27. Dient der Erläuterung der Bewertungsänderungen, nicht als Ersatz für die aktuelle Rangliste vom 2026-10-29.
- Methodik und Versionshinweise zum AA Intelligence Index.
- AA-Bewertung zur Veröffentlichung von Opus 4.8, 2026-05-28 und aktuelle Modellseite.
- Offizielle Anthropic-Seite zur Veröffentlichung von Opus 4.8.
Die Begriffe „über“ und „führend“ beziehen sich in diesem Beitrag stets auf den ausdrücklich genannten Maßstab und die erfasste Stichprobe; sie bedeuten keine statistische Signifikanz. Nach nachträglichen Tests, Korrekturen oder neu hinzugefügten Modellen bei AA müssen die Ergebnisse neu berechnet werden.