简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
GPT-6.2 Astra vs. GPT-6 Astra — vale a pena atualizar após 32 testes?
Mesmo canal e prompts, 16 testes por modelo, mesma taxa de acerto. Veja tempos na otimização e no geral, preços oficiais, custos reais e quando migrar.
Se você já usa o GPT-6 Astra, a chegada do GPT-6.2 Astra costuma levantar três perguntas. Ele consegue acertar tarefas que o modelo anterior errava? A espera vai diminuir? A conta vai subir?
Nesta rodada de 32 testes pelo mesmo canal da Crazyrouter, os dois modelos acertaram 16/16 questões por inteiro. O GPT-6.2 Astra reduziu em 54.3% o tempo médio na questão de otimização com restrições, mas teve um tempo mediano maior no conjunto de requisições e custou 37.6% a mais. Para quem já usa o GPT-6 Astra, os resultados indicam que vale testar o novo modelo em tarefas específicas antes de decidir se ele deve virar o padrão.
O teste usou uma amostra pequena de tarefas do dia a dia de desenvolvimento. Conferimos as especificações oficiais, a configuração de cobrança atual do site e o valor efetivamente debitado por requisição. Os três pontos são apresentados separadamente a seguir.
O que mudou nas especificações oficiais?#
Em 20 de novembro de 2026, as páginas da OpenAI para os dois modelos apresentavam as seguintes informações principais.[1][2]
| Item | GPT-6.2 Astra | GPT-6 Astra |
|---|---|---|
| Nome do modelo na API | gpt-6.2-astra | gpt-6-astra |
| Modalidades de entrada e saída | Entrada de texto e imagem, saída de texto | Entrada de texto e imagem, saída de texto |
| Janela de contexto | 1,050,000 tokens | 1,050,000 tokens |
| Limite de entrada | 922,000 tokens | 922,000 tokens |
| Limite de saída | 128,000 tokens | 128,000 tokens |
| Data de corte do conhecimento | 2026-05-18 | 2026-04-30 |
| Preço oficial de entrada sem cache | $8 / milhão de tokens | $10 / milhão de tokens |
| Preço oficial de leitura do cache | $0.40 / milhão de tokens | $1 / milhão de tokens |
| Preço oficial de saída | $40 / milhão de tokens | $50 / milhão de tokens |
Os preços da tabela seguem a faixa oficial Standard para entradas de até 272K tokens. Acima desse limite, as tarifas de entrada e leitura do cache dobram nos dois modelos, e a tarifa de saída passa a 1.5 vez o valor da tabela. Por isso, os valores acima não se aplicam a todas as requisições longas.[1][2]
As tarifas oficiais de entrada sem cache e de saída do 6.2 Astra caíram 20%, e a janela de contexto declarada continua do mesmo tamanho. Uma data de corte mais recente também não dá ao modelo acesso a informações em tempo real posteriores a ela.
A documentação oficial também lista recursos de ferramentas e da Responses API. Aqui, testamos chamadas de texto via Chat Completions neste site. A lista oficial de recursos não comprova que todos os endpoints do site foram testados com sucesso.
Como testamos no mesmo canal, com 8 tipos de tarefa e duas rodadas por questão#
O teste foi executado na madrugada de 20 de novembro de 2026, no horário de Pequim, correspondente a 19 de novembro de 2026 em UTC. Antes do teste principal, verificamos os dois modelos via /v1/models.
| Condição | Configuração do teste |
|---|---|
| Ponto de acesso | Crazyrouter, https://api.crazyrouter.com/v1 |
| Endpoint | POST /chat/completions |
| Roteamento | Mesmo canal de upstream fixado e confirmado individualmente nos 32 registros de consumo |
| Prompts | Mensagens system e user idênticas para a mesma questão |
| Nível de raciocínio | reasoning_effort: high |
| Limite de saída | max_completion_tokens: 8192 |
| Modo de resposta | Sem streaming, stream: false |
| Amostra e ordem | 8 tipos de tarefa × 2 execuções por modelo, em ordem aleatória, com concorrência total de 2 |
| Avaliação | Gabarito definido previamente, comparação do JSON campo a campo e exigência de HTTP 200 e finish_reason=stop |
As tarefas incluíram busca em 360 regras, verificação de uma premissa incorreta, otimização em um grafo de dependências, seleção de subconjuntos com restrições, reprocessamento de cobranças, visibilidade de transações, ordem da deduplicação e limites de intervalos. As seis primeiras questões vieram de um conjunto interno de testes anteriores. As duas últimas foram acrescentadas para cobrir casos de borda. As entradas e os gabaritos foram preservados nos arquivos de evidências. Os gabaritos não foram enviados aos modelos.
As tarefas refletem trabalhos comuns de desenvolvimento, como interpretar regras, calcular resultados e identificar casos de borda. O teste não abrangeu alterações em repositórios completos nem executou programas gerados pelos modelos. Por isso, ele não serve de base para um ranking completo de agentes de programação.
O tempo foi medido desde o envio da requisição pelo cliente até o recebimento da resposta completa. A medição inclui rede, fila, inferência e geração da saída. O tempo até o primeiro token e a taxa em tokens/s ficaram fora dessa medição.
Os modelos empataram em acertos. Em quais questões a velocidade mais variou?#
| Tarefa | Acertos do 6.2 Astra | Acertos do 6 Astra | Tempo médio do 6.2 | Tempo médio do 6 |
|---|---|---|---|---|
| Busca em uma tabela extensa de regras | 2/2 | 2/2 | 10.05 segundos | 10.20 segundos |
| Correção de uma premissa incorreta | 2/2 | 2/2 | 9.95 segundos | 7.16 segundos |
| Grafo de dependências e otimização de um único ponto | 2/2 | 2/2 | 9.05 segundos | 8.42 segundos |
| Seleção do subconjunto ótimo com restrições | 2/2 | 2/2 | 18.49 segundos | 40.46 segundos |
| Deduplicação e reprocessamento de cobranças | 2/2 | 2/2 | 10.28 segundos | 10.41 segundos |
| Visibilidade de transações no banco de dados | 2/2 | 2/2 | 4.94 segundos | 9.66 segundos |
| Deduplicação antes do filtro de tempo | 2/2 | 2/2 | 3.81 segundos | 7.18 segundos |
| Raciocínio sobre limites de intervalos semiabertos | 2/2 | 2/2 | 4.12 segundos | 7.08 segundos |
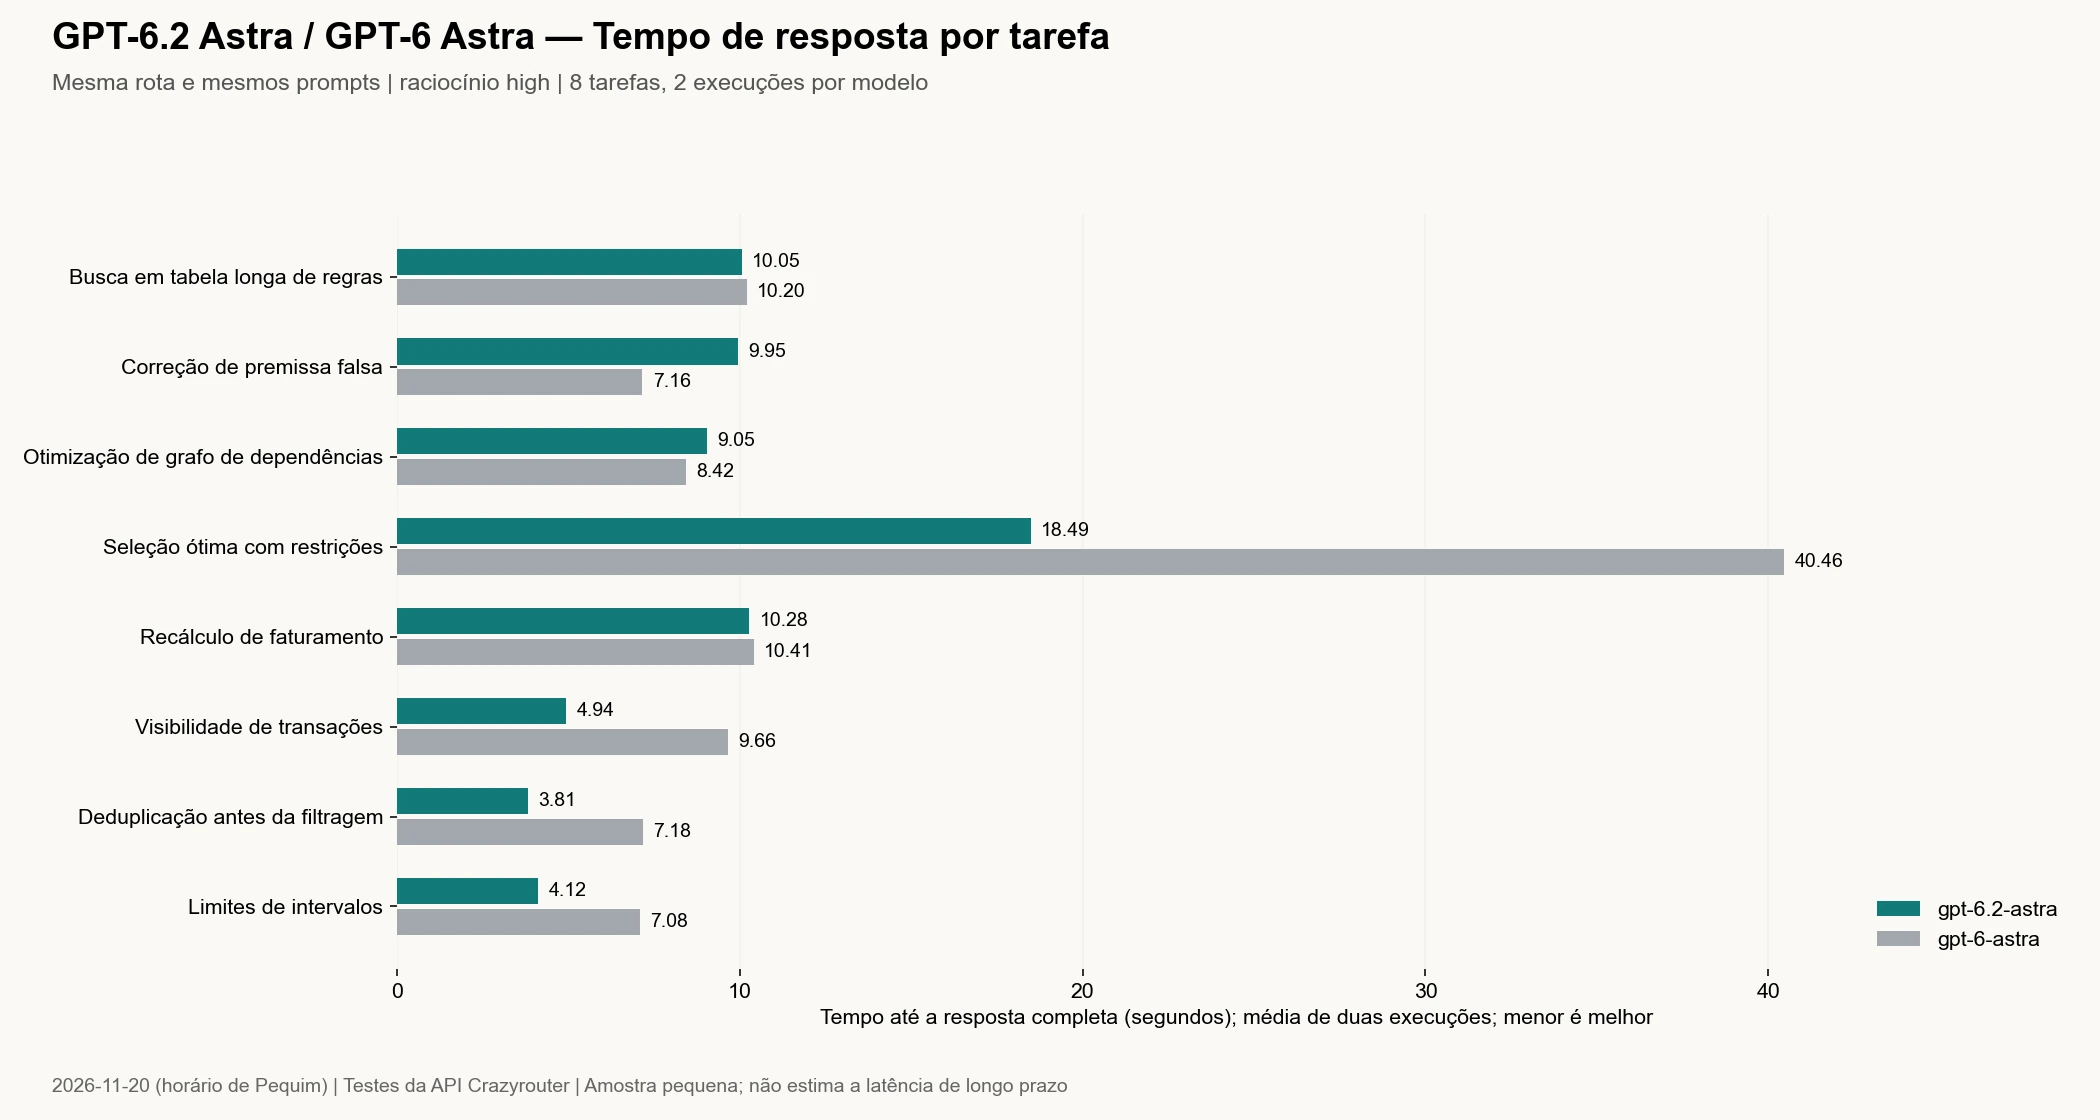
Cada célula se baseia em apenas duas requisições. Diferenças pequenas não indicam uma vantagem consistente. Nas questões desta rodada, ambos os modelos retornaram JSON completo e de acordo com o gabarito.
A maior diferença apareceu na seleção de subconjuntos com restrições. A questão apresentava 12 itens candidatos e pedia todas as soluções ótimas que respeitassem simultaneamente o peso total, o número máximo de itens selecionados, as dependências e as condições de exclusão mútua. Os dois modelos encontraram o único conjunto ótimo, [0, 2, 6, 9, 11], com valor total de 78.
O 6.2 Astra levou 18.21 e 18.78 segundos nas duas rodadas. O 6 Astra levou 37.52 e 43.41 segundos. Nessa questão, a espera média caiu 54.3%, o que torna tarefas semelhantes de otimização combinatória candidatas a um teste com o novo modelo. Duas rodadas, porém, não permitem afirmar que “todo raciocínio complexo é duas vezes mais rápido”.
A questão de deduplicação verificava outro erro comum. A primeira ocorrência de um evento estava fora da janela de tempo, e uma ocorrência posterior com o mesmo ID estava dentro dela. A questão exigia deduplicar globalmente antes de filtrar por tempo, de modo que a ocorrência duplicada posterior não poderia voltar a entrar no cálculo. Os dois modelos chegaram corretamente ao saldo líquido de 25 centavos para Alice e excluíram Bob, cujo saldo final era zero.
Os casos de borda deste conjunto não produziram diferença na taxa de acerto. O placar de 16/16 contra 16/16 só mostra que os dois modelos passaram neste conjunto de tarefas. Ele não demonstra que o limite de capacidade dos dois seja igual.
Por que a média caiu, mas a mediana subiu?#
| Estatística das 16 requisições de cada modelo | GPT-6.2 Astra | GPT-6 Astra |
|---|---|---|
| Respostas completas e corretas | 16/16 | 16/16 |
| Tempo médio | 8.84 segundos | 12.57 segundos |
| Tempo mediano | 9.57 segundos | 8.16 segundos |
| Menor / maior tempo | 3.39 / 18.78 segundos | 6.67 / 43.41 segundos |
As duas estatísticas estão corretas. O GPT-6 Astra teve duas requisições bem mais demoradas na seleção de subconjuntos com restrições, o que puxou a média para cima. O 6.2 Astra reduziu a espera nessas duas requisições e, com isso, teve uma média geral menor.
Ao ordenar todas as requisições por duração, a posição central fica em cerca de 9.57 segundos para o 6.2 Astra e em cerca de 8.16 segundos para o 6 Astra. O 6.2 Astra também não foi mais rápido nas questões sobre premissa incorreta e grafo de dependências.
Na hora de escolher o modelo, considere cada tipo de tarefa. Se a maior parte da espera vem da otimização combinatória, a redução na média faz diferença na prática. Se a maioria das requisições do dia a dia consiste em perguntas curtas sobre regras, estes dados não sustentam uma troca geral de modelo.
Os preços oficiais caíram, mas a cobrança nesta rodada foi maior no site#
A tarifa oficial difere do que os usuários deste site pagam na prática. Na configuração do grupo default da Crazyrouter consultada para o teste, o GPT-6 Astra tinha 35% de desconto (pagamento de 65% da tarifa), e para o GPT-6.2 Astra valia a tarifa integral. Para requisições com entrada de até 272K tokens, as tarifas após a aplicação do desconto eram as seguintes.
| Tarifa no site por milhão de tokens | GPT-6.2 Astra | GPT-6 Astra |
|---|---|---|
| Entrada sem cache | $8.00 | $6.50 |
| Leitura do cache | $0.40 | $0.65 |
| Saída | $40.00 | $32.50 |
Assim, o 6.2 Astra tem hoje a menor tarifa de leitura do cache, e o 6 Astra tem as menores tarifas de entrada sem cache e de saída. A redução oficial de preço da nova versão, por si só, não determina qual modelo sai mais barato neste site. Mudanças de grupo ou de desconto afetam o resultado. Antes de contratar ou integrar os modelos, confira novamente a página de preços do site.
Localizamos os 32 registros de consumo efetivo pelo ID de cada requisição e usamos o valor de quota_per_unit=500000 do site para converter os débitos em dólares.
| Uso efetivo no teste principal | GPT-6.2 Astra | GPT-6 Astra |
|---|---|---|
| Número de requisições | 16 | 16 |
| Tokens de entrada reportados pelo upstream | 128,692 | 108,708 |
| Tokens de leitura do cache incluídos na entrada | 49,536 | 48,512 |
| Proporção da entrada lida do cache | 38.5% | 44.6% |
| Tokens de saída (incluindo o consumo de raciocínio) | 2,625 | 3,946 |
| Custo efetivo | $0.758064 | $0.551052 |
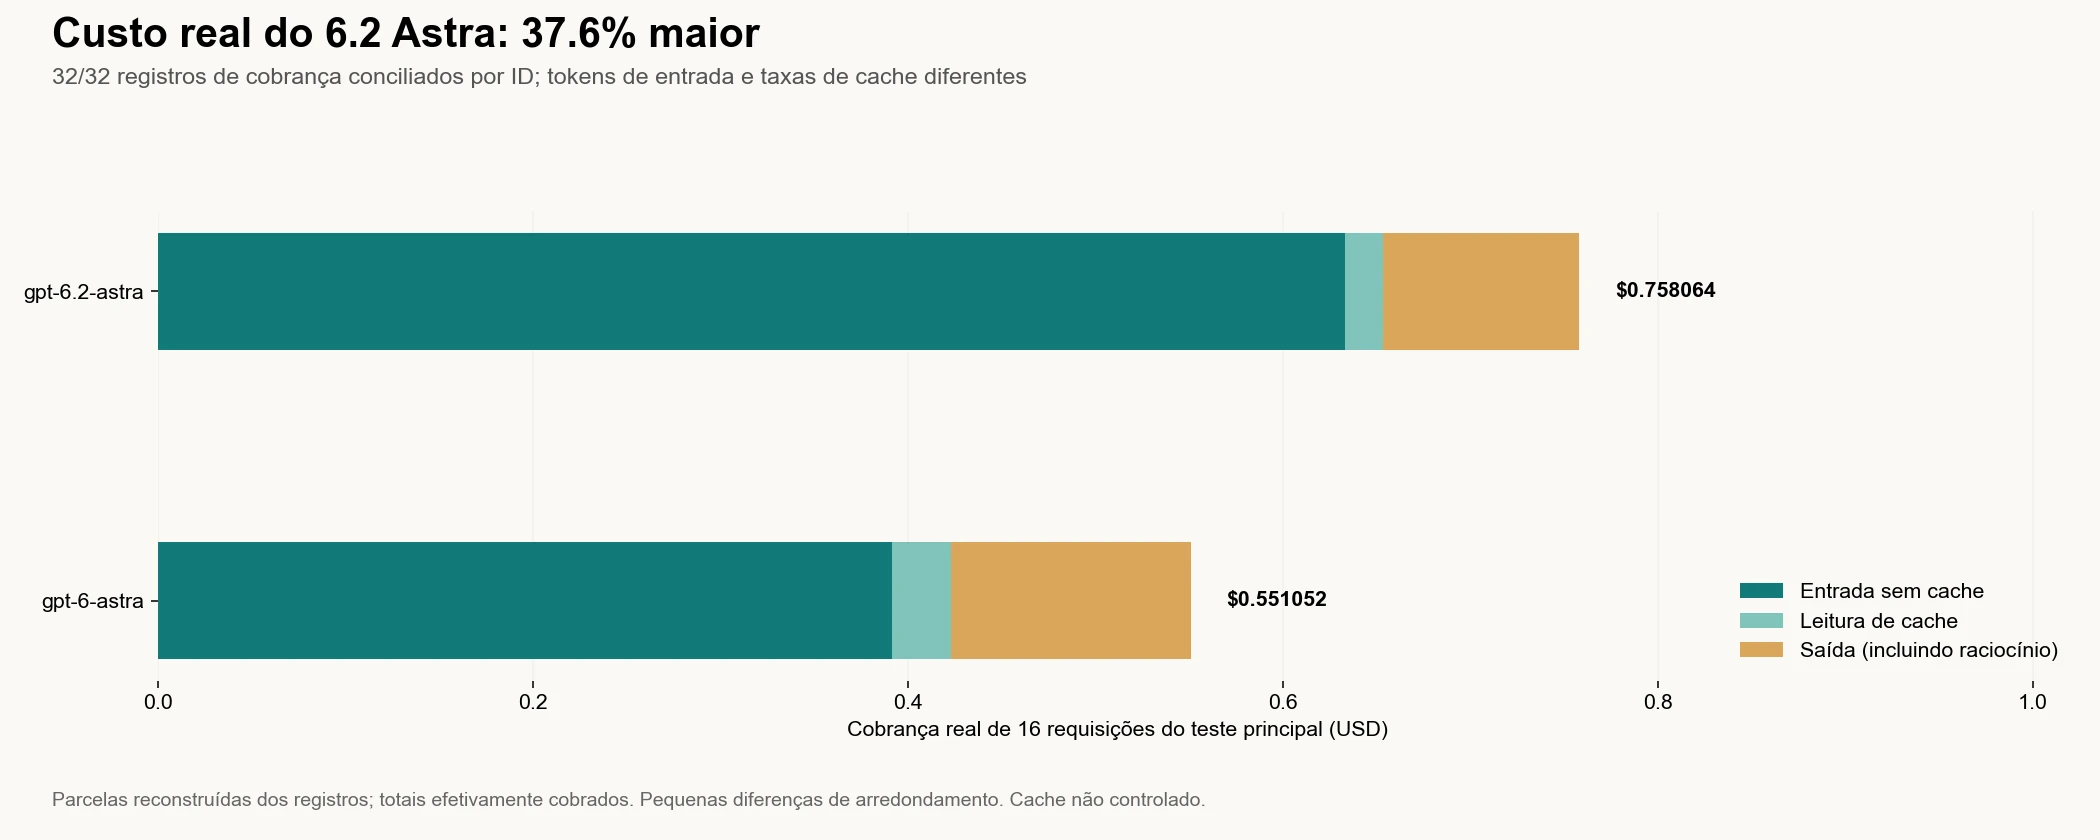
O total corresponde aos valores efetivamente debitados. Os componentes do gráfico foram reconstituídos a partir dos registros de cobrança, e pequenas diferenças em relação ao total decorrem do arredondamento. As duas chamadas independentes do exemplo mais abaixo ficaram de fora.
O 6.2 Astra usou menos tokens de saída nesta rodada, mas a conta ficou 37.6% mais alta porque as tarifas, o volume de entrada reportado e a proporção lida do cache influenciam o custo final. Os mesmos prompts visíveis também resultaram em contagens diferentes de tokens de entrada no upstream. O teste não investigou a causa dessa diferença.
O cache não foi limpo, e parte das questões veio de um conjunto de testes anteriores. Esses valores registram o custo de uma carga de trabalho real, sem as condições padronizadas de um benchmark com cache frio. Eles também não permitem projetar diretamente um aumento mensal de 37.6% para todos os usuários.
Na integração, mantenha a opção de trocar o modelo e comece com seus testes de regressão#
Quem já usa o GPT-6 Astra pode manter o modelo padrão atual, alterar o campo model no ambiente de testes e comparar os resultados com suas próprias tarefas. O exemplo abaixo usa a mesma URL base para chamar os dois modelos e pede que eles façam a união de intervalos semiabertos.
Antes de executar o exemplo, instale requests e forneça sua chave de API na variável de ambiente CRAZYROUTER_API_KEY. O código não imprime a chave.
import json
import os
import requests

BASE_URL = "https://api.crazyrouter.com/v1"
MODELS = ["gpt-6.2-astra", "gpt-6-astra"]
PROMPT = ('Merge half-open intervals [[-3,2],[1,5],[5,9]]. '
          'Return JSON only: {"merged":[[start,end]],"length":integer}.')


def run():
    session = requests.Session()
    session.trust_env = False
    results = []
    for model in MODELS:
        response = session.post(
            BASE_URL + "/chat/completions",
            headers={"Authorization": "Bearer " + os.environ["CRAZYROUTER_API_KEY"]},
            json={
                "model": model,
                "messages": [{"role": "user", "content": PROMPT}],
                "reasoning_effort": "high",
                "max_completion_tokens": 8192,
                "stream": False,
            },
            timeout=(15, 180),
        )
        response.raise_for_status()
        data = response.json()
        choice = data["choices"][0]
        if choice["finish_reason"] != "stop":
            raise RuntimeError("Incomplete output: " + str(choice["finish_reason"]))
        answer = json.loads(choice["message"]["content"])
        assert answer == {"merged": [[-3, 9]], "length": 12}, answer
        result = {"model": model, "answer": answer,
                  "request_id": response.headers.get("x-oneapi-request-id")}
        print(json.dumps(result, ensure_ascii=False))
        results.append(result)
    return results


if __name__ == "__main__":
    run()
O código foi executado separadamente. Os dois modelos retornaram {"merged":[[-3,9]],"length":12} com motivo de encerramento stop. Essas duas chamadas não entram nas 32 requisições da avaliação acima. O exemplo usou o roteamento comum dos usuários, enquanto o teste principal usou um canal fixo para reduzir diferenças de rota.
Para conferir os campos da integração, consulte a documentação da API da Crazyrouter. As equipes que usam a configuração de integração com o Codex (em inglês) ou a configuração de integração com o Cursor (em inglês) também devem rodar testes de regressão no conjunto de ferramentas que usam na prática. O sucesso das chamadas de texto deste artigo não valida todos os recursos dessas ferramentas.
Já usa o GPT-6 Astra? Vale a pena migrar para o 6.2 Astra?#
A escolha pode começar pelo tipo de tarefa.
| Sua principal necessidade | O que os dados desta rodada indicam |
|---|---|
| As tarefas atuais de verificação de regras e organização de dados já passam de forma consistente, e o custo é a prioridade | Mantenha o GPT-6 Astra. Com o desconto atual no site, as tarifas de entrada sem cache e de saída são menores. |
| A espera nas tarefas de otimização combinatória é longa | Teste primeiro o GPT-6.2 Astra e use mais questões reais para confirmar o ganho de velocidade. |
| Você lida com frequência com ordem de deduplicação, semântica de transações e casos de borda | Inclua o 6.2 Astra na comparação de regressão. Ele foi mais rápido nessas questões nesta rodada, e os dois modelos acertaram. |
| Você espera uma taxa de acerto maior só por causa do número da versão | Esta rodada não oferece evidência disso. Inclua tarefas em que o modelo atual de fato erra. |
| Você precisa de interpretação de imagens, agentes de longa duração ou uso coordenado de ferramentas | Faça testes específicos para esses cenários, que ficaram fora desta rodada. |
Você também pode começar pelo Model Arena para comparar os modelos nas mesmas questões. Para uma migração definitiva, mantenha o registro dos prompts exatos, dos critérios de avaliação e do consumo. A página do modelo GPT-6 Astra serve para conferir a configuração anterior, sem substituir os resultados dos seus próprios testes de regressão.
Como reproduzir a questão de otimização com restrições#
O prompt completo do usuário para essa questão está abaixo. No teste principal, usamos o nível de raciocínio high, um limite de saída de 8192 e uma mensagem system que exigia apenas JSON. O gabarito foi usado apenas na avaliação local e não foi enviado aos modelos.
Items IDs 0..11 have weights [4, 7, 2, 9, 5, 3, 8, 6, 4, 7, 1, 5] and values [13, 18, 7, 26, 14, 9, 23, 16, 12, 20, 4, 15]. Select total weight <=26 and at most 5 items. Constraints: selecting 3 requires 1; 6 and 7 cannot both be selected; selecting 9 requires 2; at least one of 0 and 4 must be selected. Maximize total value. Return JSON with best_value and optimal_sets (ALL optimal ID lists sorted ascending, and lists lexicographically sorted).
O gabarito calculado previamente está abaixo.
{"best_value": 78, "optimal_sets": [[0, 2, 6, 9, 11]]}
Para verificar a solução ótima, basta enumerar todos os subconjuntos dos 12 itens candidatos e filtrar pelo peso, pela quantidade, pelas dependências e pelas exclusões mútuas. As requisições e respostas originais e os registros de consumo de cada chamada foram arquivados para conferência. As tabelas e os gráficos deste artigo foram gerados a partir desses registros.
IDs das duas requisições independentes do exemplo mínimo de chamada deste artigo.
gpt-6.2-astra—83b6190a33a5765d75070b0cf645e4ca.gpt-6-astra—6a229d1cd68136b18781f531d8a5d77e.
Perguntas frequentes#
O GPT-6.2 Astra é necessariamente mais inteligente que o GPT-6 Astra?#
Esta rodada não permite chegar a essa conclusão. Foram 8 tipos de tarefa, com duas rodadas por tipo, e os dois modelos acertaram 16/16 questões por inteiro. Para avaliar um avanço de capacidade, são necessárias mais questões difíceis, casos reais de falha e uma avaliação independente.
Quanto mais rápido é o GPT-6.2 Astra em relação ao GPT-6 Astra?#
Depende da tarefa e da métrica. Nesta rodada, o tempo médio na seleção de subconjuntos com restrições caiu 54.3%. No conjunto de todas as requisições, a média caiu de 12.57 segundos para 8.84 segundos, mas a mediana subiu de 8.16 segundos para 9.57 segundos. Esses resultados não indicam que todas as chamadas sejam mais rápidas.
O GPT-6.2 Astra é mais barato?#
Na faixa oficial Standard para entradas curtas, as tarifas de entrada sem cache e de saída são 20% menores. No teste deste site, porém, o modelo anterior tinha 35% de desconto (pagamento de 65% da tarifa), e o uso de tokens e de cache diferiu entre os dois modelos. Ao executar o mesmo conjunto de tarefas, o 6.2 Astra teve o maior custo efetivo total.
A janela de contexto do GPT-6.2 Astra é maior?#
Segundo as páginas oficiais consultadas, ambos têm uma janela de 1,050,000 tokens e um limite de entrada de 922,000 tokens.[1][2] O maior volume de entrada reportado nas nossas requisições foi de 14,326 tokens. O teste não avaliou o desempenho em contextos de um milhão de tokens.
Retornar JSON significa que o recurso de saída estruturada foi validado?#
Não. Nesta rodada, pedimos JSON no prompt e usamos um programa para interpretar as respostas e compará-las com o gabarito. Não testamos a aplicação obrigatória de restrições via JSON Schema nem validamos streaming, chamadas de ferramentas ou a Responses API.
O sucesso nas 32 chamadas demonstra estabilidade no longo prazo?#
Mostra apenas que nenhuma das 32 requisições do teste principal apresentou falha HTTP, truncamento ou erro na resposta. A amostra veio de um único período e de um único canal, com apenas duas execuções por questão. Ela não serve como referência de disponibilidade no longo prazo nem como SLA de produção.
Referências e materiais de reprodução
- OpenAI — documentação do modelo GPT-6.2 Astra, consultada em 2026-11-20.
- OpenAI — documentação do modelo GPT-6 Astra, consultada em 2026-11-20.
- PostgreSQL — isolamento de transações e Read Committed, usado para conferir as regras da questão sobre transações.
Por Boluo Z. Os testes foram executados por scripts automatizados. Este artigo registra o desempenho do serviço com o roteamento deste site, sem auditoria independente dos pesos dos modelos fornecidos pelo upstream. A revisão dos preços e das informações sobre recursos sujeitos a mudanças está prevista para 2026-12-20.
Implementation Guides
Podcast
AI Dev Tools: The Crazyrouter Podcast
Episódios curtos (em inglês) para desenvolvedores: APIs de IA, gateways, controle de custos e ferramentas de código.
Episódios mais recentes
EP196 · 29 de out. de 2026 · 6:53
AI API Security Posture — Turn Controls Into Continuous Evidence
A practical guide to AI API security posture: inventory exposure, verify controls continuously, protect keys and data, constrain tools, and turn security assumptions into evidence that operators can act on.
EP195 · 28 de out. de 2026 · 7:21
AI API Policy Drift — Detect When Production Rules Stop Matching Intent
A practical guide to policy drift in AI APIs: version routing and safety rules, detect stale enforcement, compare intended and observed behavior, and restore control before small gaps become incidents.