简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
GPT-6.2 Astra против GPT-6 Astra: стоит ли обновляться по итогам 32 тестов?
По 16 тестов на одном канале с теми же промптами. Точность равна. Сравниваем время оптимизации, общее время, тарифы и расходы. Где стоит обновляться?
Если вы уже пользуетесь GPT-6 Astra, с выходом GPT-6.2 Astra вас, скорее всего, интересуют три вопроса. Справится ли новая модель с задачами, на которых ошибалась прежняя? Станет ли короче ожидание? Вырастет ли счёт?
В этой серии из 32 тестовых запросов через один и тот же канал Crazyrouter обе модели полностью решили 16/16 задач. У GPT-6.2 Astra среднее время на задаче оптимизации с ограничениями сократилось на 54.3%, но медиана по всем запросам оказалась выше, а фактические расходы выросли на 37.6%. Если вы уже используете GPT-6 Astra, по этим результатам имеет смысл сначала попробовать новую модель на отдельных задачах, а затем решить, стоит ли менять модель по умолчанию.
Мы взяли небольшую выборку повседневных задач разработки. Мы сверили официальные характеристики, текущие настройки тарификации Crazyrouter и фактические списания по каждому запросу.
Что изменилось в официальных характеристиках?#
По состоянию на 20 ноября 2026 года на страницах моделей OpenAI были указаны следующие ключевые параметры. [1][2]
| Параметр | GPT-6.2 Astra | GPT-6 Astra |
|---|---|---|
| Имя модели в API | gpt-6.2-astra | gpt-6-astra |
| Типы входных и выходных данных | На входе текст и изображения, на выходе текст | На входе текст и изображения, на выходе текст |
| Контекстное окно | 1,050,000 токенов | 1,050,000 токенов |
| Максимальный объём входа | 922,000 токенов | 922,000 токенов |
| Максимальный объём вывода | 128,000 токенов | 128,000 токенов |
| Дата отсечения знаний | 2026-05-18 | 2026-04-30 |
| Официальная цена за некэшированные входные токены | $8 / млн токенов | $10 / млн токенов |
| Официальная цена за чтение из кэша | $0.40 / млн токенов | $1 / млн токенов |
| Официальная цена за выходные токены | $40 / млн токенов | $50 / млн токенов |
В таблице приведены официальные цены тарифа Standard для запросов с объёмом входа до 272K токенов включительно. За этим порогом у обеих моделей ставки за входные токены и чтение из кэша удваиваются, а ставка за выходные токены увеличивается в 1.5 раза. Поэтому цены из таблицы применимы не ко всем длинным запросам. [1][2]
Официальные цены за некэшированные входные и выходные токены у 6.2 Astra снизились на 20%, а заявленный размер контекстного окна остался прежним. Дата отсечения знаний у новой модели более поздняя, но сама по себе она не даёт модели доступа к актуальной информации после этой даты.
В официальной документации также перечислены возможности работы с инструментами и Responses API. Мы проверили текстовые вызовы Chat Completions через Crazyrouter. Для подтверждения работы остальных эндпоинтов сервиса нужны отдельные тесты, даже если соответствующие возможности перечислены в документации OpenAI.
Как мы тестировали: один канал, 8 типов задач, по два прогона на задачу#
Тесты провели в ночь на 20 ноября 2026 года по пекинскому времени, что соответствует 19 ноября 2026 года по UTC. Перед основным тестом обе модели проверили через /v1/models.
| Условие | Настройка в этом тесте |
|---|---|
| Точка доступа | Crazyrouter, https://api.crazyrouter.com/v1 |
| Эндпоинт | POST /chat/completions |
| Маршрутизация | Один и тот же фиксированный канал к вышестоящему провайдеру для всех запросов. Это проверили по каждой из 32 записей о списаниях |
| Промпты | Сообщения system и user для каждой задачи полностью совпадали у обеих моделей |
| Уровень рассуждения | reasoning_effort: high |
| Бюджет генерации | max_completion_tokens: 8192 |
| Режим ответа | Без потоковой передачи, stream: false |
| Выборка и порядок | 8 типов задач × 2 прогона на модель. Случайный порядок, до 2 параллельных запросов суммарно |
| Оценка | Эталонные ответы задали заранее, поля JSON сравнивали по отдельности. Обязательные условия: HTTP 200 и finish_reason=stop |
В тест вошли поиск по 360 правилам, проверка ошибочной предпосылки, оптимизация графа зависимостей, выбор набора с ограничениями, повторное проведение операций по счёту, видимость данных в транзакциях, порядок дедупликации и обработка границ интервалов. Первые шесть задач взяли из внутреннего набора прошлых тестов, а последние две добавили для проверки граничных случаев. Входные данные и эталонные ответы сохранили в файлах с материалами теста. Эталонные ответы моделям не передавали.
Эти задачи соответствуют типичной работе разработчика: прочитать правила, вычислить результат и проверить граничные случаи. Тесты не охватывали внесение изменений в целый репозиторий. Мы также не запускали сгенерированные моделями программы, поэтому по этому тесту нельзя составить полноценный рейтинг моделей как агентов программирования.
Время измеряли на стороне клиента с момента отправки запроса до получения полного ответа. В замер вошли сетевые задержки, ожидание в очереди, вычисления модели и генерация ответа. Задержку до первого токена и скорость в токенах в секунду отдельно не измеряли.
Точность одинаковая. На каких задачах различается скорость?#
| Задача | Пройдено у 6.2 Astra | Пройдено у 6 Astra | Среднее время 6.2 | Среднее время 6 |
|---|---|---|---|---|
| Поиск по длинной таблице правил | 2/2 | 2/2 | 10.05 с | 10.20 с |
| Исправление ошибочной предпосылки | 2/2 | 2/2 | 9.95 с | 7.16 с |
| Граф зависимостей и оптимизация одного узла | 2/2 | 2/2 | 9.05 с | 8.42 с |
| Выбор оптимального набора с ограничениями | 2/2 | 2/2 | 18.49 с | 40.46 с |
| Дедупликация и повторное проведение операций по счёту | 2/2 | 2/2 | 10.28 с | 10.41 с |
| Видимость данных в транзакциях базы данных | 2/2 | 2/2 | 4.94 с | 9.66 с |
| Дедупликация перед фильтрацией по времени | 2/2 | 2/2 | 3.81 с | 7.18 с |
| Проверка границ полуоткрытых интервалов | 2/2 | 2/2 | 4.12 с | 7.08 с |
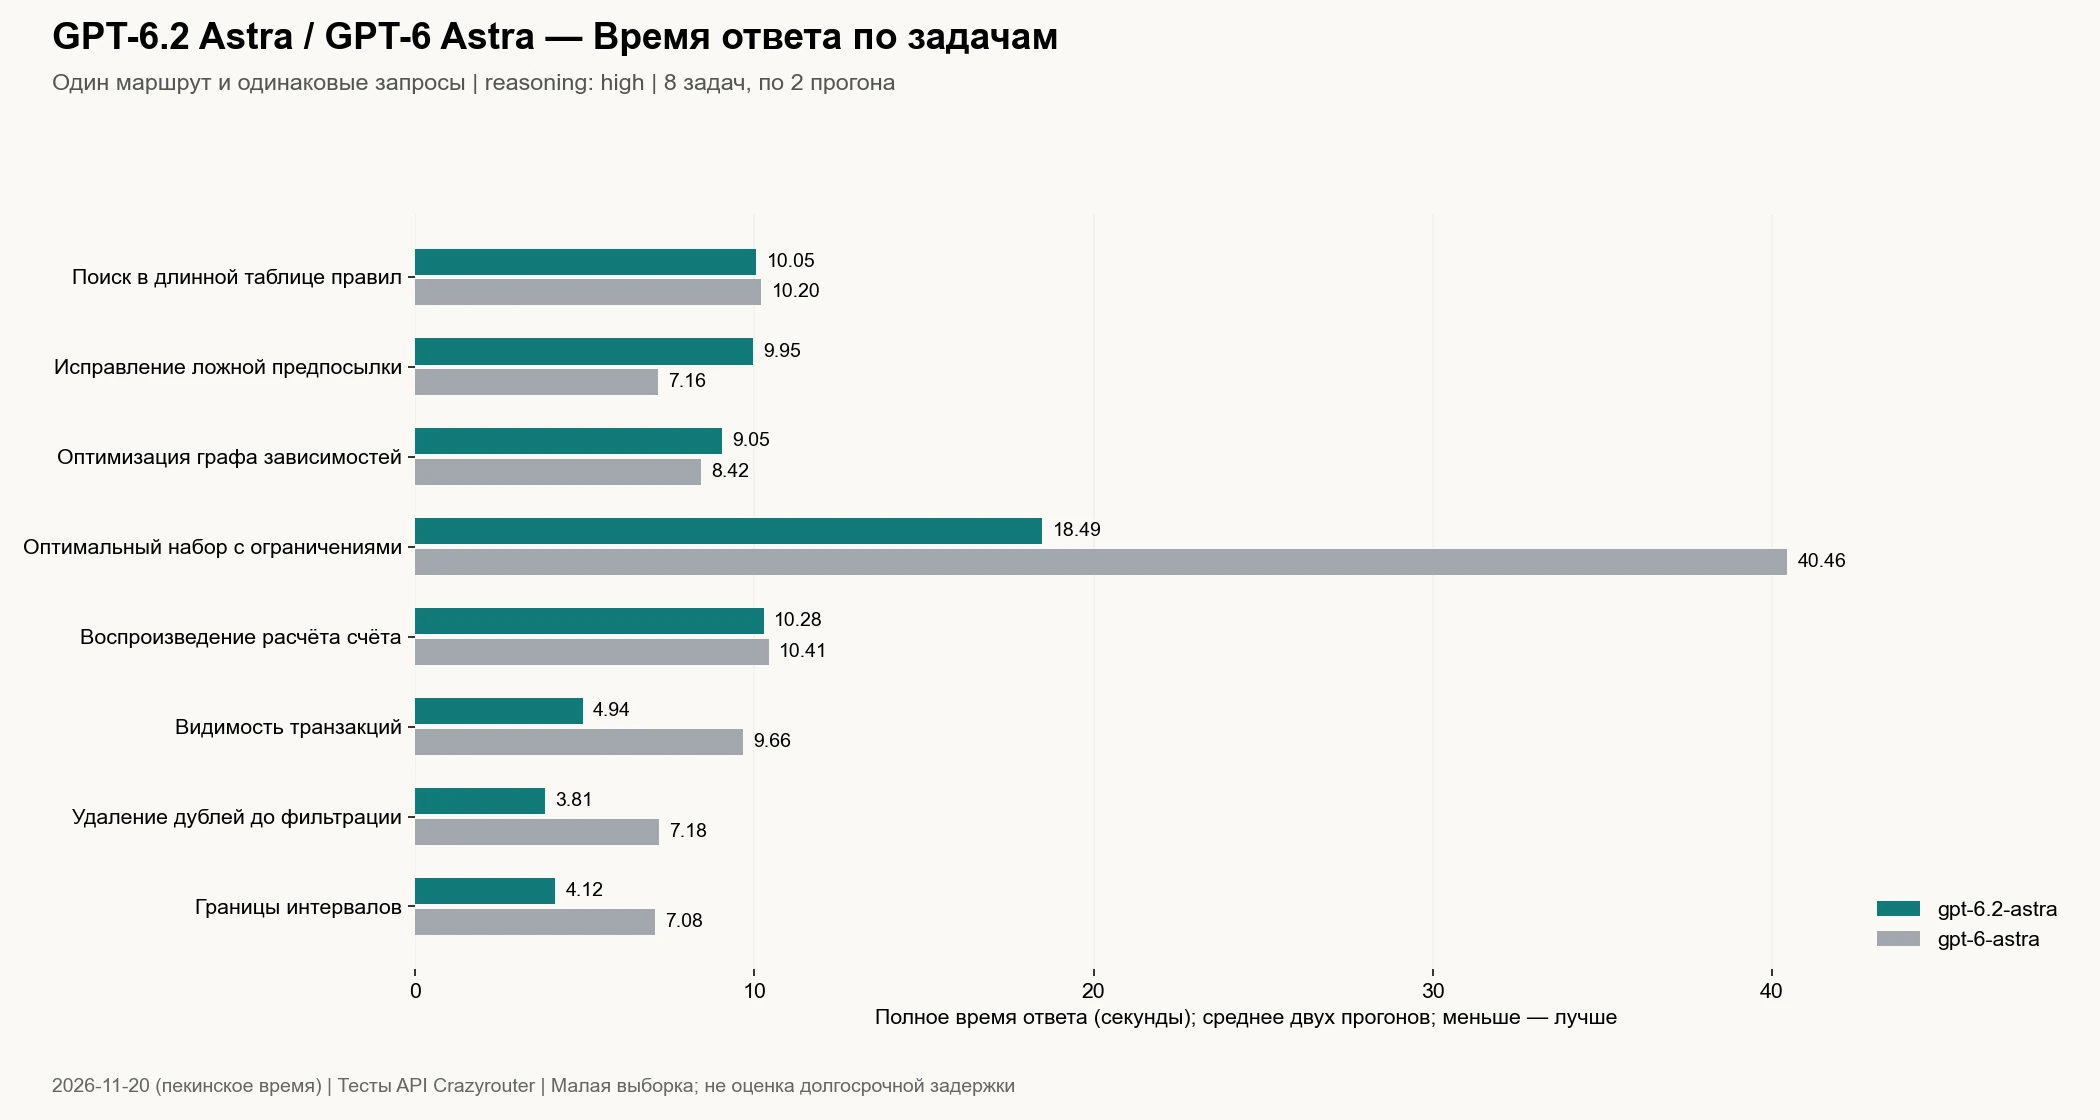
На каждую ячейку приходится всего два запроса, поэтому близкие значения не стоит считать признаком устойчивого преимущества. Обе модели по всем задачам этой серии вернули полный JSON, соответствующий эталонным ответам.
Самая заметная разница проявилась в задаче выбора набора с ограничениями. Из 12 вариантов требовалось выбрать набор с учётом общего веса, максимального числа элементов, зависимостей и условий взаимного исключения, а затем перечислить все оптимальные решения. Обе модели нашли единственный оптимальный набор [0, 2, 6, 9, 11] с суммарной ценностью 78.
Два прогона у 6.2 Astra заняли 18.21 и 18.78 секунды, а у 6 Astra — 37.52 и 43.41 секунды. Среднее ожидание на этой задаче сократилось на 54.3%. Похожие задачи комбинаторной оптимизации стоит включить в пробную оценку новой модели. Двух прогонов мало для вывода, что «любая сложная задача на рассуждение решается вдвое быстрее».
Задача на дедупликацию проверяла другую типичную ошибку. Первое событие с некоторым ID произошло за пределами временного окна, а последующее событие с тем же ID попало в окно. По условию нужно было сначала выполнить дедупликацию по всем событиям, а затем отфильтровать их по времени. Поэтому поздний дубликат нельзя было учитывать повторно. Обе модели правильно рассчитали чистую сумму для Alice в 25 центов и исключили Bob, у которого итоговая чистая сумма равнялась нулю.
На этих граничных случаях разницы в точности не обнаружилось. Результат 16/16 против 16/16 показывает лишь, что обе модели прошли этот набор тестов. По нему нельзя заключить, что предел их возможностей одинаков.
Почему среднее время сократилось, а медиана выросла?#
| Статистика по всем 16 запросам | GPT-6.2 Astra | GPT-6 Astra |
|---|---|---|
| Полные правильные ответы | 16/16 | 16/16 |
| Среднее время | 8.84 с | 12.57 с |
| Медианное время | 9.57 с | 8.16 с |
| Минимум / максимум | 3.39 / 18.78 с | 6.67 / 43.41 с |
Оба показателя рассчитаны корректно. Два заметно более долгих запроса GPT-6 Astra на задаче выбора набора с ограничениями подняли среднее. У 6.2 Astra оба запроса завершились быстрее, что снизило её среднее время по всей серии.
После сортировки всех запросов по времени медиана у 6.2 Astra составила около 9.57 секунды, у 6 Astra — около 8.16 секунды. На проверке ошибочной предпосылки и задаче с графом зависимостей 6.2 Astra тоже не выиграла в скорости.
При выборе модели важно учитывать тип задачи. Если больше всего времени уходит на ожидание результатов комбинаторной оптимизации, снижение среднего времени имеет практическое значение. Если ваши повседневные запросы в основном сводятся к коротким вопросам по правилам, этой выборки недостаточно, чтобы рекомендовать полный переход на новую модель.
Официальные цены снизились, а фактические расходы на Crazyrouter выросли#
Официальные цены за токены отличаются от сумм, которые фактически платят пользователи Crazyrouter. В проверенных для этого теста настройках группы default на GPT-6 Astra действовала скидка 35% (оплата 65% тарифа), а на GPT-6.2 Astra действовал полный тариф. Ниже приведены ставки с учётом скидки для запросов с объёмом входа до 272K токенов включительно.
| Ставка Crazyrouter за млн токенов | GPT-6.2 Astra | GPT-6 Astra |
|---|---|---|
| Некэшированные входные токены | $8.00 | $6.50 |
| Чтение из кэша | $0.40 | $0.65 |
| Выходные токены | $40.00 | $32.50 |
Таким образом, у 6.2 Astra сейчас ниже ставка за чтение из кэша, а у 6 Astra ниже ставки за некэшированные входные и выходные токены. По одному лишь официальному снижению цен на новую версию нельзя определить, какая модель обойдётся дешевле на Crazyrouter. Перед покупкой или подключением перепроверьте ставки: результат зависит от группы и действующих скидок. Страница цен Crazyrouter.
Мы нашли по идентификаторам запросов все 32 записи о фактических списаниях и перевели суммы в доллары по настройке сервиса quota_per_unit=500000.
| Фактическое потребление в основном тесте | GPT-6.2 Astra | GPT-6 Astra |
|---|---|---|
| Число запросов | 16 | 16 |
| Входные токены по данным вышестоящего провайдера | 128,692 | 108,708 |
| Из них токены, прочитанные из кэша | 49,536 | 48,512 |
| Доля кэшированных токенов во входе | 38.5% | 44.6% |
| Выходные токены, включая токены рассуждения | 2,625 | 3,946 |
| Фактические расходы | $0.758064 | $0.551052 |
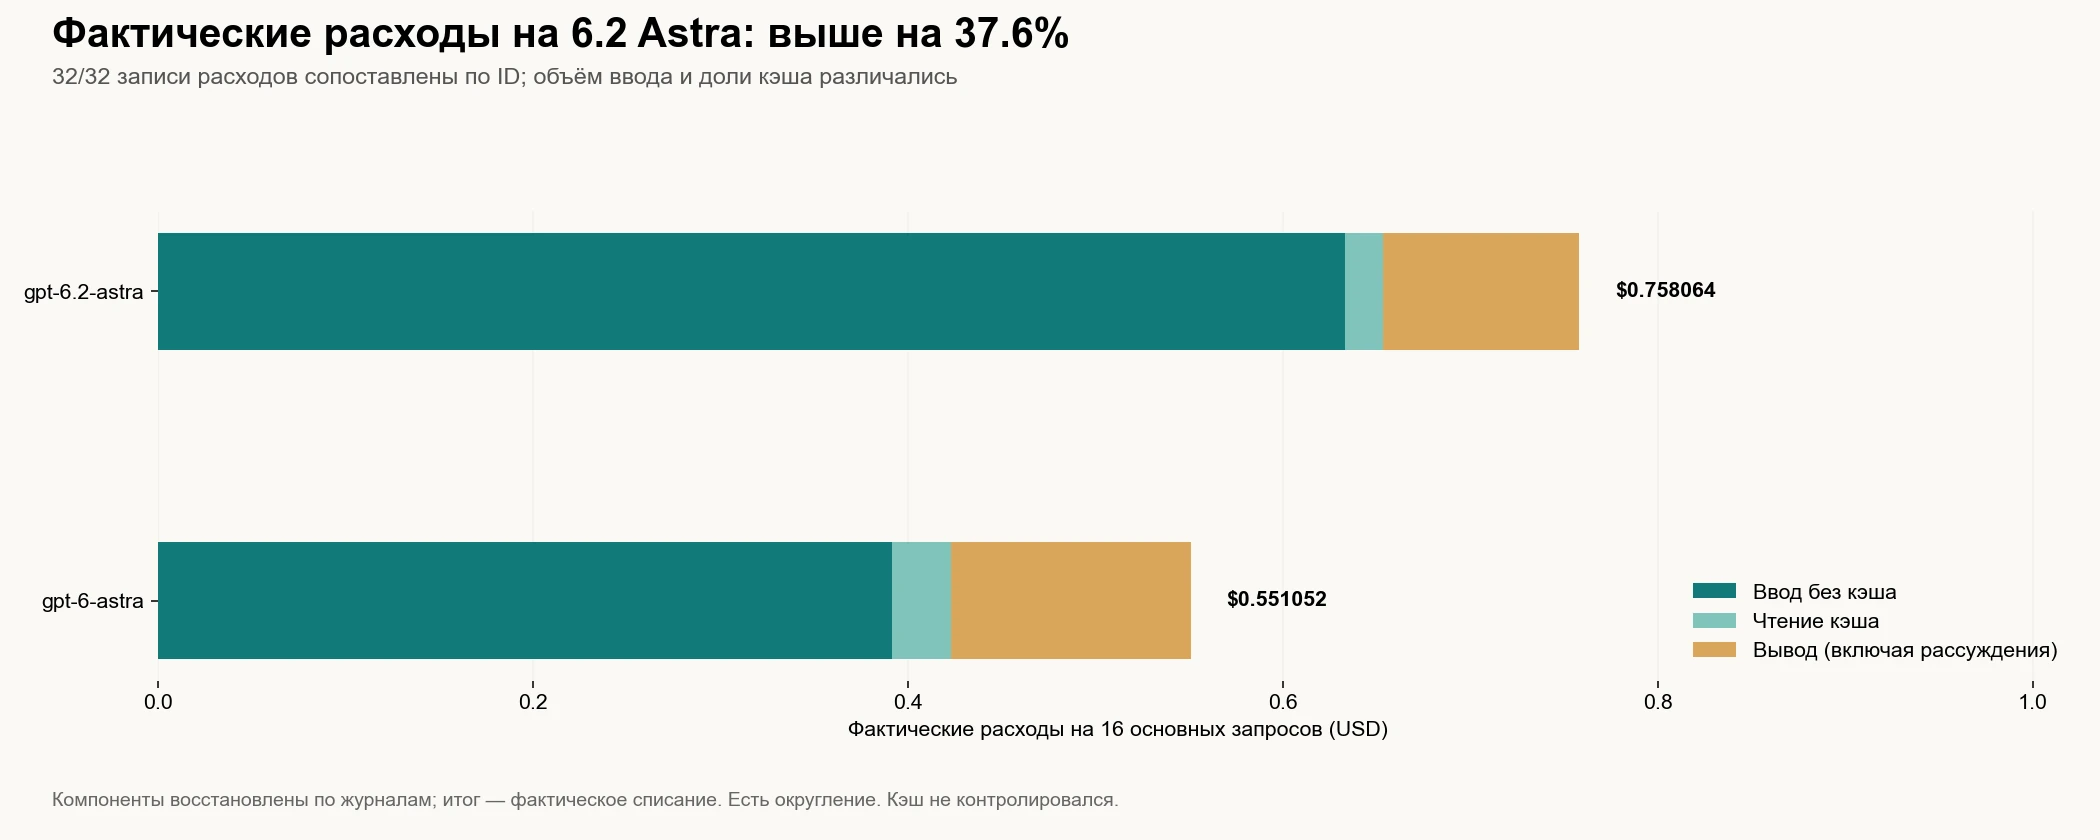
Итоги взяты из фактических списаний. Разбивка на графике восстановлена по журналам тарификации. Небольшое расхождение с итоговыми суммами вызвано округлением. Два отдельных вызова из примера ниже в расчёт не вошли.
6.2 Astra использовала меньше выходных токенов, но итоговый счёт оказался на 37.6% выше. На сумму повлияли ставки, число входных токенов по отчётам провайдера и доля чтения из кэша. Хотя видимые промпты совпадали, провайдер сообщил разное число входных токенов. Причину расхождения в этом тесте отдельно не выясняли.
Кэш не очищали, а часть задач взяли из предыдущих тестов. Эти суммы отражают расходы на конкретный набор запросов. Состояние кэша не контролировали, поэтому результаты нельзя считать сравнением затрат при одинаковом холодном кэше или напрямую переносить рост на 37.6% на ежемесячные расходы каждого пользователя.
Как подключить новую модель и сначала прогнать свои регрессионные тесты#
Если у вас уже настроены вызовы GPT-6 Astra, можно оставить её моделью по умолчанию, изменить поле model в тестовом окружении и сравнить модели на собственных задачах. В примере ниже обе модели вызываются через один и тот же базовый URL и получают задачу на объединение полуоткрытых интервалов.
Перед запуском установите requests и задайте свой ключ API в переменной окружения CRAZYROUTER_API_KEY. Код не выводит ключ.
import json
import os
import requests

BASE_URL = "https://api.crazyrouter.com/v1"
MODELS = ["gpt-6.2-astra", "gpt-6-astra"]
PROMPT = ('Merge half-open intervals [[-3,2],[1,5],[5,9]]. '
          'Return JSON only: {"merged":[[start,end]],"length":integer}.')


def run():
    session = requests.Session()
    session.trust_env = False
    results = []
    for model in MODELS:
        response = session.post(
            BASE_URL + "/chat/completions",
            headers={"Authorization": "Bearer " + os.environ["CRAZYROUTER_API_KEY"]},
            json={
                "model": model,
                "messages": [{"role": "user", "content": PROMPT}],
                "reasoning_effort": "high",
                "max_completion_tokens": 8192,
                "stream": False,
            },
            timeout=(15, 180),
        )
        response.raise_for_status()
        data = response.json()
        choice = data["choices"][0]
        if choice["finish_reason"] != "stop":
            raise RuntimeError("Incomplete output: " + str(choice["finish_reason"]))
        answer = json.loads(choice["message"]["content"])
        assert answer == {"merged": [[-3, 9]], "length": 12}, answer
        result = {"model": model, "answer": answer,
                  "request_id": response.headers.get("x-oneapi-request-id")}
        print(json.dumps(result, ensure_ascii=False))
        results.append(result)
    return results


if __name__ == "__main__":
    run()
Этот код запускали отдельно. Обе модели вернули {"merged":[[-3,9]],"length":12} с причиной завершения stop. Эти два вызова не входят в 32 тестовых запроса выше. В примере использовалась обычная пользовательская маршрутизация, а в основном тесте канал зафиксировали, чтобы уменьшить влияние различий в маршрутах.
Параметры подключения можно сверить с документацией API Crazyrouter. Командам, использующим интеграции Codex или Cursor, также стоит прогнать регрессионные тесты на своей реальной цепочке инструментов. Успешные текстовые вызовы в этой статье подтверждают лишь работу текстовых вызовов. Настройка интеграции с Codex (на английском) и настройка интеграции с Cursor (на английском).
Стоит ли переходить на 6.2 Astra, если вы уже используете GPT-6 Astra?#
Решение можно принимать по типу задач.
| Что для вас важнее | Что подсказывают результаты теста |
|---|---|
| Текущие задачи проверки правил и подготовки данных выполняются стабильно, а расходы важнее скорости | Оставьте GPT-6 Astra. С учётом текущей скидки на Crazyrouter у неё ниже ставки за некэшированные входные и выходные токены |
| Задачи комбинаторной оптимизации выполняются долго | В первую очередь попробуйте GPT-6.2 Astra и проверьте выигрыш в скорости на большем числе реальных задач |
| Вы часто работаете с порядком дедупликации, семантикой транзакций и граничными условиями | Включите 6.2 Astra в регрессионное сравнение. В этой серии она быстрее решила такие задачи, а правильные ответы дали обе модели |
| Вы рассчитываете на большую точность уже за счёт перехода на новую версию | Этот тест не даёт оснований ожидать прироста точности. Включите задачи, на которых текущая модель действительно ошибается |
| Вам нужны анализ изображений, длительная работа агента или взаимодействие с инструментами | Проведите отдельные тесты для этих сценариев. В текущую серию они не вошли |
Сравнение на одинаковых задачах можно начать в Model Arena. Для официального перехода сохраните конкретные промпты, правила оценки и записи о списаниях. Прежнюю конфигурацию можно сверить по странице модели GPT-6 Astra. Результаты регрессионных тестов нужно получить на своих задачах.
Как воспроизвести задачу оптимизации с ограничениями#
Ниже приведён полный пользовательский промпт для этой задачи. В основном тесте использовали уровень рассуждения high, бюджет генерации 8192 токена и требование возвращать только JSON в системном сообщении. Эталонный ответ использовали только для локальной оценки и не отправляли моделям.
Items IDs 0..11 have weights [4, 7, 2, 9, 5, 3, 8, 6, 4, 7, 1, 5] and values [13, 18, 7, 26, 14, 9, 23, 16, 12, 20, 4, 15]. Select total weight <=26 and at most 5 items. Constraints: selecting 3 requires 1; 6 and 7 cannot both be selected; selecting 9 requires 2; at least one of 0 and 4 must be selected. Maximize total value. Return JSON with best_value and optimal_sets (ALL optimal ID lists sorted ascending, and lists lexicographically sorted).
Эталонный ответ рассчитали заранее.
{"best_value": 78, "optimal_sets": [[0, 2, 6, 9, 11]]}
Оптимальное решение можно проверить полным перебором всех подмножеств из 12 элементов с отбором по весу, количеству элементов, зависимостям и условиям взаимного исключения. Исходные запросы, ответы и записи по каждому списанию сохранены в архиве для повторной проверки. Все таблицы и графики в статье основаны на этих записях.
Идентификаторы двух отдельных запросов из минимального примера вызова:
gpt-6.2-astra—83b6190a33a5765d75070b0cf645e4ca.gpt-6-astra—6a229d1cd68136b18781f531d8a5d77e.
Часто задаваемые вопросы#
GPT-6.2 Astra точно умнее GPT-6 Astra?#
По этой серии тестов такого вывода сделать нельзя. Обе модели полностью решили 16/16 задач при 8 типах задач и двух прогонах на тип. Чтобы оценить прирост возможностей, нужны более сложные задачи, реальные случаи ошибок и независимая оценка.
Насколько GPT-6.2 Astra быстрее GPT-6 Astra?#
Это зависит от задачи и выбранного показателя. Среднее время на задаче выбора набора с ограничениями сократилось на 54.3%, а среднее по всем запросам снизилось с 12.57 до 8.84 секунды. При этом медиана выросла с 8.16 до 9.57 секунды. Скорость выросла не на каждом запросе.
GPT-6.2 Astra дешевле?#
В официальном тарифе Standard для короткого входа ставки за некэшированные входные и выходные токены ниже на 20%. Но на Crazyrouter во время теста на прежнюю модель действовала скидка 35% (оплата 65% тарифа), а расход токенов и доля чтения из кэша у моделей различались. В результате выполнение одного и того же набора задач на 6.2 Astra обошлось дороже.
У GPT-6.2 Astra больше контекстное окно?#
По официальным страницам моделей, которые мы сверили для этой статьи, контекстное окно у обеих составляет 1,050,000 токенов, а максимальный объём входа — 922,000 токенов. [1][2] Максимальный объём входа по отчётам о наших запросах составил 14,326 токенов. Работу с контекстом в миллион токенов мы не проверяли.
Если модель вернула JSON, значит ли это, что структурированный вывод проверен?#
Нет. Мы попросили модель вернуть JSON в промпте, после чего программа разобрала ответ и сверила его с эталоном. Принудительное соответствие JSON Schema не тестировали. Потоковую передачу, вызов инструментов и Responses API также не проверяли.
Все 32 запроса прошли успешно. Говорит ли это о стабильности в долгосрочной перспективе?#
Это показывает лишь, что в 32 основных запросах не было HTTP-сбоев, обрезанных ответов или ошибок в ответах. Выборка охватывает один период и один канал, а каждую задачу повторяли всего дважды. По этим данным нельзя судить о долгосрочной доступности или использовать их как SLA для рабочей среды.
Источники и материалы для воспроизведения
- OpenAI — документация модели GPT-6.2 Astra, дата проверки 2026-11-20.
- OpenAI — документация модели GPT-6 Astra, дата проверки 2026-11-20.
- PostgreSQL — изоляция транзакций и Read Committed. По этому источнику сверили правила для задачи о транзакциях.
Автор — Boluo Z. Тесты выполнил автоматизированный скрипт. В статье зафиксированы результаты работы сервиса при маршрутизации через Crazyrouter. Независимый аудит весов моделей вышестоящего провайдера не проводился. Повторную проверку изменяемых цен и сведений о возможностях запланировали на 2026-12-20.
Implementation Guides
Podcast
AI Dev Tools: The Crazyrouter Podcast
Короткие выпуски для разработчиков (на английском): AI API, шлюзы, контроль затрат и инструменты для кода.
Новые выпуски
EP196 · 29 окт. 2026 г. · 6:53
AI API Security Posture — Turn Controls Into Continuous Evidence
A practical guide to AI API security posture: inventory exposure, verify controls continuously, protect keys and data, constrain tools, and turn security assumptions into evidence that operators can act on.
EP195 · 28 окт. 2026 г. · 7:21
AI API Policy Drift — Detect When Production Rules Stop Matching Intent
A practical guide to policy drift in AI APIs: version routing and safety rules, detect stale enforcement, compare intended and observed behavior, and restore control before small gaps become incidents.