简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
GPT-6.2 AstraとGPT-6 Astraを比較:32回の実測で、アップグレードする価値はある?
同じチャネルとプロンプトでGPT-6.2 AstraとGPT-6 Astraを各16回テストした結果、正答率は同じでした。制約付き最適化の速度、全体の応答時間、公式料金と当サイトでの実際の費用を比較し、どのタスクでアップグレードを試す価値があるかを解説します。
すでにGPT-6 Astraを使っているなら、GPT-6.2 Astraが出てまず気になるのは、これまで正しく処理できなかったタスクを解けるようになるか、待ち時間は短くなるか、請求額は増えるか、という3点でしょう。
今回、Crazyrouterの同一チャネルで行った32回のテストでは、両モデルとも16/16件で全項目に正解しました。GPT-6.2 Astraは制約付き最適化問題の平均応答時間を54.3%短縮しましたが、全リクエストの応答時間の中央値は長く、実際の費用は37.6%高くなりました。 すでにGPT-6 Astraを使っているなら、この結果からは、まずタスクを選んで試し、そのうえでデフォルトモデルを切り替えるか判断するのが妥当です。
今回は、日常的な開発タスクを対象にした小規模なテストです。公式仕様、当サイトの現在の料金設定、リクエストごとの実際の請求額も確認しました。以下では、この3つを分けて説明します。
公式仕様はどう変わった?#
2026年11月20日時点で、OpenAIの両モデルのページに記載されている主な情報は以下のとおりです。[1][2]
| 項目 | GPT-6.2 Astra | GPT-6 Astra |
|---|---|---|
| APIモデル名 | gpt-6.2-astra | gpt-6-astra |
| 入力 / 出力モダリティ | 入力はテキストと画像、出力はテキスト | 入力はテキストと画像、出力はテキスト |
| コンテキストウィンドウ | 1,050,000 tokens | 1,050,000 tokens |
| 最大入力 | 922,000 tokens | 922,000 tokens |
| 最大出力 | 128,000 tokens | 128,000 tokens |
| 知識のカットオフ日 | 2026-05-18 | 2026-04-30 |
| 公式のキャッシュなし入力単価 | $8 / 100万 tokens | $10 / 100万 tokens |
| 公式のキャッシュ読み取り単価 | $0.40 / 100万 tokens | $1 / 100万 tokens |
| 公式の出力単価 | $40 / 100万 tokens | $50 / 100万 tokens |
表の料金は、公式Standardのうち入力が272K tokens以下の場合に適用されるものです。このしきい値を超えると、両モデルとも入力とキャッシュ読み取りの単価が2倍に、出力単価が1.5倍になります。上の表をすべての長文リクエストにそのまま適用することはできません。[1][2]
仕様から確認できるのは、6.2 Astraの公式のキャッシュなし入力単価と出力単価がともに20%下がり、公称のコンテキストウィンドウは拡大していないことです。知識のカットオフ日が新しくなっても、それ以降のリアルタイム情報を把握しているとは限りません。
公式ページにはツールやResponses APIへの対応も記載されていますが、この記事で実際に検証したのは、当サイトのChat Completionsを使ったテキスト呼び出しです。公式の機能一覧は、当サイトのすべてのエンドポイントで動作を確認した証拠にはなりません。
テスト方法:同一チャネルで8種類の課題を各2回#
テストは北京時間の2026年11月20日未明に実施しました。UTCでは2026年11月19日に当たります。両モデルとも、まず/v1/modelsで確認してから本テストに進みました。
| 条件 | 今回の設定 |
|---|---|
| 接続先 | Crazyrouter、https://api.crazyrouter.com/v1 |
| エンドポイント | POST /chat/completions |
| ルーティング | 同一の上流チャネルに固定し、32件の利用ログを1件ずつ確認して一致を確認 |
| プロンプト | 同じ問題では、systemメッセージとuserメッセージを完全に統一 |
| 推論レベル | reasoning_effort: high |
| 出力上限 | max_completion_tokens: 8192 |
| 応答方式 | 非ストリーミング、stream: false |
| サンプルと実行順 | 8種類のタスク × 各モデル2回。順序はランダム、全体の同時実行数は2 |
| 採点 | 事前に正解を用意し、JSONの各フィールドを照合。HTTP 200かつfinish_reason=stopが条件 |
テストの内容は、360件のルールからの検索、誤った前提の検証、依存関係グラフの最適化、制約付き集合選択、請求処理のリプレイ、トランザクションの可視性、重複排除の順序、区間の境界です。最初の6問は過去の社内テストセットから流用し、残りの2問で境界ケースを補いました。入力と正解はどちらも検証用ファイルに残しており、正解はモデルに送っていません。
いずれも、開発者が日常的に行う「ルールを読み、結果を計算し、境界条件を見極める」作業に対応しています。コードリポジトリ全体にわたる変更は対象外で、モデルが生成したプログラムも実行していません。そのため、この結果をもとにコーディングエージェントとしての総合的な能力を順位付けすることはしません。
応答時間は、クライアントがリクエストを送信してから応答をすべて受信するまでの時間です。ネットワーク、キューでの待機、推論、出力にかかる時間を含みます。最初のトークンまでの遅延やtokens/sとは異なる指標です。
正答率は同じ。どの課題で速度に差が出た?#
| タスク | 6.2 Astraの正解数 | 6 Astraの正解数 | 6.2の平均応答時間 | 6の平均応答時間 |
|---|---|---|---|---|
| 長いルール表からの検索 | 2/2 | 2/2 | 10.05秒 | 10.20秒 |
| 誤った前提の訂正 | 2/2 | 2/2 | 9.95秒 | 7.16秒 |
| 依存関係グラフと単一箇所の最適化 | 2/2 | 2/2 | 9.05秒 | 8.42秒 |
| 制約付き最適集合選択 | 2/2 | 2/2 | 18.49秒 | 40.46秒 |
| 重複排除と請求処理のリプレイ | 2/2 | 2/2 | 10.28秒 | 10.41秒 |
| データベースのトランザクション可視性 | 2/2 | 2/2 | 4.94秒 | 9.66秒 |
| 重複排除後の時間フィルタリング | 2/2 | 2/2 | 3.81秒 | 7.18秒 |
| 半開区間の境界に関する推論 | 2/2 | 2/2 | 4.12秒 | 7.08秒 |
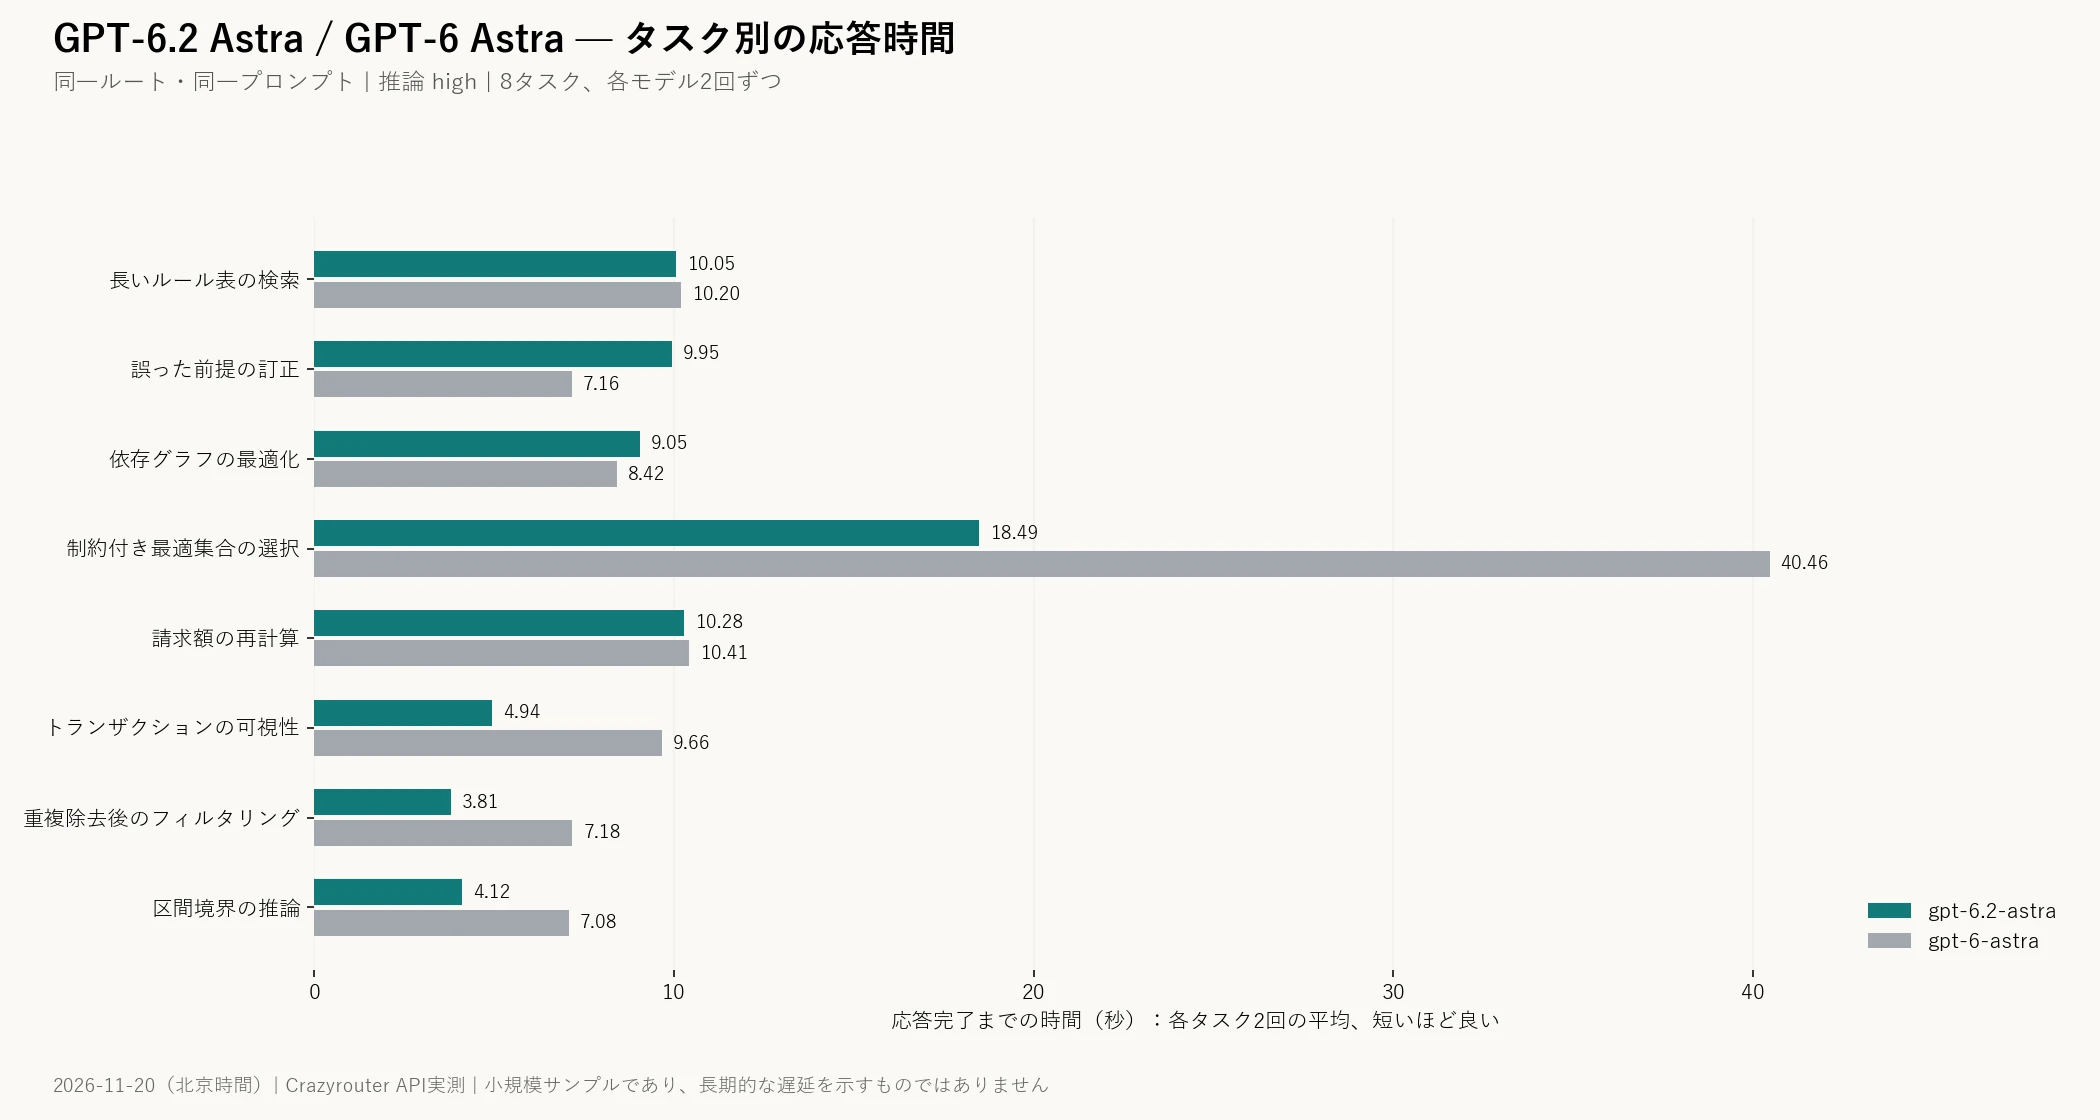
各セルの集計対象はわずか2回のリクエストです。数値が近い場合、安定した優位性があるとは判断できません。今回の全問題で、両モデルとも正解に一致する完全なJSONを返しました。
最も大きな差が出たのは、制約付き集合選択です。12個の候補から、総重量、選択数の上限、依存関係、排他条件をすべて満たし、最適解を漏れなく列挙するよう求めました。両モデルとも、唯一の最適な集合[0, 2, 6, 9, 11]を見つけました。合計価値は78です。
6.2 Astraの2回の応答時間はそれぞれ18.21秒、18.78秒で、6 Astraは37.52秒、43.41秒でした。この問題では平均待ち時間が54.3%短くなったため、同様の組み合わせ最適化はアップグレードを試す候補に入れてよいでしょう。ただし、2回の結果から「複雑な推論はすべて倍速になる」とは結論づけられません。
重複排除の問題では、別のよくある誤りを検証しました。あるイベントが最初に現れたのは時間範囲外で、その後に同じIDのイベントが範囲内に現れます。問題の指定は「まず全体で重複を排除し、その後に時間で絞り込む」なので、後から現れた重複イベントを再び集計に入れてはいけません。両モデルともAliceの純額を25セントと正しく算出し、最終的な純額がゼロのBobを除外しました。
今回の境界条件を扱う問題では、正答率に差は出ませんでした。16/16対16/16という結果が示すのは、両モデルがこのテストセットの全問題に正解したことまでです。両モデルの能力の上限が同じだとは証明できません。
平均では速いのに、なぜ中央値では遅い?#
| 全16回のリクエストの統計 | GPT-6.2 Astra | GPT-6 Astra |
|---|---|---|
| 完全かつ正しい応答 | 16/16 | 16/16 |
| 平均応答時間 | 8.84秒 | 12.57秒 |
| 応答時間の中央値 | 9.57秒 | 8.16秒 |
| 最短 / 最長 | 3.39 / 18.78秒 | 6.67 / 43.41秒 |
どちらの統計も正しい値です。GPT-6 Astraでは、制約付き集合選択の2回のリクエストに明らかに長い時間がかかり、平均を押し上げました。6.2 Astraではこの2回の待ち時間が短く、その分、全体の平均値が下がりました。
一方、全リクエストを応答時間順に並べると、中央値は6.2 Astraが約9.57秒、6 Astraが約8.16秒です。誤った前提の検証と依存関係グラフの問題でも、6.2 Astraの方が速いという結果は出ませんでした。
モデルを選ぶ際は、タスクの種類ごとに結果を見る必要があります。待ち時間の主な要因が組み合わせ最適化なら、平均応答時間の短縮には実用上の意味があります。日常のリクエストの大半が短いルール照会なら、このデータだけで全面的な切り替えを判断するには不十分です。
公式料金は値下げ、当サイトでの今回の請求額は増加#
公式単価と、当サイトでユーザーが実際に支払う料金は異なります。今回確認したCrazyrouterのdefaultグループの設定では、GPT-6 Astraは通常料金の6.5割(35%引き)、GPT-6.2 Astraは通常料金のままです。入力が272K tokens以下のリクエストには、割引適用後の以下の単価が適用されます。
| 当サイトの100万 tokensあたりの単価 | GPT-6.2 Astra | GPT-6 Astra |
|---|---|---|
| キャッシュなし入力 | $8.00 | $6.50 |
| キャッシュ読み取り | $0.40 | $0.65 |
| 出力 | $40.00 | $32.50 |
現在は、キャッシュ読み取りの単価は6.2 Astraの方が低く、キャッシュなし入力と出力の単価は6 Astraの方が低くなっています。公式の「新バージョンの値下げ」だけで、当サイトではどちらが安いかを判断することはできません。グループや割引が変われば結果も変わるため、注文や導入の前に当サイトの料金ページを改めて確認してください。
リクエストIDをもとに、32件すべての実際の課金記録を特定し、当サイトのquota_per_unit=500000を使って米ドルに換算しました。
| 本テストでの実際の使用量 | GPT-6.2 Astra | GPT-6 Astra |
|---|---|---|
| リクエスト数 | 16 | 16 |
| 上流サービスが報告した入力トークン数 | 128,692 | 108,708 |
| うちキャッシュから読み取ったトークン数 | 49,536 | 48,512 |
| 入力に占めるキャッシュ読み取りの割合 | 38.5% | 44.6% |
| 出力トークン数(推論分を含む) | 2,625 | 3,946 |
| 実際の費用 | $0.758064 | $0.551052 |
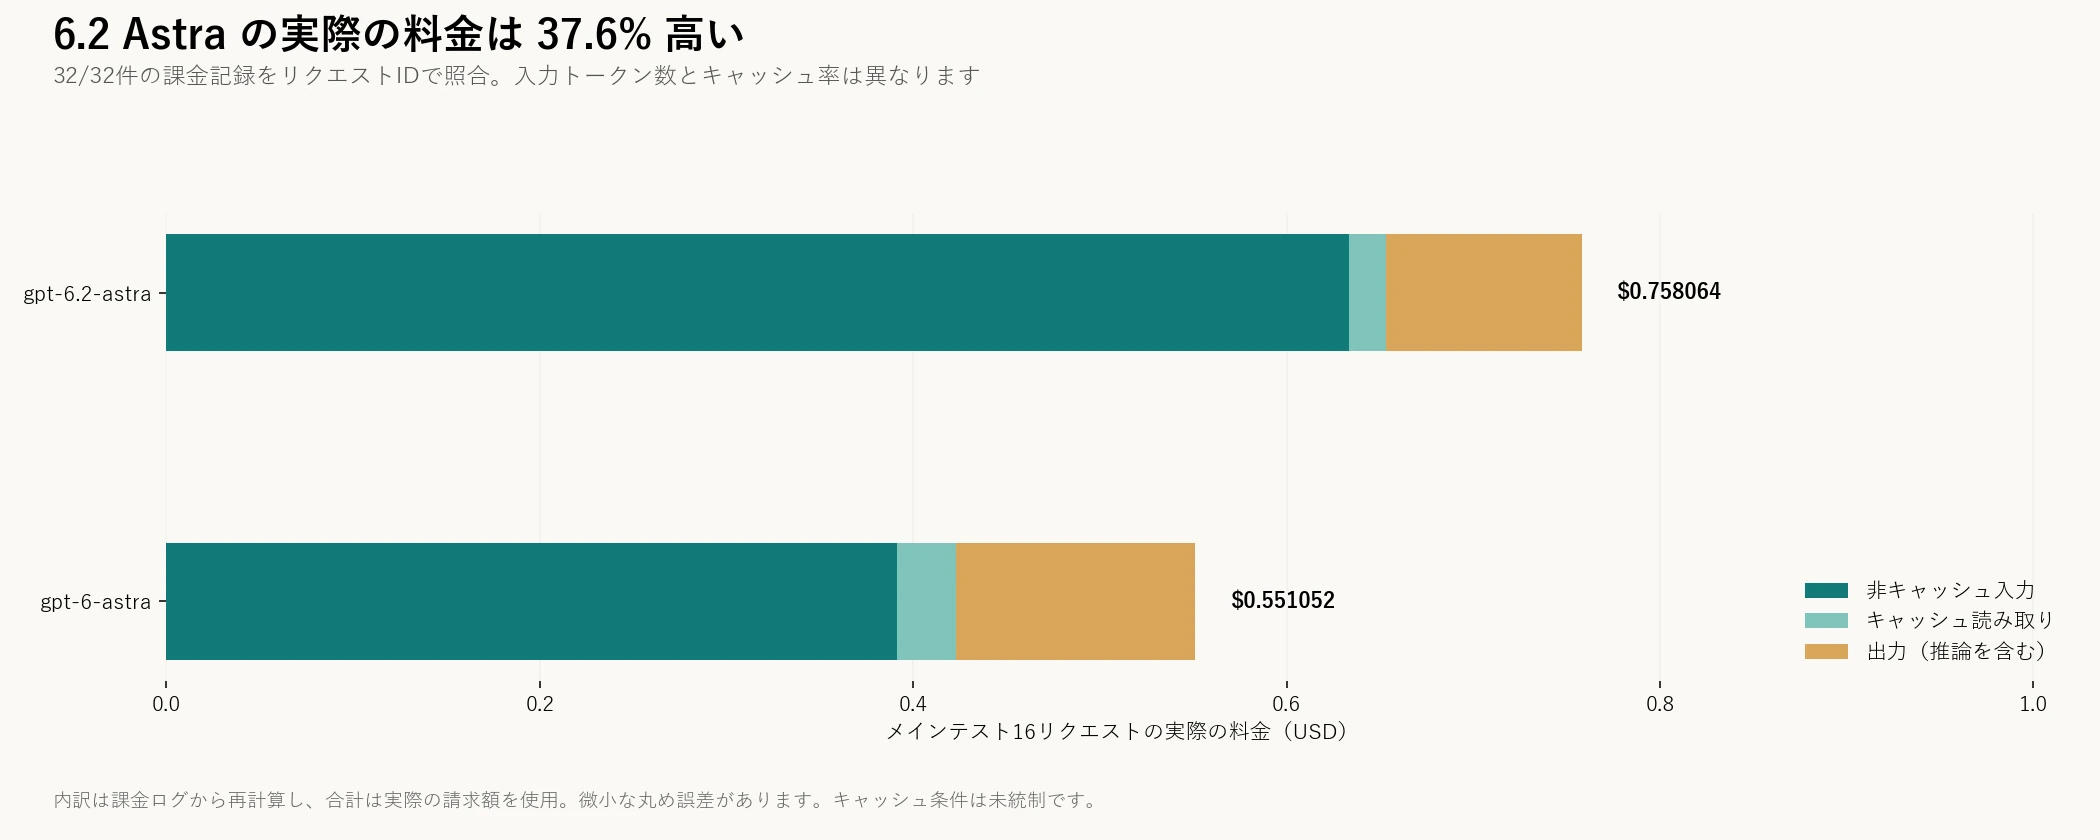
合計額には実際の請求額を用いています。図の内訳は課金ログから再現したもので、合計額とのわずかな差は丸めによるものです。記事末尾のサンプルを別途実行した2回の呼び出しは含みません。
今回、6.2 Astraの出力トークン数は少なかったものの、請求額は**37.6%**高くなりました。最終的な費用には、単価、報告された入力トークン数、キャッシュの割合がいずれも影響します。見えているプロンプトが同じでも、上流サービスが報告した入力トークン数は一致しませんでした。今回のテストでは、その原因の特定までは行っていません。
キャッシュは消去しておらず、一部の問題は過去のテストセットから流用しています。これは実際に処理したタスクの費用の記録です。キャッシュが空の状態にそろえたコストベンチマークではなく、すべてのユーザーの月額費用が37.6%増えるとそのまま推計することもできません。
導入方法:モデル名を切り替えられるようにし、手元のタスクで回帰テストを行う#
すでにGPT-6 Astraを呼び出している場合は、既存のデフォルトモデルを維持したまま、テスト環境でmodelフィールドを切り替え、普段使うタスクで比較できます。以下のサンプルでは、同じBase URLから両モデルを呼び出し、半開区間の結合を求めます。
実行前にrequestsをインストールし、環境変数CRAZYROUTER_API_KEYに自分のAPIキーを設定してください。コードはキーを出力しません。
import json
import os
import requests

BASE_URL = "https://api.crazyrouter.com/v1"
MODELS = ["gpt-6.2-astra", "gpt-6-astra"]
PROMPT = ('Merge half-open intervals [[-3,2],[1,5],[5,9]]. '
          'Return JSON only: {"merged":[[start,end]],"length":integer}.')


def run():
    session = requests.Session()
    session.trust_env = False
    results = []
    for model in MODELS:
        response = session.post(
            BASE_URL + "/chat/completions",
            headers={"Authorization": "Bearer " + os.environ["CRAZYROUTER_API_KEY"]},
            json={
                "model": model,
                "messages": [{"role": "user", "content": PROMPT}],
                "reasoning_effort": "high",
                "max_completion_tokens": 8192,
                "stream": False,
            },
            timeout=(15, 180),
        )
        response.raise_for_status()
        data = response.json()
        choice = data["choices"][0]
        if choice["finish_reason"] != "stop":
            raise RuntimeError("Incomplete output: " + str(choice["finish_reason"]))
        answer = json.loads(choice["message"]["content"])
        assert answer == {"merged": [[-3, 9]], "length": 12}, answer
        result = {"model": model, "answer": answer,
                  "request_id": response.headers.get("x-oneapi-request-id")}
        print(json.dumps(result, ensure_ascii=False))
        results.append(result)
    return results


if __name__ == "__main__":
    run()
このコードは本テストとは別に実行しました。両モデルとも{"merged":[[-3,9]],"length":12}を返し、終了理由はstopでした。この2回の呼び出しは、前述の32回の評価に含めていません。サンプルでは一般ユーザー向けのルートを使用し、本テストでは経路による差を抑えるためにチャネルを固定しました。
接続時に指定するフィールドは、Crazyrouter APIドキュメントで確認できます。Codexの接続設定やCursorの接続設定を使っているチームも、実際のツールチェーンで回帰テストを行ってください。この記事でテキスト呼び出しに成功しただけでは、これらのツールのすべての機能を検証したことにはなりません。
すでにGPT-6 Astraを使っているなら、6.2 Astraにアップグレードすべき?#
まずはタスクに応じて判断できます。
| 主なニーズ | 今回のデータに基づく選択肢 |
|---|---|
| 既存のルール検証やデータ整理が安定しており、費用を優先したい | GPT-6 Astraを維持する。当サイトの現在の割引料金では、キャッシュなし入力と出力の単価が有利 |
| 組み合わせ最適化の待ち時間が長い | GPT-6.2 Astraを優先的に試し、実際の問題を増やして速度の改善を確認する |
| 重複排除の順序、トランザクションの挙動、境界条件の判断をよく扱う | 回帰テストの比較対象に6.2 Astraを加える。今回はこれらの問題で6.2 Astraの方が速かったが、正答は両モデルで得られた |
| バージョン番号が上がるだけで正答率も上がると期待している | 今回はそれを裏づける証拠がない。現行モデルが実際に間違えたタスクを追加する必要がある |
| 画像理解、長時間のエージェント動作、ツール連携が必要 | 用途に応じたテストを別途行う。今回はこうした場面を対象にしていない |
Model Arenaで同じ問題を使った比較を始めることもできます。ただし、本格的な移行にあたっては、具体的なプロンプト、採点ルール、利用料金の記録を残しておいてください。GPT-6 Astraのモデルページ (英語)は旧設定の確認に使えますが、手元の回帰テストの結果に代わるものではありません。
制約付き最適化問題を再現する#
この問題で使用したユーザープロンプトの全文は以下のとおりです。本テストでは推論レベルをhigh、出力上限を8192とし、systemメッセージでJSONのみを返すよう指定しました。正解はローカルでの採点にのみ使い、モデルには送っていません。
Items IDs 0..11 have weights [4, 7, 2, 9, 5, 3, 8, 6, 4, 7, 1, 5] and values [13, 18, 7, 26, 14, 9, 23, 16, 12, 20, 4, 15]. Select total weight <=26 and at most 5 items. Constraints: selecting 3 requires 1; 6 and 7 cannot both be selected; selecting 9 requires 2; at least one of 0 and 4 must be selected. Maximize total value. Return JSON with best_value and optimal_sets (ALL optimal ID lists sorted ascending, and lists lexicographically sorted).
事前に算出した正解は以下のとおりです。
{"best_value": 78, "optimal_sets": [[0, 2, 6, 9, 11]]}
12個の候補のすべての部分集合を列挙し、重量、選択数、依存関係、排他条件で絞り込めば、最適解を検証できます。検証に使えるリクエストと応答の原本、および課金明細は保存済みです。この記事の表とグラフはすべてこれらの記録に基づいています。
記事中の最小構成のサンプルを別途実行した2回のリクエストIDは以下のとおりです。
gpt-6.2-astra:83b6190a33a5765d75070b0cf645e4ca。gpt-6-astra:6a229d1cd68136b18781f531d8a5d77e。
よくある質問#
GPT-6.2 Astraは必ずGPT-6 Astraより賢い?#
今回のテストからはそう結論づけられません。8種類のタスクを各2回実施し、両モデルとも16/16件で全項目に正解しました。能力の向上を評価するには、より多くの難問、実際に失敗した事例、独立した採点が必要です。
GPT-6.2 AstraはGPT-6 Astraよりどれくらい速い?#
タスクと集計方法によります。今回は、制約付き集合選択の平均応答時間が54.3%短縮され、全リクエストの平均応答時間は12.57秒から8.84秒に下がりました。一方、中央値は8.16秒から9.57秒に上がりました。呼び出すたびに速くなるとは言えません。
GPT-6.2 Astraの方が安い?#
公式Standardの短い入力向けの料金区分では、キャッシュなし入力と出力の単価がいずれも20%低くなっています。ただし、今回、当サイトでは旧モデルの料金が通常の6.5割(35%引き)で、両モデルのトークン使用量やキャッシュの状況にも違いがありました。その結果、同じ一連のタスクを処理するのにかかった総費用は6.2 Astraの方が高くなりました。
GPT-6.2 Astraのコンテキストウィンドウは広くなった?#
今回確認した公式モデルページによると、両モデルとも1,050,000 tokensで、最大入力もともに922,000 tokensです。[1][2] 実際のリクエストで報告された最大入力は14,326 tokensであり、100万トークン規模のコンテキストでの性能は検証していません。
JSONが返ったなら、構造化出力の機能も検証済み?#
いいえ。今回はプロンプトでJSON出力を求め、プログラムで解析して正解と照合しました。JSON Schemaによる制約の強制はテストしておらず、ストリーミング、ツール呼び出し、Responses APIも検証していません。
32回すべて成功したなら、長期的な安定性も確認できた?#
今回分かるのは、本テストの32回のリクエストでHTTPレベルの失敗、応答の途中打ち切り、誤答がなかったことまでです。サンプルは1つの時間帯、1つのチャネルから得たもので、各問題の反復は2回だけです。長期的な可用性や本番環境のSLAを示すものではありません。
参考資料・再現情報
- OpenAI:GPT-6.2 Astraモデルドキュメント。確認日:2026-11-20。
- OpenAI:GPT-6 Astraモデルドキュメント。確認日:2026-11-20。
- PostgreSQL:トランザクション分離とRead Committed。トランザクション問題のルール確認に使用しました。
執筆:Boluo Z。テストは自動化スクリプトで実行しました。この記事は当サイトのルーティングを利用した際のサービスの実測記録であり、上流モデルの重みを独立に監査したものではありません。変更される可能性がある料金や機能の情報は、2026-12-20に再確認する予定です。
Implementation Guides
最新エピソード
EP196 · 2026年10月29日 · 6:53
AI API Security Posture — Turn Controls Into Continuous Evidence
A practical guide to AI API security posture: inventory exposure, verify controls continuously, protect keys and data, constrain tools, and turn security assumptions into evidence that operators can act on.
EP195 · 2026年10月28日 · 7:21
AI API Policy Drift — Detect When Production Rules Stop Matching Intent
A practical guide to policy drift in AI APIs: version routing and safety rules, detect stale enforcement, compare intended and observed behavior, and restore control before small gaps become incidents.