简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
Claude Opus 5.5 vs GPT-6.1 Sol:公式ベンチマーク・料金・選び方
Claude Opus 5.5とGPT-6.1 Solの公式ベンチマーク、API料金、選定基準を比較。Crazyrouterの16件の記録を補足し、ベンダー公表値と実測を区別します。Opusの同一タスク比較はありません。
2026年10月30日時点では、公開情報だけで Claude Opus 5.5 と GPT-6.1 Sol に、あらゆるタスクに通用する総合順位を付けることはできません。**Crazyrouter が固定経路で GPT-6.1 Sol に送った16回のタスクリクエストでは、14回で結果を受領し、そのうち13/14件の回答が完全正解でした。Opus 5.5 の同一課題サンプルがないため、このローカルデータから勝者を判定することはできません。**一方、公式発表資料によれば、GPT-6.1 Sol は中程度の推論設定での AutomationBench で Opus 5.5 を2.2パーセントポイント上回り、タスク当たりのコストは約3分の1でした。Opus 5.5 は、別の高推論設定によるコーディングおよび科学ベンチマークで、高い能力の上限を示しています。これらのベンダー評価を、同じ研究機関が同一設定で実施した独立した比較評価とみなすことはできません。
長時間にわたる多段階のコーディングエージェント作業を重視するなら、Opus 5.5 を優先的に候補に入れるとよいでしょう。日常のタスク量が多く、API コストを抑えたいなら、GPT-6.1 Sol を先に試す価値があります。最終的には、個別のランキングだけでなく、自分のタスクでの合格率、手直し回数、総請求額で選ぶべきです。
Claude Opus 5.5 vs GPT-6.1 Sol、日常業務にはどちらが向いている?#
両モデルの対象領域には重なりがありますが、公開データから見える重点は異なります。Opus 5.5 は Anthropic が公開した高難度のコーディング、デスクトップ操作、知識労働のテストで優れた結果を示しています。一方、OpenAI は GPT-6.1 Sol の専門文書、業務ワークフロー、科学研究タスクにおけるコスト効率を強調しています。公開情報はワークロード別の選択を支持するものであり、あるベンダーの単一項目での優位を全面的な勝利へと一般化する根拠にはなりません。
早見比較#
| 項目 | Claude Opus 5.5 | GPT-6.1 Sol | 数値を読む際の注意点 |
|---|---|---|---|
| 公式 API モデル名 | claude-opus-5-5 | gpt-6.1-sol | サードパーティーのゲートウェイを利用する場合は、その時点の /v1/models の返却内容とドキュメントを基準にする |
| 公式 API 標準料金 / 100万 token | 入力 20、キャッシュ読み取り $0.20 | 入力 10、キャッシュ入力 $0.10 | GPT-6.1 Sol の標準入力・出力・キャッシュ入力の公示料金は、Opus 5.5 の約半額。実際の請求額はキャッシュ、ツール、出力長にも左右される |
| API コンテキストウィンドウ | 1,000,000 tokens | 1,050,000 tokens | 実際に使えるウィンドウは、利用する製品、インターフェース、リクエスト設定にも依存する |
| デフォルトの推論設定 | medium。adaptive thinking は常に有効 | medium | 同名の設定でも、推論予算や計算量が同じとは限らない |
| Anthropic SWE-bench Pro サブセット | medium:解決率92.8%、$0.22 / solved task | 同一サブセットでの公開比較なし | 元の互換サブセットは482問。Opus 5.5 の2回の実行は478問で採点されており、公開ランキングの成績とは異なる |
| AutomationBench | Anthropic 公表値は40.0%。この結果では fallback を不使用 | OpenAI によれば、中程度の推論設定で2.2パーセントポイント高く、タスク当たりのコストは約3分の1 | Anthropic のページには、Opus 5.5 の結果が Zapier の初期テストに由来するとも記載されている。各報告の fallback と実行条件は分けて考える必要がある |
| GDP.pdf 専門文書 | OpenAI の比較では、GPT-6.1 Sol はテストした全推論設定で fallback 付きの Opus 5.5 を上回り、タスク当たりのコストは半分未満 | OpenAI の発表資料における自己報告の結果 | 公開本文には、この比較の全スコアが記載されていない。すべての PDF や知識労働で GPT-6.1 Sol が勝つとは推測できない |
| Terminal-Bench 4.0 | Anthropic 公表値は66.4%、xhigh effort を使用 | Anthropic の表に GPT-6.1 Sol の記載なし | 表中の GPT 比較対象は GPT-6 Astra であり、GPT-6.1 Sol ではない |
| Terminal-Bench Science 0.1 | Anthropic 公表値は58.7%、標準誤差は±3.5–5パーセントポイント | OpenAI によれば、最高推論設定の平均タスクコストは 23.21。発表本文には GPT-6.1 Sol の正確なスコアの記載なし | タスク合格率とタスク当たりのコストは別の指標。低コストをそのまま相手より高い正答率と言い換えることはできない |
| Crazyrouter のローカル小規模サンプル | Opus 5.5 の同一課題の結果なし | 16回のリクエスト中14回で結果を受領。受領した回答の13/14件が正解で、別に2回のタイムアウトあり | 2026-09-30 の固定経路による個別のワークロード記録。Opus との比較でも、長期稼働率でもない |
公式ベンチマークが示す強みは異なる#
業務ワークフロー:GPT-6.1 Sol はコスト面の主張がより明確#
OpenAI は2026年9月29日の発表資料で、GPT-6.1 Sol は中程度の推論設定の AutomationBench で Opus 5.5 より2.2パーセントポイント高く、タスク当たりのコストは約3分の1だと述べています。AutomationBench は、エージェントが47種類のツールを使い、営業、マーケティング、業務運営、顧客対応、財務、人事などのエンドツーエンドのワークフローを完了する能力をテストします。
Anthropic の Opus 5.5 のページには AutomationBench 40.0% と記載され、この実行では fallback を使用していないことが明示されています。同じ表の GPT-6 Astra は41.4%です。したがって、OpenAI の直接比較を引用する際は、OpenAI の発表資料における比較結果であるという位置付けを維持すべきです。両社のページにある数値をつなぎ合わせ、条件が完全に統制された独立実験として扱ってはいけません。fallback は完了率とコストだけでなく、ユーザーが実際に受け取る成果物にも影響します。
コーディング:Opus 5.5 は公開された高推論設定の成績が優秀、GPT-6.1 Sol の直接比較スコアは少ない#
Anthropic によれば、Opus 5.5 の Terminal-Bench 4.0 のスコアは66.4%で、評価には xhigh 推論設定が使われています。同ページには GPT-6 Astra の57.9%も掲載されていますが、GPT-6.1 Sol の同項目の結果はありません。また Anthropic は、Opus 5.5 の FrontierCode v1.1 メインセットのスコアを54.4%と公表しており、表中の GPT-6 Astra の53.3%を上回っています。これらの数値は、記載されたコーディングエージェントのテストで Opus 5.5 に競争力があることを示します。ただし、比較モデル、推論設定、評価条件が完全にはそろっていないため、GPT-6.1 Sol に必ず勝ることを直接示すものではありません。
Anthropic のモデルコストガイドには、別の比較的新しいコーディングデータも掲載されています。SWE-bench Pro 互換サブセットでは当初482問を選定しましたが、採点コンテナの問題により、Opus 5.5 の2回の medium 実行は残り478問で採点され、解決率は92.8%、解決タスク当たりのコストは約 $0.22 でした。Anthropic は、このサブセットと実行条件が、公開 SWE-bench Pro ランキングおよび Opus 5.5 system card の結果とは異なることを明記しています。OpenAI は同じサブセットで GPT-6.1 Sol の比較スコアを公開していないため、これらの数値は Opus 5.5 自体の品質とコストの基準を補足するものにとどまります。
OpenAI の GPT-6.1 Sol に関する主張は DeepSWE v1.1 が中心です。同社によれば、GPT-6.1 Sol は低めの推論設定でも GPT-6 Sol の最高スコアを6.4パーセントポイント上回り、GPT-6 Astra と同等の結果を、約5分の1のタスクコストで達成しています。この結果は、GPT-6.1 Sol が前世代の Sol から向上したことの根拠であり、Opus 5.5 との比較スコアではありません。
専門文書と科学タスク:成果を得るコストと、スコアが示されているかを確認する#
OpenAI によれば、GPT-6.1 Sol は GDP.pdf でテストしたすべての推論設定において「fallback 付きの Opus 5.5」を上回り、タスク当たりのコストは半分未満です。GDP.pdf では、表、グラフ、模式図、詳細な規定を含む複雑な PDF から、専門的な質問に回答することが求められます。発表本文には、設定別の全スコア、fallback の実行詳細、共通の評価記録がそろって掲載されていないため、この結論は選定の手掛かりとして扱うのが適切であり、無条件の勝敗判定に書き換えるべきではありません。
Terminal-Bench Science 0.1 では、OpenAI は GPT-6.1 Sol の最高推論設定での平均タスクコストを 23.21 と報告しています。Anthropic は Opus 5.5 のスコアを58.7%とし、その標準誤差は±3.5–5パーセントポイントとしています。しかし、OpenAI の発表本文には GPT-6.1 Sol の正確なスコアが記載されていません。したがって、公開されたコスト情報は比較できますが、この2つの記述だけで、どちらの科学タスク成功率が高いかを判断することはできません。
API 料金にはどれほど差がある?#
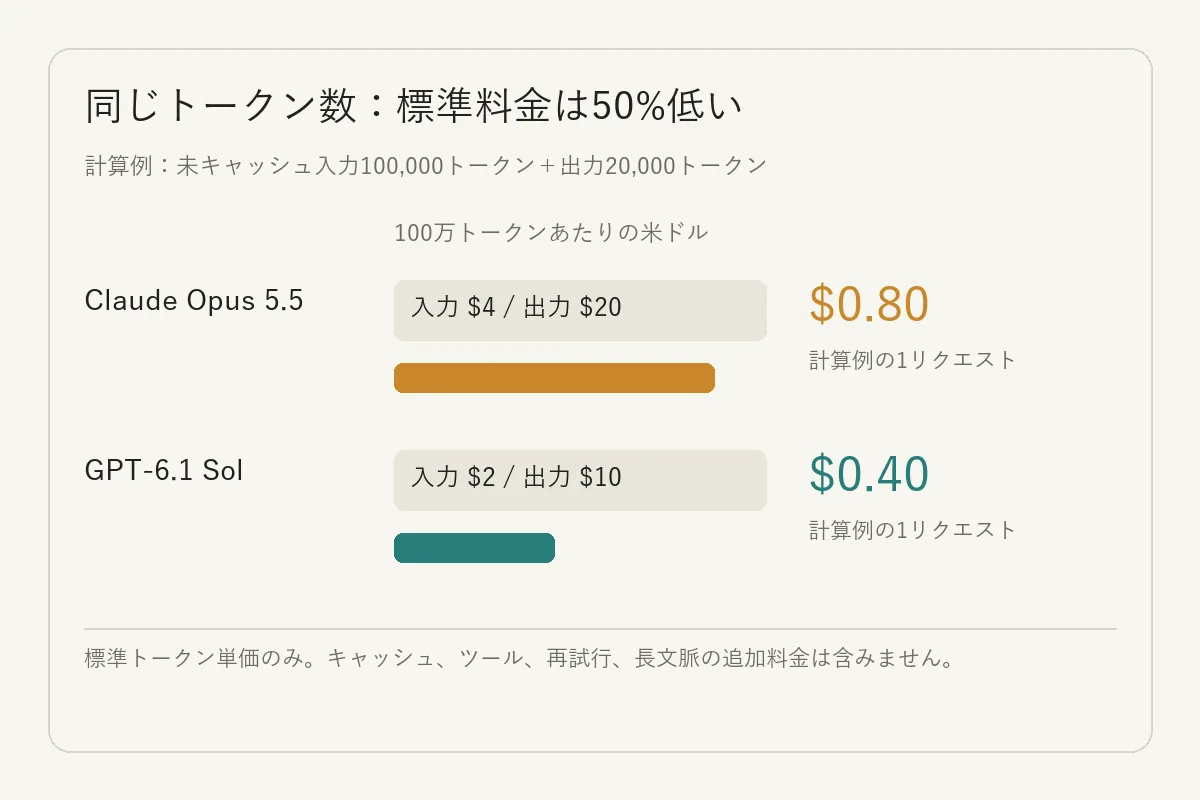
両社の公式ページに記載された標準 API 料金では、Opus 5.5 は入力100万 token 当たり 20、GPT-6.1 Sol はそれぞれ 10 です。1回のリクエストで、未キャッシュの入力100,000 token と出力20,000 token を使用した場合、標準料金による概算は次のとおりです。
input_tokens = 100_000
output_tokens = 20_000

opus55 = input_tokens / 1_000_000 * 4 + output_tokens / 1_000_000 * 20
gpt61 = input_tokens / 1_000_000 * 2 + output_tokens / 1_000_000 * 10

print(f"Opus 5.5: ${opus55:.2f}")
print(f"GPT-6.1 Sol: ${gpt61:.2f}")
この例では Opus 5.5 が 0.40 になります。比較しているのは未キャッシュのテキスト token の公示料金のみで、再試行、ツール呼び出し、長文脈の追加料金、キャッシュ戦略、その他のホスティングプラットフォームの割引は含まれません。GPT-6.1 Sol は API リクエストの入力が272,000 tokens を超えると、そのリクエストにはより高い長文脈料金が適用されると公式料金ドキュメントに記載されています。一方、Opus 5.5 の公式ドキュメントでは、1M のコンテキストウィンドウを標準料金で利用できるとされています。Anthropic と OpenAI では、token の計測方法、推論のオーバーヘッド、製品設定も完全に同じとは限りません。そのため、「公示料金が半額」は「同じワークフローの総請求額が必ず半額」を意味しません。
利用前には、ベンダー別のモデルと接続方法やモデル料金比較を確認できます。提供元のカタログを確認する場合は、Anthropic モデルカタログと OpenAI モデルカタログも参照できます。各プラットフォームの割引や課金設定は、ベンダーの標準公示料金と異なる場合があります。
Crazyrouter の GPT-6.1 Sol の記録から何が分かる?#
2026年9月30日に行ったローカル開発ワークロードのテストでは、GPT-6.1 Sol を固定経路、reasoning_effort=high、max_completion_tokens=8192 で使用しました。8種類のタスクをそれぞれ独立に2回ずつ、合計16回リクエストし、14/16回で結果を受領しました。そのうち13件の回答は完全正解でした。残る2回は240秒待っても完全なレスポンスを受信できませんでした。主バッチには、隠しチェック付きのコード問題が2問含まれます。別途、独立した模擬ツールフローも1回実施しましたが、上記16回の主タスクには含まれません。このような小規模サンプルは、長期的なリポジトリ開発テストの代わりにはなりません。
このテストでは Claude Opus 5.5 に同じ問題群を実行していません。したがって、このタスク群における GPT-6.1 Sol の結果の受領状況は分かりますが、GPT-6.1 Sol が Opus 5.5 より正確、高速、安定的だとは主張できません。公式ベンチマークに対するこの記録の価値は、実際のゲートウェイ経路での小規模サンプルを補い、タイムアウトも成果物を受け取る体験に含める必要があると示す点にあります。
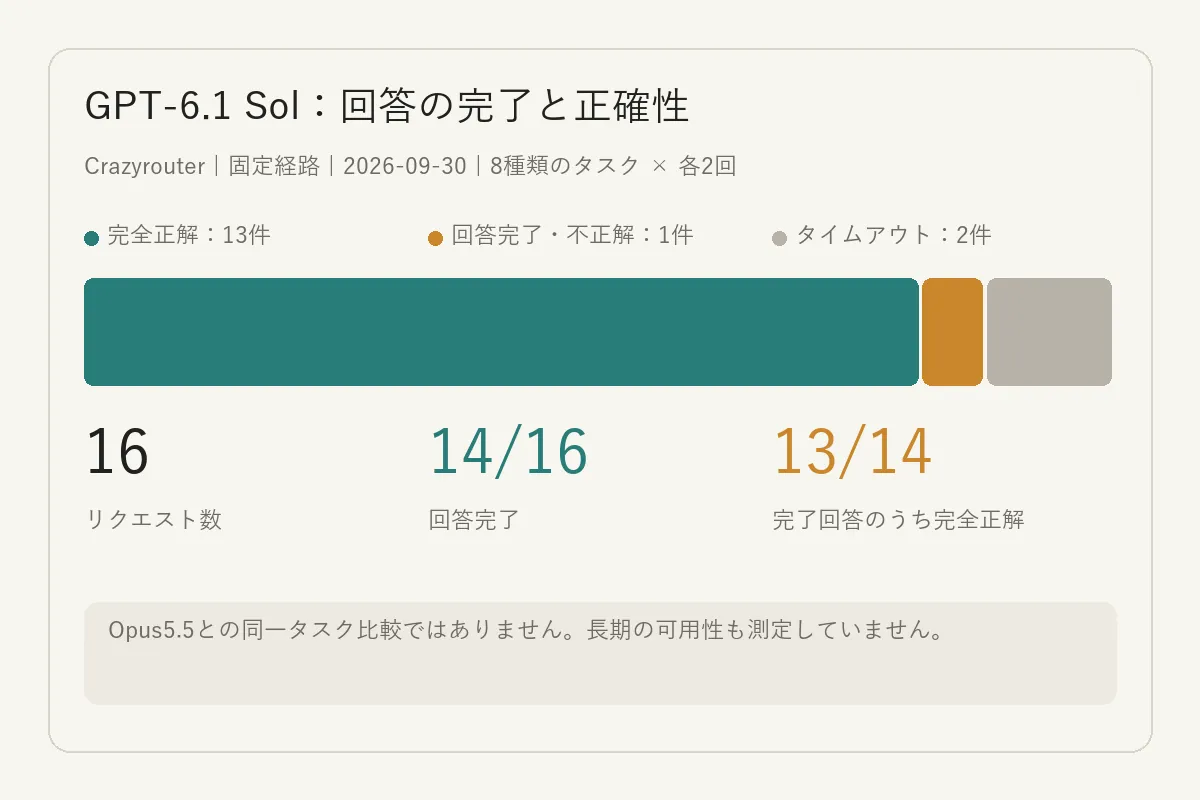
この記録は、各ベンダーが公開するモデルカードとは種類の異なる証拠です。モデルをコーディングエージェントに接続する予定なら、まず Claude Code 接続ガイドと Codex 接続ガイドを確認し、自分のリポジトリのタスクで受け入れテストセットを作成するとよいでしょう。
ローカル記録のリクエストと失敗に関する説明#
このテストで使用した Base URL は https://api.crazyrouter.com/v1、エンドポイントは POST /chat/completions、モデルは gpt-6.1-sol です。リクエストには messages(固定の system プロンプトと同一課題の user プロンプト)、reasoning_effort="high"、max_completion_tokens=8192 を使用し、temperature は送信していません。これは2026-09-30 の過去の記録であり、本記事の公開日に改めて行った可用性テストではありません。
| 項目 | 確認可能な結果 |
|---|---|
| 結果の受領状況 | 14/16回のリクエストで完全な結果を受信。そのうち13/14件の回答が完全正解 |
| 受領したが誤答 | ルールの件数を数えるタスクで、実際には72件あるところを1回、71件と回答 |
| 結果を受領できなかったもの | 長いルール群の検索と、制約付き最適集合の選択が、それぞれ1回ずつ240秒待機後にタイムアウト。再試行の成功で失敗を上書きしていない |
| タスク例 | 請求イベントの重複排除:イベント ID で全体の重複を除き、10 <= ts < 20 を残し、内部ユーザーを除外して純額を計算 |
| リクエスト例の最終状態 | HTTP 200、finish_reason=stop。回答はローカルの正解データとの照合に合格 |
レスポンス ID の例:resp_0a6633bd82c5ee75016abd0e0e8b9887d29ef32e920c8843ba。リクエスト ID:202609301326374284700288BdKuu3w。この例は合成テストデータで、返された最終回答は次のとおりです。
{"net_cents_by_user":{"alice":-173,"bob":88},"included_unique_events":12}
タイムアウトが示すのは、クライアントが待機上限内に完全な結果を受信できなかったということだけです。モデルが問題を解けないことや、上流のリクエストがすでにキャンセルされたことを証明するものではありません。このサンプルでは、長期稼働率や両モデルの最初の token までの遅延は測定していません。
選び方:タスクに応じた受け入れテストセットを作る#
- Opus 5.5 を優先評価:大規模なコード移行、複数リポジトリのレビュー、長期にわたるコーディングエージェント作業、高い推論能力のために高めの標準 token 料金を支払える業務。
- GPT-6.1 Sol を優先評価:大量に繰り返す日常的な API リクエスト、業務プロセスの自動化、複雑な PDF からの抽出、タスク当たりのコストを抑える必要があるエージェントタスク。
- 並行して試す:タスクの価値が高い場合、誤りの損失が大きい場合、結果をそのまま本番で使う場合。モデルのバージョン、推論設定、ツール、コンテキスト、合格条件を固定し、タイムアウト、fallback、再試行の記録を残す。
まずは20–50件の実タスクから小規模な受け入れテストセットを作り、完全な結果を受領できたか、自動チェックの合格率、人手による手直し回数、エンドツーエンドの所要時間、総 token コストを項目ごとに記録することを勧めます。タスクをコーディング、文書、ツールフローに分類してから集計してください。総合点だけでは、特定のサブタスクにおけるモデルの明確な弱点が隠れがちです。
よくある質問#
Claude Opus 5.5 は必ず GPT-6.1 Sol より高性能ですか?#
そのようには一括りにできません。Opus 5.5 は Anthropic が公開した Terminal-Bench 4.0 などのテストで優れた成績を示しています。一方、OpenAI は、特定の GDP.pdf と AutomationBench の条件下では GPT-6.1 Sol が Opus 5.5 を上回るとしています。評価機関、推論設定、fallback、タスク集合が異なるため、自分のタスクと組み合わせて検証するのが適切です。
GPT-6.1 Sol は Opus 5.5 よりどれくらい安いですか?#
公式の標準 API 料金では、GPT-6.1 Sol は入力100万 token 当たり 10、Opus 5.5 はそれぞれ 20 です。同じ未キャッシュ token 数なら、公示料金は約50%低くなります。実際のタスクの請求額は、出力長、キャッシュ、再試行、プラットフォームの料金にも左右されます。
コーディングにはどちらが向いていますか?#
Opus 5.5 は、公式に公開された Terminal-Bench 4.0 と FrontierCode の成績が優秀です。GPT-6.1 Sol の公開発表資料は、長期的なソフトウェアエンジニアリングのテストである DeepSWE を重視しています。両モデルを同じコーディング評価ハーネス、同じ推論予算で比較した完全な公開データがないため、実際のリポジトリのタスクで試す方が確実です。
この記事では Opus 5.5 と GPT-6.1 Sol のローカル同一課題テストを行いましたか?#
いいえ。この記事は両社の公式評価資料を引用し、Crazyrouter が2026年9月30日に行った GPT-6.1 Sol への16回のリクエスト記録を補足しています。このバッチには Opus 5.5 の比較対象が含まれていないため、ローカルの2モデル比較 benchmark とは呼べません。
モデルを選ぶ際には、どの指標を見るべきですか?#
少なくとも、タスク合格率、完全な結果の受領率、タイムアウトと fallback、人手による手直し、エンドツーエンドの所要時間、総 token コストを併せて確認してください。エージェントのワークフローでは、ツール呼び出しが完了したか、モデルが失敗を正しく処理したか、最終成果物が自動受け入れテストに合格したかも確認する必要があります。
結論#
Opus 5.5 と GPT-6.1 Sol の公開データが示すのは、タスクごとのトレードオフです。Opus 5.5 は高推論設定のコーディングと科学タスクの結果が魅力的です。GPT-6.1 Sol は標準 token 料金が低く、OpenAI は一部の業務ベンチマークでタスクコストの優位性を報告しています。コストが主な制約なら、まず GPT-6.1 Sol を試してください。複雑で長期にわたるタスクの品質の上限を重視するなら、Opus 5.5 を同一課題の受け入れテストに含めてください。両者を同条件で実測するまでは、ベンダーのベンチマークを合算して総合王者を決めるべきではありません。
出典とテスト条件#
- Anthropic, Claude Opus 5.5 の紹介, 2026-09-22. 公式料金、Terminal-Bench、FrontierCode、AutomationBench、Terminal-Bench Science のデータと条件の説明を含む。
- OpenAI, GPT-6.1 Sol の紹介, 2026-09-29. GDP.pdf、AutomationBench、Terminal-Bench Science における GPT-6.1 Sol と Opus 5.5 の発表元による比較、および API 料金を含む。
- Anthropic, Claude Opus 5.5 モデル・料金ドキュメントおよびコストと能力の最適化ガイド. モデルの制限、料金、当初482問の SWE-bench Pro 互換サブセットの方法と結果を含む。
- OpenAI, GPT-6.1 Sol API モデルドキュメント. API コンテキストウィンドウ、出力上限、標準入力料金とキャッシュ入力料金、長文脈料金の適用しきい値を含む。
- Crazyrouter、2026-09-30 の内部アーカイブ『GPT-6 Sol、GPT-6.1 Sol と GPT-5.6 Sol、GPT-6 Astra の比較:実測と主力モデルの選定』。本記事では結果の概要とレスポンス識別子1件を公開。完全なリクエスト、採点スクリプト、レスポンスは編集部でローカル保存しており、完全な証拠一式のオンラインダウンロードは提供していない。このバッチには Opus 5.5 の同一課題の結果は含まれない。
本記事は、ベンダーが自己報告した評価を独立した追試とは呼ばず、両モデルの最初の token までの遅延、長期信頼性、本番環境での総合順位も比較していません。両社の公式料金とローカルゲートウェイの実際の料金は異なる場合があるため、本番導入前に最新の料金表を再確認してください。