简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
Claude Opus 5.5 vs GPT-6.1 Sol:官方基準、價格與選型
比較Claude Opus 5.5與GPT-6.1 Sol的官方基準、API價格與選型,並補充Crazyrouter的16次請求紀錄。廠商自報結果與本地樣本分開呈現,保留逾時與答錯紀錄,明確說明沒有Opus同題對照。
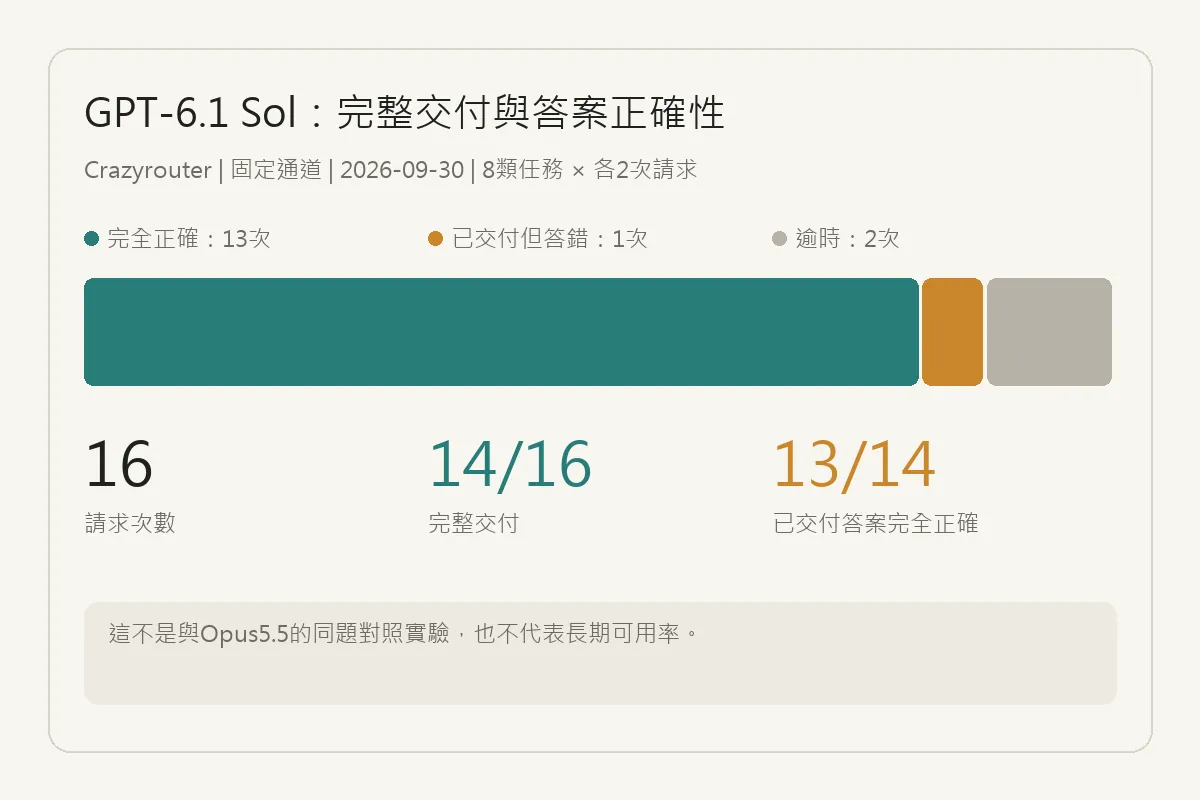
截至 2026 年 10 月 30 日,公開證據不足以為 Claude Opus 5.5 和 GPT-6.1 Sol 排出一個適用於所有任務的總排名。**Crazyrouter 在固定管道對 GPT-6.1 Sol 的 16 次任務請求中記錄到 14 次交付、13/14 個交付答案完全正確;由於沒有 Opus 5.5 同題樣本,這組本地資料無法判定誰勝出。**官方發布資料另稱,GPT-6.1 Sol 在中等推理等級的 AutomationBench 比 Opus 5.5 高 2.2 個百分點、單一任務成本約為三分之一;Opus 5.5 則在另一組高推理等級的程式開發與科學基準中展現了很強的能力上限。這些廠商評測不能當成同一實驗室、同一設定下的獨立比較。
如果你重視長時間、多步驟的程式碼代理工作,可以優先將 Opus 5.5 納入候選;如果日常任務量大、希望控制 API 成本,GPT-6.1 Sol 更值得先測試。最終選擇應看自己的任務通過率、重做次數和總帳單,而不是只看單項排行榜。
Claude Opus 5.5 vs GPT-6.1 Sol,哪款更適合日常工作?#
兩款模型的目標範圍有所重疊,但公開資料反映的重點不同:Opus 5.5 在 Anthropic 公布的高難度程式開發、桌面操作和知識工作測試中表現突出;OpenAI 則強調 GPT-6.1 Sol 在專業文件、業務工作流程和科學研究任務中的成本效益。公開證據支持依工作負載做選擇,不支持將某一家廠商的單項領先推論為全面勝出。
快速比較#
| 面向 | Claude Opus 5.5 | GPT-6.1 Sol | 解讀時要注意 |
|---|---|---|---|
| 官方 API 模型名稱 | claude-opus-5-5 | gpt-6.1-sol | 使用第三方閘道時,應以其當時的 /v1/models 回傳結果和文件為準 |
| 官方 API 標準價格 / 百萬 token | 輸入 20;快取讀取 $0.20 | 輸入 10;快取輸入 $0.10 | GPT-6.1 Sol 的標準輸入、輸出和快取輸入標價約為 Opus 5.5 的一半;實際帳單還受快取、工具和輸出長度影響 |
| API 上下文視窗 | 1,000,000 tokens | 1,050,000 tokens | 實際可用視窗還取決於使用的產品、介面與請求設定 |
| 預設推理等級 | medium;調適性思考始終開啟 | medium | 同名等級不保證相同推理預算或相同運算量 |
| Anthropic SWE-bench Pro 子集 | medium:92.8% 解題率,$0.22 / 已解決任務 | 沒有同一子集的公開對照 | 原始相容子集 482 題;Opus 5.5 兩次執行按 478 題計分,不等於公開排行榜成績 |
| AutomationBench | Anthropic 公布 40.0%,該次結果未使用備援機制(fallback) | OpenAI 稱中等推理等級高 2.2 個百分點,單一任務成本約為三分之一 | Anthropic 頁面還指出,其 Opus 5.5 結果來自 Zapier 早期測試;不同報告的 fallback 與執行方式須分開看 |
| GDP.pdf 專業文件 | OpenAI 的比較稱 GPT-6.1 Sol 在各測試推理等級均高於使用 fallback 的 Opus 5.5,且每個任務成本不到一半 | OpenAI 發布資料中的自報結果 | 公布文字沒有列出這組比較的完整分數;不能據此推斷所有 PDF 或知識工作都由 GPT-6.1 Sol 勝出 |
| Terminal-Bench 4.0 | Anthropic 報告 66.4%,使用 xhigh effort | Anthropic 表格未列 GPT-6.1 Sol | 該表的 GPT 對照為 GPT-6 Astra,不是 GPT-6.1 Sol |
| Terminal-Bench Science 0.1 | Anthropic 報告 58.7%;標準誤為 ±3.5–5 個百分點 | OpenAI 報告最高推理等級每個任務平均成本 23.21;發布內文未提供 GPT-6.1 Sol 的精確分數 | 任務通過率與單一任務成本是兩個指標,不能將低成本直接寫成高於對方的準確率 |
| Crazyrouter 本地小樣本 | 沒有 Opus 5.5 同題結果 | 16 次請求中 14 次交付;交付答案 13/14 正確,另有 2 次逾時 | 2026-09-30 固定管道的獨立工作負載紀錄,不是 Opus 對照,也不是長期可用率 |
官方基準顯示的優勢並不相同#
業務工作流程:GPT-6.1 Sol 的成本主張更明確#
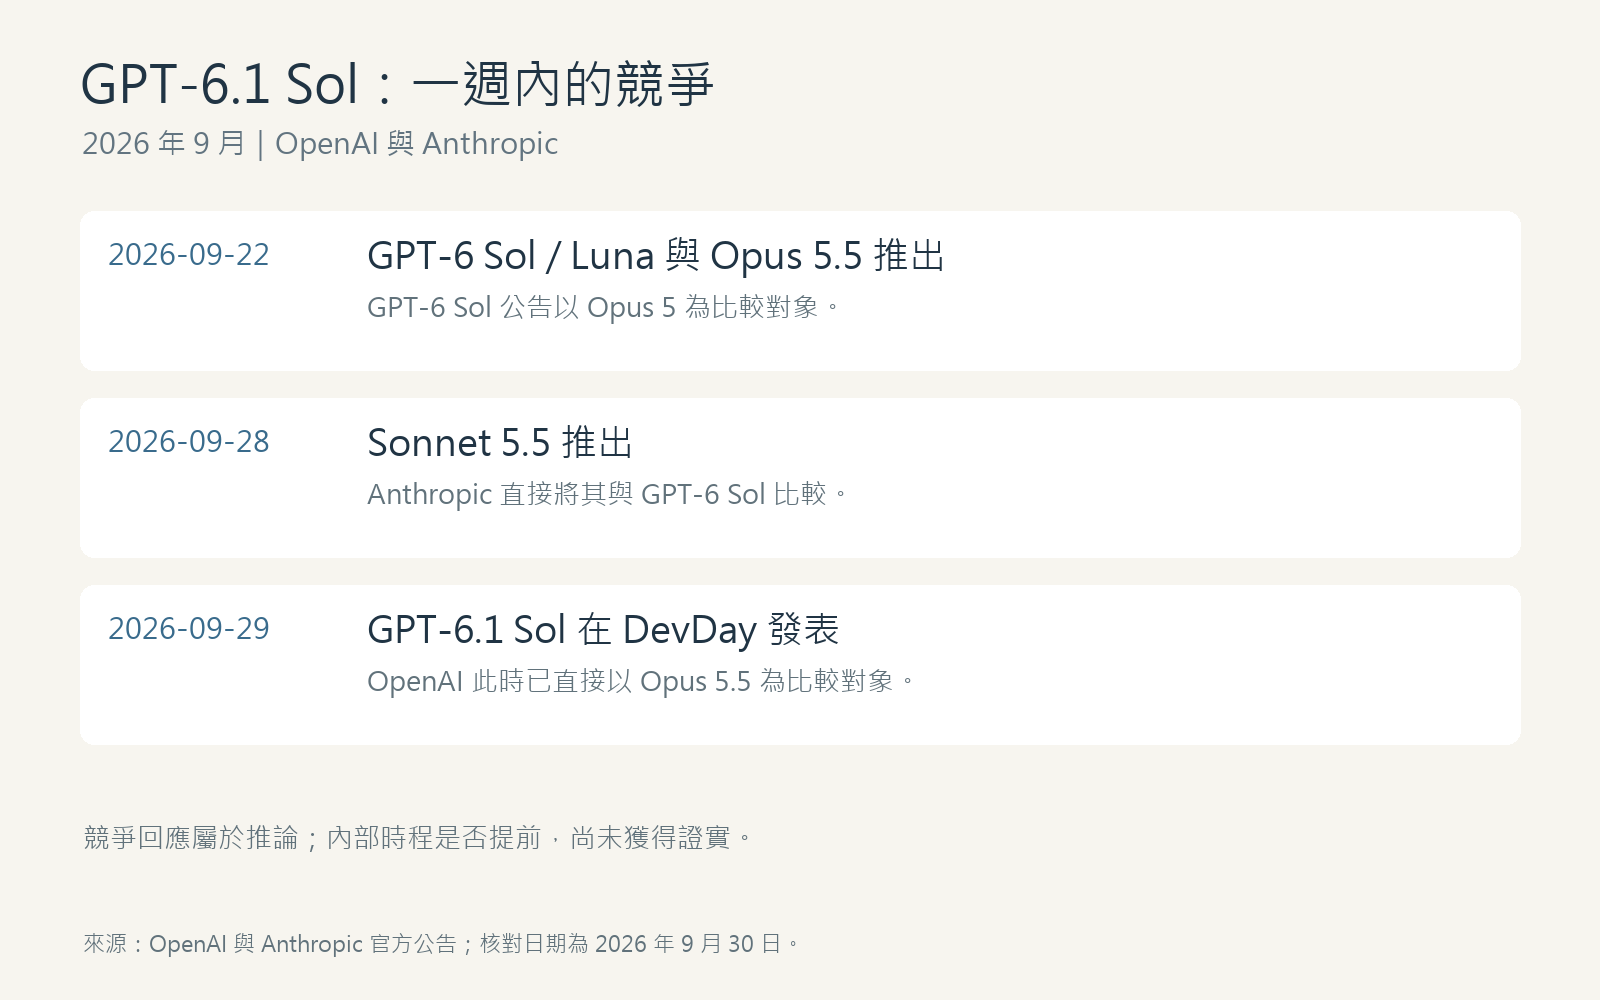
OpenAI 在 2026 年 9 月 29 日的發布資料中稱,GPT-6.1 Sol 在中等推理等級的 AutomationBench 得分比 Opus 5.5 高 2.2 個百分點,單一任務成本約為三分之一。AutomationBench 測試代理使用 47 種工具完成銷售、行銷、營運、客服、財務和人力資源等端到端工作流程。
Anthropic 的 Opus 5.5 頁面則列出 AutomationBench 40.0%,並明確說明這次執行未使用 fallback;同表 GPT-6 Astra 為 41.4%。因此,引用 OpenAI 的直接比較時,應保留它屬於 OpenAI 發布資料中的對照結果;不能將兩家頁面上的數字拼成一場控制條件完全一致的獨立實驗。fallback 會影響完成率與成本,也會影響使用者實際取得的交付結果。
程式開發:Opus 5.5 的公開高推理等級成績亮眼,GPT-6.1 Sol 的直接分數較少#
Anthropic 公布 Opus 5.5 在 Terminal-Bench 4.0 得分 66.4%,評測使用 xhigh 推理等級;該頁面同時列出 GPT-6 Astra 的 57.9%,但沒有 GPT-6.1 Sol 的同項結果。Anthropic 還公布了 Opus 5.5 在 FrontierCode v1.1 主要集合得分 54.4%,高於表內 GPT-6 Astra 的 53.3%。這些數字說明 Opus 5.5 在所列程式碼代理測試中具有競爭力,但不能直接說明它一定勝過 GPT-6.1 Sol,因為對照模型、推理等級或評測條件並不完全一致。
Anthropic 的模型成本指南還公布了另一組較新的程式開發資料:其 SWE-bench Pro 相容子集最初選取 482 題;由於評分容器問題,Opus 5.5 的兩次 medium 執行按剩餘 478 題計分,解題率為 92.8%,每個已解決任務約 $0.22。Anthropic 明確指出,這個子集和執行條件與公開 SWE-bench Pro 排行榜及 Opus 5.5 系統卡的結果不同。OpenAI 沒有在同一子集上公布 GPT-6.1 Sol 的對照分數,因此這組數字只能補充 Opus 5.5 本身的品質與成本基準。
OpenAI 對 GPT-6.1 Sol 的主張集中在 DeepSWE v1.1:它稱 GPT-6.1 Sol 在較低推理等級就超過 GPT-6 Sol 的最高分 6.4 個百分點,並與 GPT-6 Astra 的結果相當、任務成本約為五分之一。這個結果是 GPT-6.1 Sol 相較上一代 Sol 的升級證據,不是 Opus 5.5 對照分數。
專業文件與科學任務:看任務交付成本,也看是否提供分數#
OpenAI 稱 GPT-6.1 Sol 在 GDP.pdf 的各個測試推理等級均高於「使用 fallback 的 Opus 5.5」,單一任務成本不到一半。GDP.pdf 要求模型從包含表格、圖表、示意圖和細則的複雜 PDF 中回答專業問題。由於發布內文沒有同時提供完整的各等級分數、fallback 執行細節和共同評測紀錄,這個結論適合作為選型線索,不應改寫成無條件的勝負裁決。
在 Terminal-Bench Science 0.1 上,OpenAI 報告 GPT-6.1 Sol 最高推理等級平均每個任務 23.21。Anthropic 報告 Opus 5.5 得分 58.7%,並指出該分數的標準誤為 ±3.5–5 個百分點;但 OpenAI 發布內文沒有列出 GPT-6.1 Sol 的精確得分。因此可以比較公開的成本資訊,卻不能只憑這兩句話判斷誰的科學任務成功率更高。
API 價格差距有多大?#
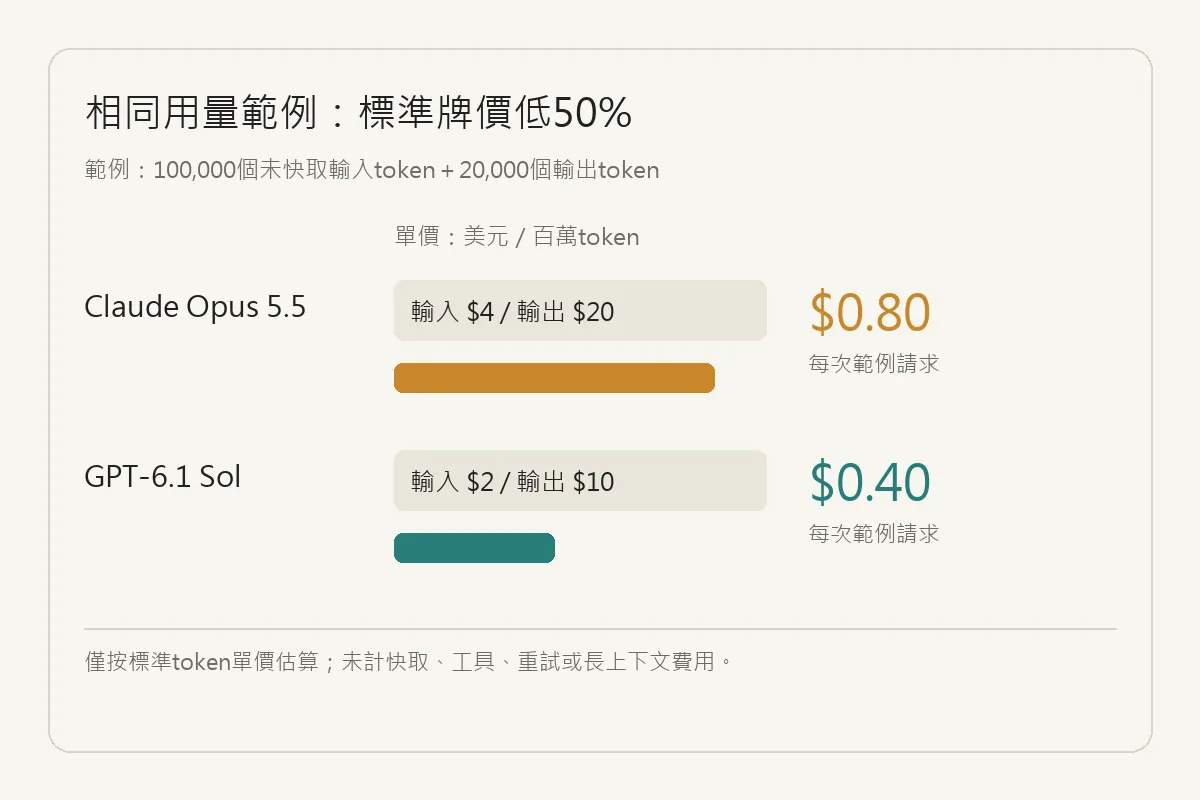
依兩家官方頁面所列的標準 API 標價,Opus 5.5 為每百萬輸入 token 20;GPT-6.1 Sol 為 10。若一次請求使用 100,000 個未快取輸入 token、20,000 個輸出 token,依標準標價估算:
input_tokens = 100_000
output_tokens = 20_000

opus55 = input_tokens / 1_000_000 * 4 + output_tokens / 1_000_000 * 20
gpt61 = input_tokens / 1_000_000 * 2 + output_tokens / 1_000_000 * 10

print(f"Opus 5.5: ${opus55:.2f}")
print(f"GPT-6.1 Sol: ${gpt61:.2f}")
這組範例得出 Opus 5.5 0.40。它只比較未快取文字 token 的標價,不包含重試、工具呼叫、長上下文附加費、快取策略或其他託管平台折扣。GPT-6.1 Sol 的 API 請求輸入超過 272,000 tokens 時,官方定價文件說明該請求會依較高的長上下文價格計費;Opus 5.5 的官方文件則說明其 1M 上下文視窗依標準價格計費。Anthropic 與 OpenAI 的 token 計量、推理額外用量和產品設定也未必完全相同,所以「標價一半」不等於「相同工作流程總帳單必定一半」。
實際使用前,可查看依廠商瀏覽模型與串接方式,以及模型價格比較。若要核對供應商目錄,還可查看 Anthropic 模型目錄 與 OpenAI 模型目錄。不同平台的折扣與計費設定可能和廠商標準標價不同。
Crazyrouter 的 GPT-6.1 Sol 紀錄能說明什麼?#
2026 年 9 月 30 日的一輪本地開發工作負載測試中,GPT-6.1 Sol 使用固定管道、reasoning_effort=high 和 max_completion_tokens=8192。8 類任務各獨立請求兩次,共 16 次:14/16 成功交付,其中 13 個交付答案整題正確;另外兩次請求等待 240 秒仍未取得完整回應。主要批次包含兩道程式題的隱藏檢查;另有一次獨立的模擬工具流程,不計入上述 16 次主要任務。這類小樣本結果不能取代長期儲存庫開發測試。
這輪測試沒有將 Claude Opus 5.5 放入同一題組。因此它能說明 GPT-6.1 Sol 在這批任務上的交付情況,不能據此宣稱 GPT-6.1 Sol 比 Opus 5.5 更準、更快或更穩定。與官方基準相比,它的價值是補充一份實際閘道路徑下的小樣本紀錄,同時提醒讀者將逾時也計入交付體驗。
這組紀錄和任何廠商發布的模型卡都不是同一類證據。若計畫將模型串接至程式碼代理,可先查看 Claude Code 串接指南 與 Codex 串接指南,再用自己的儲存庫任務建立驗收集。
本地紀錄的請求與失敗說明#
本輪呼叫的 Base URL 為 https://api.crazyrouter.com/v1,端點為 POST /chat/completions,模型為 gpt-6.1-sol。請求使用 messages(固定 system 提示和同題 user 提示)、reasoning_effort="high"、max_completion_tokens=8192,不傳送 temperature。這是 2026-09-30 的歷史紀錄,不是本文發布日重新進行的可用性測試。
| 項目 | 可核對的結果 |
|---|---|
| 交付情況 | 14/16 請求收到完整結果;其中 13/14 答案整題正確 |
| 已交付但答錯 | 一次規則計數將實際 72 條寫為 71 條 |
| 未交付 | 長規則檢索、具有限制條件的最佳集合選取各一次等待 240 秒逾時;未用重試成功覆蓋失敗 |
| 範例任務 | 帳單事件去重:全域依事件 ID 去重,保留 10 <= ts < 20,排除內部使用者,計算淨額 |
| 範例請求最終狀態 | HTTP 200,finish_reason=stop,答案通過本地標準答案核對 |
範例回應 ID:resp_0a6633bd82c5ee75016abd0e0e8b9887d29ef32e920c8843ba;請求 ID:202609301326374284700288BdKuu3w。該例為合成測試資料,回傳的最終答案如下:
{"net_cents_by_user":{"alice":-173,"bob":88},"included_unique_events":12}
逾時只表示用戶端未在等待上限內收到完整交付,不能證明模型不會解題,也不證明上游請求已經取消。樣本沒有測量長期可用率或兩款模型的首 token 延遲。
怎麼選:依任務建立自己的驗收集#
- 優先評估 Opus 5.5:大型程式碼遷移、多儲存庫審查、長期程式碼代理,以及你願意為高推理等級能力支付更高標準 token 費用的工作。
- 優先評估 GPT-6.1 Sol:大量重複的日常 API 請求、業務流程自動化、複雜 PDF 擷取和需要控制單一任務成本的代理任務。
- 進行平行試跑:任務價值高、錯誤代價大,或結果會直接用於正式環境時。固定模型版本、推理等級、工具、上下文和驗收條件,並保留逾時、fallback 與重試紀錄。
建議先從 20–50 個真實任務建立小型驗收集,逐項記錄是否完整交付、通過自動檢查的比例、人工重做次數、端到端耗時和總 token 成本。將任務依程式開發、文件、工具流程分類後再計算結果;單一總分容易掩蓋某個模型在特定子任務上的明顯弱點。
常見問題#
Claude Opus 5.5 一定比 GPT-6.1 Sol 更強嗎?#
不能這樣概括。Opus 5.5 在 Anthropic 公布的 Terminal-Bench 4.0 等測試中成績突出;OpenAI 則稱 GPT-6.1 Sol 在特定 GDP.pdf 和 AutomationBench 條件下優於 Opus 5.5。測試機構、推理等級、fallback 和任務集合不同,適合搭配自己的任務進行驗證。
GPT-6.1 Sol 比 Opus 5.5 便宜多少?#
依官方標準 API 標價,GPT-6.1 Sol 的每百萬輸入 token 10,Opus 5.5 為 20;相同未快取 token 數的標價約低 50%。實際任務帳單還取決於輸出長度、快取、重試和平台定價。
哪款更適合寫程式?#
Opus 5.5 在其官方公布的 Terminal-Bench 4.0 和 FrontierCode 成績上很強;GPT-6.1 Sol 的公開發布資料強調 DeepSWE 長期軟體工程測試。由於缺少兩款模型在同一程式開發測試框架、相同推理預算下的完整公開對照,依實際儲存庫任務試跑更可靠。
這篇文章做了 Opus 5.5 與 GPT-6.1 Sol 的本地同題測試嗎?#
沒有。本文引用兩家官方評測資料,並補充 Crazyrouter 在 2026 年 9 月 30 日對 GPT-6.1 Sol 的 16 次請求紀錄;該批次沒有 Opus 5.5 對照,不能稱作本地雙模型基準測試。
選擇模型時應該看哪些指標?#
至少同時看任務通過率、完整交付率、逾時和 fallback、人工重做、端到端耗時、總 token 成本。對於代理工作流程,還要檢查工具呼叫是否完成、模型是否正確處理失敗,以及最終產出是否通過自動驗收。
結論#
Opus 5.5 與 GPT-6.1 Sol 的公開資料呈現的是不同任務上的取捨:Opus 5.5 的高推理等級程式開發與科學結果具有吸引力,GPT-6.1 Sol 的標準 token 價格更低,且 OpenAI 在部分業務基準中報告了更佳的任務成本表現。如果成本是主要限制,先試 GPT-6.1 Sol;如果複雜長程任務的品質上限更重要,將 Opus 5.5 納入同題驗收。在兩者尚未進行相同條件的實測之前,不將廠商基準合併成一個總冠軍。
來源與測試方式#
- Anthropic, Claude Opus 5.5 介紹, 2026-09-22. 包含官方標價、Terminal-Bench、FrontierCode、AutomationBench 和 Terminal-Bench Science 資料及條件說明。
- OpenAI, GPT-6.1 Sol 介紹, 2026-09-29. 包含 GPT-6.1 Sol 與 Opus 5.5 在 GDP.pdf、AutomationBench、Terminal-Bench Science 的發布方比較及 API 標價。
- Anthropic, Claude Opus 5.5 模型與定價文件與成本與能力最佳化指南. 包括模型限制、價格,以及原始 482 題 SWE-bench Pro 相容子集的方法和結果。
- OpenAI, GPT-6.1 Sol API 模型文件. 包括 API 上下文視窗、輸出上限、標準與快取輸入價格,以及長上下文計價門檻。
- Crazyrouter,2026-09-30 內部封存《GPT-6 Sol、GPT-6.1 Sol 對比 GPT-5.6 Sol 與 GPT-6 Astra:實測與主力模型選擇》。本文公開結果摘要和一筆回應識別碼;完整請求、評分指令碼與回應由編輯部在本地留存,未提供完整證據套件的線上下載。該批次不含 Opus 5.5 同題結果。
本文不將廠商自報評測稱為獨立重現,也不比較兩款模型的首 token 延遲、長期可靠性或正式環境整體排名。兩家官方標價與本地閘道實際價格可能不同,正式上線前請重新核對當時的價目。