 简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
2026년 10월 9일4 회 조회한국어Tutorial
Crazyrouter 사용 가이드: 가입과 API 키 생성부터 대화·이미지 생성까지
8장의 화면으로 Crazyrouter 가입, API 키 생성, 잔액 확인, 대화, 이미지 생성, 개발 도구 연결을 설명합니다. 키 한도와 잔액의 차이, 첫 사용 시 점검할 문제도 정리했습니다.
8장의 화면으로 Crazyrouter 가입, API 키 생성, 잔액 확인, 대화, 이미지 생성, 개발 도구 연결을 설명합니다. 키 한도와 잔액의 차이, 첫 사용 시 점검할 문제도 정리했습니다.
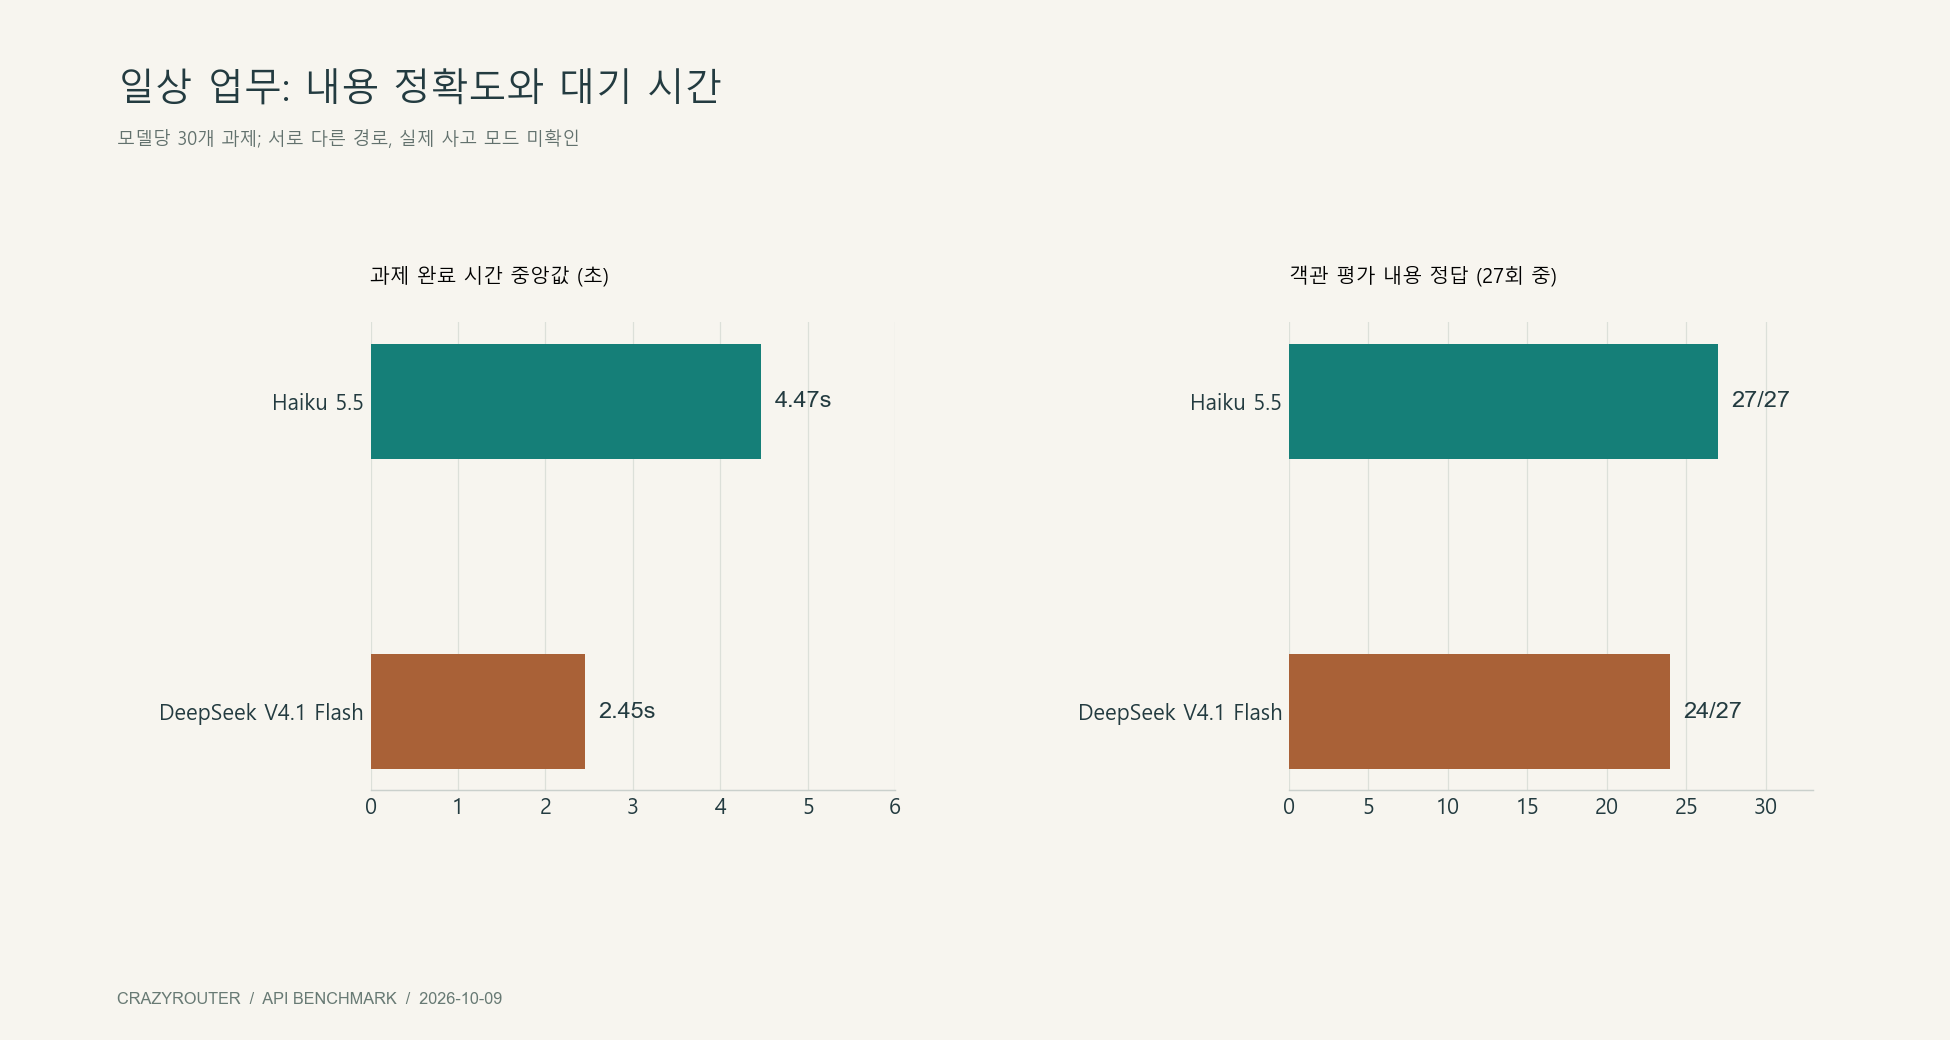
중국어 과제 10종을 3회씩 실행했습니다. 내용 정답 27/27 대 24/27, 완료 중앙값 4.47초 대 2.45초. JSON, 실제 비용, 오류와 경로·캐시·사고 모드의 한계를 비교합니다.
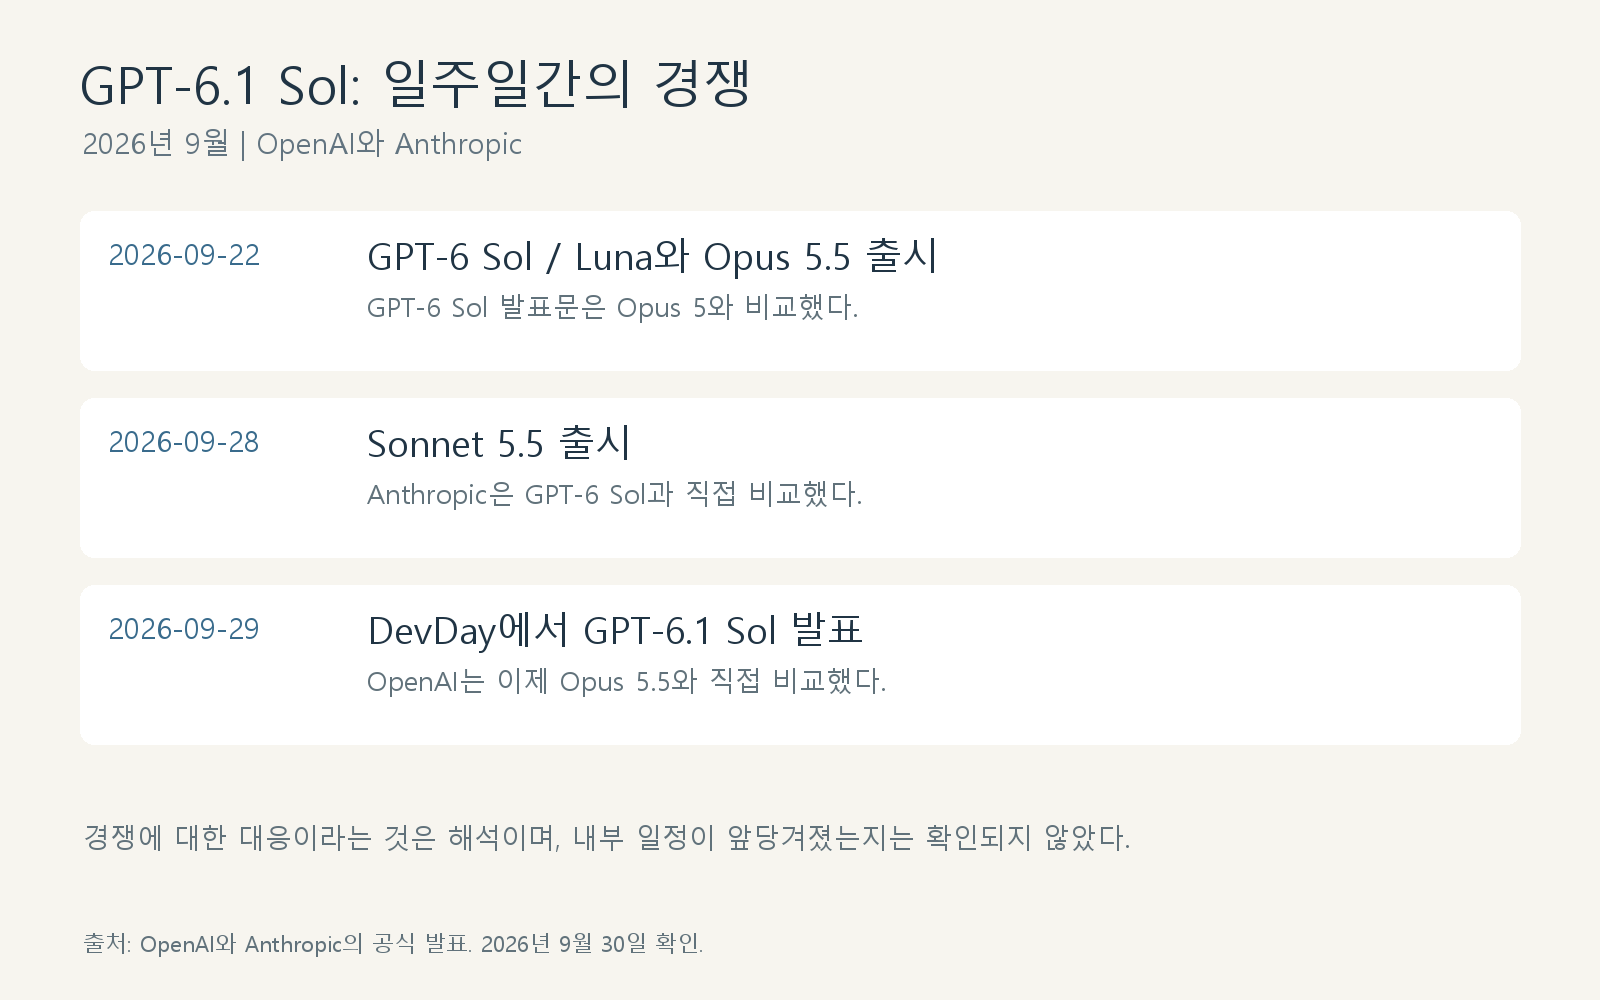
GPT-6.1 Sol이 일주일 만에 등장한 배경을 Claude Opus 5.5·Sonnet 5.5와의 경쟁 구도에서 살펴본다. 공식 평가의 개선 폭과 API 비교 테스트 결과를 분석하되, 경쟁 때문에 내부 출시 일정이 앞당겨졌는지는 확인되지 않았다는 점을 구분한다.
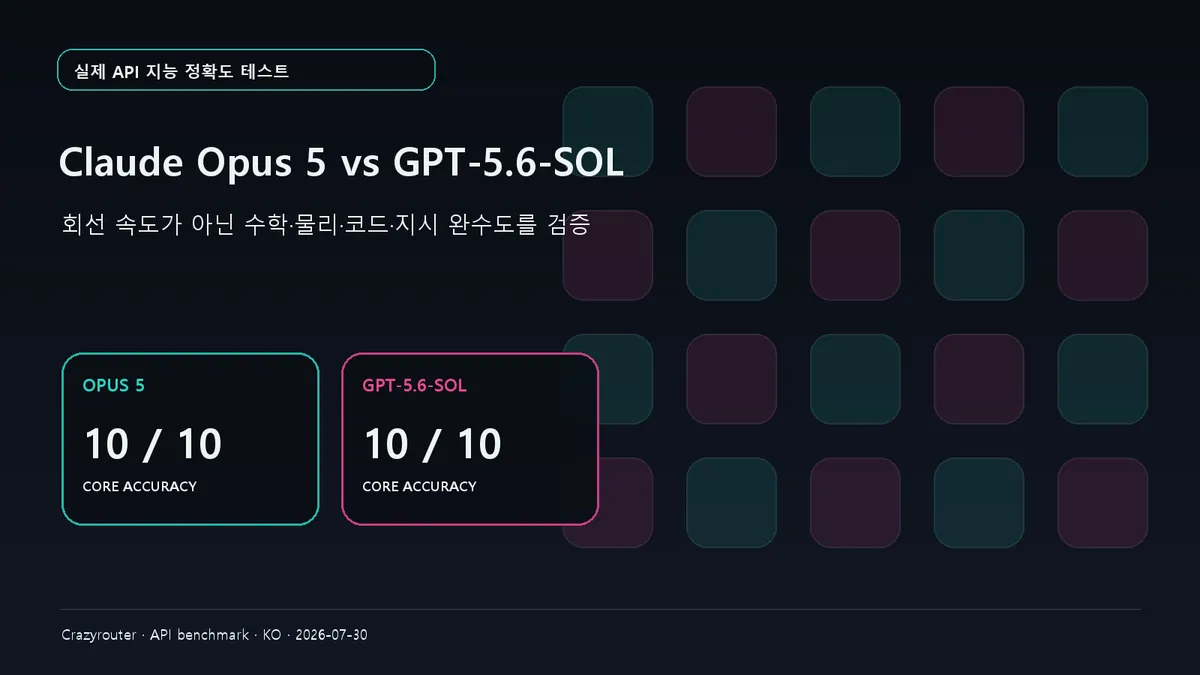
Claude Opus 5와 GPT-5.6-SOL을 동일 API의 10개 검증 과제로 비교했습니다. 두 모델 모두 핵심 답변 10/10을 기록했으며, 코드 숨은 테스트, 전체 요구사항 완수, 엄격한 JSON 준수를 별도로 평가합니다.
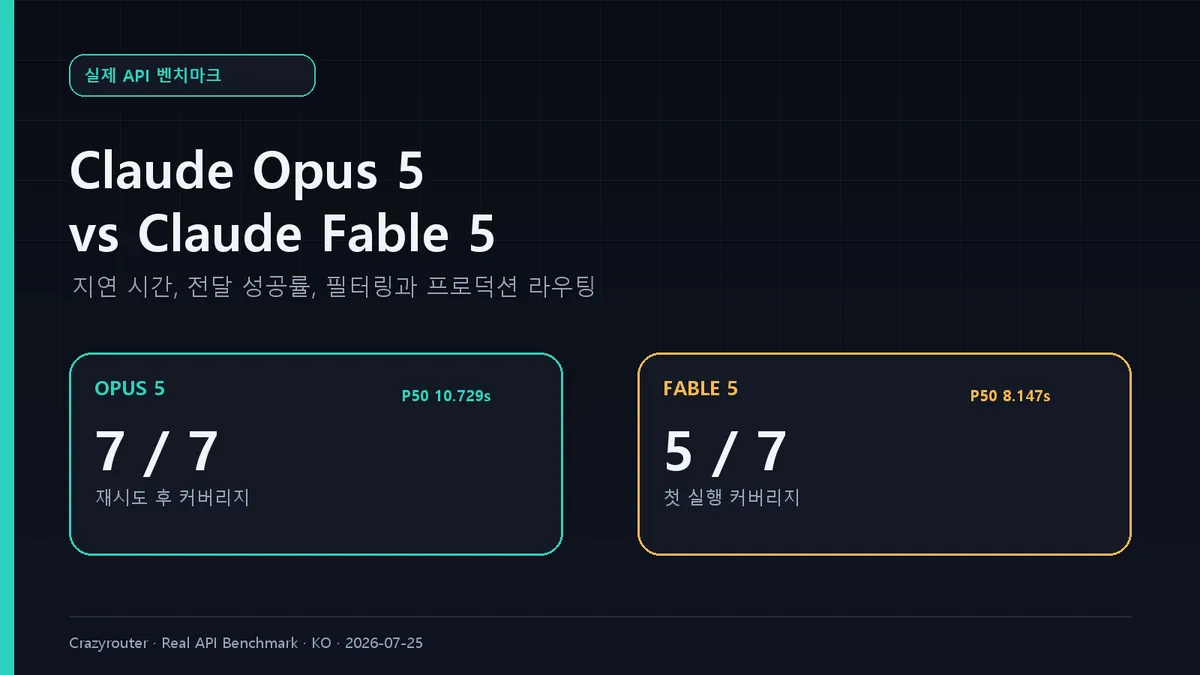
동일한 OpenAI-compatible API, 동일한 프롬프트와 파라미터 조건에서 Claude Opus 5와 Claude Fable 5를 수학, 물리, 제약 추론, 코드 리뷰, strict JSON, 실험 설계 과제로 비교하고, 전달률, 콘텐츠 필터링, latency, token, 재시도 결과를 기록했습니다.
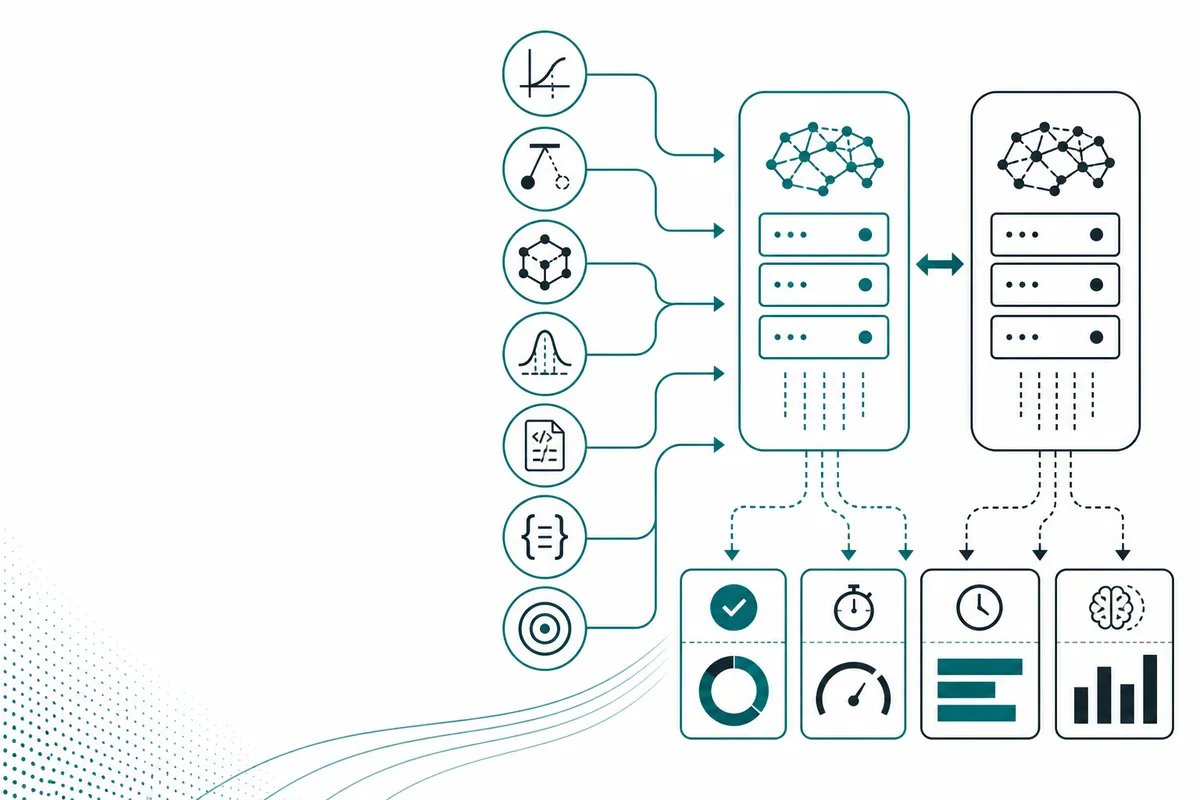
정밀 수학, 물리 모델링, 제약 추론, 통계적 역유도, 코드 리뷰, 엄격한 JSON, 불확실성 보정 등 7개 관점에서 Kimi K3와 Claude Opus 4.8의 정답률, 첫 가시 응답, 전체 지연 시간, reasoning Token 효율을 비교합니다.
동일한 OpenAI-compatible API와 동일한 프롬프트 조건에서 kimi-k3와 gpt-5.6-sol을 대상으로 패턴 정지 시간, 도르래 회전 관성이 포함된 물리 문제, 의존성 클로저 프로그래밍 문제를 테스트하고, 정답 여부, 출력 잘림, 지연 시간, 로컬 코드 검증 결과를 기록합니다.
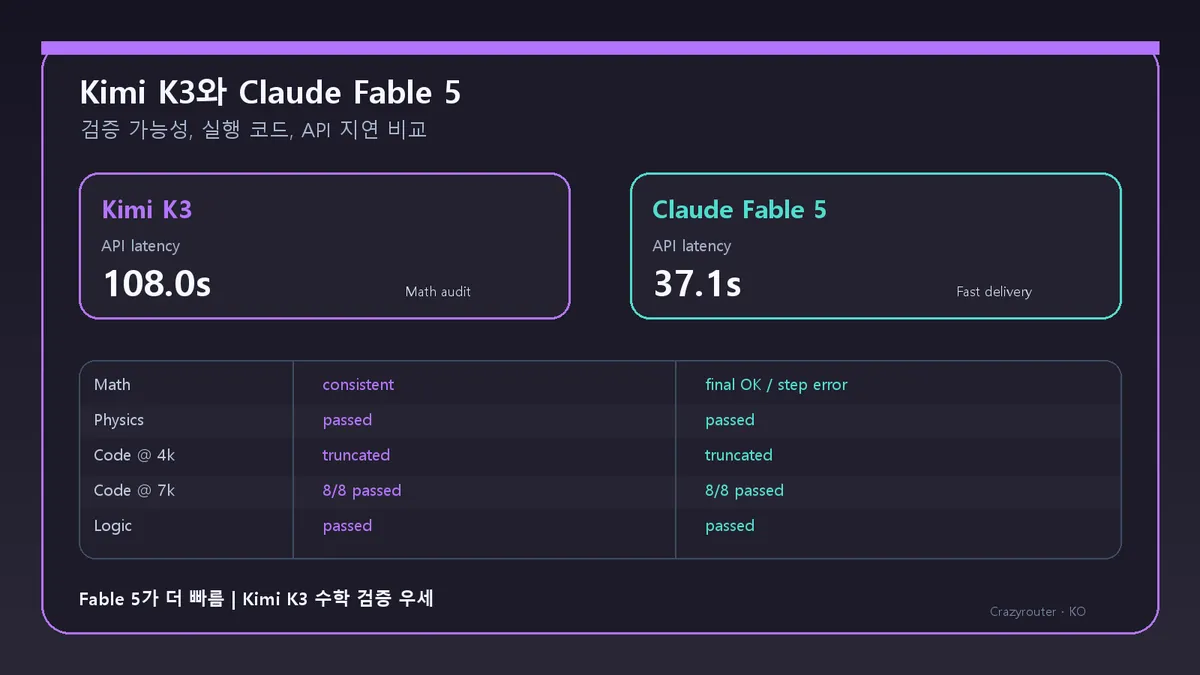
수학, 물리, 실행 가능한 Python, 제약 추론으로 Kimi K3와 Claude Fable 5를 비교하고 finish_reason, reasoning tokens, 지연 시간을 분석합니다.