简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
엔비디아 Spark 4대에 자체 배포한 DeepSeek 실측과 Crazyrouter V4.1 Flash 1017 기준선 비교
2026년 11월 3—4일 실측 기록을 바탕으로 엔비디아 Spark 4대의 자체 배포 환경과 Crazyrouter V4.1 Flash 1017 기준선의 짧은·긴 입력 속도, 캐시, 저녁 요청 중단, 직결·게이트웨이 지연을 비교한다. 자체 배포 가중치의 동일성은 확인되지 않았다.
엔비디아 Spark 4대에 DeepSeek를 자체 배포하면 실제 호출 성능이 기성 API에 근접할 수 있을까? 2026년 11월 3—4일의 테스트 기록을 살펴봤다. 같은 회차에서 Crazyrouter 기준선의 출력 속도가 더 빨랐고, 이후 Spark의 성능은 시간대에 따라 크게 달라졌다. 부하가 낮을 때와 요청이 몰릴 때의 체감 차이도 컸다.
11월 3일 같은 회차에서 진행한 소표본 테스트에서 Crazyrouter DeepSeek V4.1 Flash 1017 기준선의 짧은 입력과 긴 입력 출력 속도 중앙값은 각각 147.31, 136.87 token/s였다. Spark 4대에 자체 배포한 서비스는 각각 41.46, 10.02 token/s였으며, 양쪽 모두 속도 측정 요청을 6/6건 완료했다.1
이 글은 배포 후 실제 호출에서 첫 토큰까지 얼마나 기다리는지, 스트리밍 출력은 얼마나 빠른지, 반복되는 컨텍스트가 캐시에 적중하는지, 부하가 높은 시간대에도 테스트 제한 시간 안에 요청을 완료하는지를 다룬다. 데이터는 과거 테스트 기록에서 가져왔다. 11월 20일에 다시 측정한 결과가 아니며 현재 서비스 상태를 보장하지 않는다. 아래 시각은 모두 베이징 시간이다.
1017 기준선과 Spark 자체 배포는 같은 버전인가?#
이 글에서 다루는 모델 계열은 Crazyrouter DeepSeek 모델 페이지에서, Spark 제품 정보는 NVIDIA DGX Spark 공식 페이지에서 확인할 수 있다. 두 페이지는 참고 자료이며, 당시 성능에 관한 결론은 이 글의 테스트 기록을 근거로 한다.
당시 양쪽에 요청한 모델명은 모두 deepseek-v4.1-flash였지만 응답에 표시된 모델명은 달랐다.
| 비교 대상 | 응답에 표시된 모델명 | 당시 확인한 범위 |
|---|---|---|
| Crazyrouter 기준선 DeepSeek | deepseek-v4.1-flash-1017 | 응답 식별자에 1017 접미사가 붙어 있었음 |
| Spark 4대에 자체 배포한 DeepSeek | deepseek-v4.1-flash | GB10 노드 4대 모두에서 추론 rank 프로세스가 실행 중임을 확인 |
과거 자료에는 자체 배포 측의 가중치 해시, 정확한 리비전, 양자화 설정이 모두 기록되어 있지 않다. 따라서 이 글에서 DeepSeek V4.1 Flash 1017은 기준선의 응답 식별자를 가리킨다. 양쪽이 동일한 가중치를 사용했는지는 검증하지 못했으며, 응답에 표시된 이름만으로는 가중치의 동일성을 확인할 수 없다.2
“엔비디아 Spark deepseekv4.1flash1017 자체 배포”를 검색할 때는 호환 인터페이스를 제공하는 것과 완전히 동일한 모델 버전이 실행 중임을 입증하는 것에는 서로 다른 검증이 필요하다는 점에 유의해야 한다. 이 글은 당시 실제로 사용한 두 서비스 경로를 비교한다. 모든 변수를 통제한 GPU 하드웨어 성능 순위는 이 비교로 알 수 없다.
테스트 방법은 동일한 접속 지점, 고정 채널, 고정 출력 예산을 사용했다#
11월 3일 본 테스트에서는 같은 Crazyrouter 접속 지점을 통해 고정된 두 채널을 호출했다. 한 채널은 기준선 서비스로, 다른 채널은 Spark 4대에 자체 배포한 서비스로 연결됐다. 다른 채널의 응답을 결과에 섞지 않았으며, 테스트 도중 채널 설정도 변경하지 않았다.
당시 테스트에서 실제로 사용한 주소는 다음과 같다.
Base URL: https://crazyrouter.com/v1
Endpoint: POST /chat/completions
Model: deepseek-v4.1-flash
아래는 측정에 사용한 주요 설정이다. 전체 요청에는 동일한 작업 본문과 회차를 구분하는 접두사도 포함됐다.
{
  "model": "deepseek-v4.1-flash",
  "stream": true,
  "temperature": 0,
  "max_tokens": 768,
  "thinking": { "type": "disabled" }
}
짧은 입력은 64 토큰, 긴 입력은 6,230 토큰으로 각각 세 번 실행했다. 캐시 동작을 관찰하기 위해 긴 입력의 본문은 반복해서 사용했다. 같은 채널에서는 직전 요청이 끝난 뒤 6초 간격을 두고 다음 요청을 보냈다. 서로 다른 채널은 병렬로 테스트했고, 각 채널 내부에서는 요청을 순차적으로 처리했다.
당시 전체 테스트에는 채널 4개와 정식 요청 26건이 포함됐다. 이 글은 기준선과 Spark의 요청 12건에 초점을 맞춘다. 나머지 두 채널은 결과의 범위를 확인하는 데 사용했으며, 별도로 진행한 스모크 테스트 1건은 통계에서 제외했다. 모든 정식 요청의 채널과 토큰 수는 사용량 로그와 대조했다.
본 테스트의 모든 요청에서 768 토큰이 출력됐으며 추론 토큰은 0이었다. 여기서 ‘완료’는 클라이언트가 스트림의 정상 종료와 사용량 기록을 모두 받았다는 뜻이다. 출력 예산에 도달해 finish_reason=length로 끝나는 것은 이번 속도 측정에서 예상한 동작이다. 6/6 완료는 응답 전송이 끝났다는 집계다. 답변의 정답률이나 모델이 실제 업무를 자연스럽게 마쳤는지는 이 수치로 판단할 수 없다.
시간은 두 가지 방식으로 측정했다. 첫 토큰 대기 시간은 클라이언트가 요청을 보낸 시점부터 잰다. 출력 속도는 첫 번째 본문 청크부터 마지막 본문 청크까지 걸린 시간으로 출력 토큰 수를 나눠 계산한다. 출력 속도는 클라이언트 측 근삿값으로, 첫 청크의 토큰을 포함한다. 첫 청크 이전의 연결 및 대기열 지연은 포함하지 않는다. 표에는 각 조건에서 요청 세 건의 중앙값을 제시한다.1
같은 회차 결과에서 첫 토큰 대기 시간은 비슷했지만 지속 출력 속도 차이는 컸다#
| 지표 | Crazyrouter 1017 기준선 | Spark 4대 자체 배포 |
|---|---|---|
| 요청 완료 건수 | 6/6 | 6/6 |
| 짧은 입력 첫 토큰 대기 시간 중앙값 | 3.31초 | 3.25초 |
| 짧은 입력 출력 속도 중앙값 | 147.31 token/s | 41.46 token/s |
| 짧은 입력 총 소요 시간 중앙값 | 9.05초 | 21.78초 |
| 긴 입력 첫 토큰 대기 시간 중앙값 | 3.36초 | 7.73초 |
| 긴 입력 출력 속도 중앙값 | 136.87 token/s | 10.02 token/s |
| 긴 입력 총 소요 시간 중앙값 | 9.09초 | 84.40초 |
| 가장 느린 단일 요청의 총 소요 시간 | 10.26초 | 156.11초 |
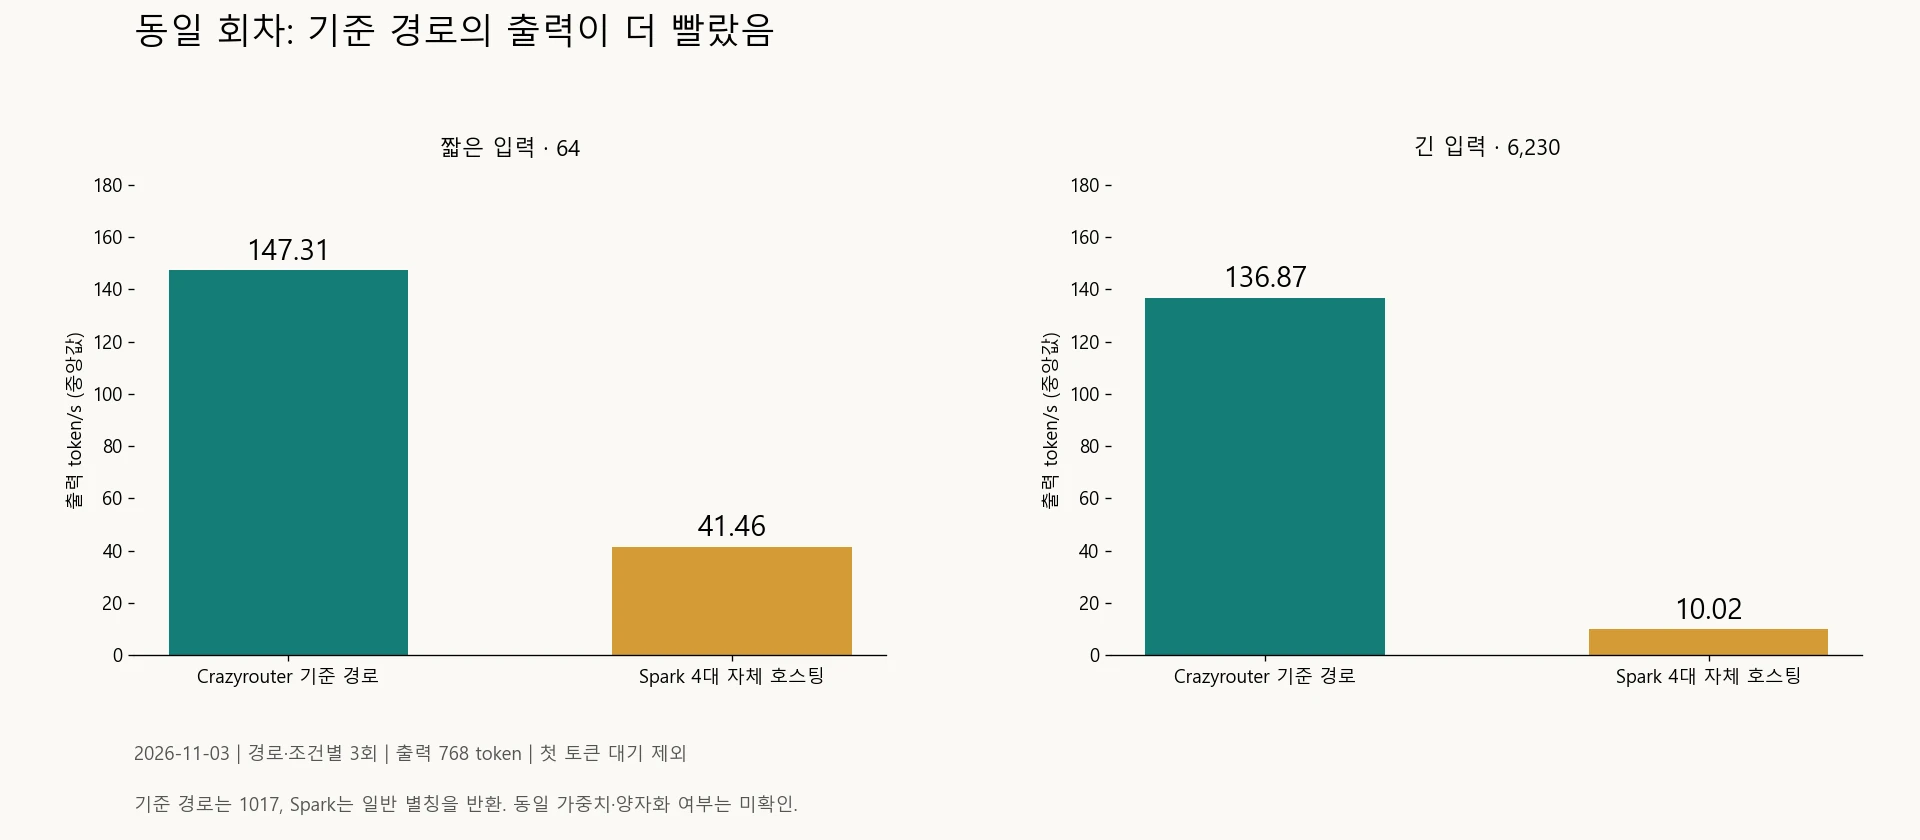
그림 1. 2026년 11월 3일, 양쪽에서 조건별로 세 번씩 측정했다. 출력 속도에는 첫 토큰 대기 시간이 포함되지 않는다. 양쪽의 가중치와 양자화 설정이 동일한지는 검증되지 않았다.
짧은 입력에서는 Spark의 첫 토큰 대기 시간이 오히려 약간 짧았지만, 이후 생성 속도가 느려 총 소요 시간은 더 길었다. 출력 속도 중앙값을 기준으로 Crazyrouter 기준선은 Spark보다 짧은 입력에서 약 3.55배, 긴 입력에서 약 13.66배 빨랐다. 이 배수는 해당 회차의 서비스 상태를 보여주는 값으로, Spark 4대의 하드웨어 성능 한계는 이 수치로 판단할 수 없다.
Spark에서는 유독 느린 요청도 있었다. 세 번째 짧은 입력 요청은 약 105.38초가 걸렸고 출력 속도는 약 7.47 token/s였지만, 스트림은 끝까지 정상적으로 종료됐다. 따라서 오류 없이 완료됐는지와 서비스 이용 경험이 안정적이었는지는 따로 봐야 한다. 나머지 두 참고 채널의 출력 속도 중앙값은 짧은 입력에서 143.69—148.13 token/s, 긴 입력에서 130.20—141.49 token/s였다. 이번 회차에서 기준선의 속도는 4개 채널 중 유독 높게 나온 값이 아니었다.1
캐시에 적중했는데도 속도가 달라진 이유는 무엇인가?#
본 테스트에서 긴 입력의 캐시 기록은 다음과 같다.
| 서비스 경로 | 긴 입력 요청 세 건의 캐시 토큰 수 | 마지막 요청에서 캐시 토큰이 입력에서 차지한 비율 |
|---|---|---|
| Crazyrouter 기준선 | 0 → 6,144 → 6,144 | 98.62% |
| Spark 4대 자체 배포 | 0 → 0 → 0 | 0% |
이 회차만 보면 Spark가 캐시를 지원하지 않는다고 생각할 수 있다. 이후 기록에서는 캐시 적중이 확인됐다. 11월 4일 01:04 재시험에서 긴 입력의 캐시 토큰 수는 0 → 6,234 → 6,234였고, 마지막 요청에서는 입력의 **99.98%**를 차지했다. 그런데도 이 회차의 긴 입력 출력 속도 중앙값은 13.37 token/s에 그쳤다. 세 요청은 각각 13.37, 12.90, 45.15 token/s를 기록해 캐시에 적중한 두 요청 사이에서도 속도 차이가 뚜렷했다.3
14:14 재시험에서는 마지막 긴 입력 요청의 캐시 비율이 **82.13%**였지만, 출력 속도 중앙값은 57.91 token/s에 달했다. 캐시 토큰 비율만으로는 전체 응답 속도를 설명할 수 없다. 이 비율이 비용 절감률을 뜻하는 것도 아니며, 이번 테스트에서는 이를 근거로 비용상 이점을 계산하지 않았다.
같은 Spark 구성에서 네 시간대의 결과는 얼마나 달랐나?#
후속 재시험에서도 같은 작업 본문과 출력 설정을 사용했다. 회차별로 고유한 접두사를 붙였기 때문에 짧은 입력은 약 64—69 토큰, 긴 입력은 약 6,230—6,235 토큰이었다. 요청 내용이 토큰 단위까지 완전히 같지는 않았다.
| 테스트 시각 | 완료 건수 | 짧은 입력 출력 속도 | 긴 입력 출력 속도 | 짧은 입력 첫 토큰 대기 시간 | 긴 입력 첫 토큰 대기 시간 |
|---|---|---|---|---|---|
| 11월 3일 23:43 | 6/6 | 41.46 token/s | 10.02 token/s | 3.25초 | 7.73초 |
| 11월 4일 01:04 | 6/6 | 50.69 token/s | 13.37 token/s | 4.25초 | 3.61초 |
| 11월 4일 14:14 | 6/6 | 56.70 token/s | 57.91 token/s | 2.04초 | 5.31초 |
| 11월 4일 20:24 | 3/6 | 16.84 token/s* | 7.07 token/s* | 51.96초* | 37.59초* |
저녁 시간대에는 완료된 요청만 집계했다. 짧은 입력은 2/3건, 긴 입력은 1/3건이 완료됐다. 중단된 나머지 세 건은 출력 속도와 첫 토큰 대기 시간의 중앙값 계산에서 제외했다.
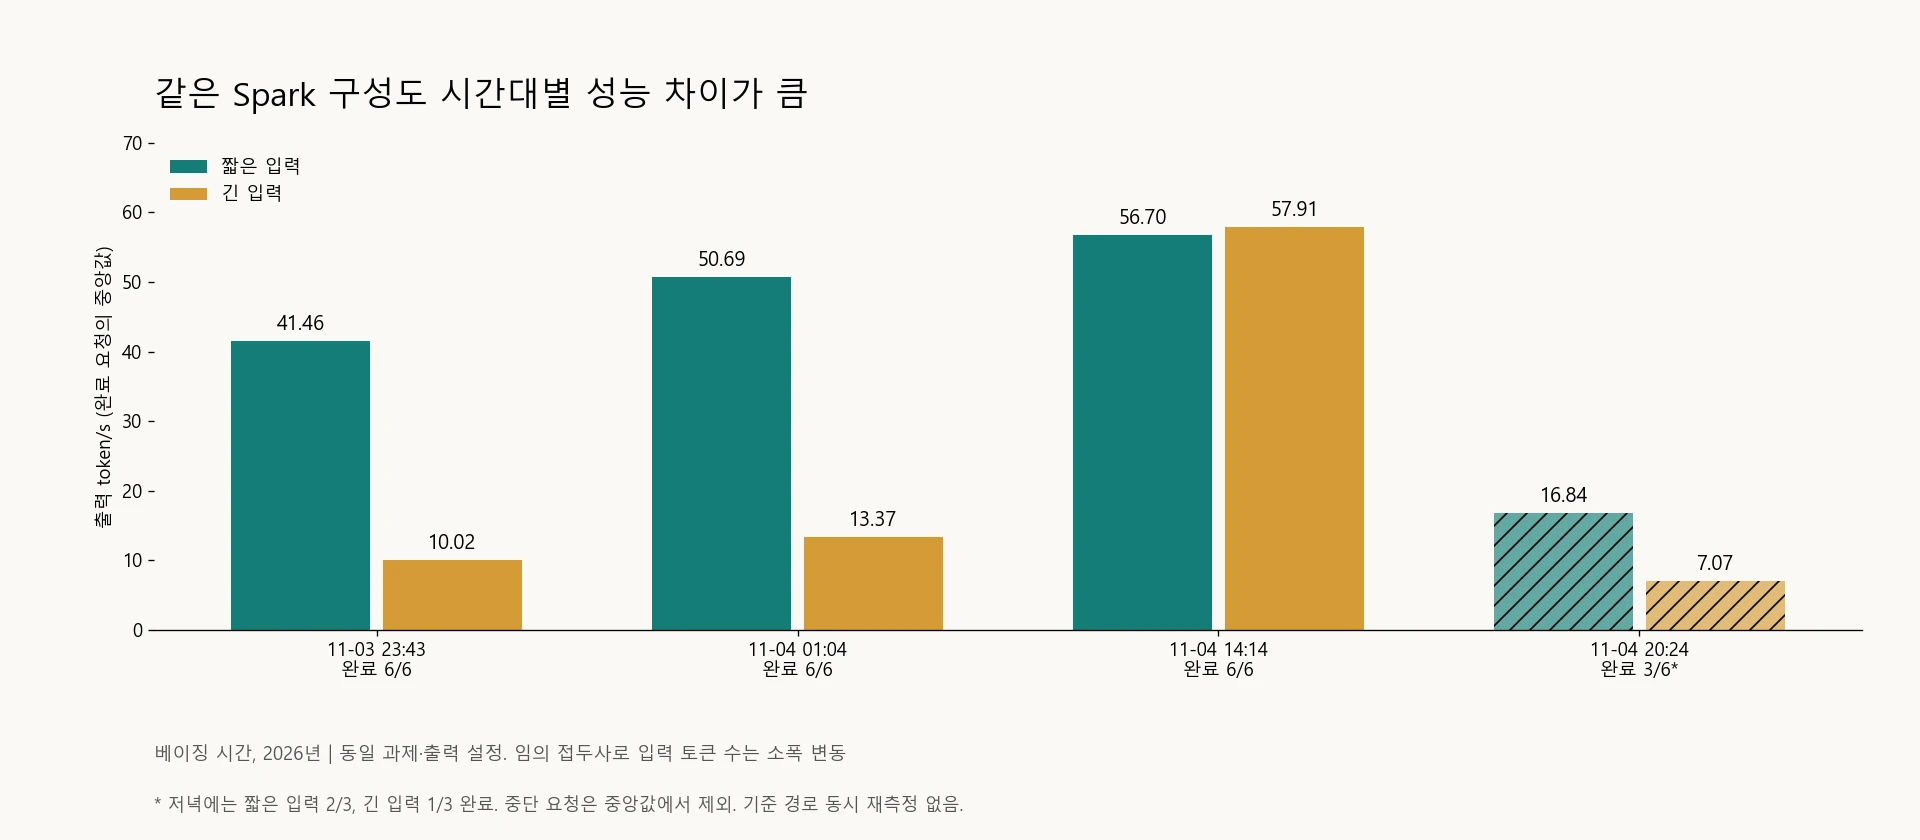
그림 2. 이후 세 회차에서는 Spark만 재시험했고 Crazyrouter 기준선은 동시에 다시 측정하지 않았다. 이전 기준선과 이후 시간대의 결과를 같은 조건에서 진행한 한 회차의 비교로 묶을 수 없다.
저녁에 중단된 요청 세 건은 HTTP 200 응답 헤더와 스트리밍 콘텐츠 일부를 받았지만 정상적으로 완료되지 않았다. 클라이언트는 약 166—187초 뒤 호출을 종료했고, 사이트 로그에는 499 클라이언트 연결 종료로 기록됐다. HTTP 200 응답만 세면 이 회차를 6/6건 완료로 잘못 집계하게 된다.3
이 시간대에는 완료된 요청의 속도도 낮아졌지만, 더 중요한 결과는 6건 중 3건만 완료됐다는 점이다. 이처럼 표본이 적은 한 회차의 결과로 장기 가용성을 추정하기는 어렵다.
지연은 어디에서 생겼나? 당시 기록은 부하와 대기열을 가리킨다#
당시 읽기 전용 점검에서 GB10 노드 4대 모두에서 추론 프로세스가 실행되고 있음을 확인했다. 서비스 용량 스냅샷에는 slots=4, peak_batch=4가 기록돼 있었다. 이는 당시 추론 엔진의 설정값이다. 소프트웨어와 모델에 관계없이 Spark 4대에 적용되는 고정 용량 한계로 볼 수 없다.
같은 서비스가 실행되는 동안 부하에 따라 서로 다른 두 가지 기록이 남았다.
- 11월 4일 19:44, 부하가 비교적 낮았다. 서버 로그에서 입력 32 또는 59 토큰, 출력 256 토큰인 요청은 104.8—156.8 token/s에 도달했고, 첫 토큰까지는 0.115—0.148초가 걸렸다. 당시 상태를 재구성한 결과, 미완료 요청은 한 건뿐이었으며 입력이 10,000 토큰을 넘는 긴 요청은 없었다.
- 20:24, 저녁 속도 측정을 시작했다. 완료된 요청의 종료 시각과 소요 시간으로 역산한 결과, 입력이 10,000 토큰을 넘는 요청 중 최소 12건이 아직 끝나지 않았으며, 이들의 입력은 합계 약 1,530,000 토큰이었다. 20:33의 다른 스냅샷에서는 이런 미완료 요청이 최소 16건이었다.4
이 수치에는 대기 중인 요청과 실행 중인 요청이 모두 포함되며, 과거 로그로 역산한 최솟값이다. 12건 또는 16건이 동시에 GPU에서 디코딩 중이었다는 뜻은 아니다. 다른 트래픽이 어디에서 유입됐는지는 기록으로 확인하지 못했다.
부하가 비교적 낮을 때 Spark는 빠르게 토큰을 생성했다. 긴 컨텍스트를 사용하는 요청이 많이 밀려 있을 때는 클라이언트가 오랫동안 본문을 받지 못할 수 있었다. 부하가 높은 시간대에는 모델에 직접 연결한 요청에서도 대기가 발생했다. 따라서 모든 지연을 Crazyrouter 게이트웨이 탓으로 돌릴 수 없다.
현재 남아 있는 증거는 긴 컨텍스트 요청으로 인한 부하와 대기열 경합을 가장 유력한 설명으로 뒷받침한다. 단계별 추적 기록이 완전하지 않아 전체 지연에서 스케줄링, 프리필, 디코딩, 전송이 각각 얼마나 차지했는지는 정확히 나눌 수 없다. 19:44의 속도는 짧은 프롬프트와 256 토큰 출력 조건에서 서버 측이 기록한 값이다. 앞서 본 768 토큰 출력의 클라이언트 측 본 테스트와는 측정 기준이 달라 한데 묶어 계산할 수 없다.
Crazyrouter 게이트웨이는 지연을 늘렸나? 두 차례 추가 측정에서는 더 오래 걸렸다#
11월 4일 22:16, 부하가 비교적 낮을 때 요청을 두 쌍으로 나눠 추가 측정했다. 각 쌍에서는 공용 인터넷을 통한 직접 연결과 Crazyrouter를 경유하는 연결로 동일한 Spark 자체 배포 서비스를 동시에 호출했다. 두 경로 모두 입력은 26 토큰으로 동일했고 출력 예산은 256 토큰이었다.
| 요청 쌍 | 경로 | 첫 토큰 대기 시간 | 총 소요 시간 |
|---|---|---|---|
| 1 | Spark에 직접 연결 | 0.786초 | 3.779초 |
| 1 | Crazyrouter를 경유해 동일한 Spark에 연결 | 6.150초 | 8.307초 |
| 2 | Spark에 직접 연결 | 1.031초 | 4.301초 |
| 2 | Crazyrouter를 경유해 동일한 Spark에 연결 | 3.704초 | 7.496초 |
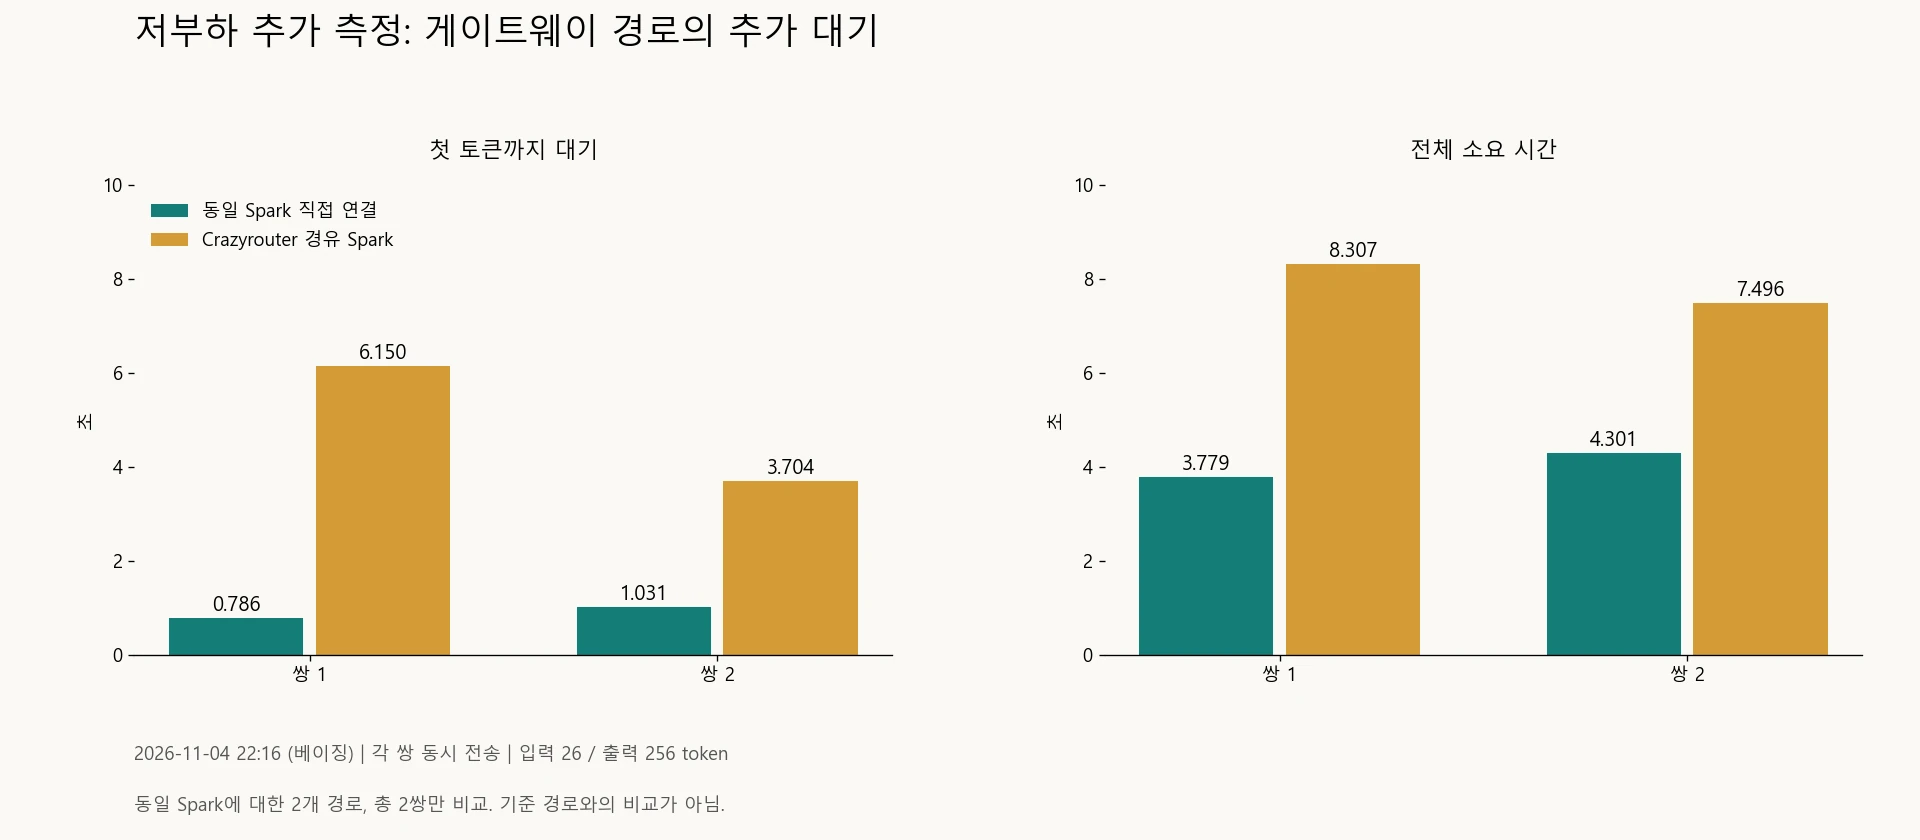
그림 3. 비교 대상은 동일한 Spark 서비스에 접속하는 두 경로이며, 앞에서 다룬 1017 기준선은 이 비교에 포함되지 않는다. 각 쌍의 요청은 동시에 보냈지만, 두 요청이 추론 서비스에 동시에 도착했다고 보장할 수는 없다.
게이트웨이를 경유했을 때 총 소요 시간은 각각 4.528초, 3.195초 더 길었다. 서버에 기록된 처리 시간은 두 경로가 비교적 비슷했다. 이는 요청이 추론 서비스에 도착하기 전의 추가 대기가 차이에 포함됐음을 시사한다. 다만 요청 두 쌍만으로는 게이트웨이 처리, 아웃바운드 연결, 공용 인터넷 매핑이 각각 얼마나 영향을 미쳤는지 구분할 수 없다. 이 차이를 고정된 게이트웨이 오버헤드로 볼 수도 없다.5
더 빠른 업스트림 기준선을 선택하는 것과 같은 자체 배포 백엔드 앞에 중계 계층을 추가하는 것은 서로 다른 문제다. 앞서 같은 회차에서 비교했을 때는 기준선이 더 빨랐다. 같은 Spark 서비스에 접속한 두 쌍의 추가 측정에서는 직접 연결의 종단 간 소요 시간이 더 짧았다.
자체 배포를 준비한다면 이 결과를 어떻게 활용할 수 있나?#
이번 기록에서는 Spark 4대에서 해당 DeepSeek 서비스를 실행할 수 있었다. 예측 가능한 호출 성능을 제공하려면 부하가 낮을 때 한 번 속도를 측정하는 것만으로는 도입 검증이 충분하지 않다.
배포를 준비하는 팀이라면 다음 검증에서 네 가지 항목을 확인하는 것이 좋다.
- 먼저 버전을 고정한다. 가중치 리비전, 해시, 양자화 설정, 추론 엔진 버전과 토폴로지를 기록한다. 인터페이스의 별칭만으로 같은 버전이라고 판단하지 않는다.
- 실제 업무를 반영한 혼합 부하를 테스트한다. 짧은 대화, 약 6K 컨텍스트, 실제로 들어오는 긴 요청을 함께 포함해 짧은 요청까지 느려지는지 관찰한다.
- 대기 시간, 출력 속도, 완료율을 함께 기록한다. 중단된 표본을 빠짐없이 남기고, 가장 빠른 한 건만 제시하는 대신 충분한 표본을 확보한 뒤 P95/P99를 집계한다.
- 서버와 클라이언트 측의 시간 측정 기준을 맞춘다. 직접 연결과 게이트웨이 경유, 유휴 상태와 부하가 높은 상태를 각각 비교하면 다음에 최적화할 구간을 판단할 수 있다.
이 글의 테스트 조건에서 응답 속도가 우선이라면, 같은 회차 결과에서는 Crazyrouter 기준선이 앞섰다. 배포 환경과 스케줄링 정책을 직접 관리하는 것이 목표라면, 이번 Spark 기록을 도입 검증에 참고할 수 있다. 자체 배포 채택 여부를 판단하려면 처리 용량, 응답 품질, 장애 복구, 운영 비용 데이터도 확보해야 한다.
이번 테스트에서는 기기 4대의 구매비나 임대료, 전기 요금, 소비 전력, 이용률, 유지보수에 걸린 시간을 측정하지 않았고 답변 품질도 평가하지 않았다. 이 글의 결과만으로는 자체 배포 비용이 더 낮은지, 어느 쪽 모델의 답변 품질이 더 좋은지 입증할 수 없다.
자주 묻는 질문#
엔비디아 Spark 4대에 DeepSeek V4.1 Flash 1017을 자체 배포하면 API를 대체할 수 있나?#
이번 기록에서는 GB10 노드 4대에서 실행한 서비스가 DeepSeek 요청에 응답할 수 있음을 확인했다. 자체 배포 가중치가 동일한 1017 리비전인지는 확인할 수 없었다. 업무에서 쓰는 API를 대체할 수 있는지는 실제 부하, 응답 제한 시간, 품질과 운영 요구사항에 달려 있다. 저녁에 3/6건만 완료된 결과를 고려하면 부하가 높은 시간대에도 추가로 검증해야 한다.
본 테스트에서 나타난 13.66배의 차이는 하드웨어 성능 차이인가?#
13.66배는 같은 회차에서 긴 입력의 출력 속도 중앙값을 비교한 비율이다. 당시 캐시, 부하, 추론 서비스, 접속 경로 등의 차이가 모두 반영돼 있으므로 이 수치로 GPU 연산 성능의 배율을 추정할 수 없다.
캐시 적중률이 99.98%인데도 왜 충분히 빠르지 않았나?#
해당 회차에서 캐시는 거의 전부 적중했지만 긴 입력의 출력 속도 중앙값은 13.37 token/s에 그쳤다. 캐시 적중 비율만으로는 전체 속도를 설명하기 어렵다. 기록에는 단계별 소요 시간 데이터가 충분하지 않아 각 원인의 영향을 더 구체적으로 수치화할 수 없다.
Spark는 초당 100개가 넘는 토큰을 생성할 수 있나?#
과거 서버 로그에는 부하가 비교적 낮고 입력이 짧으며 출력이 256 토큰인 조건에서 104.8—156.8 token/s가 기록됐다. 이는 클라이언트 측에서 768 토큰 출력을 측정한 본 테스트와 기준이 다르며, 어떤 부하에서도 해당 성능이 지속된다고 볼 수 없다.
HTTP 200 응답을 받으면 호출이 성공했다고 볼 수 있나?#
이번 저녁 테스트에서는 그렇게 집계할 수 없다. 세 요청은 HTTP 200과 본문 일부를 받은 뒤 정상 종료 전에 중단됐다. 따라서 완료 건수는 6/6이 아니라 3/6으로 집계했다.
자체 배포와 Crazyrouter 중 어느 쪽이 더 저렴한가?#
이 글에는 두 방식을 같은 기준으로 비교할 수 있는 비용 데이터가 충분하지 않아 결론을 내릴 수 없다. 비용을 추산하려면 같은 업무량에서 하드웨어 비용, 이용률, 운영 비용, 실패 후 재시도 비용을 실제 API 청구액과 함께 비교해야 한다. 최신 요금은 Crazyrouter 요금 페이지에서 확인할 수 있다. 현재 요금을 과거 테스트의 실제 비용으로 적용할 수는 없다.
테스트 자료와 참고 문서#
서비스 연동에는 Crazyrouter 연동 가이드를 참고할 수 있다. 과제 정답률과 실제 비용 비교에 관심이 있다면 별도로 진행한 GPT-6.2 Sol과 DeepSeek V4.1 Flash 클라우드 비교 테스트 (중국어)를 참고할 수 있다. 해당 테스트의 문항과 채점 방식은 이 글의 속도 측정과 다르므로 결과를 합산할 수 없다.
이 글은 Crazyrouter의 과거 테스트 기록을 바탕으로 정리했으며, 통계는 2026년 11월 20일에 다시 계산했다. 원본 표본, 채널 검증 기록, 장비 진단 자료의 색인은 내부에 보관했다. 아래 주석에는 각 데이터의 출처와 집계 범위를 적었다.
작성자 Sophie M · 정리 날짜 2026년 11월 20일 · 데이터 수집일 2026년 11월 3—4일.
Footnotes#
-
2026-11-03에 진행한 4개 채널 본 테스트의 정식 요청은 26건이다. 이 글에는 기준선과 Spark에서 각각 6건을 사용했다. 개별 요청 기록, 집계 결과, 사용량 로그를 교차 확인했다. ↩ ↩2 ↩3
-
본 테스트의 응답 모델 필드와 2026-11-04에 진행한 4개 노드 점검을 근거로 한다. 확인된 범위는 응답 식별자와 배포 프로세스까지이며, 동일한 가중치인지는 검증되지 않았다. ↩
-
2026-11-04 01:04, 14:14, 20:24에 Spark를 세 차례 재시험했다. 회차당 요청은 6건이었으며, 저녁에 클라이언트 측에서 중단된 요청 세 건은 별도로 보관했다. ↩ ↩2
-
2026-11-04 장비 진단 기록. 미완료 요청 수는 완료된 요청의 소요 시간을 바탕으로 역산했으며, 대기 중인 요청과 실행 중인 요청을 모두 포함한다. ↩
-
2026-11-04 22:16에 직접 연결과 게이트웨이 경유를 두 쌍의 요청으로 추가 측정했다. 입력은 26 토큰, 출력은 256 토큰이었다. ↩
Implementation Guides
최신 에피소드
EP196 · 2026년 10월 29일 · 6:53
AI API Security Posture — Turn Controls Into Continuous Evidence
A practical guide to AI API security posture: inventory exposure, verify controls continuously, protect keys and data, constrain tools, and turn security assumptions into evidence that operators can act on.
EP195 · 2026년 10월 28일 · 7:21
AI API Policy Drift — Detect When Production Rules Stop Matching Intent
A practical guide to policy drift in AI APIs: version routing and safety rules, detect stale enforcement, compare intended and observed behavior, and restore control before small gaps become incidents.