Crazyrouter Blog

Praxisnotizen zu KI-Modellen, API-Kosten und Produktions-Workflows.

Modell-Updates, Integrationsanleitungen, Preisaufschlüsselungen und Tool-Workflows für Entwickler und Teams.

Crazyrouter-Anleitung: Von der Registrierung und dem API-Schlüssel bis zu Chat und Bildern
9. Oktober 20265 AufrufeDeutschTutorial

Crazyrouter-Anleitung: Von der Registrierung und dem API-Schlüssel bis zu Chat und Bildern

Crazyrouter Schritt für Schritt: Registrierung, API-Schlüssel, Wallet, Browser-Chat, Bilderzeugung und Entwicklerwerkzeuge. Mit acht Screenshots und Antworten auf häufige Fragen.
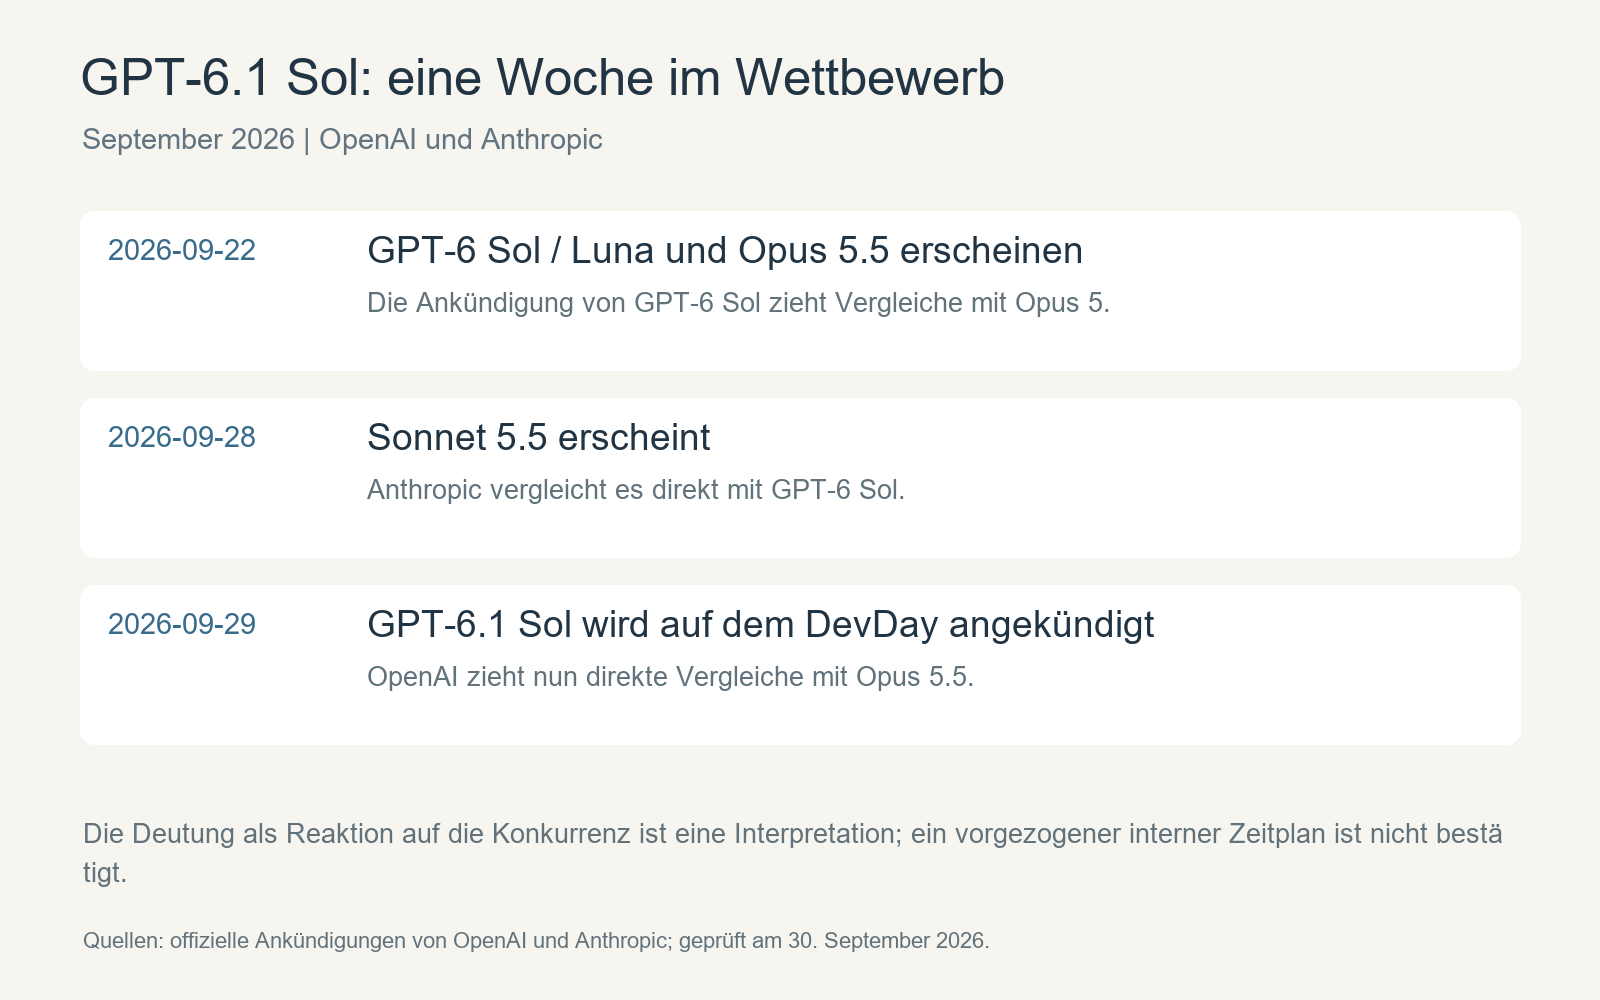
GPT-6.1 Sol vs. GPT-6 Sol: Update nach nur einer Woche – welche Rolle spielt Claude 5.5?
30. September 202673 AufrufeDeutschComparison

GPT-6.1 Sol vs. GPT-6 Sol: Update nach nur einer Woche – welche Rolle spielt Claude 5.5?

GPT-6.1 Sol im Vergleich mit GPT-6 Sol: die Rolle von Claude 5.5, offizielle Fortschritte bei langen Aufgaben und meine API-Tests samt Grenzen.

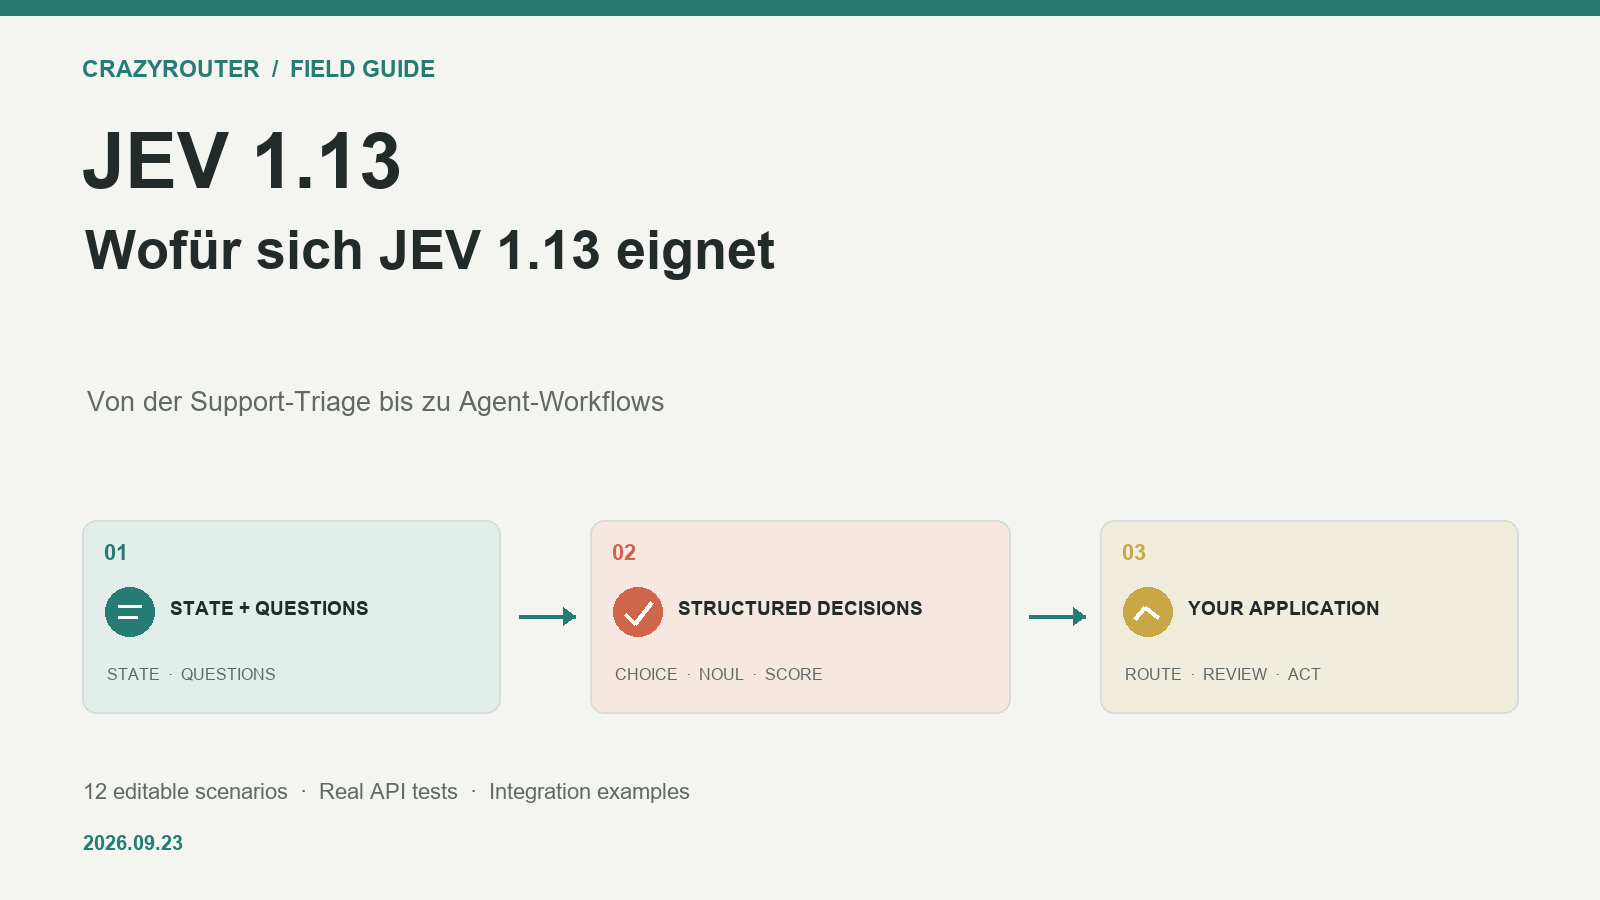
JEV 1.13 verwenden: Von Support-Triage bis Agent-Routing
23. September 2026107 AufrufeDeutschTutorial

JEV 1.13 verwenden: Von Support-Triage bis Agent-Routing

JEV 1.13 macht aus natürlicher Sprache Entscheidungen, Wahrscheinlichkeiten und Scores. Praxisbeispiele erklären Choice, Noul und Score. Im Crazyrouter JEV Decision Playground lassen sich 12 Szenarien testen und API-Code kopieren.

Warum Crazyrouter statt OpenRouter? Drei Unterschiede, die wirklich zählen
17. September 2026124 AufrufeDeutschComparison

Warum Crazyrouter statt OpenRouter? Drei Unterschiede, die wirklich zählen

Dieselben Claude-, GPT- und Gemini-Modelle, aber 35–45 % unter Listenpreis und ohne Aufladegebühr; keine gestaffelten Rate-Limits, individuelles RPM auf Anfrage; und ein echter Ansprechpartner, der jeden Fehler bis zur Lösung begleitet. Ein direkter Vergleich mit konkreten Preisen.

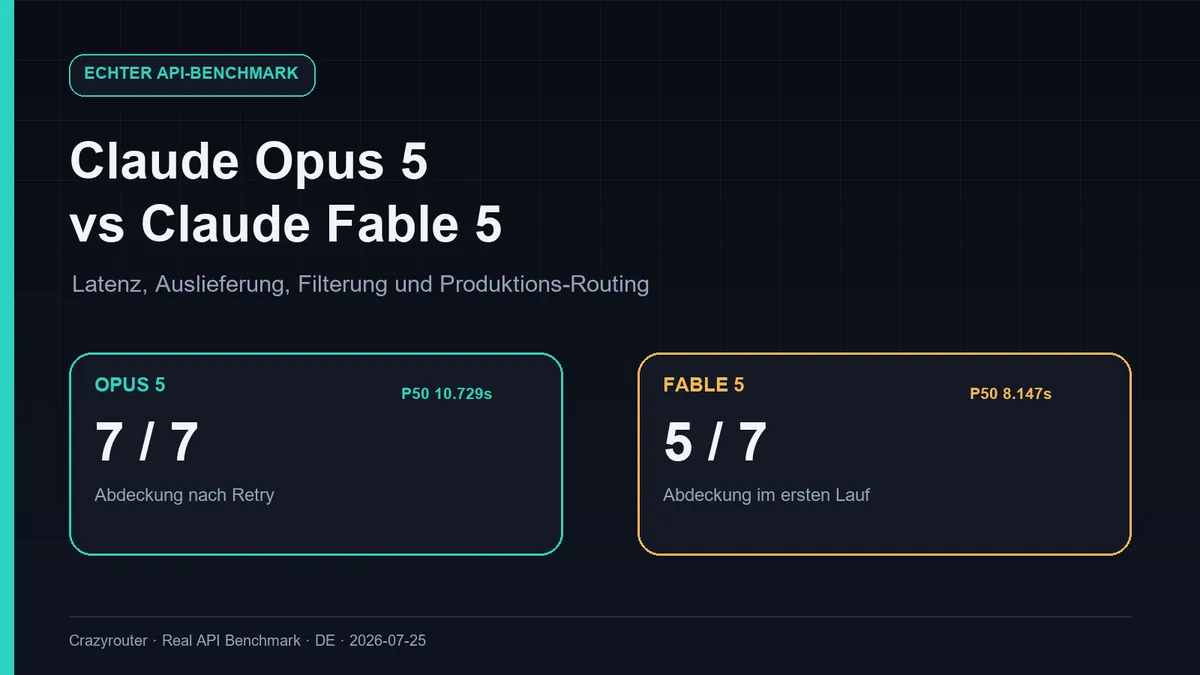
Claude Opus 5 vs. Claude Fable 5: Sieben-Task-Benchmark mit realer API und Empfehlungen für Production-Routing
25. Juli 2026271 AufrufeDeutschComparison

Claude Opus 5 vs. Claude Fable 5: Sieben-Task-Benchmark mit realer API und Empfehlungen für Production-Routing

Claude Opus 5 und Claude Fable 5 im Vergleich unter derselben OpenAI-compatible API sowie identischen Prompts und Parametern: getestet wurden Mathematik, Physik, Constraint Reasoning, Code Review, striktes JSON und Versuchsdesign. Erfasst wurden Auslieferungsrate, Content-Filtering, Latenz, Token-Nutzung und Retry-Ergebnisse.

Hat Kimi K3 bereits Claude Opus 4.8 erreicht? Ein API-Test in sieben Dimensionen
19. Juli 2026269 AufrufeDeutschComparison

Hat Kimi K3 bereits Claude Opus 4.8 erreicht? Ein API-Test in sieben Dimensionen

Ein Vergleich von Kimi K3 und Claude Opus 4.8 anhand von sieben Dimensionen: exakte Mathematik, physikalische Modellierung, schlussfolgern unter Nebenbedingungen, statistische Gegeninduktion, Code-Review, striktes JSON und Kalibrierung von Unsicherheit. Bewertet werden Korrektheit, erste sichtbare Antwort, Gesamtlatenz und Effizienz der Reasoning Tokens.

Kimi K3 im Vergleich zu Claude Opus 4.8: Mathematik, Physik und Programmierung auf Graduiertenniveau
19. Juli 2026268 AufrufeDeutschComparison

Kimi K3 im Vergleich zu Claude Opus 4.8: Mathematik, Physik und Programmierung auf Graduiertenniveau

Auf derselben Crazyrouter OpenAI-compatible API werden Kimi K3 und Claude Opus 4.8 anhand von Aufgaben zu Markov-Ketten mit Ersttrefferzeit auf Graduiertenniveau, dem Frequenzgang gekoppelter gedämpfter Oszillatoren und einem Abhängigkeits-Scheduling-Algorithmus verglichen; dokumentiert werden Ausgabevollständigkeit, Korrektheit, Latenz und unabhängige Abnahmeergebnisse.

Kimi K3 im Vergleich zu GPT-5.6-SOL: Härtetests in Mathematik, Physik und Programmierung
18. Juli 2026312 AufrufeDeutschComparison

Kimi K3 im Vergleich zu GPT-5.6-SOL: Härtetests in Mathematik, Physik und Programmierung

Unter derselben OpenAI-kompatiblen API und mit demselben Prompt werden kimi-k3 und gpt-5.6-sol anhand von Modus-Stop-Zeit, einer Physikaufgabe zum Trägheitsmoment mit Umlenkrolle und einer Programmieraufgabe mit Closure-Abhängigkeiten getestet; erfasst werden Korrektheit, Trunkierung, Latenz und lokale Code-Validierung.