简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
GPT-6.2 Sol против GPT-6 Sol: стоит ли доплачивать за точность? Результаты 32 тестов
32 теста на одном канале: GPT-6.2 Sol — 16/16, GPT-6 Sol — 13/16. Разбор 3 ошибок, времени по задачам, скидки, расходов и миграции reasoning_effort.
Если GPT-6 Sol уже справляется с повседневной работой, оценивать переход на GPT-6.2 Sol стоит на конкретных задачах. Исправляет ли новая модель ошибки в расчётах, сокращает ли время ожидания и оправдывает ли это дополнительные расходы?
В этой серии из 32 тестов через один и тот же канал Crazyrouter GPT-6.2 Sol полностью решила 16/16 задач, а GPT-6 Sol — 13/16. В задаче оптимизации с ограничениями новая модель в среднем ответила на 38.4% быстрее, но фактические расходы оказались выше на 53.2%. Для работы, где нужен точный подсчёт или оптимальное решение, эти результаты дают повод в первую очередь испытать 6.2 Sol. Если текущие задачи уже выполняются стабильно и важнее стоимость, 6 Sol стоит оставить.
Мы использовали те же восемь типов задач и те же критерии оценки, что и в предыдущей статье о сравнении Astra, но все запросы к Sol выполнили заново. Серии тестов проводились в разное время и при разном состоянии кэша, поэтому расходы из двух статей не стоит сводить в общий рейтинг моделей разных серий.
Что изменилось по официальным данным: контекст и базовые цены на ввод и вывод остались прежними#
Данные проверены 20 ноября 2026 года. Они взяты из официальной документации обеих моделей, без предположений на основе номеров версий. [1][2]
| Параметр | GPT-6.2 Sol | GPT-6 Sol |
|---|---|---|
| Идентификатор модели | gpt-6.2-sol | gpt-6-sol |
| Ввод / вывод | На входе текст и изображения, на выходе текст | На входе текст и изображения, на выходе текст |
| Контекстное окно | 1,050,000 токенов | 1,050,000 токенов |
| Максимум входных / выходных токенов | 922,000 / 128,000 токенов | 922,000 / 128,000 токенов |
| Дата отсечения знаний | 2026-06-01 | 2026-04-20 |
| Официальный тариф на некэшированный ввод | $2 за миллион токенов | $2 за миллион токенов |
| Официальный тариф на чтение из кэша | $0.10 за миллион токенов | $0.20 за миллион токенов |
| Официальный тариф на вывод | $10 за миллион токенов | $10 за миллион токенов |
reasoning_effort: none | Согласно документации, модель отклоняет это значение | Указано в документации как поддерживаемое значение |
Цены приведены для тарифа Standard при объёме ввода до 272K токенов включительно. Согласно документации обеих моделей, при вводе свыше 272K токенов тарифы на ввод и чтение из кэша удваиваются, а тариф на вывод становится в 1.5 раза выше, чем при коротком вводе. [1][2]
Формулировка «новая версия дешевле» может ввести в заблуждение. Официальные цены на некэшированный ввод и вывод у обеих моделей Sol одинаковы. На 50% снизилась цена чтения из кэша. Экономия зависит от доли кэшированных токенов, фактического расхода токенов и скидок на вашей платформе.
В официальных описаниях моделей также указаны поддержка изображений и работа с инструментами. В этой статье мы проверяли только текстовые запросы через Chat Completions. Перечень возможностей в документации сам по себе не подтверждает их работу через нашу платформу.
Условия тестирования: 32 основных запроса и отдельные проверки параметров и кода#
Основной тест прошёл 20 ноября 2026 года с 12:55 до 12:59 по пекинскому времени. Сначала мы проверили наличие обеих моделей через /v1/models, затем сравнили их на одном и том же канале вышестоящего поставщика.
| Условие | Настройки теста |
|---|---|
| Точка входа | Crazyrouter, https://api.crazyrouter.com/v1 |
| Эндпоинт | POST /chat/completions |
| Контроль маршрута | Зафиксировали один канал вышестоящего поставщика и подтвердили его по всем 32 записям о расходах |
| Промпты | Для каждой задачи сообщения system и user были полностью идентичны |
| Уровень рассуждений и лимит вывода | reasoning_effort: high, max_completion_tokens: 8192 |
| Режим ответа | Без потоковой передачи, stream: false |
| Порядок запросов | 8 типов задач × 2 прогона на модель, случайный порядок, всего 2 параллельных запроса |
| Критерии полного зачёта | HTTP 200, finish_reason=stop, JSON разбирается и по всем полям совпадает с заранее определённым эталонным ответом |
Задачи охватывали поиск по правилам, проверку ошибочного утверждения, оптимизацию на графе зависимостей, выбор оптимального набора с ограничениями, воспроизведение расчёта счёта, видимость данных в транзакциях, порядок удаления дубликатов и фильтрации, а также работу с границами интервалов. Эталонные ответы определили до отправки запросов и не включали в промпты для моделей.
Мы измеряли время от отправки запроса клиентом до получения полного ответа. В него вошли передача по сети, ожидание в очереди, рассуждение и формирование ответа. Задержку до первого токена отдельно не измеряли. Первые шесть задач взяли из прежнего набора тестов, а кэш не очищали. Поэтому расходы отражают фактический прогон без отдельного эксперимента на холодном кэше.
Совместимость параметров и примеры из статьи проверяли отдельно и не включали в 32 основных запроса. Несколько дополнительных запросов совпали по времени с основной серией, поэтому условия замера производительности не были строго изолированы. Максимальный зарегистрированный объём ввода в основной серии составил 14,377 токенов. Контекст на миллион токенов и правки по всему репозиторию не проверяли, а сгенерированный моделями код не запускали.
Результаты: 6.2 Sol прошла все тесты, 6 Sol допустила ошибки в двух типах задач#
| Задача | Зачёт у 6.2 Sol | Зачёт у 6 Sol | Среднее время 6.2 | Среднее время 6 |
|---|---|---|---|---|
| Поиск по длинной таблице правил | 2/2 | 2/2 | 15.60 с | 15.12 с |
| Исправление ошибочного утверждения | 2/2 | 0/2 | 15.39 с | 19.60 с |
| Оптимизация на графе зависимостей | 2/2 | 2/2 | 8.43 с | 9.74 с |
| Выбор оптимального набора с ограничениями | 2/2 | 1/2 | 20.24 с | 32.86 с |
| Воспроизведение расчёта счёта | 2/2 | 2/2 | 14.44 с | 11.32 с |
| Видимость данных в транзакциях | 2/2 | 2/2 | 8.54 с | 6.20 с |
| Удаление дубликатов перед фильтрацией | 2/2 | 2/2 | 8.79 с | 6.52 с |
| Работа с границами интервалов | 2/2 | 2/2 | 8.51 с | 5.70 с |
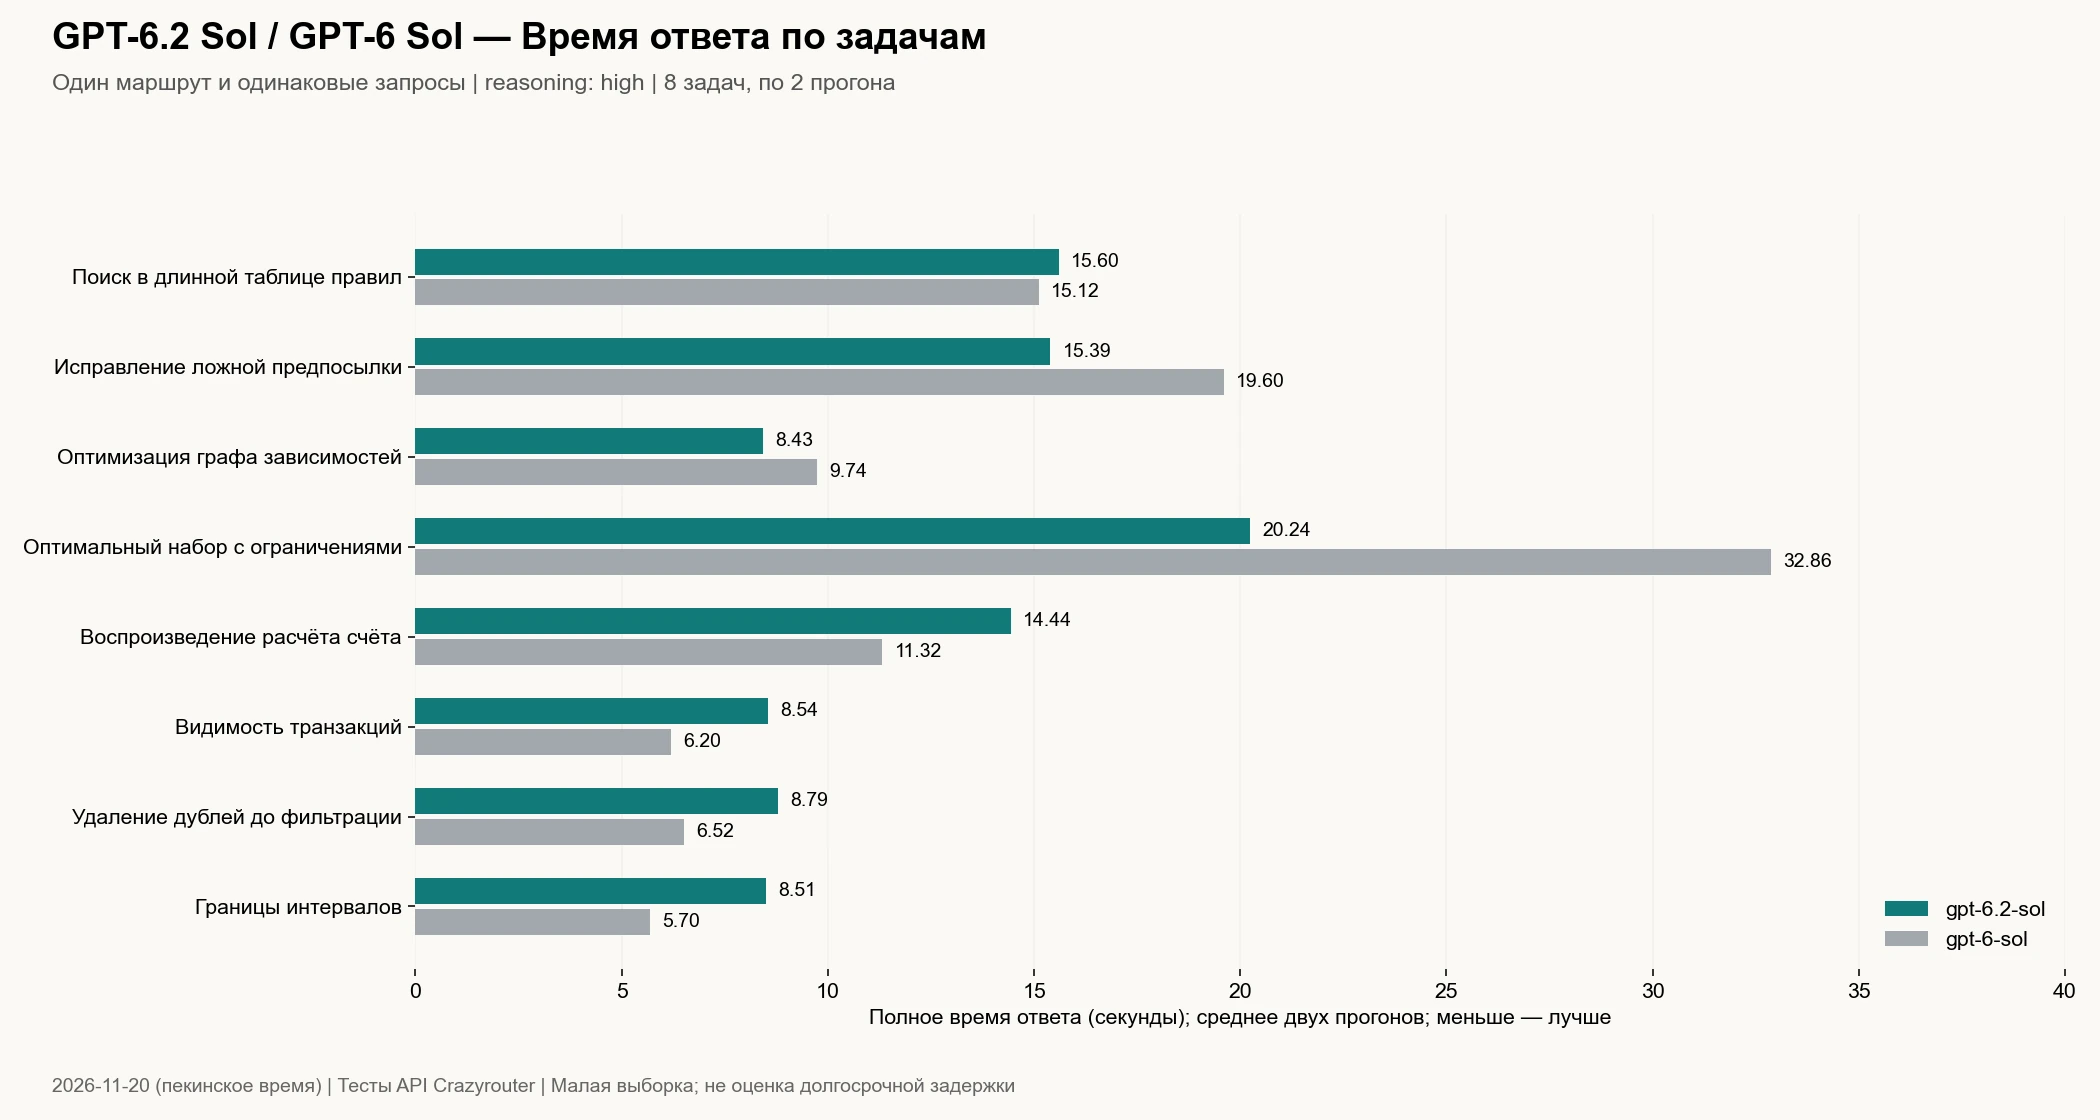
В расчёт времени вошли и запросы с ошибочными ответами. В каждой ячейке всего два замера, поэтому небольшая разница во времени не говорит об устойчивом преимуществе.
Все 32 запроса к обеим моделям завершились с HTTP 200, валидным JSON и причиной завершения stop. Модели разошлись в правильности ответов. Все три незачтённых ответа GPT-6 Sol содержали ошибки по существу.
Первая ошибка: модель опровергла утверждение, но неверно посчитала правила#
В задаче было 360 правил. Требовалось проверить утверждение «при delay=8 срабатывают ровно два правила SETTLED» и вернуть общее число подходящих правил.
Статусы правил повторяются с периодом в пять строк, поэтому правил SETTLED всего 72. Все значения delay_gt лежат в диапазоне 1–7, так что при delay=8 условие срабатывания выполняется для всех 72 правил.
Обе модели верно опровергли утверждение «ровно два», но получили разные результаты подсчёта.
| Поле ответа | Эталонный ответ | Два прогона GPT-6.2 Sol | Два прогона GPT-6 Sol |
|---|---|---|---|
exactly_two | false | В обоих false | В обоих false |
matching_count | 72 | 72, 72 | 69, 71 |
winner_policy_specified | false | Верно в обоих | Верно в обоих |
max_days_among_matches | 116 | Верно в обоих | Верно в обоих |
Если проверить лишь то, возразила ли модель коллеге, все четыре ответа выглядят правильными. Пополевая проверка показала, что старая версия в обоих прогонах пропустила часть правил, поэтому оба ответа не были засчитаны.
Такие расхождения особенно важны при сверке счетов, аудите правил и массовой фильтрации. Убедительная формулировка не избавляет от проверки чисел, а валидный JSON не заменяет проверку по бизнес-правилам.
Вторая ошибка: модель нашла допустимый набор, но пропустила оптимальный#
В задаче требовалось выбрать из 12 проектов набор с максимальной суммарной ценностью и соблюсти лимит веса, ограничение на количество проектов (не более 5), зависимости и условия взаимного исключения.
Перебор всех 4,096 подмножеств дал единственный оптимальный вариант.
{"best_value":78,"optimal_sets":[[0,2,6,9,11]]}
GPT-6.2 Sol правильно ответила в обоих прогонах. GPT-6 Sol правильно ответила в первом, а во втором вернула следующий результат.
{"best_value":77,"optimal_sets":[[0,2,4,6,9],[0,4,6,8,11]]}
Во втором прогоне предложенный набор удовлетворял ограничениям и действительно имел ценность 77, но модель пропустила набор с ценностью 78. Она нашла хороший допустимый вариант, хотя по условию требовался оптимальный.
На этой задаче среднее время ответа 6.2 Sol составило 20.24 секунды, а у 6 Sol — 32.86 секунды. Разница составила около 38.4%. Аналогичные задачи с ограничениями стоит включить в пробное тестирование новой версии. Двух прогонов недостаточно, чтобы заключить, что она будет быстрее или точнее на всех задачах оптимизации.
Скорость: среднее время немного сократилось, медианное выросло#
| Статистика по 16 основным запросам | GPT-6.2 Sol | GPT-6 Sol |
|---|---|---|
| HTTP 200 / валидный JSON | 16/16 | 16/16 |
| Задача полностью зачтена | 16/16 | 13/16 |
| Доля полностью зачтённых задач в этой серии | 100% | 81.25% |
| Среднее время получения полного ответа | 12.49 с | 13.38 с |
| Медианное время получения полного ответа | 12.48 с | 11.14 с |
| Минимальное / максимальное время | 5.29 / 20.28 с | 5.58 / 34.79 с |
6.2 Sol в среднем отвечала быстрее в трёх типах задач: при проверке ошибочного утверждения, оптимизации на графе зависимостей и выборе набора с ограничениями. В остальных пяти типах задач она не опередила прежнюю модель по среднему времени. Выигрыш на выборе набора снизил общее среднее, а медианное время, напротив, выросло.
По итогам этого теста переход может дать более точные ответы на отдельных задачах и сократить ожидание при более долгом поиске решения с ограничениями. Об общем ускорении говорить нельзя. Показатели 100% и 81.25% описывают результаты этой выборки. По ним нельзя оценить точность на любых задачах или гарантировать надёжность в долгосрочной работе.
Стоимость: базовые официальные цены совпадают, а на итоговый счёт влияют скидки платформы и фактический расход токенов#
На момент проверки в группе default на Crazyrouter для GPT-6 Sol действовала скидка 35% (оплата 65% тарифа), а GPT-6.2 Sol тарифицировалась без скидки. Ниже приведены цены платформы с учётом скидки для короткого ввода.
| За миллион токенов | GPT-6.2 Sol | GPT-6 Sol |
|---|---|---|
| Некэшированный ввод | $2.00 | $1.30 |
| Чтение из кэша | $0.10 | $0.13 |
| Вывод | $10.00 | $6.50 |
У новой версии дешевле чтение из кэша, у старой — некэшированный ввод и вывод. Чтобы оценить собственные расходы, заново сверьтесь со страницей цен Crazyrouter. Одного сравнения номеров версий или официальных цен для этого мало.
Для всех 32 основных запросов мы нашли записи о списании по идентификатору запроса. В таблице фактические списания пересчитаны делением на значение quota_per_unit=500000, действующее на платформе.
| Фактическое потребление и расходы | GPT-6.2 Sol | GPT-6 Sol |
|---|---|---|
| Число основных запросов | 16 | 16 |
| Входные токены по данным вышестоящего поставщика | 125,998 | 112,964 |
| Из них токены, прочитанные из кэша | 56,576 | 55,168 |
| Доля входных токенов из кэша | 44.9% | 48.8% |
| Выходные токены (включая токены рассуждений) | 5,460 | 7,325 |
| Фактические расходы | $0.199104 | $0.129922 |
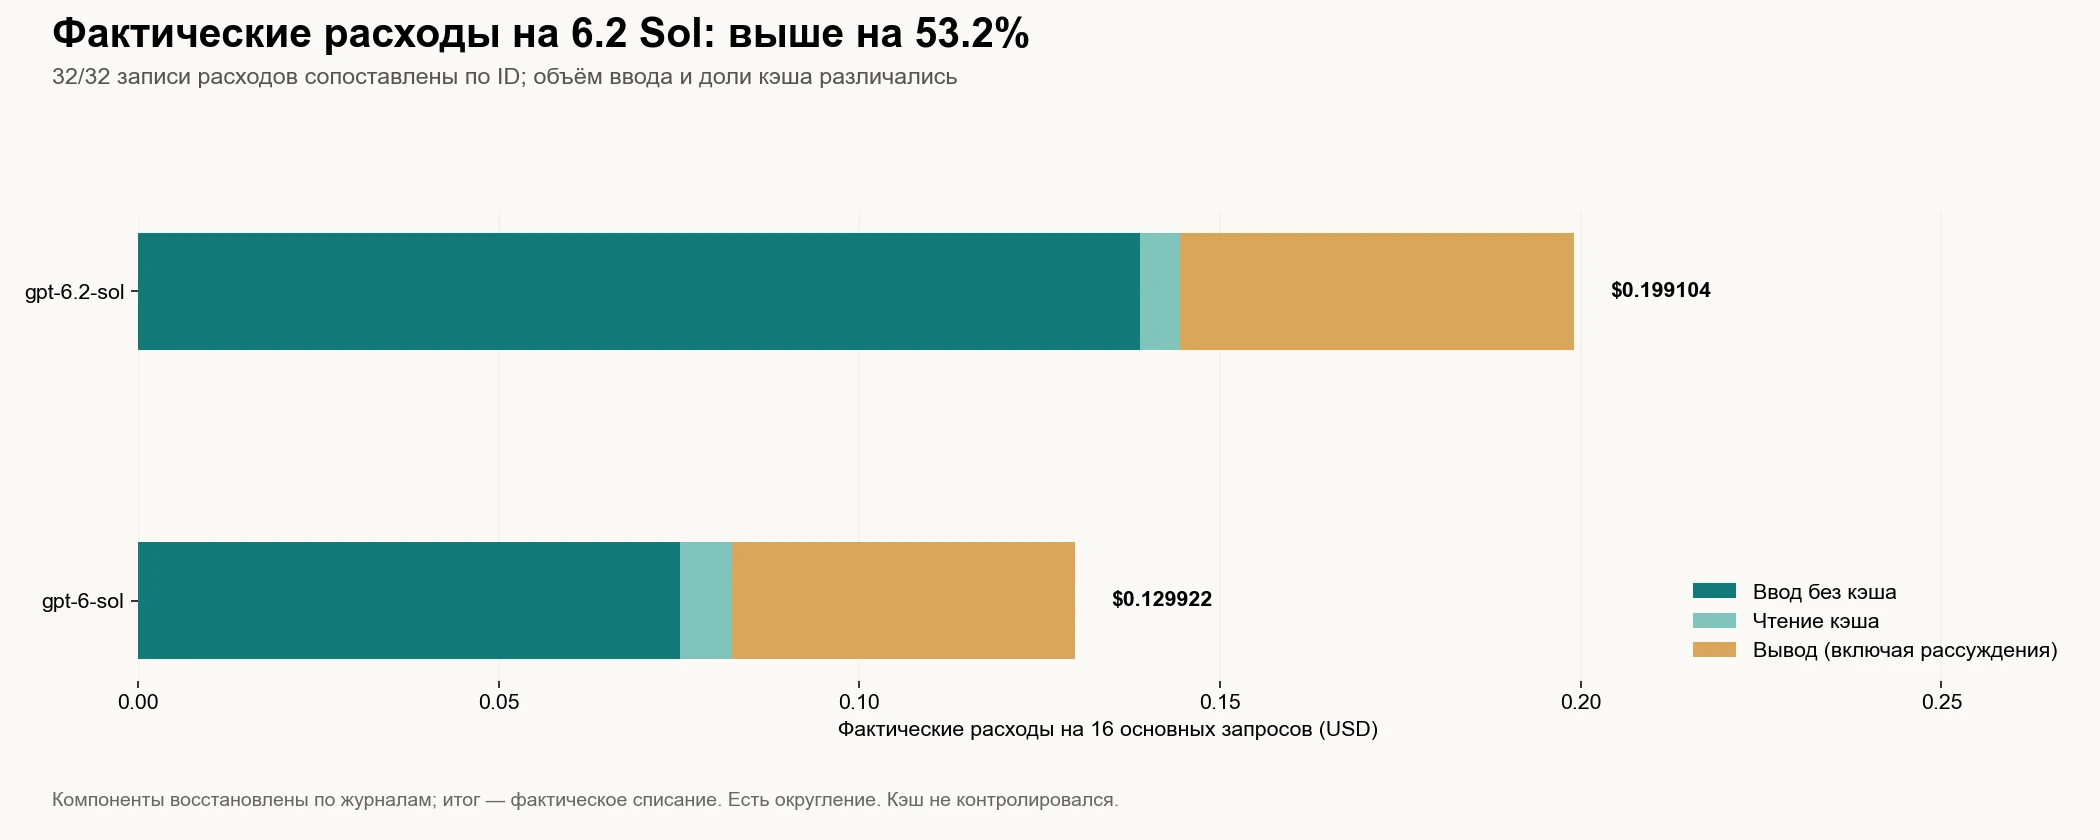
Итог взят из фактических списаний, разбивка восстановлена по журналам. Незначительные расхождения связаны с округлением. В расходы включены запросы с неверными ответами. Проверки параметров, примеры кода и генерация обложки в расчёт не вошли.
В этом прогоне новая версия обошлась на 53.2% дороже, но решила и те задачи, с которыми старая версия справилась не во всех прогонах. Три ошибочных ответа старой модели тоже были оплачены. В таблице не учтены затраты на ручную проверку, повторные запросы и исправления в реальной работе.
При одинаковом видимом промпте вышестоящий поставщик сообщил разное количество входных токенов, при этом у новой версии выходных токенов оказалось меньше. Мы не установили причину расхождения в числе входных токенов и не выравнивали степень прогрева кэша. Поэтому 53.2% описывают только этот прогон. У других пользователей разница в расходах может быть иной.
Что проверить перед переходом: значение none из старых настроек нельзя переносить напрямую#
Согласно официальной документации, GPT-6 Sol поддерживает reasoning_effort: none, а GPT-6.2 Sol отклоняет это значение. [1][2] Мы отдельно отправили через тот же канал по одному короткому запросу на ответ в JSON к каждой модели, явно указав none.
| Дополнительная проверка параметра | GPT-6.2 Sol | GPT-6 Sol |
|---|---|---|
| Статус HTTP | 400 | 200 |
| Ответ | provider_temporarily_unavailable, общее сообщение о недоступности сервиса | {"ok":true}, штатное завершение |
Наблюдение согласуется с различиями, описанными в документации. При этом Crazyrouter сопоставил ошибку 6.2 с общим сообщением, и в ответе нет прямого указания на none. Одного сообщения о временной недоступности сервиса недостаточно, чтобы определить причину сбоя. Бесконечно повторять запросы с теми же несовместимыми настройками тоже не стоит.
Перед переходом проверьте параметры существующих запросов и протестируйте явно поддерживаемый уровень рассуждений. В основном тесте и в примере статьи использовался high. Кроме того, в официальном описании GPT-6 Sol указаны ограничения на уровень рассуждений при вызове функций через Chat Completions. Приложениям, работающим с инструментами, нужны отдельные регрессионные тесты. Вызовы инструментов и Responses API в рамках статьи не проверялись.
Пример вызова, проверенный на обеих моделях#
В примере ниже нужно объединить пересекающиеся или смежные полуоткрытые интервалы. Установите requests, задайте свой ключ в переменной окружения CRAZYROUTER_API_KEY и запустите пример. К адресу API UTM-метки не добавляются.
import json
import os
import requests

BASE_URL = "https://api.crazyrouter.com/v1"
MODELS = ["gpt-6.2-sol", "gpt-6-sol"]
PROMPT = ('Merge overlapping OR TOUCHING half-open intervals [[-3,2],[1,5],[5,9]] into maximal intervals. '
          'Return JSON only: {"merged":[[start,end]],"length":integer}.')


def run():
    session = requests.Session()
    session.trust_env = False
    results = []
    for model in MODELS:
        response = session.post(
            BASE_URL + "/chat/completions",
            headers={"Authorization": "Bearer " + os.environ["CRAZYROUTER_API_KEY"]},
            json={
                "model": model,
                "messages": [{"role": "user", "content": PROMPT}],
                "reasoning_effort": "high",
                "max_completion_tokens": 8192,
                "stream": False,
            },
            timeout=(15, 180),
        )
        response.raise_for_status()
        data = response.json()
        choice = data["choices"][0]
        if choice["finish_reason"] != "stop":
            raise RuntimeError("Incomplete output: " + str(choice["finish_reason"]))
        answer = json.loads(choice["message"]["content"])
        assert answer == {"merged": [[-3, 9]], "length": 12}, answer
        result = {"model": model, "answer": answer,
                  "request_id": response.headers.get("x-oneapi-request-id")}
        print(json.dumps(result, ensure_ascii=False))
        results.append(result)
    return results


if __name__ == "__main__":
    run()
Окончательный вариант проверили отдельным вызовом каждой модели. Обе вернули {"merged":[[-3,9]],"length":12} с finish_reason=stop. Эти два вызова прошли через обычный пользовательский маршрут и учитывались отдельно от основного теста с фиксированным каналом.
В первоначальном промпте примера было сказано только «объединить полуоткрытые интервалы». 6.2 Sol вернула [[-3,5],[5,9]]. Длина по-прежнему составила 12, но проверка в программе ожидала один интервал. Когда мы явно попросили «объединить пересекающиеся или смежные интервалы, чтобы получить максимальные интервалы», обе модели прошли проверку. Историю правки примера сохранили. В задаче основного теста требование объединять смежные интервалы было указано с самого начала. Задачу не меняли и не заменяли результаты повторным прогоном.
Поля запроса можно сверить с документацией API Crazyrouter. Командам, использующим Codex (на английском) или Cursor (на английском), стоит провести регрессионные тесты на собственных задачах и наборе инструментов. Успешный текстовый пример не подтверждает работу всего агентного процесса.
Когда стоит переходить на GPT-6.2 Sol?#
| Сценарий | Что следует из результатов теста |
|---|---|
| Точный подсчёт и фильтрация по правилам, при которых уже случались пропуски | В первую очередь протестируйте 6.2 Sol и сохраните программную проверку |
| Поиск оптимального набора с зависимостями и взаимными исключениями | Попробуйте 6.2 Sol. В этом тесте оба ответа были правильными, а среднее время ожидания сократилось |
| Повседневная обработка данных уже проходит регрессионные проверки, приоритет — расходы | Можно оставить 6 Sol. Сейчас её тарифы на платформе с учётом скидки ниже |
| Главная цель — сократить время ответа | Сначала измерьте время на своих задачах. В этом тесте новая версия в среднем быстрее только в трёх типах задач |
В существующих запросах задано reasoning_effort: none | Сначала измените уровень рассуждений, затем переключите модель |
| Нужны понимание изображений, вызовы инструментов или длительные агентные сессии | Проверьте эти возможности отдельно. По этому тесту судить о них нельзя |
Для предварительного сравнения на одинаковых задачах можно использовать Model Arena, а затем собрать фиксированный регрессионный набор из реальных задач, на которых модель ошибалась. Если задать критерии приёмки для каждого важного поля, оценить пользу перехода будет проще, чем по тому, насколько гладко написан один ответ.
Как воспроизвести задачу оптимизации с ограничениями#
Ниже приведён полный пользовательский промпт для этой задачи. В основном тесте задали уровень рассуждений high и лимит вывода 8192, а в сообщении system потребовали вернуть только JSON. Эталонный ответ использовали только для локальной оценки и модели не отправляли.
Items IDs 0..11 have weights [4, 7, 2, 9, 5, 3, 8, 6, 4, 7, 1, 5] and values [13, 18, 7, 26, 14, 9, 23, 16, 12, 20, 4, 15]. Select total weight <=26 and at most 5 items. Constraints: selecting 3 requires 1; 6 and 7 cannot both be selected; selecting 9 requires 2; at least one of 0 and 4 must be selected. Maximize total value. Return JSON with best_value and optimal_sets (ALL optimal ID lists sorted ascending, and lists lexicographically sorted).
Заранее рассчитанный эталонный ответ
{"best_value": 78, "optimal_sets": [[0, 2, 6, 9, 11]]}
Оптимальность решения можно подтвердить полным перебором всех подмножеств из 12 кандидатов с отбрасыванием вариантов, нарушающих ограничения по весу и количеству, условия зависимостей или взаимного исключения. Исходные запросы, ответы и записи по каждому списанию, необходимые для перепроверки, сохранены в архиве. Таблицы и графики в статье построены по этим данным.
Идентификаторы двух отдельных запросов из минимального примера вызова
gpt-6.2-sol—8f830a249943b0b13a1ec388dbf882f6.gpt-6-sol—f08d86841a979c9bf2d8928816e31789.
Частые вопросы#
GPT-6.2 Sol точнее GPT-6 Sol?#
В этой серии из восьми типов задач с двумя прогонами на каждый тип новая версия набрала 16/16, старая — 13/16. Разница пришлась на подсчёт подходящих правил и оптимизацию с ограничениями. По этим результатам нельзя судить о точности на всех задачах.
Насколько GPT-6.2 Sol быстрее GPT-6 Sol?#
В этой серии среднее время выбора набора с ограничениями сократилось на 38.4%, а среднее по всем запросам — примерно на 6.6%. При этом медиана выросла с 11.14 до 12.48 секунды. Новая версия оказалась быстрее лишь в части типов задач.
Снизилась ли цена API для GPT-6.2 Sol?#
Официальные цены на некэшированный ввод и вывод остались прежними. Чтение из кэша подешевело с 0.10 за миллион токенов. На нашей платформе для старой модели сейчас действует скидка 35% (оплата 65% тарифа), и фактические суммарные расходы в этой серии оказались выше у новой версии.
Оправдывает ли результат дополнительные расходы?#
Если пропущенные позиции при подсчёте или упущенный оптимум в старой модели могут привести к убыткам, новую версию стоит включить в тестирование. Если текущие задачи уже проходят проверку стабильно, можно пока оставить старую. Мы не измеряли затраты на ручные исправления и повторные запросы, поэтому по этому тесту нельзя рассчитать выгоду для каждого бизнеса.
Почему в статье ответ засчитали как ошибочный, хотя запрос к API завершился успешно?#
HTTP 200, валидный JSON и штатное завершение показывают только, что запрос был выполнен. Во всех трёх ошибочных ответах старой версии структура была правильной, но значения полей не совпадали с заранее определённым эталоном, поэтому ответы не зачли целиком.
Можно ли просто изменить имя модели на gpt-6.2-sol?#
Базовый URL и способ отправки текстовых запросов можно сохранить. Сначала проверьте параметры рассуждений. В документации прямо указано, что новая версия не принимает none, и при проверке через нашу платформу мы тоже получили HTTP 400. Потоковые ответы, инструменты, изображения и прочие возможности нужно проверять отдельно.
Источники
- OpenAI — документация модели GPT-6.2 Sol, проверено 2026-11-20.
- OpenAI — документация модели GPT-6 Sol, проверено 2026-11-20.
- PostgreSQL — изоляция транзакций и Read Committed, использована для проверки правил в задаче о транзакциях.
Автор — Brian J. Тесты выполнил автоматизированный скрипт. Статья описывает фактическую работу сервиса при маршрутизации через нашу платформу. Независимого аудита весов моделей у вышестоящего поставщика не проводили. Каждую задачу проверили всего дважды, через один канал и в один период времени, без изоляции ранее заполненного кэша. Исходные запросы, ответы, эталонные решения и обезличенные записи о расходах сохранены в архиве. Повторная проверка сведений, которые могут измениться, запланирована на 2026-12-20.
Implementation Guides
Podcast
AI Dev Tools: The Crazyrouter Podcast
Короткие выпуски для разработчиков (на английском): AI API, шлюзы, контроль затрат и инструменты для кода.
Новые выпуски
EP196 · 29 окт. 2026 г. · 6:53
AI API Security Posture — Turn Controls Into Continuous Evidence
A practical guide to AI API security posture: inventory exposure, verify controls continuously, protect keys and data, constrain tools, and turn security assumptions into evidence that operators can act on.
EP195 · 28 окт. 2026 г. · 7:21
AI API Policy Drift — Detect When Production Rules Stop Matching Intent
A practical guide to policy drift in AI APIs: version routing and safety rules, detect stale enforcement, compare intended and observed behavior, and restore control before small gaps become incidents.