简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
GPT-6.2 SolとGPT-6 Solを比較:32回の実測で検証、正確さの向上は追加費用に見合うか?
同一チャネルで32回テストした結果、全項目が正解だったのはGPT-6.2 Solが16/16、GPT-6 Solが13/16。3回の誤答、設問別の応答時間、当サイトの割引と実際の請求額を比較し、移行時のreasoning_effortの違いも検証した。
GPT-6 Solですでに日常業務をこなせているなら、GPT-6.2 Solに切り替える理由は、具体的なタスクで判断したい。これまで間違えやすかった計算が正しくなるか、待ち時間は短くなるか、追加費用に見合うかという点だ。
今回Crazyrouterで同一チャネルを使って行った32回のテストでは、全項目が正解だったのはGPT-6.2 Solが16/16、GPT-6 Solが13/16だった。新版は制約付き最適化問題の平均所要時間を38.4%短縮した一方、実際の利用額は53.2%高かった。 正確な件数や最適解を求める業務では、今回の結果から6.2 Solを優先して試す価値がある。既存タスクで安定して合格しており、費用を優先する用途なら、6 Solを使い続ける選択肢もある。
今回は前回のAstra比較記事と同じ8種類の設問と採点方法を用い、Solへのリクエストはすべて改めて実行した。両シリーズはテスト時刻とキャッシュ状態が異なるため、2本の記事の費用をもとにシリーズ横断のランキングを作るのは適切ではない。
公式仕様の変更点:コンテキストウィンドウと入出力の基本料金は同じ#
確認日は2026年11月20日。以下の情報は両モデルの公式ドキュメントに基づく。[1][2]
| 項目 | GPT-6.2 Sol | GPT-6 Sol |
|---|---|---|
| モデル名 | gpt-6.2-sol | gpt-6-sol |
| 入力 / 出力 | テキスト・画像入力、テキスト出力 | テキスト・画像入力、テキスト出力 |
| コンテキストウィンドウ | 1,050,000トークン | 1,050,000トークン |
| 最大入力 / 最大出力 | 922,000 / 128,000トークン | 922,000 / 128,000トークン |
| 知識のカットオフ日 | 2026-06-01 | 2026-04-20 |
| キャッシュされていない入力の公式料金 | 100万トークンあたり $2 | 100万トークンあたり $2 |
| キャッシュ読み取りの公式料金 | 100万トークンあたり $0.10 | 100万トークンあたり $0.20 |
| 出力の公式料金 | 100万トークンあたり $10 | 100万トークンあたり $10 |
reasoning_effort: none | 公式ドキュメントではこの値を拒否すると明記 | 公式ドキュメントではサポート対象 |
料金はStandardのうち、入力が272Kトークン以下の区分を適用している。両モデルのドキュメントによると、入力が272Kを超えると、入力とキャッシュの料金は2倍になり、出力料金は短い入力向けの区分の1.5倍になる。[1][2]
ここで誤解しやすいのは「新版のほうが安い」という点だ。両Solモデルで、キャッシュされていない入力と出力の公式料金は同じ。キャッシュ読み取りの単価は50%下がった。 実際に節約できるかは、キャッシュの利用割合、実際のトークン消費量、利用するプラットフォームの割引によって決まる。
公式モデルページには画像やツール関連の機能も記載されている。この記事で実測したのはテキストのChat Completionsのみであり、公式の機能一覧を、当サイトですべての機能が検証済みである根拠にはしていない。
テスト設定:本テスト32回とは別にパラメータとコードを確認#
本テストは**2026年11月20日 12:55—12:59(北京時間)**に実行した。両モデルをまず/v1/modelsで確認し、その後、同じ上流チャネルを使って比較した。
| 条件 | 今回の設定 |
|---|---|
| 接続先 | Crazyrouter、https://api.crazyrouter.com/v1 |
| エンドポイント | POST /chat/completions |
| ルーティングの制御 | 同一の上流チャネルに固定し、32件の利用ログを1件ずつ照合して一致を確認 |
| プロンプト | 同じ設問ではsystemメッセージとuserメッセージを完全に統一 |
| 推論 / 出力上限 | reasoning_effort: high、max_completion_tokens: 8192 |
| 応答方式 | 非ストリーミング、stream: false |
| リクエストの実行方法 | 8種類のタスク × 各モデル2回。順序はランダム、全体の同時実行数は2 |
| 設問単位の合格基準 | HTTP 200、finish_reason=stop、JSONを解析でき、事前に確定した正解と全フィールドが一致 |
タスクは、ルール検索、誤った前提の検証、依存関係グラフの最適化、制約付きの項目選択、請求処理の再現、トランザクションの可視性、重複排除と絞り込みの順序、区間の境界を扱う推論で構成した。正解はリクエスト送信前に確定し、モデルに送ったプロンプトには含めていない。
所要時間は、クライアントがリクエストを送信してから応答全体を受信するまでを計測した。ネットワーク通信、キューでの待機、推論、出力を含み、最初のトークンが返るまでの時間とは異なる。最初の6問は過去のテストセットを再利用し、キャッシュは消去しなかった。したがって、費用はキャッシュが空の状態での実験値ではなく、今回の実行時に記録した実額である。
パラメータの互換性と記事中のサンプルは別途検証し、本テストの32回には含めていない。少数の追加リクエストは本テストと同じ時間帯に実行しており、厳密に分離した性能実験ではない。本テストで報告された最大入力は14,377トークンだった。100万トークン規模のコンテキストは検証しておらず、リポジトリ全体の変更やモデルが生成したコードの実行もテストしていない。
結果:6.2 Solは全問合格、6 Solは2種類のタスクで不合格#
| タスク | 6.2 Solの合格数 | 6 Solの合格数 | 6.2の平均所要時間 | 6の平均所要時間 |
|---|---|---|---|---|
| 長いルール表からの検索 | 2/2 | 2/2 | 15.60秒 | 15.12秒 |
| 誤った前提の訂正 | 2/2 | 0/2 | 15.39秒 | 19.60秒 |
| 依存関係グラフの最適化 | 2/2 | 2/2 | 8.43秒 | 9.74秒 |
| 制約付きの最適な組み合わせの選択 | 2/2 | 1/2 | 20.24秒 | 32.86秒 |
| 請求処理の再現 | 2/2 | 2/2 | 14.44秒 | 11.32秒 |
| トランザクションの可視性 | 2/2 | 2/2 | 8.54秒 | 6.20秒 |
| 重複排除してから絞り込み | 2/2 | 2/2 | 8.79秒 | 6.52秒 |
| 区間の境界を扱う推論 | 2/2 | 2/2 | 8.51秒 | 5.70秒 |
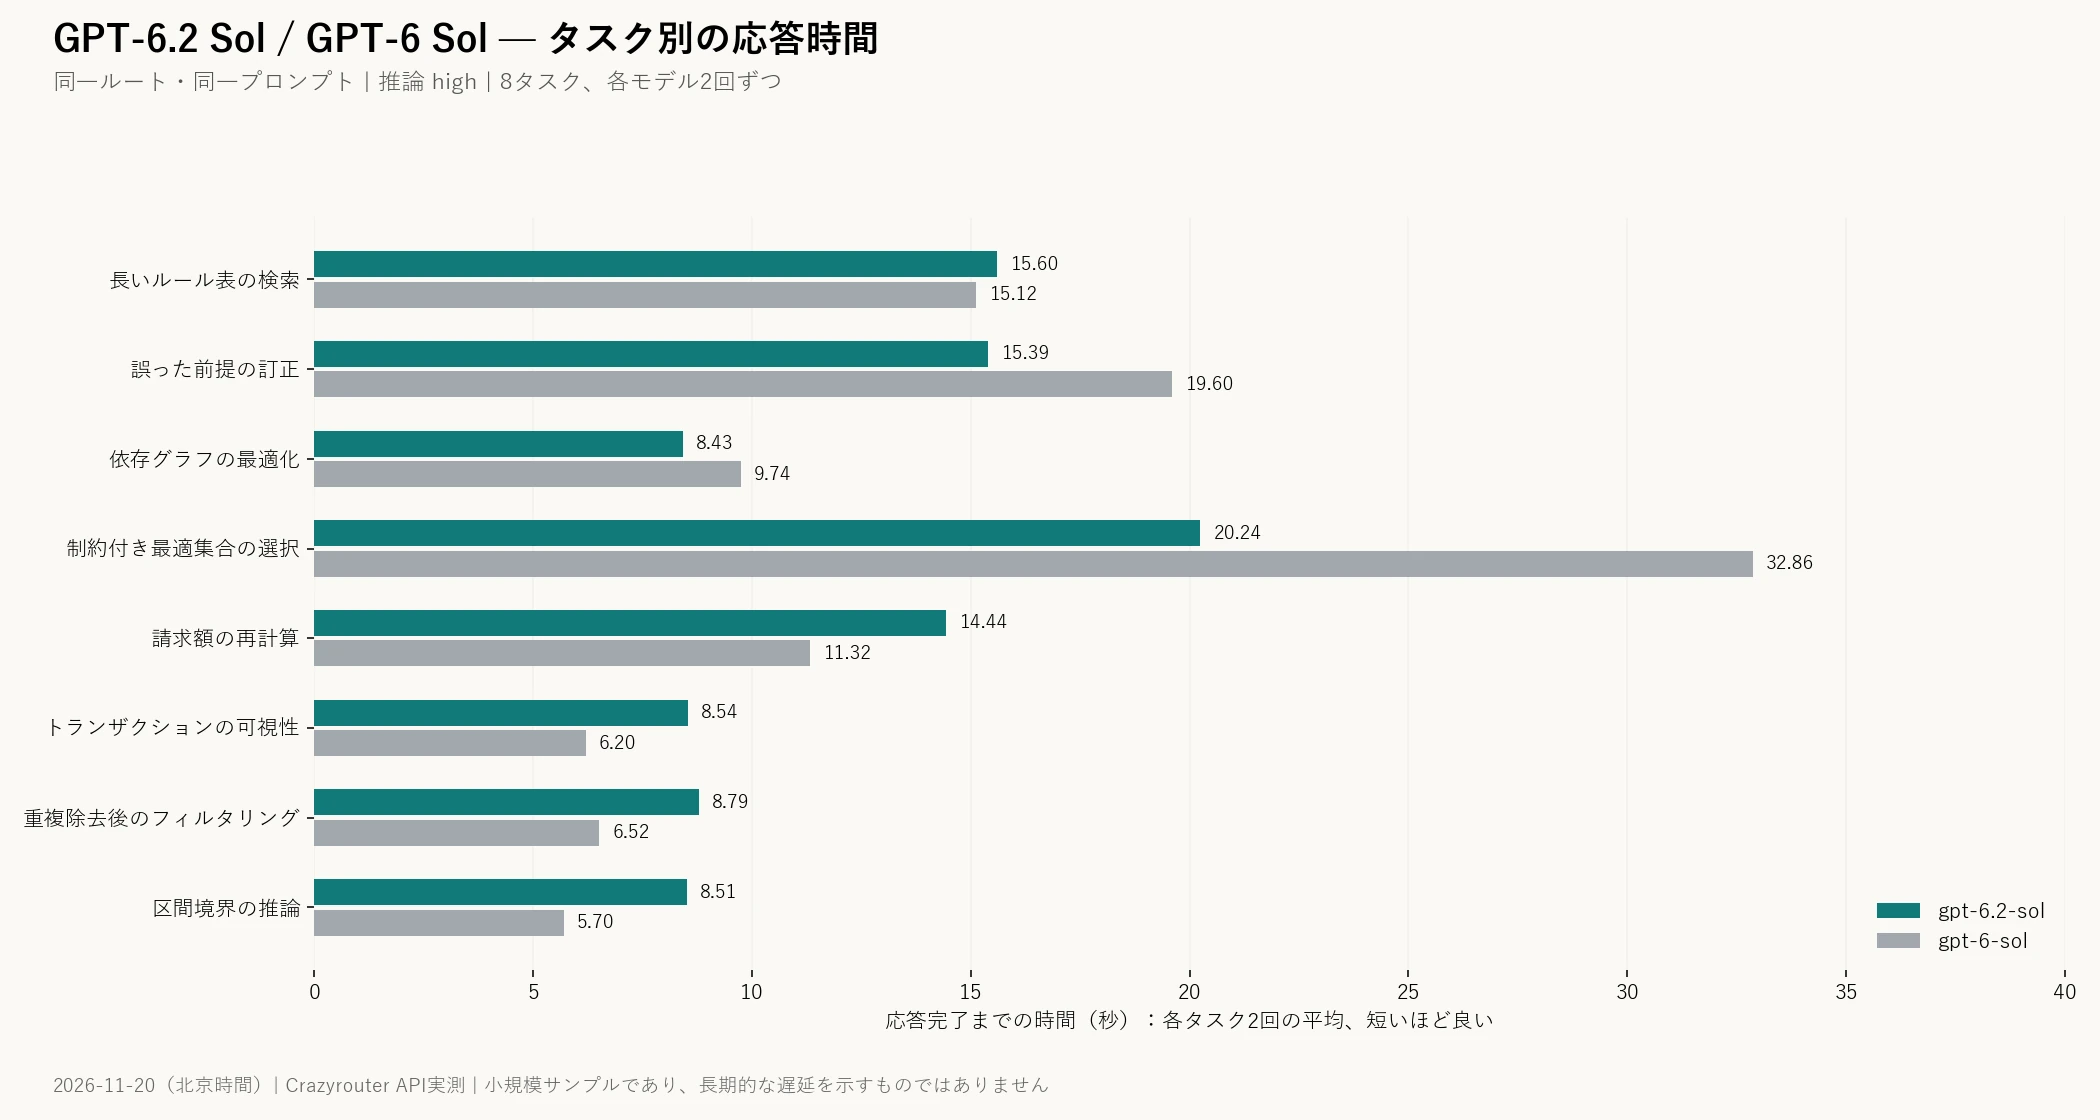
所要時間には誤答したリクエストも含めており、正解した応答だけを集計したわけではない。各セルは2回分のみなので、所要時間が近い場合に安定した優位性があるとは判断できない。
両モデルへの32回のリクエストは、すべてHTTP 200と有効なJSONを返し、終了理由もすべてstopだった。差が出たのは回答の正しさで、GPT-6 Solの3回の不合格はいずれも回答内容の誤りによるものだった。
誤りその1:誤った前提は否定できたが、件数を正しく数えられなかった#
この設問では360件のルールを提示し、「delay=8のとき発動するSETTLEDルールはちょうど2件」という主張を検証したうえで、該当するルールの総数を返すよう求めた。
ルールのステータスは5件周期で切り替わるため、SETTLEDは合計72件ある。すべてのdelay_gtは1—7の範囲にあるので、delay=8ではこの72件すべてが発動条件を満たす。
両モデルとも「ちょうど2件」という主張は正しく否定したが、集計した件数に差があった。
| 返却フィールド | 正解 | GPT-6.2 Solの2回の結果 | GPT-6 Solの2回の結果 |
|---|---|---|---|
exactly_two | false | いずれもfalse | いずれもfalse |
matching_count | 72 | 72、72 | 69、71 |
winner_policy_specified | false | いずれも正解 | いずれも正解 |
max_days_among_matches | 116 | いずれも正解 | いずれも正解 |
同僚の主張を否定したかどうかだけを見れば、4つの回答はどれも正解に見える。フィールドごとに照合すると、旧版は2回とも数え漏れがあり、設問全体では不合格となった。
この種の差は、請求内容の照合、ルール監査、一括フィルタリングで特に重要になる。説明がもっともらしくても件数の正しさは保証されず、JSONが有効でも業務上の検証は必要だ。
誤りその2:制約を満たす案は出したが、真の最適解を見落とした#
制約付きの項目選択では、重量の上限、選べる項目は最大5つ、依存関係と排他条件をすべて満たしながら、12の項目から合計価値が最大になる組み合わせを選ぶよう求めた。
4,096通りの部分集合をすべて列挙した結果、最適解は次の1通りだった。
{"best_value":78,"optimal_sets":[[0,2,6,9,11]]}
GPT-6.2 Solは2回とも正解した。GPT-6 Solは1回目に正解し、2回目は次の回答を返した。
{"best_value":77,"optimal_sets":[[0,2,4,6,9],[0,4,6,8,11]]}
2回目の組み合わせは制約を満たし、価値も確かに77だったが、価値78の組み合わせを見つけられなかった。条件を満たす有力な案は提示できたものの、設問が要求した最適解には届かなかった。
この設問で6.2 Solの平均所要時間は20.24秒、6 Solは32.86秒で、約38.4%短縮された。この結果から、同様の制約付きタスクを新版の試用対象に加える価値はある。ただし、2回の結果だけでは、あらゆる最適化問題で速さや正確さが向上するとは言えない。
速度は全面的には向上せず、平均はやや短く中央値は長い#
| 本テスト16回の集計 | GPT-6.2 Sol | GPT-6 Sol |
|---|---|---|
| HTTP 200 / 有効なJSON | 16/16 | 16/16 |
| 設問単位の合格数 | 16/16 | 13/16 |
| 今回の設問単位の合格率 | 100% | 81.25% |
| 応答完了までの平均所要時間 | 12.49秒 | 13.38秒 |
| 応答完了までの所要時間の中央値 | 12.48秒 | 11.14秒 |
| 最短 / 最長所要時間 | 5.29 / 20.28秒 | 5.58 / 34.79秒 |
6.2 Solの平均所要時間が短かったのは、誤った前提の検証、依存関係グラフ、制約付きの組み合わせ選択の3種類だった。残りの5種類では平均所要時間で先行しなかった。制約付きの組み合わせ選択で短縮できた待ち時間が全体の平均を引き下げた一方、中央値は逆の傾向を示した。
今回の結果からアップグレードの理由として挙げられるのは、特定の設問で正確さが向上し、時間がかかっていた制約付きの求解が短縮されたことだ。「6.2 Solは全面的に高速化した」とは言えない。同様に、100%と81.25%はこのサンプルでの成績であり、汎用的な能力評価や長期的な信頼性の保証にはならない。
費用:公式の基本料金は同じでも、当サイトの割引と実際の使用量で請求額は変わる#
今回確認したCrazyrouterのdefaultグループでは、GPT-6 Solに35%の割引が適用され、支払額は定価の65%になる。GPT-6.2 Solには通常料金を適用する。短い入力向けの区分における当サイトの割引適用後の料金は次のとおり。
| 100万トークンあたり | GPT-6.2 Sol | GPT-6 Sol |
|---|---|---|
| キャッシュされていない入力 | $2.00 | $1.30 |
| キャッシュ読み取り | $0.10 | $0.13 |
| 出力 | $10.00 | $6.50 |
キャッシュ読み取りは新版のほうが安く、キャッシュされていない入力と出力は旧版のほうが安い。自分の利用費用を見積もるときは、バージョン番号や公式料金だけで判断せず、当サイトの料金ページで改めて確認してほしい。
本テストの32件すべてについて、リクエストIDで利用記録と照合できた。実際に差し引かれたクォータを当サイトのquota_per_unit=500000で割り、次の表にまとめた。
| 実際の使用量と費用 | GPT-6.2 Sol | GPT-6 Sol |
|---|---|---|
| 本テストのリクエスト数 | 16 | 16 |
| 上流側が報告した入力トークン数 | 125,998 | 112,964 |
| うちキャッシュ読み取りトークン数 | 56,576 | 55,168 |
| 入力に占めるキャッシュの割合 | 44.9% | 48.8% |
| 出力トークン数(推論分を含む) | 5,460 | 7,325 |
| 実際の利用額 | $0.199104 | $0.129922 |
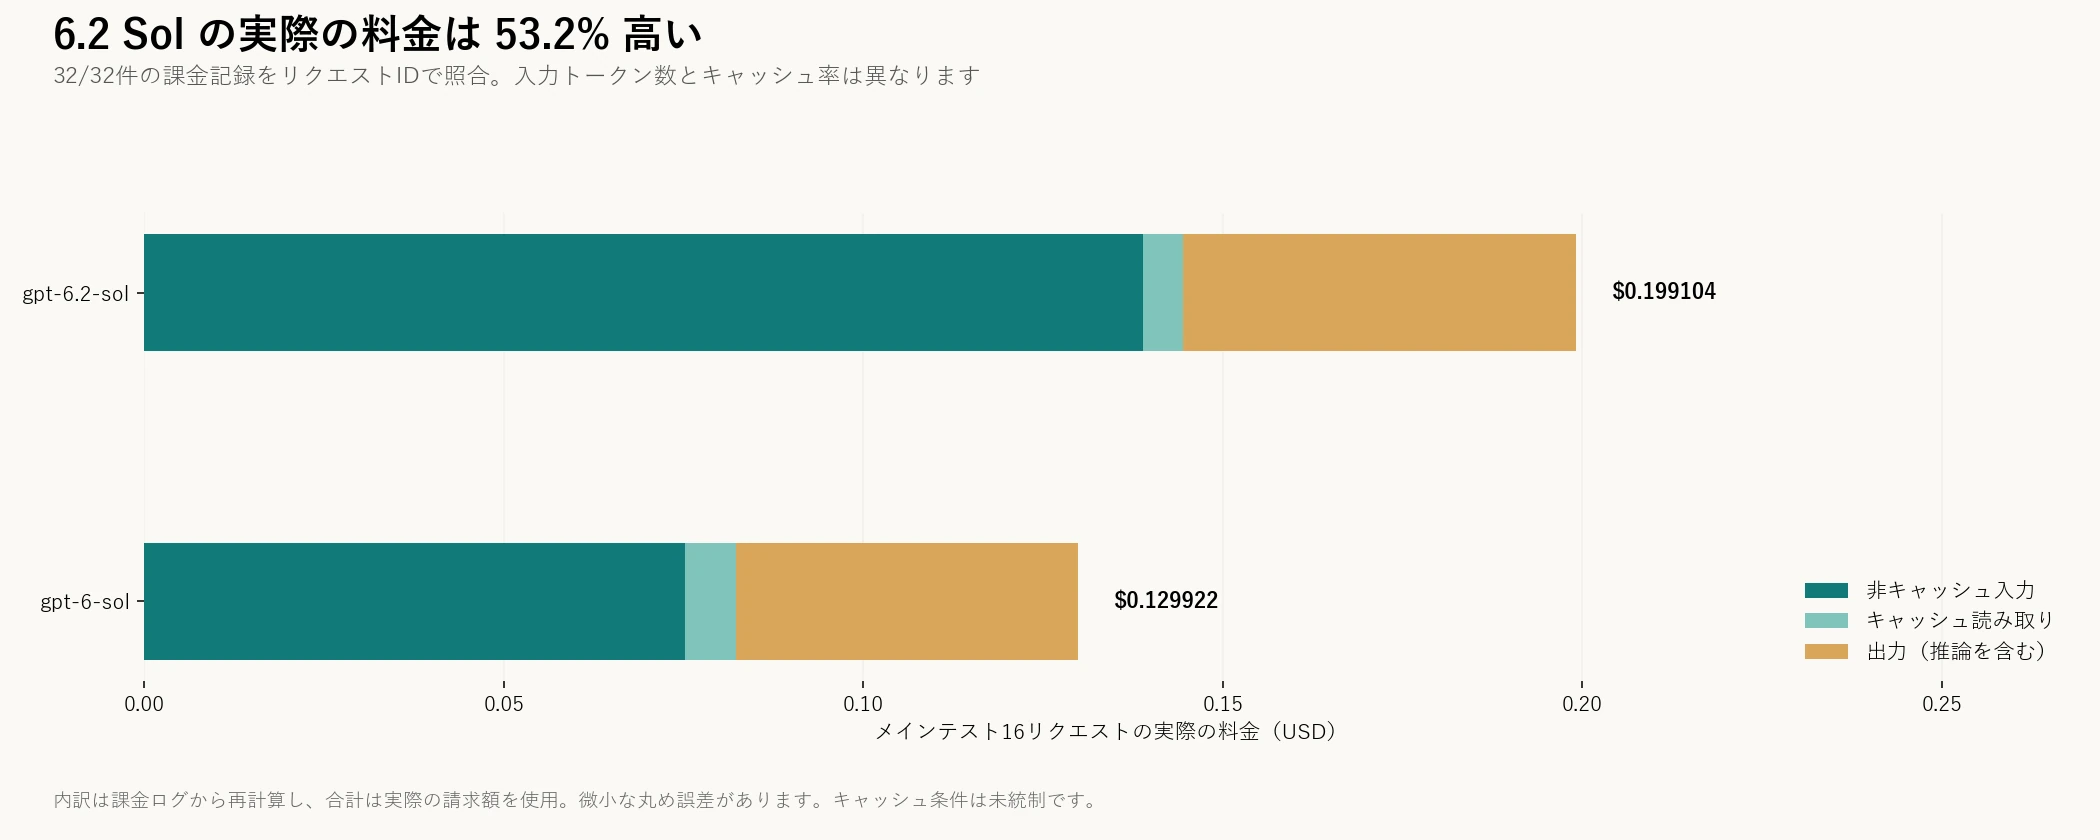
総額は実際に差し引かれたクォータから算出し、内訳はログから再構成した。わずかな差は丸めによる。費用には誤答したリクエストを含む。パラメータの確認、コードサンプル、カバー画像の生成は含まない。
今回、新版の実際の費用は**53.2%**高かったが、旧版が全問正解できなかったタスクもこなした。旧版は誤答した3回にも費用がかかっている。実際の業務で発生する人手による確認、再試行、訂正の費用は、上の表に含めていない。
ユーザーから見えるプロンプトは同一でも、上流側が報告した入力トークン数には差があり、出力トークン数は新版のほうが少なかった。報告された入力トークン数が異なる具体的な理由は特定しておらず、キャッシュが温まっているかどうかも統一していない。したがって、53.2%は今回の実行結果に限った数字で、今後すべてのユーザーに当てはまる一定の値上がり幅とはみなせない。
移行前の確認:旧設定のnoneはそのまま使えない#
公式ドキュメントでは、GPT-6 Solはreasoning_effort: noneをサポートし、GPT-6.2 Solはこの値を拒否するとされている。[1][2] 別途、同じチャネルで両モデルに短いJSONを求めるリクエストを1回ずつ送り、noneを明示的に設定して確認した。
| 追加のパラメータ確認 | GPT-6.2 Sol | GPT-6 Sol |
|---|---|---|
| HTTPステータス | 400 | 200 |
| 応答 | provider_temporarily_unavailable、サービスが一時的に利用できないことを示す汎用メッセージ | {"ok":true}、正常終了 |
今回の観測結果は公式に記載されているパラメータの違いと一致する。ただし、当サイトでは6.2のエラーを汎用メッセージに変換しており、応答内にnoneへの明示的な言及はなかった。「サービスが一時的に利用できない」という表示だけで障害の根本原因は断定できない。同じ非互換の設定で再試行を繰り返し続けるのも避けるべきだ。
移行時は既存のリクエストパラメータを確認し、サポートが明記されている推論レベルで検証する。本テストと記事中のサンプルでは、いずれもhighを使用した。また、GPT-6 Solの公式ページには、Chat Completionsで関数呼び出しを行う際の推論レベルに制限があると記載されている。ツールを使うアプリケーションには別途回帰テストが必要で、この記事ではツール呼び出しやResponses APIを検証していない。
両モデルで実行済みのサンプル#
以下のサンプルでは、重なっているか隣接している半開区間を結合するよう求める。requestsをインストールし、環境変数CRAZYROUTER_API_KEYに自分のキーを設定して実行する。APIのURLにはUTMパラメータを付けていない。
import json
import os
import requests

BASE_URL = "https://api.crazyrouter.com/v1"
MODELS = ["gpt-6.2-sol", "gpt-6-sol"]
PROMPT = ('Merge overlapping OR TOUCHING half-open intervals [[-3,2],[1,5],[5,9]] into maximal intervals. '
          'Return JSON only: {"merged":[[start,end]],"length":integer}.')


def run():
    session = requests.Session()
    session.trust_env = False
    results = []
    for model in MODELS:
        response = session.post(
            BASE_URL + "/chat/completions",
            headers={"Authorization": "Bearer " + os.environ["CRAZYROUTER_API_KEY"]},
            json={
                "model": model,
                "messages": [{"role": "user", "content": PROMPT}],
                "reasoning_effort": "high",
                "max_completion_tokens": 8192,
                "stream": False,
            },
            timeout=(15, 180),
        )
        response.raise_for_status()
        data = response.json()
        choice = data["choices"][0]
        if choice["finish_reason"] != "stop":
            raise RuntimeError("Incomplete output: " + str(choice["finish_reason"]))
        answer = json.loads(choice["message"]["content"])
        assert answer == {"merged": [[-3, 9]], "length": 12}, answer
        result = {"model": model, "answer": answer,
                  "request_id": response.headers.get("x-oneapi-request-id")}
        print(json.dumps(result, ensure_ascii=False))
        results.append(result)
    return results


if __name__ == "__main__":
    run()
最終版は両モデルに個別にリクエストを送って検証した。どちらも{"merged":[[-3,9]],"length":12}を返し、finish_reason=stopだった。この2回の呼び出しは一般ユーザー向けのルーティングを使用し、チャネルを固定した本テストとは別に集計した。
このサンプルではプロンプトの表現にも調整が必要だった。当初は「半開区間を結合する」とだけ指示していたため、6.2 Solは[[-3,5],[5,9]]を返した。長さは12で変わらなかったが、区間が1つになることを求めるプログラムのアサーションを満たさなかった。要件を「重なっているか隣接している区間を結合し、極大な区間を得る」と明記したところ、両モデルが合格した。このサンプルの修正履歴は保存している。本テストの区間問題は、最初から隣接する区間も結合するよう明記しており、設問の変更や再実行による結果の上書きは行っていない。
接続時に使うフィールドはCrazyrouter APIドキュメントで確認できる。CodexやCursorを使うチームは、自分たちのタスクとツールチェーンで回帰テストを行う必要がある。テキストのみのサンプルが合格しても、エージェントのワークフロー全体を検証したことにはならない。
どのような場合にGPT-6.2 Solへ切り替える価値があるか?#
| 利用場面 | 今回の結果に基づく選択肢 |
|---|---|
| 正確な件数集計やルールの絞り込みで、すでに漏れが起きている | 6.2 Solを優先して試し、プログラムによる検証は続ける |
| 依存関係や排他条件を含む最適な組み合わせの選択 | 6.2 Solを試す。今回は2回とも正解し、平均待ち時間も短かった |
| 日常のデータ処理が業務の回帰テストにすでに合格しており、費用を優先したい | 6 Solを継続利用できる。当サイトでは現在、割引適用後の料金が低い |
| 主な要件が応答時間の短縮 | まず自分のタスクで計測する。今回、新版の平均所要時間が短かったのは3種類のみ |
既存リクエストでreasoning_effort: noneを固定している | 先に推論レベルの設定を変更し、その後でモデル名を切り替える |
| 画像理解、ツール呼び出し、長時間動作するエージェントが必要 | 該当機能を個別に検証する。今回の成績からは判断できない |
Model Arenaで同じ設問を使った初期比較を行い、その後、実際に失敗したタスクを固定の回帰テストセットにまとめることができる。回答が一度流暢に見えたかどうかだけで判断するよりも、重要なフィールドごとに合格基準を定めたほうが、アップグレードで実際の問題が解消したかを判断しやすい。
制約付き最適化問題を再現する#
この設問で使用したユーザープロンプトの全文を以下に示す。本テストでは推論レベルをhigh、出力上限を8192に設定し、systemメッセージでJSONのみを返すよう求めた。正解はローカルでの採点にのみ使用し、モデルには送信しなかった。
Items IDs 0..11 have weights [4, 7, 2, 9, 5, 3, 8, 6, 4, 7, 1, 5] and values [13, 18, 7, 26, 14, 9, 23, 16, 12, 20, 4, 15]. Select total weight <=26 and at most 5 items. Constraints: selecting 3 requires 1; 6 and 7 cannot both be selected; selecting 9 requires 2; at least one of 0 and 4 must be selected. Maximize total value. Return JSON with best_value and optimal_sets (ALL optimal ID lists sorted ascending, and lists lexicographically sorted).
事前に算出した正解は以下のとおり。
{"best_value": 78, "optimal_sets": [[0, 2, 6, 9, 11]]}
12の候補項目の部分集合をすべて列挙し、重量、個数、依存関係、排他条件で絞り込めば、最適解を検証できる。再確認用に元のリクエスト、応答、個別の課金記録を保存している。この記事の表とグラフは、いずれもこれらの記録に基づく。
記事中の最小構成の呼び出しサンプルを、個別に2回実行したときのリクエストIDは以下のとおり。
gpt-6.2-sol:8f830a249943b0b13a1ec388dbf882f6。gpt-6-sol:f08d86841a979c9bf2d8928816e31789。
よくある質問#
GPT-6.2 SolはGPT-6 Solより正確か?#
今回は8種類のタスクをそれぞれ2回実行し、新版は16/16、旧版は13/16だった。差が出たのはルールの件数確認と制約付き最適化であり、この成績をすべてのタスクでの正解率に当てはめることはできない。
GPT-6.2 SolはGPT-6 Solよりどのくらい速いか?#
今回、制約付きの組み合わせ選択では平均所要時間が38.4%短縮され、全リクエストの平均所要時間は約6.6%短縮された。一方、中央値は11.14秒から12.48秒に増えた。新版のほうが速いかどうかはタスクの種類による。
GPT-6.2 SolのAPI料金は下がったか?#
キャッシュされていない入力と出力の公式料金は変わっていない。キャッシュ読み取りは100万トークンあたり0.10に下がった。当サイトでは現在、旧モデルに35%の割引が適用されて支払額が定価の65%になるため、今回の実際の総費用は新版のほうが高かった。
費用が高くなっても使う価値はあるか?#
旧版の数え漏れや最適解の見落としが業務上の損失につながるなら、新版を実測の候補に加える価値がある。既存タスクがすでに安定して合格しているなら、まずは旧版を維持してもよい。今回は人手による訂正や再試行の費用を測っていないため、すべての業務について費用対効果を算出することはできない。
APIの呼び出しに成功したのに、なぜ記事では誤答と判定したのか?#
HTTP 200、有効なJSON、正常終了から確認できるのは、リクエストが完了したことまでだ。旧版の3回の不合格はいずれも構造が正しい回答を返していたが、フィールドの値が事前に確定した正解と一致しなかったため、設問全体を不合格と判定した。
モデル名をそのままgpt-6.2-solに変更できるか?#
Base URLとテキストの呼び出し方法は引き継げるが、先に推論パラメータを確認する必要がある。公式ドキュメントでは新版がnoneを受け付けないことが明記されており、当サイトでの今回の確認でもHTTP 400が返った。ストリーミング、ツール、画像などの機能は別途テストが必要だ。
参考資料
- OpenAI:GPT-6.2 Solのモデルドキュメント(確認日 2026-11-20)。
- OpenAI:GPT-6 Solのモデルドキュメント(確認日 2026-11-20)。
- PostgreSQL:トランザクション分離とRead Committed(トランザクション問題のルール確認に使用)。
執筆はBrian J。テストは自動化スクリプトで実行した。この記事は当サイトのルーティングを使用した際の実際のサービス性能を記録したもので、上流モデルの重みについて独立した監査は行っていない。各設問は2回のみで、使用したチャネルと実行時間帯はいずれも1つに限られ、過去のキャッシュの影響も分離していない。元のリクエスト、応答、正解、機密情報を除いた課金記録はすべて保存している。変更されやすい情報は2026-12-20に再確認する予定。
Implementation Guides
最新エピソード
EP196 · 2026年10月29日 · 6:53
AI API Security Posture — Turn Controls Into Continuous Evidence
A practical guide to AI API security posture: inventory exposure, verify controls continuously, protect keys and data, constrain tools, and turn security assumptions into evidence that operators can act on.
EP195 · 2026年10月28日 · 7:21
AI API Policy Drift — Detect When Production Rules Stop Matching Intent
A practical guide to policy drift in AI APIs: version routing and safety rules, detect stale enforcement, compare intended and observed behavior, and restore control before small gaps become incidents.